Note de l’auteur : présentation de LongCat 2.5. Cet article passe en revue ses paramètres et son architecture, huit démonstrations officielles, ses résultats dans 25 tests officiels, le coût avec la réduction temporaire et les étapes pour l’utiliser dans Claude Code et Cline.
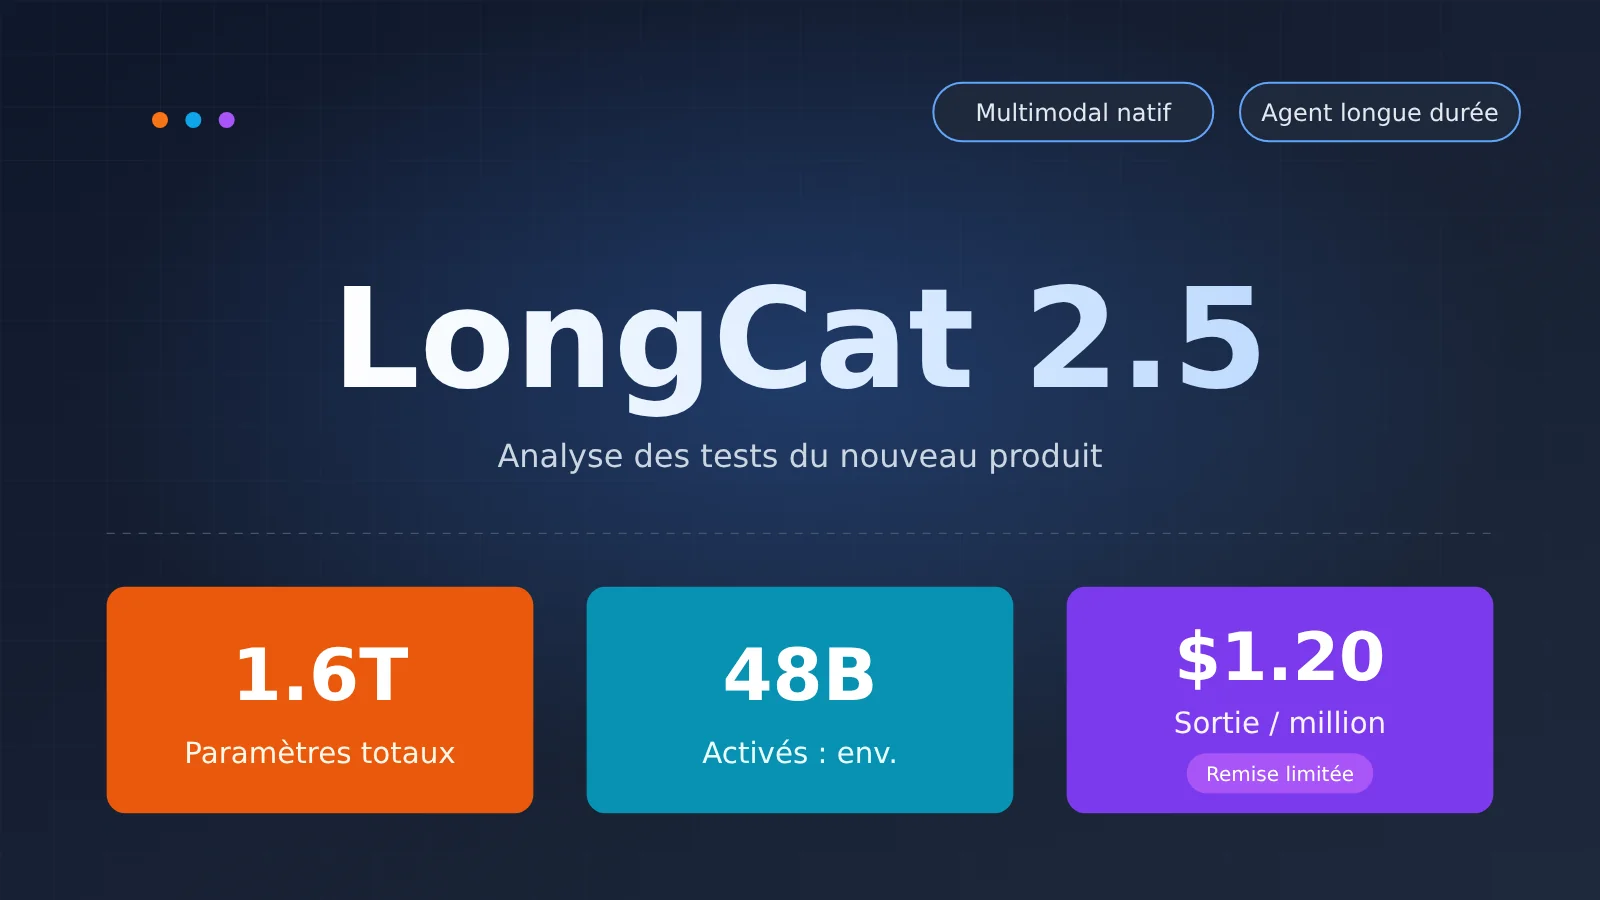
L’équipe LongCat de Meituan, comme l’appelle couramment la communauté, a publié LongCat-2.5 le 1er novembre. Ce modèle multimodal natif compte 1 600 milliards de paramètres au total et en active environ 48 milliards par token. Il est conçu pour les tâches d’agents de longue durée. Par rapport à la version 2.0, les principales améliorations portent sur la compréhension visuelle native et la programmation par agent. Une réduction est proposée pour une durée limitée : 1,20 $ par million de tokens en sortie, 0,30 $ par million de tokens en entrée sans accès au cache et 0,006 $ avec accès au cache.
Ce n’est pas un comparatif pour choisir entre plusieurs modèles. Nous allons nous concentrer sur trois questions : ce qu’est LongCat 2.5, les tâches où il excelle et son coût d’utilisation. Les scores servent uniquement de points de comparaison ; il ne s’agit pas de décider quel modèle en remplace un autre.
À retenir : à la fin de cet article, vous aurez une carte de ses capacités, de quoi calculer vos coûts et le chemin le plus court pour commencer.
LongCat 2.5 : les points essentiels
| Information | Détails |
|---|---|
| Date de lancement | 2026-11-01 (blog officiel) |
| Positionnement | Modèle multimodal natif conçu pour les tâches d’agents de longue durée |
| Taille | 1,6 billion de paramètres au total, dont environ 48 milliards activés par token |
| Nouveautés par rapport à la version 2.0 | Compréhension visuelle native, programmation agentique |
| Contexte / sortie maximale | 1 million de tokens / 128 000 tokens |
| Interfaces | Deux protocoles : formats OpenAI et Anthropic |
| Prix (réduction à durée limitée) | Entrée : 0,30 $ (hors cache) / 0,006 $ (en cache) ; sortie : 1,20 $, par million de tokens |
| Poids | Annoncés comme « à venir » sur GitHub et Hugging Face, pas encore publiés |
Un point peut prêter à confusion concernant les paramètres activés. Le jour du lancement, une publication communautaire indiquait 440 milliards de paramètres activés. Selon le blog officiel, le modèle en active environ 48 milliards par token. C’est donc ce chiffre que nous retenons dans cet article.
Qu’est-ce que LongCat 2.5 ? Paramètres, architecture et multimodalité native
Taille et méthode d’entraînement de LongCat 2.5
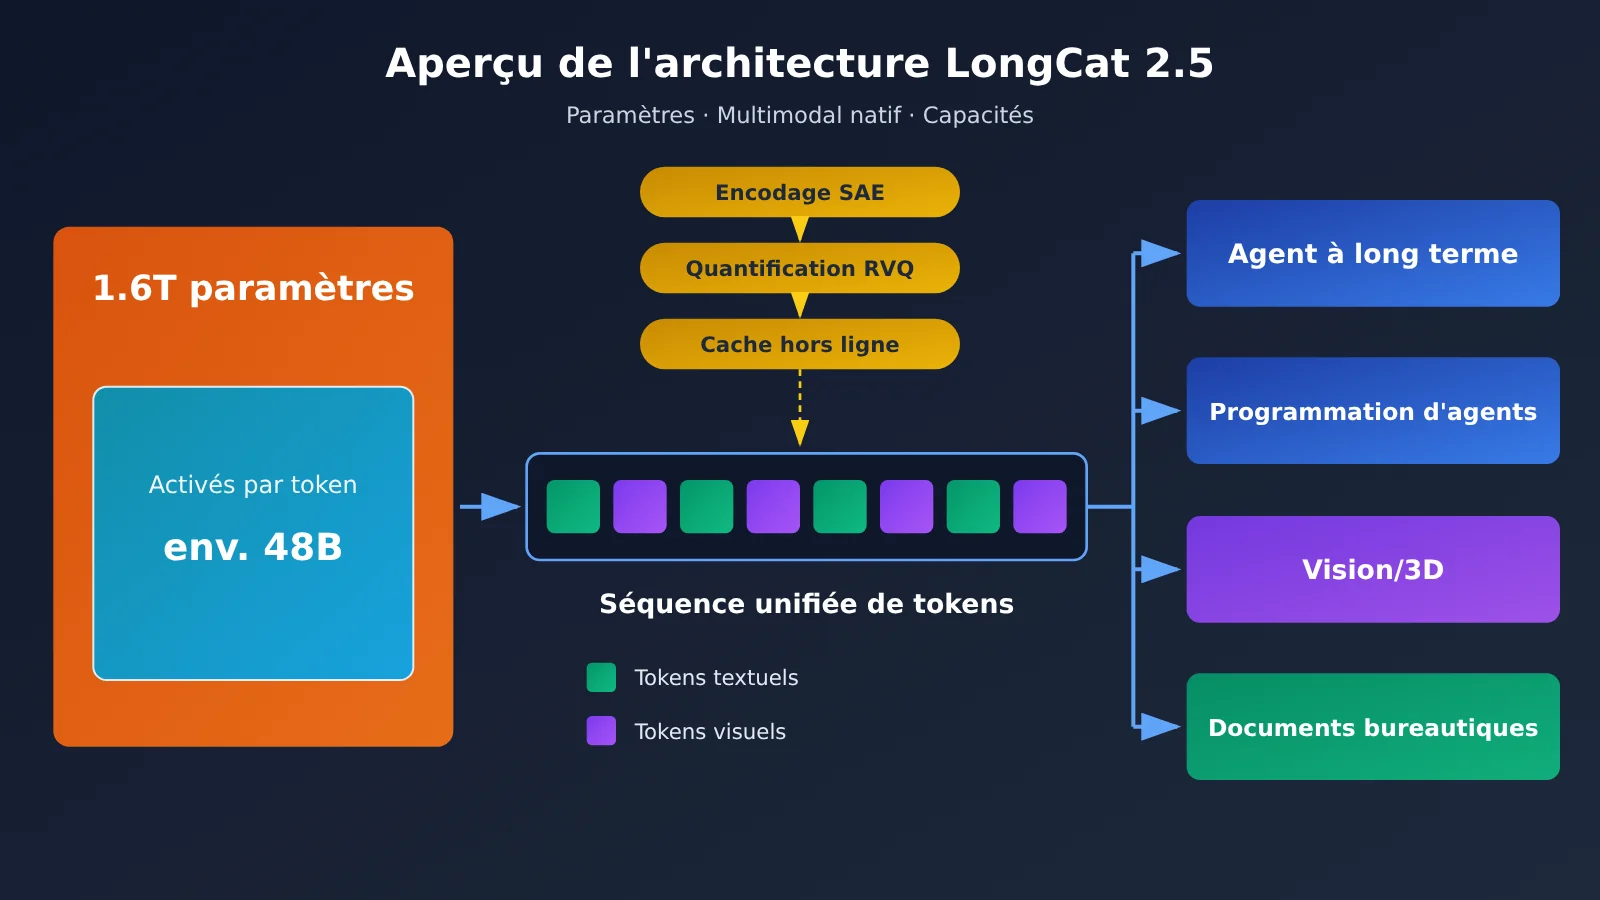
Avec 1,6 billion de paramètres au total et environ 48 milliards activés, LongCat 2.5 est un grand modèle de langage à activation parcellaire : sa taille totale est importante, mais seule une petite partie est mobilisée à chaque inférence. Cette architecture offre un compromis entre capacité de stockage des connaissances et coût d’inférence. C’est aussi l’une des conditions qui permettent de réduire les prix par la suite.
Côté entraînement, l’équipe présente plusieurs méthodes directement liées aux « tâches de longue durée » :
- Davantage de données de trajectoires longues : l’entraînement sur de longues séquences intègre davantage de trajectoires longues, puis un apprentissage par renforcement à grande échelle prépare le modèle à des tâches d’ingénierie de bout en bout, comme le développement dans des bases de code complexes ou la construction de projets complets.
- Transformer les échecs réels en exercices d’entraînement : la synthèse de données, la création d’environnements et l’entraînement mixte entre différents harness sont développés en parallèle pour convertir les trajectoires d’échec d’agents réels en tâches reproductibles et vérifiables.
- Limiter la « réflexion excessive » et les « appels répétés » : les raisonnements et appels d’outils répétitifs font l’objet de pénalités supplémentaires. Pour les cas de réflexion excessive ou d’allongement trop rapide des réponses, les récompenses associées aux exemples positifs sont redistribuées.
Le troisième point est particulièrement utile pour les agents. Dans les tâches de longue durée, ce qui coûte le plus cher est souvent le modèle qui tourne en rond en appelant le même outil. Limiter ce comportement dès l’entraînement permet d’économiser directement des tokens.
Comment fonctionne le multimodal natif de LongCat 2.5
Ici, « multimodal natif » a un sens précis. Les signaux visuels sont représentés par des tokens discrets organisés sur plusieurs niveaux. Le modèle principal traite les données visuelles et le texte sous une forme unifiée, sans passer par un encodeur visuel externe dont les caractéristiques seraient ensuite ajoutées au modèle.
L’équipe officielle décrit trois étapes :
- Discrétisation visuelle à la résolution native : un encodeur à alignement sémantique (SAE) et une quantification vectorielle résiduelle (RVQ) transforment l’image en tokens discrets.
- Prétraitement hors ligne des tokens visuels : une fois le tokenizer figé, les identifiants des tokens visuels peuvent être précalculés et mis en cache hors ligne.
- Apprentissage conjoint : les embeddings visuels sont entraînés en même temps que le modèle principal.
Selon l’équipe officielle, cette conception permet au modèle d’obtenir de bons résultats en programmation visuelle et de prendre en charge des tâches de création graphique ou de 3D. Dans le tableau des benchmarks présenté plus loin, 3DCodeBench et Vision2Web évaluent justement ce type de capacités.
Pourquoi LongCat 2.5 peut être proposé à ce prix
Le billet de blog officiel consacre une large place à l’efficacité de l’infrastructure, ce qui aide à comprendre le prix. L’entraînement repose sur des ressources de calcul produites en Chine, avec moins de 80 Go de mémoire vidéo par carte. Pour réduire la consommation mémoire, l’équipe utilise notamment FSDP avec un double partitionnement, le parallélisme sur un vocabulaire mixte et la réplication dynamique des experts. Sur les tâches de SFT à longues séquences, cette configuration FSDP offre un débit par carte supérieur de 86 % à la référence DDP.
Pour l’inférence, le modèle utilise W4A4 : les poids et les activations des experts sont quantifiés sur 4 bits. Selon les tests de charge officiels en production, par rapport à la référence W8A8 INT8, le débit de prefill augmente de 43,3 %, celui de decode de 42,77 %, tandis que la latence du premier token (TTFT) baisse de 15,91 % et celle par token (TPOT) de 19,72 %. Avec un débit supérieur de plus de 40 %, le coût par token diminue mécaniquement.
Les points forts de LongCat 2.5 : agents sur tâches longues et 8 cas officiels
Le bond entre LongCat 2.0 et 2.5
Commençons par comparer les deux générations. Les chiffres ci-dessous proviennent des tests internes officiels de LongCat. Les comparaisons marquées d’un astérisque dans la source proviennent de classements publics ; cette section ne reprend que les scores des deux générations de LongCat.
- Terminal Bench v4.0 : 3,0 pour 2.0, contre 38,5 pour 2.5.
- DeepSWE v1.1 : 9,7 pour 2.0, contre 64,6 pour 2.5.
- Program Bench Almost Resolved : 2,5 pour 2.0, contre 25,5 pour 2.5.
- AutomationBench v1.0.6 : 15,8 pour 2.0, contre 51,8 pour 2.5.
Ces benchmarks portent sur des tâches longues : opérations en plusieurs étapes dans un terminal, corrections à l’échelle d’un dépôt ou encore workflows automatisés. La version 2.0 y obtenait des scores proches de zéro ; la 2.5 atteint un niveau qui permet de la comparer à d’autres modèles. La progression en programmation agentique est donc bien réelle. L’équipe précise aussi que tous les résultats de LongCat-2.5 ont été obtenus avec le mode thinking activé, temperature=1.0 et top_p=0.95.
Les 8 démonstrations officielles de LongCat 2.5
L’équipe présente huit cas générés de bout en bout, répartis en deux groupes. Il s’agit de démonstrations officielles : nous ne les avons pas reproduites une par une.
| Catégorie | Cas | Ce que le cas met à l’épreuve |
|---|---|---|
| Développement logiciel | Simulation de fluides en temps réel | Calcul physique + rendu frontend en temps réel |
| Développement logiciel | Présentation interactive d’objets patrimoniaux en 3D | Création d’une scène 3D et logique d’interaction |
| Développement logiciel | Maquette urbaine | Agencement et organisation d’un grand nombre d’objets |
| Développement logiciel | Ressources pour une scène miniature | Contrôle des détails lors de la génération de ressources 3D |
| Bureautique professionnelle | Analyse de l’activité commerciale | Lecture des données, analyse des indicateurs et rédaction des conclusions |
| Bureautique professionnelle | Rapport d’analyse des retours clients | Classification et synthèse de textes non structurés |
| Bureautique professionnelle | Page consacrée à l’esthétique des couleurs chinoises | Sens esthétique et mise en page web |
| Bureautique professionnelle | Générateur d’invitations pour un événement | Interaction avec un formulaire + conception de la mise en page |
Trois des quatre cas de développement logiciel touchent directement à la 3D : ils illustrent les capacités visuelles natives et le Visual Coding du modèle. Les cas bureautiques sont davantage axés sur la lecture de documents et la production de livrables, dans la même veine que les tâches des benchmarks JobBench et GDPVal.
Où se situe LongCat 2.5 dans les benchmarks ?
Le tableau d’évaluation officiel compte plus de 25 tests, répartis en trois catégories : agents de code, agents généralistes et vision. Voici une comparaison de cinq modèles sur neuf de ces tests.
| Benchmark | LongCat-2.5 | Claude Opus 5 | GPT-5.6-Sol | GLM-5.3 | Kimi K3 |
|---|---|---|---|---|---|
| Terminal Bench v2.1 | 88.4 | 89.1* | 88.8* | 88.2* | 88.3* |
| Terminal Bench v4.0 | 38.5 | 53.9* | 37.3* | 41.8* | 12.6* |
| DeepSWE v1.1 | 64.6 | 68.8* | 72.7* | 66.9* | 67.5* |
| BrowseComp | 91.9 | 90.8* | 90.4* | 81.0 | 91.2* |
| HLE w/tools | 63.1 | 64.7* | 58.0* | 62.5* | 56.0* |
| JobBench | 65.4 | 66.7* | 45.4* | 61.4* | 52.9* |
| MCP Atlas | 83.1 | 85.8* | 81.8* | 84.2* | 84.2* |
| 3DCodeBench Text to 3D | 55.4 | 54.3 | 52.3 | 53.4 | 49.3 |
| Vision2Web | 78.6 | 80.2* | 73.5* | 77.8* | 79.0* |
Les scores marqués d’un * proviennent de classements publics ou de rapports techniques cités par LongCat. Les autres sont issus de ses propres tests et servent uniquement de points de comparaison.
En s’en tenant aux chiffres, quelques constats ressortent :
- Recherche d’informations : LongCat atteint 91.9 sur BrowseComp, le meilleur score des cinq modèles. L’équipe utilise un harness léger développé en interne, avec seulement deux outils activés, search et browse_with_goal, et un maximum de 1024 tours.
- Génération 3D : avec 55.4 sur 3DCodeBench Text to 3D, LongCat arrive en tête. Mais aucun des cinq scores de cette ligne ne porte d’astérisque : ils proviennent tous des tests de LongCat.
- Tâches en terminal : sur Terminal Bench v2.1, les cinq modèles se tiennent entre 88.2 et 89.1. Sur la version v4.0, plus difficile, LongCat-2.5 obtient 38.5 contre 53.9 pour Claude Opus 5, soit un écart de 15.4 points.
- Corrections à l’échelle d’un dépôt : LongCat obtient 64.6 sur DeepSWE v1.1, le score le plus bas des cinq modèles, contre 72.7 pour GPT-5.6-Sol.
- Utilisation d’outils et tâches bureautiques : avec 83.1 sur MCP Atlas et 65.4 sur JobBench, LongCat se situe respectivement à 2.7 et 1.3 points d’Opus 5.
Il faut aussi tenir compte du harness. Les deux versions de Terminal Bench utilisent Claude Code comme harness, avec un max_seq_length de 512K ; DeepSWE utilise mini-swe-agent, avec une longueur de séquence de 1M. Il vaut donc mieux éviter de comparer directement les scores de tests utilisant des harness différents.
Prix de LongCat 2.5 : comparatif et facture pour 1 million de tokens
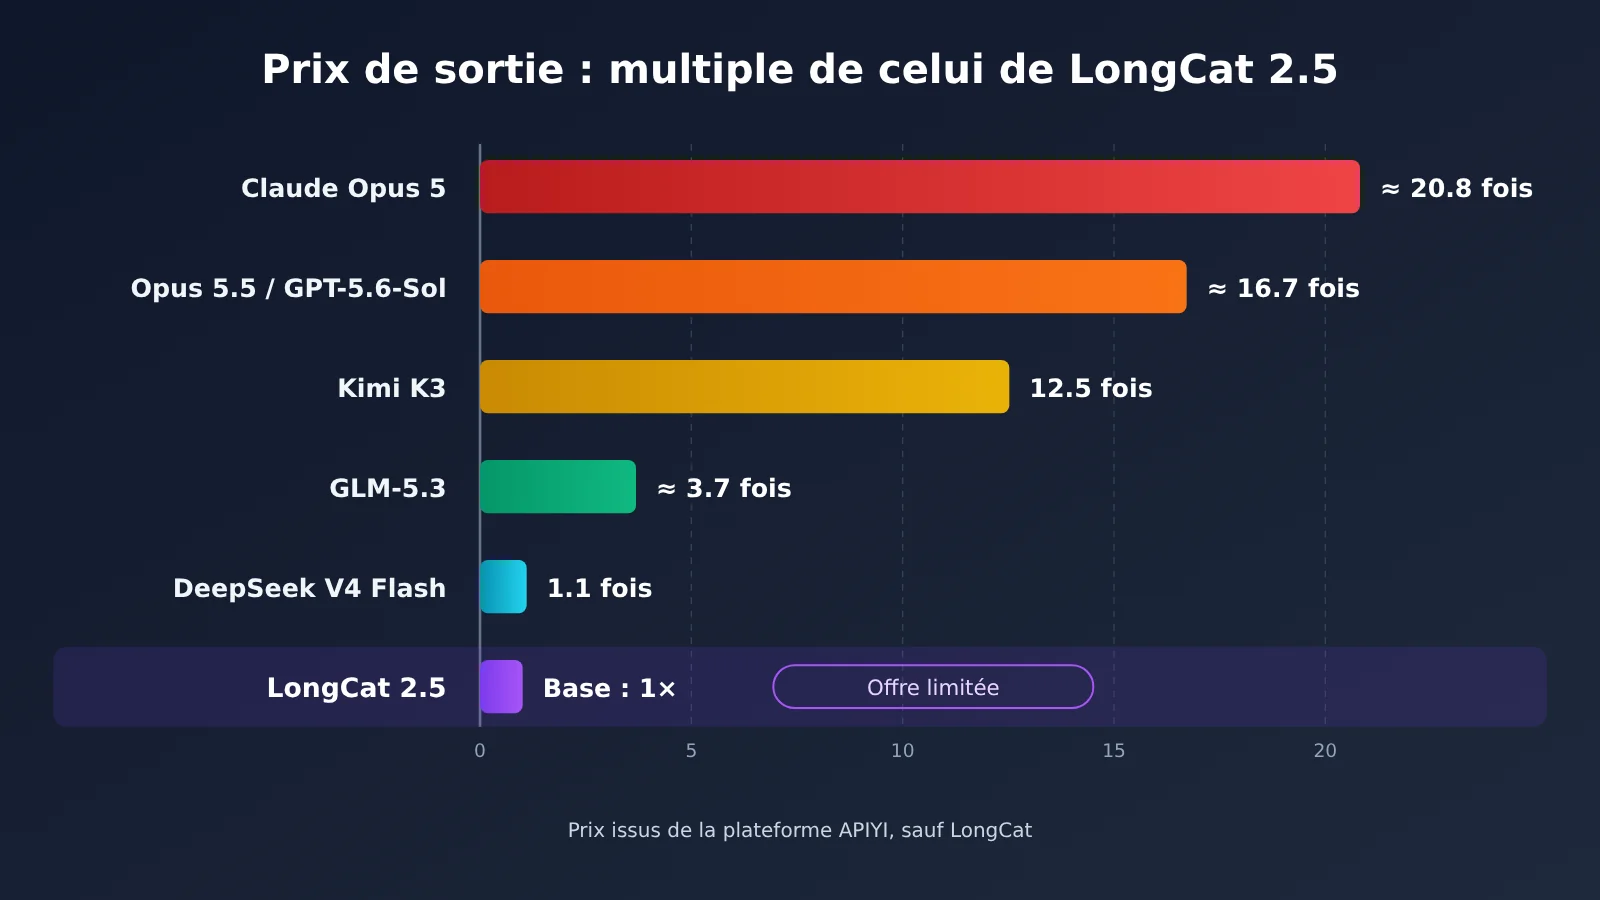
Légende : le prix de LongCat-2.5 est le tarif promotionnel à durée limitée de la plateforme API officielle. Les prix des autres modèles proviennent de la liste des modèles de la plateforme APIYI apiyi.com.
| Modèle | Entrée (par million de tokens) | Sortie (par million de tokens) | Prix de sortie par rapport à LongCat |
|---|---|---|---|
| LongCat-2.5 (promotion à durée limitée, plateforme officielle) | $0,30 ($0,006 en cas de cache hit) | $1,20 | 1 fois |
| Claude Opus 5 | $5 | $25 | Environ 20,8 fois |
| Claude Opus 5.5 | $4 | $20 | Environ 16,7 fois |
| GPT-5.6-Sol | $4 | $20 | Environ 16,7 fois |
| Kimi K3 | $3 | $15 | 12,5 fois |
| GLM-5.3 | $1,4 | $4,396 | Environ 3,7 fois |
| DeepSeek V4 Flash | $0,44 | $1,32 | Environ 1,1 fois |
Prix APIYI apiyi.com consultés le 2 novembre 2026, tels qu’affichés ce jour-là dans la liste des modèles de la plateforme. Le prix de LongCat-2.5 provient de la plateforme LongCat API, qui précise qu’il peut être modifié.
La facture pour 1 million de tokens
Prenons une tâche par lot de 1 million de tokens : 800 000 en entrée et 200 000 en sortie, sans tenir compte du cache.
- LongCat-2.5 (réduction à durée limitée) : 0,8 × $0.30 + 0,2 × $1.20 = $0.48
- DeepSeek V4 Flash : $0.352 + $0.264 = $0.616
- GLM-5.3 : $1.12 + $0.879 ≈ $2.00
- Kimi K3 : $2.40 + $3.00 = $5.40
- GPT-5.6-Sol ou Claude Opus 5.5 : $3.20 + $4.00 = $7.20
- Claude Opus 5 : $4.00 + $5.00 = $9.00
Pour le même travail, Opus 5 coûte environ 18,75 fois plus cher que LongCat-2.5. Si la tâche bénéficie du cache, l’écart est encore plus grand. L’exemple officiel prévoit 1 million de tokens en entrée (400 000 trouvés dans le cache et 600 000 non trouvés), plus 500 000 en sortie : la facture s’élève à $0.18 + $0.0024 + $0.6 = $0.7824. Les tokens d’entrée trouvés dans le cache ne coûtent que $0.006 par million, soit 1/50 du tarif des tokens non trouvés.
Deux autres détails de facturation à retenir : seules les requêtes qui renvoient un code HTTP 200 sont facturées ; les requêtes en échec, avec un code 401, 403, 429 ou 500 par exemple, ne le sont pas. Le solde est prépayé et n’expire pas. Si vous disposez de crédits offerts, ils sont utilisés en premier.
Comparer plusieurs modèles sans se compliquer la vie
En pratique, un projet d’agent utilise rarement un seul modèle. Vous voudrez peut-être tester les mêmes invites sur LongCat-2.5, Claude, GPT et GLM pour comparer leurs réponses. Avec APIYI apiyi.com, un seul compte et une seule clé API permettent de passer d’un modèle à l’autre, sans créer ni approvisionner un compte chez chaque fournisseur.
📌 À noter : les modèles et leurs tarifs sont indiqués dans la liste des modèles sur APIYI apiyi.com. LongCat-2.5 n’y est pas encore disponible, mais sera proposé dès que possible.
Prendre en main LongCat 2.5 : site officiel et intégration API
Première étape : tester dans le navigateur
L’interface officielle est accessible à l’adresse longcat.ai/chat. Selon une publication communautaire, pendant la période de lancement, les nouveaux utilisateurs reçoivent 10 millions de tokens et les utilisateurs existants 5 millions. Ces crédits sont ajoutés automatiquement, et les réponses issues du cache ne les consomment pas. La publication mentionne aussi une offre promotionnelle à 9,9 yuans, « bientôt disponible ».
Pour commencer, essayez des tâches de recherche et d’analyse d’images : ce sont deux domaines où le modèle se classe bien dans les tests.
Deuxième étape : utiliser l’API et retenir quatre paramètres
- Point de terminaison au format OpenAI :
https://api.longcat.ai/openai - Point de terminaison au format Anthropic :
https://api.longcat.ai/anthropic - Champ model :
LongCat-2.5 - Contexte et sortie : fenêtre de contexte de 1 million de tokens, sortie maximale de 128 000 tokens
Pour les limites de débit, la documentation officielle indique seulement qu’un dépassement renvoie le code HTTP 429, le code d’erreur rate_limit_exceeded et une valeur retry_after de 60. Elle recommande aussi d’utiliser une stratégie de nouvelles tentatives avec temporisation exponentielle côté client. Les limites précises en RPM et TPM ne sont pas publiques.
Si votre code utilise déjà le SDK OpenAI pour appeler un autre modèle, il suffit de modifier trois champs : base_url, api_key et model. Par exemple, si vous utilisez habituellement APIYI avec le base_url https://api.apiyi.com/v1, remplacez-le par https://api.longcat.ai/openai pour passer à l’API officielle de LongCat, puis définissez model sur LongCat-2.5.
Troisième étape : intégrer LongCat à Claude Code
- Claude Code, section env de
~/.claude/settings.json: renseignez la clé API LongCat dansANTHROPIC_AUTH_TOKEN - Section env du même fichier : définissez
ANTHROPIC_BASE_URLsurhttps://api.longcat.ai/anthropic - Section env du même fichier : définissez
ANTHROPIC_MODELsurLongCat-2.5 - Section env du même fichier : définissez
CLAUDE_CODE_MAX_OUTPUT_TOKENSsur131072 - Section env du même fichier (recommandé) : faites aussi pointer
ANTHROPIC_SMALL_FAST_MODEL,ANTHROPIC_DEFAULT_SONNET_MODELetANTHROPIC_DEFAULT_OPUS_MODELversLongCat-2.5
Si vous ne modifiez pas ces trois dernières variables, certaines sous-tâches internes de Claude Code risquent de continuer à appeler les modèles par défaut, ce qui peut provoquer des erreurs ou une facturation inattendue.
Quatrième étape : intégrer LongCat à Cline
- Cline, panneau de paramètres dans la barre latérale de VS Code : sous API Provider, sélectionnez une option compatible avec OpenAI
- Dans le même panneau : renseignez
https://api.longcat.ai/openaidans Base URL - Dans le même panneau : renseignez votre clé API LongCat dans API Key et
LongCat-2.5dans Model ID
La documentation officielle de LongCat propose une page d’intégration dédiée à Cline : référez-vous à cette page pour les noms exacts des champs. Elle contient aussi des guides pour plus d’une dizaine d’autres outils, dont Codex, OpenCode, Kilo Code, Cherry Studio, Chatbox et CC Switch.
🚀 Conseil pour démarrer rapidement : utilisez d’abord les crédits offerts par LongCat pour tester vos tâches, puis décidez si vous souhaitez l’intégrer durablement. Si vous avez aussi besoin d’appeler Claude, GPT et Gemini pour les comparer, APIYI sur apiyi.com permet de les gérer via une interface commune compatible avec OpenAI. Une fois LongCat-2.5 disponible sur la plateforme, vous pourrez également y accéder depuis le même compte.
À quoi sert LongCat 2.5 ?
| À confier à LongCat 2.5 | À tester d’abord |
|---|---|
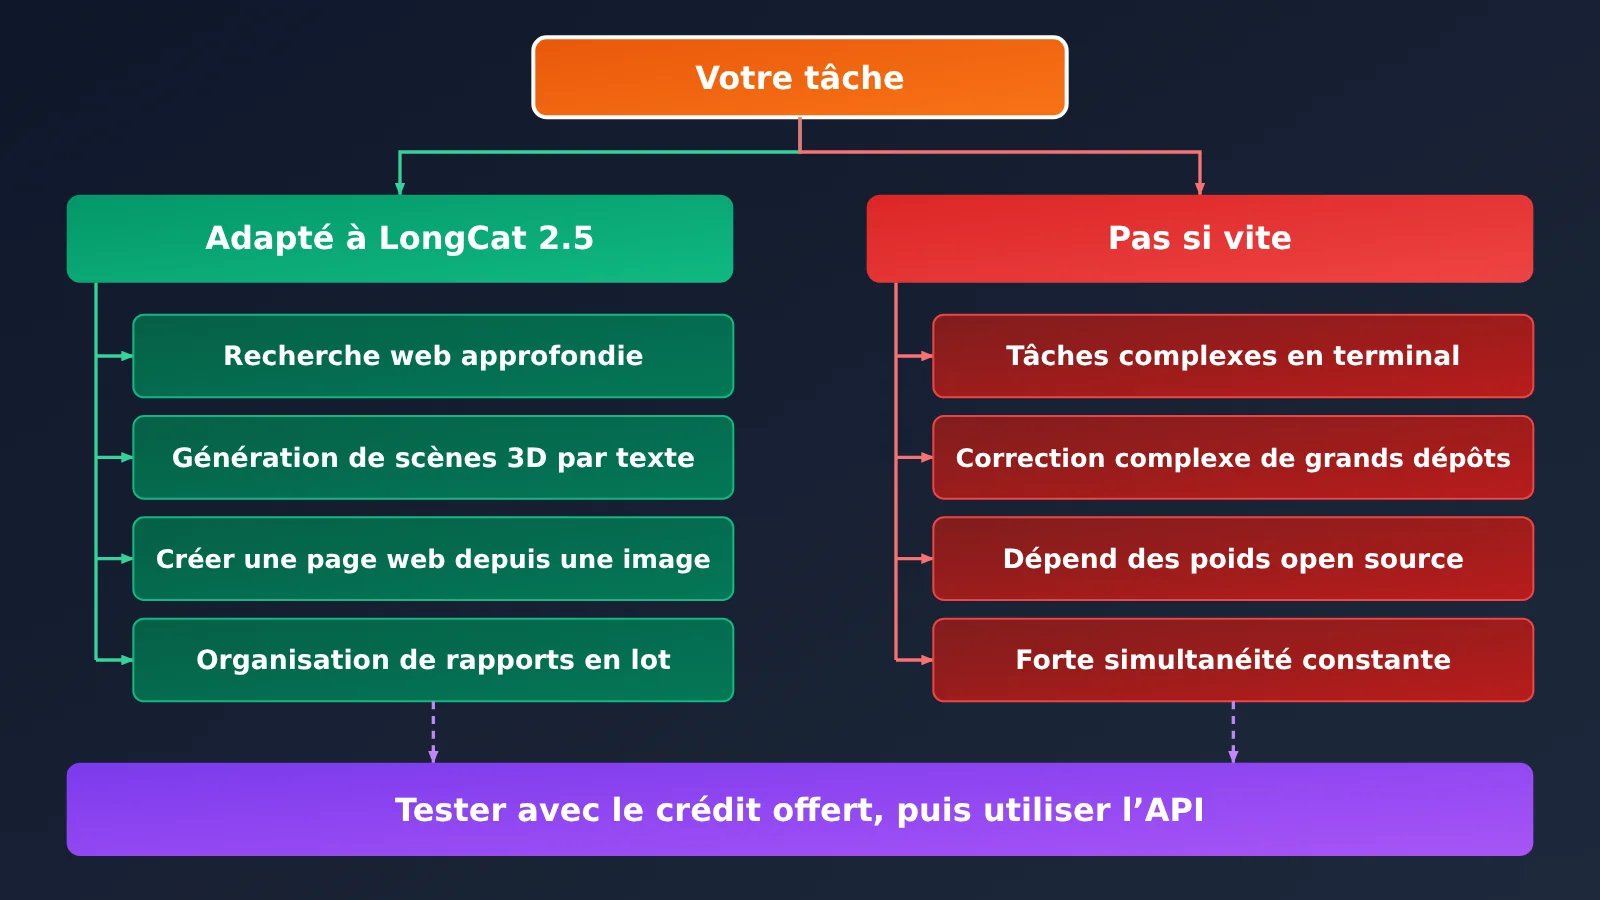
| Recherches web en plusieurs étapes et synthèse documentaire (BrowseComp : 91,9) | Tâches d’administration complexes en plusieurs étapes dans un terminal (Terminal Bench v4.0 : 38,5, contre 53,9 pour Opus 5) |
| Génération de scènes 3D Three.js et autres à partir d’une description textuelle (3DCodeBench : 55,4) | Correction de bugs difficiles dans de grands dépôts (DeepSWE v1.1 : 64,6, le score le plus bas des cinq colonnes) |
| Création d’une page web à partir d’une maquette ou d’une capture d’écran (Vision2Web : 78,6) | Projets nécessitant un déploiement privé et des poids locaux (les poids ne sont pas encore disponibles) |
| Compilation et rédaction en masse de retours clients et de données d’activité (JobBench : 65,4 ; tarif de sortie promotionnel à durée limitée : 1,20 $ par million de tokens) | Services en production nécessitant un quota fixe pour une forte concurrence (RPM et TPM non communiqués officiellement) |
Les tâches de la colonne de gauche ont un point commun : elles sont longues, consomment beaucoup de tokens et sont sensibles au coût unitaire. LongCat-2.5 est convaincant tant par ses scores que par son prix. Pour la colonne de droite, cela ne signifie pas qu’il en est incapable : ses scores montrent encore un écart ou les conditions de déploiement et les quotas restent flous. Mieux vaut donc commencer par un test à petite échelle.
FAQ : questions fréquentes sur LongCat 2.5
Q1 : Les scores de LongCat 2.5 ont-ils été mesurés par un tiers ?
Non. Dans le tableau, tous les scores de LongCat-2.5 proviennent de tests réalisés par l’équipe officielle de LongCat. Pour les modèles utilisés à titre de comparaison, les scores marqués d’un astérisque proviennent de rapports publics ou de classements officiels ; les autres ont également été mesurés par LongCat. Mieux vaut donc les utiliser comme points de comparaison.
Q2 : Le tarif de 1,20 $ par million de tokens est-il permanent ?
Non. L’équipe officielle précise qu’il s’agit d’un tarif promotionnel à durée limitée et qu’il peut changer. Consultez la page de la plateforme LongCat API et votre facture pour connaître le tarif applicable. Pour prévoir votre budget à long terme, prévoyez aussi un modèle de rechange : une plateforme d’agrégation comme APIYI, sur apiyi.com, vous permet de passer de l’un à l’autre.
Q3 : LongCat 2.5 est-il open source ?
Pas encore. Sur le blog officiel, les boutons GitHub et HuggingFace portent tous deux la mention « Bientôt disponible ». Pour l’instant, seuls l’essai en ligne et l’accès par API sont disponibles. Aucun calendrier de publication en open source n’a été annoncé.
Q4 : Peut-on invoquer LongCat 2.5 sur APIYI ?
Pas encore. APIYI proposera ce modèle dès que possible. En attendant, vous pouvez utiliser directement l’API officielle de LongCat. Pour comparer Claude, GPT et GLM, vous pouvez déjà tester ces modèles sur APIYI, sur apiyi.com, avec une seule clé API. Consultez la liste des modèles sur la plateforme pour connaître les versions et les tarifs disponibles.
Q5 : Que faire en cas d’erreur 429 ?
Cela signifie qu’une limite de débit a été atteinte. Le corps de la réponse contient `retry_after` avec la valeur 60. L’équipe officielle recommande d’utiliser une stratégie de nouvelles tentatives avec délai exponentiel côté client. Les requêtes renvoyant une erreur 429 ne sont pas facturées : elles n’entraînent donc aucun frais supplémentaire.
Bilan : faut-il intégrer LongCat 2.5 ?
Les points clés de LongCat 2.5 :
- Positionnement : un modèle nativement multimodal de 1 600 milliards de paramètres, dont environ 48 milliards sont activés par token, conçu pour les tâches agentiques de longue durée.
- Progrès : par rapport à la version 2.0, le score passe de 3,0 à 38,5 sur Terminal Bench v4.0 et de 9,7 à 64,6 sur DeepSWE v1.1.
- Points forts : avec 91,9 sur BrowseComp et 55,4 sur 3DCodeBench, il obtient les meilleurs résultats des cinq modèles comparés dans cet article, selon les chiffres officiels.
- Limites : un écart notable subsiste sur Terminal Bench v4.0 et DeepSWE v1.1.
- Prix : pendant la promotion, la sortie coûte 1,20 $ par million de tokens. Une requête de 800 000 tokens en entrée et 200 000 en sortie revient à environ 0,48 $.
- Intégration : compatible avec les protocoles OpenAI et Anthropic ; il suffit de modifier quatre variables pour l’utiliser avec Claude Code.
En bref : testez d’abord les tâches de recherche et d’analyse d’images sur longcat.ai/chat avec les 10 millions de tokens offerts, puis passez à l’API si les résultats vous conviennent. Pour basculer régulièrement entre plusieurs modèles, vous pouvez les gérer au même endroit avec APIYI sur apiyi.com.
📚 Références
- Blog officiel de LongCat : article de lancement de LongCat-2.5, avec l’architecture, l’entraînement et les tableaux d’évaluation
- Lien :
longcat.ai/blog/longcat-2.5 -
À consulter pour : les paramètres, les 8 exemples de démonstration et la méthodologie des évaluations
-
Documentation de la plateforme API LongCat : interface, facturation et intégration aux outils
- Lien :
longcat.ai/platform/docs -
À consulter pour : les endpoints des deux protocoles, les tarifs promotionnels et les pages d’intégration à Claude Code et Cline
-
Liste des modèles APIYI : tarifs des modèles sur les différentes plateformes
- Lien :
docs.apiyi.com/models - À consulter pour : les prix comparés dans cet article, selon les tarifs affichés le jour de la consultation
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour en savoir plus, consultez le centre de documentation docs.apiyi.com.