Note de l’autrice : si le taux de cache d’invites de Claude tombe soudainement à 0, ou si votre facture refuse de baisser, vous pouvez utiliser diagnostics en trois étapes pour localiser l’endroit où le préfixe diverge, puis croiser avec usage pour savoir si le cache est réellement touché. Cet article explique aussi comment faire l’auto-vérification quand vous passez par le service proxy APIYI. (Si le problème vous concerne, n’hésitez pas à envoyer cet article à votre Agent après l’avoir lu pour qu’il mène l’enquête.)
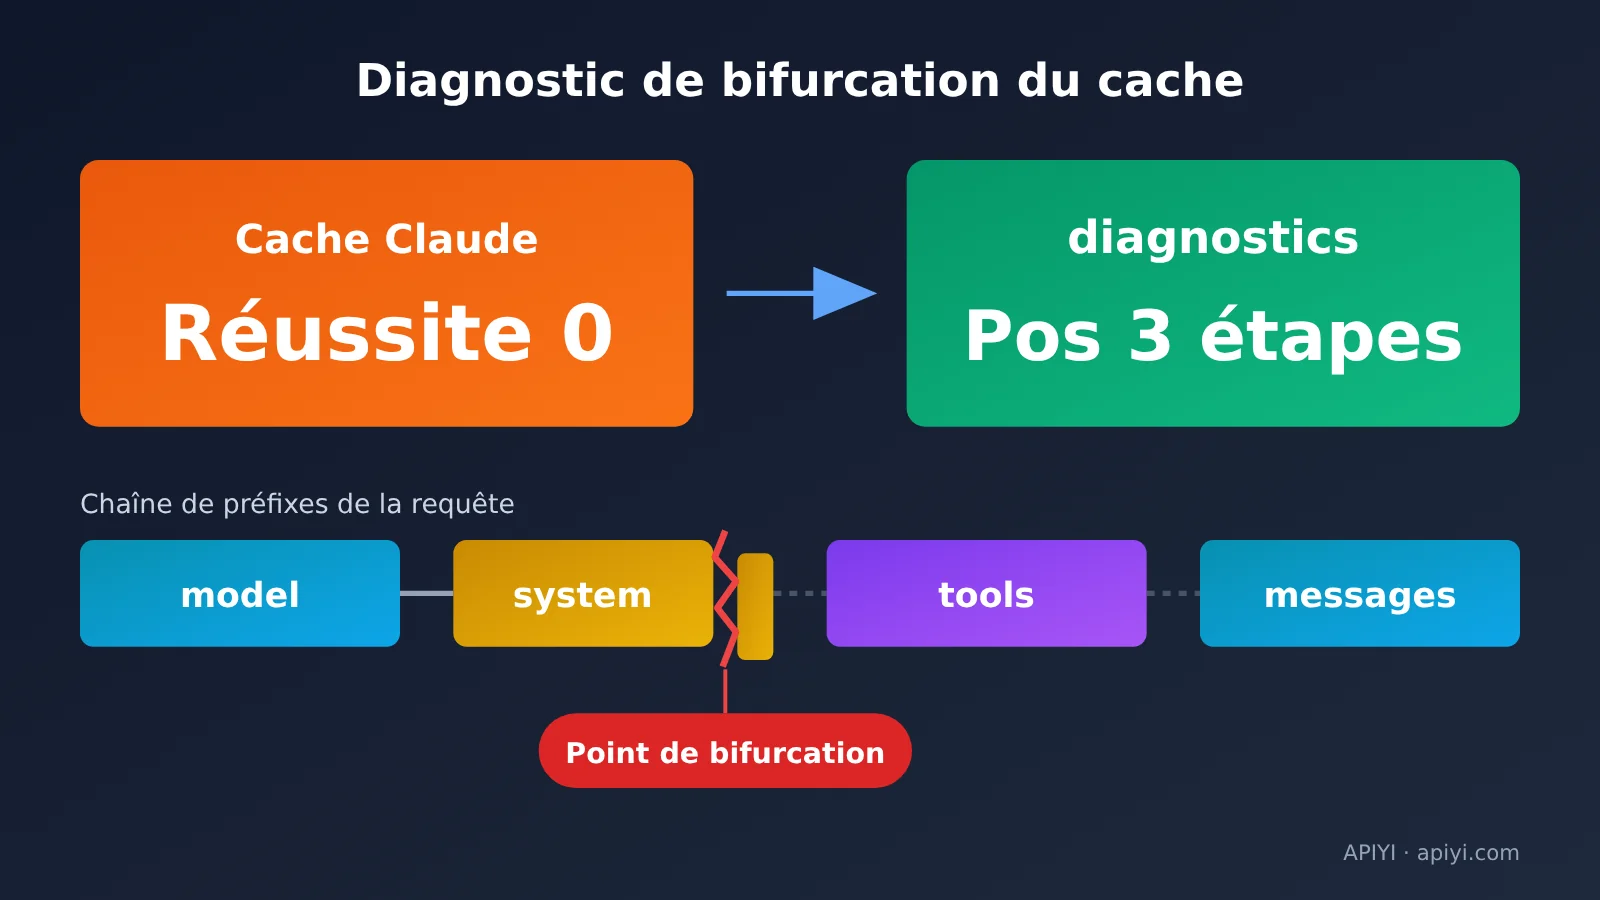
Un cache qui ne prend pas, ce n’est pas de la magie noire : l’API vous indique à partir de quel segment le préfixe diverge. Il vous suffit de renvoyer l’id de la réponse du tour précédent pour voir où tombe le premier écart : model, system, tools ou messages.
Ce n’est pas une analyse de nouvelle fonctionnalité. Cet article s’adresse aux développeurs qui utilisent déjà le cache d’invites de Claude, mais dont le taux de réussite est soudainement tombé à zéro ou dont la facture reste élevée. Toutes les étapes de diagnostic sont décrites avec ce que vous verrez à chaque fois.
L’essentiel : après avoir lu cet article, vous saurez identifier la cause d’un cache invalidé en trois requêtes. Vous saurez aussi distinguer ce que disent respectivement diagnostics et usage, et quels deux champs comparer quand vous passez par un service proxy.
Points clés du diagnostic de cache Claude
En une phrase : vous transmettez l’id de la réponse précédente, l’API compare les deux requêtes et vous indique où se situe le premier point de divergence — model, system, tools ou messages. Avant, quand le cache tombait silencieusement, vous ne voyiez que usage.cache_read_input_tokens passer à 0, sans savoir quel segment avait changé.
| Point | Explication | Ce que ça vous apporte |
|---|---|---|
| Activation | Il faut un objet diagnostics au niveau racine du corps de requête pour que l’empreinte soit enregistrée |
Aucune logique métier à modifier, un champ suffit |
| Méthode de comparaison | On passe l’id de la réponse précédente dans previous_message_id |
On localise directement le premier segment divergent |
| Champ de conclusion | cache_miss_reason renvoie l’un des six types |
Chaque type indique précisément où corriger |
| À combiner avec | À lire avec usage.cache_read_input_tokens |
Évite de confondre « pas de divergence » et « pas d’effet » |
| Disponibilité | Uniquement sur l’API Claude officielle | Via un autre canal, il faut se rabattre sur l’auto-vérification via usage |
Chronologie du diagnostic de cache Claude
La fonctionnalité est arrivée en beta en mai 2026 ; il fallait alors ajouter l’en-tête anthropic-beta: cache-diagnosis-2026-04-07. En septembre, les règles ont été resserrées une première fois : seules les requêtes contenant explicitement l’objet diagnostics enregistrent une empreinte, celles qui n’ont que l’en-tête ne sont pas conservées.
Le 23 septembre, elle est passée en version stable : plus besoin de cache-diagnosis-2026-04-07, et les requêtes portant l’ancien en-tête continuent de fonctionner normalement. Désormais, la réponse de POST /v1/messages contient toujours un champ diagnostics, dont la valeur est null quand l’option n’est pas activée. Voir ce champ à null ne signifie donc pas que l’interface a un problème.
L’empreinte ne conserve qu’un hash et une estimation du nombre de tokens, jamais le contenu brut de l’invite. Elle est indexée par response id, limitée à votre organisation et à votre workspace, et gardée assez peu de temps.
Diagnostiquer le taux de cache de Claude en 3 étapes avec diagnostics
Voici les trois étapes, rédigées d’après la documentation officielle des champs. Si vous passez par APIYI, pour l’interface native Messages, renseignez https://api.apiyi.com/v1 comme base_url ; le chemin de requête est /v1/messages. Attention toutefois : la partie test pratique plus bas montrera ce que diagnostics renvoie réellement dans un contexte de service proxy API.
Étape 1 : ajouter l’objet diagnostics au niveau racine de la requête
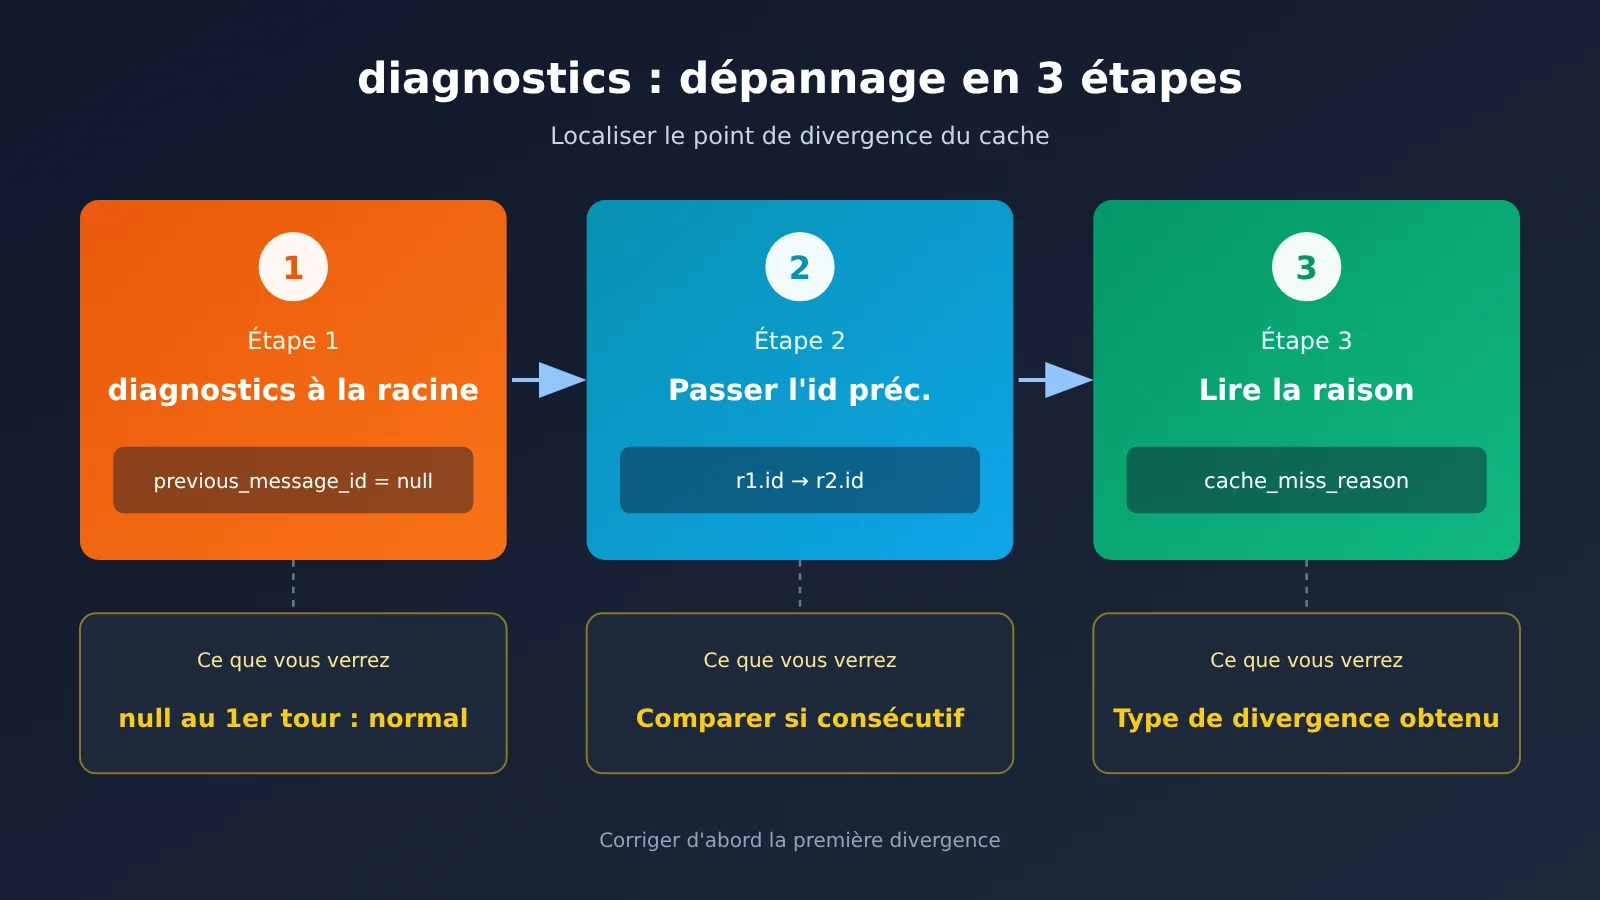
diagnostics est le seul interrupteur : une requête sans cet objet n’enregistre pas d’empreinte, et il n’y aura donc rien à comparer ensuite. Au premier tour, il n’y a rien à comparer, donc on passe null à previous_message_id, ce qui signifie « commencer l’enregistrement à partir de ce tour ».
- Conservez l’en-tête de version habituel :
anthropic-version: 2023-06-01 - Plus besoin de l’en-tête suivant après la version stable :
anthropic-beta: cache-diagnosis-2026-04-07 - Ajoutez au niveau racine du corps de requête :
"diagnostics": {"previous_message_id": null} - Le bloc
systemà mettre en cache garde son point d’ancrage habituel :"cache_control": {"type": "ephemeral"} - Ce que vous verrez : dans la réponse,
diagnosticsvautnull,cache_read_input_tokensest généralement à 0, etcache_creation_input_tokensest supérieur à 0
Voir null au premier tour ne signifie pas un échec. Ce tour sert à écrire le cache : il n’y a par définition pas de tour précédent à comparer, donc inutile de chercher une erreur.
Étape 2 : transmettre l’id de la réponse précédente à chaque tour suivant
À partir du deuxième tour, mettez l’id de la réponse du tour précédent dans previous_message_id. L’erreur la plus fréquente consiste à ne fournir diagnostics qu’au premier tour, puis à l’oublier ensuite. Du coup, la requête vers laquelle pointe le tour suivant n’a pas été enregistrée, et vous recevez previous_message_not_found en retour.
- Corps de la requête du deuxième tour :
"diagnostics": {"previous_message_id": "<id de la réponse du premier tour>"} - Corps de la requête du troisième tour :
"diagnostics": {"previous_message_id": "<id de la réponse du deuxième tour>"} - La règle de la boucle multi-tours :
nullau premier tour,r1.idau deuxième,r2.idau troisième, et ainsi de suite - En appel streaming, le résultat apparaît dans l’événement
message_start, et l’id se transmet là aussi de tour en tour - Ce que vous allez voir : lorsque deux tours consécutifs sont suffisamment rapprochés et se trouvent dans le même workspace, des résultats de comparaison commencent à apparaître dans la réponse
Étape 3 : lire cache_miss_reason et corriger en conséquence
diagnostics peut prendre trois formes ; il faut les distinguer avant de lire :
null: la requête ne contient pasdiagnostics, ouprevious_message_idvautnull, ou bien la comparaison est terminée et aucune divergence n’a été détectée{"cache_miss_reason": null}: la comparaison est encore en cours ; comme la réponse a démarré trop vite, ce tour ne tire pas de conclusion, passez au suivantcache_miss_reasonest un objet : la conclusion est là, avec le type de bifurcation et les détails- Ce que vous allez voir : une fois le type récupéré, corrigez selon la table de correspondance de la section suivante, en commençant par la bifurcation la plus ancienne, car seul le premier point de divergence est signalé — les problèmes suivants peuvent être masqués par celui-là
🚀 Démarrage rapide : si vous voulez d’abord vérifier que votre préfixe de cache peut bien être écrit et récupéré, vous pouvez passer par APIYI apiyi.com, utiliser la même clé API pour basculer entre les différents modèles Claude et faire deux tours de comparaison — regardez surtout si les deux chiffres d’écriture et de lecture du cache dans
usageconcordent.
Les six types de cache_miss_reason et où corriger
Une fois que vous avez récupéré cache_miss_reason, reportez-vous au tableau ci-dessous pour savoir où intervenir :
| Type | Signification | Où corriger |
|---|---|---|
model_changed |
Le modèle diffère de celui du tour précédent : un routage, un test A/B ou un fallback a changé de modèle. Le cache est isolé par modèle | Fixez le modèle sur toute la durée d’une même conversation mise en cache |
system_changed |
Le system a changé ; le cas le plus fréquent est l’insertion d’un timestamp, d’un ID de requête ou d’une autre valeur différente à chaque fois | Transformez le system en constante stable octet par octet, et déplacez les données dynamiques dans le premier message user qui suit le point de rupture |
tools_changed |
Des outils ont été ajoutés, supprimés ou réordonnés, ou bien la sérialisation de input_schema n’est pas stable |
Envoyez la même liste d’outils à chaque tour, avec un ordre fixe et une sérialisation triée par clé |
messages_changed |
Des messages antérieurs ont été modifiés, réordonnés ou supprimés, au lieu d’un simple ajout en fin de liste | L’historique ne fait que s’allonger ; renvoyez le contenu assistant et les résultats d’outils tels quels |
previous_message_not_found |
Impossible de retrouver l’empreinte correspondante, ce qui ne signifie pas que la requête a changé | Incluez diagnostics à chaque tour, ne changez pas de workspace, et n’espacez pas trop les tours |
unavailable |
Impossible d’obtenir le résultat du diagnostic pour ce tour : par exemple tool_choice, thinking, context_management, output_config, output_format ou l’ensemble des beta headers ne sont pas cohérents, ou bien la conversation est trop longue |
Sur tout le cycle de vie d’une conversation mise en cache, ces paramètres doivent rester identiques |
Les quatre types *_changed sont en outre accompagnés de cache_missed_input_tokens, qui indique à peu près combien de tokens d’entrée cachables ont été perdus après le point de divergence. Ce nombre est calculé à partir de la longueur en octets : il ne sert qu’à évaluer l’ordre de grandeur, ce n’est pas un montant de facturation, et il peut même parfois dépasser usage.input_tokens.
Se fier uniquement à diagnostics mène à une erreur de jugement : croiser avec usage pour évaluer le cache Claude
diagnostics répond à la question « ma requête a-t-elle changé ? », tandis que usage.cache_read_input_tokens répond à « le cache a-t-il été touché ? ». Ce sont deux questions différentes : n’en regarder qu’une seule conduit facilement à une conclusion erronée.
| Résultat diagnostics | Tokens lus du cache | Conclusion | Que faire |
|---|---|---|---|
null |
Élevé | Préfixe stable, cache touché | Rien à faire |
null |
Faible ou 0 | La requête n’a pas changé, mais le cache a expiré | Raccourcir l’intervalle entre les requêtes, ou passer à un TTL d’une heure |
*_changed |
Faible | La requête a changé, d’où l’absence de hit | Corriger en suivant le tableau de la section précédente |
*_changed |
Élevé | Le changement se situe plus loin dans la requête, les points de rupture précédents sont toujours touchés | Ça vaut le coup de corriger, mais l’impact reste limité |
Il faut le répéter : null ne veut pas dire que ça n’a pas fonctionné — c’est parfois le meilleur résultat possible. Ce tableau ne s’applique pas non plus dans quelques cas : au premier tour, quand cache_miss_reason vaut null (la comparaison est encore en cours), ainsi que pour previous_message_not_found et unavailable. Dans ces situations, aucune comparaison valable n’a été produite.
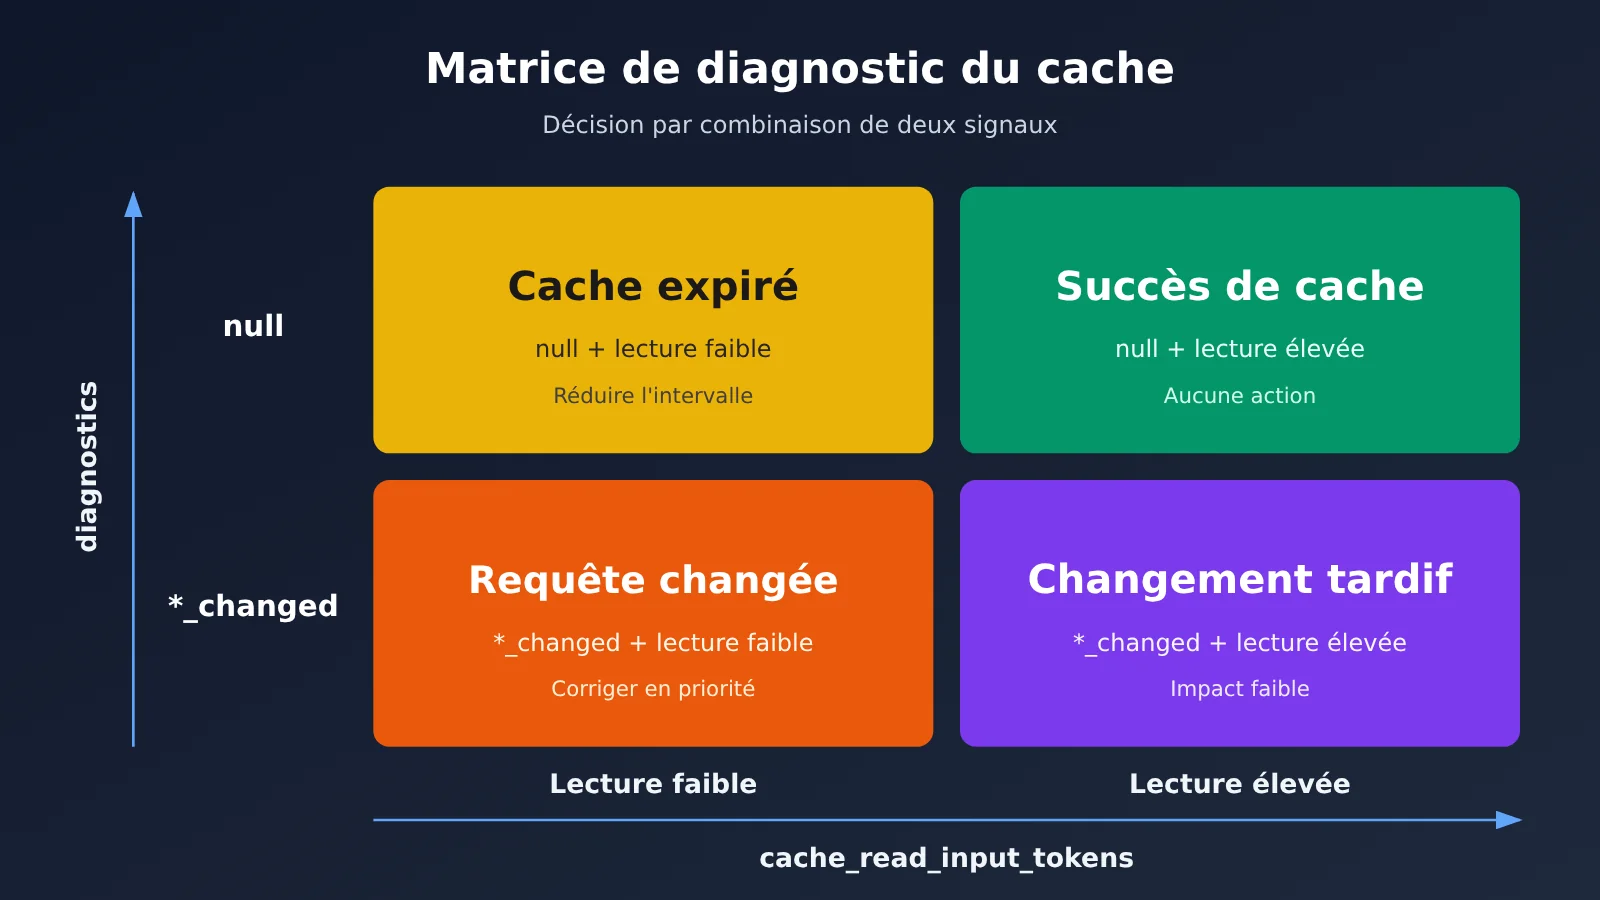
Si vous n’êtes pas encore sûr du tour qui correspond à telle ou telle case, vous pouvez envoyer deux fois la même requête sur APIYI apiyi.com, noter à chaque tour les chiffres de lecture et d’écriture du cache, puis éliminer les possibilités une à une avec la matrice ci-dessus.
Causes fréquentes d’un faible taux de réussite du cache Claude : trois conditions strictes
Bien souvent, un taux de réussite bas ne vient pas du fait que la requête a changé, mais du fait que le cache n’a jamais été écrit dès le départ. Il manque l’une de ces trois conditions, et le cache ne s’active pas :
- Il faut poser
cache_controlexplicitement : soit sur un bloc de contenu précis pour créer un point de rupture explicite, soit au niveau supérieur de la requête, et le système placera alors automatiquement le point de rupture sur le dernier bloc cachable. Sicontentest une simple chaîne, sans bloc de contenu auquel accrocher le marqueur, il n’y aura jamais de cache. - Atteindre la longueur minimale cachable : sur l’API Claude, Sonnet 5.5 comme Opus 5.5, c’est 512 tokens. En dessous, le cache est ignoré en silence, sans la moindre erreur.
- Un préfixe identique octet par octet : l’historique ne fait que s’allonger,
systemettoolsrestent stables. Un espace, l’ordre des champs JSON, un timestamp — il suffit d’un seul changement pour que tout soit traité comme un nouveau préfixe.
La documentation du cache d’APIYI ajoute deux limites strictes : au maximum 4 points de rupture cache_control par requête, et chaque point de rupture ne remonte que sur les 20 derniers blocs de contenu. Dans une longue conversation multi-tours, poser le marqueur uniquement sur le dernier message ne permet donc pas de couvrir tout l’historique.
Le TTL est lui aussi souvent oublié. Par défaut, il est de 5 minutes, et chaque succès le renouvelle, mais le décompte part de la requête d’écriture ou de lecture, pas de la fin de la réponse. Si une réponse en streaming met 4 minutes à sortir, la requête suivante doit partir dans la minute environ. Besoin d’une fenêtre plus longue ? Il suffit d’écrire "ttl": "1h" dans cache_control.
Quand le taux de hit du cache Claude tombe à 0 : la facture
Commençons par les prix, en dollars par million de tokens, relevés le 25 octobre 2026. Les prix en temps réel de la console font foi :
| Modèle | Entrée | Sortie | Lecture du cache | Écriture 5 minutes | Écriture 1 heure |
|---|---|---|---|---|---|
| Claude Sonnet 5.5 | $2 | $10 | $0,10 | $2,50 | $4 |
| Claude Opus 5.5 | $4 | $20 | $0,20 | $5 | $8 |
| Claude Haiku 5.5 (moins de 100 000 tokens) | $0,1 | $0,5 | $0,01 | $0,125 | $0,20 |
| Claude Haiku 5.5 (plus de 100 000 tokens) | $0,50 | $2,50 | $0,05 | $0,625 | $1 |
Les multiplicateurs doivent être lus séparément. Le guide du cache d’APIYI donne la règle générale : hit à 0,1×, écriture 5 minutes à 1,25×, écriture 1 heure à 2×. Sonnet 5.5 a suivi l’ajustement officiel le 7 octobre : la lecture du cache est passée de $0,20 à $0,10, soit 0,05× le prix d’entrée de base ; le prix d’écriture n’a pas changé.
Cet ajustement n’est pas une baisse générale : la lecture du cache de Sonnet 5 reste à $0,20. Donc ne prenez pas 0,1× pour calculer Sonnet 5.5 ; pour le modèle et le prix exacts, référez-vous à la liste des modèles de la plateforme.
Le seuil de rentabilité se calcule avec la règle générale de 0,1× de la plateforme : avec un TTL de 5 minutes, deux réutilisations suffisent à rentabiliser (1,25 + 0,1 = 1,35, moins que 2,0 sans cache) ; avec un TTL d’une heure, il faut trois réutilisations (2 + 0,2 = 2,2, moins que 3,0).
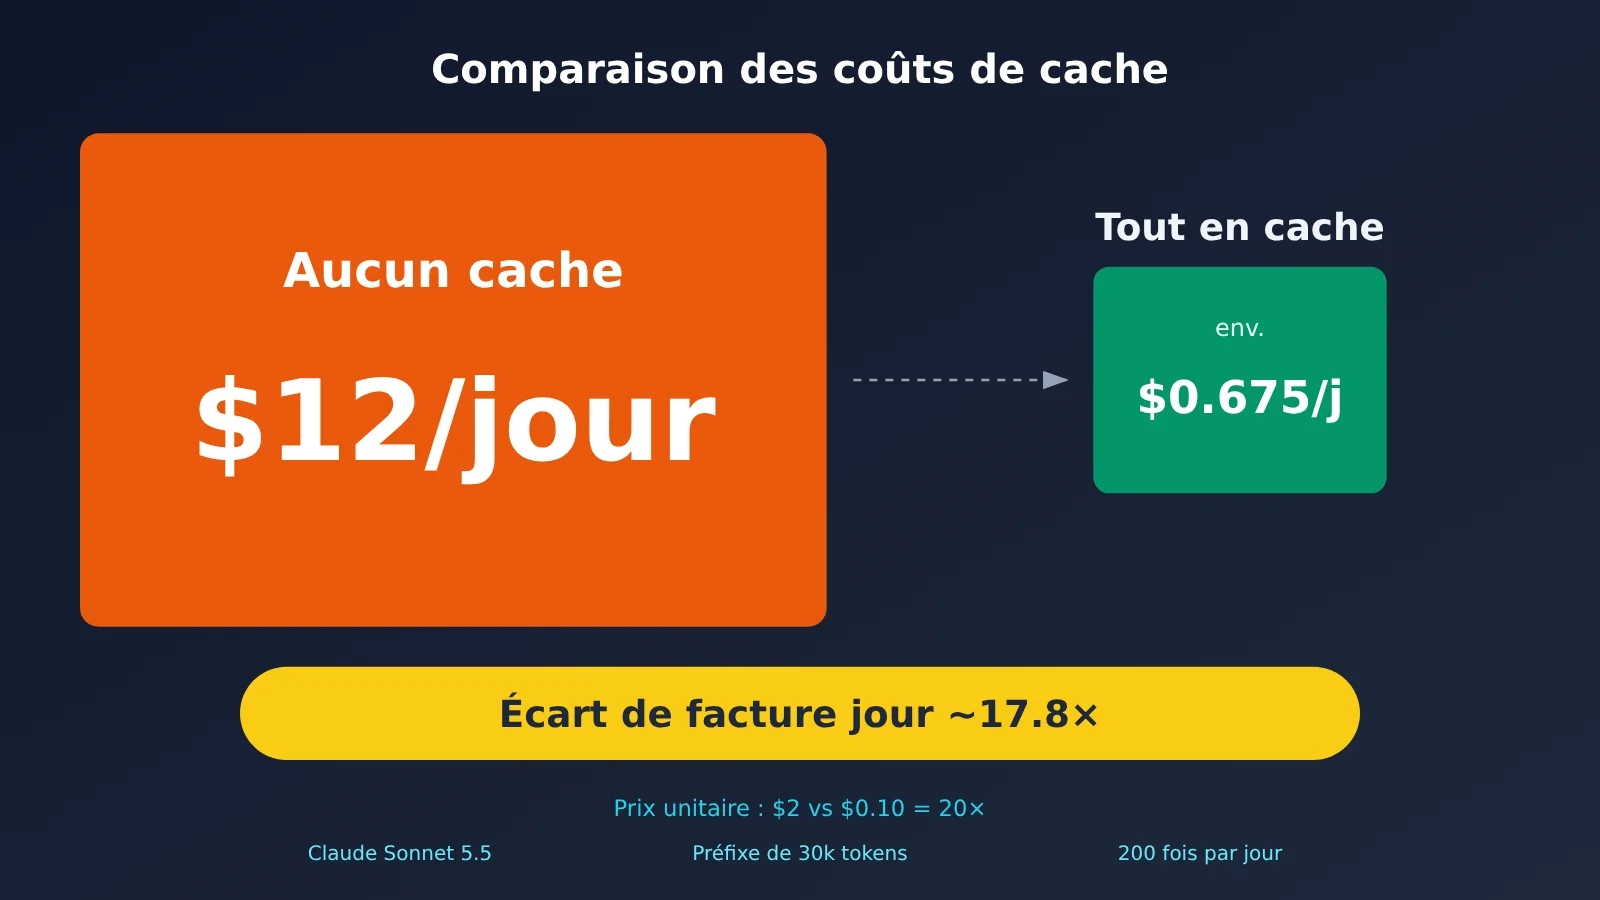
Prenons un exemple de calcul. Sonnet 5.5, préfixe fixe de 30 000 tokens, 200 requêtes par jour, toutes dans le TTL de 5 minutes :
- Tout en hit : 200 × 30 000 × $0,10/million = $0,60, plus une écriture de $0,075, soit environ $0,675/jour
- Aucun hit : 200 × 30 000 × $2/million = $12/jour
Entre les deux, la facture journalière diffère d’environ 17,8 fois ; ce n’est pas la différence de prix unitaire. Le prix unitaire est de $2 contre $0,10, soit 20 fois. Si l’on passe à un TTL d’une heure, une écriture coûte $0,12, et le prix du hit ne change pas. Quand les intervalles entre requêtes dépassent souvent 5 minutes, comparez : ce surcoût d’écriture est-il plus faible que le coût de reconstruire le préfixe à répétition ?
Comment diagnostiquer le taux de hits du cache de Claude via APIYI
Commençons par les résultats des tests. Le 2026-10-26, nous avons testé sur APIYI avec Claude Sonnet 5.5 sur deux tours : au premier tour, 2523 tokens écrits dans le cache, 0 lu ; au second tour, après renvoi à l’identique, 2523 tokens lus dans le cache, 0 écrit, et le nombre de tokens correspond parfaitement. Avec Claude Opus 5.5, un long préfixe permet également d’écrire dans le cache et d’obtenir des hits.
Mais la réponse ne contient pas de champ diagnostics. Absent en appel non streaming, absent aussi dans le message_start des appels en streaming. Nous avons renvoyé une requête avec l’en-tête beta, et avons même modifié volontairement le system pour provoquer un véritable miss de cache (lecture 0, écriture 2526) : le champ n’apparaissait toujours pas dans la réponse. Toutes les requêtes ont renvoyé 200, sans erreur. Le canal amont de la couche proxy n’est pas forcément l’API Claude officielle ; dans un contexte de proxy, on se base donc surtout sur la comparaison des deux champs dans usage.
| Symptôme à vérifier | Explication |
|---|---|
cache_read_input_tokens de ce tour est exactement égal à cache_creation_input_tokens du tour précédent |
Hit complet sur le préfixe |
| La lecture de ce tour est nettement inférieure à l’écriture du tour précédent | Seul un segment plus ancien a été touché ; un contenu au milieu a changé |
| L’écriture reste à 0 | Pas de marqueur, longueur insuffisante, ou format compatible OpenAI utilisé |
| Le deuxième tour écrit à nouveau, alors que la lecture est à 0 | Le préfixe a changé ; vérifiez les horodatages, les UUID et l’ordre de sérialisation |
Autre point important : le cache ne fonctionne qu’avec l’endpoint natif /v1/messages. Si vous appelez Claude au format compatible OpenAI via /v1/chat/completions, vous n’obtiendrez jamais la facturation du cache, quels que soient les paramètres.
💡 Conseil de diagnostic : APIYI (apiyi.com) transmet
cache_controltel quel à l’upstream, et renvoie aussi tels quels les deux champs de cache dans la réponse. Votre code n’a pas besoin d’adaptation supplémentaire pour la couche proxy. En transformant « lecture de ce tour = écriture du tour précédent » en alerte dans les logs, vous remplacez la majeure partie des vérifications manuelles.
Limites du diagnostic de cache Claude
Le diagnostics ne résout pas tout. Avant de l’utiliser, il faut connaître ses limites :
- Il n’est disponible que sur l’API Claude officielle. Les versions de Claude hébergées sur Amazon Bedrock et Google Cloud n’en bénéficient pas.
- Les empreintes ne sont conservées que peu de temps : il faut enchaîner plusieurs tours de requêtes avec un intervalle court.
- Les deux requêtes doivent appartenir à la même organisation et au même workspace, ce que l’on peut vérifier avec l’en-tête de réponse
anthropic-workspace-id. - Dans les longues conversations, si le changement se cache dans les profondeurs de la liste des messages, la réponse peut se limiter à
unavailable. - C’est un mécanisme best-effort : l’absence de résultat ne bloque pas la requête et ne la fait pas échouer.
FAQ
Q1 : Pourquoi diagnostics reste-t-il toujours à null ?
Trois cas possibles : l’objet `diagnostics` n’a pas été fourni ; on est au premier tour et `previous_message_id` vaut `null` ; ou la comparaison est terminée sans divergence. Il faut croiser cela avec les chiffres de cache : un chiffre élevé signifie que tout va bien, un chiffre à 0 indique le plus souvent un cache expiré. Si vous passez par un service proxy, le champ peut tout simplement ne pas être renvoyé ; dans ce cas, utilisez plutôt l’auto-vérification via les données usage.
Q2 : previous_message_not_found signifie-t-il que la requête a changé ?
Non. Cela indique seulement que l’empreinte correspondante est introuvable. Trois causes fréquentes : le tour précédent n’avait pas de `diagnostics`, il provenait d’un autre workspace, ou l’intervalle était trop long. Il suffit d’inclure `diagnostics` à chaque tour et de raccourcir l’intervalle.
Q3 : Le diagnostic entraîne-t-il des frais supplémentaires ?
La documentation officielle ne liste pas de « frais de diagnostic » à part : ils sont facturés avec la requête Messages classique. La documentation ne précise pas non plus qu’il n’y a pas de surcoût, donc pour la facturation, fiez-vous à votre facture et à la console.
Q4 : Peut-on encore utiliser ce diagnostic via un service proxy ?
Dans nos tests sur APIYI, nous n’avons pas obtenu le champ `diagnostics`, mais l’écriture et la lecture en cache fonctionnaient normalement. On peut alors vérifier que « la lecture de ce tour est exactement égale à l’écriture du tour précédent » ; pour l’intégration, voir la documentation sur la facturation du cache sur APIYI apiyi.com.
Q5 : J’ai mis cache_control, pourquoi rien n’a jamais été écrit en cache ?
Vérifiez d’abord trois points : le content est-il une simple chaîne de caractères ? Le préfixe atteint-il 512 tokens (Sonnet 5.5 et Opus 5.5) ? Passez-vous par le format compatible OpenAI ? Si l’un des trois n’est pas rempli, la mise en cache est ignorée silencieusement.
Q6 : Plusieurs problèmes apparaissent en même temps, lequel corriger en premier ?
Corrigez d’abord celui signalé par `cache_miss_reason`. Il ne rapporte que le premier point de divergence ; une fois corrigé, relancez un tour et les problèmes masqués derrière apparaîtront. En rejouant la même requête plusieurs fois sur APIYI apiyi.com, on peut les éliminer un par un assez rapidement.
Points clés du diagnostic de cache Claude
- Ce que sont les diagnostics : transmettez l’id de la réponse du tour précédent pour localiser le premier point de divergence du préfixe
- Comment l’activer : ajoutez
diagnosticsau niveau supérieur, passeznullau premier tour, puis à chaque tour suivant - Signification de
null: c’est aussinullau premier tour ou en l’absence de divergence, à ne pas interpréter seul comme un signal de panne - Comment juger : il faut croiser les diagnostics avec
cache_read_input_tokenspour pouvoir conclure - Conditions strictes : marquage explicite, atteindre 512 tokens, préfixe identique octet par octet
- Écart de coût : un préfixe de 30 000 tokens sur 200 appels par jour, la facture journalière varie d’environ 17,8 fois
- Auto-vérification via proxy : sur APIYI apiyi.com, vérifiez si « la lecture de ce tour égale l’écriture du tour précédent »
En résumé
Le diagnostic du taux de réussite du cache Claude se résume en trois points :
- Localiser la divergence : transmettez
diagnosticsà chaque tour, lisezcache_miss_reason, et corrigez d’abord la première occurrence signalée - Juger en croisant : regardez à la fois les diagnostics et l’usage ;
nullne signifie pas que ça n’a pas fonctionné - Respecter les conditions strictes : marquez correctement, atteignez la longueur requise, ne faites qu’ajouter à l’historique, gardez
systemettoolsstables
Si votre chaîne d’appels ne peut pas récupérer les diagnostics, utilisez les deux champs de l’usage pour mettre en place une auto-vérification. Je recommande de valider d’abord les chiffres de lecture/écriture du cache avec deux requêtes sur APIYI apiyi.com, avant de passer en production.
📚 Références
- Documentation officielle Claude : Cache diagnostics : champs de diagnostic, six types et matrice de décision
- Lien :
platform.claude.com -
Description : les champs, la chronologie et les limites des diagnostics de cet article s’appuient sur cette documentation.
-
Documentation officielle Claude : Prompt caching : règles de cache, TTL, longueur minimale et tarifs
- Lien :
platform.claude.com -
Description : source de la longueur minimale cachable et du tableau tarifaire officiel.
-
Liste des modèles APIYI : prix d’entrée, de sortie et de lecture du cache pour chaque modèle Claude
- Lien :
docs.apiyi.com/models -
Description : données tarifaires mises à jour le 2026-10-25.
-
Guide de facturation du cache Claude Prompt Caching chez APIYI : multiplicateurs, seuil de rentabilité et critères d’auto-contrôle
- Lien :
docs.apiyi.com/api-capabilities/claude-prompt-caching - Description : base de dépannage dans le contexte d’un service proxy API.
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI. Vous trouverez davantage de ressources dans le centre de documentation docs.apiyi.com.