Note de l’auteur : répondons à une question fréquente sur la facturation. Même si les tarifs affichés des modèles ont chuté à vue d’œil ces derniers mois, les agents de développement restent étonnamment coûteux pour les mêmes raisons. Les prix mentionnés ici ont été vérifiés le 26/10/2026 d’après les grilles tarifaires officielles disponibles et la page des tarifs d’APIYI. Le chiffre de 96 % est une estimation d’un auteur tiers et non une mesure issue de nos propres bancs d’essai.
Du 26 juin au 29 septembre 2026, sur une période d’environ quatre mois, OpenAI et Anthropic se sont livré une véritable guerre des prix. Le 25 octobre 2026, Max Woolf a retracé cette chronologie sur minimaxir.com/2026/10/cheap-llms, affichant des baisses allant jusqu’à 80 % dans son titre. Il y explique notamment que, pour un agent de programmation, la lecture de cache (cache read) représente entre 96 % et 99 % des dépenses totales en tokens. La raison ? À chaque itération, l’historique complet de la conversation est relu directement depuis le cache, avec un taux de succès (hit rate) oscillant entre 90 % et 100 % selon le fournisseur d’inférence. L’article d’origine ne fournissant pas de journaux de requêtes vérifiables, nous considérons cette affirmation comme une estimation externe à ne pas substituer à vos propres métriques de consommation.
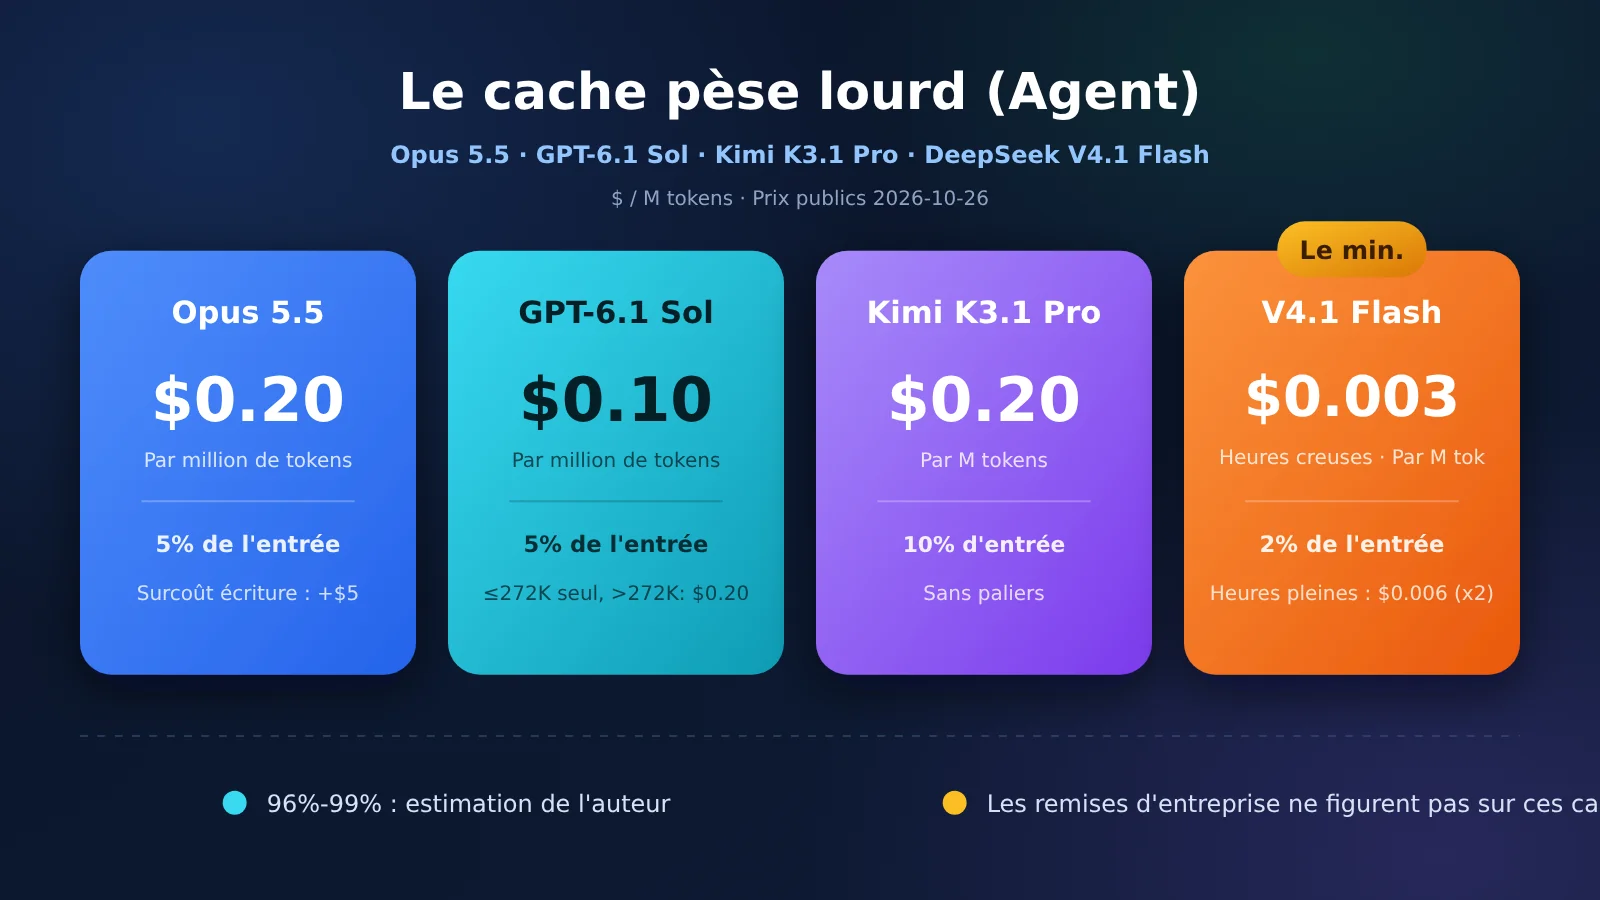
Sur cette même période, les tarifs publics de lecture de cache que l’on peut encore vérifier sur les grilles officielles sont les suivants : Claude Opus 5.5 à 0,20 $, GPT-6.1 Sol à 0,10 $ (pour un contexte d’entrée inférieur ou égal à 272k tokens), Kimi K3.1 Pro à 0,20 $, et DeepSeek V4.1 Flash à 0,003 $ en heures creuses contre 0,006 $ en heures de pointe. Tous les prix s’entendent en dollars américains par million de tokens ($/M tokens).
Ce n’est pas un tableau de compromis où chaque option se vaut. Pour une boucle de développement au préfixe stable et dont le contexte reste sous les 272k tokens, regardez en priorité le coût de lecture de cache de GPT-6.1 Sol parmi les trois modèles propriétaires. Si vous cherchez à descendre d’un ordre de grandeur supplémentaire, visez la lecture de cache de DeepSeek en heures creuses. De leur côté, Opus 5.5 et Kimi partagent le même tarif de lecture en cache : la différence se jouera sur les requêtes non mises en cache (cache misses), les tokens de sortie et le surcoût d’écriture.
L’essentiel à retenir : après cette lecture, vous saurez choisir votre modèle en fonction du taux d’accès au cache plutôt que du simple prix d’entrée, tout en comprenant pourquoi les remises grands comptes vantées dans la presse ne correspondent jamais aux factures des petites équipes.
💡 Notre conseil : vous pouvez tester ces quatre options directement sur APIYI (apiyi.com) avec une seule clé API en changeant simplement le nom du modèle. Les nouveaux comptes disposent de crédits de test offerts. Pensez à stabiliser votre préfixe avant d’analyser vos métriques de lecture en cache, et évitez de tirer des conclusions hâtives sur un simple échange court.
Quelles sont les différences de prix pour la lecture du cache entre ces quatre fournisseurs ?
Regardons d’abord le prix de la lecture du cache (cache read), puis la proportion qu’il représente par rapport au tarif d’entrée sans cache (cache miss). C’est ce ratio qui détermine à quel point cette colonne devient avantageuse lors des longues sessions. Pour Opus 5.5 et GPT-6.1 Sol en contexte court, la lecture du cache ne coûte que 5 % du prix d’entrée standard ; elle s’élève à 10 % pour Kimi K3.1 Pro et tombe à seulement 2 % pour DeepSeek V4.1 Flash. En valeur absolue, l’écart est encore plus spectaculaire : à 0,003 $ en heures creuses, Flash coûte 33 fois moins cher que GPT-6.1 Sol en contexte court (0,10 $), et 67 fois moins cher que les modèles facturés à 0,20 $.
| Modèle | Lecture du cache | % de l’entrée sans cache | Entrée sans cache | Sortie |
|---|---|---|---|---|
| Claude Opus 5.5 | 0,20 $ | 5 % | 4 $ | 20 $ |
| GPT-6.1 Sol, entrée ≤ 272K | 0,10 $ | 5 % | 2 $ | 10 $ |
| GPT-6.1 Sol, entrée > 272K | 0,20 $ | 5 % | 4 $ | 15 $ |
| Kimi K3.1 Pro | 0,20 $ | 10 % | 2 $ | 10 $ |
| DeepSeek V4.1 Flash (heures creuses) | 0,003 $ | 2 % | 0,15 $ | 0,60 $ |
| DeepSeek V4.1 Flash (heures pleines) | 0,006 $ | 2 % | 0,30 $ | 1,20 $ |
Tous les tarifs sont indiqués en dollars par million de tokens, pour le niveau de service standard (hors API Batch, modes Fast ou majorations régionales). Pour Opus 5.5, les chiffres proviennent de la grille tarifaire d’Anthropic, où le cache hit est facturé 0,05 fois le prix d’entrée. GPT-6.1 Sol correspond aux tarifs officiels d’OpenAI : le palier « contexte court » s’applique aux requêtes dont l’entrée ne dépasse pas 272 000 tokens. Au-delà, la lecture du cache, l’entrée et la sortie basculent ensemble au palier supérieur (la sortie passe alors à 15 $ et non 20 $). Les tarifs de Kimi sont tirés de la documentation publique de Moonshot, sans variation selon la taille du contexte. Enfin, les données de DeepSeek proviennent de leur page officielle pour l’identifiant deepseek-flash (version DeepSeek-V4.1-Flash-1017). Les heures pleines s’appliquent du lundi au vendredi, de 01:00 à 04:00 UTC et de 06:00 à 10:00 UTC (soit 09:00–12:00 et 14:00–18:00 à l’heure de Pékin), hors jours fériés chinois. L’intervalle intermédiaire entre 12:00 et 14:00 reste en heures creuses, tout comme l’intégralité des week-ends et jours fériés chinois.
Sur la page des tarifs d’APIYI (docs.apiyi.com/models), dans le catalogue au 25 octobre 2026, claude-opus-5-5 est affiché à 4 $ / 20 $ / 0,20 $, gpt-6.1-sol à 2 $ / 10 $ / 0,10 $ (avec la mention précisant que l’entrée passe à 4 $ au-delà de 272 000 tokens) et kimi-k3.1-pro à 2 $ / 10 $ / 0,20 $. L’offre DeepSeek est découpée en deux lignes distinctes : deepseek-v4.1-flash et deepseek-flash sont à 0,30 $ / 1,20 $ / 0,006 $ (alignés sur le tarif officiel des heures pleines), tandis que deepseek-v4-1-flash-260910 s’affiche à 0,15 $ / 0,60 $ / 0,003 $ (heures creuses officielles). Alors que l’API officielle bascule automatiquement en fonction de l’horodatage de la requête, le catalogue d’APIYI a matérialisé ces deux barèmes sous forme de lignes de modèles distinctes. Pensez donc à vérifier le nom exact du modèle dans votre console avant chaque invocation du modèle.
Attention : la lecture du cache ne représente que la moitié de l’équation. C’est le tarif d’écriture dans le cache qui détermine si vous devrez payer un surcoût à chaque expiration de votre préfixe. Gardez aussi en tête que les paliers « courts » et « longs » du tableau suivant ne reposent pas sur les mêmes durées : le palier court d’OpenAI couvre déjà une fenêtre de 30 minutes, contre seulement 5 minutes pour Anthropic et Kimi.
| Modèle | Écriture courte durée | Écriture longue durée | Comment le préfixe entre en cache |
|---|---|---|---|
| Opus 5.5 | 5 min, 5 $, soit 1,25× l’entrée | 1 h, 8 $, soit 2× l’entrée | La requête doit inclure cache_control |
| GPT-6.1 Sol, ≤272K | 30 min, 2,50 $, soit 1,25× l’entrée | 12 h, 5 $, soit 2,5× l’entrée | Écriture listée séparément sur la grille tarifaire ; le préfixe doit être stable |
| Kimi K3.1 Pro | 5 min, 2 $, égal au prix d’entrée | 1 h, 4 $, estimé à 2× | Automatique par défaut, 5 min ; préciser 1 h pour un intervalle plus long |
| V4.1 Flash | Pas de tarif d’écriture séparé | Aucun | Première requête facturée comme échec de cache, les suivantes comme lecture de cache |
Sur la page d’accueil de Kimi, la carte indique un coût d’écriture en cache de 2 $, ce qui correspond au palier par défaut de 5 minutes. Le tarif de 4 $ pour le palier d’une heure provient de la configuration indiquée dans la documentation Kimi sur APIYI. Cette page précise toutefois que ce palier de cache n’a pas encore fait l’objet d’une vérification de facturation lors des tests actuels. Dans la documentation officielle de la génération précédente (Kimi K3), l’écriture pour 1 heure coûtait le double de celle de 5 minutes ; en appliquant le même ratio au K3.1 Pro, on obtient 4 $. En cas de divergence avec la console, fiez-vous toujours à la console. Pour la version haute vitesse kimi-k3.1-pro-highspeed, les tarifs d’entrée et de sortie doublent, mais la lecture de cache reste à 0,20 $. Lorsque le taux de réussite sur le préfixe est très élevé, l’écart entre les deux paliers a tendance à se réduire nettement.
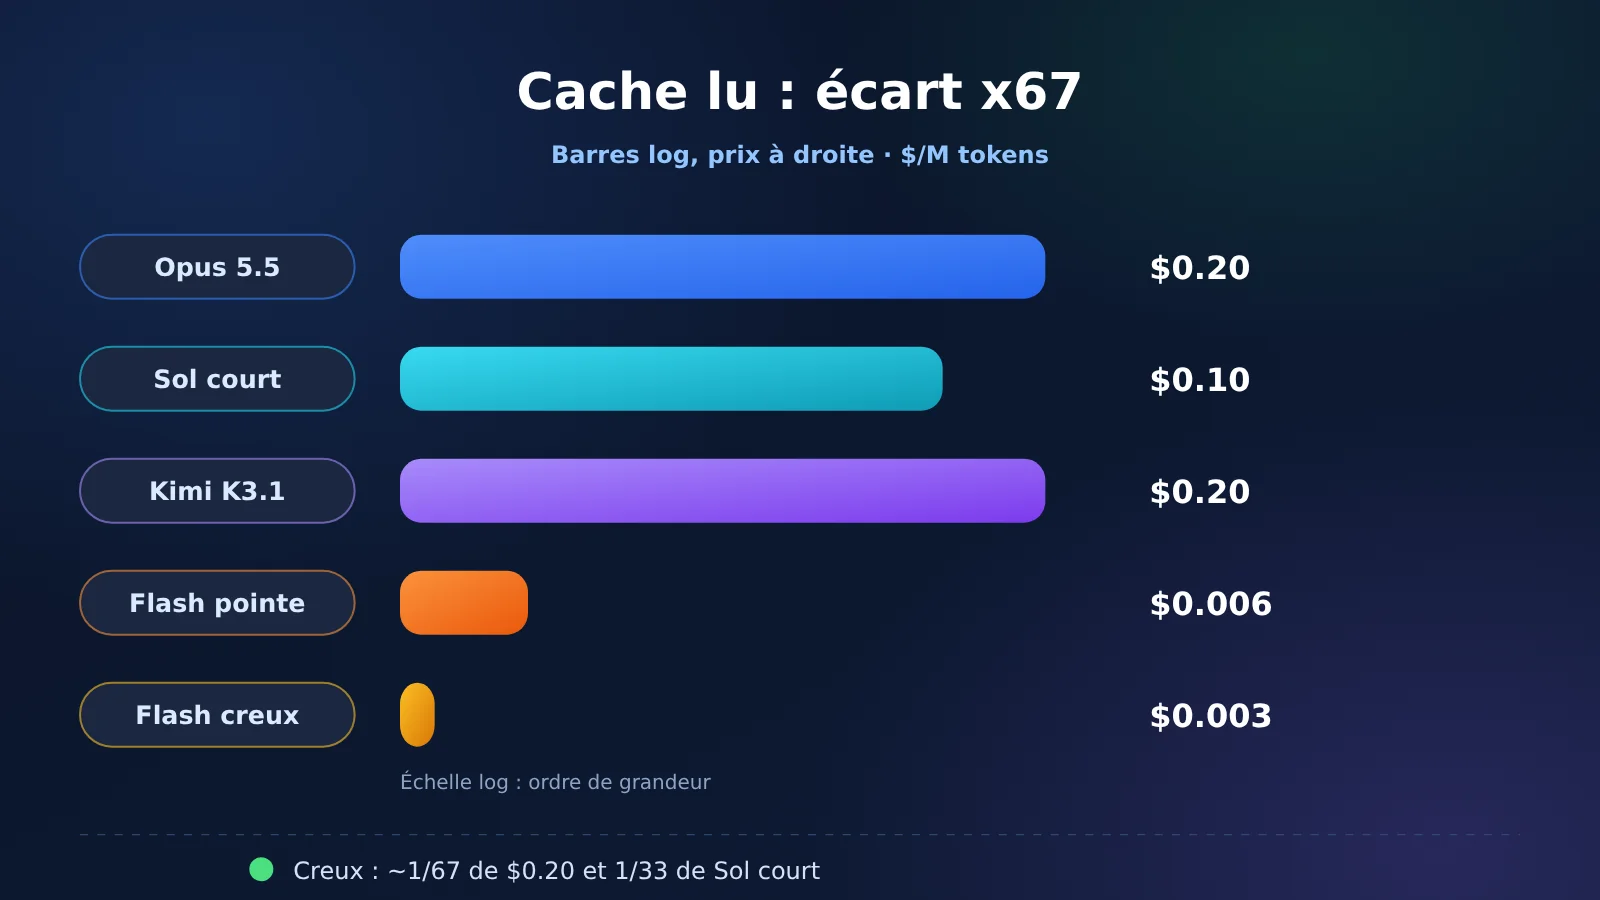
La longueur des barres sur le graphique sert uniquement à visualiser les ordres de grandeur. La facturation réelle s’effectue toujours en multipliant le prix d’origine par le nombre de tokens. Si vous changez de modèle avec la même clé API, référez-vous toujours à la colonne dédiée aux lectures de cache dans la console APIYI, et évitez d’utiliser ce graphique pour estimer vos montants réels.
Pourquoi la facture d’un agent de code doit-elle isoler la lecture de cache ?
À chaque tour d’échange, un agent renvoie l’invite système, les définitions d’outils et l’historique complet de la conversation. Toute la partie du préfixe qui n’a pas bougé a de bonnes chances d’être facturée au tarif de lecture de cache (cache read). En revanche, dès que le préfixe change, tout ce qui suit le point de modification est considéré comme un échec de cache (cache miss), et certains fournisseurs facturent même des frais d’écriture. Ainsi, une baisse de 20 % sur le prix des tokens d’entrée ne signifie absolument pas une réduction de 20 % sur la facture d’une session de code. Si la lecture de cache représente la part la plus massive de vos tokens, c’est cette colonne-là qu’il faut examiner en priorité.
Les 96 % à 99 % cités par Max Woolf font référence à la « dépense totale de tokens ». En anglais, le mot expenditure peut désigner une somme d’argent comme un volume brut de tokens, et l’article initial ne précisait pas le dénominateur. Une autre mesure tierce a posé clairement la méthode : selon une mise à jour de WorkloadBench datée du 16 octobre 2026, sur des tâches de code au long cours, 89 % à 96 % des tokens d’invite proviennent du cache. La médiane s’établit à 95 % pour GPT-6.1 Sol comme pour Claude Opus 5.5, avec des plages respectives de 91 %–98 % et 94 %–99 % (source : workloadbench.brenhq.com/cache). Il s’agit bien ici d’une part de tokens d’invite : le dénominateur n’intègre pas les tokens de sortie, et cela ne représente en rien une proportion en dollars. Impossible donc d’additionner ces données pour en déduire « 96 % de la facture ».
En dollars, la proportion est souvent bien inférieure, car le prix unitaire en sortie est des dizaines, voire des centaines de fois plus élevé que celui d’une lecture de cache. Recalculons cela avec un ensemble d’hypothèses explicites — simplement pour analyser la structure de coûts, et non pour refléter le décompte exact de l’auteur ou un log de test réel. Imaginons une session de 40 tours : chaque tour compte 120 000 tokens en lecture de cache, 1 500 nouveaux tokens en échec de cache (miss), 800 tokens de sortie, avec une écriture initiale unique de 40 000 tokens au démarrage de la session. Ces 40 000 tokens ne sont pas comptés à nouveau en échec de cache par la suite (DeepSeek ne facturant pas l’écriture, ces 40 000 tokens sont comptés comme un miss classique). Avec environ 120 000 tokens d’entrée par tour, on reste dans le palier de contexte court de Sol.
Le total s’élève à 4 932 000 tokens, dont 4 800 000 en lecture de cache, soit environ 97 %. Cela montre simplement qu’avec l’hypothèse « préfixe long, tours nombreux, sorties courtes par tour », le volume de tokens correspond bien aux ordres de grandeur rapportés par l’auteur.
| Modèle | Lecture de cache | Cache miss | Sortie | Écriture ou 1er miss | Total | Part du cache en $ |
|---|---|---|---|---|---|---|
| Opus 5.5, écriture 5 min | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | env. 47% |
| GPT-6.1 Sol, ≤272K, écriture 30 min | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | env. 47% |
| Kimi K3.1 Pro, écriture 5 min | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | env. 65% |
| V4.1 Flash (heures creuses) | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | env. 30% |
| V4.1 Flash (heures pleines) | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | env. 30% |
Entre Opus et Sol, les quatre tarifs unitaires en contexte court sont exactement dans un rapport de 2 pour 1 : leur répartition reste donc identique et le total est divisé par deux. Chez Kimi, la lecture du cache représente 10 % du prix d’entrée (au lieu de 5 %) ; avec la même structure de tokens, la lecture en cache pèse environ 65 % du total, soit 1,48 $, ce qui le place entre les deux. Flash tourne autour de 0,049 $ en heures creuses, et le double en heures pleines. Comme la lecture en cache ne coûte ici que 2 % d’un échec de cache (cache miss), dans ce scénario, c’est la génération de sortie qui représente la plus grosse part des coûts (environ 40 %), contre environ 30 % pour la lecture en cache. Parmi les trois modèles phares, la lecture en cache demeure le poste le plus lourd de cette simulation. Flash, quant à lui, réduit carrément l’ordre de grandeur de l’ensemble de la facture, plutôt que de simplement reproduire la même structure de coûts.
Si votre préfixe change à chaque échange, ce calcul ne tient plus. Un horodatage, une liste d’outils ordonnée aléatoirement ou un nom d’utilisateur inséré au milieu de l’invite système suffisent à faire sauter le cache. Dès lors, ce sont les tarifs de cache miss et d’écriture qu’il faut regarder. L’écriture pour 5 minutes sur Opus coûte 1,25 fois le prix d’entrée standard ; chez Sol, le palier de 30 minutes est aussi à 1,25x, et celui de 12 heures passe à 2,5x. Chez Kimi, l’écriture sur 5 minutes équivaut simplement au prix d’entrée normal, sans surcoût pour le palier court. Quant à DeepSeek, la première requête est tout simplement facturée au tarif sans cache.
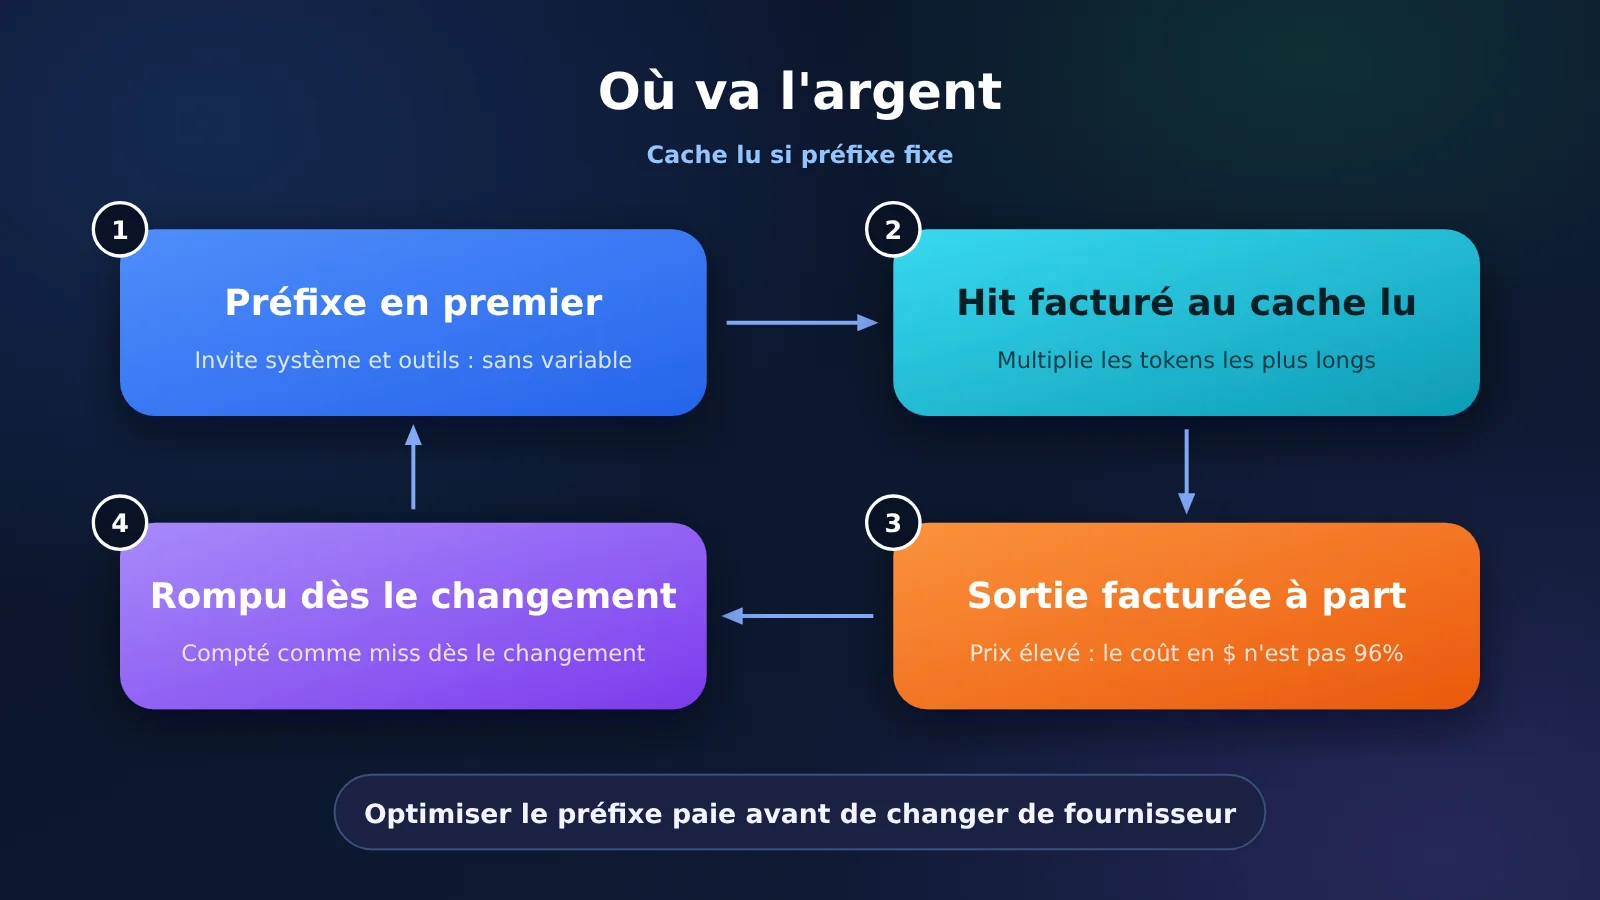
Optimiser ses préfixes est souvent bien plus rentable à court terme que de changer de fournisseur. Veillez à garder un ordre strictement stable pour votre liste d’outils, placez les contenus dynamiques à la toute fin des messages et assurez-vous que l’intervalle entre deux requêtes d’une même session ne dépasse pas le TTL court. Une fois ces optimisations en place, vous pourrez réellement choisir votre modèle en fonction du coût unitaire de lecture en cache.
Que nous apprend cette chronologie de baisses de prix sur quatre mois ?
L’affirmation d’une « baisse allant jusqu’à 80 % » correspond bien à deux cas précis, mais attention : cela ne signifie absolument pas que tous les modèles ont vu leurs prix réduits de 80 %. Le premier cas a été relevé par Max Woolf : le 30 juillet 2026, OpenAI a fait passer GPT-5.6 Luna de 1 $ / 6 $ / 0,10 $ à 0,20 $ / 1,20 $ / 0,02 $, soit une baisse d’environ 80 % sur les tokens d’entrée et la lecture de cache. Le second concerne la lecture de cache sur la gamme Sol : elle est passée de 0,50 $ pour GPT-5.6 Sol le 26 juin 2026 à 0,10 $ pour GPT-6.1 Sol le 29 septembre 2026, soit là aussi 80 % de moins. Notez toutefois qu’on est passé de la version 5.6 à la 6.1 ; il ne s’agit donc pas d’une simple réduction appliquée au même produit.
| Date | Évolution relevée | Entrée / Sortie / Lecture de cache |
|---|---|---|
| 2026-06-26 | OpenAI lance GPT-5.6 Sol et Luna | Sol : 5 $ / 30 $ / 0,50 $ |
| 2026-06-30 | Anthropic lance Sonnet 5, en précisant que le prix de lancement est temporaire | 2 $ / 10 $ / 0,20 $ |
| 2026-07-24 | Anthropic lance Opus 5 | 5 $ / 25 $ / 0,50 $ |
| 2026-07-30 | Baisse de prix pour GPT-5.6 Luna | 0,20 $ / 1,20 $ / 0,02 $ |
| 2026-08-21 | Baisse temporaire d’environ 20 % pour GPT-5.6 Sol (sur 3 mois) | 4 $ / 20 $ / 0,40 $ |
| 2026-09-01 | Fable 5.1, avec une lecture de cache moins chère que Fable 5 en juin | 10 $ / 50 $ / 0,25 $ |
| 2026-09-22 | Lancement le même jour de GPT-6 Sol et Opus 5.5 | Sol : 2 $ / 10 $ / 0,20 $ ; Opus 5.5 : 4 $ / 20 $ / 0,20 $ |
| 2026-09-29 | GPT-6.1 Sol, la lecture de cache est encore divisée par deux | 2 $ / 10 $ / 0,10 $ |
Le tableau ci-dessus est issu de la synthèse de Max Woolf, où les trois valeurs indiquent systématiquement l’entrée, la sortie et la lecture de cache. Nous avons vérifié les tarifs actuels des deux dernières lignes : les 4 $ / 20 $ / 0,20 $ d’Opus 5.5 correspondent parfaitement à la grille tarifaire d’Anthropic, et les 2 $ / 10 $ / 0,10 $ de GPT-6.1 Sol collent à l’offre standard d’OpenAI pour les contextes courts. Les lignes antérieures n’ont pas fait l’objet d’une vérification exhaustive dans les annonces officielles d’époque ; référez-vous à son article original si vous souhaitez vous appuyer dessus.
Il avance également qu’Opus 5.5 permettrait une réduction globale des coûts de 40 % à 60 %. Ce que la grille officielle permet d’attester, ce sont les tarifs unitaires : par rapport à Opus 5, l’entrée et la sortie baissent chacune de 20 % (de 5 $ à 4 $, et de 25 $ à 20 $), tandis que la lecture de cache passe de 0,50 $ à 0,20 $, soit une baisse de 60 %. Cette fourchette de 40 % à 60 % est donc une estimation basée sur un profil d’usage type, et non une réduction uniforme promise par l’éditeur. Anthropic a d’ailleurs précisé que l’inférence d’Opus 5.5 demandait moins de calcul que celle d’Opus 5, et que les prix reflétaient simplement cette réalité technique — une explication qui reste la communication officielle du fournisseur.
Il note enfin que DeepSeek V4.1 Flash tourne autour de 0,15 $ / 0,60 $ / 0,003 $ sur l’API officielle de DeepSeek. Ces chiffres correspondent aux heures creuses officielles ; en période de pointe, les tarifs doublent. Pour Kimi K3.1 Pro, il indique 2 $ / 10 $ / 0,20 $, ce qui est conforme à la fiche tarifaire du site officiel. Quant aux scores Artificial Analysis cités dans l’article (55 pour Kimi, 58 pour Opus 5.5 et 45 pour Flash), il s’agit d’indices tiers et non de nos propres benchmarks de programmation : ne basez pas votre sélection de modèle sur ces trois petits points d’écart.
Comment choisir ses modèles quand on n’a pas accès aux remises grands comptes ?
Au-delà des tarifs publics, il existe une grille de remises que seuls les très grands clients ont le privilège de voir. Le 24 octobre 2026, AI Weekly relayait une information de The Information : OpenAI aurait accordé plus de 30 % de réduction pour décrocher un contrat annuel dépassant les 100 millions de dollars, incitant Replit à transférer la majorité de ses dépenses en IA d’Anthropic vers OpenAI. L’article rapportait également qu’Anthropic n’avait pas souhaité reconduire la remise accordée jusque-là à Replit. Aucune des trois entreprises n’a confirmé publiquement ces chiffres. Lors de la conférence TechCrunch Disrupt, le PDG de Replit, Amjad Masad, a simplement expliqué que cette décision reposait sur des critères de coût, de partenariat et de performances. Le même article précise que les modèles Claude restent accessibles, mais qu’OpenAI est devenu l’option par défaut pour les Agents. Le texte mentionne également le cas de Rippling, qui a basculé son volume d’utilisation pour le code d’Anthropic vers OpenAI, justifiant ce choix par des raisons budgétaires. Tout cela reste des échos de presse, et non une grille tarifaire officielle signée conjointement.
Pour une petite équipe, ce type de contrat est hors de portée. Sans un engagement annuel de 100 millions de dollars, impossible d’obtenir les 30 % évoqués dans la presse. Et même en appliquant bêtement ces 30 % sur la lecture de cache d’Opus, passer de 0,20 $ à 0,14 $ reste plus cher que le tarif public de GPT-6.1 Sol sur contexte court, fixé à 0,10 $. L’article ne précise pas si la remise portait sur la lecture de cache, sur les requêtes non mises en cache ou sur la facture globale, mais cette comparaison donne un ordre de grandeur : les tarifs publics de lecture de cache suffisent amplement pour faire un premier arbitrage au sein d’une petite structure.
| Profil de session | Option à privilégier | Raison |
|---|---|---|
| Préfixe stable, entrée généralement inférieure à 272K, besoin d’un modèle de code propriétaire | GPT-6.1 Sol | Lecture de cache à 0,10 $, le prix le plus bas parmi les trois |
| Entrée unitaire dépassant 272K | Ne comptez plus sur les 0,10 $ | Sur Sol, la lecture de cache grimpe à 0,20 $ et la sortie monte à 15 $ |
| Même budget de lecture de cache qu’Opus, mais volonté de réduire le coût des échecs de cache et de sortie | Kimi K3.1 Pro | Lecture de cache identique à 0,20 $, mais entrée/sortie à 2 $ / 10 $, sans paliers tarifaires |
| Taux de cache hit élevé, tâches pouvant être décalées hors heures de pointe | DeepSeek V4.1 Flash (heures creuses) | Lecture de cache à 0,003 $, la facture change carrément d’ordre de grandeur |
| Contrainte stricte sur les heures de bureau (9h-12h, 14h-18h, heure de Pékin) | Recalculer Flash au tarif plein | Lecture de cache à 0,006 $, et les autres prix unitaires doublent également |
| Le préfixe change à chaque tour | Travaillez d’abord sur votre invite | Inutile de regarder la colonne lecture de cache |
Ce tableau ne classe pas les modèles par capacités brutes. Max Woolf considère par exemple qu’Opus 5.5 est plus performant que le très coûteux Fable 5.1 — c’est son retour d’expérience personnel. De son côté, DeepSeek indique explicitement dans sa documentation que deepseek-flash pointe désormais vers DeepSeek-V4.1-Flash-1017, que l’ancien identifiant deepseek-v4-flash reste actif et facturé au tarif Flash, tandis que deepseek-v4-pro continue d’être proposé séparément. L’éditeur ne fournit aucune hiérarchie officielle entre Flash et Pro. Lorsque le coût d’un échec dépasse l’écart de prix en tokens, orientez-vous vers le modèle le plus cher. Quand le coût d’un échec est dérisoire face à la différence de tarif, laissez Flash faire tourner vos boucles.
💰 Optimisation des coûts : Le prix catalogue est le tarif affiché par défaut. La console d’APIYI (apiyi.com) applique directement le tarif remisé selon votre groupe, sans compter les promotions sur les recharges détaillées sur la page des tarifs. Il s’agit de règles publiques et transparentes, pas d’un accord-cadre annuel négocié avec un commercial. Le débit réel correspond toujours à ce qui est indiqué dans votre console.
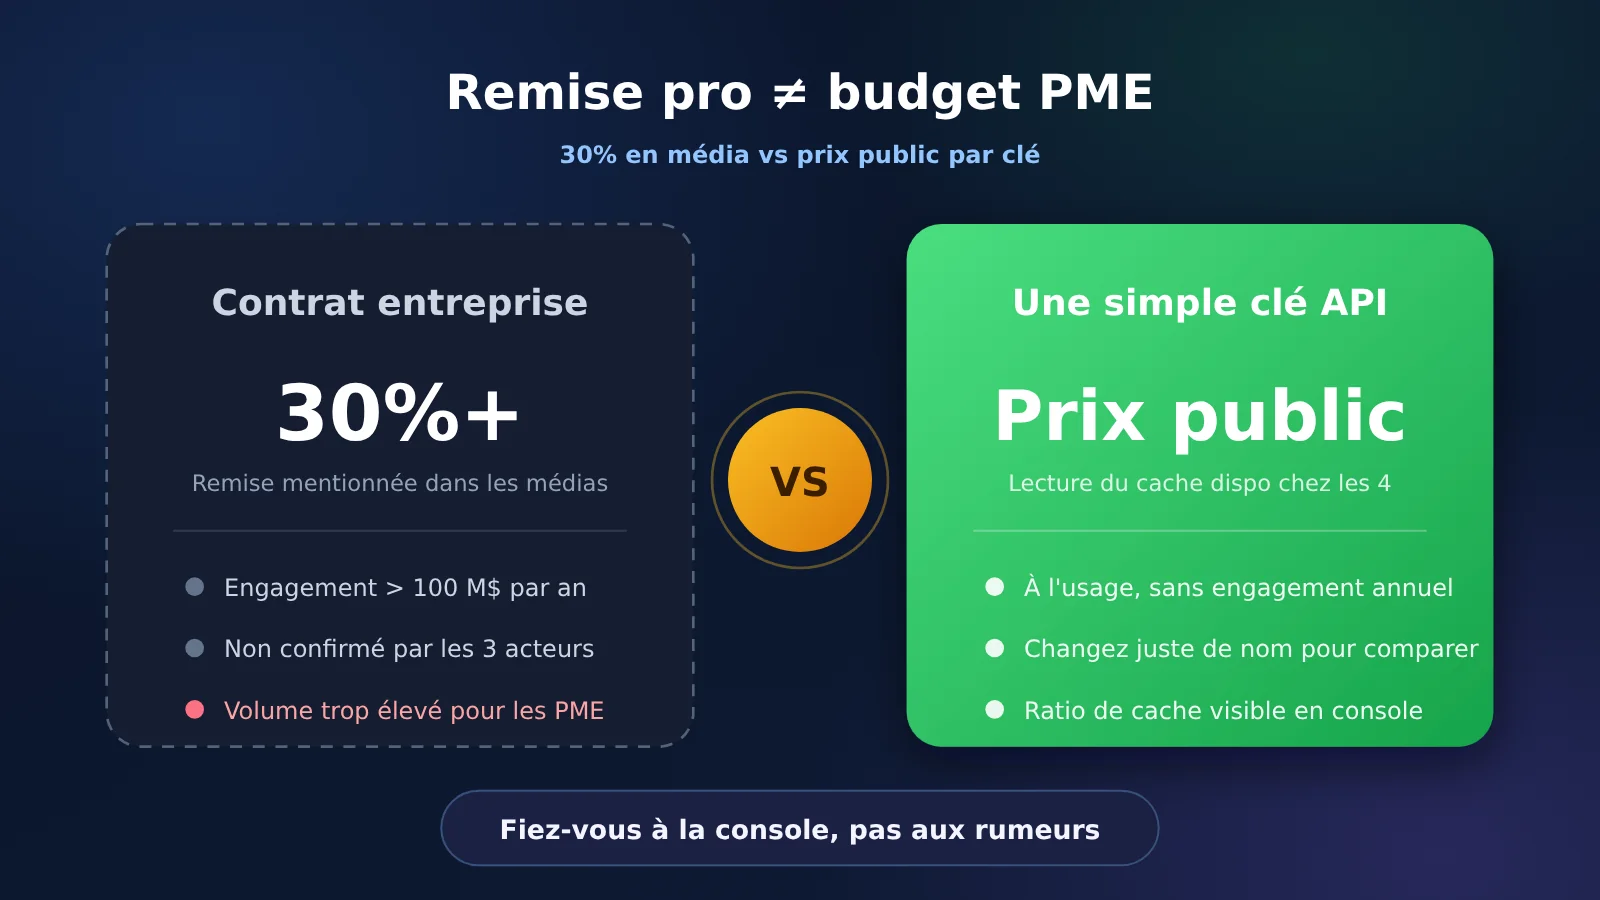
La partie gauche (les 30 % et les 100 millions de dollars) relève d’articles de presse : ce n’est pas une offre accessible d’un clic. La partie droite, en revanche, représente la stratégie concrète et immédiatement applicable pour une petite équipe.
Comment vérifier les lectures en cache de quatre fournisseurs avec une seule clé ?
La page des tarifs recommande d’utiliser en priorité /v1/responses pour les modèles GPT-5 et ultérieurs, car le cache multi-tours y est plus facilement exploité. Le endpoint Chat Completions reste toutefois disponible. Dans l’exemple ci-dessous, nous utilisons Chat Completions afin de pouvoir basculer entre gpt-6.1-sol, kimi-k3.1-pro et deepseek-flash simplement en modifiant le nom du modèle.
En revanche, le cache d’Opus 5.5 ne s’active pas par défaut sur cette route. Chez Anthropic, la mise en cache nécessite d’ajouter un paramètre cache_control au niveau racine de la requête ou de définir des points d’arrêt sur les blocs de contenu. APIYI prend en charge à la fois chat et messages pour claude-opus-5-5. Si vous souhaitez bénéficier de la tarification réduite sur le cache, passez impérativement par messages en incluant cache_control. Si vous vous limitez à Chat Completions, ne partez pas du principe que le tarif catalogue de 0,20 $ s’applique automatiquement.
- Installez les prérequis : Si vous n’avez pas encore installé le SDK, lancez d’abord
pip install openai. En haut de votre script, importez les modules avecimport osetfrom openai import OpenAI. Stockez votre clé API dans la variable d’environnementAPIYI_API_KEY, sans jamais l’écrire en dur dans votre dépôt. - Initialisez le client : Une seule ligne suffit :
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). C’est le seul endroit où vous aurez besoin de configurer l’adresse de base. - Fixez le préfixe : Placez dans
STABLE_PREFIXvotre invite système et les définitions d’outils, au caractère près. La variableuser_turncontiendra les ajouts dynamiques de l’échange en cours et devra toujours figurer en dernière position. - Envoyez la requête :
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}]). Pour tester les deux autres fournisseurs, il suffit de remplacermodelparkimi-k3.1-prooudeepseek-flash. - Analysez la consommation : Récupérez les détails avec
details = resp.usage.prompt_tokens_details, puis extrayez le cache viacached = getattr(details, "cached_tokens", 0) or 0, et affichez le résultat :print(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens). Ces trois chiffres correspondent respectivement aux tokens d’invite totaux, aux tokens servis depuis le cache et aux tokens générés en sortie.
En exécutant plusieurs tours consécutifs, divisez les tokens en cache par le total des tokens d’invite pour calculer votre taux de succès (cache hit rate). Multipliez ensuite le volume de tokens en cache par le tarif unitaire de lecture de chaque fournisseur pour connaître le coût réel en dollars. La documentation de Kimi indique que son palier de cache dépend de la configuration et que la facturation fait foi sur la console. Pour DeepSeek, si vous souhaitez profiter du tarif en heures creuses, utilisez directement l’identifiant deepseek-v4-1-flash-260910 indiqué au catalogue : n’espérez pas que deepseek-flash ajuste son tarif automatiquement selon l’heure de la journée.
Gardez toujours votre clé API dans la variable d’environnement APIYI_API_KEY, à l’abri de Git. Les crédits d’évaluation gratuits sont idéaux pour passer le même préfixe sur les quatre modèles durant quelques échanges afin de comparer la structure de consommation des tokens. Si vos quotas sont limités, augmentez progressivement le nombre de tours au lieu de saturer d’entrée de jeu les quatre plateformes avec un contexte volumineux.
FAQ sur la comparaison des lectures en cache
Q1 : 96 %, est-ce que cela signifie que la lecture en cache représente 96 % de la facture finale ?
Ce n’est pas la conclusion de cet article. Max Woolf indique que les lectures en cache représentent 96 % à 99 % de la consommation totale de tokens, sans préciser le dénominateur ; il s’agit d’une estimation tierce. WorkloadBench a mesuré entre 89 % et 96 % des tokens d’invite, sans inclure les tokens de sortie. Selon les hypothèses illustratives de notre article, les tokens en cache représentent environ 97 % du volume, mais en termes de coût en dollars, cela équivaut à environ 47 % sur Opus et Sol, environ 65 % sur Kimi et environ 30 % sur Flash.
Q2 : Pourquoi la lecture en cache de Sol est-elle parfois à 0,10 $ et parfois à 0,20 $ ?
Tout dépend de la longueur d’entrée de chaque requête. En dessous de 272 000 tokens (272K), le tarif standard d’OpenAI pour la lecture en cache est de 0,10 $. Au-delà, il passe à 0,20 $, tandis que l’entrée sans correspondance (cache miss) monte à 4 $ et la sortie à 15 $. Le catalogue d’APIYI affiche les tarifs pour contexte court (2 $ / 10 $ / 0,10 $) et précise que l’entrée passe à 4 $ au-delà de 272 000 tokens. Pour la sortie et la lecture en cache en contexte long, référez-vous aux paliers officiels d’OpenAI ; si la console affiche des paliers distincts, fiez-vous aux indications de la console.
Q3 : Pourquoi DeepSeek propose-t-il deux grilles tarifaires pour la lecture en cache ?
Le fournisseur officiel applique une tarification heures pleines / heures creuses : le tarif en heures creuses est divisé par deux. La lecture en cache coûte 0,003 $ en heures creuses et 0,006 $ en heures pleines. Les heures pleines correspondent aux jours ouvrés de 09h00 à 12h00 et de 14h00 à 18h00, heure de Pékin (converti depuis la plage UTC officielle), hors jours fériés chinois. Les week-ends et jours fériés sont entièrement comptabilisés en heures creuses. Le catalogue d’APIYI liste ces deux grilles séparément sur deux lignes de modèles distinctes.
Q4 : Les petites équipes peuvent-elles prétendre à la réduction entreprise de 30 % ?
D’après les informations rapportées, cette réduction est liée à des contrats dépassant les 100 millions de dollars par an, sans confirmation publique officielle de la part des trois fournisseurs. Une petite équipe n’atteint évidemment pas un tel volume d’engagement. Comparer les prix publics de lecture en cache suffit largement pour faire un premier choix technique éclairé. Quant aux remises par paliers et aux offres de recharge, fiez-vous directement à la console APIYI, sans les confondre avec les remises grands comptes évoquées dans la presse.
Q5 : Comment connecter les quatre fournisseurs avec une seule clé ?
Il vous suffit de créer une clé API sur APIYI (apiyi.com) et d’utiliser l’URL racine `https://api.apiyi.com/v1`. Les modèles `gpt-6.1-sol`, `kimi-k3.1-pro` et `deepseek-flash` fonctionnent avec l’endpoint Chat Completions : changez simplement le nom du modèle. Pour `claude-opus-5-5`, afin de bénéficier de la tarification de cache, passez par l’endpoint `messages` en incluant le paramètre `cache_control`. Pour GPT-5 et versions ultérieures, si vous souhaitez un meilleur taux de correspondance sur les échanges multi-tours, la page de tarification recommande de basculer sur `/v1/responses`.
Q6 : La lecture en cache étant très abordable, devrait-on faire de Flash son modèle par défaut ?
Seulement si le coût d’un échec éventuel est inférieur à la différence de prix. En heures creuses, la simulation donne une facture environ 20 fois moins élevée que Sol (0,0486 $ contre 1,02 $), et environ 10 fois moins en heures pleines. En revanche, si Flash nécessite plusieurs tours supplémentaires pour accomplir la même tâche, cette multiplication des requêtes absorbera vite l’économie réalisée. Testez d’abord le nombre de tours nécessaires avec vos crédits gratuits sur un même préfixe avant de choisir votre modèle par défaut.
Q7 : Le coût d’écriture en cache est-il plus élevé que celui de la lecture ?
Tout à fait, si vos préfixes expirent souvent et que le nombre de hits est minime. Pour Opus et Sol, l’écriture sur le palier court coûte 1,25 fois le tarif d’entrée (input), et le palier de 12 heures de Sol monte à 2,5 fois. Chez Kimi, l’écriture sur le créneau de 5 minutes est facturée au même prix que l’entrée standard. Ce n’est qu’après deux ou trois tours de cache hits que la lecture en cache devient le poste de coût principal. Pour des tâches aux intervalles irréguliers, commencez par bien régler votre TTL avant de comparer les tarifs de lecture en cache.
Points clés pour comparer la lecture en cache
- Le chiffre de 96 % est une estimation tierce : Max Woolf n’a pas rendu ses logs publics. Pour évaluer la part réelle en dollars, vous devez multiplier les volumes par les prix unitaires.
- Regardez d’abord la lecture en cache, puis vérifiez les paliers : au-delà de 272K tokens chez Sol, la lecture en cache passe de 0,10 $ à 0,20 $.
- Opus et Kimi sont tous les deux à 0,20 $ la lecture en cache : Kimi reste toutefois plus économique sur les requêtes non mises en cache (misses) et sur les sorties, sans aucun surcoût d’écriture sur le palier court.
- L’avantage de Flash se joue à un ordre de grandeur près : à 0,003 $ en heures creuses et 0,006 $ en heures pleines, le budget n’est plus du tout phagocyté par la lecture en cache.
- Les 30 % accordés aux grands comptes ne concernent pas les petites équipes : il s’agit d’accords-cadres annuels évoqués dans les médias. Les tarifs publics sont largement suffisants pour arbitrer un premier choix.
- Une seule clé API pour brancher les quatre fournisseurs : changez simplement le nom du modèle sur APIYI apiyi.com, puis suivez votre taux de cache hits directement d’après les métriques de la console.
En résumé
Au cours de ces quatre derniers mois, les baisses de prix publiques ont atteint jusqu’à 80 %. Elles concernent principalement le tarif de base de Luna, ainsi que la lecture du cache de la gamme Sol, passée de 0,50 $ à 0,10 $. Pour les agents de développement, il reste indispensable d’isoler la lecture du cache dans vos calculs. D’après les tarifs officiels au 26 octobre 2026, la lecture du cache en contexte court revient à 0,10 $ pour GPT-6.1 Sol, 0,20 $ pour Opus 5.5 et Kimi K3.1 Pro, et pour DeepSeek V4.1 Flash à 0,003 $ en heures creuses contre 0,006 $ en heures de pointe. Les chiffres de 96 % à 99 % ne sont mentionnés qu’en référence aux estimations de Max Woolf. Sur une facture type, la réduction sur le volume de tokens peut approcher cette fourchette, mais l’économie réelle en dollars reste un cran en dessous.
Les remises « Enterprise » mentionnées dans la presse exigent un engagement annuel qu’une petite équipe ne peut pas obtenir. Brancher ces quatre fournisseurs sur une même clé API et multiplier votre propre taux de cache hit par le tarif public de lecture du cache s’avère bien plus pragmatique que d’espérer négocier un contrat à -30 %. Le plus simple reste de tester un même préfixe stable sur APIYI (apiyi.com) avant d’arrêter votre choix de modèle par défaut.
Auteur : L’équipe technique APIYI
Échanges techniques : N’hésitez pas à nous contacter via la page d’accueil d’APIYI. Les tarifs unitaires font foi sur la page des prix de notre centre de documentation : docs.apiyi.com.
Références
- Max Woolf, chronologie de la baisse des prix et estimation de 96 % à 99 %
- Lien :
minimaxir.com/2026/10/cheap-llms -
Remarque : 25/10/2026. La fourchette de 96 % à 99 % provient de l’auteur lui-même et ne correspond pas à des mesures effectuées dans cet article.
-
Tarifs des modèles Anthropic
- Lien :
platform.claude.com/docs/en/about-claude/pricing -
Remarque : Tarifs d’Opus 5.5 pour l’entrée, la sortie, la lecture en cache et les deux paliers d’écriture.
-
Tarifs des modèles OpenAI
- Lien :
developers.openai.com/api/docs/pricing -
Remarque : GPT-6.1 Sol pour le contexte court, le contexte long, la lecture et l’écriture en cache. Le seuil officiel séparant contexte court et contexte long est fixé à 272K.
-
Tarifs des modèles DeepSeek
- Lien :
api-docs.deepseek.com/quick_start/pricing -
Remarque : Tarifs de
deepseek-flashen heures pleines et heures creuses pour les correspondances en cache (hit), les échecs de cache (miss) et la génération en sortie. -
API Kimi
- Lien :
platform.kimi.ai -
Remarque : Tarifs de Kimi K3.1 Pro pour l’entrée, la sortie, les correspondances en cache et l’écriture par défaut.
-
Relai du contrat de Replit par AI Weekly
- Lien :
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
Remarque : La remise de plus de 30 % et le budget annuel supérieur à 100 millions de dollars sont tirés d’un article de The Information. Ces clauses n’ont pas été confirmées publiquement par les trois parties concernées.
-
Proportion de tokens en cache selon WorkloadBench
- Lien :
workloadbench.brenhq.com/cache - Remarque : 16/10/2026. Correspond à la part de tokens d’invite provenant du cache, et non à un pourcentage calculé sur les coûts en dollars.