Nota del autor: desde los criterios de aceptación y el aislamiento de datos hasta la revisión independiente, diseña en 5 pasos una validación externa para tareas de IA de alta complejidad y evita las falsas finalizaciones que genera la autoevaluación del modelo.
El modelo responde «tarea completada, resultado correcto», pero no resiste una reproducción. Es el problema con el que se topan muchos usuarios de IA cuando abordan tareas de alta complejidad. En este artículo presentamos un método de diseño de validación externa que se puede ejecutar de forma independiente, para que pases de «el modelo dice que está hecho» a «las pruebas demuestran que está hecho».
En una guía práctica publicada en octubre de 2026, el desarrollador de Claude, Felix Rieseberg, recomienda expresamente no dejar que el modelo se puntúe a sí mismo y apostar por la validación externa. Según él, la forma ideal son herramientas que el propio modelo pueda ejecutar y que le devuelvan retroalimentación al instante. InfoQ publicó la traducción al chino de este artículo el 4 de noviembre de 2026.
Este no es un recordatorio del tipo «revísalo una vez más». El artículo original marca la dirección y, a partir de ahí, aquí organizamos pasos de diseño que se pueden llevar a la práctica, abarcando la elección de los métodos de validación, los modos de fallo habituales y las formas de revisión con varios modelos.
Valor clave: al terminar el artículo, podrás escribir un contrato de validación para tus tareas de IA de alta complejidad, para que el modelo itere con retroalimentación comprobable en lugar de terminar con una autoevaluación.
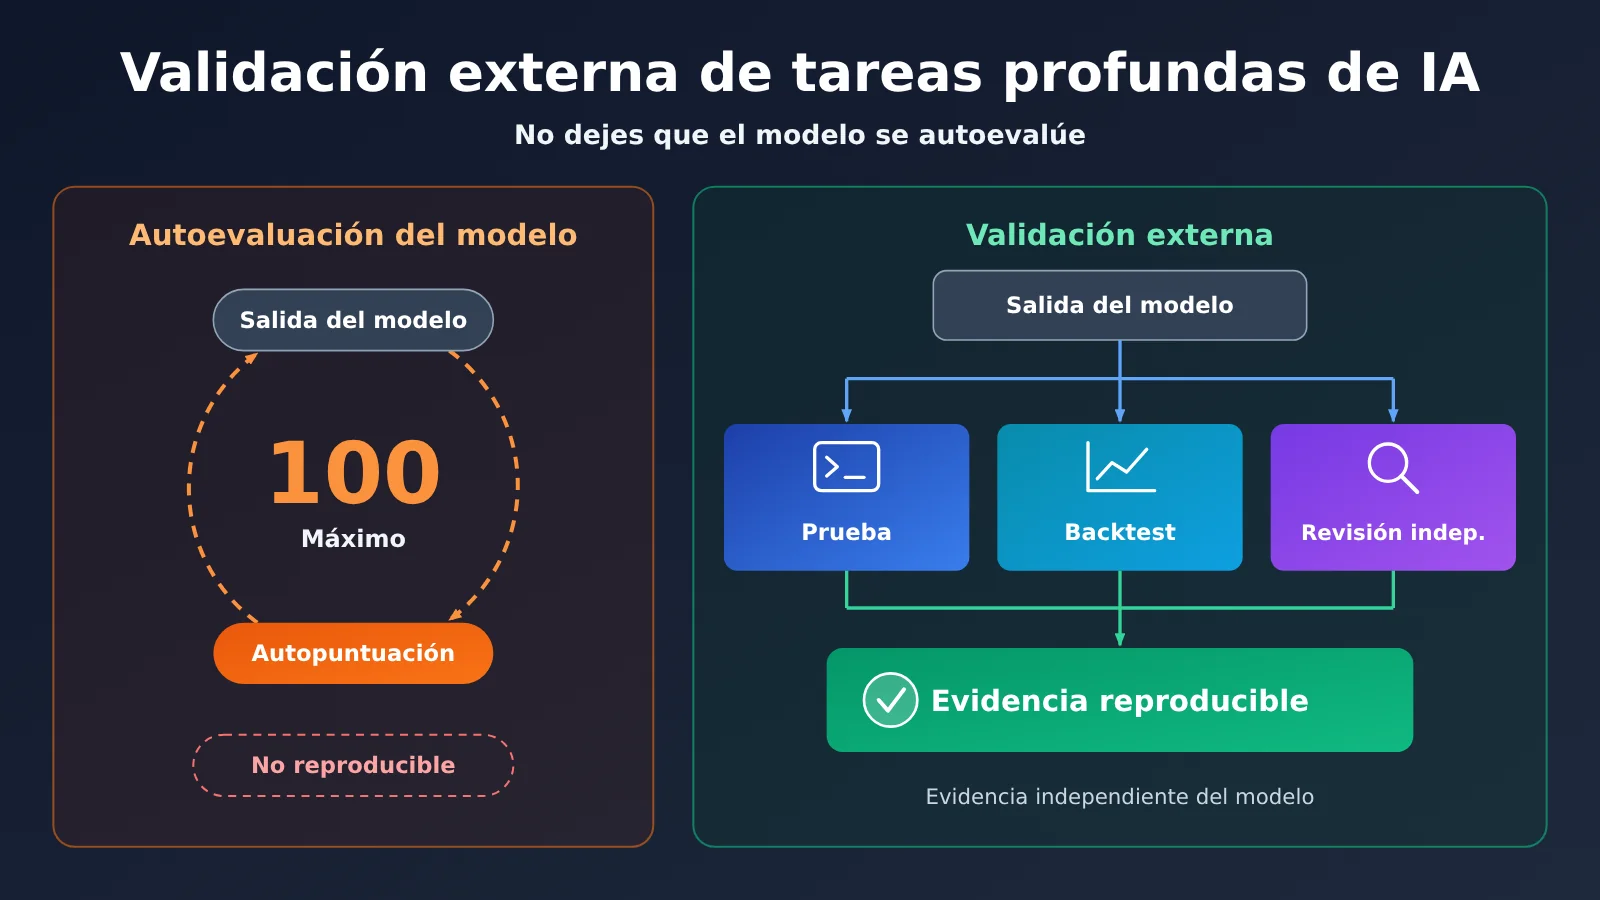
Puntos clave de la verificación externa en tareas profundas con IA
La clave de la verificación externa no consiste en añadir un paso de comprobación más, sino en lograr que la base del juicio sea independiente del propio proceso de razonamiento del modelo.
| Punto clave | Descripción | Valor |
|---|---|---|
| Definir el criterio primero | Dejar por escrito las condiciones de aprobación antes de empezar y hacerlas, en lo posible, verificables | Evita que el modelo reinterprete el objetivo a posteriori |
| Aislar los datos | Comprobar las conclusiones con datos o escenarios que el modelo no haya visto | Distingue un hallazgo real de un ajuste posterior a los hechos |
| Priorizar las herramientas | Usar preferentemente validadores que puedan ejecutarse y den retroalimentación inmediata | Permite que el modelo itere por su cuenta y reduce la vigilancia manual |
| Conservar la evidencia | Guardar resultados de ejecución, registros y pasos de reproducción | Permite auditar las conclusiones en lugar de simplemente creer en ellas |
| Revisión independiente | Cuestionar los resultados con métodos y posturas distintas | Detecta problemas que un único validador deja pasar |
Por qué las tareas profundas con IA necesitan verificación externa
Cuando Rieseberg habla de «profundidad», se refiere a usar las herramientas, técnicas y conocimientos que emplean los mejores expertos del campo, y a llegar hasta los datos de fondo en lugar de quedarse en la superficie de la tarea. Cuanto más profunda es la tarea, más difícil resulta para una persona juzgar por intuición si el resultado es correcto. Un análisis de churn redactado con tono profesional puede sonar muy convincente, pero eso no demuestra que sus juicios causales sean válidos.
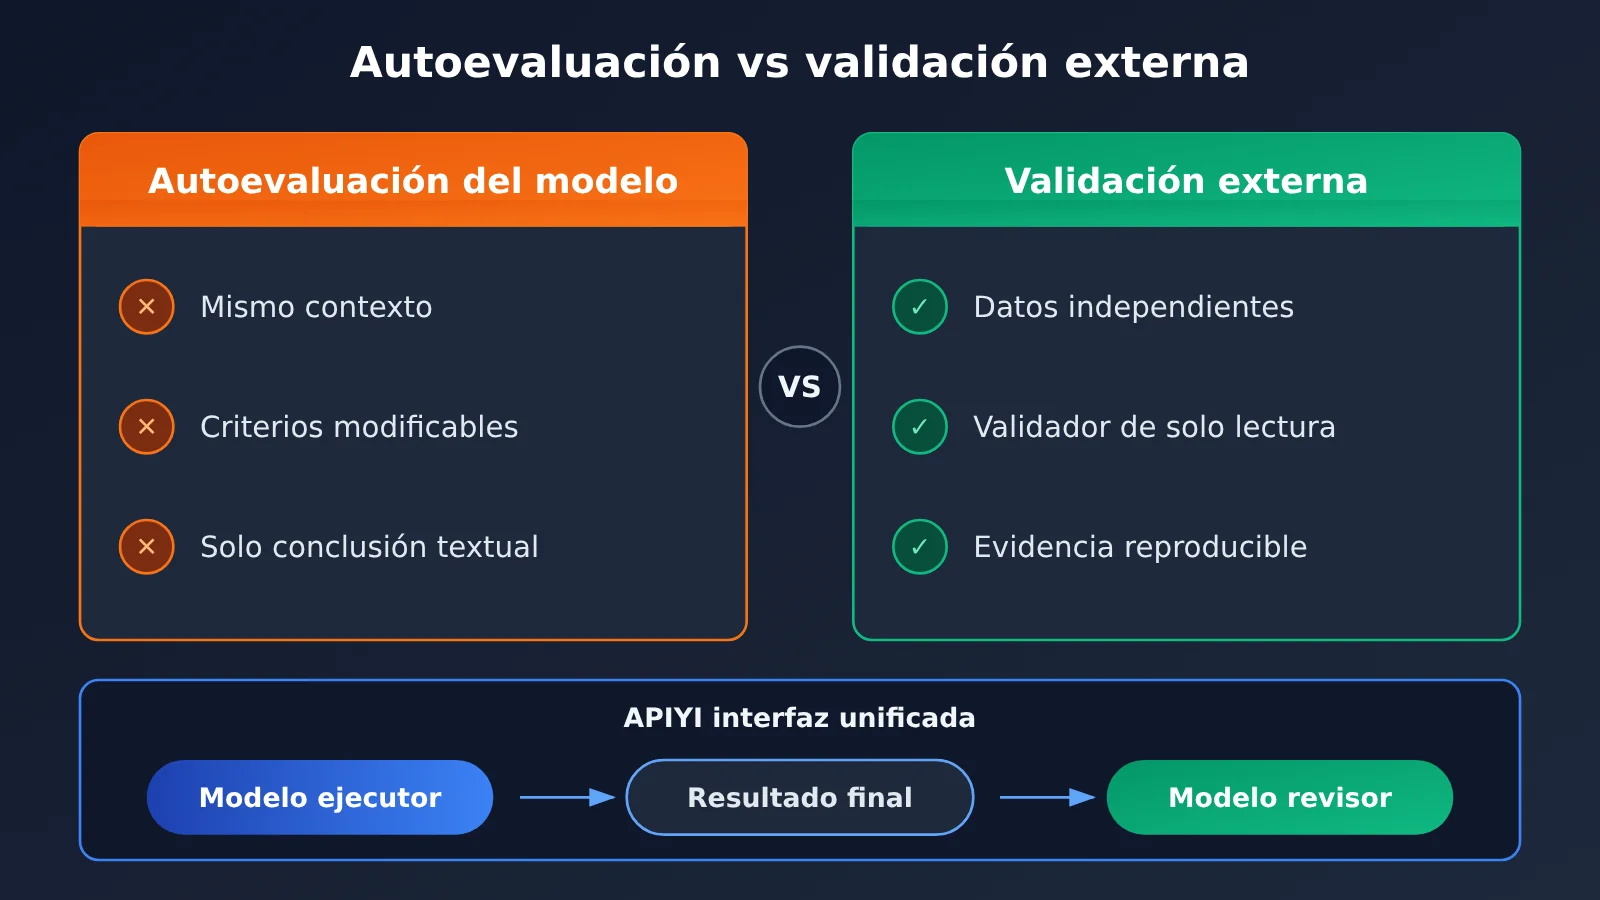
También menciona un fenómeno habitual: cuando se le pide al modelo que se comporte como un experto, a menudo solo cambia el vocabulario, sin que su forma de trabajar cambie de verdad. La autoevaluación difícilmente detecta este tipo de problemas, porque el evaluador y el productor comparten el mismo conjunto de supuestos. Si el razonamiento ya parte de un sesgo, la puntuación del modelo probablemente se despliegue siguiendo ese mismo sesgo.
Los objetivos ambiciosos hacen que la verificación sea aún más importante. El texto original propone fijar metas que parecen desproporcionadas, como reducir el tiempo de carga de un sitio web de 10 segundos a 200 milisegundos, y pedirle al modelo que siga intentándolo. Este tipo de objetivos resulta útil porque 200 milisegundos se pueden medir. Si el objetivo es a la vez agresivo e imposible de verificar, lo más probable es que solo se obtenga un informe más seguro de sí mismo.
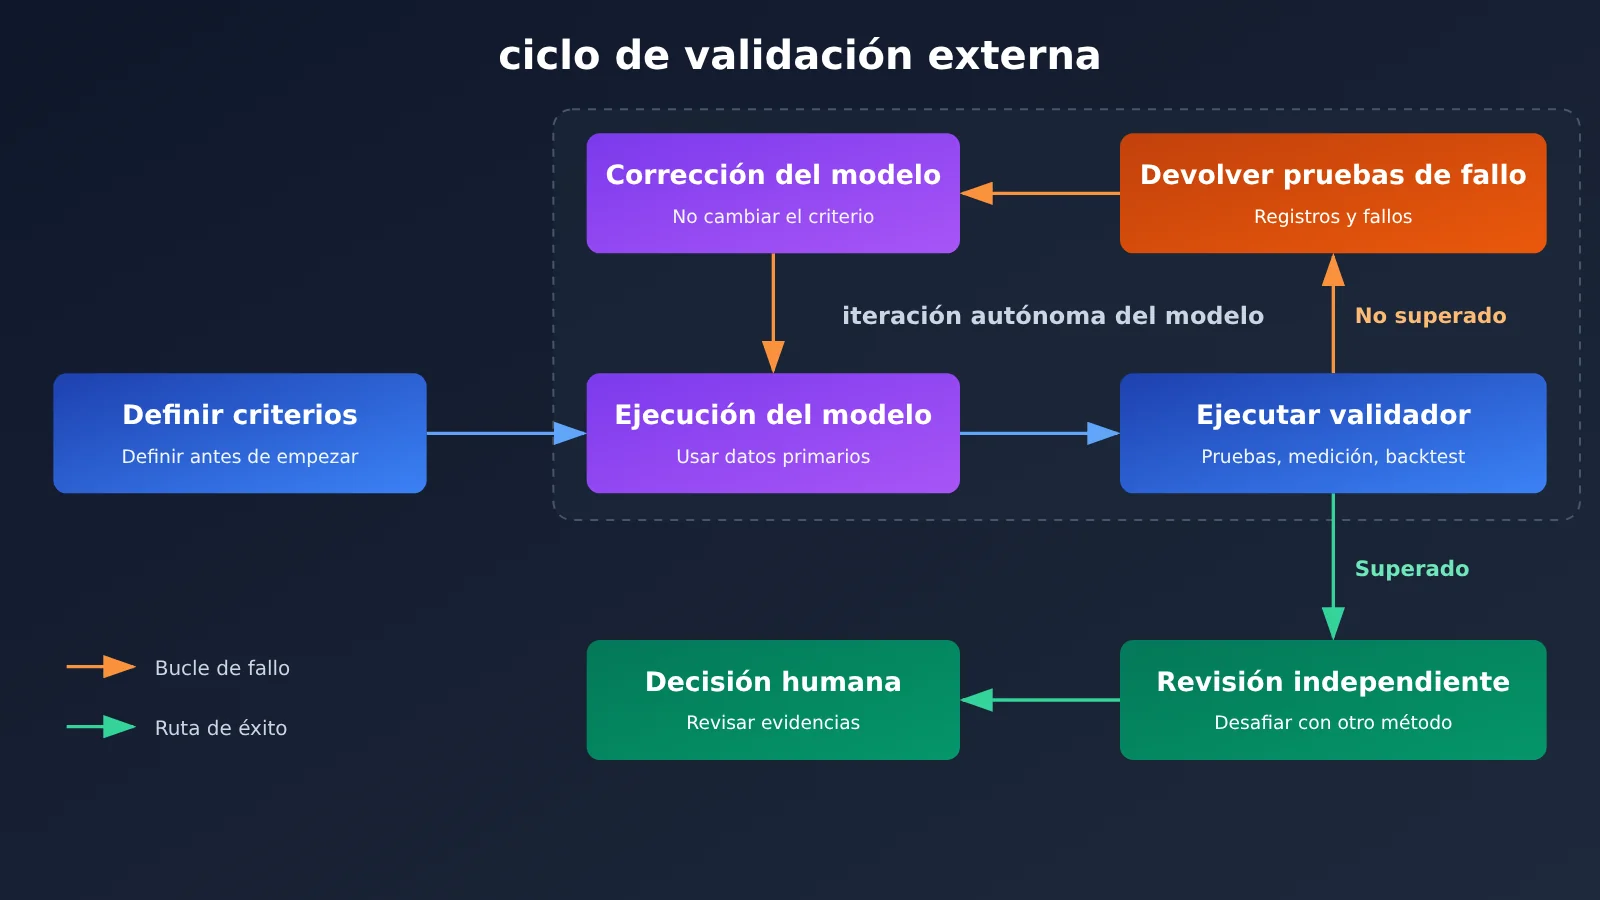
Inicio rápido a la verificación externa de tareas profundas de IA: método de diseño en 5 pasos
El siguiente método no depende de un modelo o framework específico; puedes empezar eligiendo una tarea que tengas en curso y aplicarlo. Si por ahora no puedes implementarlo todo, se recomienda completar primero los tres primeros pasos.
Paso 1: reformular el objetivo de la tarea como criterio de verificación externa
“Un análisis completo” o “código de alta calidad” no se pueden determinar directamente; hay que reescribirlos como condiciones que puedan aprobarse o fallar. Por ejemplo, cambia “arreglar el fallo” por “ejecutar los pasos de reproducción originales ya no provoca el fallo y todas las pruebas relacionadas pasan”. Los criterios deben escribirse antes de que el modelo empiece a trabajar; de lo contrario, podría ajustar la definición de éxito después de terminar.
Puedes redactar primero este contrato de verificación y luego entregárselo al modelo para que lo ejecute:
| Campo | Qué debe especificarse con claridad | Ejemplo |
|---|---|---|
| Objetivo final | El resultado de negocio o de ingeniería que realmente se desea | La aplicación se mantiene estable y deja de presentar el mismo tipo de fallo |
| Material original | Datos de primera mano que el modelo debe usar directamente | Informe de fallo, correspondencia entre versiones y commits de Git |
| Verificador | Qué herramienta o datos determinan el resultado | Script de reproducción, pruebas automatizadas, datos reservados |
| Condición de aprobación | Umbral o regla de decisión clara | El fallo ya no se puede reproducir en los tres sistemas objetivo |
| Prohibiciones | Contenido que el modelo no debe modificar | No eliminar pruebas, no modificar los datos reservados |
| Evidencia a entregar | Resultados de ejecución que deben adjuntarse | Comandos, registros, historial de fallos y resultado final |
| Condición de parada | Cuándo terminar o pasarlo a una persona | Tras alcanzar el límite de iteraciones, presentar el motivo del bloqueo |
Paso 2: Romper el vínculo entre las conclusiones y los datos de validación
Que el modelo formule una hipótesis y la demuestre con los mismos datos no es una validación externa. El ejemplo de abandono de usuarios del texto original ofrece una buena práctica: pedir al modelo que busque en los registros las primeras señales de abandono y luego demostrar, con datos que no haya visto, que esa señal realmente tiene capacidad predictiva. En la práctica, se pueden dividir los datos por tiempo: los primeros se usan para explorar y los posteriores para comprobar.
Lo ideal es que los datos de reserva los custodie un script o una persona independiente; el modelo solo debe recibir los resultados de la ejecución, no leer los detalles directamente. Si se ajusta el enfoque una y otra vez según los resultados, el conjunto de reserva también acabará siendo “aprendido” poco a poco. Por eso, para las conclusiones importantes conviene reservar además un conjunto de datos que solo se use en la aceptación final.
Paso 3: Priorizar herramientas de validación externa que el modelo pueda ejecutar por sí mismo
Cuanto más cerca esté el validador del resultado real y más rápida sea la retroalimentación, más podrá iterar el modelo por su cuenta. La siguiente tabla recoge varios métodos de validación externa según tareas habituales. Al elegirlos no hay que buscar una única “solución más potente”, sino combinarlos en función del riesgo.
| Método de validación | Qué puede demostrar | Velocidad de retroalimentación | Limitaciones principales |
|---|---|---|---|
| Pruebas automatizadas y scripts de reproducción | Que el comportamiento especificado cumple lo esperado | Rápida | Solo cubre los escenarios ya definidos |
| Herramientas de medición de rendimiento | Si las métricas alcanzan el umbral | Rápida | Las diferencias de entorno pueden afectar los resultados |
| Prueba retrospectiva con datos de reserva | Si las conclusiones tienen capacidad predictiva | Media | Los patrones históricos no siempre se mantienen |
| Revisión con enfoque de red team | Si las hipótesis y la cadena de evidencia son débiles | Media | La calidad del juicio depende del método de revisión |
| Ejecución en sombra | Si la solución funciona en el flujo real | Lenta | Ciclo largo y costo organizativo alto |
| Muestreo por expertos del dominio | Si los resultados coinciden con el criterio profesional | Lenta | Difícil de cubrir a gran escala |
Paso 4: Incorporar la validación externa al ciclo de trabajo del modelo
Las herramientas de validación solo generan iteración continua cuando se integran en el entorno de trabajo del modelo. El caso de reparación de fallos que describe el artículo original es muy representativo: el autor primero se aseguró de que Claude pudiera acceder fácilmente a los informes de fallos, supiera qué commit de Git corresponde a cada versión y pudiera usar equipos con Windows, macOS y Linux. Con esas condiciones, el modelo puede reproducir el problema y verificar la corrección por su cuenta.
Esto también demuestra que la validación externa a menudo exige ajustar el flujo de trabajo, no solo cambiar la indicación. Hay que abrir los datos y las herramientas necesarios —por ejemplo, conectar fuentes de datos mediante un conector MCP— y, al mismo tiempo, limitar los permisos al alcance de la tarea. El diseño del ciclo debe incluir al menos tres elementos:
- Retroalimentación de fallos: devolver registros de error concretos y los elementos que no pasaron, en lugar de solo la palabra «fallo».
- Límite de iteraciones: acotar el número de reintentos y el presupuesto total para evitar que el modelo entre en un bucle inútil.
- Elementos protegidos: dejar en solo lectura las pruebas, los scripts de validación y los datos de reserva (holdout), para que el modelo no «apruebe» modificando el criterio.
Paso 5: Completar la validación externa con revisión independiente y ejecución en paralelo
Que un único validador dé el visto bueno no significa que la conclusión sea fiable. El artículo menciona la posibilidad de incorporar un «equipo rojo» dedicado a buscar errores, como inversores bajistas y contadores forenses, pero lo importante no es imitar su tono, sino aplicar sus métodos de investigación reales. Por ejemplo, pedir al modelo que rastree el origen original de cada cifra clave o que busque activamente datos capaces de refutar la conclusión.
Para los cambios de proceso también se puede recurrir a la ejecución en paralelo. El artículo sugiere demostrar primero, con datos históricos, que el nuevo mecanismo de retrospectiva habría detectado los problemas antes, y luego hacerlo funcionar en paralelo con el proceso actual durante un trimestre. Así se comprueba el efecto real y no se asume desde el principio el riesgo de sustituir por completo el proceso antiguo.
Consejo de integración: si necesitas que distintos modelos se encarguen por separado de la ejecución y la revisión, puedes invocarlos de forma unificada a través de APIYI. APIYI ofrece la invocación por API de los modelos mencionados en este artículo, es compatible con los formatos de interfaz de OpenAI y Anthropic, y para integrarlo normalmente solo hay que configurar
base_url,api_keyymodelsegún la documentación. Documentación: https://docs.apiyi.com
Modos comunes de fallo en la validación externa de tareas profundas de IA
La validación externa también puede quedarse en pura apariencia. Los siguientes problemas deberían tenerse en cuenta ya en la fase de diseño; de lo contrario, los resultados de la validación solo aportarán una falsa sensación de seguridad.
| Modo de fallo | Manifestación típica | Cómo abordarlo |
|---|---|---|
| Modificar los criterios | Eliminar casos fallidos o relajar las aserciones | Validador de solo lectura y revisión de los cambios relevantes |
| Sobreajuste al conjunto de validación | Las métricas suben de forma sostenida, pero fallan con datos nuevos | Reservar un conjunto final de datos de aceptación |
| Razonamiento circular | Validar las conclusiones del modelo con datos generados por el propio modelo | Volver a los registros originales y al material de primera mano |
| Validar solo la forma | El formato es correcto, pero el contenido es erróneo | Añadir reglas de negocio y comprobaciones por muestreo |
| Juego de roles | La conversación suena a experto, pero los resultados no mejoran | Exigir la aplicación de un método concreto y la entrega de evidencia |
La “revisión por un segundo modelo” merece una mención aparte. Es mejor que la autoevaluación, porque puede revelar parte de los puntos ciegos, pero sigue siendo una revisión basada en el juicio y no sustituye a las pruebas ni a los datos reales. Al revisar, conviene proporcionar solo los criterios de la tarea, el material original y el resultado final, sin la conversación previa, para reducir la influencia del razonamiento anterior sobre el juicio.
Ejemplos de diseño de validación externa para distintas tareas profundas de IA
Los siguientes ejemplos pueden servir como punto de partida para el diseño; los umbrales concretos deben determinarse según el contexto del negocio.
| Tarea | Enfoque basado solo en la autoevaluación | Diseño de validación externa |
|---|---|---|
| Corregir un fallo de la aplicación | El modelo explica el principio de la corrección y declara que ha terminado | Reproducir en distintos sistemas y confirmar que el fallo ya no aparece tras la corrección |
| Encontrar señales de abandono | El modelo entrega un informe de atribución razonable | Comprobar la capacidad predictiva con datos que no participaron en la exploración |
| Verificar las causas del abandono | El modelo reutiliza el juicio de que “el onboarding de nuevos usuarios tiene problemas” | Buscar en los datos originales evidencia a favor y en contra |
| Optimizar la velocidad de carga | El modelo enumera optimizaciones y estima sus beneficios | Medir en un entorno fijo y comparar con el umbral objetivo |
| Reestructurar la retrospectiva del negocio | El modelo argumenta que la nueva propuesta es más avanzada | Tras un backtesting histórico, ejecutarla en paralelo con el proceso actual durante un trimestre |
Para decidir si una tarea merece este tipo de diseño, se puede usar un criterio sencillo: si el coste del error supera el coste de la validación. Si solo se trata de reescribir un correo, quizá baste con leerlo una vez. Pero si el resultado afecta a sistemas en producción o a la asignación de recursos, conviene diseñar una validación externa.
Preguntas frecuentes (FAQ)
P1: ¿Qué es la validación externa en tareas de razonamiento profundo de IA?
Consiste en comprobar los resultados con evidencia independiente del juicio del propio modelo, por ejemplo, pruebas automatizadas, medición de rendimiento, backtesting con datos reservados y revisión por expertos. El requisito central es que los criterios de evaluación no los decida sobre la marcha el modelo que generó el resultado.
P2: ¿Cuál es la diferencia entre la validación externa y la autoevaluación del modelo?
La autoevaluación del modelo puede detectar omisiones evidentes con rapidez, pero el productor y el evaluador comparten los mismos supuestos. La validación externa incorpora fuentes de evidencia independientes y es más adecuada para determinar si un resultado es real y válido. Se pueden usar juntas, pero la autoevaluación no debe ser la base de aceptación final.
P3: ¿Sigue siendo necesaria la validación externa a medida que los modelos se vuelven más potentes?
Rieseberg considera que, a medida que los modelos se vuelvan más inteligentes, este problema podría terminar resolviéndose, pero recomienda explícitamente mantener la validación externa al menos hasta octubre de 2026. Es un juicio práctico por etapas. Antes de que se valide la fiabilidad de la autoevaluación de los modelos, las tareas de alto riesgo deberían conservar una verificación independiente.
P4: ¿En qué escenarios se necesita más la validación externa?
Principalmente en estas categorías de tareas:
– **Reparación de ingeniería**: corrección de fallos, optimización de rendimiento y migración de datos.
– **Investigación de datos**: análisis de abandono, juicio causal y descubrimiento de señales predictivas.
– **Flujos de agentes de larga duración**: tareas que requieren que el modelo trabaje de forma continua con poca intervención humana.
P5: ¿Cómo construir una revisión cruzada entre varios modelos a través de API?
Se puede acceder de forma unificada a través de APIYI, cuya interfaz es compatible con los formatos de OpenAI y Anthropic:
1. Configura la dirección de la interfaz y la clave API siguiendo la documentación de APIYI https://docs.apiyi.com.
2. Consulta en la página de precios https://docs.apiyi.com/models los modelos disponibles y sus costos.
3. Configura un `model` distinto para la ejecución y para la revisión; la solicitud de revisión no debe incluir la conversación de la fase de ejecución.
4. Registra por separado las observaciones de la revisión y los resultados de las pruebas, dando prioridad a las pruebas y a la evidencia de datos.
P6: ¿Cómo estimar el costo de un ciclo de validación externa?
El costo total suele depender del número de iteraciones, la longitud del contexto, la longitud de la salida y la cantidad de modelos revisores. Se recomienda ejecutar varias rondas con una muestra pequeña, registrar el uso real de cada ronda y estimar el presupuesto combinándolo con un límite de iteraciones. Este artículo no incluye precios unitarios concretos; los precios de los modelos, los criterios de facturación, los precios de entrada y salida y los precios de caché deben tomarse de los datos reales de la página de precios de APIYI https://docs.apiyi.com/models.
P7: ¿Qué limitaciones tiene la validación externa?
Las pruebas solo pueden cubrir escenarios ya definidos; el backtesting no garantiza que los patrones históricos sigan vigentes, y el periodo de ejecución en modo sombra suele ser largo. Que una validación pase solo significa que el resultado recibió respaldo bajo condiciones limitadas, no que sea absolutamente correcto. En asuntos legales, financieros y decisiones de negocio importantes, la decisión final debe seguir recayendo en los responsables correspondientes.
Puntos clave de la validación externa en tareas profundas de IA
- Principio central: no tomes la autoevaluación del modelo como criterio de aceptación; el juicio debe provenir de evidencia independiente.
- Estándares por delante: define las condiciones de aprobación antes de empezar, para evitar redefinir el éxito a posteriori.
- Aislamiento de datos: comprueba los hallazgos con datos que el modelo no haya visto, evitando así la argumentación circular.
- Herramientas primero: los validadores que se ejecutan y dan retroalimentación inmediata son los que mejor favorecen la iteración autónoma.
- Entorno adecuado: el modelo necesita acceso a datos, herramientas y un entorno de ejecución para poder autocorregirse.
- Revisión por capas: el segundo modelo sirve para detectar puntos ciegos, pero no sustituye a las pruebas ni a los datos reales.
- Integración flexible: con APIYI puedes invocar varios modelos de forma unificada, lo que reduce el coste de integrar la revisión cruzada.
Resumen
Al diseñar la validación externa de tareas profundas de IA, basta con recordar estos tres puntos:
- Convierte primero el objetivo en un criterio decidible: sin condiciones de aprobación, es imposible saber si la tarea se completó de verdad.
- Haz que la evidencia sea independiente del razonamiento del modelo: aísla los datos, protege los validadores y conserva un registro completo de las ejecuciones.
- Combina los métodos de validación según el riesgo: las herramientas aportan retroalimentación rápida, la revisión descubre puntos ciegos y la ejecución en paralelo comprueba el efecto real.
Como siguiente paso, elige una tarea profunda que tengas entre manos, escribe primero un contrato de validación y luego deja que el modelo empiece a trabajar. Así no solo reduces los errores, sino que te atreves a plantearte objetivos más ambiciosos, porque por muy audaz que sea la meta, siempre habrá una forma de aceptar el resultado a examen.
Si necesitas montar un flujo de ejecución y revisión con varios modelos, puedes probar las llamadas a través de APIYI; la forma de integración está en https://docs.apiyi.com, y los precios de los modelos y los criterios de facturación se rigen por los datos reales de https://docs.apiyi.com/models.
📚 Referencias
- Cómo fijar objetivos más ambiciosos: una guía práctica para usuarios de IA: traducción al chino de InfoQ
- Enlace:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Descripción: incluye métodos prácticos en las tres dimensiones de altura, profundidad y amplitud
-
How to be more ambitious: A tutorial for humans with models: texto original de Felix Rieseberg
- Enlace:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Descripción: fuente original de las recomendaciones de validación externa y de casos como la corrección de fallos y la pérdida de usuarios
-
Centro de documentación de APIYI: instrucciones de integración de la interfaz
- Enlace:
docs.apiyi.com -
Descripción: se usa para consultar la configuración de integración en los formatos compatibles con OpenAI y Anthropic
-
Página de modelos y precios de APIYI: información sobre modelos y facturación
- Enlace:
docs.apiyi.com/models - Descripción: los precios de los modelos, los criterios de facturación y los precios de caché se rigen por esta página
Autor: equipo técnico de APIYI
Contacto técnico: puedes escribirnos desde la página principal del sitio web de APIYI; encontrarás más materiales en el centro de documentación docs.apiyi.com