Note de l’auteur : aujourd’hui, il faut appeler l’API, alors on continue avec grok-4.7. Au 13 novembre 2026, Grok 4.8 n’a toujours pas d’ID de modèle. Cet article vérifie, sources à l’appui, les 3 points faibles de Grok 4.7, pour voir si Grok 4.8 a déjà des preuves de les avoir comblés.
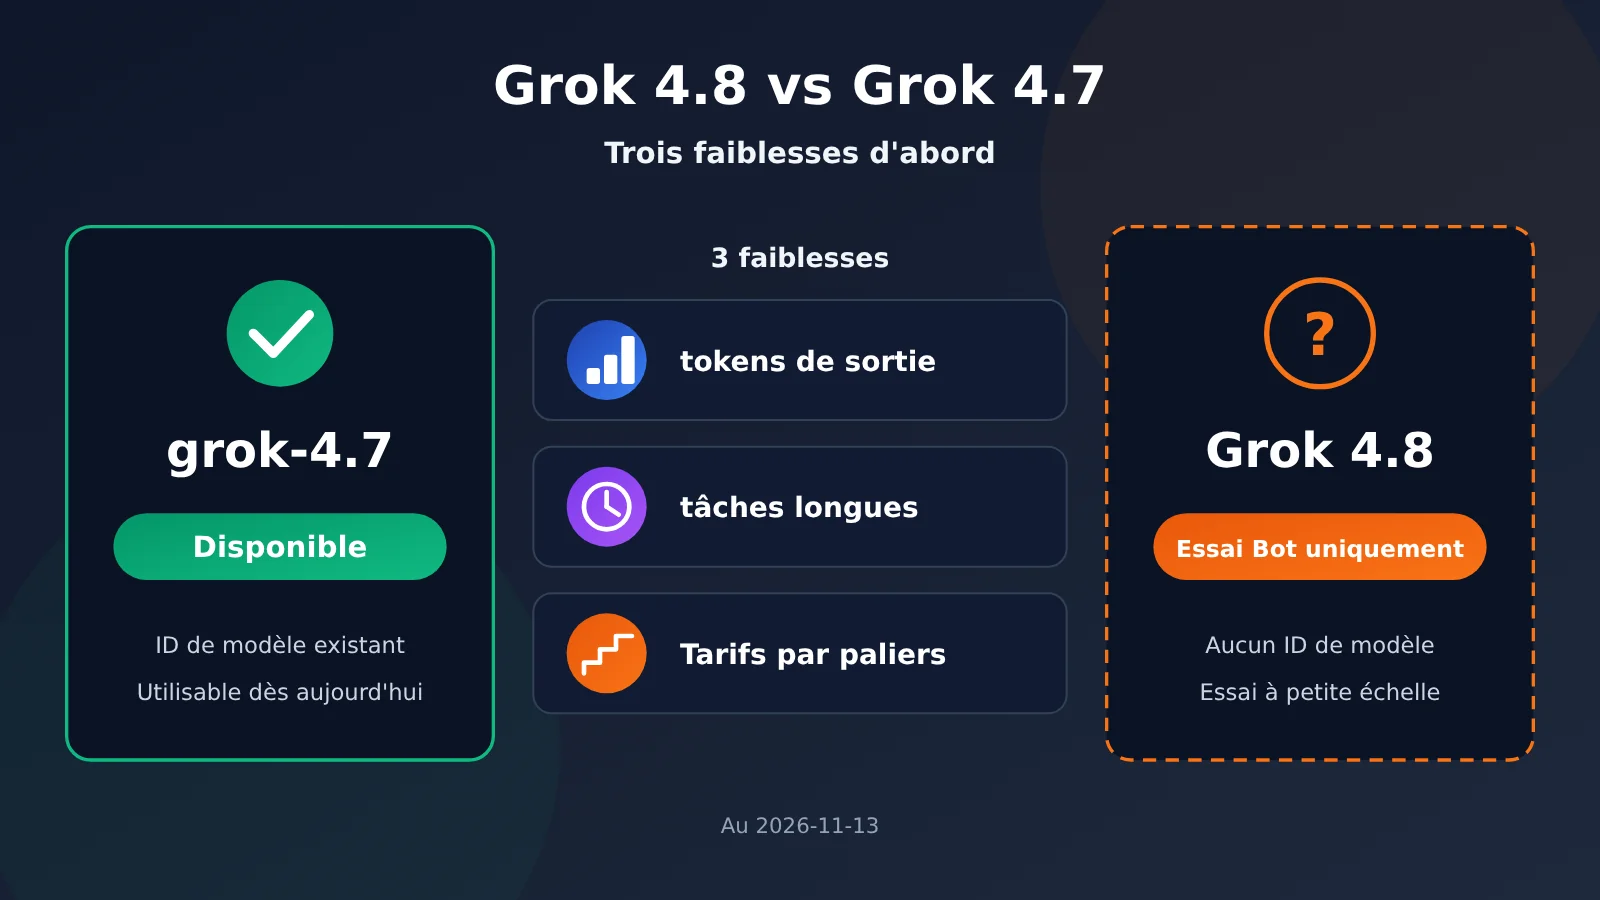
Si vous appelez déjà grok-4.7 en production, vous vous demandez sans doute s’il faut vous arrêter et attendre Grok 4.8. D’abord la conclusion : si vous devez appeler l’API aujourd’hui, utilisez grok-4.7. Au 13 novembre 2026, Grok 4.8 n’a ni ID de modèle, ni fiche modèle, ni score de classement, ni prix. Le « cette semaine » d’Elon Musk ne concerne qu’un test à petite échelle auprès des utilisateurs de Grok Bot (un soft rollout), pas une ouverture de l’API.
Ce n’est pas un article d’annonce qui affirme que « la nouvelle version sera forcément meilleure ». Cet article se contente de comparer trois points faibles identifiables dans les données publiques de Grok 4.7. Chaque point indique sa source : une donnée déclarée par l’éditeur, un classement tiers ou les propos d’Elon Musk. Ensuite, on regarde si Grok 4.8 apporte aujourd’hui des preuves qu’il les comble.
Ce que vous allez y gagner : après lecture, vous saurez où se situent précisément les points faibles de Grok 4.7, de quelles données ils proviennent, et comment maîtriser les coûts par paliers de 200 000 tokens avant la disponibilité de Grok 4.8.
Grok 4.8 face à Grok 4.7 : que choisir aujourd’hui
Cette comparaison ne ressemble pas aux comparatifs habituels entre ancienne et nouvelle version. Pour Grok 4.8, il n’y a pour l’instant que quelques phrases de Musk sur X, sans aucun score vérifiable. Le « comparatif » consiste donc en réalité à se demander : quelles lacunes de Grok 4.7 sont documentées par des données publiques, et les changements connus de Grok 4.8 répondent-ils à ces lacunes ?
| Votre situation | Recommandation | Raison |
|---|---|---|
| Vous devez mettre en production ou modifier une interface cette semaine | Utilisez grok-4.7 | La liste des modèles de la plateforme ne contient que grok-4.7 |
| Vous évaluez un choix à long terme | Commencez par établir une référence avec grok-4.7 | 4.8 n’a pas de classement, impossible de comparer horizontalement |
| Vous voulez tester 4.8 le plus tôt possible | Surveillez la liste des modèles de la plateforme | Une sortie progressive côté Bot ne signifie pas que l’API est disponible |
| Vous avez des exigences très élevées sur les tâches longues | Ne misez pas vos espoirs sur 4.8 | Rien ne prouve que l’écart sur les tâches longues soit comblé |
Une précision s’impose : « Bot users » désigne les utilisateurs de Grok Bot, pas des robots physiques. Un « soft rollout » est un déploiement à petite échelle, pas une interface ouverte aux développeurs. Le prendre pour « un ID de modèle déjà disponible » conduit directement à une erreur d’appel.
Grok 4.8 vs Grok 4.7 : l’origine des 3 points faibles
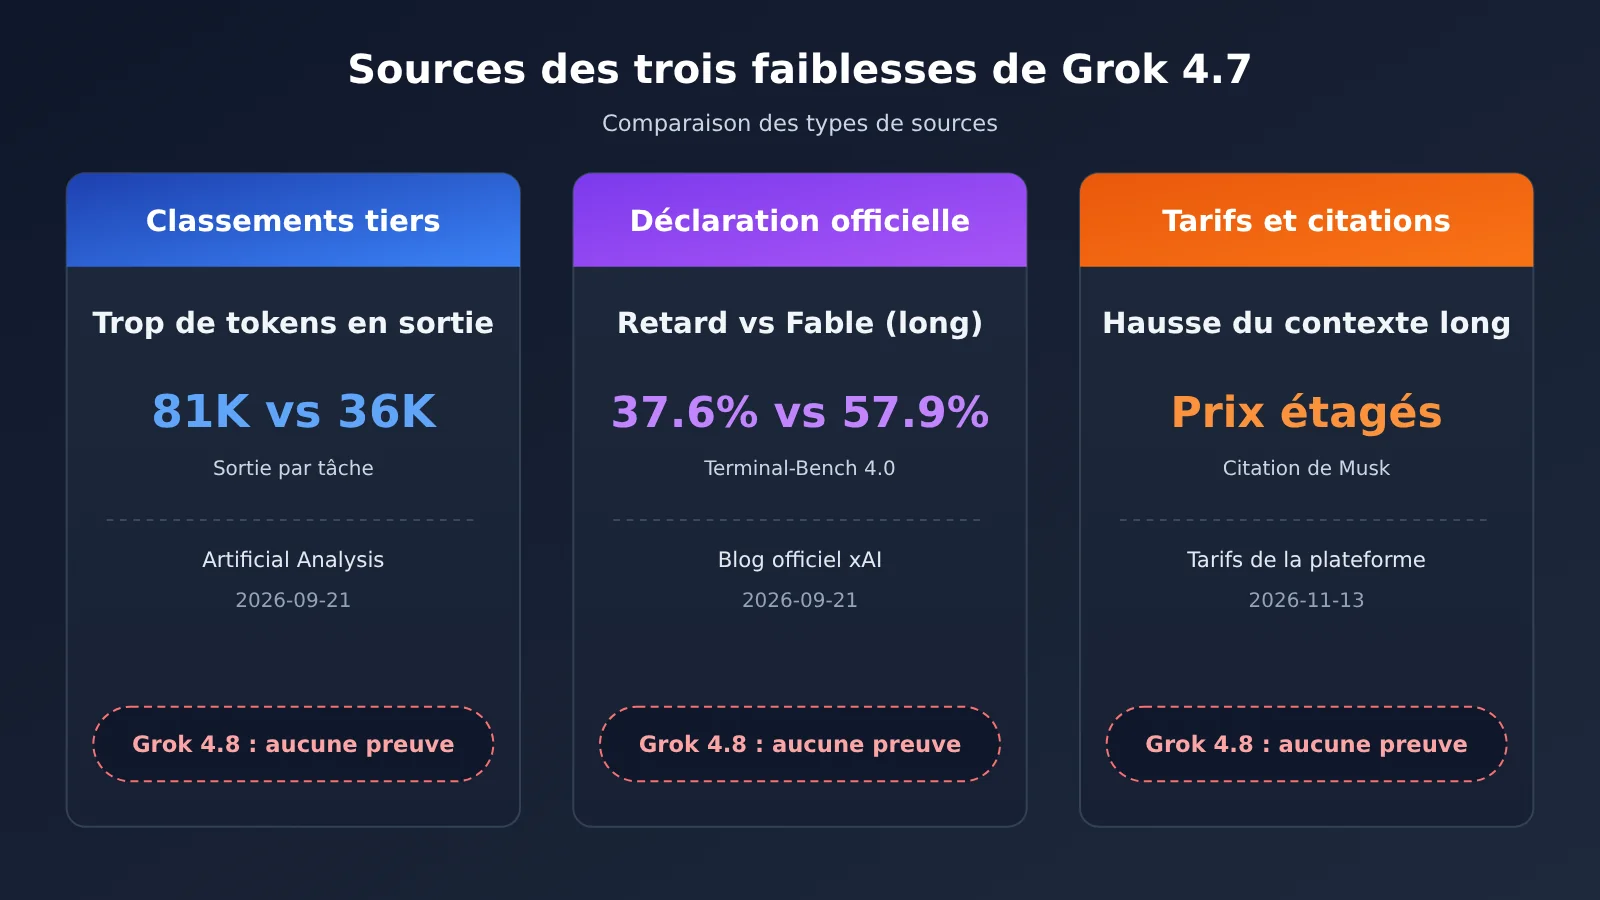
Le tableau ci-dessous indique d’abord le type de source de chacun des trois points faibles. Le développement qui suit respecte strictement cet ordre.
| Point faible | Type de source | Date de la source | Grok 4.8 a-t-il des preuves pour combler l’écart ? |
|---|---|---|---|
| Trop de tokens en sortie | Classement tiers (Artificial Analysis) | 2026-09-21 | Non |
| Retard sur les tâches de plusieurs heures face à Fable | Auto-déclaration officielle (tableau du blog xAI) | 2026-09-21 | Non |
| Tarification par paliers sur le long contexte + Musk ne reconnaît pas les bases | Grille tarifaire de la plateforme + propos de Musk | 2026-11-13 / 2026-11-10 | Non |
Point faible n°1 : Grok 4.7 produit trop de tokens en sortie (classement tiers)
La source, ici, c’est l’évaluation de Grok 4.7 publiée par Artificial Analysis le 2026-09-21. Il s’agit d’un classement tiers : ni des données officielles, ni un test réalisé par l’auteur de cet article. Ils ont testé au niveau xhigh, et l’indice d’intelligence de Grok 4.7 atteint 46, soit 2 points de plus que Grok 4.6. Le score progresse, mais au prix d’une nette hausse des tokens en sortie.
Voici le comparatif des volumes de sortie issu de cette même évaluation — attention, les deux chiffres de Grok 4.6 correspondent à des niveaux différents et ne se cumulent pas :
- Grok 4.7 (xhigh) : environ
81,000tokens en sortie par tâche de l’indice d’intelligence - Grok 4.6 (high) : environ
36,000tokens en sortie - Grok 4.6 (xhigh) : environ
38,000tokens en sortie ; l’évaluation indique que 4.7 fait plus du double - GPT-6 Astra (max) : environ
27,000tokens en sortie
Pour se faire une idée de l’ordre de grandeur, on peut calculer grossièrement avec le prix officiel de sortie $6 / 1M tokens : 81 000 tokens en sortie coûtent environ $0.49, 36 000 environ $0.22. Ce n’est qu’une méthode de conversion pour les tâches du classement, destinée à illustrer « pour une même question, où part l’argent » ; ce n’est en rien la facture réelle d’une plateforme quelconque.
Artificial Analysis précise également que la fenêtre de contexte de Grok 4.7 est de 500K, que le tarif affiché est $2 / $6 et le cache hit $0.50, tous identiques à ceux de 4.6. Autrement dit, le prix unitaire n’a pas bougé, mais chaque tâche recrache davantage de tokens : le coût par tâche augmente bel et bien.
Deuxième point faible : Grok 4.7 reste en retrait face à Fable sur les tâches longues de plusieurs heures (selon l’éditeur)
Cette comparaison provient du tableau comparatif du blog officiel de xAI (2026-09-21) ; il s’agit de chiffres auto-déclarés par l’éditeur. Les quatre colonnes de l’en-tête sont, dans l’ordre : Grok 4.7 xHigh, Grok 4.6 High, GPT-5.6 Sol Max et Fable 5.1 Max. Les deux éléments suivants illustrent le mieux l’écart sur les tâches longues :
- Terminal-Bench 4.0 : Grok 4.7
37.6%, Fable 5.1 Max57.9%(Grok 4.620.3%, GPT-5.6 Sol37.3%) - CursorBench 4.0 : Grok 4.7
46.3%, Fable 5.1 Max51.8%(Grok 4.640.4%, GPT-5.6 Sol41.7%)
Mais le tableau officiel ne montre pas un retard généralisé. Les progrès de Grok 4.7 par rapport à 4.6 sont bien réels, et le modèle arrive en tête sur deux benchmarks spécialisés :
- EEBench : Grok 4.7
64.0%, contre53.0%pour 4.6,39.4%pour GPT-5.6 Sol et56.4%pour Fable 5.1 - Harvey Legal Agent Benchmark : Grok 4.7
19.6%, contre15.8%/2.5%/6.7% - DeepSWE v1.1 : Grok 4.7
71.0%; l’éditeur précise qu’il s’agit du mode high effort et non xhigh, soit légèrement en dessous des72.7%de GPT-5.6 Sol - AA Briefcase v1.1 : Grok 4.7
1657, légèrement en dessous des1678de Fable - HealthBench Professional : Grok 4.7
56.7%, en dessous des60.5%de GPT-5.6 Sol et des62.1%de Fable
| Benchmark du tableau officiel | Par rapport à Grok 4.6 | Par rapport à GPT-5.6 Sol | Par rapport à Fable 5.1 |
|---|---|---|---|
| Terminal-Bench 4.0 | Nettement plus élevé | Globalement équivalent, un peu plus élevé | Écart marqué |
| CursorBench 4.0 | Plus élevé | Plus élevé | Plus faible |
| DeepSWE v1.1 | Plus élevé | Légèrement inférieur | Légèrement supérieur |
| EEBench | Plus élevé | Plus élevé | Plus élevé |
| Harvey Legal Agent | Plus élevé | Plus élevé | Plus élevé |
| HealthBench Professional | Plus élevé | Plus faible | Plus faible |
Un classement tiers fournit un autre jeu de données, qu’il faut signaler séparément. L’évaluation d’Artificial Analysis montre que, par rapport à Grok 4.6, Grok 4.7 gagne 4.5 points sur Terminal-Bench 4.0 et 3.0 points sur GDP.pdf ; en revanche, il perd 3.7 points sur AA-LCR et 1.1 point sur AutomationBench-AA. Les « +4.5 points » évoqués ici et les 37.6% face à 20.3% du tableau officiel ne relèvent pas du même référentiel de scores absolus : il ne faut pas les mélanger.
Point faible n° 3 : les paliers tarifaires de Grok 4.7 et les propos de Musk (grille + citations)
Ce troisième point comporte deux volets : d’une part le prix du contexte long, d’autre part l’attitude de Musk lui-même vis-à-vis de la version 4.7. Commençons par le prix. Le tableau récapitulatif de la plateforme et l’interface de tarification ne concordent pas totalement au-delà de 200 000 tokens :
| Élément de prix | Tableau récapitulatif des modèles | Interface de tarification billing_expr |
|---|---|---|
| Entrée / sortie / lecture de cache ≤ 200 000 tokens | Indiqué | Indiqué, identique au tableau récapitulatif |
| Entrée au-delà de 200 000 | Indiqué | Indiqué, identique au tableau récapitulatif |
| Sortie au-delà de 200 000 | Non indiqué séparément | Indiqué |
| Lecture de cache au-delà de 200 000 | Non indiqué séparément | Indiqué |
Les chiffres concrets sont les suivants ; les données tarifaires datent du 2026-11-13 et l’unité est le prix pour 1 M de tokens :
- Palier bas (0–200 000 tokens) : entrée
$2, sortie$6, lecture de cache$0.5— le tableau récapitulatif et l’expression tarifaire concordent - Entrée du palier haut (200 001–500 000 tokens) :
$4— le tableau récapitulatif et l’expression tarifaire concordent - Sortie du palier haut : l’expression tarifaire indique
$12, la grille du tableau récapitulatif ne le mentionne pas - Lecture de cache du palier haut : l’expression tarifaire indique
$1, la grille du tableau récapitulatif ne le mentionne pas
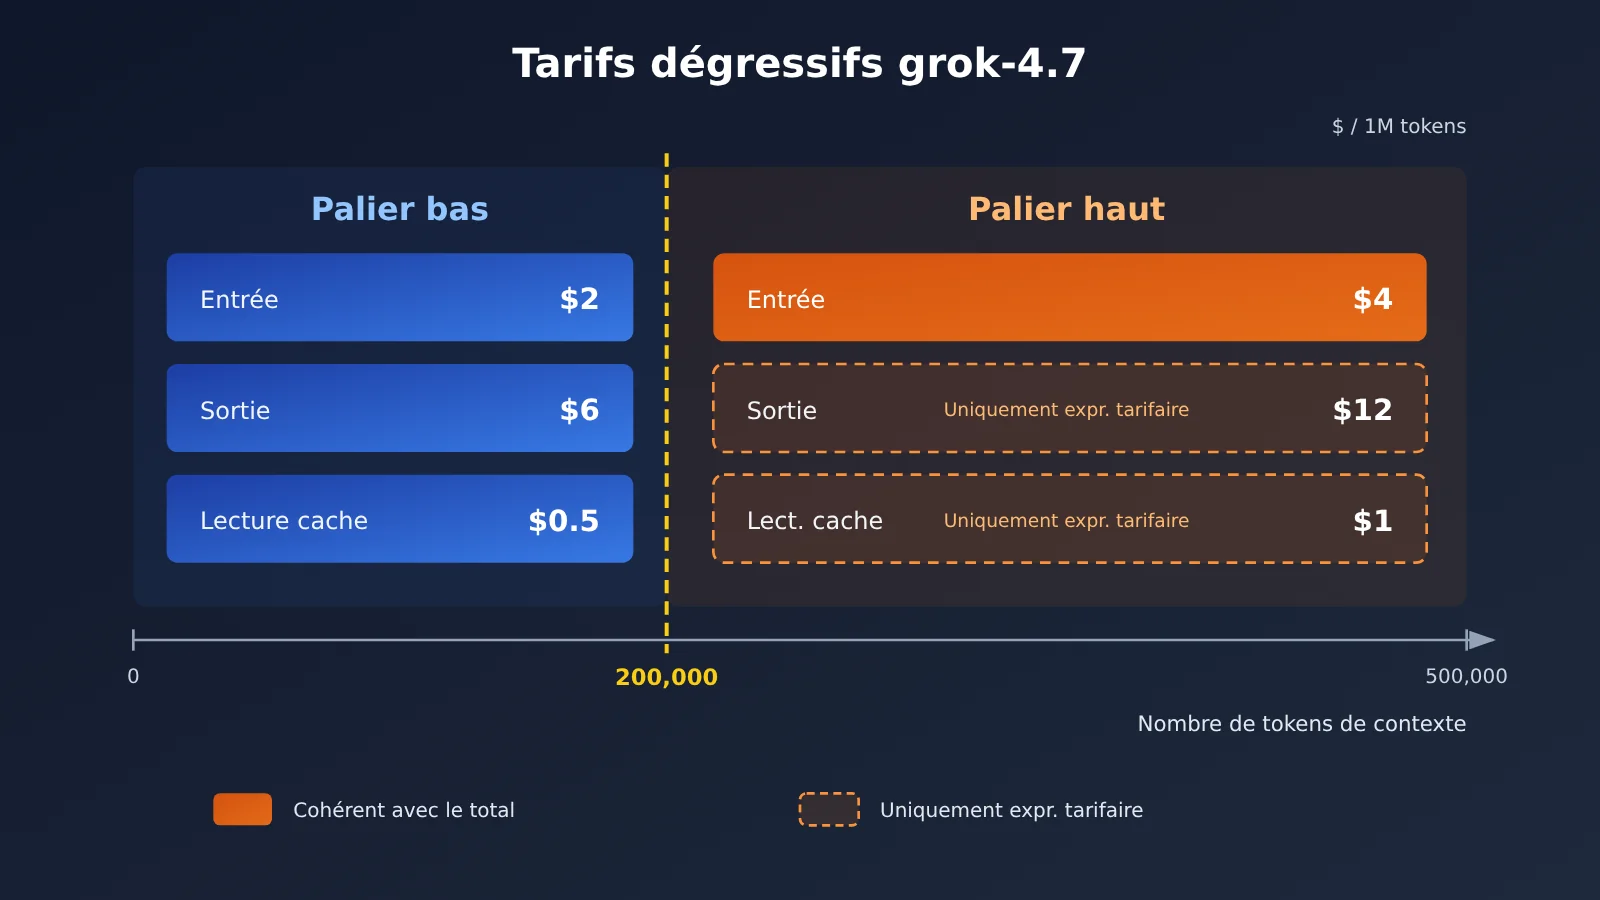
Les informations tarifaires ci-dessus proviennent de l’interface de tarification et du tableau récapitulatif des modèles d’APIYI apiyi.com ; vérification effectuée le 2026-11-13, la liste des modèles de la plateforme faisant foi.
Passons aux propos. Le 2026-11-10 à 17 h 35, Musk a déclaré sur X que Grok 4.8 « will bear no resemblance to 4.7 (thankfully). It is not yet incredible ». Le même jour à 18 h 22, il ajoutait dans une réponse : « Not as good. Opus 5.5 is a masterpiece. », autrement dit que la 4.8 reste en dessous d’Opus 5.5. Il estimait par ailleurs que Grok 5 devrait dépasser Opus 5.5 dans les deux ou trois mois.
Ce sont des opinions, pas les scores de Grok 4.8. Quand un fondateur dit d’une nouvelle version qu’elle « ne ressemble pas à la 4.7, et heureusement », cela prouve seulement qu’il ne valide pas les bases de la 4.7 — on ne peut pas en déduire que la 4.8 a corrigé les trois points faibles évoqués plus haut.
Grok 4.8 peut-il combler ces 3 lacunes ?
Tout ce que l’on peut affirmer provient du post original d’Elon Musk. Il y mentionne l’abandon de JAX/SGLang au profit d’une réécriture de zéro, en C/C++, de la pile d’apprentissage par renforcement (RL) et d’inférence ; le pré-entraînement est terminé ; les données SFT ont été largement nettoyées ; le 4.8 en est actuellement à la phase RL, et « evals are starting to climb ». Le post ne donne aucun nom de benchmark, aucun score, ni le nombre de paramètres.
Si l’on confronte ces informations aux trois points faibles, la conclusion reste très prudente :
- Trop de tokens en sortie : la phase RL peut effectivement influer sur la longueur des réponses, mais il ne parle pas d’efficacité en tokens.
- Retard sur les tâches longues face à Fable : aucune mention de Terminal-Bench ni de CursorBench, et pas la moindre donnée sur les tâches longues.
- Tarification au-delà de 200 000 tokens : aucune information de prix, et le 4.8 n’apparaît sur aucune grille tarifaire.
On en reste donc au niveau de la supposition : « pile RL et inférence réécrites, données SFT nettoyées ». Rien ne prouve pour l’instant que les trois points ci-dessus sont corrigés. Il faudra attendre que le 4.8 dispose d’une fiche modèle et de benchmarks tiers pour qu’une comparaison point par point ait du sens.
Utiliser grok-4.7 dès maintenant : comment gérer les paliers à 200 000 tokens
Avant la mise en ligne du 4.8, la démarche la plus concrète consiste à bien maîtriser le coût de grok-4.7. Le point clé, c’est la barre des 200 000 tokens : dès que l’entrée la franchit, le prix unitaire double directement, et selon l’expression tarifaire, la sortie et la lecture de cache doublent également. Voici les informations d’accès exploitables et les recommandations par palier :
- ID du modèle :
grok-4.7, endpoint chat, groupesCodexResponses,Default,SVIP - Adresse de l’API : format compatible OpenAI, renseignez
https://api.apiyi.com/v1dans base_url et définissez model surgrok-4.7 - Maîtrise du palier bas : gardez autant que possible le contexte d’une requête sous
200,000tokens ; remplacez l’injection d’un document entier par des résumés ou des extraits issus de la recherche - Budget du palier haut : si le contexte long est vraiment nécessaire, partez sur entrée
$4, sortie$12, lecture de cache$1, et gardez à l’esprit l’incohérence du tableau général, qui ne précise pas la sortie du palier haut - Longueur de sortie : en lien avec la première lacune, fixez max_tokens sur les tâches concernées pour éviter que la sortie ne s’emballe aux niveaux de raisonnement élevés
Les modèles et les prix font foi sur la liste des modèles de la plateforme ; consultez docs.apiyi.com/models pour les informations à jour. Le blog officiel mentionne aussi une variante fast de Grok 4.7, environ deux fois plus rapide en sortie et deux fois plus chère, mais le tableau général de la plateforme ne comporte pas d’ID de modèle fast distinct : ne l’inventez pas au moment de l’appel.
🚀 Démarrage rapide : dès que grok-4.8 sera disponible, APIYI apiyi.com publiera ce modèle au plus vite. En attendant, établissez une base avec grok-4.7 en utilisant la même clé API ; quand le 4.8 sera disponible, il suffira de changer le paramètre model pour comparer.
Grok 4.8 vs Grok 4.7 : recommandations par scénario
Cas où il vaut mieux continuer avec Grok 4.7
- Tâches juridiques et d’ingénierie : dans le tableau officiel, Grok 4.7 arrive en tête sur les deux items EEBench et Harvey Legal Agent. Pour ce type de tâche, il n’y a aucune raison d’attendre.
- Activités dont le contexte reste sous 200 000 tokens : vous pouvez rester tranquillement dans la tranche tarifaire basse, le prix unitaire étant identique à celui de la 4.6.
- Projets qui doivent être mis en ligne immédiatement : grok-4.7 est actuellement la seule version disponible.
Cas où il vaut la peine de surveiller Grok 4.8
- Agents de plusieurs heures / tâches longues en terminal : l’écart sur Terminal-Bench 4.0 et Fable 5.1 est net, il est donc judicieux d’évaluer en parallèle d’autres modèles comme solution de repli.
- Tâches par lots sensibles au coût des tokens de sortie : les classements tiers indiquent que la 4.7 produit des sorties plutôt longues ; si la 4.8 s’améliore, cela réduira directement les coûts, mais on n’en a pour l’instant aucune preuve.
- Applications qui s’appuient massivement sur un contexte supérieur à 200 000 tokens : le tarif de la tranche haute double, il faudra donc surveiller le mode de facturation de la 4.8 une fois disponible.
Grok 4.8 vs Grok 4.7 : conseils de décision
| Point d’attention | Action actuelle | Quand réévaluer |
|---|---|---|
| Stabilité de mise en production | Utiliser grok-4.7 | Quand la 4.8 apparaît dans la liste des modèles de la plateforme |
| Coût par tâche | Maîtriser le contexte et la longueur des sorties | Quand on disposera de données tierces sur les tokens consommés par la 4.8 |
| Capacité sur les tâches longues | Évaluer des modèles alternatifs en parallèle | Quand la 4.8 publiera des scores Terminal-Bench, etc. |
| Transparence des prix | Budgéter d’après l’API des tarifs | Quand le tableau récapitulatif de la plateforme complètera les prix de sortie de la tranche haute |
💡 Conseil de choix : la version à retenir dépend de si votre tâche est une tâche longue et si vous dépassez souvent les 200 000 tokens. Je vous suggère de faire tourner vos propres échantillons via APIYI apiyi.com avec la même interface, puis de décider si vous basculez vos tâches longues vers un autre modèle.
FAQ — Questions fréquentes
Q1 : Peut-on déjà appeler Grok 4.8 via API ?
Non. Au 13 novembre 2026, Grok 4.8 n’a pas d’ID de modèle : le tableau général des modèles de la plateforme comme l’interface de tarification ne listent que grok-4.7. La « soft launch » de cette semaine évoquée par Musk ne concerne que les utilisateurs de Grok Bot.
Q2 : Entre Grok 4.8 et Grok 4.7, lequel est vraiment le plus fort ?
Impossible de trancher pour l’instant. Grok 4.8 n’apparaît sur aucun classement public et n’a aucun score ; Musk se contente de dire que « les évaluations progressent », que le modèle « n’est pas encore impressionnant » et qu’il « reste en dessous d’Opus 5.5 ». Ce sont des impressions, pas des données comparables.
Q3 : D’où vient l’affirmation selon laquelle Grok 4.7 produit beaucoup de tokens en sortie ?
Elle vient de l’évaluation tierce d’Artificial Analysis du 21 septembre 2026, sur le palier de test xhigh. Environ 81 000 tokens de sortie par tâche, contre 36 000 pour 4.6 high et 38 000 pour 4.6 xhigh. Ce ne sont pas des données officielles.
Q4 : Grok 4.7 est-il globalement moins bon que Grok 4.6 ?
Non. Dans le tableau officiel, Grok 4.7 dépasse 4.6 sur plusieurs benchmarks, dont Terminal-Bench, CursorBench et EEBench. Les classements tiers montrent en revanche un recul de 3,7 points sur AA-LCR et de 1,1 point sur AutomationBench-AA : ce sont des baisses ponctuelles.
Q5 : Comment appeler grok-4.7 dès maintenant ?
Inscrivez-vous sur APIYI apiyi.com et récupérez une clé API ; les nouveaux utilisateurs disposent d’un quota de test gratuit. Utilisez un SDK compatible OpenAI, renseignez l’URL de l’interface de la plateforme dans base_url et mettez model sur grok-4.7, c’est tout.
Q6 : À quel tarif sont facturées les sorties au-delà de 200 000 tokens ?
L’expression de tarification indique 12 $ en sortie et 1 $ en lecture de cache ; la grille générale ne mentionne qu’une entrée à 4 $ pour le palier supérieur, sans ligne distincte pour la sortie haut de gamme. Les deux sources ne concordent pas totalement : pour établir un budget, mieux vaut estimer prudemment à partir de l’expression de tarification et se fier à la liste des modèles de la plateforme.
Q7 : Comment migrer une fois Grok 4.8 disponible ?
Le fil d’actualité temps réel de la plateforme ne signale encore aucune mise en ligne de Grok 4.8. Une fois le modèle disponible, il suffit normalement de remplacer le paramètre model ; mieux vaut toutefois comparer d’abord, sur un même jeu d’échantillons, les tokens de sortie, le taux de réussite sur les tâches longues et le coût par palier, avant de basculer le trafic.
Points clés de la comparaison Grok 4.8 vs Grok 4.7
- Le choix du jour : pour appeler l’API, prenez grok-4.7 ; Grok 4.8 n’a pas encore d’ID de modèle.
- Premier point faible (classements tiers) : en mode xhigh, environ 81 000 tokens de sortie par tâche, c’est long.
- Deuxième point faible (déclaration officielle) : Terminal-Bench et CursorBench restent derrière Fable 5.1.
- Pas un retard généralisé : sur EEBench et Harvey, Grok 4.7 est premier.
- Troisième point faible (tarifs + citations) : au-delà de 200 000 tokens d’entrée, le prix double, et le fondateur ne reconnaît pas la base de la 4.7.
- Ce qu’on sait des changements de la 4.8 : réécriture du RL et de la pile d’inférence, nettoyage du SFT, mais aucune preuve que les trois points faibles soient comblés.
- Comment démarrer : passer d’abord par APIYI apiyi.com pour établir une base grok-4.7, puis comparer directement dès que la 4.8 sera disponible.
En résumé
L’essentiel de la comparaison Grok 4.8 vs Grok 4.7 :
- Disponibilité : au 13 novembre 2026, seul grok-4.7 peut être appelé. Une version préliminaire via le bot ne signifie pas que l’API est ouverte.
- Trois points faibles : trop de tokens en sortie (classements tiers), retard sur les tâches longues face à Fable (déclaration officielle), hausse des tarifs sur le contexte long et position du fondateur (tarifs et citations). Les sources sont différentes à chaque fois.
- Les preuves pour la 4.8 : pour l’instant, seules des déclarations sur la réécriture du RL et de la pile d’inférence, et le nettoyage du SFT. Aucun score, aucun prix, aucune fiche modèle.
Plutôt que d’attendre sans rien faire, mieux vaut commencer par bien gérer les paliers de contexte et la longueur de sortie de grok-4.7, puis comparer point par point quand la 4.8 aura des données vérifiables. Je recommande de passer par APIYI apiyi.com pour valider d’abord les performances de grok-4.7 sur votre activité via une interface unifiée, et ainsi garder une base de référence pour la suite.
📚 Références
- Blog officiel xAI – Lancement de Grok 4.7 : tableau comparatif des benchmarks et tarification annoncés par l’éditeur
- Lien :
x.ai/news/grok-4-7 -
Description : source des données Terminal-Bench 4.0, CursorBench 4.0, EEBench, etc.
-
Artificial Analysis – Évaluation de Grok 4.7 : classement tiers, incluant la consommation de tokens en sortie
- Lien :
artificialanalysis.ai/articles/benchmarking-grok-4-7 -
Description : indice d’intelligence, comparaison des tokens en sortie, évolution des métriques AA-LCR, etc.
-
Post X d’Elon Musk (2026-11-10) : déclarations originales sur les avancées de Grok 4.8
- Lien :
x.com/elonmusk/status/2120088070443655190 -
Description : réécriture du RL et de la pile d’inférence, nettoyage du SFT, lancement en douceur du Bot
-
Réponse d’Elon Musk sur X (2026-11-10) : prise de position comparative entre 4.8 et Opus 5.5
- Lien :
x.com/elonmusk/status/2120099798078656909 -
Description : origine de la mention « Not as good »
-
Tableau récapitulatif des modèles APIYI : modèles grok-4.7, groupes et tarification par paliers
- Lien :
docs.apiyi.com/models - Description : référence pour les modèles et les prix, vérification au 2026-11-13
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; vous trouverez davantage de ressources sur le centre de documentation docs.apiyi.com