Note de l’auteur : inutile de changer de modèle dès qu’un 429 apparaît. Cet article propose un diagnostic en 3 étapes pour déterminer si la limitation vient du fournisseur en amont, de la passerelle ou du palier gratuit, et donne les configurations de backoff exponentiel, de Retry-After et de basculement.
Pendant un traitement par lots au milieu de la nuit, le journal déverse soudain tout un écran de 429 Too Many Requests. Le premier réflexe de beaucoup de gens : « ce modèle ne tient pas la route, changeons-en vite ». Ce jugement est presque toujours prématuré. Un 429 dit seulement que quelqu’un vous a limité — pas qui, ni sur quelle dimension. La thèse de cet article : localiser d’abord la source de la limitation, puis décider entre backoff et bascule.
Ce n’est pas un énième article générique sur les retries. Nous allons suivre l’ordre réel d’un diagnostic : décomposer le message d’erreur, les en-têtes de réponse et les dimensions de limitation, avant de proposer des paramètres de backoff et une chaîne de basculement.
L’essentiel : à la fin de cet article, vous saurez en quelques minutes si un 429 vient du fournisseur en amont, d’une passerelle intermédiaire ou du quota du palier gratuit, et vous aurez configuré pour votre application une stratégie de tolérance aux pannes qui « attend quand il faut attendre, bascule quand il faut basculer ».
Points clés pour identifier une limitation 429
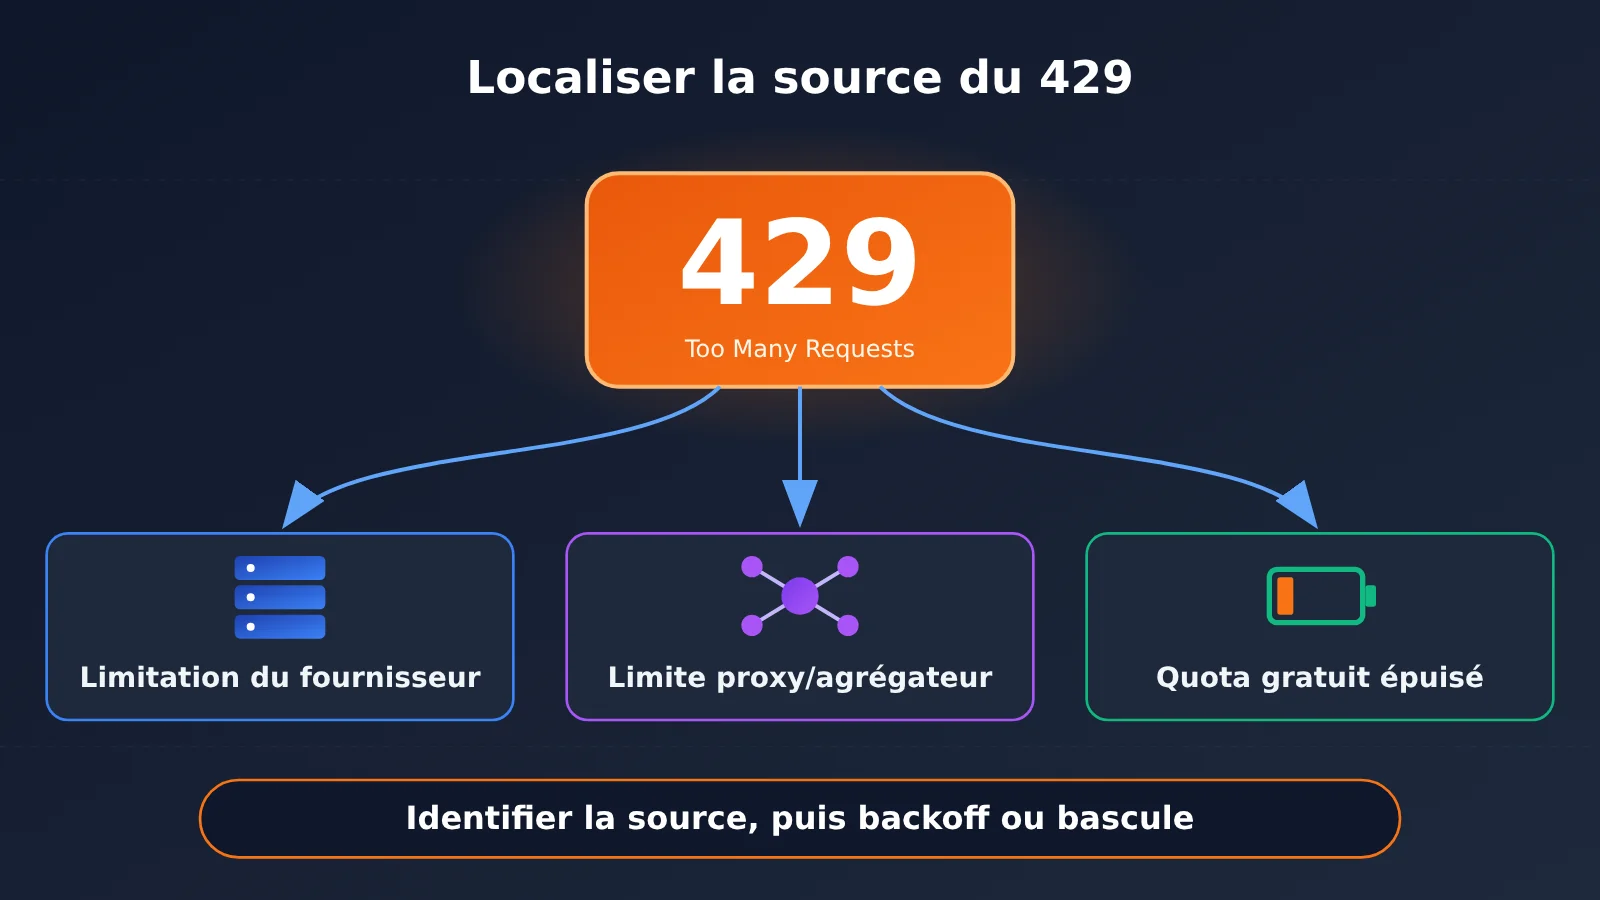
Le 429 est le code de statut HTTP standard pour « trop de requêtes ». Dans le contexte des API de grands modèles de langage, il peut être renvoyé par n’importe quelle couche de la chaîne d’appel. Le tableau ci-dessous récapitule les trois sources les plus courantes et la bonne façon de réagir pour chacune.
| Source de limitation | Caractéristiques typiques | Faut-il changer de modèle | Traitement recommandé |
|---|---|---|---|
| Fournisseur du modèle en amont | Le corps d’erreur contient le type d’erreur et le libellé propres au fournisseur ; les en-têtes de réponse incluent ses champs de limitation | Généralement non | Appliquer un backoff selon Retry-After, réduire la concurrence ou demander une augmentation de quota si nécessaire |
| Passerelle intermédiaire / plateforme d’agrégation | Le libellé d’erreur vient de la passerelle et mentionne un débit au niveau du compte ou du groupe | Non | Vérifier les quotas et les paramètres de concurrence côté passerelle, ou changer de groupe de passerelle |
| Offre gratuite / quota d’essai | Mentionne un quota gratuit, un nombre quotidien d’appels ou une capacité insuffisante | Selon le cas | Passer à une offre payante ou basculer vers un modèle équivalent disposant de capacité |
Pourquoi un 429 ne signifie pas que le modèle est en panne
Lorsque le modèle lui-même est indisponible, le signal le plus courant est une erreur de la série 5xx. Par exemple, une surcharge d’Anthropic renvoie 529 overloaded_error, et les anomalies de passerelle ou d’équilibrage de charge donnent souvent 502 ou 503. Ces codes indiquent que le serveur ne peut temporairement pas traiter la demande, ce qui n’a rien à voir avec « votre compte a dépassé son quota ».
Le 429, lui, porte une signification claire d’attribution : la règle de limitation vous cible, que ce soit votre clé API, votre organisation, votre offre gratuite ou le débit que la passerelle vous a attribué. Changer de modèle peut parfois contourner le problème, mais si la limitation vient d’un quota au niveau du compte de la passerelle, changer de modèle se heurtera au même mur. Si la limitation vient de la limite de tokens par minute du fournisseur en amont, attendre quelques secondes suffit à rétablir la situation ; changer de modèle introduit au contraire une incertitude sur la qualité de sortie.
Un guide de dépannage tiers consacré à Claude Code confirme également ce point : lorsqu’il rencontre un 429, Claude Code affiche Request rejected (429), suivi du message exact du serveur. Et c’est précisément ce message qui vous indique si la limitation vient d’Anthropic, de la passerelle ou de l’offre gratuite. Le premier réflexe de diagnostic est donc toujours de lire le message d’erreur complet, et pas seulement le code de statut.
Différences entre 429 et les codes d’état voisins
Pour éviter de confondre des erreurs différentes, le tableau ci-dessous récapitule les codes d’état souvent pris à tort pour un 429 lors de l’invocation d’un grand modèle de langage.
| Code d’état | Signification | Responsabilité | Nouvelle tentative adaptée ? | Basculement adapté ? |
|---|---|---|---|---|
| 429 | Trop de requêtes, limite de débit ou de quota atteinte | Quota de l’appelant | Oui, avec backoff | Oui, après échec du backoff |
| 529 | Surcharge amont (spécifique à Anthropic) | Capacité côté serveur | Oui, bref backoff | Oui |
| 503 | Service temporairement indisponible | Serveur ou passerelle | Oui | Oui |
| 500/502 | Erreur interne ou erreur de passerelle | Serveur ou passerelle | Nouvelle tentative en nombre limité | Oui |
| 400/401/403 | Problème de paramètre, d’authentification ou de permission | Configuration de l’appelant | Non | Non, corriger la configuration |
Un détail de ce tableau est facile à manquer : d’après des tests tiers, le mécanisme fallbackModel de Claude Code ne se déclenche qu’en cas de surcharge 529, avec jusqu’à 3 modèles de secours essayés, et non en cas de 429. Cela signifie que les concepteurs de l’outil considèrent eux aussi que la première réaction face à un 429 doit être un backoff, pas un changement de modèle.
Comment déterminer qui est à l’origine d’une limitation 429 : diagnostic en 3 étapes
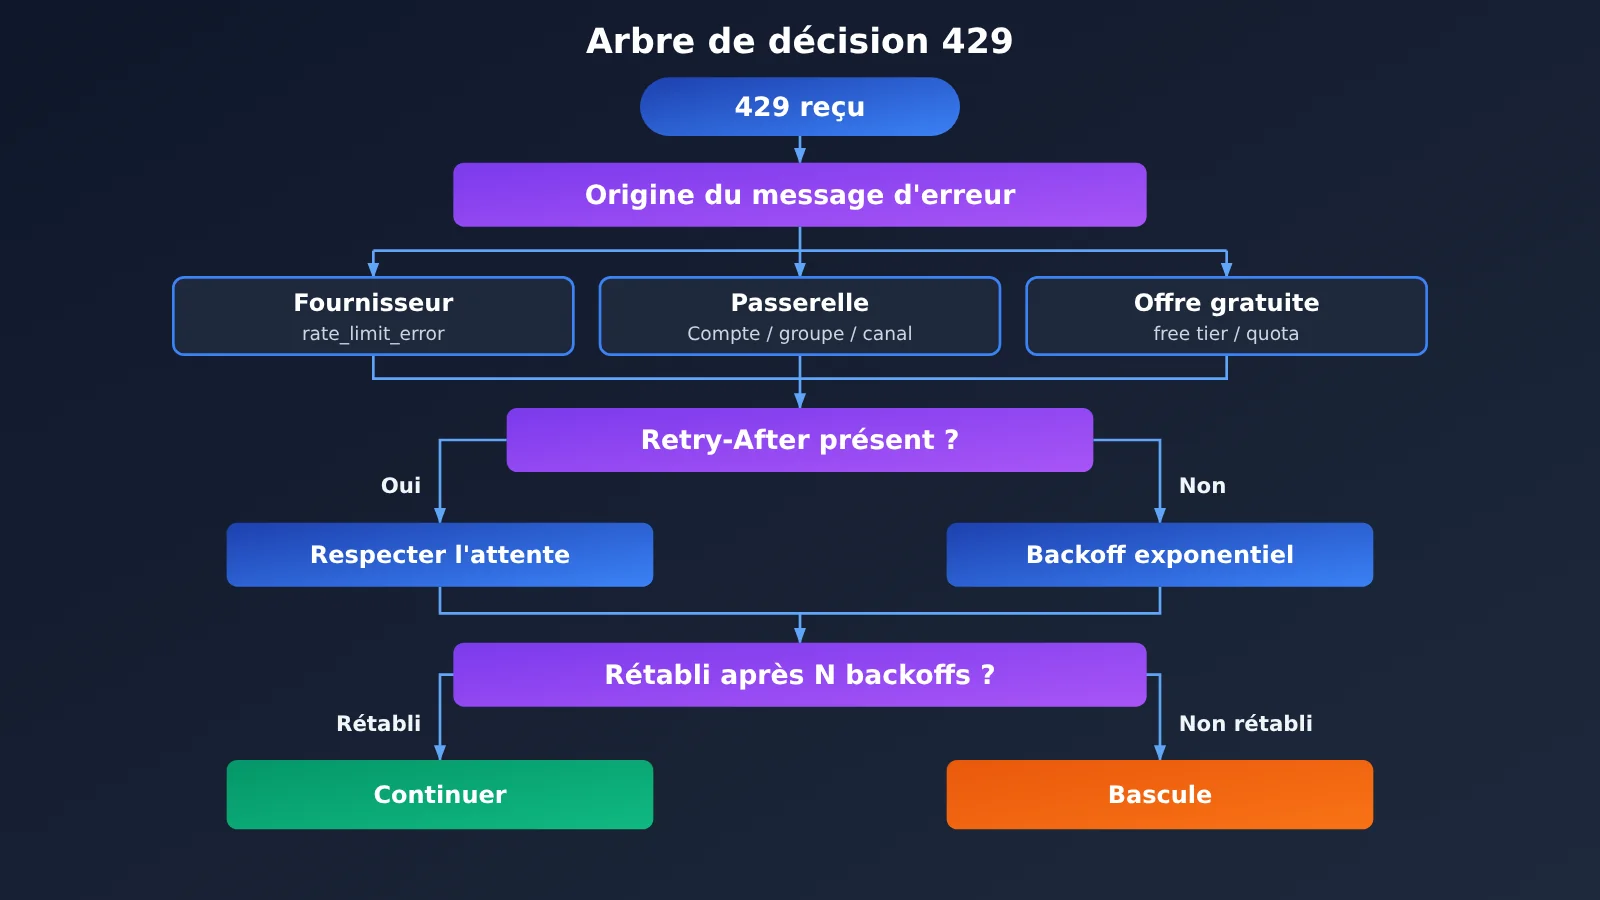
Voici une procédure de diagnostic 429 que vous pouvez appliquer telle quelle. Les trois étapes sont classées par coût croissant ; dans la plupart des cas, la première suffit à identifier la source.
Étape 1 : lisez le corps complet de l’erreur 429
Ne vous contentez pas d’enregistrer le code de statut dans les logs : conservez le corps de la réponse tel quel. Les 429 renvoyés par les différentes couches présentent des formulations très différentes ; c’est l’indice le plus direct.
- Renvoi par le fournisseur en amont : le corps de l’erreur contient généralement un champ de type d’erreur propre au fournisseur. Par exemple, Anthropic indique le type
rate_limit_error, et les API de style OpenAI renvoient un code d’erreur du genrerate_limit_exceeded, en précisant si la limite concerne le nombre de requêtes ou le nombre de tokens. - Renvoi par la passerelle : la formulation mentionne souvent des notions propres à la passerelle, comme « compte », « groupe », « jeton » ou « canal », ou indique explicitement le nom de la passerelle.
- Renvoi par l’offre gratuite : on y trouve des mentions comme « free tier », « quota », « daily limit » ou « capacity ». Dans les tests réalisés par des tiers sur les essais gratuits de certains modèles, ce type de 429 lié à la capacité est fréquent.
Si vous passez par une plateforme proxy ou un agrégateur, faites particulièrement attention à ce que la passerelle relaie ou non l’erreur originale de l’amont. Si elle la relaie telle quelle, c’est l’amont qui vous limite ; si elle renvoie une formulation personnalisée, c’est la passerelle qui vous limite.
Étape 2 : vérifier les en-têtes de la réponse 429
Les en-têtes de réponse constituent la deuxième chaîne de preuves. Les principaux fournisseurs renvoient généralement le quota restant et le délai de réinitialisation dans ces en-têtes, et la passerelle peut aussi y ajouter ses propres champs.
| En-tête de réponse | Source courante | Signification | Utilité pour le diagnostic |
|---|---|---|---|
Retry-After |
Standard HTTP, largement utilisé | Nombre de secondes à attendre recommandé | À privilégier pour le backoff |
x-ratelimit-remaining-requests |
API de style OpenAI | Nombre de requêtes restantes dans la fenêtre actuelle | Déterminer s’il s’agit d’une limitation RPM |
x-ratelimit-remaining-tokens |
API de style OpenAI | Nombre de tokens restants dans la fenêtre actuelle | Déterminer s’il s’agit d’une limitation TPM |
anthropic-ratelimit-requests-remaining |
Anthropic | Nombre de requêtes restantes | Confirmer que la limitation vient d’Anthropic |
anthropic-ratelimit-input-tokens-remaining |
Anthropic | Nombre de tokens d’entrée restants | Déterminer s’il s’agit d’une limitation sur les tokens d’entrée |
La règle de diagnostic est simple : si un en-tête de limitation préfixé par le fournisseur est présent et que la valeur restante est à 0, il y a de fortes chances que ce soit le fournisseur en amont qui vous limite ; s’il n’y a aucun en-tête de limitation de fournisseur, seulement des champs personnalisés de la passerelle, ou rien du tout, c’est plutôt du côté de la passerelle qu’il faut chercher. Attention : ces dernières années, certains fournisseurs n’affichent plus les quotas précis que dans leur console ; les informations des en-têtes de réponse peuvent donc être incomplètes. Dans ce cas, revenez au libellé d’erreur de l’étape 1 et à la comparaison des dimensions de l’étape 3.
Étape 3 : identifier la dimension concernée par la limitation
Savoir qui vous limite, c’est bien ; encore faut-il comprendre ce qui est limité. Les règles ne sont pas harmonisées d’un fournisseur à l’autre. Une comparaison transversale menée par un tiers sur 5 fournisseurs montre que : Anthropic limite principalement en tokens par minute, et les tokens servis depuis le cache ne sont pas comptabilisés dans le quota ; DeepSeek limite surtout le nombre de requêtes simultanées ; pour OpenAI et Google, les quotas précis se consultent plutôt dans la console.
Cela a un impact direct sur la stratégie de configuration. Les correspondances les plus courantes sont les suivantes :
- Dépassement du RPM (requêtes par minute) : regrouper plusieurs petites requêtes en une requête batch, ou ajouter un token bucket côté client pour envoyer à débit constant.
- Dépassement du TPM (tokens par minute) : raccourcir le contexte, activer la mise en cache des invites, découper les tâches sur documents longs en plusieurs fenêtres temporelles.
- Dépassement du nombre de requêtes simultanées : réduire le nombre de workers, contrôler via une file d’attente le nombre de requêtes en vol ; le simple backoff a ici un effet limité.
- Quota journalier ou crédit gratuit épuisé : le backoff ne sert à rien, il faut attendre la remise à zéro, changer d’offre ou basculer vers un autre canal.
Le quatrième cas est le seul type de 429 pour lequel « le backoff est voué à l’échec ». C’est aussi celui qu’il faut détecter au plus vite pour passer directement au basculement (failover).
Comment configurer une stratégie de backoff pour les erreurs 429
Une fois confirmé que le 429 correspond à une limitation de débit récupérable, on entre dans la phase de backoff. L’objectif du backoff n’est pas de « réessayer au plus vite », mais de « récupérer au plus vite sans aggraver la congestion ».
Backoff exponentiel avec jitter aléatoire
La solution la plus courante est le backoff exponentiel (Exponential Backoff) avec jitter aléatoire. Le temps d’attente de la n-ième tentative est d’environ « délai de base × 2 puissance n », auquel on ajoute une quantité aléatoire, avec une limite supérieure. Le jitter aléatoire sert à étaler les instants de nouvelle tentative de plusieurs clients, afin d’éviter qu’ils frappent tous à la même seconde et créent une « tempête de retries ».
Si la réponse contient Retry-After, sa priorité doit être supérieure au temps de backoff que vous avez calculé vous-même. Le serveur sait mieux que vous quand la fenêtre se réinitialise ; attendre selon sa recommandation est souvent le moyen de récupérer le plus vite.
Valeurs recommandées pour les paramètres de backoff
Le tableau ci-dessous donne un jeu de paramètres de départ adaptés à la plupart des scénarios de conversation et de traitement par lots. En pratique, ajustez-les selon la tolérance de latence de votre activité.
| Paramètre | Valeur de départ recommandée | Description |
|---|---|---|
| Délai de base | 1 seconde | Temps d’attente avant la première nouvelle tentative |
| Multiplicateur de backoff | 2 | Le temps d’attente double à chaque tentative |
| Attente maximale par tentative | 30-60 secondes | Empêche le temps d’attente de croître indéfiniment |
| Nombre maximal de tentatives | 3-5 fois | Au-delà, basculer vers un fallback ou renvoyer une erreur |
| Jitter aléatoire | 0-100 % du temps d’attente, aléatoire | Mode « full jitter » recommandé, pour étaler les tentatives |
| Retry-After | Prioritaire s’il est présent | Remplace le temps de backoff calculé localement |
Deux détails de configuration sont souvent négligés. Premièrement, dans les scénarios interactifs (par exemple une interface de chat), le temps d’attente total ne doit pas être trop long : il est conseillé de définir un budget de timeout global, au-delà duquel on bascule directement ou on prévient l’utilisateur. Deuxièmement, ne faites pas de backoff/retry sur des erreurs de configuration comme 400, 401, 403 : attendre plus longtemps ne les fera pas s’améliorer, cela ne fera que consommer inutilement du temps et du quota.
Si vous utilisez un SDK officiel, beaucoup intègrent déjà des nouvelles tentatives automatiques pour les 429 et les 5xx, généralement contrôlées par un paramètre du type max_retries. Avant d’ajouter votre propre couche de retry, vérifiez le comportement par défaut du SDK, pour éviter que deux niveaux de retry se cumulent et multiplient le nombre réel de tentatives.
Comment configurer le basculement (failover) sur une erreur 429
Le backoff consiste à « attendre sur place », tandis que le basculement (failover) consiste à « changer de chemin ». Les deux ne s’excluent pas : ils s’enchaînent. On commence par le backoff, puis on bascule si l’attente ne suffit pas.
Quand déclencher le basculement
Il est recommandé de basculer lorsque l’une des conditions suivantes est remplie, plutôt que de basculer dès qu’un 429 apparaît :
- le nombre maximal de tentatives est atteint et les 429 continuent de revenir ;
- le libellé de l’erreur indique clairement un quota journalier, un épuisement du quota gratuit ou un « manque de capacité » ;
- le délai d’attente indiqué par
Retry-Afterdépasse la limite acceptable pour le service ; - un même canal enchaîne plusieurs échecs en peu de temps, ce qui déclenche le seuil du disjoncteur.
Les recommandations de tiers pour gérer les 429 fréquents sur un modèle populaire d’OpenRouter suivent la même logique : d’abord le backoff, puis le basculement vers d’autres modèles exposés par la même interface. Cet ordre permet à la fois de profiter de la qualité de sortie du modèle d’origine et de garantir la continuité du service.
Trois architectures de chaîne de basculement
La « route de secours » du basculement peut se situer à différents niveaux. Le coût du basculement va croissant dans cet ordre :
- Même modèle, autre canal : garder le même modèle et changer de clé API, de groupe ou de fournisseur. C’est l’option à privilégier, car elle offre la meilleure cohérence de sortie.
- Même fournisseur, autre gamme : par exemple, passer d’un modèle phare à un modèle léger de la même série. Les capacités baissent légèrement, mais le style reste proche.
- Modèle d’un autre fournisseur : passer à un modèle équivalent chez un autre fournisseur. La disponibilité est maximale, mais il faut vérifier à l’avance l’effet des invites et le format de sortie.
Au-dessus de cela, il est conseillé d’ajouter un disjoncteur (circuit breaker) : lorsqu’un canal enchaîne les échecs jusqu’au seuil, on le contourne complètement pendant une période de refroidissement. À la fin de cette période, on envoie quelques requêtes de sondage, puis on augmente progressivement le trafic une fois qu’il est rétabli. Cela évite que chaque requête aille d’abord se heurter au même mur avant de basculer, et réduit sensiblement la latence globale.
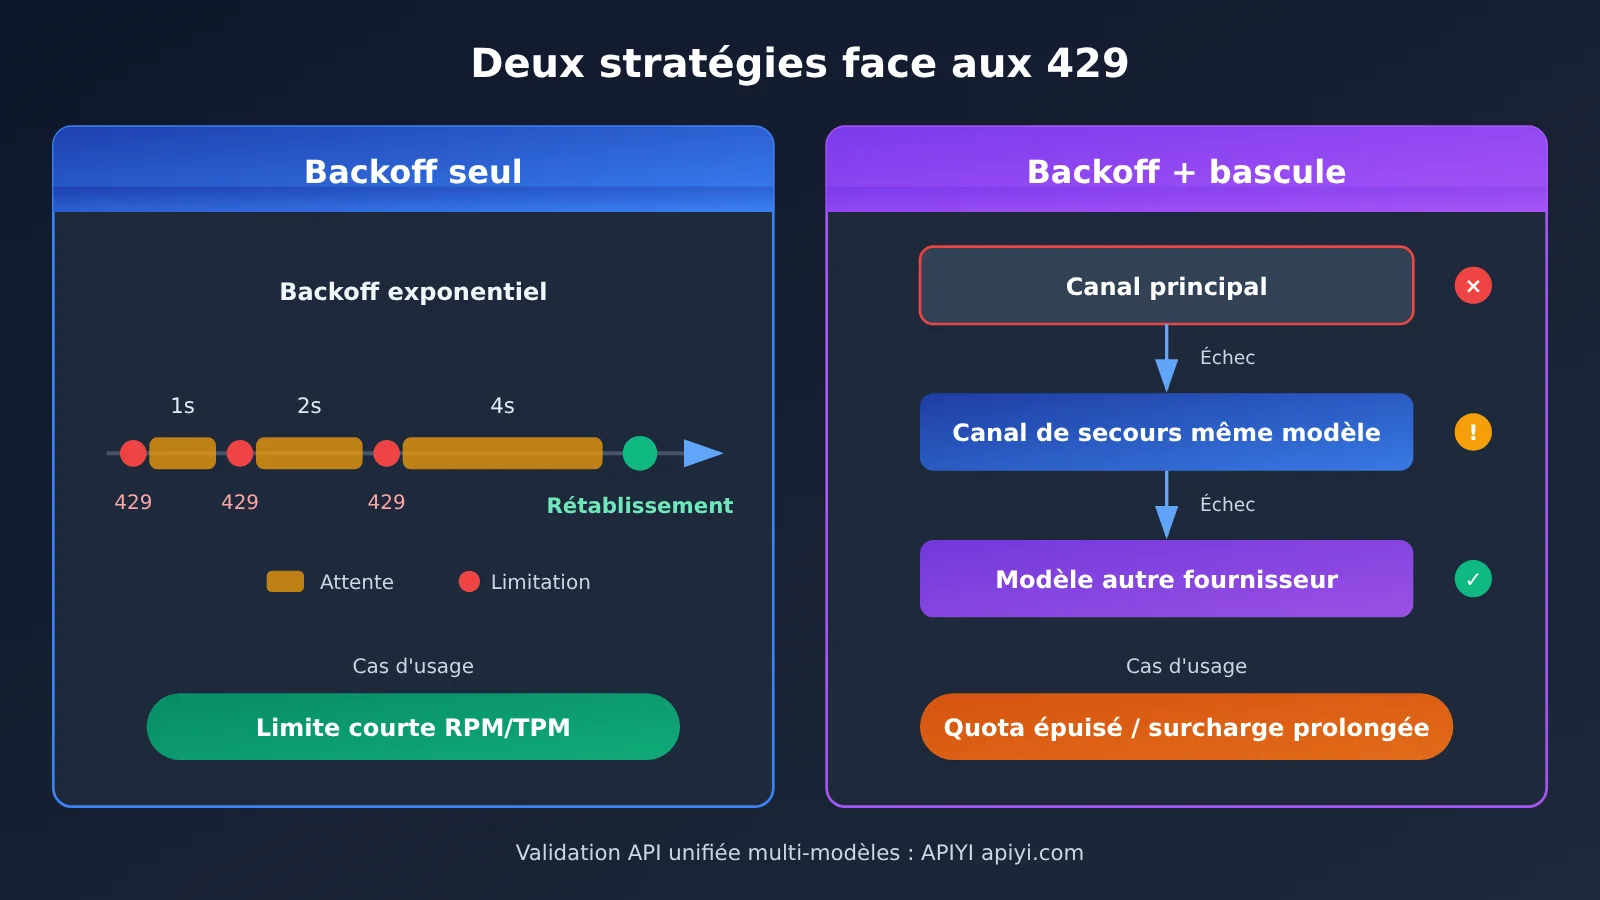
Les deux stratégies comparées ci-dessus peuvent être validées dans un projet réel via une même interface unifiée. Sur une plateforme comme APIYI, compatible avec les formats d’interface d’OpenAI et d’Anthropic, le même code permet de basculer vers un modèle de secours en modifiant simplement le paramètre model — bien plus simple que de maintenir un SDK distinct pour chaque fournisseur.
Prise en main rapide du traitement des erreurs 429 (limitation de débit)
Voici, sous forme de liste de configuration directement applicable, une synthèse de ce qui précède. Aucun code ici : voyez-la comme une checklist à utiliser lors d’une revue de code ou d’un réglage d’exploitation.
Checklist de configuration en 5 points
- Journaux : enregistrez le corps complet de la réponse et les en-têtes, avec au minimum le code de statut, le type d’erreur, le libellé de l’erreur,
Retry-Afteret les différents champsratelimit. - Classification : côté client, répartissez les erreurs en trois catégories : « retry avec backoff » (429 de débit, 529, 503), « basculer » (quota épuisé, échecs persistants), « non réessayable » (400, 401, 403).
- Backoff : configurez un backoff exponentiel avec jitter complet selon le tableau de paramètres ci-dessus, en donnant la priorité à
Retry-After, et fixez un nombre maximal de tentatives ainsi qu’un budget de temps total. - Chaîne de bascule : configurez la liste de secours dans l’ordre « même modèle, autre canal → même fournisseur, autre gamme → autre fournisseur, autre modèle », et validez à l’avance l’effet des invites sur chaque modèle de secours.
- Disjoncteur et alertes : définissez un seuil d’échec et un temps de refroidissement pour chaque canal, et mettez en place une alerte sur la proportion de 429 : si elle reste élevée, c’est le signe qu’il faut demander une augmentation de quota ou ajuster la concurrence.
Exemple de chaîne de modèles de secours
Le tableau ci-dessous illustre une chaîne de bascule à trois niveaux courante. Les noms de modèles exacts sont à vérifier dans la liste des modèles de la plateforme, et la facturation dans la page des tarifs ; cet article ne donne pas de prix unitaires.
| Niveau | Logique de choix | Format d’API | Plateformes disponibles | Base tarifaire |
|---|---|---|---|---|
| Principal | Le modèle phare qui donne les meilleurs résultats métier | Format OpenAI ou Anthropic | APIYI apiyi.com, API officielle | Voir docs.apiyi.com/models |
| Secours niveau 1 | Autre canal ou autre groupe pour le même modèle | Identique au principal | APIYI apiyi.com, API officielle | Voir docs.apiyi.com/models |
| Secours niveau 2 | Modèle léger du même fournisseur ou modèle équivalent d’un autre fournisseur | Format compatible OpenAI | APIYI apiyi.com et autres plateformes d’agrégation | Voir docs.apiyi.com/models |
Côté intégration, si vous utilisez les SDK officiels OpenAI ou Anthropic, il suffit en général de remplacer base_url par l’adresse fournie par la plateforme et api_key par la clé de la plateforme. Pour les adresses d’API précises et les instructions d’appel de chaque modèle, fiez-vous au centre de documentation APIYI, docs.apiyi.com, plutôt que de recopier des adresses non vérifiées trouvées en ligne.
🚀 Démarrage rapide : pour mettre en place une chaîne tolérante aux 429, commencez par intégrer le modèle principal et les modèles de secours via APIYI apiyi.com avec le même code. La plateforme donne accès aux API des principaux modèles cités dans cet article, compatibles avec les formats OpenAI et Anthropic ; changer de modèle ne demande que de modifier le paramètre
model. La documentation d’intégration est sur docs.apiyi.com, et les prix d’entrée/sortie, les tarifs de cache et les règles de facturation de chaque modèle sont ceux des données réelles de la page tarifs docs.apiyi.com/models.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que le rate limiting 429 ?
429 est le code de statut Too Many Requests de la norme HTTP, qui indique que l’appelant a dépassé, dans une fenêtre de temps donnée, le nombre de requêtes, de tokens, de connexions simultanées ou le quota total autorisé. Cela signifie « vous êtes limité », et non que le modèle lui-même est en panne.
Q2 : Quelle différence entre 429, 529 et 503 ?
429 renvoie à un problème de quota côté appelant : la responsabilité est du côté « vous consommez trop ». 529 est l’erreur de surcharge d’Anthropic, et 503 signale un service temporairement indisponible : dans les deux cas, la responsabilité est du côté capacité du serveur. Pour le premier, privilégiez le backoff et l’ajustement de la consommation ; pour les deux autres, un bref backoff suivi d’un basculement de secours est plus adapté.
Q3 : Comment savoir au plus vite si le 429 vient du fournisseur en amont ou de la passerelle ?
Regardez d’abord la formulation du corps d’erreur : un type d’erreur propre au fournisseur vient généralement de l’amont, tandis que des mentions de compte, de groupe ou de canal viennent généralement de la passerelle. Regardez ensuite les en-têtes de réponse : si un champ `ratelimit` préfixé par le fournisseur apparaît avec une valeur restante à 0, vous pouvez presque confirmer que c’est l’amont qui limite.
Q4 : Pourquoi le 429 ne disparaît-il pas après de nombreux backoffs ?
La cause la plus fréquente est une mauvaise identification de la dimension du rate limiting. Si le quota journalier ou le crédit gratuit est épuisé, le backoff ne servira à rien ; si c’est le nombre de connexions simultanées qui est dépassé et que le client continue d’envoyer en parallèle à haute dose, le backoff ne fera que soulager. Dans ce cas, il faut réduire la concurrence ou passer directement au basculement de secours.
Q5 : Comment monter rapidement une chaîne de basculement multi-modèles ?
Nous recommandons de valider sur une plateforme offrant une interface unifiée multi-modèles :
1. Créez un compte sur APIYI apiyi.com et récupérez une clé API ;
2. Configurez `base_url` selon la documentation docs.apiyi.com, en utilisant le format OpenAI ou Anthropic ;
3. Dans le client, configurez la liste des modèles principal et de secours, et basculez en modifiant le paramètre `model`.
Ainsi, le modèle principal et le modèle de secours partagent le même code, ce qui réduit fortement le coût de test de la chaîne de basculement.
Q6 : Le basculement de secours peut-il faire dérailler les coûts ?
C’est possible. Le prix unitaire, la longueur de contexte et la stratégie de cache du modèle de secours peuvent différer de ceux du modèle principal, et des basculements fréquents modifient la structure de la facture. Nous conseillons de vérifier à l’avance le prix de chaque modèle de secours, en se basant sur les données réelles de la page tarifs docs.apiyi.com/models d’APIYI, et de mettre en place des alertes sur la proportion de basculements.
Q7 : Quelles sont les limites connues des solutions de gestion du 429 ?
Le backoff augmente la latence des requêtes, ce qui le rend inadapté aux scénarios exigeant une réactivité extrême ; le basculement entre fournisseurs peut entraîner des différences de style et de format de sortie, qu’il faut valider par des tests de régression en amont ; certains fournisseurs n’affichent leurs limites que dans la console, avec des en-têtes de réponse incomplets, ce qui oblige à s’appuyer uniquement sur la formulation des erreurs et les données de monitoring pour diagnostiquer.
Points clés du traitement du rate limiting 429
- Un 429 indique seulement une limitation : il ne dit ni qui limite, ni ce qui est limité, et ne peut donc pas être assimilé directement à une panne du modèle.
- Lisez d’abord le message d’erreur : la formulation du corps de l’erreur est l’indice le plus rapide pour distinguer l’amont, la passerelle ou le palier gratuit.
- Regardez ensuite les en-têtes de réponse : les champs
ratelimitpréfixés par le fournisseur etRetry-Afterconstituent la deuxième chaîne de preuves. - Traitez selon la dimension concernée : RPM → lisser le débit, TPM → réduire le contexte, concurrence → limiter les workers, quota épuisé → basculer directement.
- D’abord le backoff, ensuite le basculement : backoff exponentiel avec full jitter, priorité au
Retry-After, et un nombre de tentatives plafonné. - Concevoir la chaîne de basculement en couches : changer de canal pour le même modèle en priorité, changer de modèle chez un autre fournisseur en dernier recours, avec un circuit breaker.
- Réduire les coûts grâce à une interface unifiée : l’interface d’APIYI compatible avec les formats OpenAI et Anthropic permet de gérer les modèles principal et de secours avec un seul code.
Conclusion
Face à un 429, le bon ordre est « identifier la source → déterminer la dimension → backoff → basculer », et non changer de modèle dès la première erreur :
- Identifier la source : la formulation du corps d’erreur et les en-têtes de réponse permettent de distinguer le fournisseur amont, la passerelle et le palier gratuit.
- Déterminer la dimension : savoir s’il s’agit du nombre de requêtes, du nombre de tokens, de la concurrence ou du quota global, pour décider si le backoff sera efficace.
- Configurer la tolérance aux pannes : le backoff exponentiel avec jitter comme première ligne de défense, le basculement en couches avec circuit breaker comme seconde.
En intégrant ce processus dans les logs, la classification des erreurs et la configuration du client, le 429 passe d’« alerte au milieu de la nuit » à un événement courant, prévisible et auto-réparable.
Nous vous recommandons de vérifier rapidement l’efficacité du basculement entre modèle principal et modèle de secours via APIYI apiyi.com. Les instructions d’intégration sont disponibles sur docs.apiyi.com ; pour les prix des modèles concernés et les règles de facturation, référez-vous à docs.apiyi.com/models.
📚 Références
- Rate Limit Reached in Claude Code: What Each 429 Message Means : comprendre la signification de chaque message d’erreur 429 dans Claude Code
- Lien :
ofox.ai/blog -
Description : explique comment distinguer, à partir du message renvoyé par le serveur, une limitation d’Anthropic, d’une passerelle ou du niveau gratuit
-
Claude Code fallbackModel: 3-Tier Failover Setup : configuration d’un modèle de secours dans Claude Code
- Lien :
ofox.ai/blog -
Description : précise que fallbackModel se déclenche en cas de surcharge 529, avec un maximum de 3 modèles, et non pour un 429
-
LLM API Rate Limits Compared : comparaison des règles de limitation de débit de 5 grands fournisseurs de modèles
- Lien :
ofox.ai/blog -
Description : compare les différentes approches de limitation (par token, par concurrence, ou affichage uniquement dans la console)
-
Centre de documentation et page tarifaire APIYI : instructions d’intégration et facturation des modèles
- Lien :
docs.apiyi.cometdocs.apiyi.com/models - Description : le format de l’interface, la configuration de base_url et les tarifs réels de chaque modèle font référence
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil d’APIYI apiyi.com pour échanger sur les pratiques de limitation de débit et de tolérance aux pannes. Vous trouverez davantage de ressources d’intégration dans le centre de documentation docs.apiyi.com