Note de l’auteur : cet article décrypte la facturation des tokens d’entrée, de sortie, de cache et de raisonnement, ainsi que celle du multimodal. Il explique comment vérifier l’usage à partir des journaux d’appels, repérer les variations soudaines de coûts et réagir aux changements de prix.
En ouvrant la facture à la fin du mois, vous constatez que le coût d’un modèle a nettement augmenté par rapport au mois précédent, alors que le nombre d’appels a à peine changé. Beaucoup d’équipes qui utilisent des API de grands modèles de langage en production ont déjà rencontré cette situation. Cet article présente une méthode qui combine décomposition des postes de facturation et rapprochement avec les journaux d’appels, pour vous aider à comprendre et à vérifier votre facture.
Ce n’est pas un comparatif de prix. Les tarifs des fournisseurs changent souvent : nous ne donnerons donc pas de prix unitaires, mais des principes de facturation et des méthodes de vérification qui restent utiles dans la durée.
Un signal intéressant pour le secteur : en novembre 2026, une entreprise spécialisée dans l’infrastructure IA recrutait pour un poste lié à l’exploitation d’une plateforme de grands modèles de langage. Parmi les responsabilités figuraient explicitement le « contrôle des coûts et de la facturation » : vérifier les règles de facturation des tokens d’entrée et de sortie, de cache et de raisonnement, ainsi que des images, de l’audio et de la vidéo ; repérer rapidement les factures anormales, les changements de prix et les écarts de facturation. Si les plateformes ont besoin de personnes dédiées à ce travail, c’est que les règles de facturation sont suffisamment complexes pour le justifier. En tant que client, vous avez tout intérêt à mettre en place vos propres habitudes de vérification.
Ce que vous allez en retirer : après cette lecture, vous saurez d’où vient chaque poste d’une facture d’API de grands modèles de langage, comment vérifier l’usage à partir des journaux d’appels et comment repérer rapidement les raisons d’une variation soudaine du coût d’une même requête.
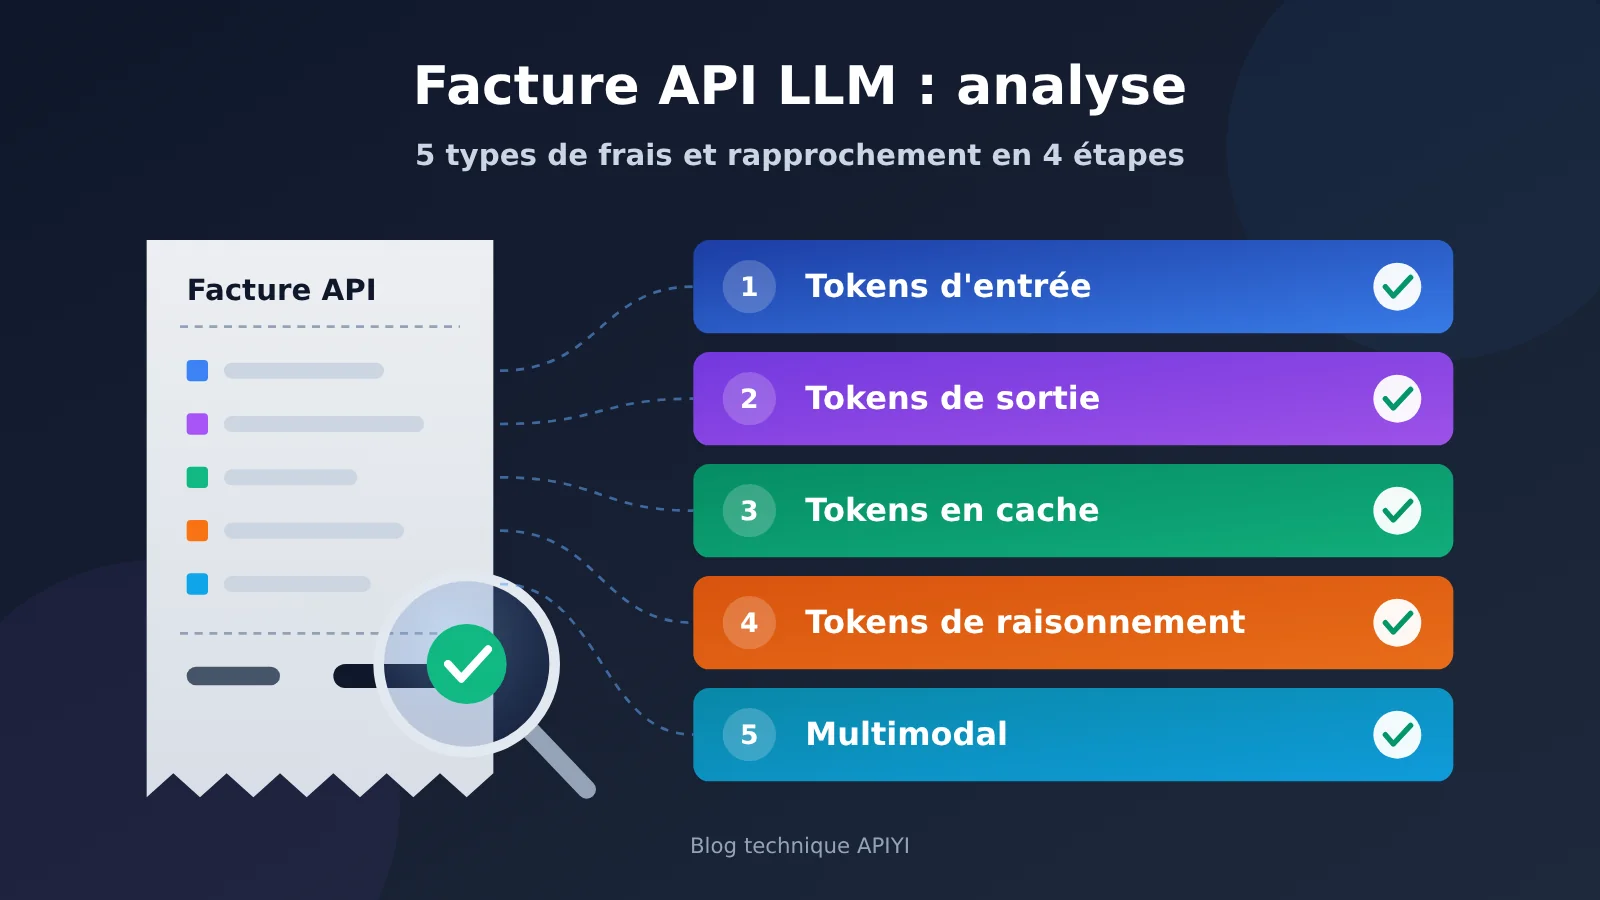
Les 5 postes de facturation d’une API de grand modèle de langage
Le coût d’une invocation du modèle ne se résume généralement pas à « nombre d’appels × prix unitaire ». Chaque poste a son propre tarif et sa propre origine. Les regrouper sans distinction peut donner une fausse idée de la structure des coûts.
| Poste de facturation | Origine | Mode de tarification courant | Points à vérifier |
|---|---|---|---|
| Tokens d’entrée | Invite système, historique des conversations, définitions des outils, documents récupérés, entrée utilisateur | Facturés au token, généralement moins chers que les tokens de sortie | La longueur du contexte augmente-t-elle sans qu’on s’en aperçoive ? |
| Tokens de sortie | Réponse visible générée par le modèle | Facturés au token, généralement plus chers que les tokens d’entrée | Longueur des réponses, réglage de max_tokens |
| Tokens en cache | Préfixe d’entrée trouvé dans le cache | La partie trouvée bénéficie souvent d’une réduction ; certains fournisseurs facturent séparément l’écriture | Le taux de correspondance du cache baisse-t-il ? |
| Tokens de raisonnement | Processus de réflexion interne des modèles de raisonnement | Généralement facturés comme des tokens de sortie, sans nécessairement apparaître dans la réponse | La longueur du raisonnement augmente-t-elle ? |
| Facturation multimodale | Entrée ou génération d’images, d’audio et de vidéo | Facturation à l’image, à la seconde, selon la résolution ou après conversion en tokens | Les paramètres techniques ont-ils changé ? |
Pourquoi est-il si difficile de faire correspondre sa facture API aux prévisions ?
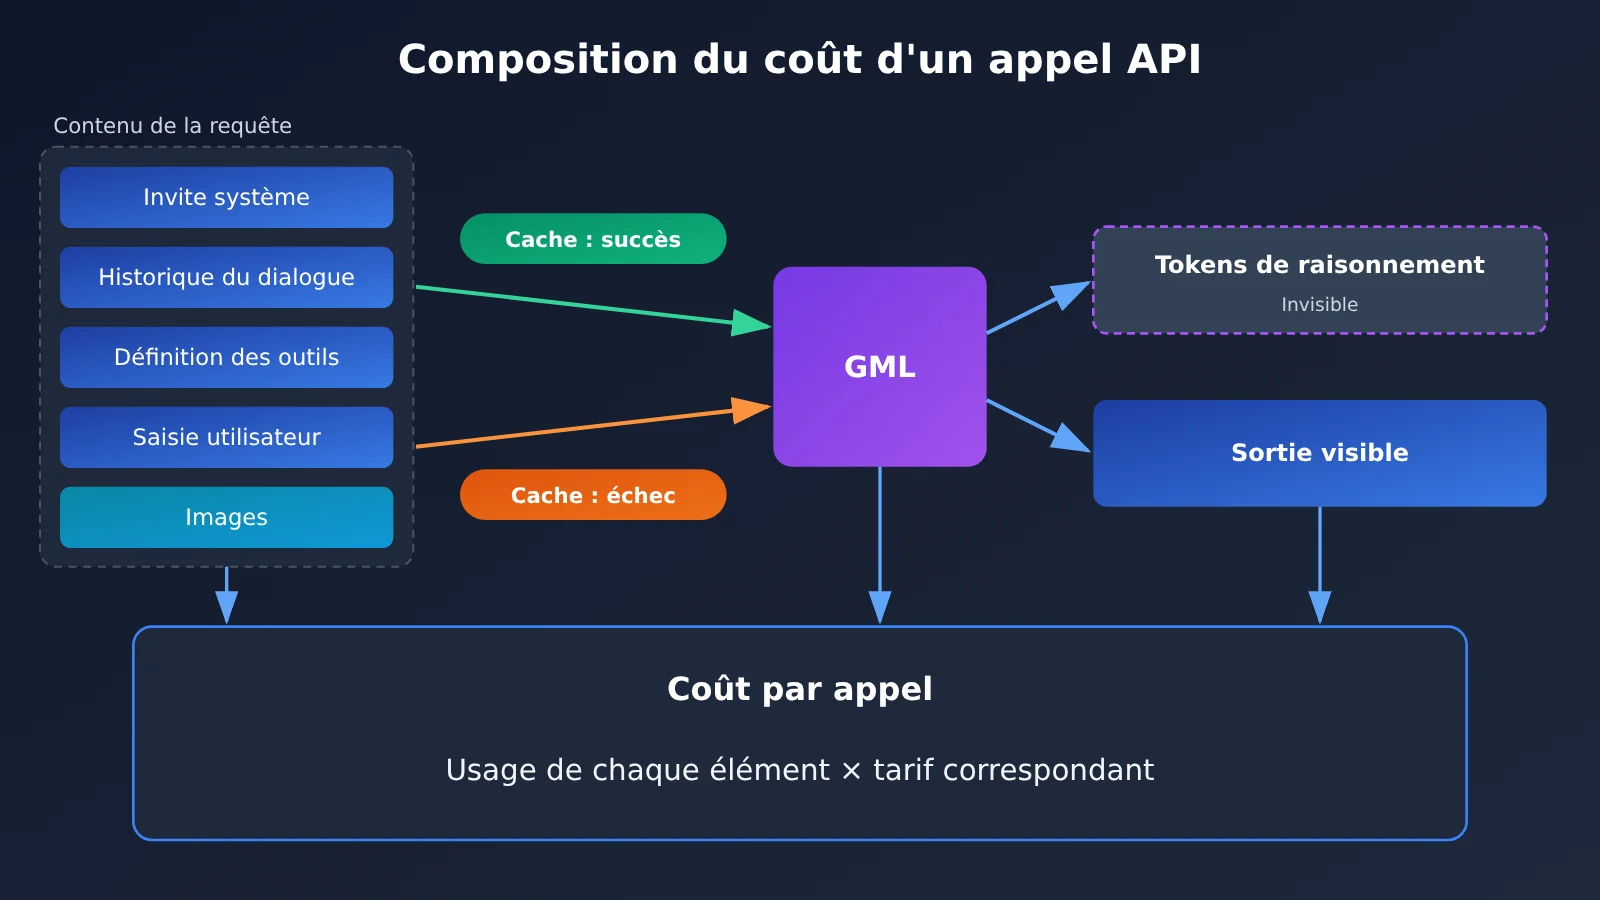
La première raison, ce sont les tokens invisibles. Vous n’avez peut-être écrit qu’une question utilisateur dans votre code, mais la requête envoyée peut contenir plusieurs milliers de tokens : invite système, historique des échanges et schémas d’outils. Les modèles de raisonnement produisent aussi de nombreux tokens de réflexion que l’utilisateur ne voit pas. Tous sont facturés, même s’ils n’apparaissent pas dans l’interface.
La deuxième raison, c’est le manque d’uniformité dans la facturation. Pour une entrée image, certains fournisseurs facturent à l’image, tandis que d’autres la convertissent en tokens selon sa résolution. Pour le cache, certains fournisseurs le gèrent automatiquement, d’autres exigent une déclaration explicite ; certains ne réduisent que le prix de lecture, d’autres facturent aussi l’écriture. Avant de comparer les coûts entre modèles ou fournisseurs, il faut donc s’assurer de comparer les mêmes éléments.
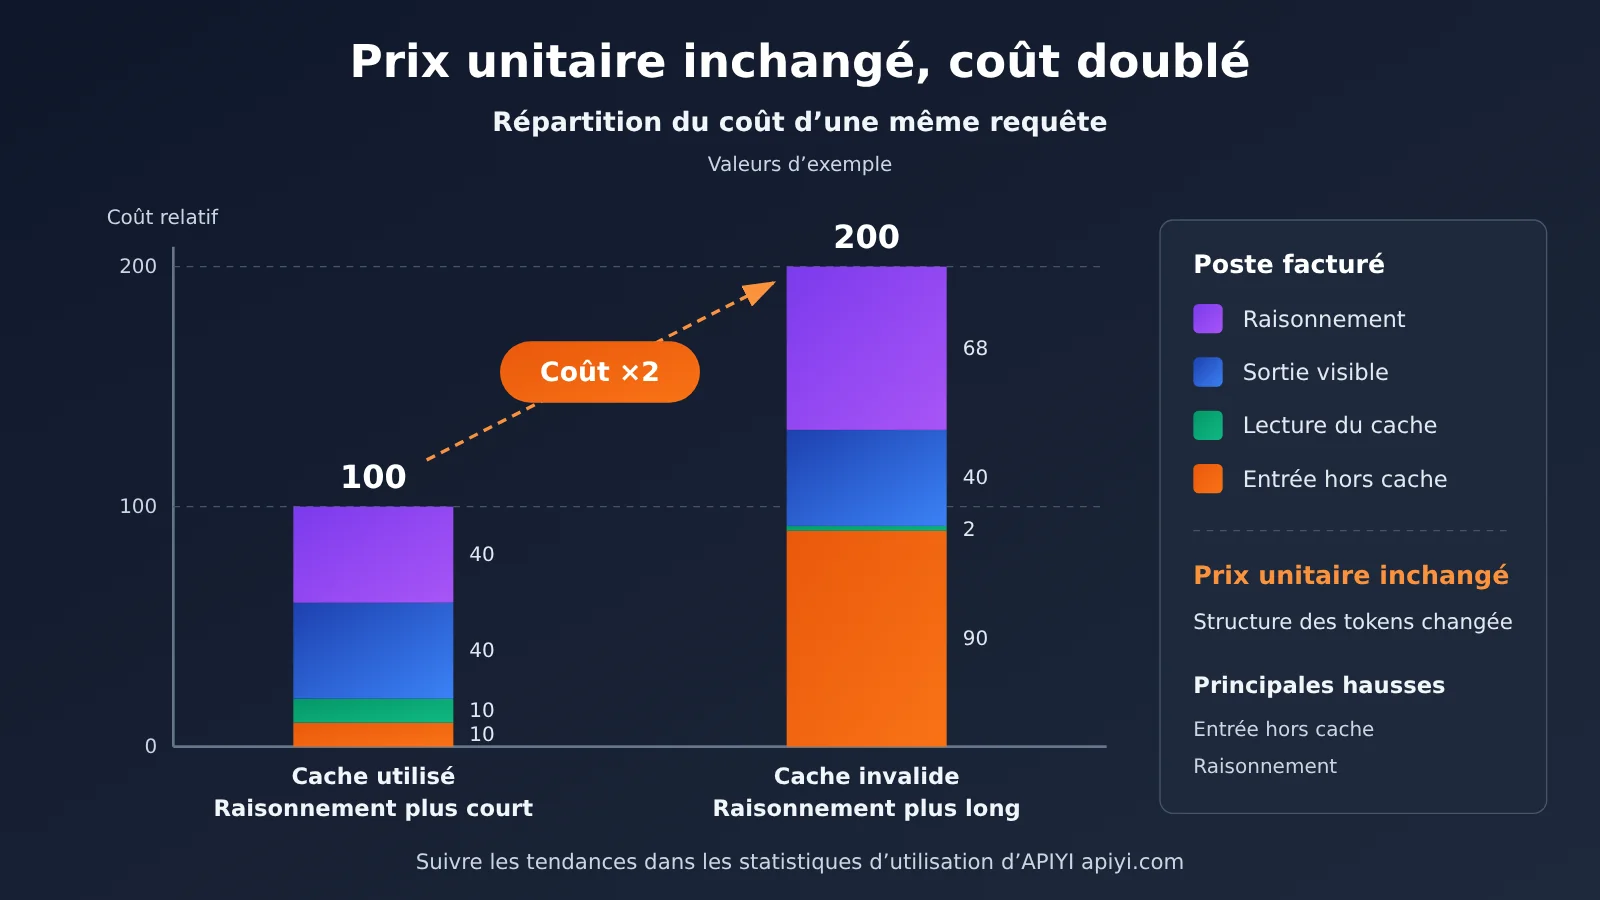
La troisième raison, c’est que les paramètres évoluent. Un alias de modèle peut pointer vers une nouvelle version, une petite modification du préfixe de l’invite peut invalider tout le cache, et un modèle de raisonnement peut réfléchir plus longtemps face à une question plus difficile. La facture peut donc changer même si les prix unitaires restent identiques.
Les différents postes de facturation des API de grands modèles de langage
Tokens d’entrée : le poste le plus souvent sous-estimé
Les tokens d’entrée correspondent à tout ce que le modèle « lit » dans une requête, et pas seulement au message de l’utilisateur. Dans une conversation à plusieurs tours, tout l’historique est renvoyé à chaque tour. Plus la conversation s’allonge, plus le coût d’entrée par tour augmente, et le coût total croît presque proportionnellement au carré du nombre de tours.
Les applications RAG consomment elles aussi beaucoup de tokens d’entrée. Le nombre de fragments de documents récupérés et leur longueur déterminent directement le coût d’entrée. Avec le Function Calling, le JSON Schema qui définit les outils est comptabilisé dans l’entrée à chaque requête : plus il y a d’outils, plus les coûts fixes augmentent.
Attention aussi : les modèles n’utilisent pas tous le même tokenizer. Un même texte en chinois peut représenter un nombre de tokens très différent selon le modèle. On ne peut donc pas utiliser le nombre de tokens d’un modèle pour estimer le coût d’un autre.
Tokens de sortie : plus chers et directement contrôlés par les paramètres
Les tokens de sortie correspondent au contenu généré par le modèle. Chez la plupart des fournisseurs, leur prix unitaire est nettement supérieur à celui des tokens d’entrée. Demander au modèle d’être concis permet donc souvent d’économiser davantage que de réduire l’entrée.
max_tokens fixe une limite pour les tokens de sortie, mais ne garantit pas que la réponse sera complète. Si elle est tronquée, la partie déjà générée reste facturée. Lorsqu’un flux est interrompu, le traitement des tokens déjà générés peut aussi varier selon la plateforme : vérifiez la documentation officielle.
Tokens en cache : des économies uniquement en cas de réutilisation
La mise en cache des invites fonctionne ainsi : lorsque plusieurs requêtes partagent le même préfixe, par exemple une même invite système ou un même document long, le fournisseur peut réutiliser la partie déjà traitée et appliquer un tarif réduit à ces tokens d’entrée.
Plusieurs règles courantes sont à vérifier :
- Activation automatique : certains fournisseurs activent le cache par défaut, tandis que d’autres demandent d’indiquer explicitement où le placer dans la requête ;
- Correspondance du préfixe : le préfixe doit généralement être identique dès le début ; toute modification à un endroit invalide la mise en cache de tout ce qui suit ;
- Longueur minimale et durée de validité : un préfixe trop court peut ne pas être mis en cache ; après expiration, il faut le mettre en cache à nouveau ;
- Coût d’écriture : certains fournisseurs facturent la première écriture en cache plus cher qu’une entrée ordinaire ; seules les lectures suivantes bénéficient d’un tarif réduit.
Lors du rapprochement des factures, comptabilisez séparément les « tokens lus depuis le cache » et les « tokens d’entrée ordinaires ». Vous éviterez ainsi de prendre une baisse du taux de réutilisation du cache pour une hausse du nombre d’invocations.
Tokens de raisonnement : invisibles, mais facturés
Les modèles de raisonnement effectuent une réflexion interne avant de répondre. Les tokens utilisés sont généralement facturés au tarif des tokens de sortie. Dans bien des cas, le raisonnement complet ne vous est pas renvoyé : seul le nombre de tokens apparaît dans les données d’utilisation.
Le nombre de tokens de raisonnement varie selon la difficulté de la question et le paramètre d’intensité du raisonnement. Avec une même API, une question plus complexe peut donc faire grimper la facture. Si votre application se limite à une classification simple ou à une conversion de format, utiliser un modèle de raisonnement revient souvent à payer pour une réflexion inutile.
Facturation multimodale : vérifier d’abord l’unité de facturation
Les modes de facturation du multimodal varient beaucoup. Il est donc particulièrement important de consulter la page tarifaire officielle de chaque modèle. Le tableau ci-dessous présente les modes de facturation courants ; les règles précises dépendent des tarifs actuellement publiés par chaque fournisseur.
| Type | Mode de facturation courant | Paramètres clés influençant le coût | Points à vérifier |
|---|---|---|---|
| Entrée image (compréhension) | Conversion en tokens selon la résolution, ou facturation par image | Dimensions de l’image, paramètre de niveau de détail | Consigner la résolution réelle avant et après l’envoi |
| Génération d’images | Facturation par image ou par token de sortie | Dimensions, niveau de qualité, nombre d’images générées | Consigner les paramètres de chaque requête |
| Entrée / sortie audio | Facturation à la durée ou conversion en tokens audio | Durée audio, méthode de traitement de l’échantillonnage | Consigner la durée réelle de l’audio |
| Synthèse vocale | Facturation au caractère ou au token | Longueur du texte, catégorie de voix | Consigner la longueur du texte à synthétiser |
| Génération / compréhension vidéo | Facturation à la seconde, à l’image ou selon le niveau de résolution | Durée, résolution, fréquence d’images | Consigner la durée et la résolution ensemble |
| Embedding | Facturation aux tokens d’entrée | Longueur du texte, taille des lots | Suivre les coûts séparément de ceux des tokens d’entrée ordinaires |
🎯 Conseil technique : pour les usages multimodaux, mieux vaut passer par un point d’entrée unique afin de centraliser la gestion des différents modes de facturation. La présentation officielle d’APIYI sur apiyi.com indique que les modèles de la plateforme utilisent un solde commun et que des statistiques d’utilisation et des journaux d’appels sont disponibles. Vérifiez d’abord les champs affichés dans les journaux de la console, puis déterminez les paramètres à ajouter à votre tableau de rapprochement.
Factures d’API de grands modèles de langage : réconciliation en 4 étapes
Le principe est simple : multipliez l’utilisation que vous avez enregistrée par l’instantané des tarifs que vous avez conservé pour obtenir le coût attendu, puis comparez-le à la facture de la plateforme. Si l’écart dépasse votre seuil de tolérance, examinez chaque poste.
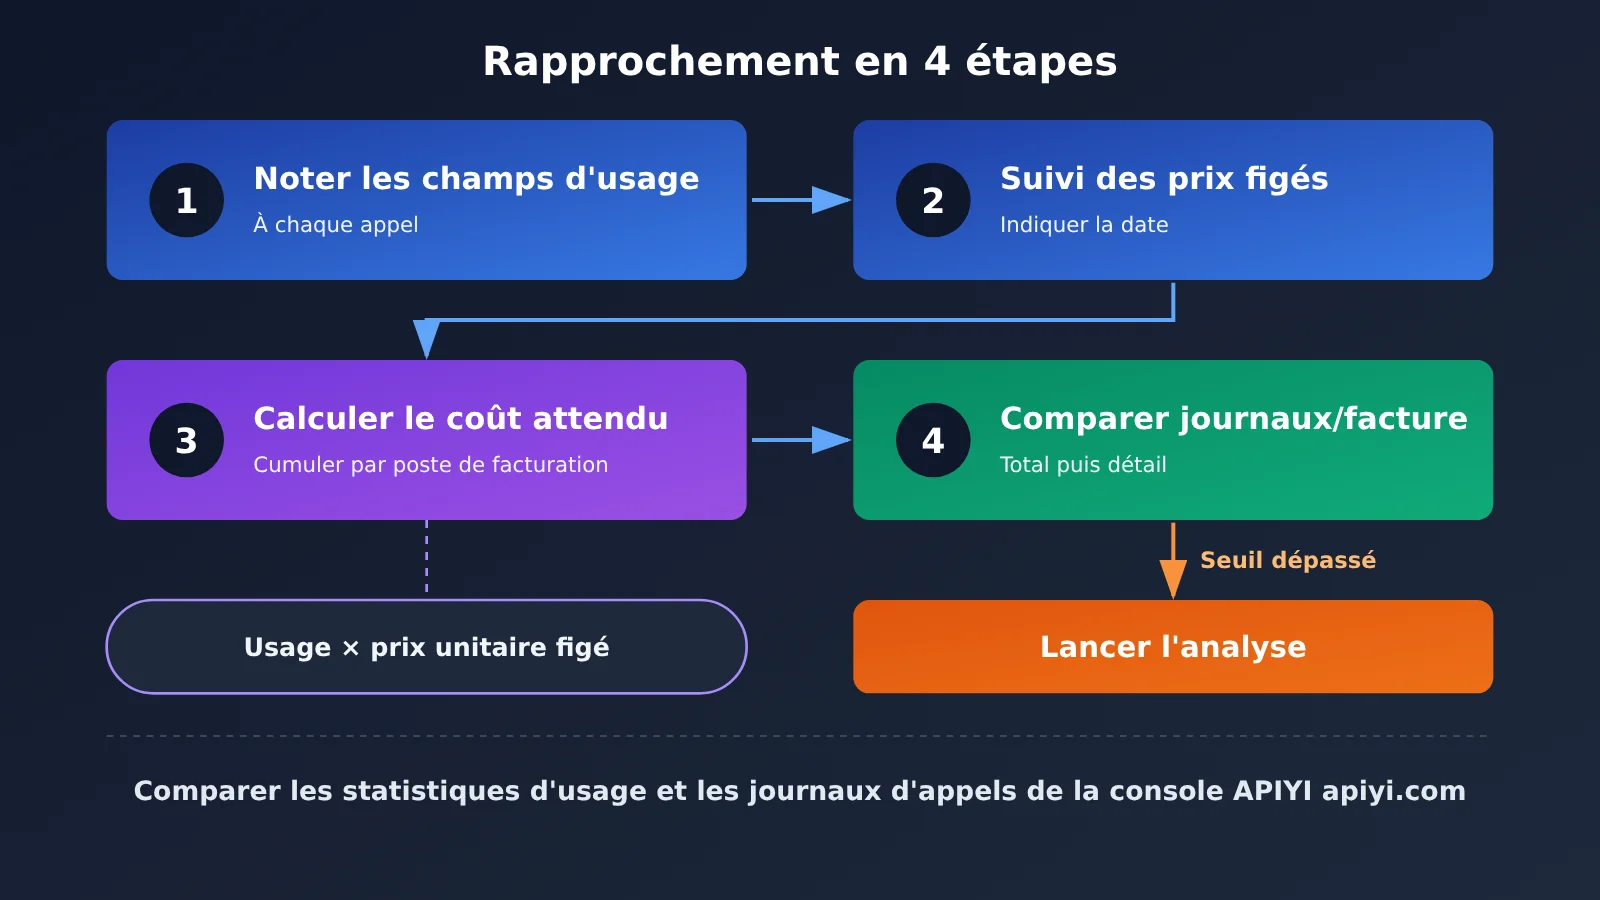
Étape 1 : consigner les champs d’utilisation après chaque appel
Les interfaces compatibles avec le format OpenAI renvoient généralement un objet usage dans leur réponse. Voici les champs courants et leur signification. Les données renvoyées peuvent varier selon le modèle et la plateforme : faites un test avant l’intégration pour vérifier ce que vous recevez.
| Champ (dénomination courante au format compatible OpenAI) | Signification | Poste de facturation correspondant |
|---|---|---|
prompt_tokens |
Nombre total de tokens en entrée pour la requête | Entrée (y compris la partie en cache) |
prompt_tokens_details.cached_tokens |
Partie de l’entrée trouvée dans le cache | Lecture du cache |
completion_tokens |
Nombre total de tokens en sortie | Sortie (pouvant inclure la partie raisonnement) |
completion_tokens_details.reasoning_tokens |
Partie de la sortie consacrée au raisonnement | Raisonnement |
model |
Nom du modèle ayant effectivement répondu | Identification des changements de version |
Pour chaque appel, il est recommandé d’enregistrer au minimum les informations suivantes en base de données :
- L’heure de la requête, son identifiant et l’identifiant du cas d’usage ;
- Le nom du modèle indiqué dans la requête et le champ
modelrenvoyé dans la réponse ; - Tous les champs d’utilisation du tableau ci-dessus, en laissant les champs absents vides plutôt qu’en les mettant à 0 ;
- Les paramètres des requêtes multimodales, comme les dimensions des images, la durée audio et le nombre d’éléments à générer ;
- Le recours ou non au streaming, une éventuelle nouvelle tentative et une éventuelle troncature (
finish_reason).
Attention : prompt_tokens et completion_tokens sont souvent des totaux. Les tokens de cache et de raisonnement en constituent des sous-ensembles. Pour calculer le coût, il faut d’abord soustraire ces sous-ensembles des totaux, puis multiplier chaque catégorie par son tarif respectif. Sinon, vous risquez de compter certains tokens deux fois ou de ne pas appliquer une réduction.
Étape 2 : tenir un historique daté des tarifs
Ne codez pas les prix unitaires en dur. Tenez plutôt un tableau dans lequel chaque ligne indique le nom du modèle, l’élément facturé, le prix unitaire, la devise, la date d’entrée en vigueur et la source (page officielle des tarifs ou annonce de la plateforme).
Lorsqu’un tarif change, ajoutez une ligne au lieu d’écraser l’ancienne valeur. Vous pourrez ainsi recalculer la facture de n’importe quel jour avec les prix alors en vigueur. Si vous utilisez une plateforme d’agrégation comme APIYI pour invoquer les modèles, référez-vous aux tarifs qu’elle publie et indiquez également la date de consultation.
Étape 3 : calculer le coût attendu
Le coût attendu d’une invocation se calcule en additionnant plusieurs éléments :
- Tokens d’entrée non trouvés dans le cache × prix unitaire des entrées ;
- Tokens lus dans le cache × prix unitaire de lecture du cache (ajoutez les écritures si elles sont facturées) ;
- Tokens de sortie visibles × prix unitaire des sorties ;
- Tokens de raisonnement × prix unitaire correspondant (généralement le même que pour les sorties, selon les indications officielles) ;
- Les éléments multimodaux, calculés séparément selon leurs modalités de facturation respectives.
En regroupant ces coûts par jour, par modèle et par cas d’usage, vous obtenez un relevé des dépenses que vous estimez devoir payer.
Étape 4 : comparer avec les journaux et la facturation de la plateforme
Comparez votre propre registre avec les statistiques d’utilisation et les journaux d’appels de la plateforme. Commencez par le montant total, puis comparez les montants par modèle, avant de remonter aux requêtes concernées.
Définissez un seuil de tolérance. De petits écarts sont fréquents en raison des taux de change, de la précision de facturation ou des fuseaux horaires utilisés pour les statistiques. Seuls les écarts dépassant ce seuil nécessitent un examen détaillé.
🚀 Pour commencer : si vous utilisez déjà des modèles sur APIYI apiyi.com, exportez les journaux d’appels sur une période donnée et comparez-les, requête par requête, avec les champs
usageque vous avez enregistrés. La distinction entre tokens mis en cache et tokens de raisonnement dépend des champs actuellement fournis par la plateforme. S’ils ne sont pas indiqués séparément, utilisez les champs de réponse enregistrés localement pour obtenir le détail.
Signaux d’anomalie sur la facture d’API de grands modèles de langage : comment enquêter sur une variation soudaine des coûts
Une variation soudaine du coût pour un même type de requête est un signal à surveiller de près. Le tableau suivant présente les causes courantes et les pistes à explorer.
| Anomalie observée | Cause possible | Vérification |
|---|---|---|
| Le coût par appel augmente alors que le volume d’appels reste stable | L’alias du modèle pointe vers une nouvelle version, avec un tarif unitaire ou une consommation de tokens différente | Comparez les valeurs du champ model dans les réponses avant et après le changement |
| Le coût des entrées augmente alors que le nombre total de tokens d’entrée reste stable | Le taux de succès du cache diminue | Vérifiez la proportion de cached_tokens et voyez si le préfixe de l’invite a été modifié |
| Le coût des sorties augmente alors que la longueur des réponses visibles reste stable | Le nombre de tokens de raisonnement augmente | Examinez l’évolution de reasoning_tokens et vérifiez le paramètre d’intensité du raisonnement |
| Le nombre de tokens d’entrée augmente lentement mais régulièrement | L’historique de conversation n’est pas tronqué, les extraits récupérés sont plus nombreux ou les définitions d’outils se multiplient | Examinez un échantillon de corps de requêtes complets |
| Le nombre d’appels dépasse le volume d’activité | Nouvelles tentatives du client ou renvois après expiration du délai | Dédupliquez les appels par ID de requête et par ID métier |
| Les coûts d’images ou de vidéos augmentent brusquement | La résolution, le niveau de qualité ou le nombre de contenus générés a augmenté | Comparez les paramètres de spécification dans les requêtes |
| Le tarif unitaire facturé ne correspond pas à l’instantané des prix | L’éditeur ou la plateforme a modifié ses tarifs | Consultez la page des tarifs et les annonces, puis mettez à jour l’instantané des prix |
Invalidation du cache : une hausse des coûts difficile à repérer
L’invalidation du cache provient souvent d’une modification « apparemment anodine ». Par exemple, l’ajout de la date du jour au début de l’invite système ou l’insertion de l’ID utilisateur dans le préfixe. Le préfixe devient alors différent pour chaque requête, le cache ne fonctionne plus et le coût des entrées revient immédiatement au tarif normal.
La bonne pratique consiste à placer le contenu fixe au début et le contenu variable à la fin. Après avoir modifié un modèle d’invite, vérifiez dès le lendemain si le taux de succès du cache a changé.
Dérive de la longueur du raisonnement : la difficulté influence aussi la facture
Le coût des modèles de raisonnement dépend de la difficulté des questions. Si, un jour, les utilisateurs posent soudainement beaucoup de questions complexes, le nombre de tokens de raisonnement augmentera sensiblement : c’est une variation normale. En revanche, si ce nombre continue d’augmenter alors que les types de requêtes restent les mêmes, vérifiez si la version du modèle ou les paramètres de raisonnement ont changé.
Vérifier régulièrement les factures d’API des grands modèles de langage face aux changements de prix
Vous ne pouvez pas contrôler les changements de prix, mais vous pouvez les détecter rapidement. Voici une routine facile à maintenir dans la durée :
- Chaque semaine : examinez les tendances de dépenses par modèle et le coût moyen par requête, en repérant les variations soudaines ;
- Chaque mois : rapprochez l’ensemble des factures et identifiez les causes de chaque écart dépassant le seuil fixé ;
- Après chaque modification d’un modèle d’invite : surveillez la proportion de requêtes servies depuis le cache pendant 1 à 2 jours ;
- Avant chaque changement ou mise à niveau de modèle : comparez la consommation de tokens et les coûts de l’ancien et du nouveau modèle sur un faible volume de trafic ;
- Suivez les annonces : abonnez-vous aux mises à jour des prix et des modèles des fournisseurs ou plateformes utilisés, puis actualisez votre relevé des prix dès leur réception ;
- Épinglez les versions : en production, privilégiez les noms de modèles comportant un numéro de version précis pour éviter les surprises liées aux mises à niveau automatiques des alias.
💡 Conseil : si votre activité utilise des modèles de plusieurs fournisseurs, rapprocher les factures de plusieurs comptes peut prendre beaucoup de temps. En passant par APIYI apiyi.com pour unifier l’accès, vous pouvez consulter l’utilisation des différents modèles avec un solde unique et un même système de journaux, ce qui facilite la comparaison du coût par requête. Vérifiez d’abord dans la console le niveau de détail disponible.
Questions fréquentes FAQ
Q1 : Qu’est-ce qu’un Token dans une facture d’API de grand modèle de langage ?
Un Token est l’unité de base utilisée par le modèle pour traiter le texte : il correspond à un fragment issu de la tokenisation. Un caractère chinois peut correspondre à un ou plusieurs Tokens, selon le tokenizer du modèle. La facture distingue généralement les Tokens d’entrée, de sortie, de cache et de raisonnement, chacun étant facturé séparément.
Q2 : Quelle est la différence entre les Tokens en cache et les Tokens d’entrée ordinaires ?
Les deux sont des Tokens d’entrée, mais les Tokens en cache correspondent à une partie d’un préfixe déjà mis en cache et bénéficient généralement d’un tarif réduit. Les Tokens d’entrée ordinaires sont facturés au tarif normal. Certains fournisseurs facturent aussi séparément la première écriture en cache : il faut donc comptabiliser ces trois catégories distinctement lors du rapprochement.
Q3 : Pourquoi les Tokens de raisonnement ne sont-ils pas visibles dans la réponse ?
Les Tokens de raisonnement sont produits lors du raisonnement interne du modèle. De nombreux modèles ne renvoient pas le processus complet à l’appelant et indiquent seulement le nombre de Tokens utilisés dans le champ d’usage. Ils sont généralement facturés au tarif de sortie : même une réponse courte peut donc coûter cher.
Q4 : Pourquoi le coût d’une même requête peut-il changer soudainement ?
Les trois causes les plus courantes sont les suivantes : l’alias du modèle pointe vers une nouvelle version, une modification du préfixe de l’invite invalide le cache, ou le raisonnement est plus long. Il peut aussi s’agir de facturations répétées dues aux tentatives de réessai, ou de paramètres multimodaux revus à la hausse. Examinez les signaux d’anomalie du tableau présenté dans cet article pour trouver la cause.
Q5 : Comment vérifier sa facture d’API de grand modèle de langage à l’aide des journaux de la plateforme ?
Commencez par enregistrer dans votre système le champ `usage` et l’identifiant de requête de chaque réponse. Exportez ensuite les journaux d’appels de la plateforme et faites correspondre les données requête par requête. Sur APIYI apiyi.com, par exemple, vous pouvez consulter les statistiques d’utilisation et les journaux d’appels dans la console. Vérifiez d’abord les champs présents dans les journaux, puis rapprochez-les de vos enregistrements locaux.
Q6 : Comment estimer le coût d’un modèle multimodal ?
Consultez d’abord la page de tarification officielle pour vérifier le mode de facturation : par image, par seconde ou en Tokens calculés à partir de la résolution. Enregistrez ensuite les paramètres correspondants dans les journaux de requêtes, par exemple les dimensions des images, la durée audio, ainsi que la résolution et la durée des vidéos. Utilisez ces paramètres et les tarifs unitaires pour établir votre estimation.
Q7 : Par où commencer lorsqu’on constate un écart lors du rapprochement ?
Vérifiez d’abord que votre relevé des tarifs est à jour afin d’écarter un changement de prix. Comparez ensuite le nombre d’appels pour repérer les tentatives de réessai et les requêtes en double. Enfin, décomposez l’écart par modèle et par poste de facturation pour déterminer s’il concerne les entrées, le cache, le raisonnement ou la partie multimodale.
Q8 : Quelles sont les limites de cette méthode de rapprochement ?
Elle dépend des champs d’usage renvoyés dans les réponses. Si certains modèles ou certaines interfaces ne fournissent pas le détail du cache et du raisonnement, il faut s’appuyer sur la facture de la plateforme. Par ailleurs, les taux de change, la précision de facturation et les fuseaux horaires utilisés pour les statistiques peuvent entraîner de légers écarts. Mieux vaut donc définir un seuil raisonnable que chercher une concordance au centime près.
Facturation des API de grands modèles de langage : les points clés
- La facture comporte plusieurs postes : les tarifs des entrées, des sorties, du cache, du raisonnement et du multimodal diffèrent et doivent être comptabilisés séparément.
- Les tokens d’entrée ne se limitent pas à la question de l’utilisateur : l’invite système, l’historique, les documents récupérés et les définitions d’outils sont aussi comptabilisés.
- Les accès au cache dépendent de la cohérence du préfixe : placez le contenu fixe en premier et les variables à la fin, puis vérifiez le taux d’accès au cache après toute modification du modèle d’invite.
- Les tokens de raisonnement sont invisibles, mais facturés : évitez les modèles de raisonnement pour les tâches simples et surveillez l’évolution de la longueur du raisonnement.
- Pour le multimodal, vérifiez d’abord l’unité de facturation : par image, par seconde ou selon la résolution. Référez-vous à la page tarifaire officielle.
- Rapprochez les factures en quatre étapes : enregistrez l’utilisation, conservez des relevés tarifaires datés, calculez les frais attendus et comparez-les aux journaux et aux factures.
- Un point d’accès unique facilite le rapprochement : le solde commun et les journaux d’invocation d’APIYI apiyi.com permettent de vérifier au même endroit l’utilisation de plusieurs modèles.
En résumé
Pour comprendre et vérifier les factures API des grands modèles de langage, retenez trois points :
- Décomposez les frais : répartissez le coût de chaque invocation entre entrée, cache, sortie, raisonnement et multimodal, en identifiant l’origine de chaque poste ;
- Tenez vos propres relevés : enregistrez en base les champs d’utilisation et les paramètres techniques de chaque invocation, et conservez des relevés tarifaires datés ;
- Comparez régulièrement : examinez les tendances chaque semaine et rapprochez les comptes chaque mois. En cas de variation soudaine, vérifiez tour à tour la version du modèle, les accès au cache, la longueur du raisonnement, les nouvelles tentatives et les paramètres techniques.
Les plateformes vérifient elles-mêmes ces modalités de facturation, mais il est tout aussi important, en tant qu’utilisateur, de prendre l’habitude de rapprocher vos propres comptes. Si votre activité nécessite d’utiliser les modèles de plusieurs fournisseurs, vous pouvez passer par APIYI apiyi.com pour les réunir dans une seule interface, consulter l’utilisation et les journaux d’invocation, puis effectuer vos vérifications avec la méthode présentée ici.
📚 Ressources
- Offre d’emploi sur V2EX : gestion de plateforme de grands modèles de langage dans une entreprise d’infrastructure pour agents IA : les responsabilités du poste incluent la « vérification des coûts et de la facturation »
- Lien :
v2ex.com/t/1254263 -
Description : publiée le 2026-11-03, cette offre précise que l’équipe plateforme doit vérifier les règles de facturation des tokens d’entrée et de sortie, des tokens mis en cache, des tokens de raisonnement, ainsi que des images, de l’audio et de la vidéo. Elle doit aussi repérer les factures anormales, les changements de prix et les écarts de facturation.
-
Pages tarifaires officielles des fournisseurs de modèles : seule source faisant autorité pour les prix unitaires et les règles de facturation
- Lien : consultez la rubrique Tarifs ou Documentation du site officiel de votre fournisseur
- Description : les prix changent fréquemment ; pensez à noter la date de consultation lorsque vous les citez.
Auteur : équipe technique APIYI
Échanges techniques : si vous avez des questions sur la vérification des factures d’API de grands modèles de langage, contactez-nous depuis la page d’accueil d’APIYI, apiyi.com. Retrouvez d’autres ressources d’intégration dans le centre de documentation docs.apiyi.com.