Note de l’auteur : guide de diagnostic des erreurs d’invocation d’API de modèles en production. Il aide à localiser la panne à l’aide des codes d’erreur, des journaux et d’une reproduction minimale avec curl, puis à préparer un signalement complet.
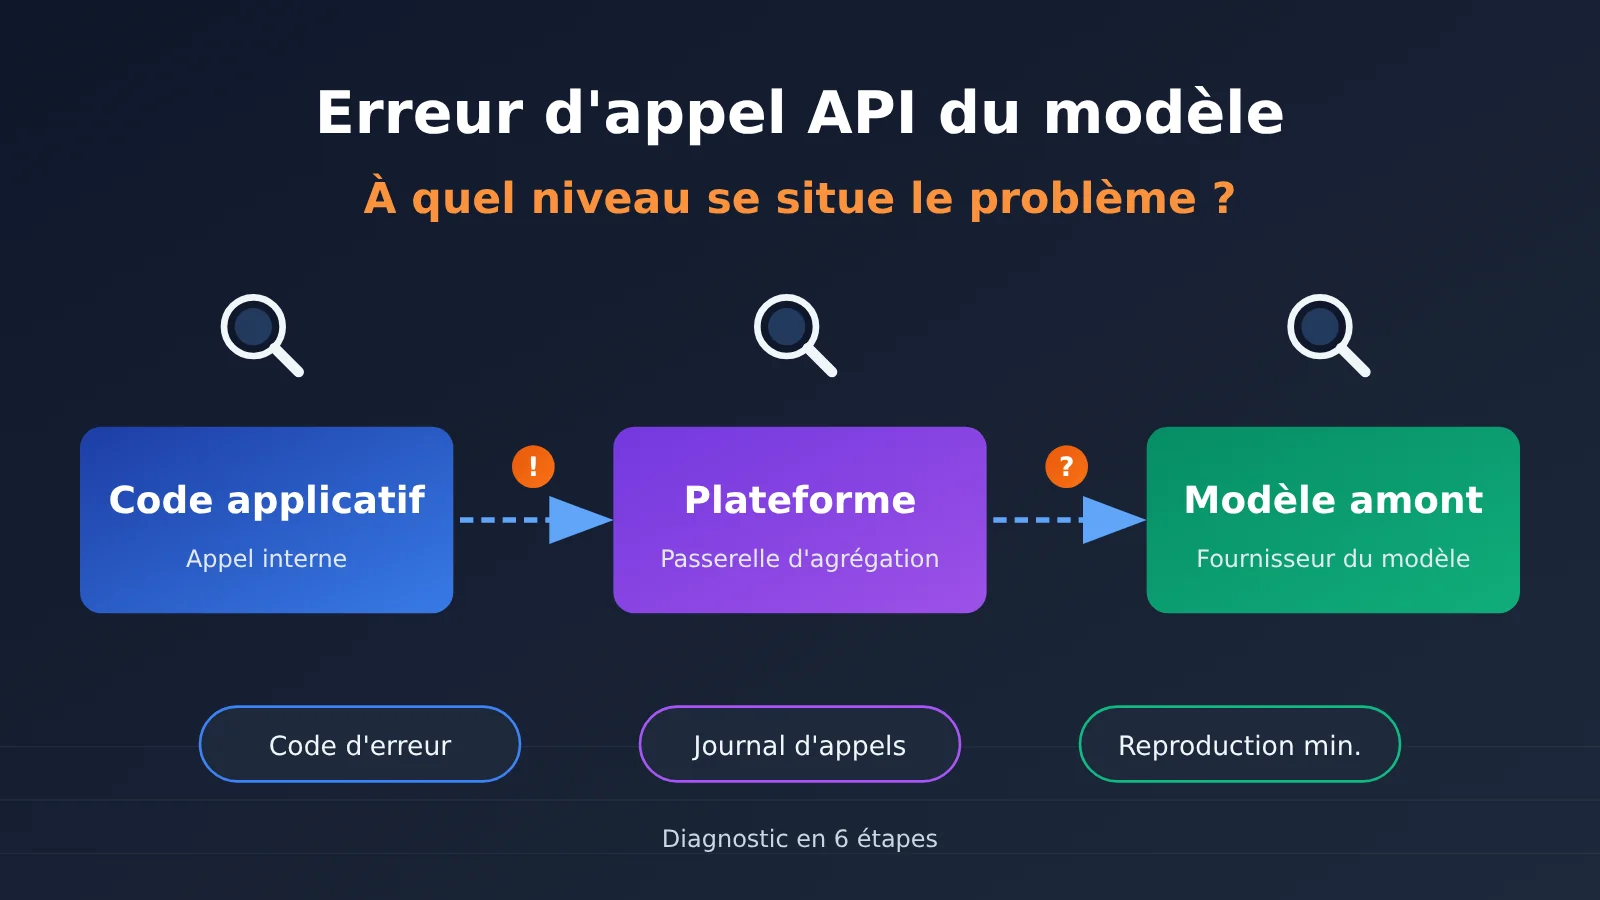
Une alerte au beau milieu de la nuit : le taux d’erreur de l’API du modèle augmente. Le plus long n’est souvent pas de corriger le problème, mais de savoir à qui s’adresser. Votre code a-t-il été modifié ? La plateforme de passerelle rencontre-t-elle un incident ? Ou le service du modèle en amont est-il instable ? Cet article présente une méthode de diagnostic en trois niveaux : « votre invocation → plateforme de passerelle → modèle en amont », pour cibler rapidement vos recherches en cas d’erreur d’invocation d’une API de modèle.
Ce n’est pas une simple liste de codes d’erreur. Cette approche en trois niveaux est aussi couramment utilisée par les équipes qui exploitent les plateformes d’agrégation de modèles : elles s’appuient sur les paramètres de requête, les journaux, les codes d’erreur et une reproduction de la chaîne d’appel pour déterminer si le problème vient de l’utilisateur, de la plateforme ou du service du modèle en amont. Nous en tirons ici un ordre de diagnostic directement applicable côté client. Que vous vous connectiez directement au fournisseur ou que vous passiez par une passerelle d’agrégation comme APIYI, vous pouvez suivre les mêmes étapes.
À retenir : vous découvrirez un diagnostic en 6 étapes, les signes qui permettent de reconnaître les grandes catégories d’erreurs, une méthode de reproduction minimale avec curl et une liste d’informations à remplir pour signaler l’incident.
Les points clés pour attribuer une erreur d’API de modèle à la bonne couche
Un appel à une API de modèle traverse au moins trois couches : votre application et son environnement réseau, une passerelle ou une plateforme d’agrégation intermédiaire, puis le service de modèle en amont qui fournit l’inférence. En accès direct auprès du fournisseur, la couche intermédiaire est mince, mais l’équilibrage de charge et la couche d’accès existent toujours. Le diagnostic consiste à déterminer précisément à quelle couche se situe le problème.
| Couche en cause | Problèmes typiques | Signaux courants | Responsable |
|---|---|---|---|
| Votre propre appel | Clé incorrecte, paramètres non valides, fenêtre de contexte dépassée, délai d’expiration local trop court, problème de proxy ou de DNS | Erreur 4xx reproductible ; fonctionnement normal dans un autre environnement ; seuls certains chemins de code sont touchés | Vous |
| Plateforme passerelle | Problème d’authentification ou de facturation, correspondance incorrecte des paramètres, routage ou mécanisme de repli défectueux, limitation de débit par la plateforme, connexion interrompue en cours de route | L’accès direct fonctionne, mais l’appel via la passerelle échoue ; le format du message d’erreur diffère de celui du fournisseur en amont ; plusieurs modèles présentent des anomalies en même temps | La plateforme |
| Modèle en amont | Surcharge du service, changement de version du modèle, dérive des capacités, limitation de débit côté fournisseur | Plusieurs canaux d’accès échouent simultanément ; la page d’état du fournisseur contient une annonce ; un seul modèle est touché | Le fournisseur du modèle (généralement par l’intermédiaire de la plateforme) |
Pourquoi commencer par identifier la couche en cause
Quand un appel à une API de modèle échoue, beaucoup d’équipes commencent par multiplier les tentatives ou changer directement de modèle. Cela peut parfois résoudre le problème temporairement, mais sans en trouver la cause, il risque de réapparaître quelques jours plus tard. Cette approche peut aussi masquer une véritable erreur de configuration. Identifier d’abord la couche en cause permet d’éviter de perdre du temps dans la mauvaise direction.
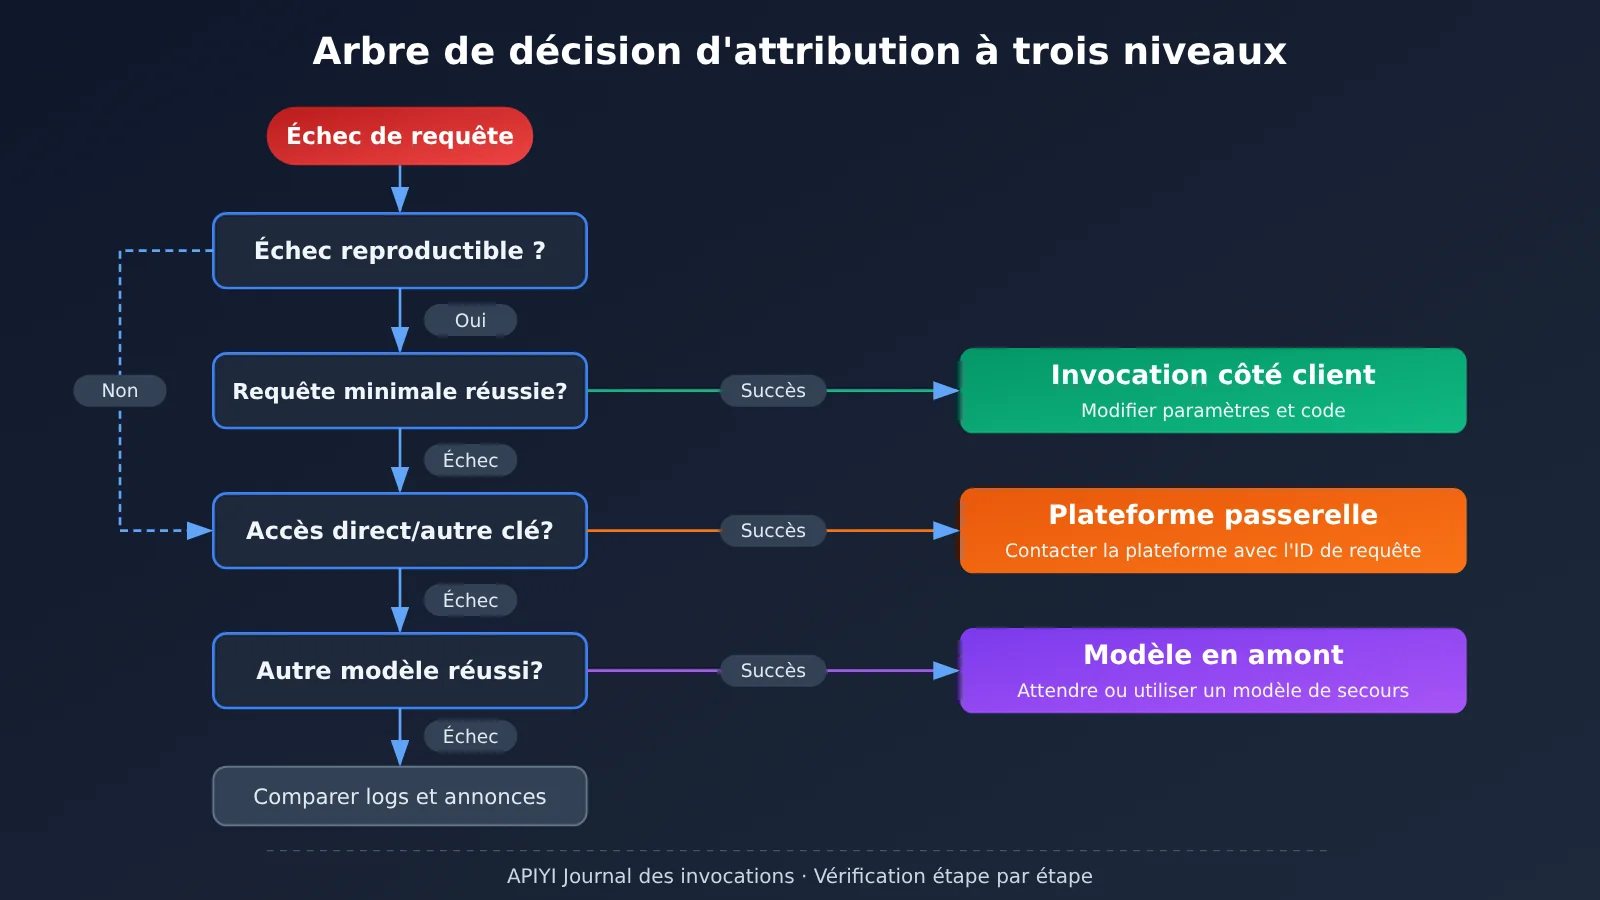
Cette attribution a un autre avantage : elle indique à qui s’adresser ensuite. Si le problème vient de votre propre appel, une modification du code peut suffire. S’il vient de la plateforme passerelle, il faut contacter celle-ci en lui fournissant l’identifiant de la requête. S’il vient du modèle en amont, il ne reste généralement qu’à attendre le rétablissement du service, changer de modèle ou activer un mécanisme de repli. Les solutions sont très différentes : une mauvaise attribution allonge donc le temps de résolution.
Les 6 étapes pour diagnostiquer une erreur d’invocation du modèle via API
Cet ordre suit un principe simple : commencer par les vérifications les moins coûteuses, isoler le problème, puis approfondir. Chaque étape vise à écarter une piste plutôt qu’à remettre en cause tous les éléments à la fois.
- Déterminer l’étendue du problème : tous les appels échouent-ils ou seulement certains ? Un seul modèle est-il touché ou plusieurs ? Depuis quand ? Plus le problème est étendu, plus il est probable qu’il vienne de la plateforme ou du service en amont. S’il ne touche qu’une fonctionnalité, la cause se trouve probablement dans votre code.
- Consigner l’erreur brute : conservez le code d’état HTTP, le corps de la réponse tel quel, l’ID de requête présent dans les en-têtes de réponse (s’il existe), l’heure et la durée de l’appel. Ne vous limitez pas à l’exception produite par le SDK : son traitement peut masquer des détails importants.
- Créer un exemple minimal reproductible : en dehors du code métier, envoyez avec curl une requête aussi simple que possible, par exemple un court texte, sans streaming ni appel d’outils. Si elle réussit, le problème vient probablement de votre combinaison de paramètres ou de votre logique métier.
- Réintroduire les paramètres progressivement : à partir de la requête minimale, ajoutez successivement l’invite système, le contexte long,
stream,tools,response_format, etc., jusqu’à trouver ce qui déclenche l’échec. - Comparer avec d’autres configurations : essayez un autre modèle sur la même passerelle ou, si votre environnement réseau le permet, connectez-vous directement au fournisseur. Si changer de modèle résout le problème, la cause se situe généralement en amont ; si la connexion directe fonctionne, elle pointe plutôt vers la passerelle.
- Consulter les journaux et les annonces : vérifiez les journaux d’appels de la plateforme et la page d’état du fournisseur pour savoir si la requête a atteint la plateforme, si celle-ci l’a transmise et quelle réponse le service en amont a renvoyée.
Erreurs courantes des API de modèles et signaux de diagnostic
Les codes d’erreur sont les indices les plus directs pour diagnostiquer un problème, mais leur correspondance varie selon les plateformes. Le tableau ci-dessous s’appuie sur la sémantique HTTP générale : pour connaître leur sens exact, consultez la documentation de votre plateforme.
| Catégorie d’erreur | Manifestation typique | Signal de diagnostic | Origine la plus probable |
|---|---|---|---|
| Échec d’authentification | 401 / 403 | Une autre clé résout le problème ; la clé contient des espaces en trop ou est utilisée dans le mauvais environnement | Principalement l’invocation du modèle, parfois l’état du compte sur la plateforme |
| Erreur de paramètre | 400 / 422 | Une requête minimale fonctionne, puis échoue après l’ajout d’un paramètre ; le message d’erreur indique le nom du champ | L’invocation du modèle ou une erreur de correspondance des paramètres sur la plateforme |
| Modèle inexistant | 404 ou message indiquant que le modèle est invalide | Le nom du modèle est mal orthographié, ou le modèle a été retiré ou renommé | L’invocation du modèle ou un changement de version du modèle |
| Limitation de débit / quota | 429 | Le service fonctionne à nouveau après réduction de la concurrence ; les en-têtes de réponse indiquent un délai avant une nouvelle tentative | Selon l’origine de la limitation : la plateforme ou le service en amont |
| Erreur serveur | 500 / 502 / 503 | Une même requête réussit parfois et échoue à d’autres moments ; plusieurs utilisateurs signalent le problème en même temps | La passerelle de la plateforme ou le modèle en amont |
| Délai dépassé | 504 ou délai dépassé côté client | Plus fréquent pour les requêtes produisant de longues réponses ; le problème disparaît en mode streaming | Le délai configuré localement, celui de la passerelle ou une inférence trop lente en amont |
| Interruption du streaming | La connexion SSE s’interrompt sans marqueur de fin | La requête fonctionne sans streaming ; le problème apparaît uniquement pour les longues réponses | Un proxy intermédiaire, la politique de maintien des connexions de la passerelle ou le service en amont |
Cas particuliers : interruptions de flux, changements de version et basculement automatique
Les interruptions de flux sont parmi les problèmes les plus difficiles à diagnostiquer. Le client voit seulement que la connexion a été interrompue, alors que le code HTTP peut encore être 200. Pour commencer, vérifiez si votre proxy, votre répartiteur de charge ou Nginx impose un délai d’inactivité trop court aux connexions longues. Utilisez ensuite curl avec l’option -N pour observer directement les données SSE brutes et vérifier si le marqueur de fin a bien été reçu.
Les changements de version ne provoquent pas forcément d’erreur, mais ils peuvent modifier les résultats : par exemple, le format JSON devient moins stable ou des paramètres manquent dans les appels d’outils. Si le nom du modèle pointe vers un alias mis à jour en continu, son comportement peut changer sans préavis après une mise à jour en amont. En production, il est préférable de choisir, autant que possible, un nom de modèle comportant une date ou un numéro de version, et d’effectuer régulièrement des tests de régression.
Le basculement automatique et le routage dynamique peuvent rendre les résultats du diagnostic incohérents d’un essai à l’autre. Certaines passerelles passent automatiquement à un canal ou à un modèle de secours en cas de défaillance en amont. Cela améliore la disponibilité, mais peut aussi donner l’impression qu’une même requête fonctionne une fois et échoue la suivante, ou que le style de la réponse change soudainement. Vérifiez si le champ model de la réponse correspond à celui de la requête. Si les journaux de la plateforme indiquent le canal ou le modèle réellement utilisé, vérifiez-les également. La possibilité pour le client de détecter ce basculement dépend de l’implémentation de la plateforme : mieux vaut le confirmer à l’avance auprès de celle-ci.
Erreurs d’invocation du modèle via API : une reproduction minimale avec curl
Une reproduction minimale permet d’écarter les interférences du code applicatif. curl ne dépend d’aucun SDK et montre les échanges HTTP bruts : c’est donc un bon moyen d’obtenir des éléments concrets pour le diagnostic. Les exemples ci-dessous utilisent une interface compatible avec OpenAI ; remplacez l’adresse par le base_url indiqué dans la documentation de votre plateforme.
5 astuces curl pour une reproduction minimale
- Voir uniquement le code de statut et la durée : utilisez
-sS -o /dev/null -w "%{http_code} %{time_total}"pour vérifier en quelques secondes si la requête aboutit et combien de temps elle prend. - Examiner les en-têtes complets de la requête et de la réponse : utilisez l’option
-vpour voir la négociation TLS et les en-têtes. De nombreuses plateformes placent l’identifiant de requête et les informations de limitation de débit dans les en-têtes de réponse. - Distinguer les temps de chaque étape de connexion : ajoutez
%{time_namelookup},%{time_connect}et%{time_starttransfer}à-w. Un DNS ou un établissement de connexion lent indique généralement un problème de réseau local ; un délai élevé avant le premier octet suggère plutôt une lenteur de la passerelle ou de l’inférence en amont. - Observer la réponse en streaming : ajoutez
-Npour désactiver la mise en mémoire tampon et définissez"stream": truedans le corps de la requête. Vous pourrez ainsi suivre les données SSE ligne par ligne et repérer où se produit l’interruption. - Réduire le corps de la requête au minimum : ne gardez que
modelet une entréemessagescontenant un court texte, sans paramètres facultatifs commetools,response_formatoumax_tokens.
🚀 Conseil de diagnostic : sur une plateforme d’agrégation comme APIYI, une même clé API permet d’accéder aux modèles de plusieurs fournisseurs. Pour comparer les modèles lors d’une reproduction minimale, il suffit de modifier le champ
model, sans créer de compte ni obtenir de clé auprès de chaque fournisseur.
Matrice de tests comparatifs : localiser la couche en cause
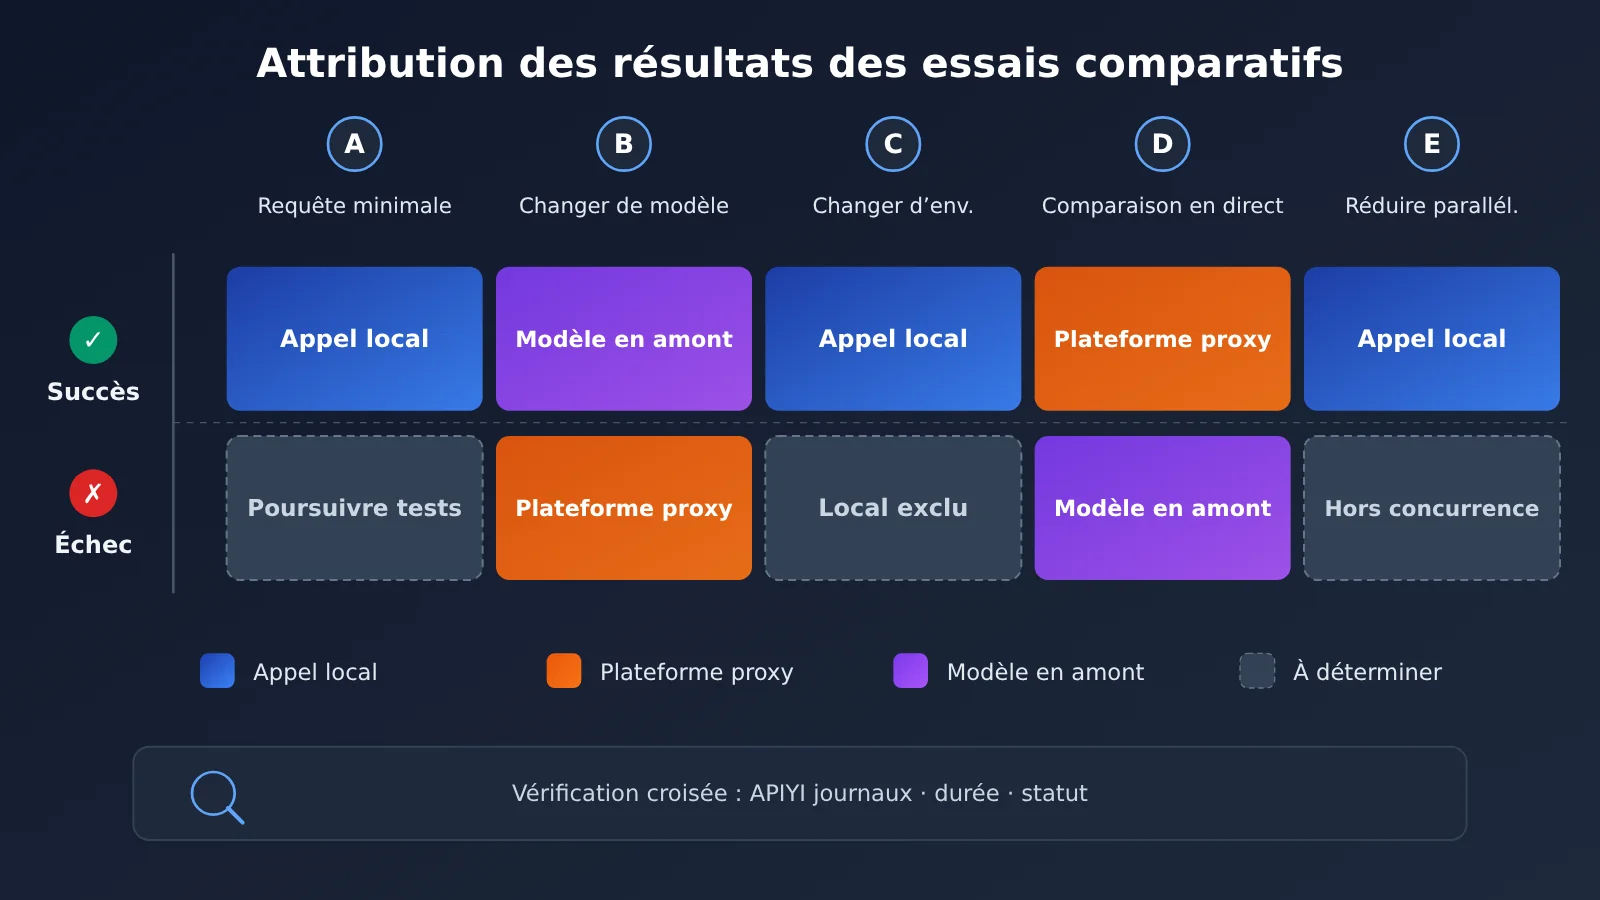
Intégrer la reproduction minimale à des tests comparatifs permet d’obtenir un diagnostic plus fiable. Nous vous conseillons d’exécuter au moins les trois premiers tests du tableau.
| Test | Action | En cas de succès | En cas d’échec |
|---|---|---|---|
| A : requête minimale | Même clé API, même modèle, corps de requête minimal | Le problème vient des paramètres applicatifs ou de la logique du code | Poursuivre avec les tests B et C |
| B : changer de modèle | Même passerelle, même clé API, modèle d’un autre fournisseur | Le service en amont du modèle initial peut être en cause | La passerelle, la clé API ou le réseau local sont plus suspects |
| C : changer d’environnement | Envoyer la même requête depuis une autre machine ou un autre réseau | Le réseau local, le proxy ou le DNS pose problème | Écarter les facteurs liés au réseau local |
| D : connexion directe | Si possible, se connecter directement à l’interface officielle du fournisseur | La passerelle est plus suspecte ; signaler le problème à la plateforme | Le modèle en amont présente une anomalie |
| E : réduire la concurrence | Réessayer avec une seule requête simultanée | Problème de limitation de débit ou de quota | Le problème n’est pas lié à la concurrence |
Utiliser les journaux d’appels pour identifier l’origine des erreurs d’API de modèles
curl peut vous dire si une requête échoue « maintenant » ; les journaux d’appels vous montrent ce qui s’est passé « à ce moment-là ». Les problèmes en production sont souvent difficiles à reproduire de manière fiable : les journaux sont alors la seule source de preuves. Pour les analyser, faites correspondre les journaux de votre application et ceux de la plateforme par heure et par ID de requête, puis examinez-les ensemble.
Côté application, il est conseillé de consigner au minimum : l’heure de la requête, le nom du modèle, un résumé des paramètres sans données sensibles, le code d’état HTTP, la réponse d’erreur originale, la durée totale, le délai avant le premier octet et l’ID de requête renvoyé par la plateforme. Les journaux de la plateforme complètent ces informations : ils peuvent notamment indiquer si la requête est arrivée à destination, combien de tokens ont été facturés et quel modèle a réellement été invoqué.
💡 Conseil pour utiliser les journaux : si vous passez par APIYI, vous pouvez consulter les appels par plage horaire dans la console et les faire correspondre un par un avec les journaux de votre application. Pour savoir quels champs figurent dans les journaux de la plateforme et si les erreurs originales du fournisseur en amont sont transmises telles quelles, reportez-vous aux indications de la console et de la documentation. En cas de doute, demander directement au support technique sera plus rapide que de faire des suppositions.
Informations à fournir au prestataire lors d’un signalement
Plus votre signalement est complet, plus le problème pourra être résolu rapidement. Une description comme « l’API ne fonctionne plus » entraînera presque à coup sûr plusieurs échanges pour obtenir des précisions. Préparez les informations du tableau ci-dessous pour les transmettre en une seule fois.
| Information | Exemple | Utilité |
|---|---|---|
| Plage horaire | Précise à la seconde, avec le fuseau horaire | Faciliter la recherche dans les journaux de la plateforme |
| ID de requête | Identifiant unique dans les en-têtes ou le corps de la réponse | Retrouver directement une requête précise |
| Nom du modèle et point de terminaison | Nom complet du modèle et chemin de l’API | Déterminer si le problème concerne un fournisseur en amont particulier |
| Erreur originale | Code d’état et corps complet de la réponse | Distinguer une erreur de la plateforme d’une erreur transmise par le fournisseur en amont |
| Procédure minimale de reproduction | Description des paramètres curl après masquage des données sensibles | Permettre au prestataire de reproduire le problème de manière fiable |
| Étendue de l’impact | Proportion d’échecs, modèles ou fonctionnalités touchés | Évaluer la gravité du problème |
| Comparaisons déjà effectuées | Résultats des tests des groupes A à E | Éviter de refaire les mêmes vérifications |
Avant de signaler le problème, masquez la clé API et les données personnelles des utilisateurs. Ne conservez que les premiers et les derniers caractères de la clé pour l’identifier. Si votre plateforme propose un support technique 24 h/24 et 7 j/7, vous pouvez, en cas d’urgence, signaler d’abord brièvement l’étendue de l’impact, puis compléter votre message avec les détails.
Questions fréquentes (FAQ)
Q1 : Quelle est la première chose à faire en cas d’erreur lors d’une invocation du modèle via l’API ?
Consignez d’abord l’erreur d’origine : code d’état, contenu exact de la réponse, identifiant de la requête et heure. Déterminez ensuite l’étendue du problème. Ne vous précipitez pas pour redémarrer le service ou modifier le code : une fois les informations d’origine perdues, il sera beaucoup plus difficile d’identifier la cause.
Q2 : Comment savoir si le problème vient de la passerelle ou du modèle en amont ?
Le plus efficace est de faire un test comparatif : essayez un autre modèle avec la même passerelle. Si tout fonctionne à nouveau, le service en amont du modèle initial est plus suspect. Si vous pouvez vous connecter directement au fournisseur et que cela fonctionne, la passerelle est plus probablement en cause. Vous pouvez aussi examiner le format de la réponse d’erreur : les erreurs transmises par le service en amont présentent souvent une structure propre au fournisseur.
Q3 : Une erreur 429 de limitation de débit vient-elle forcément de mon côté ?
Pas forcément. Une erreur 429 peut venir du quota de votre compte, d’une limite de requêtes simultanées par clé imposée par la plateforme ou d’une surcharge générale en amont. Commencez par limiter les requêtes simultanées à une seule, puis réessayez. Consultez ensuite les indications de limitation dans les en-têtes de la réponse et demandez à la plateforme à quel niveau la limite a été atteinte.
Q4 : Comment diagnostiquer une requête qui fonctionne de manière intermittente ?
Vérifiez d’abord les mécanismes de basculement automatique ou de routage dynamique : comparez le champ `model` de la réponse avec le canal réellement utilisé, indiqué dans les journaux de la plateforme. Analysez ensuite la distribution des temps de réponse des requêtes échouées. Si les échecs se concentrent autour d’une durée précise, un délai d’expiration a peut-être été atteint à un niveau de la chaîne.
Q5 : Comment réaliser des tests comparatifs entre modèles à moindre coût ?
Le plus simple est d’utiliser une plateforme d’agrégation qui propose une interface unifiée pour plusieurs modèles. Sur APIYI, il suffit de modifier le champ `model` avec la même clé pour changer de fournisseur. Vous pouvez ainsi créer un cas de reproduction minimal et comparer les modèles en quelques minutes, sans ouvrir un compte chez chaque fournisseur.
Q6 : Une baisse soudaine de la qualité des réponses du modèle est-elle considérée comme une erreur d’invocation ?
Ce type de problème ne génère pas de message d’erreur, mais il faut tout de même en trouver la cause. Vérifiez d’abord si le nom du modèle pointe vers un alias mis à jour régulièrement, puis comparez les résultats à l’aide de cas de test fixes et de résultats historiques. Si le comportement du modèle a effectivement changé, signalez-le à la plateforme avec des exemples comparatifs.
Q7 : Faut-il fournir des informations sur le service en amont lorsqu’on signale un incident via une passerelle d’agrégation ?
Vous n’avez pas besoin de contacter vous-même le fournisseur en amont, mais vous devez fournir l’identifiant de la requête, le nom du modèle et le message d’erreur exact. La plateforme pourra ainsi consulter les journaux de transfert et déterminer si l’erreur vient du service en amont. Par exemple, lorsque vous contactez le support technique d’APIYI, fournir l’identifiant de la requête et la plage horaire concernée réduit nettement le nombre d’allers-retours.
Points clés pour diagnostiquer les erreurs d’appel d’API de modèles
- Identifier d’abord la couche en cause : déterminez si le problème vient de votre appel, de la plateforme passerelle ou du fournisseur du modèle.
- Conserver les données d’origine : le code d’état, la réponse brute et l’identifiant de requête sont les principaux éléments de diagnostic.
- Délimiter le problème avec une reproduction minimale : utilisez curl pour isoler le code métier, puis réintroduisez les paramètres un par un jusqu’à trouver celui qui provoque l’échec.
- Comparer pour localiser la panne : changez de modèle, changez d’environnement et testez une connexion directe pour déterminer la couche concernée.
- Surveiller le basculement automatique : si les résultats varient d’un appel à l’autre, vérifiez le modèle réellement utilisé dans la réponse et les traces de routage.
- Recouper les journaux : comparez les journaux de l’application avec ceux de plateformes comme APIYI, en vous appuyant sur l’heure et l’identifiant de requête.
- Structurer le signalement : transmettez en une fois l’heure, l’identifiant de requête, le message d’erreur brut et les résultats des tests comparatifs.
En résumé
Lorsqu’un appel d’API de modèle échoue, le plus important n’est pas de trouver immédiatement une solution, mais de déterminer d’abord à quel niveau se situe le problème :
- Votre appel : confirmez le diagnostic avec une reproduction minimale, puis en réintroduisant les paramètres progressivement. Une modification du code ou de la configuration suffit généralement.
- La plateforme passerelle : confirmez le diagnostic en comparant avec une connexion directe et en consultant les journaux de la plateforme, puis contactez son équipe avec l’identifiant de requête.
- Le fournisseur du modèle : confirmez le diagnostic en testant un autre modèle et en consultant les annonces du fournisseur. Changez de modèle ou appliquez une stratégie de repli pour limiter l’impact.
Nous vous conseillons de consigner les six étapes de diagnostic et la liste de signalement de cet article dans le guide d’astreinte de votre équipe. Vous pourrez ainsi les suivre directement lors de la prochaine alerte. Si vous mettez en place une intégration multimodèle, APIYI apiyi.com permet de comparer différents modèles avec une même interface et de construire votre processus de diagnostic à partir des journaux d’appels de la plateforme.
📚 Références
- Codes d’état HTTP sur MDN : explication générale des codes d’état HTTP
- Lien :
developer.mozilla.org/zh-CN/docs/Web/HTTP/Status -
À consulter pour comprendre la signification standard des erreurs 4xx et 5xx
-
Manuel officiel de curl : documentation complète des paramètres de curl
- Lien :
curl.se/docs/manpage.html -
Présente les variables de durée de
-wet les options couramment utilisées pour le dépannage, comme-Net-v -
Server-Sent Events sur MDN : présentation du protocole de streaming SSE
- Lien :
developer.mozilla.org/zh-CN/docs/Web/API/Server-sent_events - Aide à comprendre le format des réponses en streaming et la manière dont les interruptions se manifestent
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil d’APIYI. Pour d’autres ressources sur l’intégration et le dépannage, consultez le centre de documentation docs.apiyi.com.