Note de l’auteur : à partir du projet d’évaluation des risques environnementaux de Heimstaden, nous examinons comment une personne qui ne développe pas peut utiliser Codex pour découvrir et nettoyer des données, puis construire un processus. Nous verrons aussi pourquoi la maîtrise de la méthodologie et la validation humaine doivent rester entre les mains des experts du domaine.
Beaucoup d’analystes métier connaissent leur secteur, mais ne savent pas coder. Face à un projet où les données sont dispersées entre des dizaines de sources publiques, dans des formats différents, ils devaient jusqu’ici attendre leur tour auprès de l’équipe technique ou faire appel à des consultants externes. À partir d’un cas réel rendu public, cet article présente une façon de répartir le travail entre l’humain et Codex lorsqu’une personne qui ne développe pas construit un processus de traitement des données. Nous nous concentrerons sur deux principes essentiels : la maîtrise de la méthodologie et la validation humaine.
Ce n’est pas un article promotionnel qui prétend que « l’IA peut tout faire à votre place ». Le cas présente des chiffres impressionnants, mais aussi beaucoup de détails qui n’ont pas été divulgués. Nous distinguerons clairement les faits connus des déductions.
Ce que vous allez en retenir : vous saurez quelles étapes d’un projet de données confier à un agent de programmation et quelles responsabilités garder pour vous. Vous comprendrez aussi comment transformer une analyse ponctuelle en une capacité que votre équipe pourra faire évoluer dans la durée.
Les points clés pour créer un processus de traitement des données avec Codex sans être développeur
Le 3 novembre 2026, OpenAI a publié une étude de cas consacrée à Heimstaden, un opérateur immobilier résidentiel européen. L’un des passages présente Julia Erlandsen, analyste en durabilité environnementale. Sans formation en développement logiciel, elle a réalisé avec Codex une évaluation des risques environnementaux couvrant l’ensemble du portefeuille immobilier. Le tableau ci-dessous résume les principaux enseignements de ce cas.
| Point clé | Ce que montre l’étude de cas | Ce que vous pouvez en retenir |
|---|---|---|
| Nature du problème | Les informations existent, mais sont dispersées entre différentes sources publiques, différents formats et jeux de données | Repérer les projets où les données sont dispersées : ils se prêtent particulièrement bien à l’utilisation d’un agent |
| Rôle de l’agent | Découverte, nettoyage et standardisation des données, contrôles qualité et développement d’un processus de traitement reproductible | Identifier les étapes que vous pouvez déléguer |
| Rôle de l’experte | L’analyste garde la maîtrise de la méthodologie et de la validation | Préserver la crédibilité des conclusions |
| Résultats à grande échelle | 20 112 biens évalués et plus de 6 millions de lignes de données exploitables générées | Montrer qu’une personne qui ne développe pas peut aussi traiter des volumes de données importants |
| Bénéfice à long terme | Le projet ponctuel devient un processus reproductible, sans recours à des consultants externes | Garder la maîtrise de la méthodologie et la faire évoluer soi-même |
Comment se répartissent les rôles dans un processus de traitement des données avec Codex
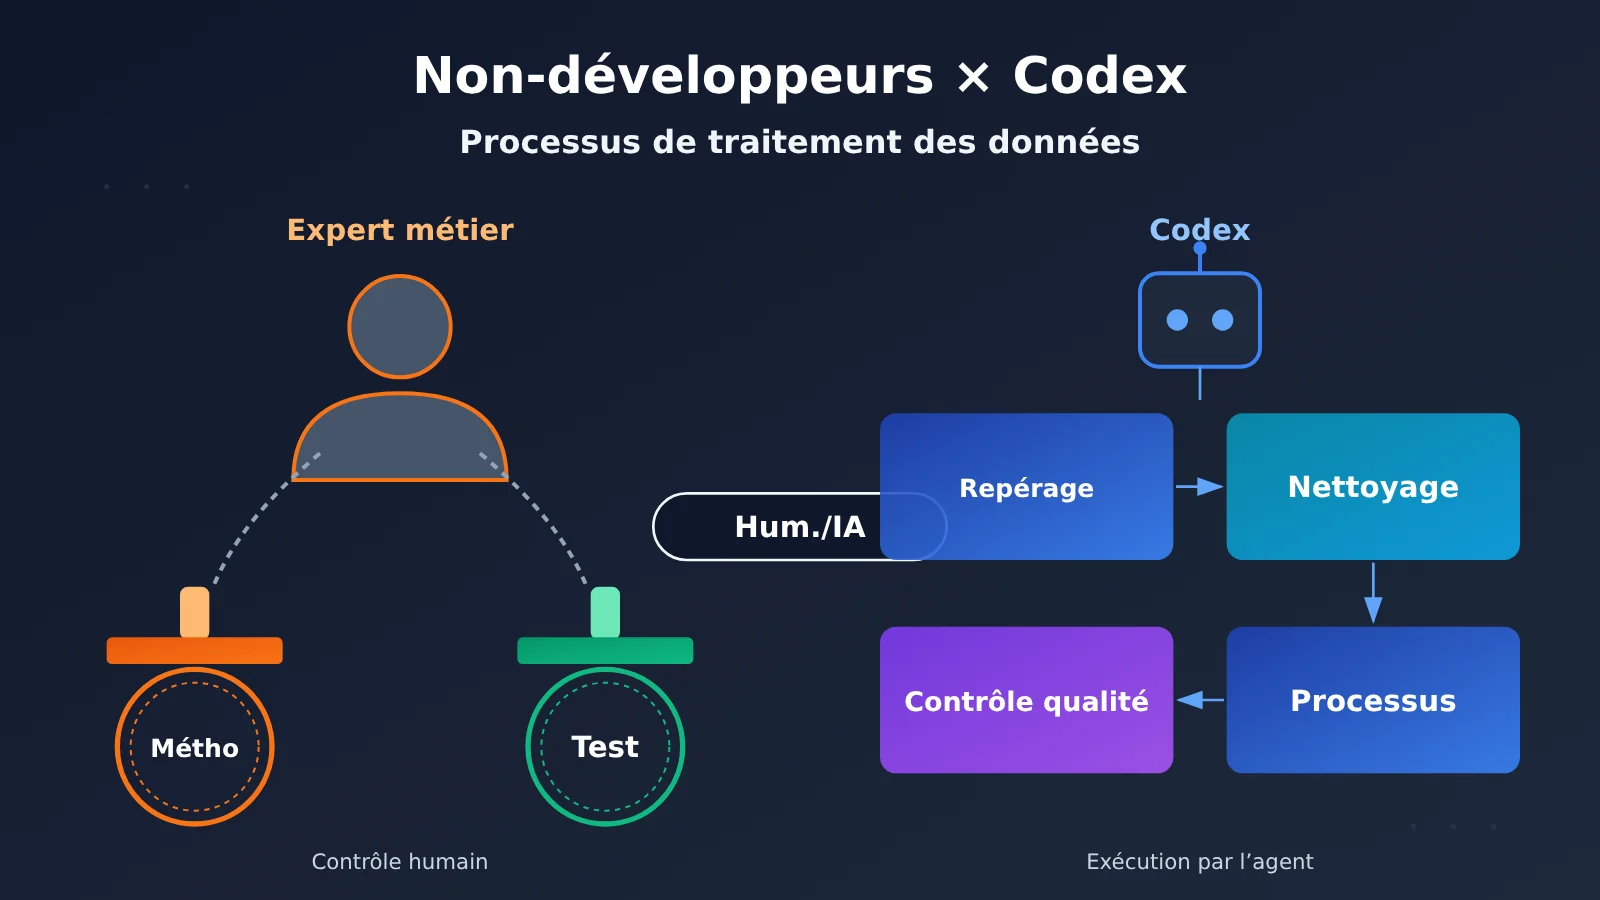
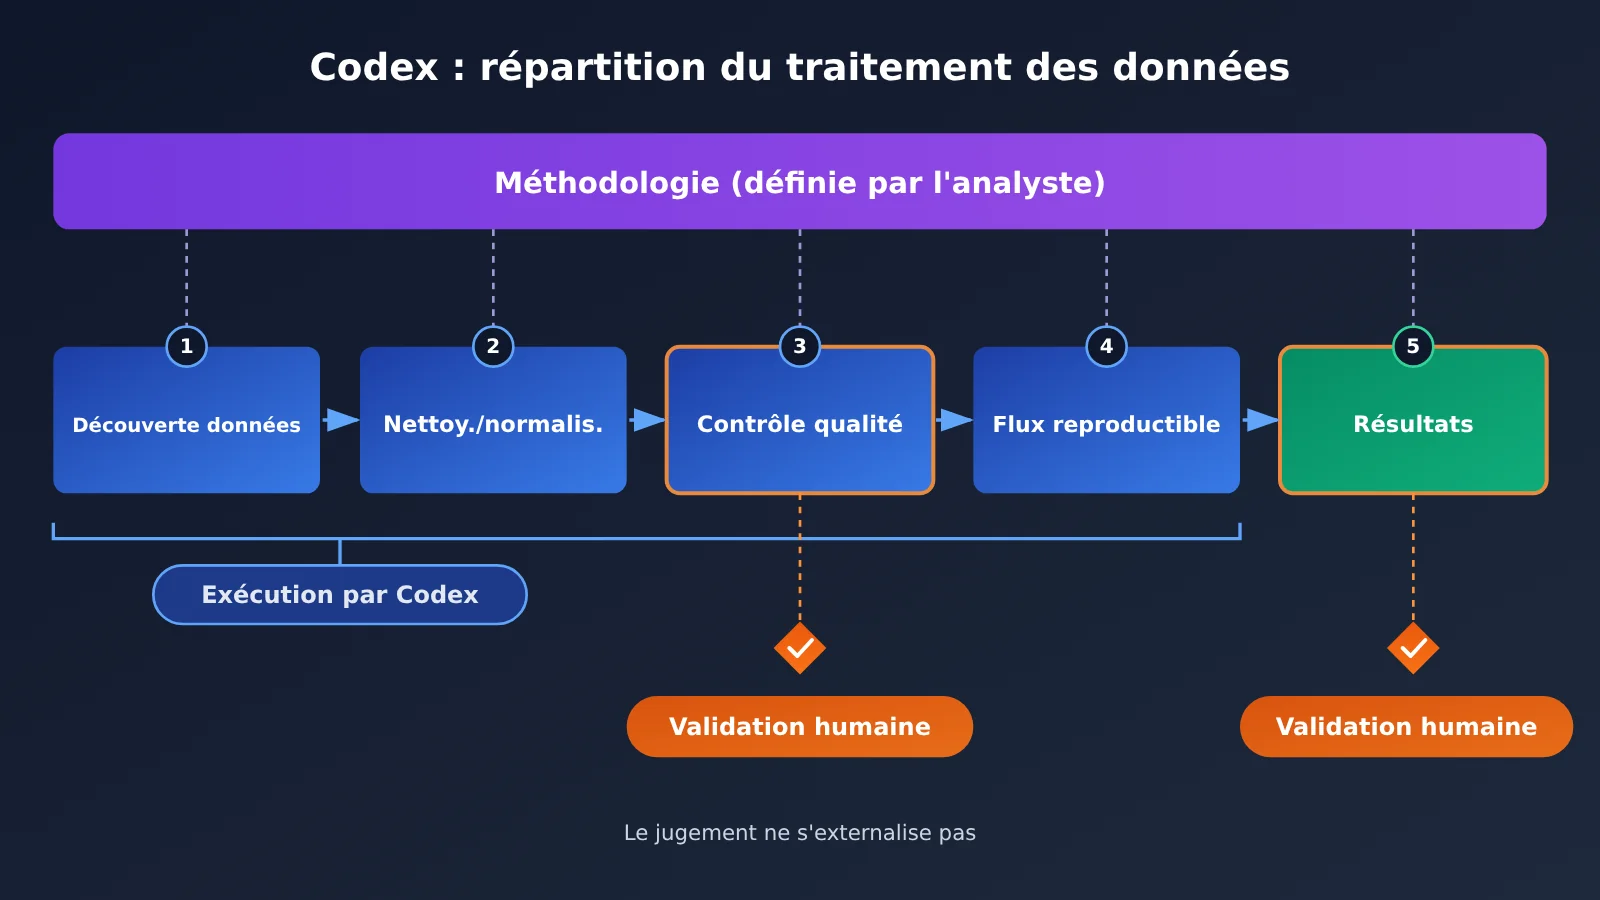
La phrase la plus importante de l’étude de cas est courte : Codex aide à découvrir, nettoyer et standardiser les données, à effectuer des contrôles qualité et à développer un processus de traitement reproductible, tandis que Julia garde le contrôle de la méthodologie et de la validation. Elle trace une frontière claire. Tout ce qui concerne la préparation des données et la mise en place d’un processus fonctionnel peut être confié à l’agent. En revanche, le choix des critères d’évaluation des risques et la vérification des résultats doivent rester entre des mains humaines.
Cette frontière est importante parce que l’évaluation des risques environnementaux sert ensuite à évaluer les risques climatiques, à respecter les obligations de reporting et à prendre des décisions d’investissement. Si la méthodologie repose sur les hypothèses par défaut de l’agent, l’analyste ne peut pas expliquer aux investisseurs ou aux auditeurs comment les conclusions ont été obtenues. Les propos de Julia vont dans ce sens : « Nous maîtrisons désormais cette méthodologie et pouvons continuer à la développer nous-mêmes. » Cette maîtrise désigne la compréhension et le contrôle de la logique d’évaluation, pas seulement la possession d’un tableau de résultats.
Principes de répartition des rôles pour un traitement de données avec Codex sans être développeur
En reprenant la répartition des responsabilités dans ce cas, on peut établir un tableau applicable à d’autres projets. La colonne « Détails révélés dans le cas » indique si le texte original fournit des précisions. Les pratiques proposées reposent sur notre expérience des projets de données et ne décrivent pas nécessairement les méthodes réellement utilisées par Heimstaden.
| Étape | Rôle de l’agent de programmation | Rôle conservé par l’expert métier | Détails révélés dans le cas |
|---|---|---|---|
| Découverte des données | Rechercher et répertorier les sources potentielles, expliquer le sens des champs | Déterminer si les sources font autorité et conviennent à l’évaluation | Sources précises non divulguées |
| Nettoyage et normalisation | Harmoniser les formats, unités et encodages, et faire correspondre les coordonnées et les adresses | Décider comment traiter les valeurs manquantes et contradictoires | Règles non divulguées |
| Contrôle qualité | Écrire des contrôles automatisés et produire une liste d’anomalies | Définir ce qui constitue une anomalie et vérifier des échantillons | Méthode et taux d’erreur non divulgués |
| Construction du processus | Regrouper les étapes dans un processus de traitement reproductible | Vérifier que la logique du processus respecte la méthodologie | Seul le caractère « reproductible » est mentionné |
| Méthodologie et conclusions | Effectuer les calculs selon les instructions | Définir le cadre d’évaluation, les pondérations et les seuils, et répondre des résultats | Explicitement conservés par l’analyste |
Ce tableau permet de dégager 5 principes de répartition des rôles :
- L’exécution peut être déléguée, pas le jugement. Un agent sait transformer une demande vague comme « organiser les données » en opérations concrètes. Mais seule une personne qui connaît le secteur peut répondre à la question : « Ce seuil est-il raisonnable ? »
- Rédigez d’abord la méthodologie, puis confiez-la à l’agent. Le cadre d’évaluation doit être un document que vous pouvez expliquer clairement par vous-même, et non une série d’instructions éparpillées dans une conversation.
- La validation exige un regard indépendant. Demander à l’agent qui a construit le processus de vérifier lui-même sa production ne permet de détecter qu’une partie des problèmes. Les vérifications humaines par échantillonnage et les comparaisons avec des références externes restent indispensables.
- Le processus doit être reproductible. Un résultat obtenu manuellement une seule fois ne permet pas d’itérer. Un processus qu’on peut relancer, lui, constitue un véritable actif.
- La responsabilité des conclusions revient toujours à une personne. La stratégie globale d’Heimstaden en matière d’IA souligne elle aussi que les employés sont responsables de l’examen et de l’approbation des décisions, et que les contenus générés par l’IA doivent être vérifiés par une personne avant leur diffusion.
🎯 Conseil technique : si une étape de votre processus de traitement des données nécessite l’invocation d’un grand modèle de langage, par exemple pour classer des descriptions textuelles non structurées par niveau de risque, vous pouvez passer par APIYI apiyi.com pour invoquer plusieurs grands modèles au moyen d’une même interface. Faire examiner les mêmes échantillons par différents modèles permet de repérer plus facilement les biais systématiques de l’un d’eux. C’est en soi une méthode de validation peu coûteuse.
Prise en main de Codex pour le traitement des données sans compétences en développement
Le cas ne précise ni quelle version de Codex Julia utilisait, ni comment elle interagissait avec l’outil ou organisait son travail. Les étapes ci-dessous ne reproduisent donc pas son expérience. Elles proposent plutôt une méthode de départ pour les analystes sans expérience en développement, inspirée de la répartition des tâches décrite dans le cas. Comme demandé, elles ne contiennent pas de code : chaque étape indique simplement ce qu’il faut fournir à l’agent et ce qu’il faut vérifier soi-même.
Première étape : rédiger une méthodologie en langage naturel
Avant de commencer, décrivez clairement la logique d’évaluation dans un document, par exemple methodology.md. Précisez au minimum l’objectif de l’évaluation, les indicateurs nécessaires, la méthode de calcul de chaque indicateur, les seuils qui définissent les niveaux de risque et les règles à suivre en cas de données manquantes. Ce document vous permet de garder la maîtrise de la méthodologie : il doit servir de référence chaque fois que vous demandez à l’agent de modifier le processus.
Deuxième étape : laissez l’agent explorer les données, mais gardez le dernier mot
Communiquez l’objectif de l’évaluation à l’agent et demandez-lui de répertorier les sources de données possibles, les champs qu’elles contiennent, leur fréquence de mise à jour et leurs limites connues. Examinez ensuite chaque source : fait-elle autorité et sa couverture correspond-elle à la répartition de vos actifs ? Demandez à l’agent de placer les données brutes téléchargées dans un répertoire raw distinct et de ne jamais les modifier. Tous les traitements ultérieurs doivent s’effectuer sur des copies.
Troisième étape : nettoyer et normaliser les données en gardant une trace de chaque modification
Indiquez à l’agent vos règles de normalisation, par exemple pour le format des adresses, le système de coordonnées, les unités et le format des dates, puis demandez-lui de générer le processus de traitement. Point essentiel : chaque transformation doit produire un journal des modifications, indiquant par exemple le nombre de lignes supprimées, le nombre d’enregistrements fusionnés et les enregistrements qui n’ont pas pu être rapprochés. Vous pourrez ainsi vérifier la pertinence du traitement à partir du journal, sans avoir à comprendre le code.
Quatrième étape : contrôler la qualité à deux niveaux
Le premier niveau est confié à l’agent : demandez-lui de créer des contrôles automatiques pour détecter les doublons, les valeurs manquantes, les valeurs hors limites et les échecs de correspondance des actifs, puis de produire une liste des anomalies. Le second niveau vous revient : prélevez aléatoirement une partie des actifs dans les résultats et vérifiez-les manuellement avec les méthodes que vous connaissez. Définissez à l’avance le taux d’échantillonnage et les critères de tolérance dans le document méthodologique, puis consignez-les séparément dans un tableau comme validation_log.
Cinquième étape : rendre le processus reproductible
Une fois les résultats jugés fiables, demandez à l’agent d’organiser l’ensemble en un processus relançable en un clic et de rédiger un mode d’emploi. Un collègue qui ne sait pas coder doit pouvoir le suivre sans difficulté. C’est à cette étape que le projet passe d’une « analyse ponctuelle » à une « capacité réutilisable ».
| Étape | Ce que vous fournissez à l’agent | Ce que vous devez vérifier | Risques courants |
|---|---|---|---|
| Méthodologie | Objectifs d’évaluation et connaissance du secteur | Document méthodologique rédigé par vos soins | Définition floue des indicateurs, entraînant des reprises répétées |
| Recherche de données | Objectifs et périmètre de couverture | Liste des sources et explication de leurs limites | Utilisation de données peu fiables ou obsolètes |
| Nettoyage et standardisation | Règles de standardisation | Historique des modifications à chaque étape | Suppression silencieuse de données, donnant une fausse impression de propreté |
| Contrôle qualité | Définition des anomalies et taux d’échantillonnage | Liste des anomalies et résultats des vérifications manuelles | Se fier uniquement aux contrôles automatiques et manquer des erreurs systématiques |
| Pérennisation du processus | Exigences d’exécution et de mise à jour | Processus relançable et mode d’emploi | L’agent est le seul à « se souvenir » de la marche à suivre |
🚀 Pour démarrer rapidement : si la troisième ou la quatrième étape nécessite un Grand modèle de langage pour comprendre des champs textuels, par exemple pour analyser des informations descriptives sur les risques dans des rapports publics de différents pays, commencez par comparer les résultats de plusieurs modèles sur un petit échantillon avec APIYI sur apiyi.com. Choisissez le plus stable, puis intégrez-le au processus définitif : vous éviterez ainsi de miser d’emblée tout le jeu de données sur un seul modèle.
Comparaison du processus de traitement des données avec Codex et d’autres approches
| Approche | Maîtrise de la méthodologie | Reproductibilité | Fiabilité de la validation | Principal problème |
|---|---|---|---|---|
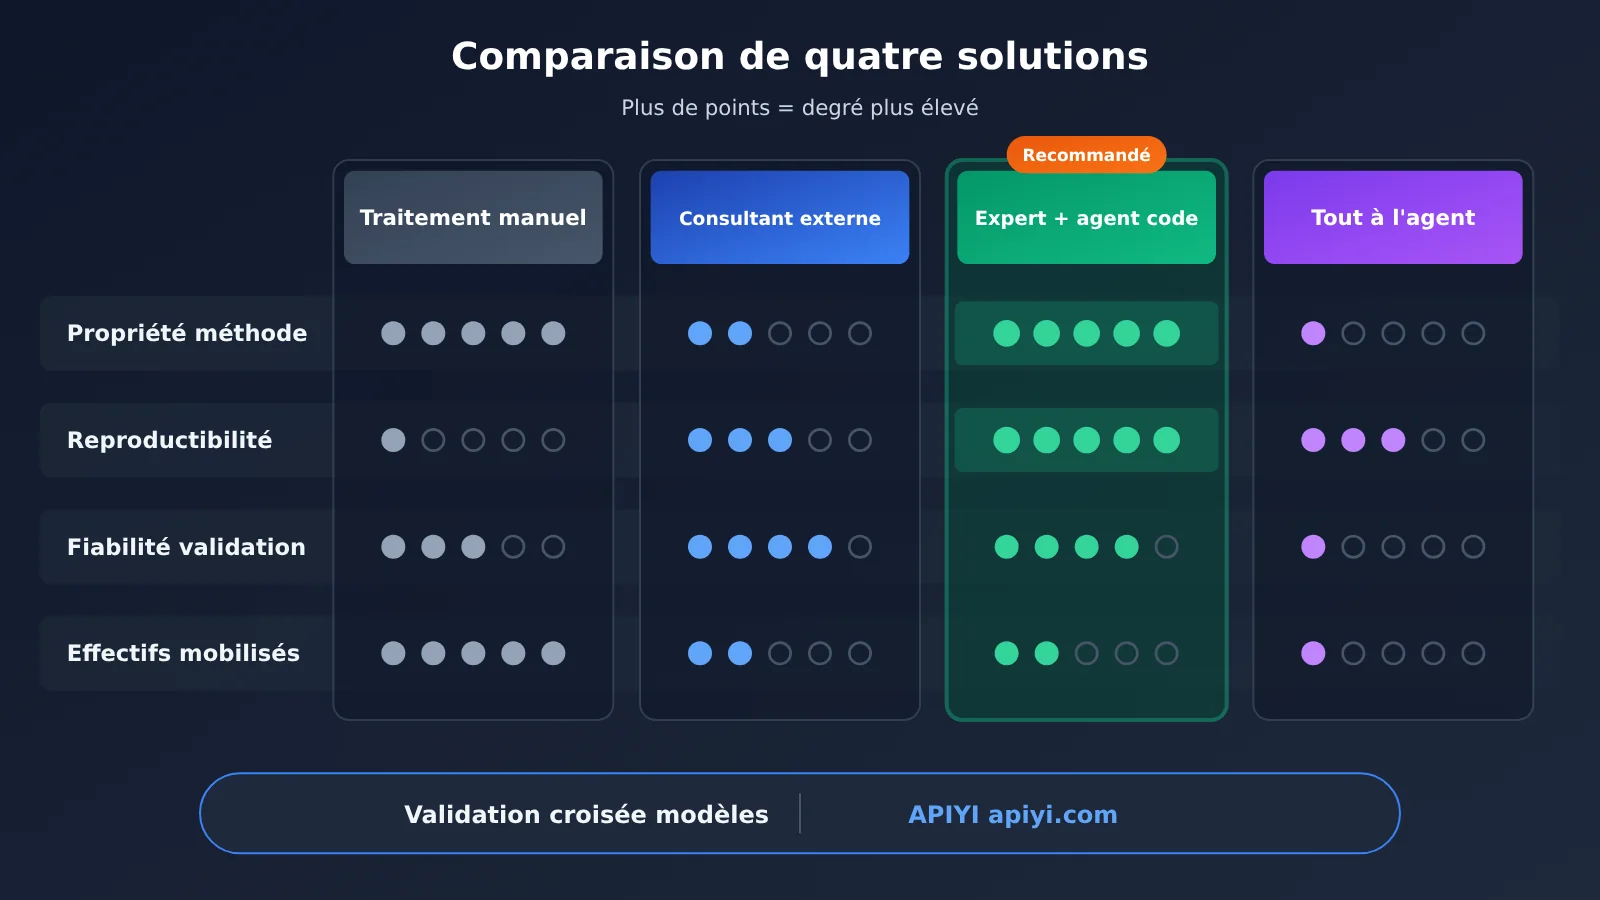
| Traitement entièrement manuel | Entre les mains des experts | Faible, souvent difficile à reproduire | Dépend de la minutie de chacun | Mobilise beaucoup de personnel : dans le cas étudié, l’estimation était de 5 personnes pendant 1 an |
| Consultants externes | Souvent entre les mains des consultants | Moyenne, dépend des livrables des consultants | Assez élevée, mais peu transparente | Les mises à jour nécessitent de faire à nouveau appel aux consultants |
| Expert + agent de programmation | Entre les mains des experts | Élevée, le processus peut être réexécuté | Élevée, à condition que la validation humaine soit rigoureuse | Exige des experts une bonne capacité à structurer leur méthodologie |
| Entièrement confié à un agent | Floue, implicite dans les hypothèses par défaut | Moyenne | Faible, l’origine des conclusions est difficile à expliquer | Les conclusions sont difficiles à défendre auprès de tiers |
Comment interpréter cette comparaison
Face aux consultants externes : les consultants externes ont certains avantages en matière d’expérience professionnelle et de rapidité de livraison. Mais la méthodologie reste souvent chez eux : pour mettre à jour l’évaluation l’année suivante, il faut reprendre les échanges et payer de nouveau. À l’inverse, l’approche « expert + agent de programmation » permet à l’organisation de conserver sa méthodologie en interne. Heimstaden précise d’ailleurs que ce projet lui a évité de recruter des consultants externes comme prévu initialement.
Face à une délégation complète à l’agent : confier tout le projet à un agent semble être la solution la plus simple, et les résultats arrivent vite. Mais l’agent fait ses propres hypothèses sur de nombreux détails, par exemple la façon de remplir les valeurs manquantes ou d’exclure les valeurs aberrantes. Ces hypothèses peuvent ne pas correspondre aux pratiques du secteur. Quand une évaluation doit servir à produire des rapports conformes et à éclairer des décisions d’investissement, de telles conclusions résistent difficilement à un examen approfondi.
Il faut aussi garder du recul sur les chiffres concernant les économies de main-d’œuvre. L’article d’origine indique que les « besoins estimés pour la livraison » sont passés de 5 personnes pendant 1 an à 2 personnes pendant 2 mois. En convertissant approximativement en mois-personnes, cela représente environ 60 mois-personnes contre 4. Mais il s’agit d’une estimation de l’entreprise, qui n’a pas été vérifiée de manière indépendante et ne précise pas non plus les rôles respectifs des 2 personnes.
💡 Conseil pour choisir : si votre équipe dispose déjà d’une méthodologie, mais manque de moyens pour la mettre en œuvre techniquement, l’approche « expert + agent de programmation » est la plus intéressante à essayer. Pour les étapes qui nécessitent l’invocation du modèle, l’interface unifiée d’APIYI apiyi.com permet de passer d’un modèle à l’autre et de les comparer, sans devoir réécrire tout le processus en cas de changement de modèle.
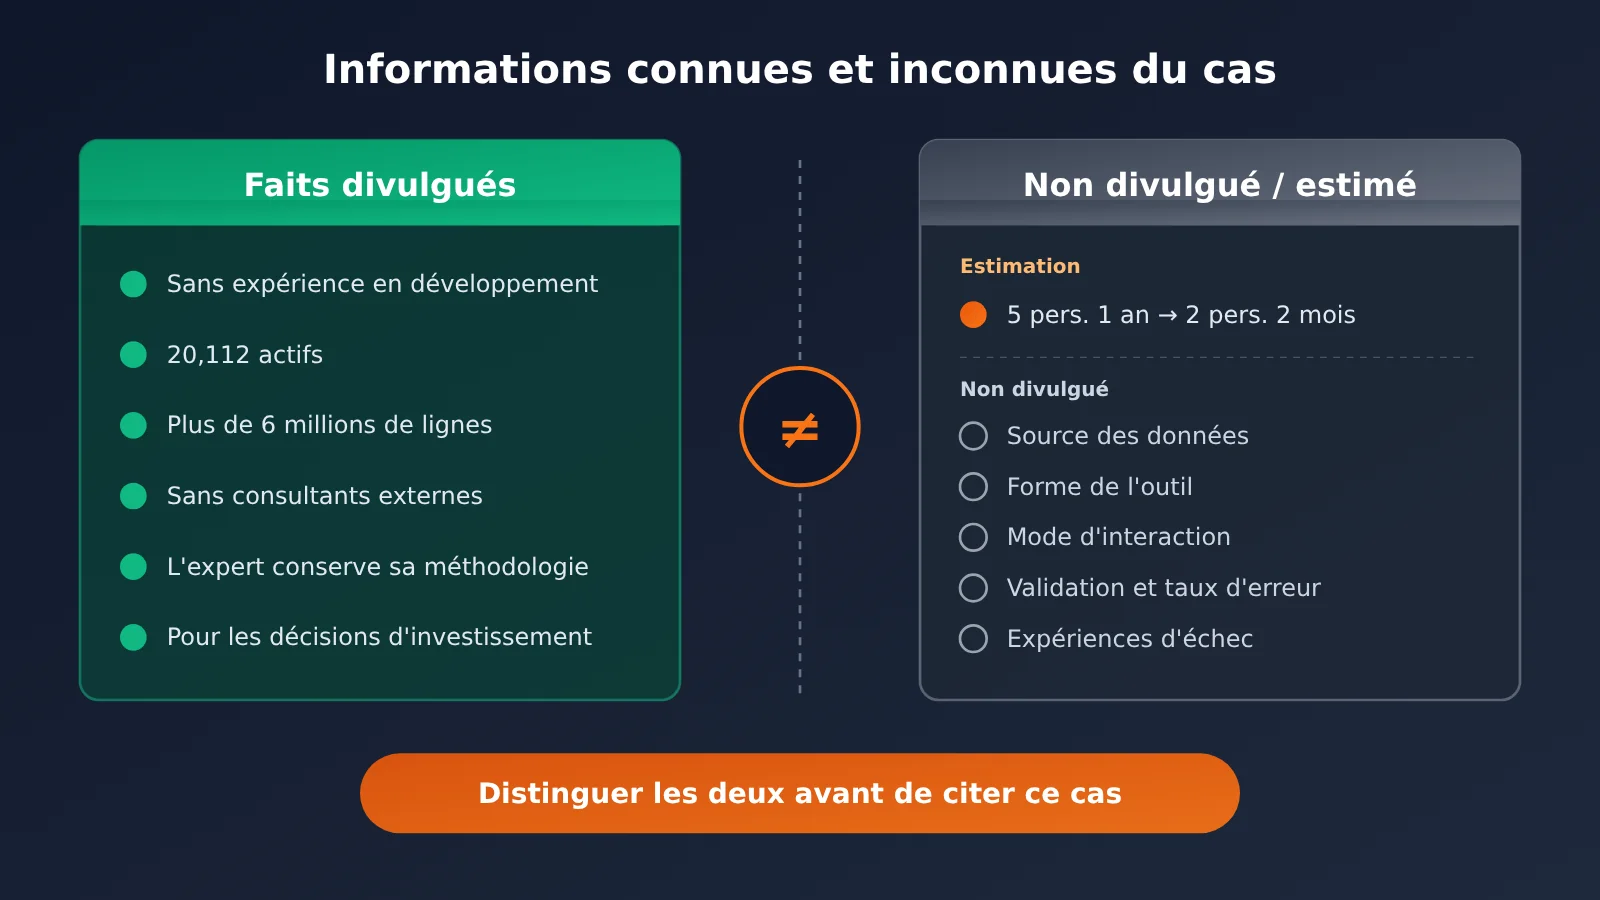
Ce que l’on sait et ce que l’on ignore du cas Codex de traitement des données
Pour éviter de faire dire trop de choses à ce cas, distinguons les informations explicitement fournies dans l’article original de celles qui n’ont pas été divulguées.
| Catégorie | Informations |
|---|---|
| Divulgué | Les analystes n’avaient pas de formation en développement logiciel ; Codex a contribué à la découverte des données, au nettoyage et à la standardisation, au contrôle qualité et au développement du processus ; les analystes sont restés responsables de la méthodologie et de la validation ; 20,112 actifs ont été évalués, produisant plus de 6 millions de lignes de données ; aucun consultant externe n’a été nécessaire ; les résultats ont servi à l’évaluation des risques climatiques, aux rapports et aux décisions d’investissement |
| Estimation | Selon l’estimation de l’entreprise, les ressources nécessaires à la livraison sont passées de 5 personnes pendant 1 an à 2 personnes pendant 2 mois |
| Non divulgué | Les sources de données précises ; la forme sous laquelle Codex a été utilisé (application de bureau, CLI ou autre) ; les modalités d’interaction et le flux de travail ; les méthodes précises de validation et le taux d’erreur ; les difficultés et les échecs rencontrés pendant l’utilisation |
Ces zones d’ombre n’enlèvent rien à la pertinence du partage des responsabilités présenté dans ce cas, mais elles signifient que vous ne pouvez pas reprendre tels quels ses chiffres de productivité. Dans un projet réel, il est probable que la clarification de la méthodologie et la validation humaine prennent plus de temps que le fait de « faire écrire le processus par l’agent ». Une phrase de la direction de Heimstaden mérite d’être retenue : l’IA ne peut pas réparer un mauvais processus, mais elle peut amplifier considérablement les effets d’un bon processus.
Questions fréquentes (FAQ)
Q1 : Que signifie concrètement construire un processus de traitement des données avec Codex sans être développeur ?
Un expert métier sans formation en programmation décrit ses besoins en langage naturel à un agent de programmation. L’agent se charge des tâches techniques, comme la collecte, le nettoyage et la vérification des données, ainsi que la création du processus. L’expert définit la méthodologie et valide les résultats. Le projet d’évaluation des risques environnementaux de Heimstaden en est un exemple public.
Q2 : Quelle différence avec le fait de poser directement des questions sur ses données à ChatGPT ?
Une utilisation sous forme de questions-réponses répond généralement à un besoin ponctuel, avec des résultats difficiles à reproduire. L’intérêt d’un agent de programmation est de produire un processus qu’on peut réexécuter lorsque les données sont mises à jour et modifier lorsque la méthodologie évolue. C’est ce que le cas décrit comme le passage « d’un projet d’analyse complexe à une capacité reproductible ».
Q3 : Quand ce cas a-t-il été publié ?
OpenAI a publié ce cas le 3 novembre 2026. Il illustre une pratique récente d’utilisation des agents de programmation en entreprise. Les chiffres et les outils peuvent évoluer, mais le principe de répartition des rôles reste pertinent : confier l’exécution à l’agent et laisser le jugement aux experts.
Q4 : Quels projets de données se prêtent le mieux à cette répartition des rôles ?
– **Intégration de données publiques provenant de plusieurs sources** : par exemple, des jeux de données sur l’environnement, le climat ou la population, répartis entre différents organismes
– **Rapports périodiques** : rapports de conformité et de divulgation à produire chaque trimestre ou chaque année
– **Évaluation en masse à l’échelle d’un portefeuille d’actifs** : situations où des milliers d’enregistrements doivent être notés selon des critères uniformes
Q5 : Comment démarrer rapidement si le processus nécessite l’invocation d’un grand modèle de langage ?
Vous pouvez commencer par vous inscrire sur APIYI apiyi.com, puis utiliser une interface commune pour invoquer plusieurs modèles populaires et comparer leurs résultats de classification ou d’extraction sur un petit échantillon représentatif. Une fois leur stabilité et la cohérence des critères confirmées, intégrez-les au processus de production. La comparaison entre modèles peut aussi aider à la validation humaine.
Q6 : Jusqu’où faut-il aller dans la validation humaine ?
Le cas ne précise ni la méthode de validation ni le taux d’erreur. Une pratique courante consiste à définir à l’avance le taux d’échantillonnage et les seuils de tolérance aux erreurs, à examiner une par une les anomalies signalées par les contrôles automatiques, puis à vérifier un échantillon aléatoire des résultats normaux et à les comparer avec des références externes connues. Toutes les traces de validation doivent être conservées en vue d’un audit ultérieur.
Q7 : Quelles sont les limites de cette approche ?
D’abord, les chiffres de gains d’efficacité proviennent d’estimations de l’entreprise et n’ont pas été vérifiés de manière indépendante. Ensuite, les personnes qui ne sont pas développeuses doivent quand même savoir formuler clairement leur méthodologie, sans quoi l’agent ne fera qu’amplifier la confusion. Enfin, le cas ne mentionne ni les difficultés ni les échecs rencontrés. En pratique, un processus peut produire une erreur difficile à comprendre : l’aide de collègues techniques reste parfois nécessaire pour la diagnostiquer.
Q8 : Pourquoi est-il si important de maîtriser soi-même la méthodologie ?
Quand l’équipe maîtrise sa méthodologie, elle peut la modifier et l’expliquer directement lors d’une mise à jour des données, d’un changement réglementaire ou d’une question d’un investisseur, sans devoir faire de nouveau appel à un consultant. C’est cette autonomie à long terme que Julia évoque lorsqu’elle dit : « Nous maîtrisons maintenant cette méthodologie et pouvons continuer à la développer nous-mêmes. »
Points clés : utiliser Codex pour traiter des données sans être développeur
- Répartition des rôles : confiez à l’agent la recherche, le nettoyage, le contrôle qualité et la mise en place du processus ; laissez la méthodologie et la validation aux experts
- La méthodologie d’abord : documentez clairement le cadre d’évaluation avant de demander à l’agent de l’appliquer
- Une validation indépendante : contrôles automatiques, échantillonnage manuel et comparaison avec des références externes sont tous indispensables
- La reproductibilité est essentielle : un processus que l’on peut relancer devient un atout ; un résultat ponctuel ne permet pas d’itérer
- Prudence avec les chiffres : passer de 5 personnes pendant 1 an à 2 personnes pendant 2 mois est une estimation, pas une référence à appliquer telle quelle
- Comparer les modèles facilite la validation : pour les étapes qui nécessitent l’invocation d’un grand modèle de langage, l’interface unifiée d’APIYI permet de croiser les résultats de plusieurs modèles
En résumé
Pour une personne qui n’est pas développeuse et qui construit un processus de traitement des données avec Codex, le principal enseignement n’est pas le gain d’efficacité chiffré, mais la clarté de la répartition des rôles :
- L’agent se charge de l’exécution : recherche des données, nettoyage et normalisation, contrôles qualité et mise en place d’un processus reproductible peuvent lui être confiés
- Les experts gardent la main sur les décisions : définir la méthodologie et valider les résultats est essentiel pour obtenir des conclusions fiables et explicables
- Le savoir-faire s’accumule : en maîtrisant la méthodologie et en disposant d’un processus reproductible, l’organisation transforme un projet ponctuel en une capacité qu’elle peut faire évoluer dans la durée
Si vous avez un projet dont les données sont éparpillées et pour lequel les ressources techniques manquent, prenez d’abord le temps de documenter votre méthodologie, puis lancez un projet pilote à petite échelle. Pour les étapes qui nécessitent l’invocation d’un grand modèle de langage, APIYI apiyi.com permet de comparer les performances de plusieurs modèles via une interface unifiée et d’ajouter ainsi un niveau de contrôle à la validation humaine.
📚 Références
- Étude de cas client OpenAI – Heimstaden : Heimstaden transforme la gestion immobilière résidentielle grâce à ChatGPT et Codex
- Lien :
openai.com/index/heimstaden/ - Description : seule source des faits présentés dans cet article, notamment la répartition des responsabilités et les estimations du projet d’évaluation des risques environnementaux
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI. Pour plus de ressources sur l’intégration des modèles, consultez le centre de documentation docs.apiyi.com