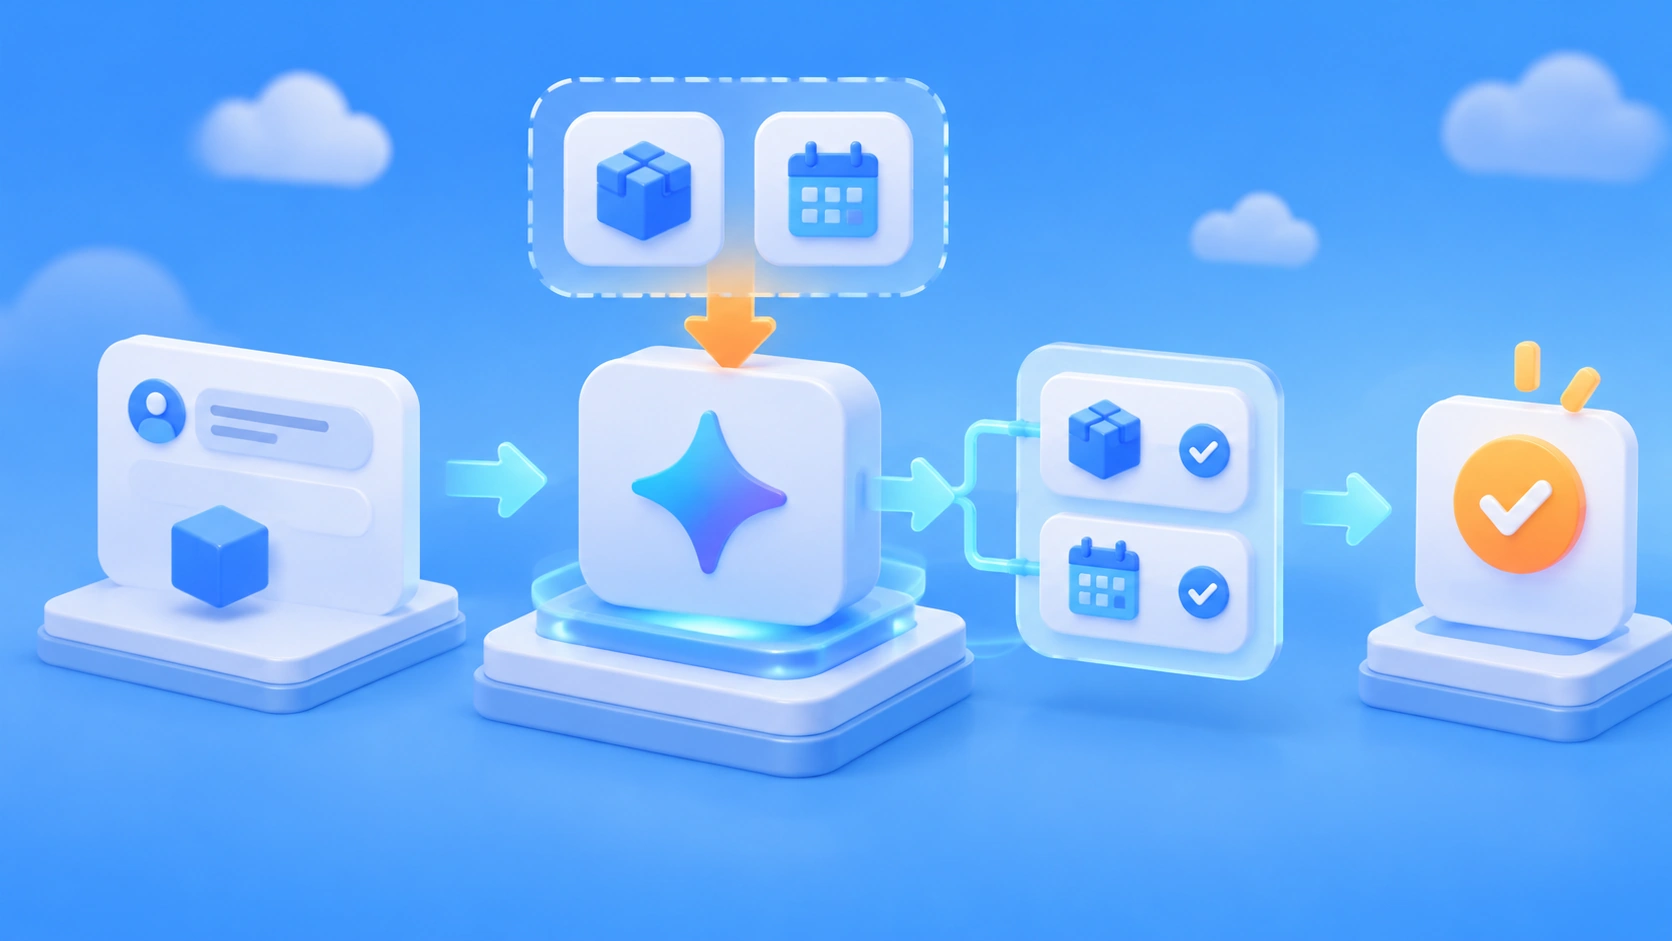
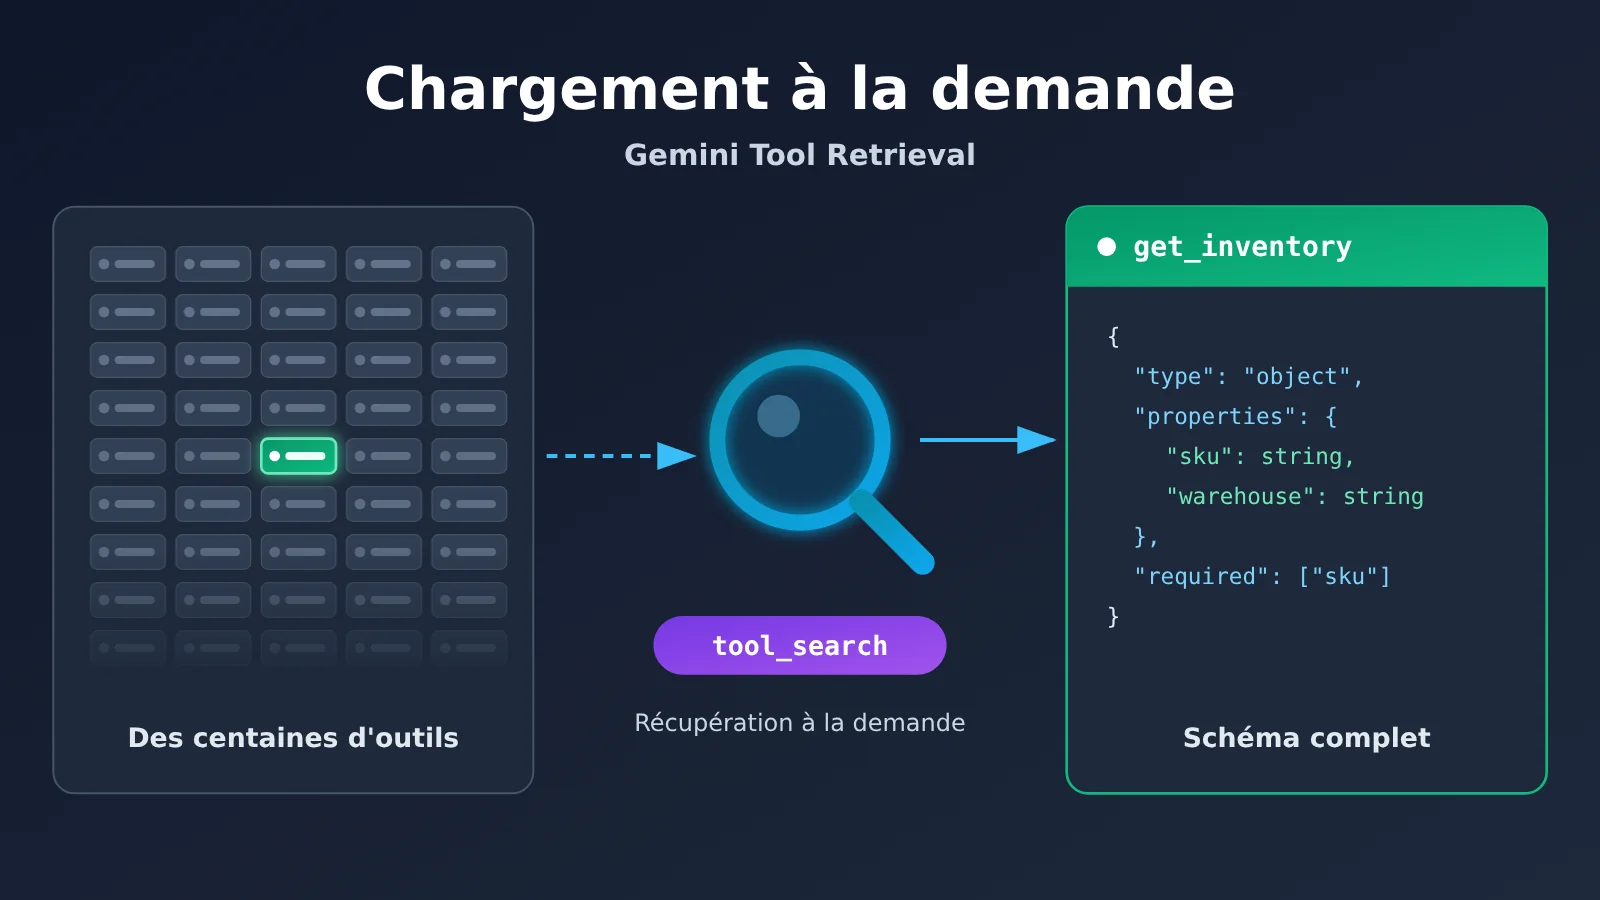
Pour intégrer Gemini Tool Retrieval, il faut faire trois choses. D’abord, ajouter {"type": "tool_search"} dans le tableau tools et définir defer_loading: True pour les fonctions métier peu utilisées. Ensuite, envoyer la requête via l’API Interactions en version v1beta, puis repérer le function_call dans interaction.steps. Enfin, exécuter la fonction en local, construire un function_result avec le call_id correspondant, et le renvoyer avec le tableau tools complet. Inutile d’écrire votre propre moteur de recherche d’outils : le service effectue la recherche et charge le schéma des paramètres côté serveur.
Mettons les choses au clair dès le départ : Tool Retrieval change uniquement le moment où la définition des paramètres d’un outil entre dans le contexte du modèle ; la fonction reste exécutée par le développeur. Et ce n’est pas forcément une économie garantie. Dans les scénarios avec peu d’outils mais un contexte long, la consommation de tokens peut même augmenter.
Ce que vous apprendrez en lisant cet article :
- Quels modèles Gemini Tool Retrieval prend en charge, quelle version du SDK est requise, et pourquoi il faut explicitement spécifier
v1beta - Un exemple Python complet aux noms de variables cohérents : deux outils à chargement différé (stock et commandes), de la recherche jusqu’à la réponse finale
- Qui traite respectivement
tool_search_call,tool_search_result,function_calletfunction_result - Les différences entre trois pistes d’extension : chargement différé MCP distant, recherche côté client et registre d’outils maison
- Comment diagnostiquer efficacement les erreurs courantes comme le HTTP 400, et comment déterminer avant activation si le jeu en vaut la chandelle
Sommaire : on commence par un tableau To Know pour expliquer les champs essentiels, puis un « aperçu des impacts » pour préciser ce que cette fonctionnalité en preview signifie pour chaque rôle. La partie « faits objectifs » suit l’ordre d’intégration : préparer l’environnement, définir les outils, observer les étapes de recherche, renvoyer le résultat de la fonction, puis étendre vers MCP et la recherche côté client, avec le dépannage regroupé à la fin de cette partie. La partie « analyse et jugement » s’appuie sur les deux exemples hypothétiques fournis par Google pour discuter des cas où Tool Retrieval est adapté — et de ceux où il ne l’est pas.
Concepts clés de Gemini Tool Retrieval (To Know)
| Concept | Brève explication |
|---|---|
| google-genai | Nom du package officiel du SDK Python de Google, importé via from google import genai |
| v1beta | Version d’API en prévisualisation, obligatoire pour Tool Retrieval, explicitement spécifiée lors de l’initialisation du client dans cet article |
| Interactions API | API de Google dédiée aux workflows d’agents, prenant en charge les conversations avec état et les étapes d’exécution observables |
tool_search |
Type de tool spécial qui déclare l’activation de la recherche de tools, un seul maximum par requête |
defer_loading |
Permet de différer l’entrée dans le contexte du modèle de la définition complète des paramètres d’une fonction ou d’un serveur MCP donné |
short_description |
Brève description d’une fonction différée, telle que le modèle la voit au départ ; utilisable uniquement pour les fonctions différées |
tool_search_call |
Étape de recherche lancée par le modèle au cours du processus de récupération côté serveur |
tool_search_result |
Étape où le serveur renvoie le schéma complet du tool correspondant |
function_call |
Le modèle demande au code du développeur d’exécuter une fonction et fournit les paramètres |
function_result |
Type d’entrée utilisé par l’application pour renvoyer le résultat d’exécution de la fonction au modèle |
call_id |
Identifiant qui fait correspondre le résultat d’exécution de la fonction au function_call.id d’origine |
previous_interaction_id |
Identifiant qui permet aux requêtes suivantes de reprendre l’enregistrement d’interaction déjà sauvegardé côté serveur |
signature |
Champ de signature à renvoyer tel quel avec l’étape d’origine lors du rejeu de l’historique des étapes dans une session sans état |
Aperçu rapide des impacts de Gemini Tool Retrieval
| Profil | Impact réel |
|---|---|
| Développeurs d’agents | Les agents disposant de nombreux outils peuvent charger en différé les outils de longue traîne, sans avoir à construire leur propre recherche vectorielle, mais ils doivent passer à l’Interactions API |
| Équipes utilisant déjà generateContent | L’ancienne méthode ne prend pas en charge Tool Retrieval ; il faut migrer l’interface et l’analyse de la structure de retour |
| Intégrateurs MCP | On peut définir defer_loading globalement au niveau mcp_server, sans déclarer chaque outil individuellement |
| Responsables des coûts | Pas de frais de fonctionnalité séparés, mais chaque recherche côté serveur génère des appels de modèle facturés en plus ; il faut surveiller total_tool_use_tokens |
| Projets à petite bibliothèque d’outils | Les scénarios avec une dizaine d’outils et un long contexte ne sont pas forcément rentables ; le chargement statique peut être plus économique |
Gemini Tool Retrieval : faits objectifs, informations de publication et processus d’intégration
État de publication de Gemini Tool Retrieval et modèles pris en charge
Le 19 novembre 2026 (20 novembre au petit matin, heure de Pékin), Google a publié sur son blog officiel « Introducing Tool Retrieval in the Gemini API », ouvrant un aperçu de Tool Retrieval dans l’Interactions API. Les auteurs sont Lucia Loher, chef de produit Gemini API, et Nora Kassner, chercheuse chez Google DeepMind. La fonctionnalité est pour l’instant en état Preview, et l’interface pourrait évoluer avant la sortie officielle.
La formulation du communiqué reste assez large : « Gemini 3.6 et les modèles plus récents, y compris tous les modèles Gemini 4 ». Mais la documentation développeur, au 20 novembre 2026, ne liste explicitement que 4 ID de modèles : gemini-4-hydrogen, gemini-4-argon, gemini-3.8-flash, gemini-3.6-flash. Au moment de l’intégration, fiez-vous à la liste de la documentation. Si vous définissez defer_loading sur un modèle non pris en charge, vous recevez directement une erreur HTTP 400.
Préparation avant intégration de Gemini Tool Retrieval : SDK et v1beta
Le SDK Python officiel de Google googleapis/python-genai a publié la version v3.6.0 le 18 novembre 2026, avec de nouveaux schémas publics liés à Tool Retrieval et aux résultats de fonctions. La commande d’installation est la suivante :
pip install -U "google-genai>=3.6.0"
export GEMINI_API_KEY="your-key"   # Ne mettez pas une vraie clé dans le code
Il y a un piège classique avec le numéro de version. Depuis v3.0.0, le client Gemini Developer API utilise v1 par défaut, alors que Tool Retrieval exige v1beta. Il faut donc le spécifier explicitement à l’initialisation :
from google import genai

client = genai.Client(
    http_options={"api_version": "v1beta"}
)
Le SDK lit les identifiants depuis la variable d’environnement GEMINI_API_KEY. En REST, l’endpoint correspondant est POST https://generativelanguage.googleapis.com/v1beta/interactions, avec l’en-tête d’authentification x-goog-api-key.
Étape 1 : Définir les outils Gemini avec tool_search et defer_loading
Le scénario de démonstration ne comporte que deux outils métier : get_inventory pour interroger le stock d’un produit et get_order_status pour consulter le statut d’une commande. Les deux sont configurés en chargement différé. Voici le rôle de chaque champ dans le tableau tools :
{"type": "tool_search"}: active la recherche côté serveur, avecexecutiondéfini par défaut surserver. Sans ce champ, si vous définissezdefer_loading, vous obtenez l’erreurdefer_loading requires tool_search.defer_loading: True: l’intégralité desparametersn’entre pas dans le contexte initial ; au départ, le modèle ne voit que le nom et un bref résumé.short_description: le résumé affiché dans la liste initiale. Si vous ne le renseignez pas, la première phrase dedescriptionest utilisée. Renseigner ce champ sur une fonction non différée est considéré comme invalide.parameters: doivent toujours être fournis dans leur intégralité. Ce qui est différé, c’est le moment où le schéma entre dans le contexte du modèle ; le serveur a toujours besoin de la définition complète.
Quels outils sont adaptés au chargement différé ? Google recommande une approche mixte : garder en chargement direct les outils fréquemment utilisés, et différer le chargement des outils spécialisés de longue traîne, moins fréquents. Autre règle : ne définissez pas en différé les outils cités directement dans les instructions système. Sinon, le modèle pourrait contourner la recherche et les appeler directement, ce qui provoquerait une erreur par manque de contexte chargé. Pour les outils aux noms proches, ajoutez un espace de noms métier, par exemple billing_get_customer et crm_get_customer pour les distinguer, plutôt que de les appeler tous get_customer.
Étape 2 : Envoyer la requête et observer les étapes de recherche d’outils de Gemini
Voici le code de démonstration complet. Le stock « 12 unités » et l’état de commande demo_pending sont des données simulées localement ; aucune requête n’est envoyée à un système réel. Pour exécuter le code, il vous faut une clé API Gemini valide et les autorisations d’accès au modèle.
import json
from google import genai

MODEL = "gemini-4-hydrogen"

client = genai.Client(
    http_options={"api_version": "v1beta"}
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "short_description": "Check product inventory by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    },
    {
        "type": "function",
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "short_description": "Check an order's current status.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"order_id": {"type": "string"}},
            "required": ["order_id"]
        }
    }
]

def execute_demo_tool(name, arguments):
    """Fonction métier simulée localement, ne consulte pas l'inventaire réel ni les commandes réelles."""
    if name == "get_inventory":
        return {"sku": arguments["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": arguments["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(f"Unknown tool: {name}")

# Première requête : le modèle découvre et sélectionne les outils nécessaires
interaction = client.interactions.create(
    model=MODEL,
    input="查询商品 SKU-42 的可用库存。",
    tools=tools
)

print("执行步骤:")
for step in interaction.steps:
    print(step.type, getattr(step, "name", ""))
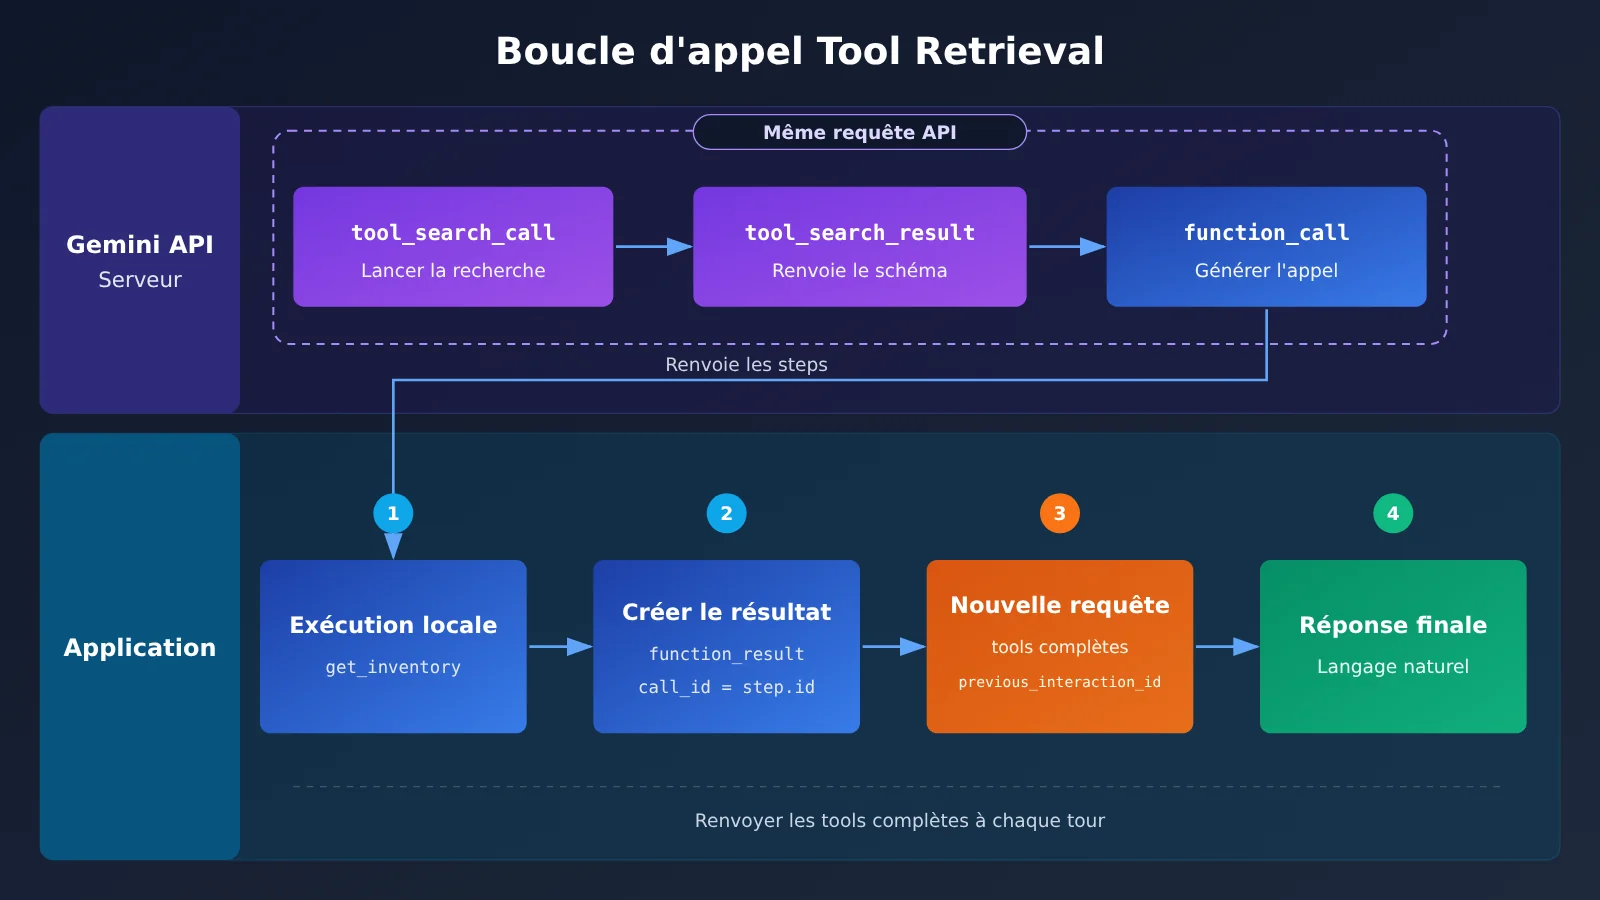
Les interaction.steps affichés suivent généralement l’ordre ci-dessous. L’ordre exact et les résultats de recherche dépendent du modèle ; plusieurs recherches peuvent aussi se produire au cours d’un même tour.
tool_search_call: le modèle constate qu’aucun outil chargé ne correspond et lance une recherche côté serveur.tool_search_result: l’API renvoie le schéma complet des paramètres deget_inventorycorrespondant.function_call: après avoir lu le schéma, le modèle génère un appel commeget_inventory(sku="SKU-42").
Ces trois étapes se déroulent dans la même requête API externe ; l’application n’a pas besoin d’écrire un moteur de recherche à part ni d’envoyer une nouvelle requête de recherche. Les deux premières étapes doivent seulement être observées et consignées ; ne répétez pas la recherche en local. Mais « même requête » ne signifie pas « une seule inférence » : chaque recherche côté serveur déclenche une invocation supplémentaire du modèle, et ces tokens sont facturés comme d’habitude. Autre point à surveiller lors du débogage : ne regardez pas uniquement interaction.status. Même si le statut n’est pas requires_action, les étapes peuvent contenir un function_call en attente d’exécution.
Étape 3 : exécuter la fonction et renvoyer function_result
Tool Retrieval ne sert qu’à trouver les outils et à charger les paramètres ; les véritables fonctions métier restent exécutées par l’application, via le mécanisme standard Function Calling. On poursuit avec le code ci-dessus :
# Exécuter uniquement les vrais appels de fonctions métier ; ne pas exécuter tool_search_call côté application
function_results = []

for step in interaction.steps:
    if step.type != "function_call":
        continue
    result = execute_demo_tool(step.name, step.arguments)
    function_results.append({
        "type": "function_result",
        "name": step.name,
        "call_id": step.id,
        "result": [{"type": "text", "text": json.dumps(result, ensure_ascii=False)}]
    })

# Renvoyer le résultat de la fonction locale à Gemini
if function_results:
    followup = client.interactions.create(
        model=MODEL,
        previous_interaction_id=interaction.id,
        tools=tools,
        input=function_results
    )
    print("最终回答:", followup.output_text)
else:
    print("当前回答:", interaction.output_text)
Ce code appelle trois points d’attention. Premièrement, call_id doit reprendre le step.id du function_call d’origine. Lorsqu’un même tour comporte plusieurs appels, le modèle s’en sert pour faire correspondre chaque résultat. Deuxièmement, previous_interaction_id=interaction.id permet au serveur de reprendre l’enregistrement d’interaction déjà sauvegardé, y compris les outils déjà récupérés. Troisièmement, il faut encore transmettre tout le tableau tools au deuxième tour. L’API conserve l’historique des étapes, mais pas les déclarations d’outils : tool_search, tous les outils différés et non différés, ainsi que la configuration MCP doivent être soumis à nouveau à chaque tour.
Cet exemple ne montre qu’une seule boucle d’appel de fonction, sans ordonnanceur générique d’Agent multi-tour. Si followup contient encore un function_call, il suffit de continuer de la même manière.
🎯 Conseil technique : Tool Retrieval repose lui-même sur l’API Interactions
v1betaofficielle de Google. Si vous voulez d’abord valider les fonctions métier avec le Function Calling standard et comparer la façon dont différents modèles choisissent les outils et remplissent les paramètres, vous pouvez utiliser la même clé API sur APIYI apiyi.com pour basculer entre Gemini, Claude, GPT et d’autres modèles afin d’effectuer des tests de référence.
Extension : MCP distant et récupération côté client avec Gemini
Un serveur MCP distant peut configurer le chargement différé au niveau du serveur : les outils qu’il expose sont alors chargés à la demande :
mcp_tools = [
    {"type": "tool_search"},
    {
        "type": "mcp_server",
        "name": "weather_service",
        "url": "https://gemini-api-demos.uc.r.appspot.com/mcp",
        "defer_loading": True
    }
]
Contrairement aux fonctions personnalisées, les outils MCP distants sont exécutés par l’API à votre place : dans les steps, on voit apparaître mcp_server_tool_call et mcp_server_tool_result, et l’application n’a pas besoin de renvoyer le résultat. La documentation officielle ne précise pas encore de « nombre maximal d’outils pouvant être différés ».
Si l’entreprise dispose déjà de son propre registre d’outils, d’une recherche vectorielle ou d’un filtrage des permissions par utilisateur, on peut basculer sur la récupération côté client : définissez "execution": "client" et fournissez les champs name, description et parameters au complet. Dans ce cas, le premier tour renvoie un simple function_call vers search_tool_registry. Après la recherche, l’application renvoie dans function_result.result un tableau complet d’objets de déclaration d’outils, sans le sérialiser en une chaîne JSON. Le mode client n’utilise pas defer_loading, et une même requête ne peut pas mélanger les deux modes.
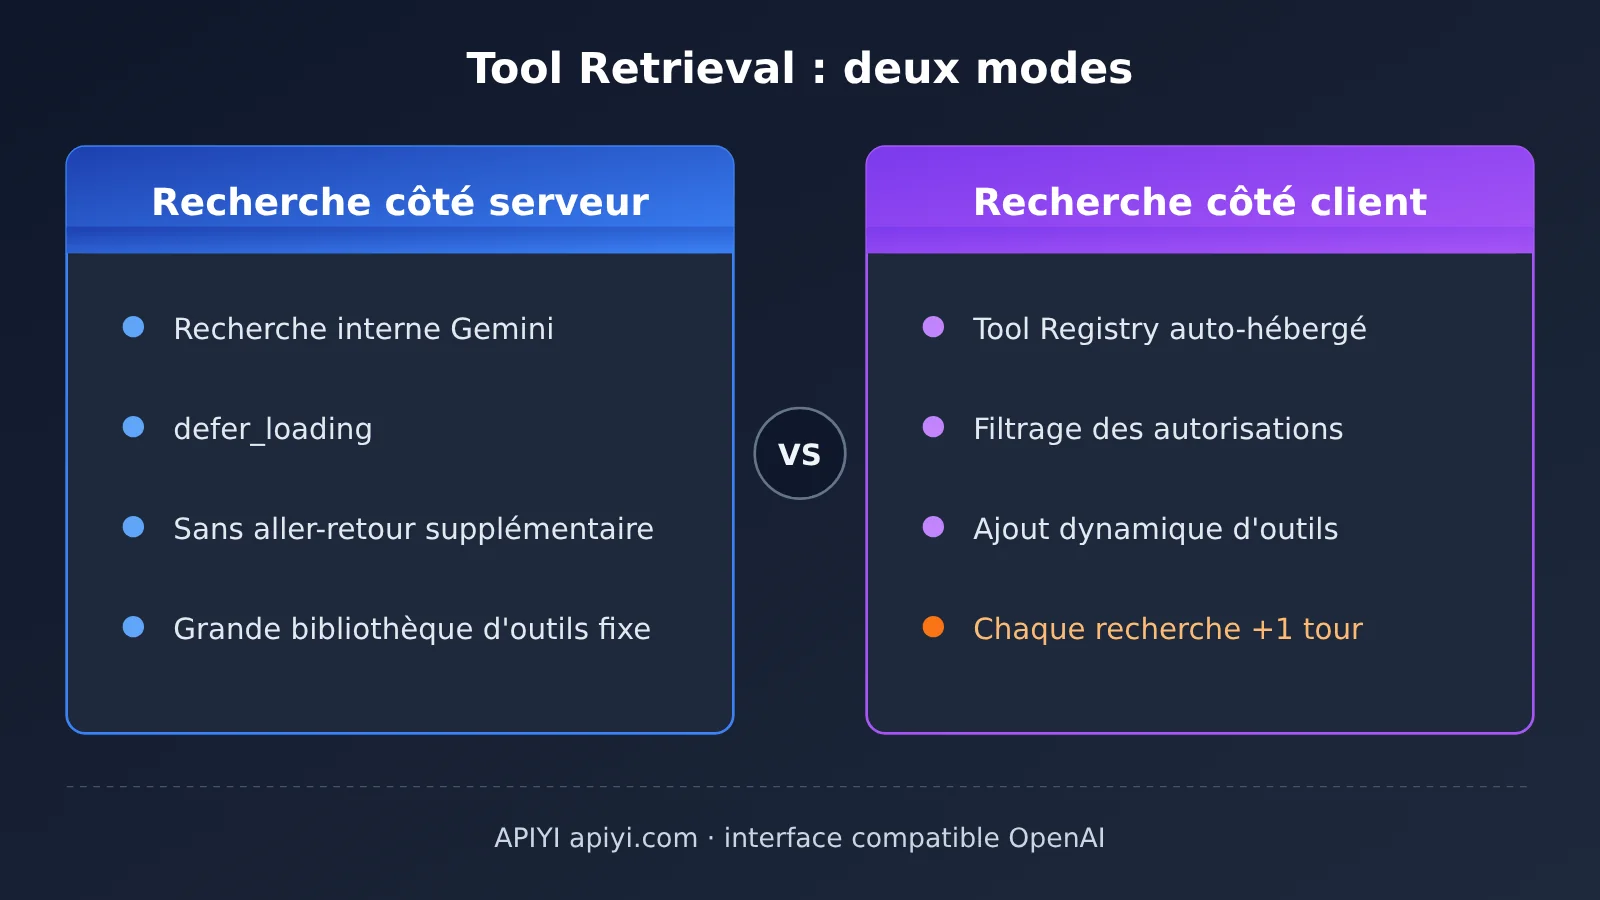
| Dimension | Récupération côté serveur | Récupération côté client (Gemini) | Tool Registry maison (approche générique) |
|---|---|---|---|
| Qui exécute la recherche | API Gemini | Application du développeur | Application du développeur |
| Configuration clé | tool_search + defer_loading |
tool_search + execution: client |
Function Calling classique |
| Faut-il déclarer tous les outils à l’avance | Oui | Non | Non |
| Allers-retours réseau supplémentaires | Aucun | +1 tour par recherche | +1 tour par recherche |
| Ajout dynamique d’outils | Peu pratique | Pris en charge | Pris en charge |
| Cas d’usage typique | Grande bibliothèque d’outils relativement stable | Multi-tenant, registre privé | Réutilisation entre modèles, changement de fournisseur |
| Plateforme disponible | v1beta officiel de Google | v1beta officiel de Google | Interface compatible OpenAI type APIYI apiyi.com |
La dernière colonne ne relève pas de Gemini Tool Retrieval, mais d’une implémentation d’ingénierie proche dans l’esprit : on n’expose d’abord qu’une seule fonction de recherche, puis, une fois la recherche fructueuse, on ajoute le schéma correspondant dans tools. C’est adapté aux équipes qui doivent jongler entre plusieurs modèles. Voici la version minimale :
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Interface compatible OpenAI d'APIYI
)
MODEL = "your-model-name"  # selon la liste de modèles de la plateforme

search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}
Voir l’appel complet en deux étapes du Tool Registry maison
import json, os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"
)
MODEL = "your-model-name"  # voir la liste des modèles de la plateforme

TOOL_REGISTRY = {
    "get_inventory": {"type": "function", "function": {
        "name": "get_inventory",
        "description": "Retrieve the available inventory for a product SKU.",
        "parameters": {"type": "object", "properties": {"sku": {"type": "string"}}, "required": ["sku"]}}},
    "get_order_status": {"type": "function", "function": {
        "name": "get_order_status",
        "description": "Retrieve the status of a customer order.",
        "parameters": {"type": "object", "properties": {"order_id": {"type": "string"}}, "required": ["order_id"]}}},
}
search_tool = {"type": "function", "function": {
    "name": "search_tool_registry",
    "description": "Search internal business tools (inventory, orders) by keyword.",
    "parameters": {"type": "object", "properties": {"query": {"type": "string"}}, "required": ["query"]}}}

def search_registry(query):
    q = query.lower()
    return [name for name, t in TOOL_REGISTRY.items()
            if any(w in t["function"]["description"].lower() for w in q.split())]

def execute_demo_tool(name, args):
    if name == "get_inventory":
        return {"sku": args["sku"], "available": 12, "data_source": "local_demo"}
    if name == "get_order_status":
        return {"order_id": args["order_id"], "status": "demo_pending", "data_source": "local_demo"}
    raise ValueError(name)

messages = [{"role": "user", "content": "查询商品 SKU-42 的可用库存。"}]
tools = [search_tool]

for _ in range(4):  # limite simple du nombre d'itérations, pour éviter une boucle infinie
    resp = client.chat.completions.create(model=MODEL, messages=messages, tools=tools)
    msg = resp.choices[0].message
    if not msg.tool_calls:
        print("最终回答:", msg.content)
        break
    messages.append(msg)
    for call in msg.tool_calls:
        args = json.loads(call.function.arguments)
        if call.function.name == "search_tool_registry":
            names = search_registry(args["query"])
            tools += [TOOL_REGISTRY[n] for n in names if TOOL_REGISTRY[n] not in tools]
            content = json.dumps({"loaded_tools": names})
        else:
            content = json.dumps(execute_demo_tool(call.function.name, args), ensure_ascii=False)
        messages.append({"role": "tool", "tool_call_id": call.id, "content": content})
💡 Conseil de choix : la qualité de la recherche dans l’approche « registre » dépend entièrement de votre fonction de recherche ; la correspondance par mots-clés de l’exemple ne sert qu’à la démonstration. En changeant de modèle sur APIYI apiyi.com pour exécuter la même série de tâches, il suffit de comparer « a-t-on trouvé le bon outil » et « les paramètres sont-ils bien remplis » pour voir quel modèle convient le mieux à votre bibliothèque d’outils.
Gemini Tool Retrieval : récapitulatif des erreurs fréquentes
| Symptôme | Cause | Solution |
|---|---|---|
defer_loading requires tool_search |
une fonction différée est déclarée, mais aucun tool_search côté serveur |
ajouter {"type": "tool_search"} dans tools |
short_description invalide |
le champ a été placé sur une fonction non différée | à réserver aux fonctions avec defer_loading=True |
| HTTP 400 unsupported model | le modèle ne figure pas dans la liste des modèles pris en charge | passer à l’un des 4 ID de modèle indiqués dans la doc |
| requête sans effet ou erreur de version | le SDK utilise v1 par défaut, ou l’appel passe par generateContent |
définir explicitement api_version="v1beta" et basculer sur l’Interactions API |
| HTTP 400 au second tour | avec store=False, une étape de retrieval ou une signature manque |
rejouer tel quel tool_search_call/result et toutes les signatures |
| le modèle réutilise l’ancien outil, ou l’outil est indisponible | les requêtes suivantes n’envoient pas tools |
renvoyer l’intégralité du tableau tools à chaque tour |
| paramètres vides après le retrieval | l’outil différé n’a fourni que son nom et un bref descriptif | un outil différé doit lui aussi fournir des parameters complets |
| échec de la configuration de recherche côté client | des champs comme name ou description sont absents |
compléter la définition de la fonction de recherche côté client |
Le mode sans état (store=False) mérite une explication à part. Ici, impossible de s’appuyer sur previous_interaction_id : l’application doit conserver elle-même, puis rejouer tel quel, l’entrée utilisateur, tool_search_call, tool_search_result, function_call, function_result ainsi que toutes les signature. Si vous supprimez ou modifiez une seule de ces étapes, le serveur risque de ne plus pouvoir reconstruire le contexte de retrieval. Autre point à garder en tête : lorsque le serveur ne trouve aucun outil correspondant, il peut très bien renvoyer directement un bloc de texte au lieu d’une erreur structurée. Autrement dit, « la requête n’a pas renvoyé d’erreur » ne signifie pas « le retrieval a réussi » : au moment de valider, vérifiez point par point que les étapes de retrieval et les appels de fonction attendus apparaissent bien dans les steps.
Analyse et décision sur Gemini Tool Retrieval : quand cela vaut-il la peine de l’intégrer
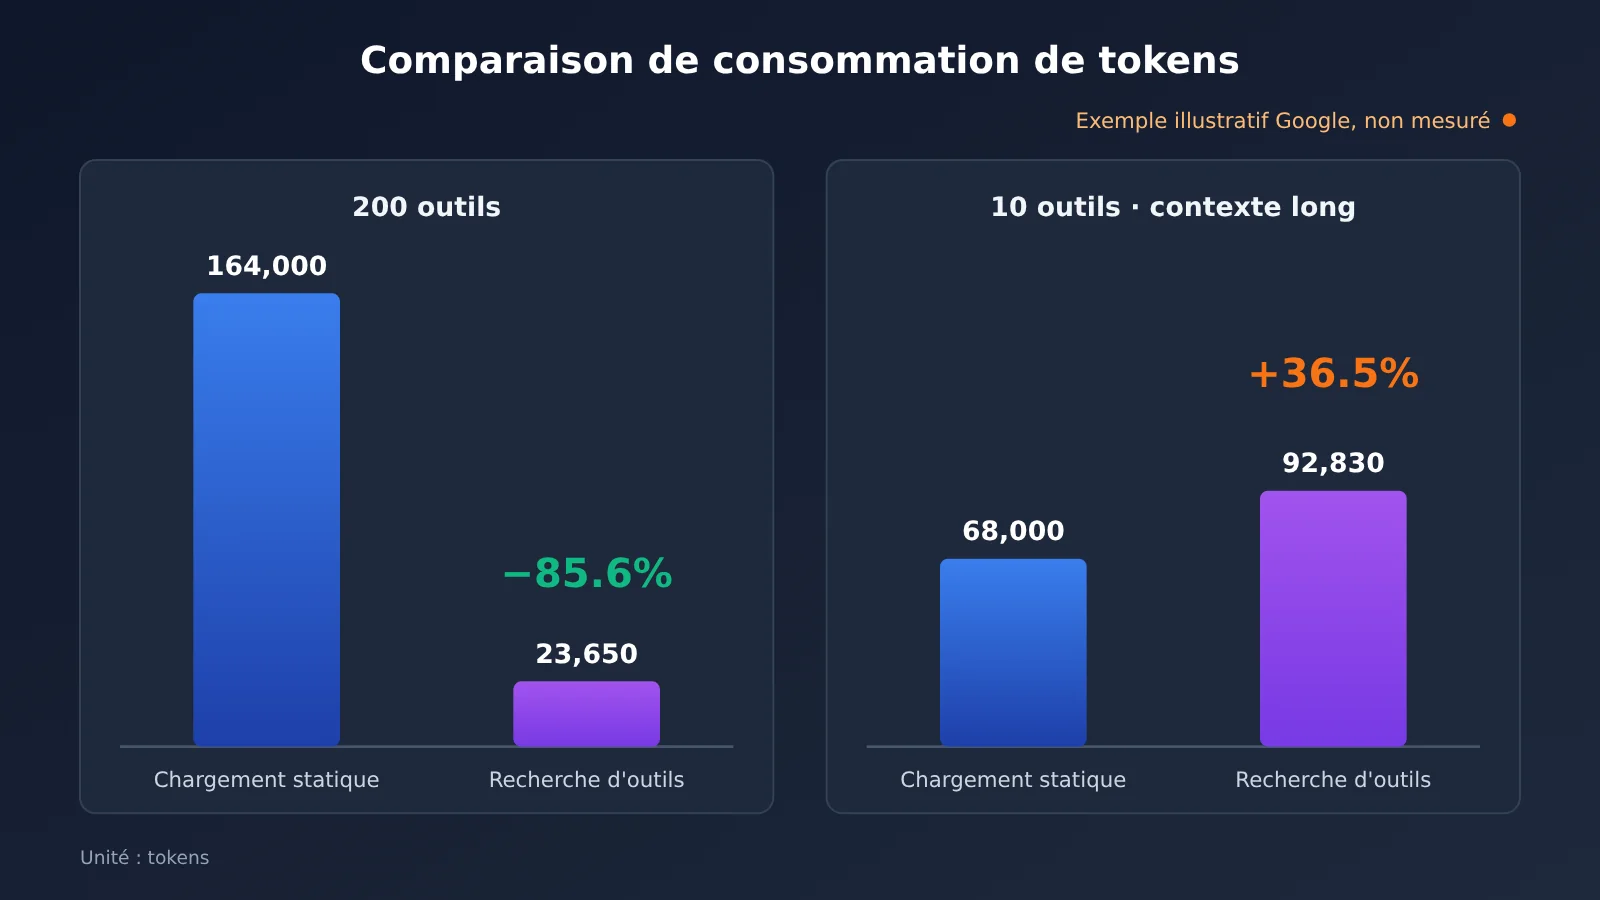
Premier constat : le bénéfice dépend de la taille de la bibliothèque d’outils et de la longueur du contexte, on n’économise pas simplement en l’activant. La documentation de Google propose deux exemples hypothétiques allant dans des directions opposées, et précise explicitement qu’il ne s’agit pas de benchmarks de production. Le premier cas : 200 outils, 400 tokens chacun, contexte de base de 2 000 tokens, 2 requêtes ; le chargement statique consomme environ 164 000 tokens, Tool Retrieval environ 23 650 tokens, ce qui donne une baisse estimée à environ 85,6 %. Le second : 10 outils, contexte de base de 30 000 tokens ; le chargement statique consomme 68 000 tokens, tandis que Tool Retrieval atteint 92 830 tokens, soit une hausse d’environ 36,5 %, parce que la recherche supplémentaire doit retraiter toute la longue portion de contexte. La recommandation d’ingénierie de Google : avec moins d’une vingtaine d’outils stables, le chargement statique suffit généralement.
Deuxième constat : pour évaluer le coût, il faut regarder total_tool_use_tokens, pas seulement l’entrée du premier tour. Dans les premiers tests officiels, le résumé de chaque outil différé pèse en moyenne environ 26 tokens ; pour 100 outils, cela fait à peu près 2 600 tokens, c’est une valeur approximative. Ce qu’il faut vraiment surveiller, ce sont les invocations supplémentaires du modèle déclenchées par la recherche, ainsi que l’accumulation des schémas déjà chargés au fil de la session. La documentation actuelle ne prévoit aucun mécanisme pour décharger les outils déjà récupérés ; plus la session est longue et plus on récupère d’outils, plus le contexte grossit. Le cache ne profite pas non plus sans condition : une fois l’invite initiale raccourcie, on peut passer sous le seuil minimal du cache implicite.
Troisième constat : le chargement à la demande des outils est devenu un consensus du secteur, mais les chiffres des uns ne se transposent pas chez les autres. Anthropic a lancé Tool Search Tool en novembre 2025, OpenAI a lancé Tool Search en mars 2026 avec GPT-5.4 ; les deux ont publié des données d’économies mesurées dans leurs propres conditions. Cette fois, Google ne fournit que des exemples hypothétiques. Au 20 novembre 2026, il n’existe encore aucune mesure indépendante en production de Gemini Tool Retrieval qui soit vérifiable. Donc des affirmations du genre « Gemini fait économiser 85 % en test » ne tiennent pas debout pour l’instant.
Conseils aux développeurs : commencez par classer les outils de votre agent existant selon leur fréquence d’appel — les outils très sollicités en chargement direct, les outils de longue traîne en chargement différé ; puis comparez, sur le même lot de tâches, le chargement statique et Tool Retrieval en termes de tokens totaux, de latence de bout en bout, de proportion de bons outils sélectionnés et de taux de paramètres corrects. La fonctionnalité est encore en préversion, sans date de sortie officielle ; en production, mieux vaut conserver un commutateur permettant de revenir au chargement statique. Au moment du choix du modèle, vous pouvez d’abord faire tourner une baseline Function Calling standard à faible coût via l’interface unifiée d’APIYI apiyi.com, puis migrer vers le v1beta officiel pour vérifier le gain net de Tool Retrieval.
Plus on a d’outils, plus il faut réfléchir à l’avance au moment où chacun doit sortir. Comme le dit le Lunyu · Wei Ling Gong : « L’ouvrier qui veut bien faire son travail doit d’abord aiguiser ses outils. »
📚 Références
-
Introducing Tool Retrieval in the Gemini API : annonce officielle de Google
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval - Description : date de publication, objectifs de conception, MCP et les deux modes de récupération
- Lien :
-
Documentation officielle de Tool retrieval : configuration, limites, facturation et exemples de calcul
- Lien :
aistudio.google.com/docs/tool-retrieval - Description : principale source pour le code de cet article, les règles d’erreur, la relecture sans état et les exemples de calcul de tokens
- Lien :
-
Documentation officielle de Function Calling : exécution des fonctions et renvoi des résultats
- Lien :
aistudio.google.com/docs/function-calling - Description : utilisation standard de
function_resultetcall_id
- Lien :
-
Documentation officielle de l’Interactions API : structure de l’interface et étapes d’exécution
- Lien :
aistudio.google.com/docs/interactions-overview - Description : différences entre dialogues avec état, steps et generateContent
- Lien :
-
python-genai v3.6.0 / v3.0.0 Release : historique des versions du SDK
- Lien :
github.com/googleapis/python-genai/releases - Description : prise en charge du schéma Tool Retrieval et évolution de la version par défaut de l’API
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour des tests comparatifs de Function Calling multi-modèles, rendez-vous sur APIYI apiyi.com ; pour plus de documentation d’intégration, consultez le centre de documentation docs.apiyi.com