Les mécanismes Tool Search des trois acteurs répondent au même problème, mais leurs approches d’implémentation diffèrent fortement. Tous trois font en sorte que le modèle ne voie au départ que de brefs indices sur les outils, puis charge le schéma complet des paramètres au moment de l’appel. Les différences se situent principalement sur trois points : Gemini propose deux modes de recherche, côté serveur et côté client ; la recherche côté client permet d’introduire de nouveaux outils. Claude expose deux méthodes de recherche côté serveur, Regex et BM25, et effectue la découverte au sein de l’ensemble d’outils déclarés via tool_reference. GPT regroupe les outils par namespace, et le mode client peut injecter dynamiquement de nouveaux outils via tool_search_output. Au moment de choisir, il faut regarder si la bibliothèque d’outils est fixe ou change souvent, ainsi que l’architecture API existante de l’équipe.
Ce que vous apprendrez en lisant cet article :
- À quelle API appartient chacun des trois mécanismes Tool Search et avec quel champ on l’active.
- Ce qui reste dans le contexte initial du modèle, et quel rôle jouent respectivement
short_description,tool_referenceetnamespace. - Comment se compose la chaîne d’événements entre la recherche d’outils et l’appel effectif de la fonction, et où l’adaptation risque de casser.
- Lequel des trois permet d’ajouter en cours de conversation de nouveaux outils absents de la requête initiale.
- Face à un agent d’entreprise du type commandes et stocks, comment choisir en fonction de la structure de la bibliothèque d’outils.
Sommaire : Le corps de l’article commence par les dates de publication et l’idée commune aux trois acteurs, puis détaille séparément les mécanismes de recherche et les champs natifs de Gemini, Claude et GPT. Il propose ensuite un tableau récapitulatif comparant huit dimensions, et illustre les trois approches techniques avec un même agent de commandes et de stocks. La partie analyse expose enfin les principes de choix et aborde les points d’attention liés à l’adaptation des protocoles dans une passerelle multi-modèles.
Concepts clés liés à Tool Search
| Concept | Explication brève |
|---|---|
| Catalogue d’outils | Ensemble d’outils métier destinés à la recherche, comprenant le nom, la description, la définition des paramètres et les informations de permissions |
| Tool Search | Capacité à rechercher les outils nécessaires pour la tâche en cours, puis à importer leur définition complète à la demande |
defer_loading |
Champ adopté par les trois fournisseurs, qui marque le chargement différé de la définition complète d’un outil |
| Regex | Utiliser des expressions régulières pour repérer des indices dans les noms, descriptions ou paramètres des outils |
| BM25 | Algorithme classique qui classe les résultats de recherche selon la pertinence entre les termes de la requête et le texte |
tool_reference |
Bloc de contenu utilisé par Claude pour référencer un outil déjà déclaré, que l’API développe ensuite en définition complète |
namespace |
Dans l’API OpenAI Responses, déclaration qui regroupe les fonctions apparentées par capacité métier |
| Injection dynamique d’outils | L’application confie au modèle des définitions d’outils non déclarées dans la requête initiale, pour qu’il continue de les utiliser |
tool_search_output |
Élément de réponse renvoyé par le client OpenAI lors d’une recherche, contenant les déclarations des outils correspondants |
| MCP distant | Service distant exposant des outils découvrables et exécutables via le Model Context Protocol |
| Préfixe de cache | Partie initiale de l’entrée, maintenue identique entre plusieurs appels au modèle, dont le cache peut être réutilisé |
Aperçu rapide des impacts de Tool Search
- Développeurs d’Agents : une fois les outils nombreux, plus besoin de fourrer tous les schémas dans le contexte d’un seul coup — mais les corps de requête et les événements de retour diffèrent entre les trois fournisseurs, si bien qu’un Agent multi-modèles doit implémenter séparément sa logique d’analyse.
- Plateformes d’entreprise et responsables de la maintenance des catalogues d’outils : le nommage des outils, les descriptions courtes et le mode de regroupement influencent désormais directement l’efficacité de la recherche ; le catalogue d’outils devient lui-même un actif à concevoir.
- Responsables des coûts et de l’exploitation : Tool Search ne fait pas forcément économiser de l’argent. Les exemples de calcul officiels de Google présentent à la fois des cas d’économie et des cas d’augmentation de tokens ; la décision d’activation doit se fonder sur la facture réelle.
Faits objectifs : la genèse et les mécanismes du Tool Search chez les trois acteurs
Pourquoi Gemini, Claude et GPT proposent tous un Tool Search
Lorsqu’un agent se connecte en même temps à un CRM, aux commandes, aux stocks, à la logistique, aux tickets et à plusieurs serveurs MCP, les déclarations d’outils à elles seules consomment une part considérable du contexte. La documentation de Google indique que quelques dizaines de déclarations de fonctions peuvent déjà occuper des dizaines de milliers de Tokens. Anthropic a donné un exemple concret : cinq serveurs MCP — GitHub, Slack, Sentry, Grafana et Splunk — totalisant 58 outils, dont les définitions représentaient à elles seules environ 55 000 Tokens.
Voici la chronologie des trois annonces : Anthropic a lancé le Tool Search Tool le 24 novembre 2025 ; OpenAI a introduit l’API Tool Search le 5 mars 2026, en même temps que GPT-5.4 ; Google a proposé le Tool Retrieval de l’API Gemini en version preview le 19 novembre 2026. L’idée de base est la même chez les trois : le modèle sait d’abord quelles capacités existent, puis ne lit la définition complète des paramètres qu’au moment de réellement s’en servir.
Chacun a publié ses propres chiffres de performance, mais les conditions de test sont tellement différentes qu’on ne peut pas en tirer un classement. Dans l’exemple d’Anthropic, le contexte initial passe d’environ 77 000 Tokens à environ 8 700 Tokens, et lors de son évaluation MCP interne, la précision de sélection d’outils de Claude Opus 4 grimpe de 49 % à 74 %. OpenAI, sur les 250 tâches de MCP Atlas réparties sur 36 serveurs MCP, mesure une réduction de 47 % du total de Tokens, avec une précision inchangée. Google, pour l’instant, ne fournit que des exemples hypothétiques : environ 85,6 % de réduction avec 200 outils, mais une augmentation d’environ 36,5 % avec 10 outils accompagnés d’un long contexte.
Gemini Tool Search : deux modes de récupération d’outils, côté serveur et côté client
La récupération d’outils (Tool Retrieval) de Gemini repose sur l’API Interactions et nécessite la version v1beta ; l’ancienne API generateContent n’est pas prise en charge. Pour activer le mode côté serveur, il faut ajouter {"type": "tool_search"} dans tools, puis définir defer_loading: true sur les function ou mcp_server peu fréquemment utilisés. Au départ, le modèle ne voit que le nom et la short_description des outils différés. D’après les premiers tests de Google, chaque entrée d’outil représente en moyenne environ 26 tokens. Si aucune description courte n’est configurée, la première phrase de la description complète est utilisée à la place.
Un point prête souvent à confusion : en mode côté serveur, le développeur doit tout de même envoyer la définition complète des outils. Même avec previous_interaction_id, il faut renvoyer l’intégralité du tableau tools à chaque requête. Le chargement différé empêche simplement le schéma complet d’entrer trop tôt dans le contexte du modèle. Par ailleurs, un schéma déjà chargé ne peut pas être déchargé dans la session en cours ; une requête ne peut déclarer qu’un seul tool_search ; et la récupération côté serveur et côté client ne peuvent pas être mélangées dans une même requête.
| Dimension | Récupération côté serveur | Récupération côté client |
|---|---|---|
execution |
server (par défaut) |
client |
| Système de récupération | Géré par l’API Gemini | Construit par le développeur |
| Bibliothèque d’outils à déclarer au préalable | Nécessaire | Non nécessaire |
defer_loading |
Applicable | Non applicable |
| Aller-retour supplémentaire | Aucun aller-retour côté client | Un aller-retour supplémentaire à chaque recherche |
| Cas d’usage typiques | Grands ensembles d’outils relativement stables | Registre d’outils privé, multi-tenant, outils dynamiques |
En mode côté client, le modèle appelle une fonction de recherche définie par le développeur (par exemple search_tool_registry), et l’application renvoie dans function_result.result l’objet complet de déclaration des outils correspondants. Cette approche permet d’introduire, au fil de la conversation, des outils qui n’avaient pas été déclarés dans la requête initiale — par exemple lorsqu’un utilisateur connecte temporairement un nouveau service SaaS pendant la session.
Claude Tool Search : Regex, BM25 et tool_reference
Le Tool Search Tool de Claude fait partie de la Messages API. Côté serveur, deux types d’outils de recherche sont proposés : tool_search_tool_regex_20251119, où le modèle génère une expression régulière, adapté aux bibliothèques d’outils dont les noms suivent des conventions fortes ; et tool_search_tool_bm25_20251119, où le modèle génère une requête en langage naturel, adapté à la découverte d’outils à partir de la description de leurs capacités. Les deux méthodes recherchent le nom, la description, les noms de paramètres et les descriptions de paramètres des outils. Chez Claude, le champ des paramètres est input_schema, contrairement aux deux autres fournisseurs qui utilisent parameters.
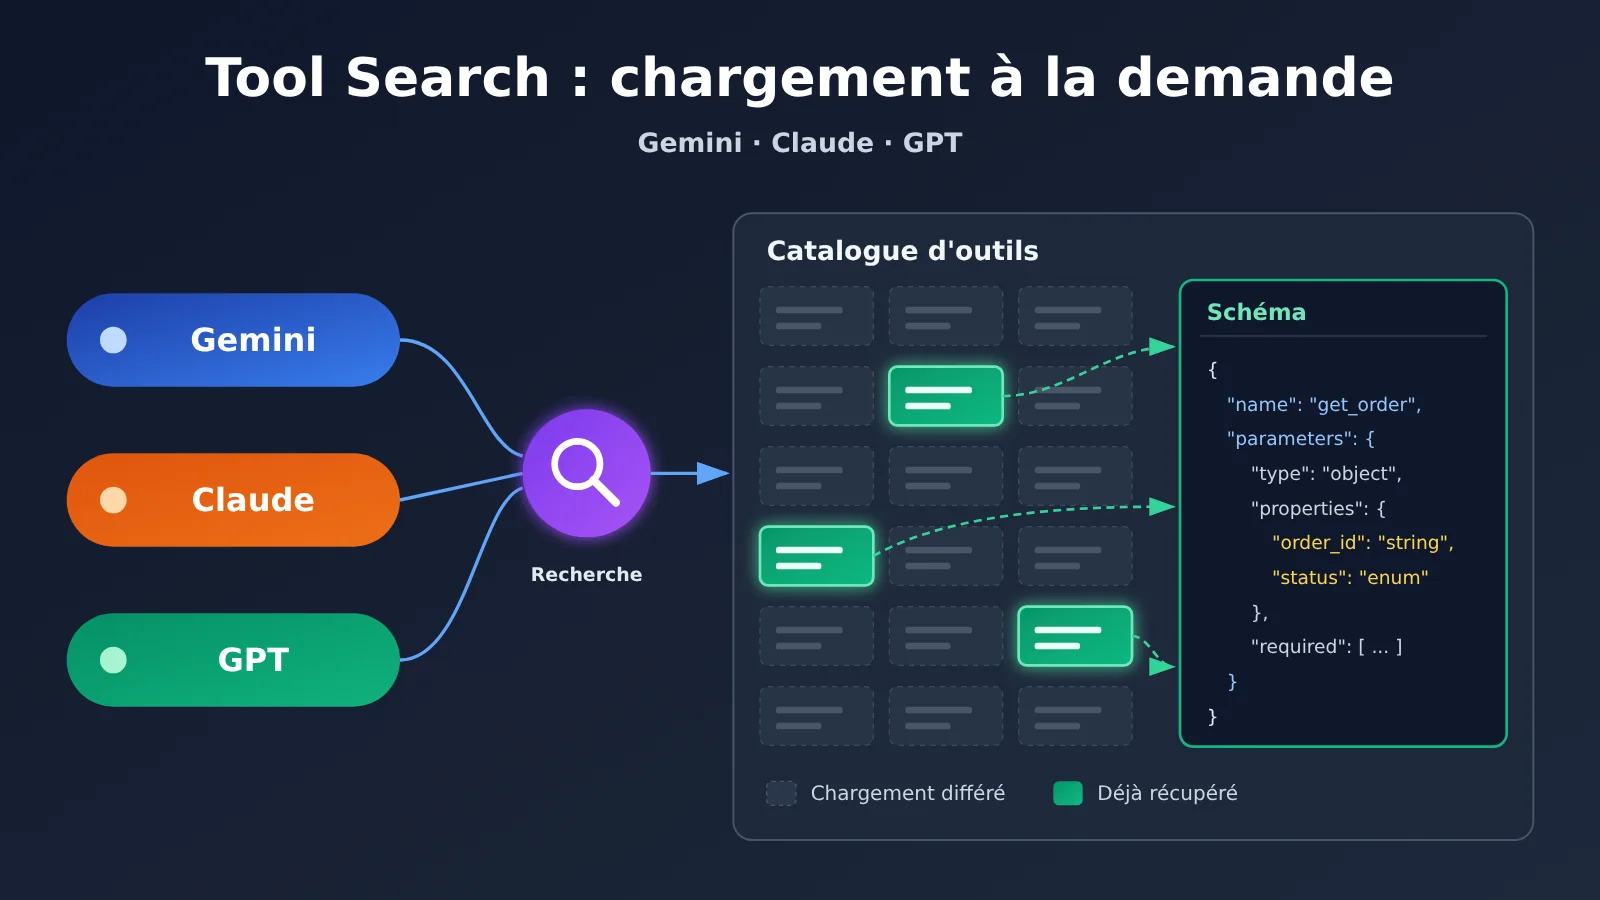
Une recherche typique suit cette chaîne d’événements : Claude commence par lancer un appel server_tool_use pour invoquer l’outil de recherche intégré, l’API renvoie tool_search_tool_result, dont le résultat contient un tool_reference ; l’API le développe ensuite en définition complète, puis le modèle émet un tool_use au niveau métier. Anthropic précise que l’identifiant srvtoolu_... de l’outil de recherche intégré ne nécessite pas que le développeur renvoie un tool_result ; l’application doit simplement exécuter le tool_use métier réel.
| Règle de Claude Tool Search | Règle officielle |
|---|---|
| Plafond d’outils différés par requête | 10 000 |
| Retour par défaut d’une recherche | 5 au maximum, ajustable via limit |
| Longueur d’une requête Regex | 200 caractères maximum |
| Longueur d’une requête BM25 | 500 caractères maximum |
| Modèles non pris en charge | Claude Opus 4.1 et modèles antérieurs |
| Contrainte de cache | Les outils avec defer_loading: true ne peuvent pas définir cache_control |
Les développeurs peuvent aussi implémenter leur propre recherche avec des algorithmes maison, par exemple à base d’embeddings, mais le résultat renvoyé reste un tool_reference, et l’outil référencé doit déjà être déclaré dans les tools de premier niveau. Le design de Claude se rapproche donc de « trouver l’outil nécessaire dans une bibliothèque d’outils préalablement déclarée ». Côté MCP, Claude configure la stratégie de chargement différé via mcp_toolset du MCP Connector : on peut la définir globalement dans default_config, ou outil par outil dans configs.
GPT Tool Search : namespace et injection dynamique d’outils
Le Tool Search d’OpenAI se trouve dans la Responses API. Il est pris en charge par GPT-5.4 et les modèles compatibles plus récents, et s’active lui aussi via tool_search et defer_loading. Sa particularité, c’est le namespace : on peut regrouper les fonctions liées à un même domaine métier (crm, billing, etc.), et le modèle commence par se fier au nom et à la description du namespace pour déterminer quelle famille de capacités est pertinente, avant de déplier les fonctions différées du groupe quand il en a besoin. Le regroupement d’outils devient ainsi une structure à part entière au niveau de l’API, et plus seulement une convention de nommage.
Côté serveur, la chaîne d’événements est tool_search_call → tool_search_output → function_call → l’application renvoie function_call_output. Côté client, l’application reçoit tool_search_call, interroge elle-même le catalogue d’outils, puis renvoie tool_search_output avec le même call_id ; son champ tools contient les déclarations complètes des outils correspondants, et le modèle n’appelle ces fonctions qu’au tour suivant. La documentation officielle autorise ici à renvoyer des outils qui n’étaient pas déclarés dans la requête initiale, tout en demandant aux développeurs de valider strictement le schéma dynamique et de n’exposer que des définitions d’outils fiables.
Pour le cache, OpenAI ajoute les nouvelles définitions d’outils découvertes à la fin du contexte, afin de limiter l’impact sur le préfixe de cache déjà en place. Un point à garder en tête côté MCP : le Tool Search de la Responses API prend en charge la découverte à la demande des outils MCP, tandis que l’Agents API branche automatiquement la découverte d’outils via le runtime lorsque le modèle et le fournisseur le permettent. La documentation officielle rappelle clairement que les deux configurations ne peuvent pas être transposées directement l’une à l’autre.
Voici une requête Responses API indicative, qui montre la structure de base du chargement différé. Les champs sont à vérifier dans la documentation officielle d’OpenAI :
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Point d'accès compatible OpenAI d'APIYI
)

tools = [
    {"type": "tool_search"},
    {
        "type": "function",
        "name": "inventory_get_stock",
        "description": "Inventory: check stock level by SKU.",
        "defer_loading": True,
        "parameters": {
            "type": "object",
            "properties": {"sku": {"type": "string"}},
            "required": ["sku"]
        }
    }
]

resp = client.responses.create(
    model="gpt-5.4",
    input="订单 A-1042 还没发货,帮我查一下 SKU-88 的库存。",
    tools=tools
)
for item in resp.output:
    print(item.type)  # On s'attend à voir des événements comme tool_search_call / function_call
Voir l’exemple de code pour la recherche côté client et l’injection dynamique
import requests

BASE_URL = "https://api.apiyi.com/v1"  # Requêtes Responses API relayées via APIYI
HEADERS = {"Authorization": "Bearer YOUR_API_KEY"}

def search_registry(query: str) -> list:
    """Recherche dans le catalogue d'outils privé de l'entreprise, avec filtrage selon les permissions utilisateur (exemple)"""
    return [{
        "type": "function",
        "name": "warehouse_schedule_shipment",
        "description": "Warehouse: schedule a new shipment date.",
        "parameters": {
            "type": "object",
            "properties": {
                "order_id": {"type": "string"},
                "date": {"type": "string"}
            },
            "required": ["order_id", "date"]
        }
    }]

def handle(output_items: list) -> list:
    follow_ups = []
    for item in output_items:
        if item["type"] == "tool_search_call":
            query = item.get("arguments", {}).get("query", "")
            follow_ups.append({
                "type": "tool_search_output",
                "call_id": item["call_id"],      # Utiliser le même call_id que l'appel de recherche
                "tools": search_registry(query)  # Peut contenir des outils non déclarés dans la requête initiale
            })
    return follow_ups
# Attention : validez toujours le schéma renvoyé dynamiquement, n'exposez que des outils fiables
🚀 Conseil pour une validation rapide : avant de brancher vos vraies applications métier, commencez par appeler GPT, Claude et Gemini séparément avec la clé unifiée d’APIYI apiyi.com, puis faites tourner le même catalogue d’outils chez les trois. Vous vérifierez ainsi que la structure des événements est bien reconnue par votre couche de parsing, et vous pourrez ensuite choisir votre solution principale.
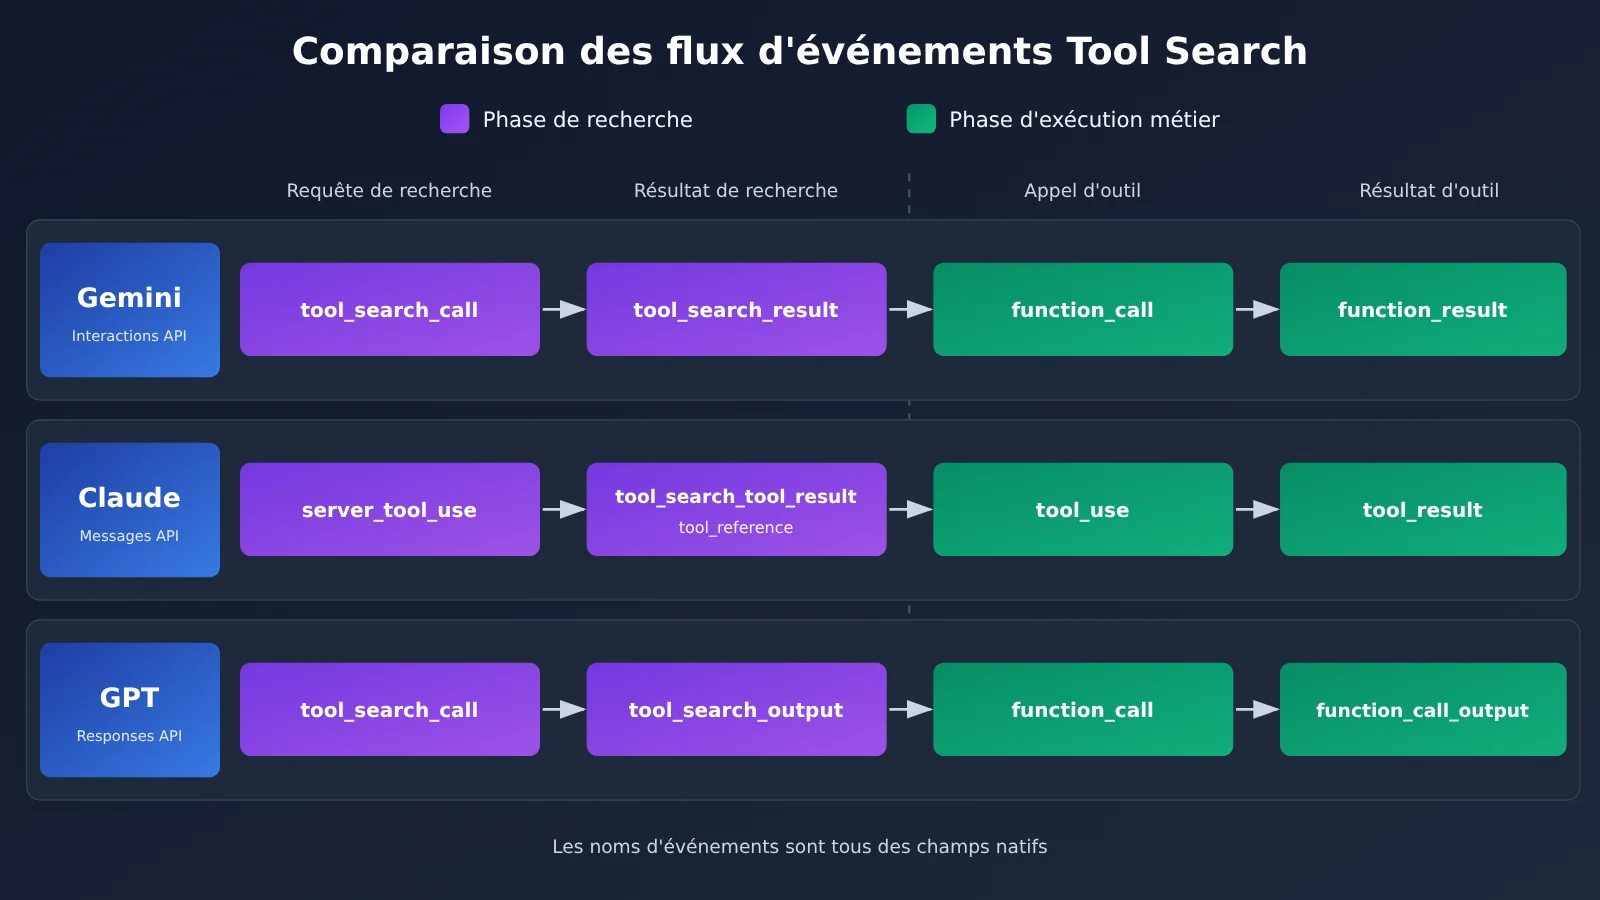
Les noms d’événements affichés dans le schéma ci-dessus sont les champs natifs de chaque fournisseur. Si vous voulez tester vous-même le flux d’événements fournisseur par fournisseur, vous pouvez utiliser APIYI apiyi.com avec le même script de test et changer de modèle pour comparer.
Comparaison ciblée des mécanismes Tool Search des trois fournisseurs
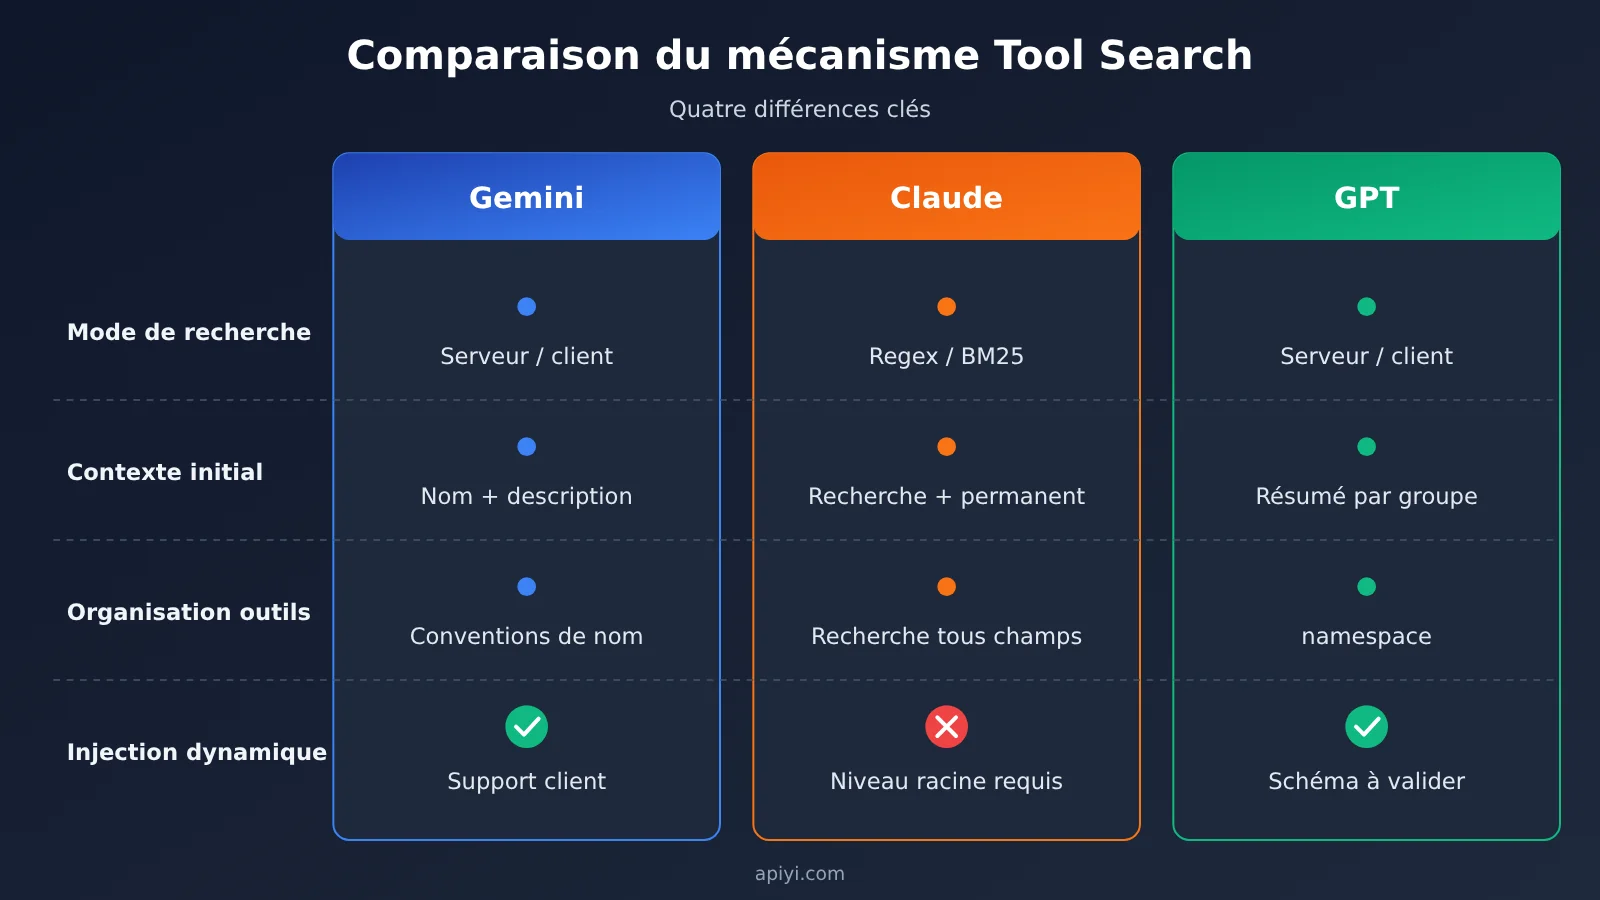
| Dimension | Gemini | Claude | GPT |
|---|---|---|---|
| API concernée | Interactions API (v1beta) |
Messages API | Responses API |
| Mode de recherche | Côté serveur (algorithme non divulgué) / côté client | Regex / BM25 / recherche personnalisée | Côté serveur / côté client |
| Conservation dans le contexte initial | Nom + short_description |
Outil de recherche + outils non différés | Outils différés ou résumé namespace |
| Organisation des outils | Convention de nommage + description courte | Nom, description et paramètres sont tous indexables | Regroupement par namespace |
| Champ des paramètres | parameters |
input_schema |
parameters |
| Recherche côté client | Pris en charge | La recherche personnalisée renvoie tool_reference |
Pris en charge (tool_search_output) |
| Ajout dynamique de nouveaux outils | Pris en charge en mode client | Les outils référencés doivent déjà être déclarés au niveau supérieur | Pris en charge en mode client, avec validation du schéma |
| Intégration MCP | mcp_server + defer_loading |
default_config / configs de mcp_toolset |
Règles différentes entre Responses et Agents |
| Cache et facturation | Pas de frais de fonctionnalité dédiés ; surveiller total_tool_use_tokens |
Pas de facturation séparée ; les outils différés ne peuvent pas définir cache_control |
Les nouveaux outils sont ajoutés en fin de liste pour préserver le préfixe de cache |
💡 Conseil de choix : le tableau ci-dessus compare uniquement les règles d’interface vérifiables. Le résultat concret dépend de votre bibliothèque d’outils et de la longueur des conversations. Le mieux est de passer par le point d’entrée multi-modèles d’APIYI apiyi.com pour faire des tests A/B sur un petit échantillon, puis de calculer les coûts à partir des champs de facturation de chaque fournisseur.
Analyse et arbitrage : les conditions d’adéquation pour le choix de Tool Search
Examiner trois approches techniques à travers un Agent dédié aux commandes et aux stocks
Imaginons le besoin métier suivant : un utilisateur consulte le statut d’une commande, constate que le produit n’a pas encore été expédié, interroge ensuite les stocks, puis cherche à savoir si une nouvelle date d’expédition peut être planifiée. Le système dispose de neuf catégories d’outils : CRM, commandes, stocks, planification des entrepôts, logistique, remboursements, facturation, notifications et approbations. Chaque catégorie contient plusieurs fonctions.
- Approche Gemini : charger directement les requêtes de commandes les plus courantes, définir les outils de longue traîne comme les stocks et la planification des entrepôts en chargement différé, puis rédiger correctement
short_description, en laissant la recherche côté serveur sélectionner le schéma deget_inventory. Si l’outil de planification des entrepôts est activé dynamiquement selon le tenant, passer à une recherche côté client, avec un retour depuis un registre privé. - Approche Claude : si les noms d’outils sont bien réguliers (par exemple
inventory_*,warehouse_*), Regex peut correspondre précisément ; si l’utilisateur emploie une formulation familière du type « voir si on peut encore réapprovisionner », BM25 convient mieux. Au final,tool_referenceest développé en untool_useappelable. - Approche GPT : créer des
namespaceseloncrm,inventory,logistics; le modèle détermine d’abord que la demande concerne les deux domaines des stocks et de la logistique, puis développe les fonctions du groupe. Pour un nouveau prestataire logistique intégré temporairement, il est possible de l’injecter viatool_search_outputcôté client.
Ce scénario sert uniquement à illustrer les différences de mécanismes ; il ne représente pas les taux de réussite ou les latences mesurés chez les trois fournisseurs.
Quatre principes de choix à l’intention des développeurs
- Bibliothèque d’outils vaste et stable : privilégiez la capacité de recherche côté serveur. Les trois fournisseurs couvrent ce besoin, mais attention : Gemini doit renvoyer le tableau d’outils complet à chaque requête, et Claude limite à 10 000 le nombre d’outils à chargement différé par requête.
- Besoin de contrôler explicitement la stratégie de recherche : les algorithmes Regex et BM25 rendus publics par Claude sont la seule solution dont l’algorithme est explicitement divulgué, ce qui convient aux équipes qui veulent obtenir des correspondances précises selon des règles de nommage. Les algorithmes côté serveur de Gemini et GPT ne sont pas divulgués ; il ne faut pas en déduire qu’ils sont identiques à ceux de Claude.
- Bibliothèque d’outils qui change souvent ou besoin de filtrer selon les permissions utilisateur : regardez surtout l’injection dynamique côté client. Les modes client de Gemini et GPT permettent d’ajouter de nouveaux outils ; la recherche personnalisée de Claude ne peut référencer que des outils déjà déclarés, il faut donc assembler l’ensemble des candidats avant d’envoyer la requête.
- Nombre d’outils limité : les calculs de Google montrent qu’avec 10 outils et un contexte long de 30 000 tokens, la consommation de tokens augmente, contre-intuitivement, d’environ 36,5 %. Google recommande de continuer à charger statiquement tant que le nombre d’outils stables reste inférieur à environ 20 ; cela vaut aussi comme référence pour les deux autres fournisseurs, mais chacun doit néanmoins procéder à ses propres mesures.
Le problème de l’adaptation des protocoles dans une passerelle multi-modèles
Le piège dans lequel tombent le plus facilement les équipes qui développent des agents multi-modèles, c’est d’assimiler « pouvoir appeler ce modèle » à « pouvoir utiliser le Tool Search de ce modèle ». On peut décomposer cette capacité en quatre couches : l’accès au modèle, les points de terminaison de protocole (Interactions / Messages / Responses), les champs de déclaration des outils (tool_search, defer_loading, namespace, configuration MCP), puis l’exécution et la gestion de l’état (événements de recherche, résultats de fonction, signature, historique de conversation). Une intégration de modèle réussie prouve seulement que la première couche fonctionne.
Il faut surtout faire attention à une règle propre à Gemini : dans une session sans état avec store=false, tool_search_call, tool_search_result et leur signature ne doivent être ni modifiés ni supprimés, sinon la requête renvoie une erreur HTTP 400. Cela veut dire qu’une passerelle ne peut pas compresser ni réécrire les messages d’historique à volonté. Pour unifier les trois fournisseurs derrière une interface Tool Search commune, il faut maintenir une table de correspondance des événements au niveau du framework d’agent ; on ne peut pas espérer qu’un simple changement de Base URL rende le même corps de requête universel.
🎯 Conseil technique : lorsque vous connectez plusieurs modèles via une plateforme d’agrégation comme APIYI (apiyi.com), commencez par un faible volume de trafic pour vérifier que le point de terminaison cible ainsi que des champs comme
tool_search,defer_loadingetnamespacesont bien transmis dans leur intégralité, puis intégrez Tool Search dans la chaîne de production.
Variables à surveiller de près
Gemini Tool Retrieval est encore en version preview : son interface pourrait évoluer avant la sortie officielle. Son taux d’économie moyen, sa latence et sa précision en environnement de production réel ne disposent, au 20 novembre 2026, d’aucun test indépendant vérifiable. Une tendance se dessine toutefois clairement : les trois acteurs confient tous la « gouvernance du catalogue d’outils » aux développeurs, et le nommage, les descriptions courtes, le regroupement et les permissions ressembleront de plus en plus à de l’ingénierie d’index pour un système de recherche. Avant la mise en production, je vous conseille de monter une expérimentation contrôlée autour des tokens d’entrée initiaux, des tokens consommés par les outils, du taux de sélection correcte de l’outil, du taux de recherche sans correspondance et du nombre moyen de recherches, puis de comparer transversalement sur le même jeu de tâches via un environnement multi-modèles comme APIYI apiyi.com — histoire de ne pas se laisser entraîner par les chiffres marketing d’un seul fournisseur.
Avoir plus d’outils ne rend pas un Agent plus intelligent pour autant ; c’est sa capacité à trouver le bon outil au moment voulu qui fixe son plafond. Comme le dit les Entretiens de Confucius (Livre XV, « Wei Ling Gong ») : « Pour bien faire son ouvrage, il faut d’abord affûter ses outils. »
Références
- Documentation technique Google Tool Retrieval : recherche côté serveur et côté client, limites, facturation et exemples de calcul
- Lien :
aistudio.google.com/docs/tool-retrieval
- Lien :
- Annonce officielle Google : Introducing Tool Retrieval in the Gemini API
- Lien :
blog.google/innovation-and-ai/technology/developers-tools/gemini-api-tool-retrieval
- Lien :
- Documentation Anthropic Tool Search Tool : Regex, BM25, tool_reference et limites
- Lien :
platform.claude.com/docs/en/agents-and-tools/tool-use/tool-search-tool
- Lien :
- Annonce Anthropic Advanced Tool Use : lancement de Tool Search et évaluations internes
- Lien :
anthropic.com/research/advanced-tool-use
- Lien :
- Documentation OpenAI Tool Search : namespace, recherche côté client et injection dynamique
- Lien :
developers.openai.com/api/docs/guides/tools-tool-search
- Lien :
- Annonce OpenAI GPT-5.4 : lancement de Tool Search et tests MCP Atlas
- Lien :
openai.com/index/introducing-gpt-5-4
- Lien :
Auteur : l’équipe technique APIYI
Échanges techniques : pour approfondir l’adaptation des appels d’outils d’Agents multi-modèles, n’hésitez pas à nous contacter via APIYI apiyi.com ; d’autres ressources d’intégration sont disponibles au centre de documentation docs.apiyi.com.