Note de l’auteur : cet article explique comment envoyer une première requête à Gemini 4 Neon via APIYI avec deux protocoles, et quels champs et journaux vérifier une fois la requête réussie.
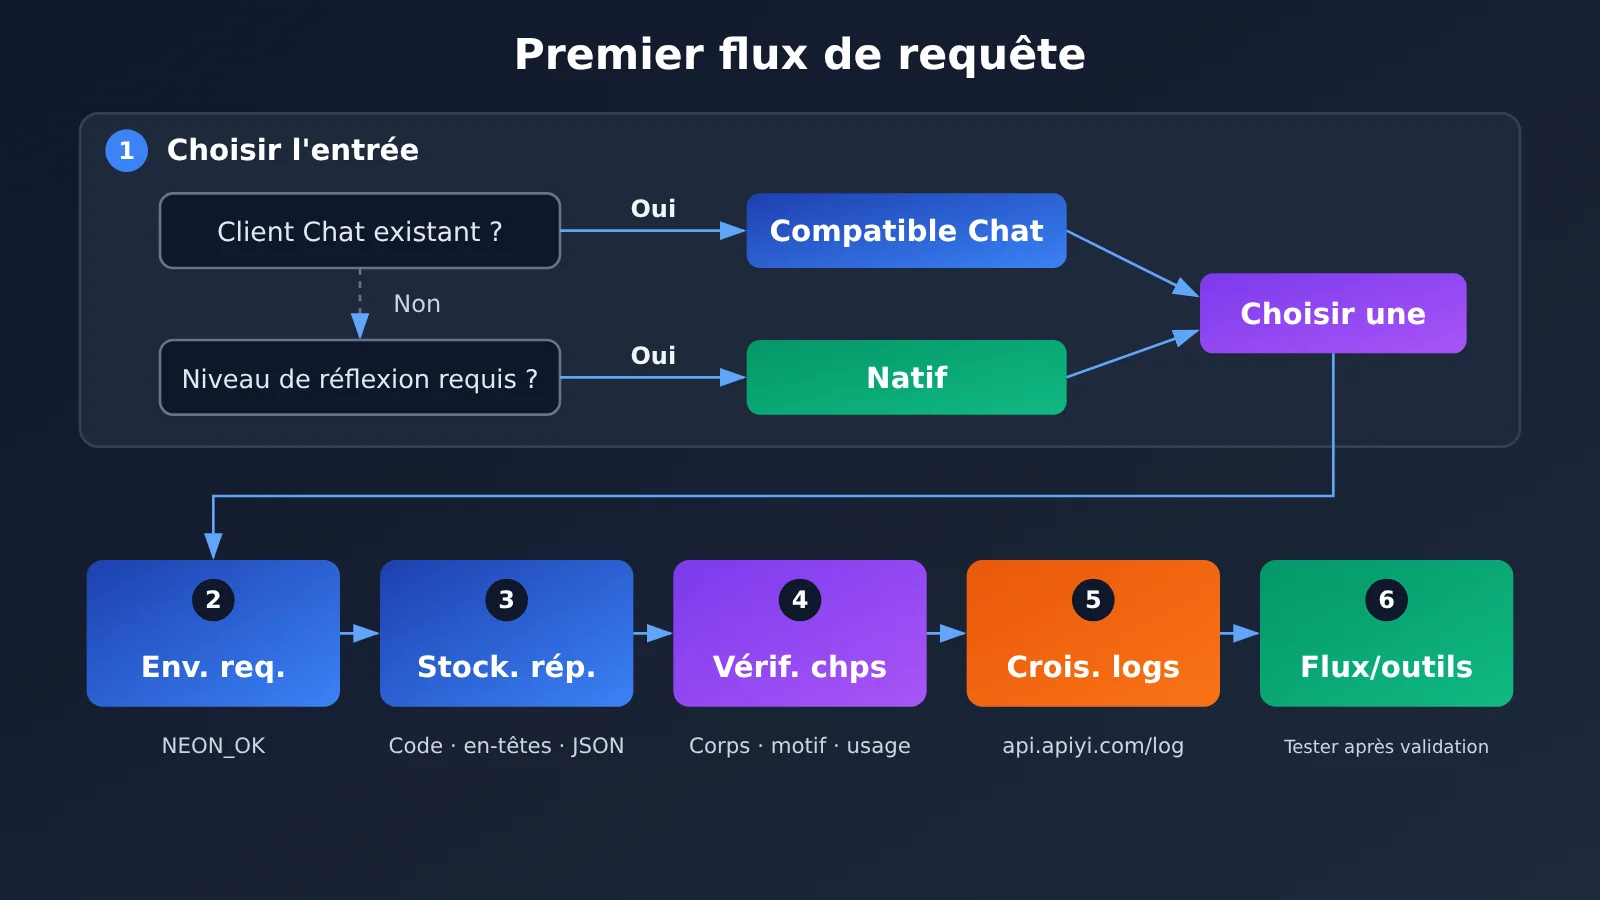
Conclusion d’abord : si votre projet dispose déjà d’un client OpenAI Chat, passez par le point d’entrée Chat Completions compatible OpenAI ; il suffit de modifier base_url et le nom du modèle. Si vous devez définir explicitement le niveau de réflexion de Gemini, passez par le point d’entrée natif generateContent de Gemini et indiquez-le dans generationConfig.thinkingConfig.thinkingLevel. Quelle que soit la voie choisie, commencez par faire fonctionner un cas de texte brut avec la même invite courte, puis validez à partir du statut HTTP, du corps de la réponse, de la raison d’arrêt, de la consommation et des journaux de la plateforme. Une fois la validation réussie, testez ensuite des capacités comme la sortie en streaming et l’appel d’outils.
Contexte : Google a publié Gemini 4 Neon dans le journal des mises à jour d’AI Studio du 18 novembre 2026 et a annoncé sa disponibilité générale (GA). APIYI a confirmé sa mise en ligne le 20 novembre 2026 à 11 h 45 (heure de Pékin) ; le catalogue de prix public affiche gemini-4-neon, avec les groupes disponibles default et svip. Les exemples de cet article sont rédigés d’après la documentation APIYI et la documentation du SDK ; aucun endpoint payant n’a été appelé, et l’article ne contient aucune statistique issue de tests réels.
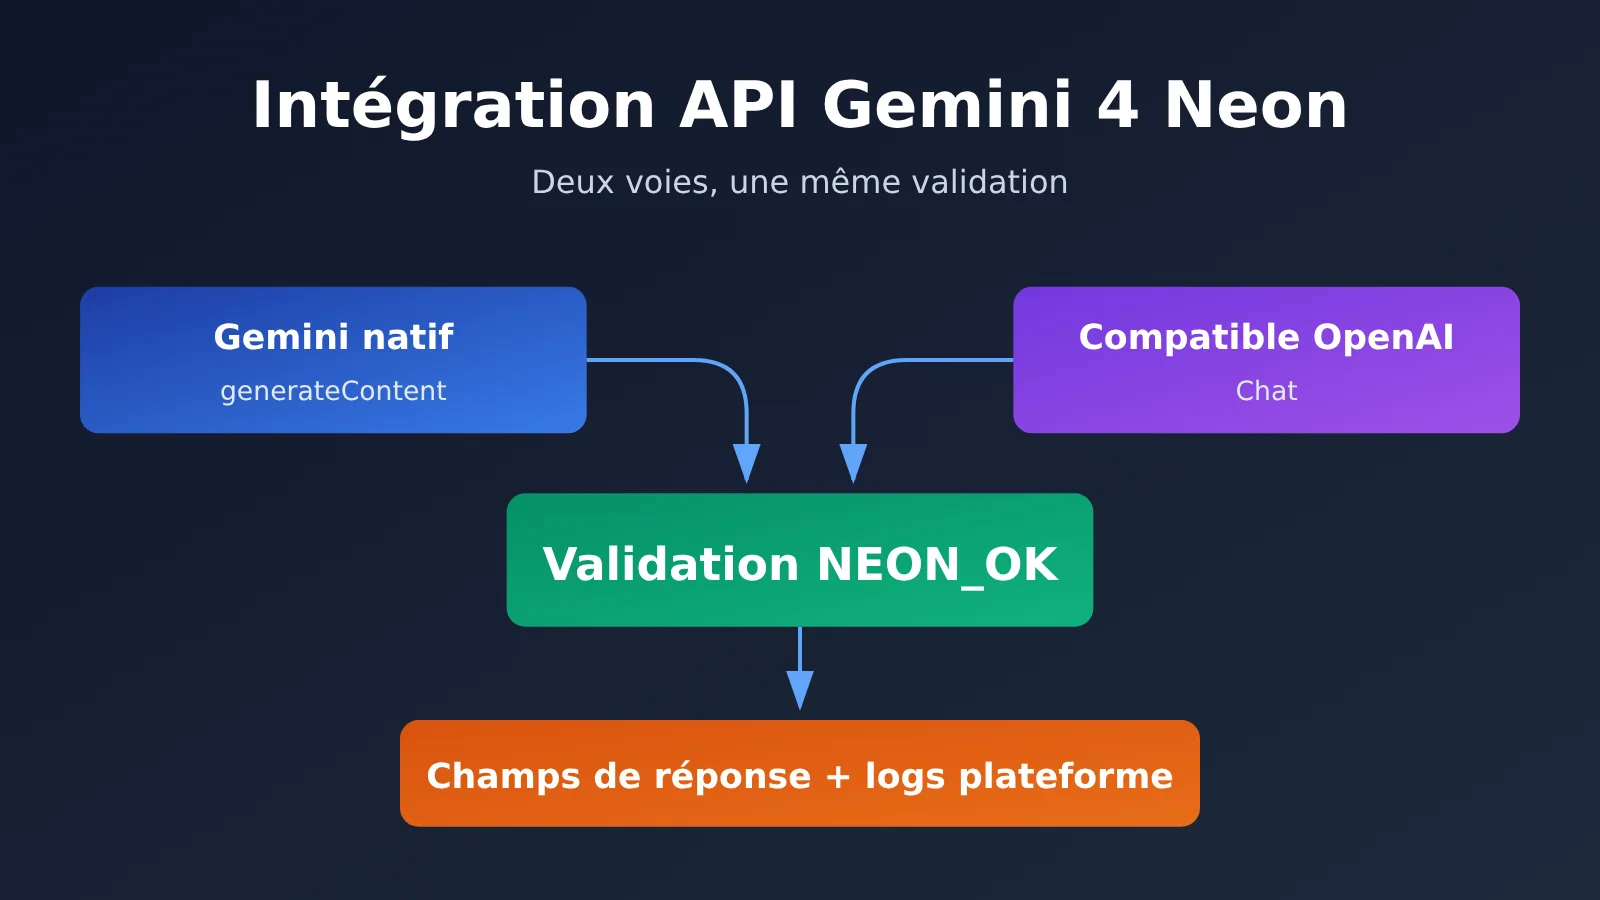
Carte des connaissances et index pour l’intégration de l’API Gemini 4 Neon
Tout le processus d’intégration se déroule en trois étapes : choisir l’interface, envoyer la requête, puis vérifier la sortie et les journaux. La sortie de chaque étape sert d’entrée à la suivante. Le tableau ci-dessous réunit l’ordre de ces trois étapes, la logique de cet enchaînement et l’objectif à atteindre à chacune : on peut le lire comme une carte des connaissances ou comme un index de lecture.
| N° | Étape | Ce que fournit l’étape précédente | Pourquoi cet ordre | Objectif de cette étape |
|---|---|---|---|---|
| 1 | Choisir le point d’entrée (1.1 compatible Chat / 1.2 natif et niveaux de réflexion) | Votre pile technique actuelle et votre besoin en niveaux de réflexion | L’entrée détermine l’URL, la méthode d’authentification et la structure des champs ; toutes les étapes suivantes en dépendent | Fixer un seul protocole pour ne pas déboguer deux voies en parallèle |
| 2 | Envoyer la même requête courte (2.1 cURL natif / 2.2 SDK Python) | L’entrée et le format de requête déjà fixés | Avec une invite courte et figée, on écarte les différences de capacités du modèle pour ne tester que la chaîne de communication | Obtenir le code de statut, les en-têtes et le corps de réponse complets |
| 3 | Valider (3.1 champs / 3.2 identité et journaux / 3.3 conservation des preuves d’échec) | La réponse brute enregistrée à l’étape 2 | On examine d’abord la réponse elle-même, puis on la compare aux journaux de la plateforme : les preuves vont du plus proche au plus lointain | Déterminer si le « succès du texte » est réel ; sinon, laisser des preuves exploitables |
Conseil de lecture : si vous n’utilisez qu’un seul protocole, après avoir lu la sous-section correspondante de la section 1, allez directement à 2.1 ou 2.2 ; en revanche, la section 3 se lit en entier.
To Know : termes indispensables de l’API Gemini 4 Neon
| Terme | Explication concise |
|---|---|
generateContent |
Interface de génération non-streaming native de Gemini ; le corps de la requête organise le contenu avec contents et parts |
thinkingLevel |
Champ du niveau de réflexion sous generationConfig.thinkingConfig dans l’interface native ; les exemples de cet article utilisent high |
| thought part | Part marquée comme contenu de réflexion dans la réponse native ; à exclure lors de l’assemblage du texte final |
finishReason / finish_reason |
Champ de raison d’arrêt, respectivement pour l’interface native et l’interface compatible |
X-Shellapi-Request-Id |
Identifiant de requête renvoyé par APIYI dans les en-têtes bruts ou dans le message d’erreur, utilisé pour le dépannage |
1 Choisir le point d’accès à l’API Gemini 4 Neon
Les deux points d’accès renvoient au même modèle ; la différence réside dans la forme du protocole et dans les paramètres que l’on peut contrôler. Voici d’abord une comparaison, puis deux sous-sections pour expliquer le choix.
| Élément de comparaison | Chat compatible OpenAI | Gemini natif |
|---|---|---|
| Adresse | https://api.apiyi.com/v1 + Chat Completions |
https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent |
| Pour qui | Projets qui ont déjà un SDK OpenAI ou un client Chat | Projets qui ont besoin de contrôler explicitement les paramètres Gemini |
| Niveau de réflexion | Cet article ne transmet pas de paramètre associé | thinkingConfig.thinkingLevel |
| Emplacement du texte | choices[0].message.content |
text hors thought dans candidates[0].content.parts |
| Identifiant du modèle | model dans la réponse |
modelVersion dans la réponse (si renvoyé) |
1.1 Point d’accès compatible Gemini 4 Neon : réutiliser son client Chat existant
Si votre code repose déjà sur le SDK Python OpenAI ou sur un autre client Chat Completions, la modification la plus légère consiste à remplacer base_url par https://api.apiyi.com/v1 et à écrire gemini-4-neon comme nom de modèle, sans toucher à la structure des messages. L’avantage, c’est que le code métier ne bouge pratiquement pas et qu’en cas de problème, il est plus facile de déterminer s’il vient du réseau, de l’authentification ou du modèle.
Il y a quelques limites à préciser pour cette voie. Premièrement, ne transmettez pas reasoning_effort. La couche de compatibilité de Google lui applique bien un mapping, mais cela ne signifie pas que le point d’accès compatible d’APIYI prenne le même engagement. Deuxièmement, cet article n’utilise pas l’interface /v1/responses. Troisièmement, l’ancienne syntaxe thinkingBudget et le niveau minimal ne rentrent pas non plus dans le cadre de cet article. Si vous avez vraiment besoin de contrôler le niveau de réflexion, passez plutôt par le point d’accès natif décrit en 1.2.
1.2 Point d’accès natif Gemini 4 Neon : définir explicitement le niveau de réflexion
Le point d’accès natif utilise la structure de requête propre à Gemini. Le niveau de réflexion est transmis explicitement via generationConfig.thinkingConfig.thinkingLevel, et la valeur utilisée dans le cas d’usage spécifique APIYI est "high". La réponse native sépare aussi le contenu de réflexion et le texte principal dans des parts différentes ; il faut donc filtrer activement lors de la lecture du texte. La section 2.1 donne l’implémentation précise.
Côté authentification, ce cas d’usage natif utilise l’en-tête Authorization: Bearer, et non la syntaxe avec paramètre key fréquente dans l’officiel Gemini. Si vous migrez du code natif existant, vérifiez ce point en premier.
2 Envoyer la même requête courte à l’API Gemini 4 Neon
Les deux protocoles utilisent la même invite : Reply with exactly NEON_OK and nothing else. La sortie attendue de cette invite est très courte, et le résultat est donc facile à juger. Si la valeur retournée n’est pas NEON_OK, cela indique un problème dans la chaîne de traitement ou dans l’analyse de la réponse, ce qui permet d’écarter les interférences du type « le style de réponse du modèle est différent ». La clé API est toujours lue depuis la variable d’environnement APIYI_API_KEY ; ne l’écrivez pas dans le code ni dans l’historique des commandes.
2.1 cURL natif Gemini 4 Neon et extraction des valeurs JSON
Les commandes ci-dessous enregistrent séparément le code de statut HTTP, les en-têtes de réponse et le corps de la réponse JSON ; ces trois éléments seront utilisés lors de la validation de la section 3.
curl -sS -X POST "https://api.apiyi.com/v1beta/models/gemini-4-neon:generateContent" \
  -H "Authorization: Bearer ${APIYI_API_KEY}" \
  -H "Content-Type: application/json" \
  -D neon_native_headers.txt \
  -o neon_native_body.json \
  -w "%{http_code}\n" \
  -d '{
    "contents": [
      {"role": "user", "parts": [{"text": "Reply with exactly NEON_OK and nothing else."}]}
    ],
    "generationConfig": {
      "thinkingConfig": {"thinkingLevel": "high"}
    }
  }' > neon_native_status.txt
Pour lire le corps de la réponse, concaténez toutes les valeurs text de candidates[0].content.parts dont le champ thought n’est pas true ; ne vous limitez pas au premier élément part. L’exemple ci-dessous utilise jq ; si jq n’est pas installé, vous pouvez le remplacer par n’importe quel outil d’analyse JSON :
# Corps : concaténer les valeurs text qui ne sont pas thought
jq -r '[.candidates[0].content.parts[]? | select(.thought != true) | .text // empty] | join("")' neon_native_body.json

# Raison d'arrêt, utilisation, version du modèle (affiche null si le champ est absent ; ne pas compléter soi-même)
jq '{finishReason: .candidates[0].finishReason, usageMetadata, modelVersion}' neon_native_body.json

# Identifiant de requête de la plateforme
grep -i "x-shellapi-request-id" neon_native_headers.txt
2.2 Appel via le SDK Python OpenAI de Gemini 4 Neon et lecture de la réponse
Le point d’entrée compatible utilise with_raw_response, ce qui permet d’obtenir à la fois l’objet analysé et les en-têtes de réponse bruts. max_retries=0 désactive les nouvelles tentatives automatiques du SDK, afin d’éviter qu’un échec soit masqué par une nouvelle tentative, et empêche l’apparition de plusieurs journaux sur la plateforme, impossibles à rattacher à la bonne requête.
import os
from openai import OpenAI, APIStatusError, APIConnectionError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",  # Point d'entrée compatible OpenAI d'APIYI
    max_retries=0,
    timeout=120.0,
)

try:
    raw = client.chat.completions.with_raw_response.create(
        model="gemini-4-neon",
        messages=[{"role": "user", "content": "Reply with exactly NEON_OK and nothing else."}],
        max_tokens=4096,
    )
    print("HTTP:", raw.status_code)
    print("X-Shellapi-Request-Id:", raw.headers.get("x-shellapi-request-id"))

    completion = raw.parse()
    if not completion.choices:
        print("choices 为空,不读取正文")
    else:
        choice = completion.choices[0]
        print("content:", choice.message.content)
        print("finish_reason:", choice.finish_reason)
    print("usage:", completion.usage)
    print("model:", completion.model)

except APIStatusError as e:
    print("HTTP:", e.status_code)
    print("X-Shellapi-Request-Id:", e.response.headers.get("x-shellapi-request-id"))
    print("error:", e.message)  # Avant de consigner, vérifier que le message ne contient pas de clé ou d'autres informations sensibles
except APIConnectionError as e:
    print("未拿到 HTTP 响应:", type(e).__name__)
Un point de ce code mérite une attention particulière : si choices est vide, n’écrivez pas directement choices[0], sinon une erreur d’indice serait levée et masquerait le vrai problème. Une erreur de connexion n’a ni code de statut HTTP ni en-têtes de réponse ; elle doit donc être traitée séparément de APIStatusError.
3 Valider la première requête de l’API Gemini 4 Neon
L’objectif de cette validation est de déterminer si « une requête en texte brut réussit » est bien le cas. Un HTTP 2xx avec le corps attendu NEON_OK prouve seulement que cette requête texte a réussi. Cela ne prouve ni l’identité du modèle, ni ne constitue un résultat de test de performance.
3.1 Statut HTTP, corps, raison d’arrêt et utilisation
| Élément à vérifier | Champ natif | Champ compatible | Condition de réussite |
|---|---|---|---|
| Statut HTTP | status sauvegardé | raw.status_code |
2xx |
| Corps | concaténation des text hors thought |
choices[0].message.content |
égal à NEON_OK |
| Raison d’arrêt | candidates[0].finishReason |
choices[0].finish_reason |
enregistrée, et cohérente avec l’état du corps |
| Utilisation | usageMetadata |
usage |
enregistrée, pour recoupement avec les logs |
Si un champ n’existe pas dans la réponse, notez-le comme « non retourné » plutôt que d’en déduire la valeur par expérience. La raison d’arrêt doit s’examiner en même temps que le corps. Quand le corps est vide alors que la raison d’arrêt n’indique pas une fin normale, le problème vient généralement du processus de génération, pas du code de parsing.
3.2 Ce que le modelVersion natif, le model compatible et les journaux peuvent réellement démontrer
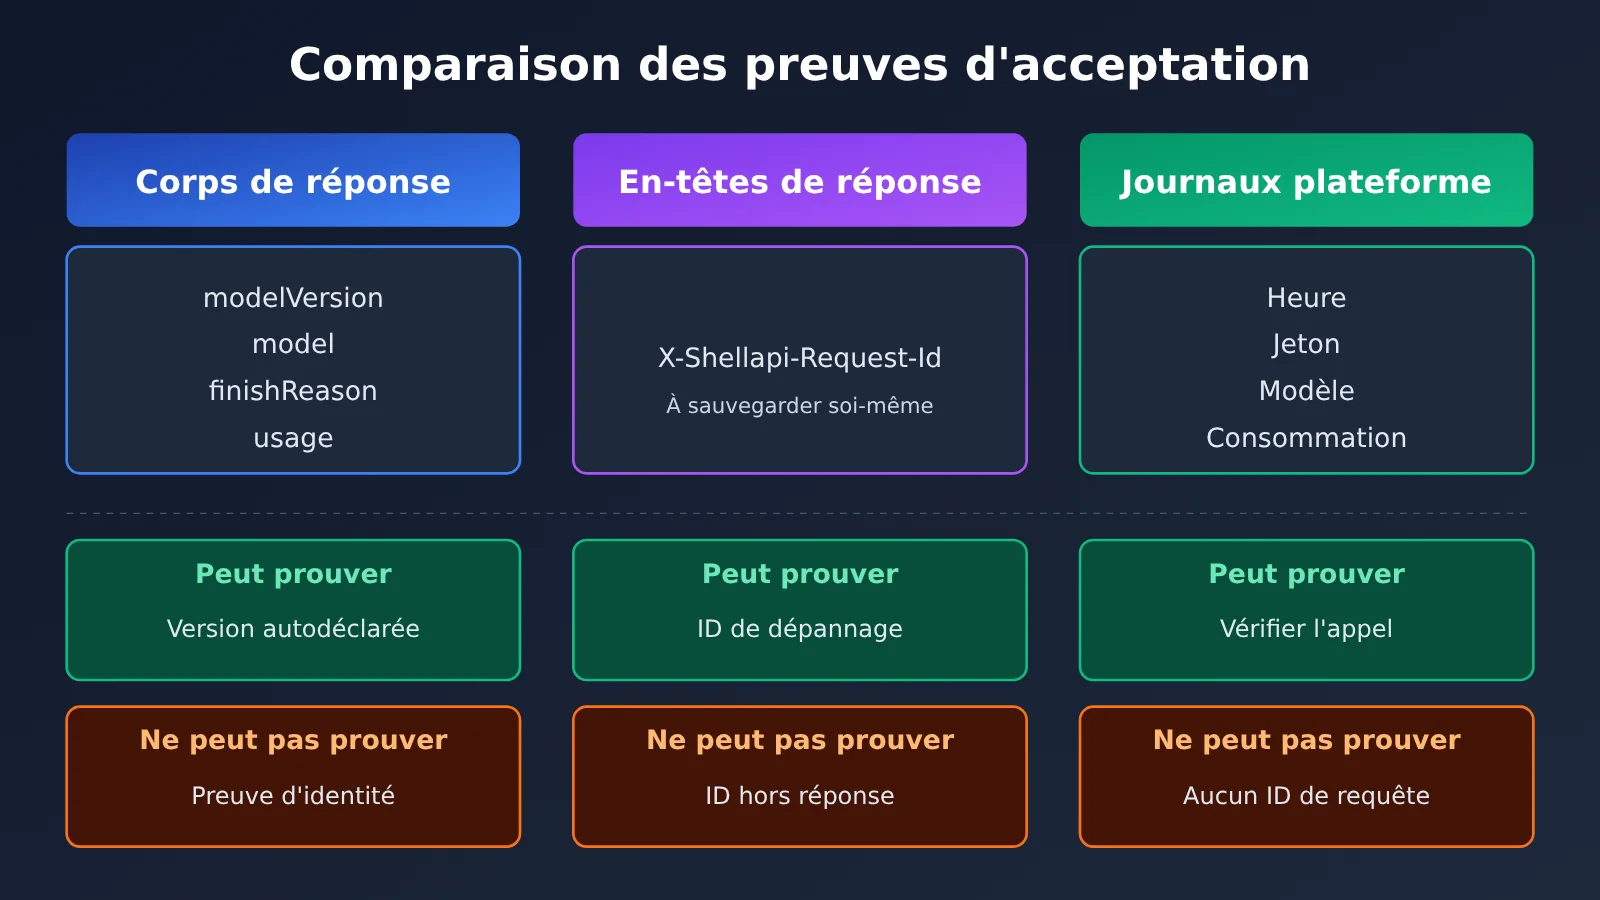
Ces différentes informations ne couvrent pas le même périmètre de preuve. Lorsque vous consignez vos vérifications, ne les utilisez pas l’une pour l’autre :
| Information | Source | Ce qu’elle peut démontrer | Ce qu’elle ne peut pas démontrer |
|---|---|---|---|
modelVersion |
Corps de réponse natif (s’il est renvoyé) | La version du modèle que la réponse déclare elle-même | Ne peut pas servir à elle seule de preuve d’identité |
model |
Corps de réponse compatible | Le nom du modèle que la réponse déclare elle-même | Idem |
| Journaux de la plateforme | api.apiyi.com/log |
Vérifier cet appel par horodatage, token, modèle et consommation | La console n’affiche pas l’ID de requête |
X-Shellapi-Request-Id |
En-tête de réponse brut ou message d’erreur | L’identifiant de requête utilisé par la plateforme pour le dépannage | Ce n’est ni le responseId, ni l’id du Chat, ni le _request_id du SDK |
Pour vérifier les journaux, faites correspondre l’heure d’envoi de la requête, le token utilisé, le nom du modèle gemini-4-neon et les chiffres de consommation. Comme la console n’affiche pas l’ID de requête, vous devez conserver vous-même X-Shellapi-Request-Id à partir de l’en-tête de réponse : impossible de le retrouver ensuite dans la console.
3.3 Comment conserver des preuves lorsque Gemini 4 Neon n’a pas de corps de réponse ou que la requête échoue
En cas d’échec de la requête ou d’absence de corps de réponse, ne relancez pas immédiatement : conservez d’abord les preuves dans l’ordre suivant :
- Enregistrez le code de statut HTTP. S’il s’agit d’une erreur de connexion, notez le type d’exception.
- Enregistrez les en-têtes de réponse bruts et récupérez-y
X-Shellapi-Request-Id. - Enregistrez le corps de réponse brut ou le message d’erreur, en retirant les éléments sensibles comme la clé API.
- Notez la raison d’arrêt et l’usage (le cas échéant), ainsi que l’heure d’envoi de la requête, le nom du jeton utilisé et le nom du modèle.
- Rendez-vous sur
api.apiyi.com/logpour retrouver l’enregistrement correspondant par heure et par jeton, puis utilisez les éléments ci-dessus pour comparer avec la documentation de dépannage par ID de requête de la plateforme.
Un autre point à surveiller concernant la réponse native : si les parts ne contiennent que du contenu thought, le texte filtré du corps sera vide. Dans ce cas, enregistrez honnêtement « corps filtré vide », sans transformer le contenu thought en corps de réponse juste pour obtenir une sortie.
Une fois validé le texte brut en tour unique de la manière décrite ci-dessus, vérifiez ensuite les capacités telles que la sortie en streaming et l’appel d’outils, selon les besoins du projet. Pour chaque capacité ajoutée, procédez à une validation séparée selon la méthode « même requête, sauvegarde de la réponse brute, comparaison avec les journaux ». Cet article ne traite ni des benchmarks ni des tarifs ; pour ces informations, référez-vous aux publications officielles et au catalogue public d’APIYI.
Références
- Journal des modifications de Google AI Studio (2026-11-18) :
aistudio.google.com/docs/changelog - Structure de Gemini GenerateContentResponse :
aistudio.google.com/api-reference/generate-content - Annonce de mise en ligne de Gemini 4 Neon sur APIYI et exemples des deux protocoles :
docs.apiyi.com/news/gemini-4-neon-launch.md - Traitement des réponses Gemini par APIYI :
docs.apiyi.com/api-capabilities/gemini/response-handling - Traitement des réponses compatibles OpenAI par APIYI :
docs.apiyi.com/api-capabilities/openai/response-handling - Dépannage par ID de requête d’APIYI :
docs.apiyi.com/faq/request-id-troubleshooting - Accès à la réponse brute avec openai-python :
github.com/openai/openai-python
Un voyage de mille lieues commence par un pas. — Dao De Jing