Note de l’auteur : en novembre 2026, les nouveaux modèles sortent en rafale. Cet article explique comment changer de modèle depuis un seul point d’entrée, se connecter par endpoint, et tenir une comptabilité séparée pour chaque canal.
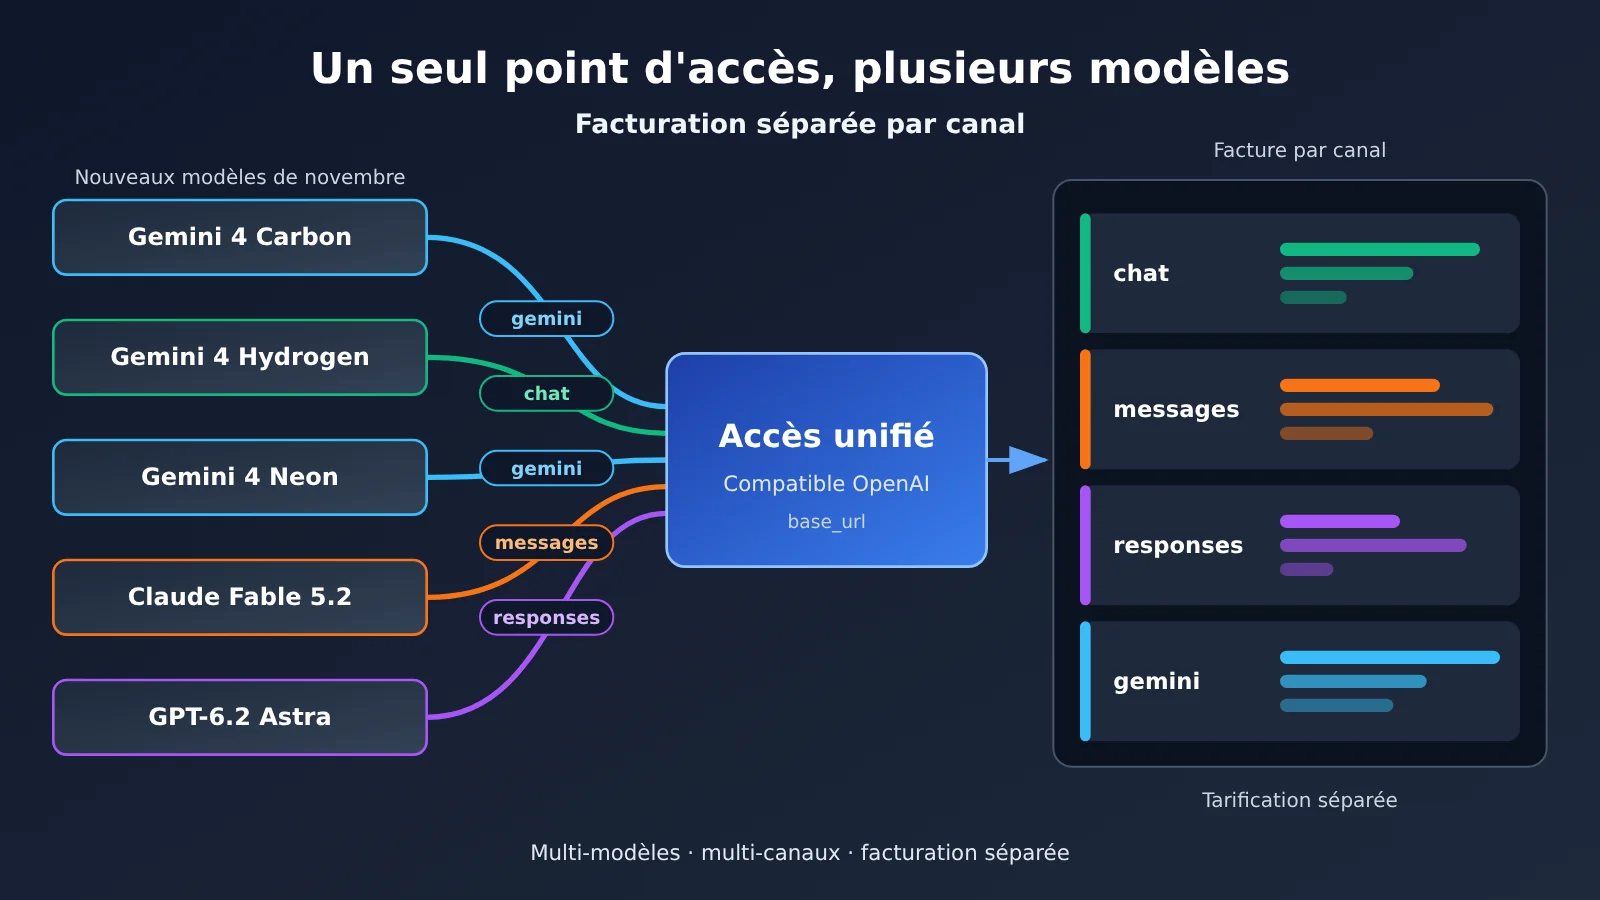
Trois semaines à peine se sont écoulées depuis début novembre, et Google a déjà lancé trois modèles Gemini 4 : Carbon le 10 novembre, Hydrogen le 12 novembre et Neon le 18 novembre. Du côté de l’image, du code et d’autres domaines, de nouveaux modèles apparaissent aussi régulièrement dans l’actualité. Pour les développeurs qui veulent tester de nouveaux modèles, la difficulté n’est pas d’écrire le code d’appel, mais que chaque fournisseur a son propre SDK, sa propre authentification et sa propre façon de facturer. Cet article propose une approche plus simple : un seul point d’entrée pour changer de modèle, et une facturation séparée par canal.
Ce n’est pas une liste promotionnelle de « tous les nouveaux modèles en un seul endroit ». Les modèles dont on parle dans l’actualité et ceux qui sont réellement appelables sur la plateforme sont traités séparément dans cet article. Par exemple, MAI Image 2.7, dont on parle dans les news, n’est pas encore disponible sur APIYI, et nous ne le présenterons pas ici comme un modèle appelable.
La valeur essentielle : après avoir lu cet article, vous saurez où vérifier d’abord la liste des modèles, comment décider quel ID de modèle utiliser, quel endpoint emprunter pour chaque type de modèle, et comment éviter d’estimer toute la facture à partir du prix unitaire d’un seul modèle. Les modèles et les prix mentionnés ci-dessous se basent sur la liste des modèles et l’API de tarification d’APIYI apiyi.com au 2026-11-20.
Points clés de l’intégration des nouveaux modèles de novembre
Quand les nouveaux modèles arrivent en masse, les erreurs les plus fréquentes se concentrent à trois endroits : prendre un modèle annoncé pour un modèle déjà disponible, utiliser le mauvais point de terminaison et estimer tous les coûts à partir d’un seul prix unitaire. Le tableau ci-dessous regroupe ces trois points et les bonnes pratiques associées.
| Point clé | Explication | Valeur |
|---|---|---|
| Vérifier d’abord la liste des modèles | Se fier au tableau récapitulatif de la plateforme et à l’API de tarification, en distinguant les modèles annoncés des modèles réellement appelables | Éviter d’appeler directement un nom de modèle présenté lors d’une conférence et de récolter une erreur |
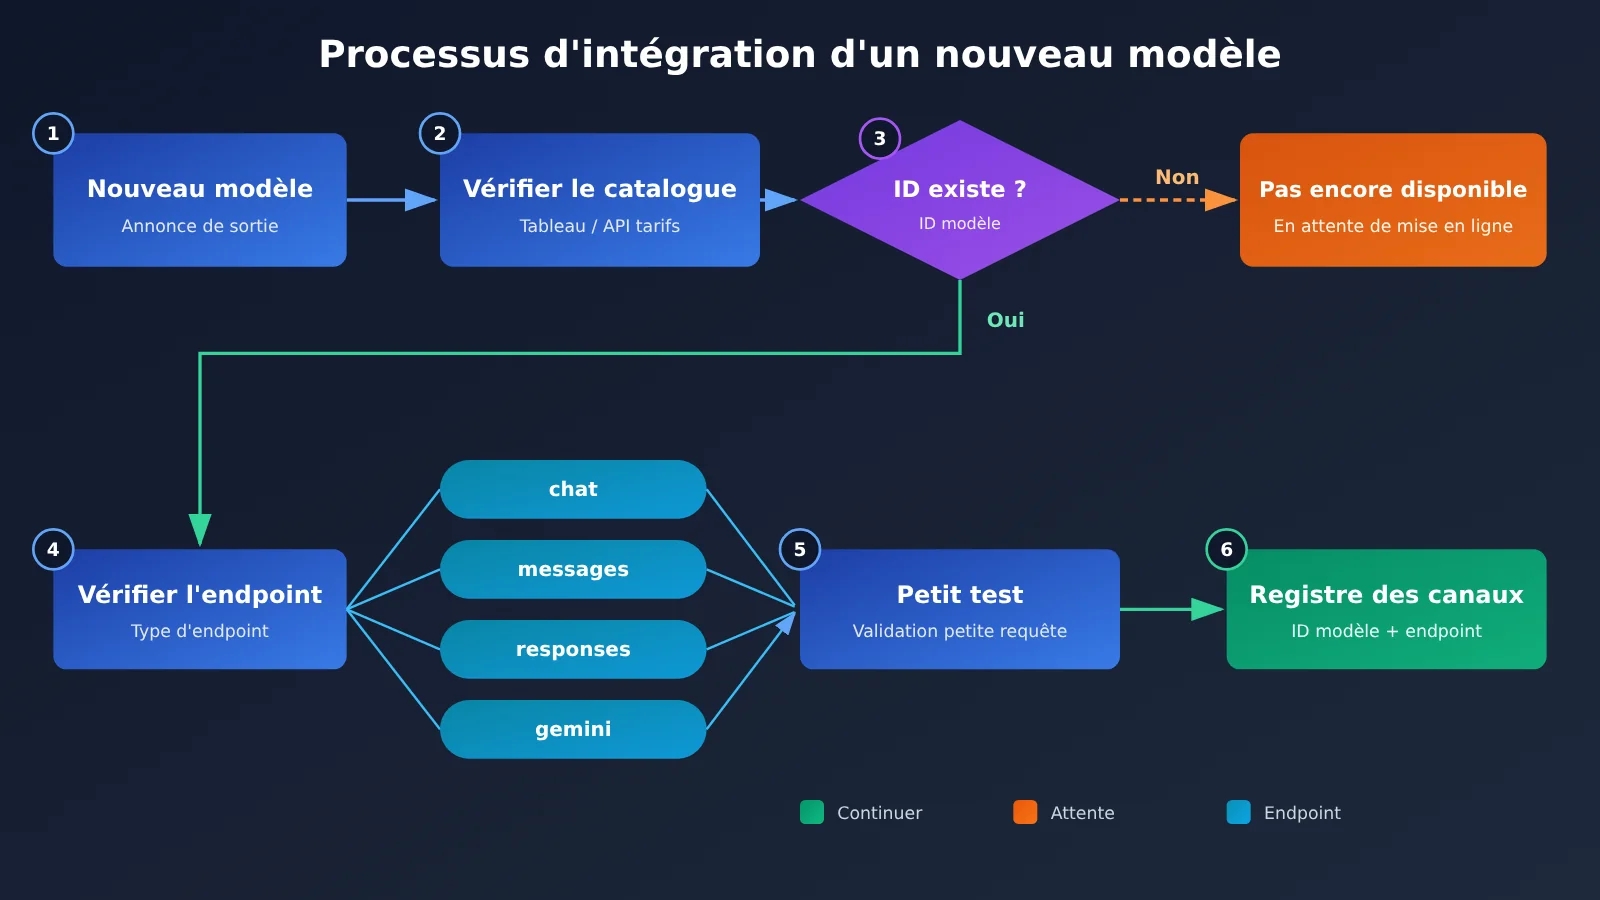
| Changer de modèle = changer l’ID de modèle + vérifier le point de terminaison | Modifier le paramètre model sous le même base_url, puis confirmer si l’appel passe par chat, messages, responses ou gemini |
Ne pas avoir à écrire un SDK différent pour chaque fournisseur |
| Suivre la facturation séparément par canal | Enregistrer séparément les tokens d’entrée, de sortie et de lecture du cache pour chaque modèle et chaque point de terminaison | Les modèles dont les prix unitaires varient de plusieurs ordres ne sont pas moyennés ensemble, et les coûts restent traçables |
| Les prix de lancement ont une date de fin | Certains nouveaux modèles bénéficient d’un tarif introductif limité dans le temps ; une fois l’offre terminée, le tarif standard officiel peut changer | Anticiper le budget du mois suivant sans que les hausses de prix perturbent vos prévisions |
Détails clés de l’intégration d’un nouveau modèle : modèle annoncé ≠ modèle disponible en catalogue
La première étape de l’intégration, c’est de consulter le catalogue, pas d’écrire du code. La table complète des modèles d’APIYI se trouve à l’adresse docs.apiyi.com/models.md ; la version consultée ici a été mise à jour le 2026-11-19 à 10:59 (UTC+8). Il existe par ailleurs une interface de tarification lisible par machine, https://api.apiyi.com/api/pricing, portant l’identifiant de version shell-api-modelmak-v1. Les deux sources ne se mettent pas forcément à jour au même rythme : par exemple, gemini-4-neon n’apparaît pas encore dans cette version de la table, alors que l’interface de tarification contient déjà tous les champs de prix. Donc, pour déterminer si un modèle « peut être appelé », je vous conseille de vérifier les deux endroits ; si l’une des deux sources le mentionne, faites ensuite une petite requête pour confirmer.
Le cas inverse mérite tout autant votre attention. MAI Image 2.7 est un modèle d’image dont on parle dans l’actualité récente, mais la table et l’interface de tarification actuelles d’APIYI ne listent que MAI-Image-2.6 et MAI-Image-2.6-Flash, pas la 2.7. Autrement dit, MAI Image 2.7 n’est pas encore disponible en catalogue ; nous mettrons ce modèle en ligne dès que possible, et d’ici là, le nom du modèle et le prix font foi selon la liste des modèles de la plateforme. Par ailleurs, Kling, Muse et gemini-4-flash-lite sont actuellement introuvables dans la table comme dans l’interface de tarification : ne les intégrez pas dans vos plans.
Correspondance entre les nouveaux modèles de novembre et leur état sur le catalogue
Le tableau ci-dessous fait correspondre, un par un, les modèles mentionnés dans les actualités de novembre avec leur état sur le catalogue au 2026-11-20. Il ne contient que les informations vérifiables dans les sources ; ce qui n’a pas pu être vérifié ne fait l’objet d’aucune supposition.
| Modèle | Informations des actualités | État sur le catalogue APIYI (2026-11-20) | ID du modèle |
|---|---|---|---|
| Gemini 4 Carbon | Publié le 2026-11-10, destiné aux tâches longues et difficiles | Consultable dans le tableau général et l’interface de tarification | gemini-4-carbon |
| Gemini 4 Hydrogen | Publié le 2026-11-12, gamme quotidienne rapide | Consultable dans le tableau général et l’interface de tarification | gemini-4-hydrogen |
| Gemini 4 Neon | Publié le 2026-11-18, capacités intermédiaires | Déjà présent dans l’interface de tarification, non listé dans le tableau général de cette version | gemini-4-neon |
| Gemini 4 Argon | — | Consultable dans le tableau général | gemini-4-argon |
| MAI Image 2.7 | Modèle d’image mentionné dans les actualités | Pas encore disponible, le sera dès que possible | Voir la liste de la plateforme |
| MAI Image 2.6 / 2.6 Flash | — | Consultable, facturation à l’appel | MAI-Image-2.6 / MAI-Image-2.6-Flash |
On peut résumer simplement le positionnement des trois gammes Gemini 4 : Carbon privilégie les tâches à longue chaîne et de difficulté élevée, Hydrogen mise sur la vitesse et convient aux appels quotidiens à haute fréquence, et Neon se situe entre les deux. Pour choisir, commencez par déterminer la gamme selon la difficulté de la tâche, puis regardez le prix : c’est plus sûr que de prendre directement le moins cher.
Prise en main rapide des nouveaux modèles de novembre : un seul point d’accès pour changer de modèle
Exemple minimal : changer de modèle en modifiant deux paramètres
APIYI propose une interface compatible OpenAI. Lors de l’intégration d’un nouveau modèle, la plupart des changements ne concernent que deux éléments : base_url et model. Avec le SDK Python officiel d’OpenAI, voici les étapes minimales :
- Installer le SDK :
pip install openai - Créer le client :
client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Lancer une conversation :
client.chat.completions.create(model="gemini-4-hydrogen", messages=[{"role": "user", "content": "Hello!"}]) - Lire le résultat :
response.choices[0].message.content
Pour passer de Hydrogen à Carbon, il suffit de remplacer model="gemini-4-hydrogen" par model="gemini-4-carbon" ; le client, l’authentification et la structure des messages ne changent pas. C’est tout le sens de « un seul point d’accès pour changer de modèle » : changer de modèle revient généralement à changer l’ID du modèle et à vérifier le point de terminaison, sans avoir à écrire un SDK différent pour chaque fournisseur.
Voir l’approche d’intégration complète (avec changement de point de terminaison et suivi des coûts par canal)
Dans un projet complet, mieux vaut placer la correspondance « ID de modèle → point de terminaison » dans la configuration, plutôt que de la disperser dans le code :
1. Définir l’élément de configuration `MODEL_ROUTES`, chaque entrée contenant trois champs `model`, `endpoint` et `price_key`. Par exemple, `gemini-4-neon` correspond à `chat`, `claude-fable-5-2` à `messages`, et `gpt-6.2-astra` à `responses`.
2. Encapsuler une fonction `call_model(model, prompt)` : selon l’`endpoint`, appeler respectivement `client.chat.completions.create`, `client.responses.create`, ou utiliser le SDK Anthropic avec le format Messages (`base_url` identique).
3. Après chaque requête, lire les tokens d’entrée, de sortie et de cache dans le champ `usage` de la réponse, puis les écrire dans un registre local en utilisant `model+endpoint` comme clé de canal.
4. Interroger une fois par jour l’API de tarification, convertir le prix unitaire à partir de `model_ratio`, `completion_ratio` et `cache_ratio`, puis le multiplier par le nombre de tokens du registre pour obtenir le coût estimé de chaque canal.
5. En cas d’échec d’appel, enregistrer `model` et le message d’erreur. Si l’erreur indique que le modèle n’existe pas, vérifier d’abord la liste des modèles avant de réessayer à l’aveugle.
Ainsi, lorsqu’un nouveau modèle est mis en ligne, il suffit d’ajouter une ligne de configuration dans `MODEL_ROUTES` ; le code métier n’a pas besoin d’être modifié.
🚀 Conseil pour démarrer rapidement : commencez par vous inscrire sur APIYI apiyi.com et récupérer le crédit d’essai gratuit réservé aux nouveaux utilisateurs. Faites d’abord fonctionner toute la chaîne avec un modèle de la gamme courante comme Hydrogen, puis passez à Neon et Carbon pour comparer les résultats. Tout le processus ne nécessite qu’une seule clé API.
Comparatif des endpoints des nouveaux modèles : n’envoyez pas tous les modèles dans chat
« Un seul point d’entrée » ne veut pas dire « un seul endpoint ». Les modèles texte déjà disponibles n’utilisent pas tous le même endpoint : lorsqu’on change de modèle, cette étape doit impérativement être vérifiée.
| Série de modèles | Exemple d’ID de modèle | Endpoints disponibles | Remarques |
|---|---|---|---|
| Série Gemini 4 | gemini-4-carbon / gemini-4-neon / gemini-4-hydrogen |
chat ou gemini | chat correspond au format compatible OpenAI /v1/chat/completions ; gemini est le format natif Gemini, le chemin exact étant à vérifier dans la documentation de la plateforme |
| Claude Fable 5.2 | claude-fable-5-2 / claude-fable-5-2-thinking |
chat ou messages | messages correspond au format Anthropic /v1/messages |
| GPT-6.2 Astra | gpt-6.2-astra |
responses recommandé | privilégier /v1/responses |
| MAI Image 2.6 | MAI-Image-2.6 / MAI-Image-2.6-Flash |
génération d’images | facturation à la requête, la méthode d’appel étant à vérifier dans la documentation de la plateforme |
En pratique, si votre équipe dispose déjà d’un important volume de code basé sur le format chat, Gemini et Claude peuvent continuer à utiliser l’endpoint chat dans un premier temps : c’est la migration la moins coûteuse. Lorsque vous avez besoin des capacités natives du fournisseur, basculez alors vers l’endpoint gemini ou messages. Pour GPT-6.2 Astra, il est en revanche conseillé de passer directement par l’endpoint responses, plutôt que de forcer le format chat par habitude.
Facture des nouveaux modèles de novembre : le détail par canal
Apprenez d’abord à lire l’API de tarification
L’API de tarification d’APIYI exprime les prix sous forme de ratios multiplicateurs. La règle de conversion est la suivante :
- Prix d’entrée =
model_ratio × 2(unité : USD / million de tokens ; avecmodel_ratioà 1, cela équivaut à$2 / 1M) - Prix de sortie = prix d’entrée ×
completion_ratio - Prix de lecture du cache = prix d’entrée ×
cache_ratio
Prenons gemini-4-neon : l’API de tarification indique model_ratio 1.5, completion_ratio 5 et cache_ratio 0.05. Après conversion, l’entrée revient à $3 / 1M, la sortie à $15 / 1M et la lecture du cache à $0.15 / 1M, ce qui correspond au tarif affiché par Google. Une fois cette méthode assimilée, dès qu’un nouveau modèle est publié, vous pouvez calculer vous-même le prix unitaire à partir de https://api.apiyi.com/api/pricing, sans attendre la mise à jour d’un article.
Comparatif des prix par canal (vérifié le 2026-11-20)
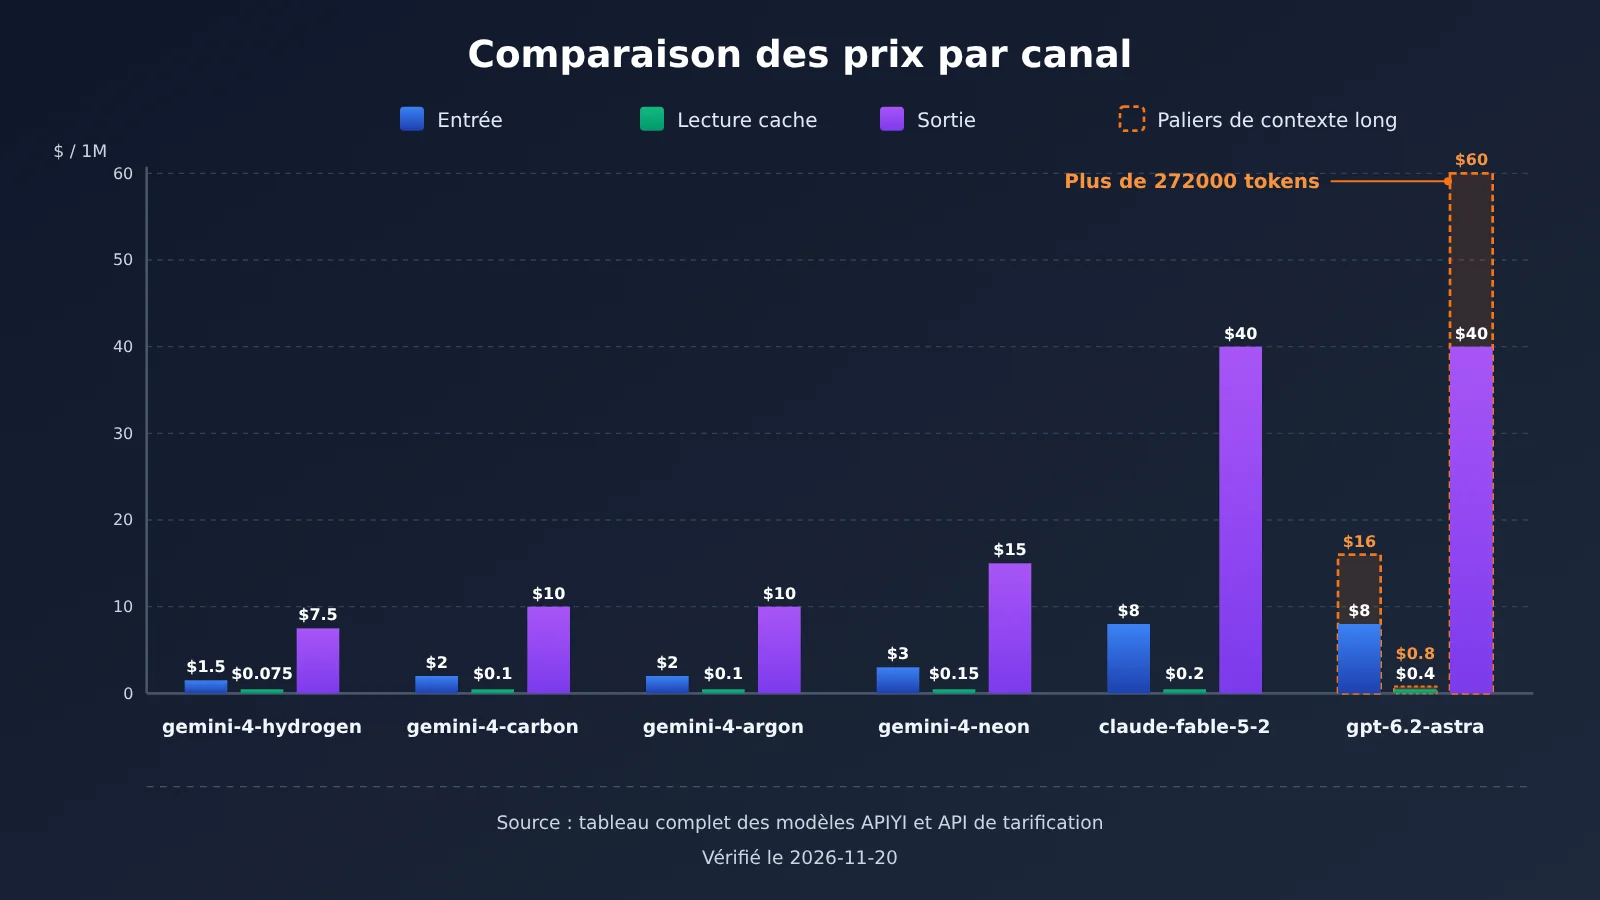
📊 Note sur la source des données : les prix du graphique ci-dessus et du tableau ci-dessous proviennent du tableau récapitulatif des modèles et de l’interface de tarification d’APIYI apiyi.com ; la vérification a été effectuée le 2026-11-20 et, en cas de modification ultérieure, c’est la liste en temps réel de la plateforme qui fait foi.
| Canal (ID du modèle) | Entrée | Lecture du cache | Sortie | Remarques |
|---|---|---|---|---|
gemini-4-hydrogen |
$1.5 / 1M |
$0.075 / 1M |
$7.5 / 1M |
Créneau rapide du quotidien |
gemini-4-carbon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
Correspond au tarif d’introduction de Google jusqu’au 2026-11-30 |
gemini-4-argon |
$2 / 1M |
$0.1 / 1M |
$10 / 1M |
Tiré du tableau récapitulatif |
gemini-4-neon |
$3 / 1M |
$0.15 / 1M |
$15 / 1M |
Tiré de l’interface de tarification |
claude-fable-5-2 / -thinking |
$8 / 1M |
$0.2 / 1M |
$40 / 1M |
Les deux ID ont le même prix |
gpt-6.2-astra (premier palier) |
$8 / 1M |
$0.4 / 1M |
$40 / 1M |
Au-delà de 272000 tokens, voir ci-dessous |
MAI-Image-2.6 |
à l’unité $0.12 |
— | — | Image |
MAI-Image-2.6-Flash |
à l’unité $0.06 |
— | — | Image |
Deux points du tableau méritent une explication séparée.
Le premier concerne le palier de contexte long de GPT-6.2 Astra. Le tableau récapitulatif indique que, au-delà de 272000 tokens, l’entrée passe à $16 / 1M ; l’interface de tarification précise en outre que, au-delà de 272000 tokens, la sortie est facturée $60 / 1M et la lecture du cache $0.8 / 1M. Si votre activité injecte des contextes très longs, estimez impérativement par palier, sans appliquer le prix du premier palier à l’ensemble des requêtes.
Le second concerne le tarif d’introduction de Gemini 4 Carbon. Le prix actuel correspond au tarif d’introduction de Google jusqu’au 2026-11-30 ; à partir du 1er décembre, le tarif standard de Google sera de $4 / 1M en entrée et $20 / 1M en sortie. Les prix ultérieurs de la plateforme font foi selon la liste des modèles APIYI ; pour établir un budget de décembre, je vous conseille de prévoir cet écart.
Pourquoi le tarif d’un seul fournisseur ne suffit pas à tout résumer
Comme le montre le tableau ci-dessus, pour un million de tokens en sortie, Hydrogen est à $7.5, tandis que Claude Fable 5.2 et GPT-6.2 Astra démarrent à $40 — plus de cinq fois plus cher. Si une équipe fait tourner trois ou quatre modèles en parallèle, se fier à un seul « prix moyen unitaire » ou au tarif d’un seul fournisseur revient très vite à sous-estimer ou surestimer lourdement les coûts. La démarche la plus sûre consiste à utiliser « ID du modèle + point de terminaison » comme clé de canal, à enregistrer séparément pour chaque canal les tokens d’entrée, de sortie et de lecture du cache, à les multiplier par le tarif correspondant, puis à tout additionner.
Autre point d’attention : un point d’entrée unifié règle le coût d’intégration, mais cela ne signifie pas pour autant que chaque modèle sera moins cher. Dans le tableau ci-dessus, plusieurs modèles Gemini 4 affichent exactement le même prix que le tarif officiel de Google. Pour savoir si c’est rentable, il faut comparer canal par canal avec votre consommation réelle, et non généraliser.
💰 Conseil coût : pour comparer les options, vous pouvez appeler séparément Hydrogen, Neon et Carbon sur le même lot d’échantillons de test via APIYI apiyi.com, puis noter la consommation de tokens par canal, calculer le coût réel par appel de chaque canal, et enfin choisir votre modèle principal.
Questions fréquentes (FAQ)
Q1 : Qu’entend-on par « un seul point d’entrée pour changer de modèle » ?
Tout simplement que tous les modèles partagent le même `base_url` et la même API Key. Pour changer de modèle, il suffit de modifier l’ID dans le paramètre `model` et de vérifier les endpoints pris en charge par ce modèle. Pas besoin de s’inscrire séparément chez chaque fournisseur ni d’intégrer un SDK par éditeur.
Q2 : Un modèle tout juste annoncé dans l’actualité est-il directement appelable ?
Pas forcément. Annonce ne veut pas dire disponible. Prenons l’exemple du 2026-11-20 : MAI Image 2.7 n’apparaissait que dans les actualités, alors que sur les rayonnages d’APIYI on ne trouvait que `MAI-Image-2.6` et `MAI-Image-2.6-Flash`, la 2.7 n’étant pas encore référencée — elle le sera dès que possible. Avant d’appeler, consultez d’abord le tableau récapitulatif et l’API de tarification, vérifiez que l’ID du modèle existe, puis intégrez-le.
Q3 : Entre Carbon, Hydrogen et Neon de Gemini 4, comment choisir ?
Choisissez le palier selon la difficulté de la tâche : pour les tâches à longues chaînes de traitement et à haute difficulté, prenez Carbon ; pour les appels quotidiens à haute fréquence où la vitesse compte, prenez Hydrogen ; entre les deux, prenez Neon. Les trois sont sortis respectivement les 10, 12 et 18 novembre, à des prix différents ; je vous conseille de comparer sur un même lot d’échantillons avant de désigner votre modèle principal.
Q4 : `gemini-4-neon` n’apparaît pas dans le tableau récapitulatif, est-ce que cela signifie qu’il n’est pas encore utilisable ?
Il ne faut pas se fier uniquement au tableau récapitulatif. Dans la version du 2026-11-19, `gemini-4-neon` n’était pas présent, mais l’API de tarification donnait déjà le multiplicateur complet, soit après conversion une entrée à `$3 / 1M`, une sortie à `$15 / 1M` et une lecture de cache à `$0.15 / 1M`. Il y a un décalage temporel entre ces deux sources : fiez-vous à l’API de tarification et au résultat d’un petit test réel.
Q5 : Comment appeler rapidement ces nouveaux modèles de novembre via l’API ?
Voici la marche à suivre :
1. Créez un compte sur APIYI apiyi.com, récupérez votre API Key et votre crédit d’essai gratuit pour nouveaux utilisateurs
2. Consultez le tableau récapitulatif des modèles et l’API de tarification pour confirmer l’ID du modèle visé
3. Réglez le `base_url` sur l’adresse compatible OpenAI de la plateforme, puis choisissez chat, messages, responses ou gemini selon le tableau des endpoints ci-dessus
4. Envoyez d’abord une requête courte pour vérifier que tout fonctionne, puis intégrez-le dans votre activité
Q6 : Pour un même Claude Fable 5.2, le prix diffère-t-il entre un appel via chat et via messages ?
Dans la documentation de référence, `claude-fable-5-2` et `claude-fable-5-2-thinking` ont le même prix, à savoir une entrée à `$8 / 1M`, une lecture de cache à `$0.2 / 1M` et une sortie à `$40 / 1M` ; la documentation ne distingue pas les prix par endpoint. Cela dit, pour la comptabilité, je vous conseille quand même d’inclure l’endpoint dans la clé de canal, histoire de faciliter le diagnostic et les vérifications ultérieures.
Q7 : Un point d’entrée unifié est-il forcément moins cher qu’une connexion directe à l’officiel ?
On ne peut pas conclure ainsi. L’intérêt principal d’un point d’entrée unifié, c’est de brancher moins d’API et d’avoir une authentification et une facturation unifiées. Les prix doivent s’examiner canal par canal ; par exemple, le prix de `gemini-4-neon` est identique au tarif affiché par Google. Savoir si vous économisez dépend de la combinaison de modèles et du volume que vous utilisez : il faut faire le calcul soi-même, canal par canal.
Q8 : Quelles limitations connues faut-il anticiper ?
Il y a trois points principaux. Premièrement, certains nouveaux modèles ne sont pas encore disponibles dans le catalogue : par exemple MAI Image 2.7, Kling, Muse et `gemini-4-flash-lite` sont introuvables pour le moment. Deuxièmement, les prix de lancement ont une date limite : le tarif introductif Google associé à Gemini 4 Carbon est valable jusqu’au 30 novembre. Troisièmement, GPT-6.2 Astra applique une tarification par paliers au-delà de 272000 tokens. Dans ces cas, commencez par ajuster votre plan en fonction de la liste de la plateforme, puis revenez modifier le code.
Points clés de l’intégration des nouveaux modèles de novembre
- Vérifiez d’abord le catalogue, puis écrivez le code : fiez-vous au tableau récapitulatif des modèles et à l’API de tarification ; consignez séparément les modèles annoncés et les modèles réellement appelables
- Changer de modèle ne demande que deux ajustements : sous le même base_url, modifiez l’ID du modèle, puis vérifiez le type d’endpoint
- Chaque endpoint doit correspondre au bon type : Gemini utilise chat ou gemini, Claude utilise chat ou messages, et GPT-6.2 Astra passe par responses (recommandé)
- Savoir lire les ratios, c’est savoir calculer le prix :
model_ratio × 2correspond au prix unitaire d’entrée ; multipliez ensuite par les ratios de sortie et de cache - Séparez la facturation par canal : tenez une comptabilité séparée avec pour clé « ID du modèle + endpoint », plutôt que d’appliquer le prix d’un seul fournisseur à l’ensemble
- Attention aux échéances et aux paliers : le prix de lancement de Carbon et le palier de 272000 tokens d’Astra influent tous deux sur le budget
- Pour démarrer : sur APIYI, récupérez un quota gratuit avec une clé API, commencez par les usages courants, puis comparez les modèles entre eux
Récapitulatif : en novembre, les nouveaux modèles arrivent en masse — un seul point d’accès pour changer de modèle, une facturation à lire par canal
Quand les nouveaux modèles se bousculent en novembre, l’essentiel n’est pas de courir après chaque annonce, mais de mettre en place une procédure stable :
- Croiser la liste des modèles : vérifiez à la fois le tableau récapitulatif et l’interface de tarification. Le MAI Image 2.7 dont parlent les actualités n’est pas encore disponible à la vente : ne l’inscrivez pas dans votre plan de mise en production.
- Changer l’ID du modèle et vérifier l’endpoint : un seul
base_urlsuffit pour plusieurs fournisseurs. Choisissez chat, messages, responses ou gemini d’après le tableau de correspondance des endpoints. - Lire la facture par canal : comptez séparément les tokens et les coûts pour chaque modèle et chaque endpoint, tout en surveillant la date de fin du tarif de lancement et les paliers liés au long contexte.
Une fois la procédure fixée, à la prochaine sortie d’un nouveau modèle, il vous suffira d’ajouter une ligne d’ID de modèle dans la configuration et de consulter une fois l’interface de tarification pour boucler l’intégration et l’évaluation des coûts. Nous vous conseillons de commencer sur APIYI apiyi.com avec le crédit gratuit accordé aux nouveaux utilisateurs, afin de faire tourner un premier canal, puis d’ajouter progressivement Gemini 4, Claude Fable 5.2 et GPT-6.2 Astra à votre comparatif.
📚 Références
-
Blog officiel de Google — annonce de Gemini 4 Neon : présentation des modèles de la gamme Gemini 4
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - À savoir : découvrir le positionnement et les dates de sortie de Carbon, Hydrogen et Neon
- Lien :
-
Tableau récapitulatif des modèles et interface de tarification APIYI : sources pour vérifier les modèles et les prix
- Lien : voir la section « modèle annoncé ≠ modèle en rayon » dans le corps de l’article
- À savoir : les versions du tableau récapitulatif et de l’interface de tarification peuvent être désynchronisées ; mieux vaut consulter les deux
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI ; de plus amples documents d’intégration sont disponibles dans le centre de documentation docs.apiyi.com