Note de l’auteur : pour un même Gemini 4 Neon, l’annonce de l’API Gemini et la documentation du modèle Antigravity annoncent des fenêtres de contexte différentes. Cet article sépare les deux chiffres selon le point d’entrée et propose l’ordre de vérification à suivre avant d’inscrire un chiffre de fenêtre dans un plan d’agent.
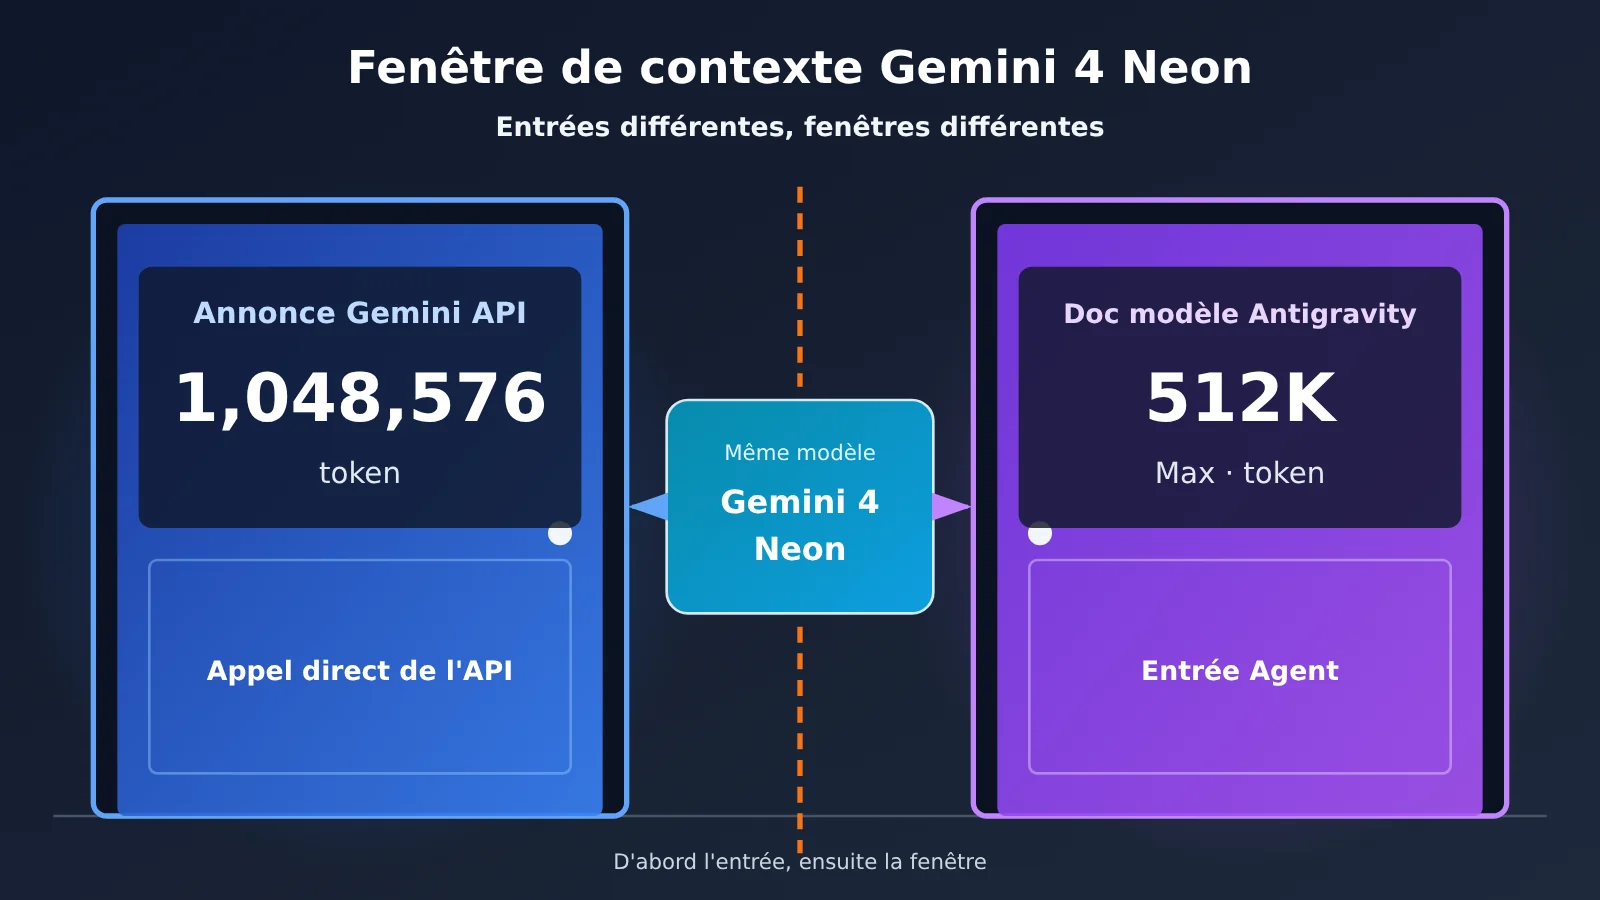
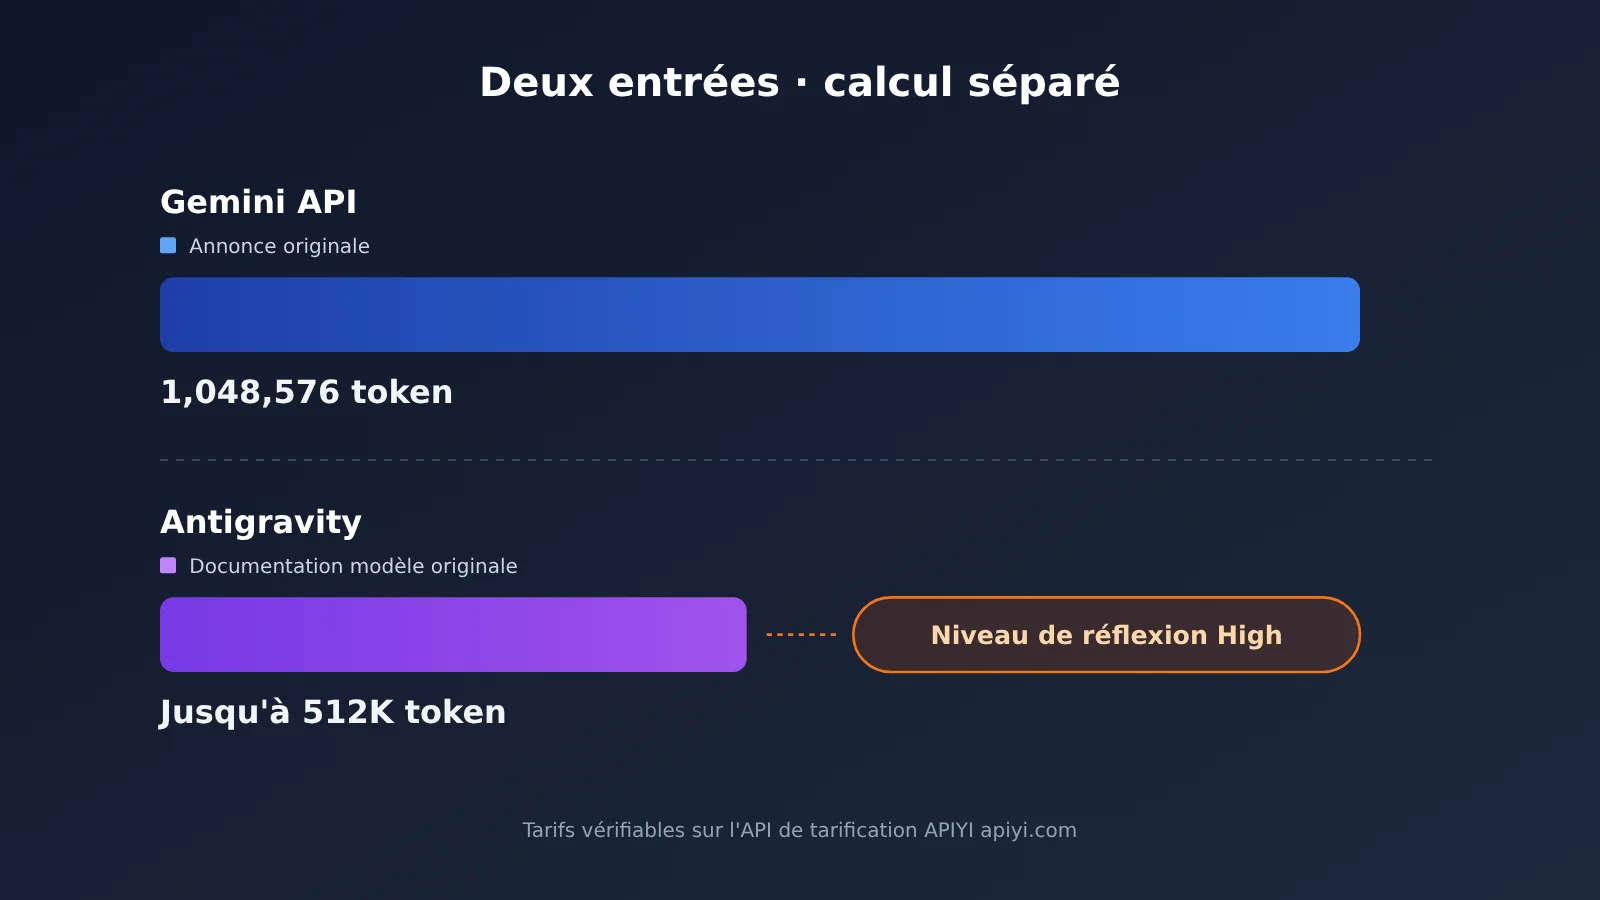
Les équipes qui construisent des agents inscrivent souvent la fenêtre de contexte affichée sur la page marketing directement dans leur plan, du genre « Neon supporte 1M, on met tout le dépôt de code d’un coup ». À l’époque du Gemini 4 Neon, ce raccourci devient risqué. L’annonce de l’API Gemini indique 1 048 576 tokens, tandis que la documentation du modèle Antigravity parle d’un maximum de 512K tokens : les deux chiffres viennent de Google, ont été publiés la même semaine, et aucune des deux pages ne cite l’autre.
Ce n’est pas qu’un camp se soit trompé. Les deux décrivent deux surfaces d’appel distinctes : l’une est l’API qui appelle le modèle directement, l’autre est le point d’entrée Agent dans Antigravity. Le chiffre à retenir dans votre plan dépend de l’endroit d’où part réellement votre requête.
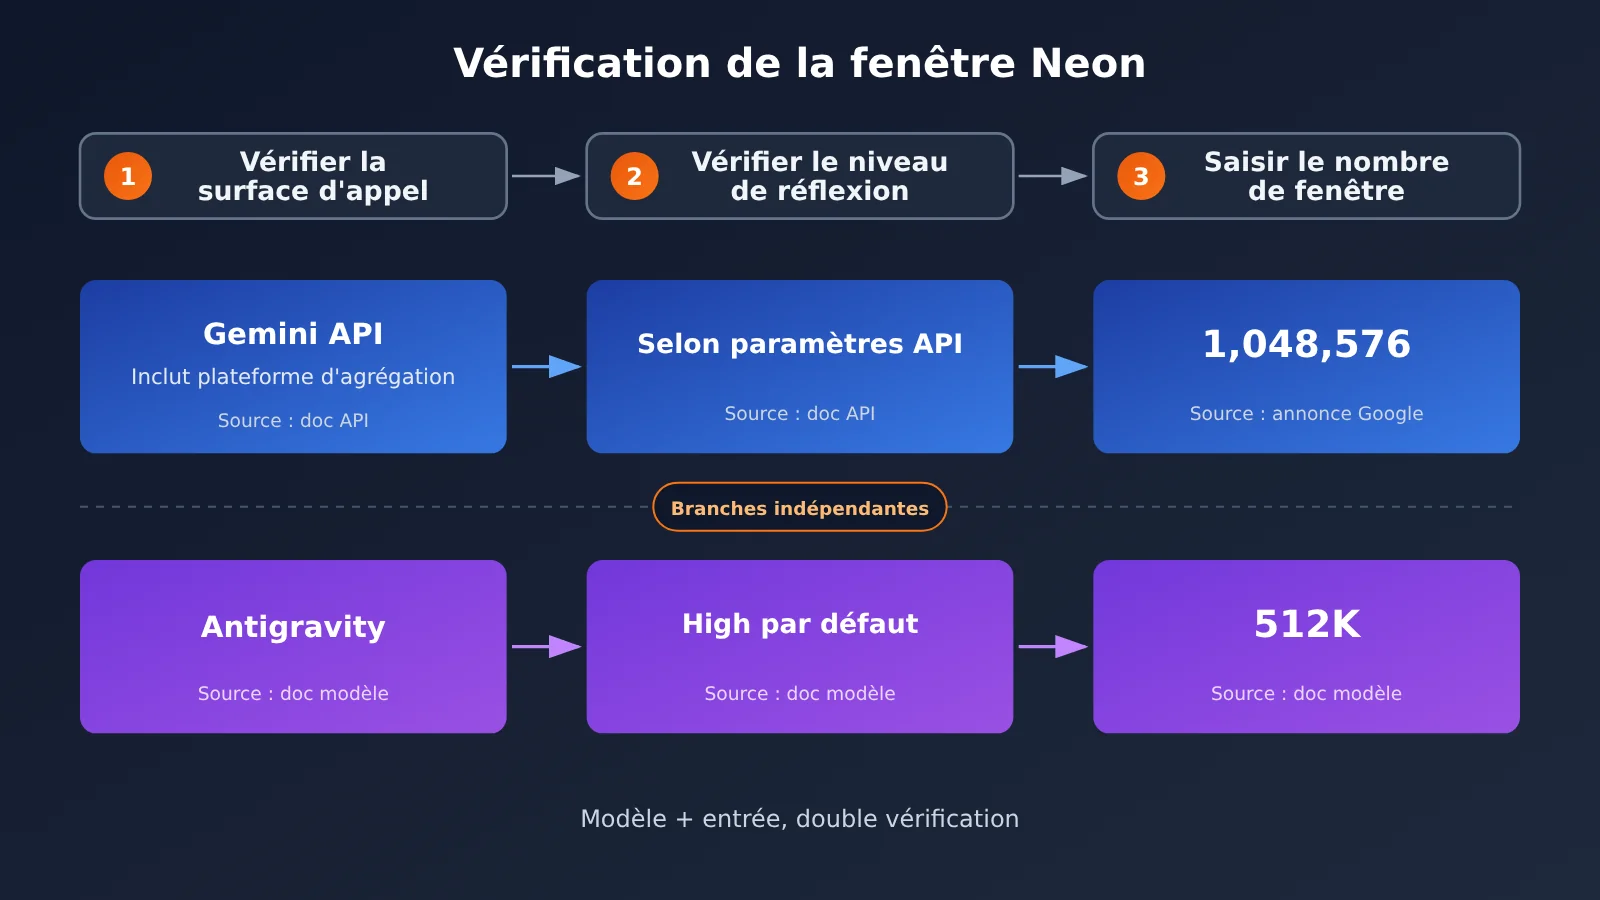
L’essentiel : après avoir lu cet article, vous saurez d’où viennent chacun des deux chiffres de fenêtre du Gemini 4 Neon, et vous aurez en main l’ordre de vérification « d’abord identifier le point d’entrée, ensuite regarder le niveau de réflexion, enfin écrire la fenêtre ». En suivant cet ordre, vous ne planifierez pas avec 1M un point d’entrée qui ne donne que 512K.
Points clés de la fenêtre de contexte de Gemini 4 Neon
Commençons par rassembler dans un tableau les faits confirmables à partir des documents de référence. Les chiffres du tableau sont ceux des documents originaux ; il ne s’agit ni d’extrapolations ni de résultats de tests.
| Point | Texte du document | Conséquence pour le plan |
|---|---|---|
| Fenêtre de l’API Gemini | Annonce Google du 18 novembre 2026 : contexte unifié de Neon à 1,048,576 tokens |
Limite de planification pour les appels directs à l’API |
| Fenêtre Antigravity | Documentation des modèles Antigravity : contexte de Gemini 4 Neon jusqu’à 512K tokens |
Limite de planification pour exécuter un agent dans Antigravity |
| Niveau de réflexion | La documentation Antigravity indique Low, Medium, High (par défaut), Extra | High est la valeur par défaut : à vérifier avant toute estimation |
| Relation entre les deux documents | Publiés la même semaine, les pages ne se citent pas entre elles | On ne peut pas déduire un chiffre à partir de l’autre |
| Tarification de l’API | Entrée $3, entrée mise en cache $0.15, sortie $15 (par million de tokens) |
L’estimation des coûts se base sur le point d’entrée API |
Pourquoi les deux chiffres de Gemini 4 Neon sont corrects
1M et 512K viennent tous deux de Google officiel, simplement inscrits sur des pages différentes. L’annonce de l’API Gemini décrit le contexte unifié du modèle sur l’API, avec la mention 1,048,576 tokens. La documentation des modèles Antigravity décrit le contexte de Neon dans le produit Antigravity, avec la mention « jusqu’à 512K tokens ». Les deux pages décrivent deux surfaces différentes, chacune valable dans son cadre : elles ne sont donc pas contradictoires.
OrcaRouter, dans un article du 19 novembre 2026, a explicitement signalé cet écart. L’article mentionne aussi que l’utilisateur @kimmonismus a publié le 18 novembre une trace d’appels d’outils. Il s’agit d’une publication tierce, pas d’une explication de Google sur la fenêtre : elle ne doit pas être citée comme spécification de la fenêtre. Lorsque vous rédigez un plan, ne retenez comme chiffres de fenêtre que les pages de documentation de Google elles-mêmes, et précisez toujours de quelle page il s’agit.
Ne mélangez pas les fenêtres de Gemini 4 Neon avec celles des autres modèles de la même série
Un autre piège fréquent consiste à emprunter un chiffre d’un modèle à l’autre. La page du modèle Gemini 4 Carbon indique elle aussi un contexte de 1,048,576, mais il s’agit de la fenêtre de Carbon sur l’API, et on ne peut pas la transposer à Neon dans Antigravity. De même, la fenêtre API de Neon ne s’applique pas directement à Neon dans Antigravity. Un chiffre doit correspondre à la fois au modèle et au point d’entrée ; si l’une de ces deux dimensions manque, la vérification n’est pas terminée.
Comparaison des deux points d’entrée de Gemini 4 Neon
Le tableau ci-dessous décompose les deux surfaces. La colonne « Recommandation de planification » indique une pratique conseillée au moment de rédiger un plan, pas une spécification issue de la documentation.
| Dimension | API Gemini (y compris l’interface d’agrégation compatible OpenAI) | Antigravity |
|---|---|---|
| Fenêtre selon le texte source | 1,048,576 tokens (annonce Google) |
jusqu’à 512K tokens (documentation du modèle) |
| Source | Gemini API / annonce Google du 2026-11-18 | antigravity.google/docs/models |
| Niveaux de réflexion | se référer aux paramètres de la documentation API | Low, Medium, High (par défaut), Extra |
| Mode de facturation | facturation au token, avec un tarif d’entrée mis en cache | selon les règles produit d’Antigravity |
| Recommandation de planification | on peut concevoir une requête unique pour un contexte long, mais garder de la marge | concevoir pour 512K ; les tâches longues doivent être découpées et compressées |
Analyse comparative du point d’entrée API : en appelant directement l’API, la fenêtre est plus grande, ce qui convient pour injecter d’un coup un gros lot de documents, un long journal ou un bloc de code entier à analyser. Une grande fenêtre ne signifie toutefois pas qu’il faut la remplir à chaque fois : plus l’entrée est longue, plus le coût et la latence augmentent. En comparaison, considérer l’API comme le point d’entrée « je lis tout le matériel long en une fois », combiné au tarif d’entrée mis en cache, convient mieux au traitement par lots hors ligne et à l’analyse de gros extraits après recherche.
Analyse comparative du point d’entrée Antigravity : Antigravity est orienté workflows d’agents, et la documentation indique une fenêtre allant jusqu’à 512K. Un agent accumule sans cesse son historique au fil des appels d’outils, si bien que l’espace réellement disponible se consume plus vite que sur une requête unique. Pour les équipes qui exécutent de longues tâches dans Antigravity, il est plus prudent de concevoir pour 512K avec des stratégies de découpage, de résumé et d’éviction du contexte, plutôt que d’estimer sur la base de 1M.
Les niveaux de réflexion de Gemini 4 Neon dans Antigravity
La documentation d’Antigravity liste quatre niveaux de réflexion, le niveau par défaut étant High. Beaucoup de gens ne remarquent pas cette valeur par défaut et établissent leur budget directement sur la limite haute de la fenêtre. Le tableau ci-dessous récapitule les recommandations de planification par niveau ; les noms de niveaux et les valeurs par défaut proviennent de la documentation, la partie « recommandation » relevant de pratiques générales.
| Niveau de réflexion | Mention dans la documentation | Recommandation de planification |
|---|---|---|
| Low | optionnel | adapté aux chaînes courtes et aux appels d’outils à forte déterminisme |
| Medium | optionnel | adapté au codage courant et à la recherche multi-étapes |
| High | par défaut | sans modification des réglages, c’est ce niveau qui s’applique ; à prendre comme base d’estimation budgétaire |
| Extra | optionnel | adapté aux problèmes difficiles ; prévoir davantage de marge et de temps d’attente |
Le niveau de réflexion influe sur le coût d’inférence et le temps de réponse ; la façon exacte dont il est comptabilisé dans le contexte et la facturation dépend de la documentation d’Antigravity. Lors de la vérification, commencez par confirmer le niveau réellement utilisé par l’équipe, en particulier le High par défaut, avant de décider de l’espace à réserver à chaque tour pour l’historique et le matériel de recherche.
Démarrage rapide avec Gemini 4 Neon
Étape 1 : identifier la surface que vous appelez
Commencez par répondre à une question simple : d’où part réellement la requête ? Si vous envoyez des requêtes via un SDK dans votre code, vous passez par la surface API, et la fenêtre se planifie sur 1,048,576. Si vous faites travailler un Agent dans Antigravity, vous passez par la surface Antigravity, avec une fenêtre allant jusqu’à 512K. Si vous utilisez les deux dans un même projet, rédigez votre document d’architecture en deux sections distinctes — ne fusionnez pas tout en un seul chiffre.
Deuxième étape : envoyer une requête via l’interface compatible OpenAI
En passant par l’API, vous pouvez appeler Neon via l’interface compatible OpenAI d’APIYI, avec l’ID de modèle gemini-4-neon. Un appel minimaliste ne demande que trois réglages :
- Créer le client :
client = OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1") - Spécifier le modèle :
model="gemini-4-neon" - Envoyer le message :
client.chat.completions.create(model="gemini-4-neon", messages=[{"role": "user", "content": "总结这份日志"}])
Une fois la réponse reçue, lisez response.usage.prompt_tokens et response.usage.completion_tokens pour connaître la consommation réelle de cette requête. C’est cette valeur de retour qui doit servir de référence pour dimensionner votre fenêtre, pas une estimation au nombre de caractères.
Voir l’approche complète pour les appels segmentés
Quand un document long dépasse le budget que vous vous êtes fixé pour un seul appel, vous pouvez procéder par étapes selon l’approche suivante :
1. Initialisation : `client = OpenAI(api_key= »YOUR_API_KEY », base_url= »https://api.apiyi.com/v1″)`
2. Définir le budget : côté API, vous pouvez fixer `budget = 1048576 * 0.7` ; si la même logique doit être réutilisée côté Antigravity, passez à sept dixièmes de 512K
3. Découper le document : découpez le document en `chunks` par chapitre ou par fichier, puis faites un essai sur chaque bloc avec `usage.prompt_tokens` pour noter sa longueur réelle
4. Résumer par segment : appelez `model= »gemini-4-neon »` pour chaque chunk en demandant un résumé au format fixe
5. Fusionner et raisonner : assemblez tous les résumés dans un nouveau `messages`, puis faites une synthèse ou une prise de décision
6. Suivre la consommation : écrivez `prompt_tokens` et `completion_tokens` dans les logs à chaque tour, pour pouvoir vérifier les coûts a posteriori
Les sept dixièmes du budget ne sont qu’une pratique empirique pour garder une marge, ce n’est pas une règle imposée par la documentation : vous pouvez l’ajuster selon la tâche.
🚀 Démarrage rapide : avant de concevoir votre solution, vous pouvez d’abord vous inscrire sur APIYI apiyi.com et récupérer un quota de test gratuit, puis lancer
gemini-4-neonsur un document réel et définir votre budget de fenêtre à partir des valeursusageretournées.
Étape 3 : vérifier le modèle et le prix
Il existe deux points d’entrée pour vérifier les prix : le tableau récapitulatif des modèles d’APIYI, https://docs.apiyi.com/models.md, et l’endpoint de tarification https://api.apiyi.com/api/pricing. Lors de la vérification du 20/11/2026, la dernière mise à jour du tableau récapitulatif datait du 19/11/2026 à 10:59 (UTC+8), et cette version n’avait pas encore intégré gemini-4-neon ; l’endpoint de tarification (version shell-api-modelmak-v1) le contenait déjà. Pour consulter le prix de Neon, fiez-vous à l’endpoint de tarification.
Dans l’endpoint de tarification, un model_ratio de 1 correspond à une entrée de $2 par million de tokens. Pour gemini-4-neon, model_ratio vaut 1.5, completion_ratio vaut 5 et cache_ratio vaut 0.05, ce qui donne après conversion $3 en entrée, $15 en sortie et $0.15 en lecture de cache, conformément au tarif affiché par Google.
| Modèle | Entrée ($/million de tokens) | Lecture du cache | Sortie | Remarque |
|---|---|---|---|---|
gemini-4-neon |
3 |
0.15 |
15 |
Conforme au tarif Google, se référer à l’endpoint de tarification |
gemini-4-carbon |
2 |
0.1 |
10 |
Correspond au tarif de lancement de Google jusqu’au 30/11/2026 |
gemini-4-hydrogen |
1.5 |
0.075 |
7.5 |
Endpoint de tarification |
gemini-4-argon |
2 |
0.1 |
10 |
Tableau récapitulatif des modèles |
| Plateformes disponibles | APIYI, API officielle Google | — | — | Adresse d’appel https://api.apiyi.com/v1 |
Un point à surveiller pour Carbon : depuis le 1er décembre, le tarif standard de Google est de $4 en entrée et $20 en sortie, tandis que le tarif de lancement ne s’applique que jusqu’au 30/11/2026. Un budget qui chevauche ce changement de mois doit donc être calculé en deux segments.
💡 Conseil de choix : pour une même tâche, vous pouvez d’abord lancer une passe avec
gemini-4-neon, puis une avecgemini-4-hydrogen, et comparer les résultats ainsi que l’usage. APIYI fournit une interface unifiée compatible OpenAI : pour changer de modèle, il suffit de modifier le paramètremodel.
Comment intégrer le budget de contexte de Gemini 4 Neon dans un document de plan
Une fois l’entrée et le niveau de réflexion confirmés, vous pouvez inscrire les chiffres de fenêtre dans le plan. Voici quelques pistes de planification pour les tâches d’agent courantes. Dans le tableau, la colonne « Stratégie recommandée » décrit une pratique d’ingénierie, pas une spécification documentaire.
| Type de tâche | Entrée | Plafond de planification (texte du document) | Stratégie recommandée |
|---|---|---|---|
| Analyse de code sur tout le dépôt | API | 1,048,576 token |
Récupérer d’abord les fichiers concernés, puis envoyer le bloc entier en gardant de la marge |
| Débogage de longs journaux | API | 1,048,576 token |
Découper par fenêtre temporelle, réutiliser le préfixe répété via l’entrée en cache |
| Refactorisation multi-tours dans l’IDE | Antigravity | Jusqu’à 512K token |
Résumer régulièrement l’historique, éliminer les anciennes sorties d’outils |
| Tâches longues d’agent multi-outils | Antigravity | Jusqu’à 512K token |
Découper en sous-tâches, écrire une mémoire structurée à la fin de chaque segment |
| Réutilisation d’un même processus sur les deux entrées | Les deux | Prendre 512K comme plafond commun |
Concevoir sur la petite fenêtre, pour que ça tourne aussi directement côté API |
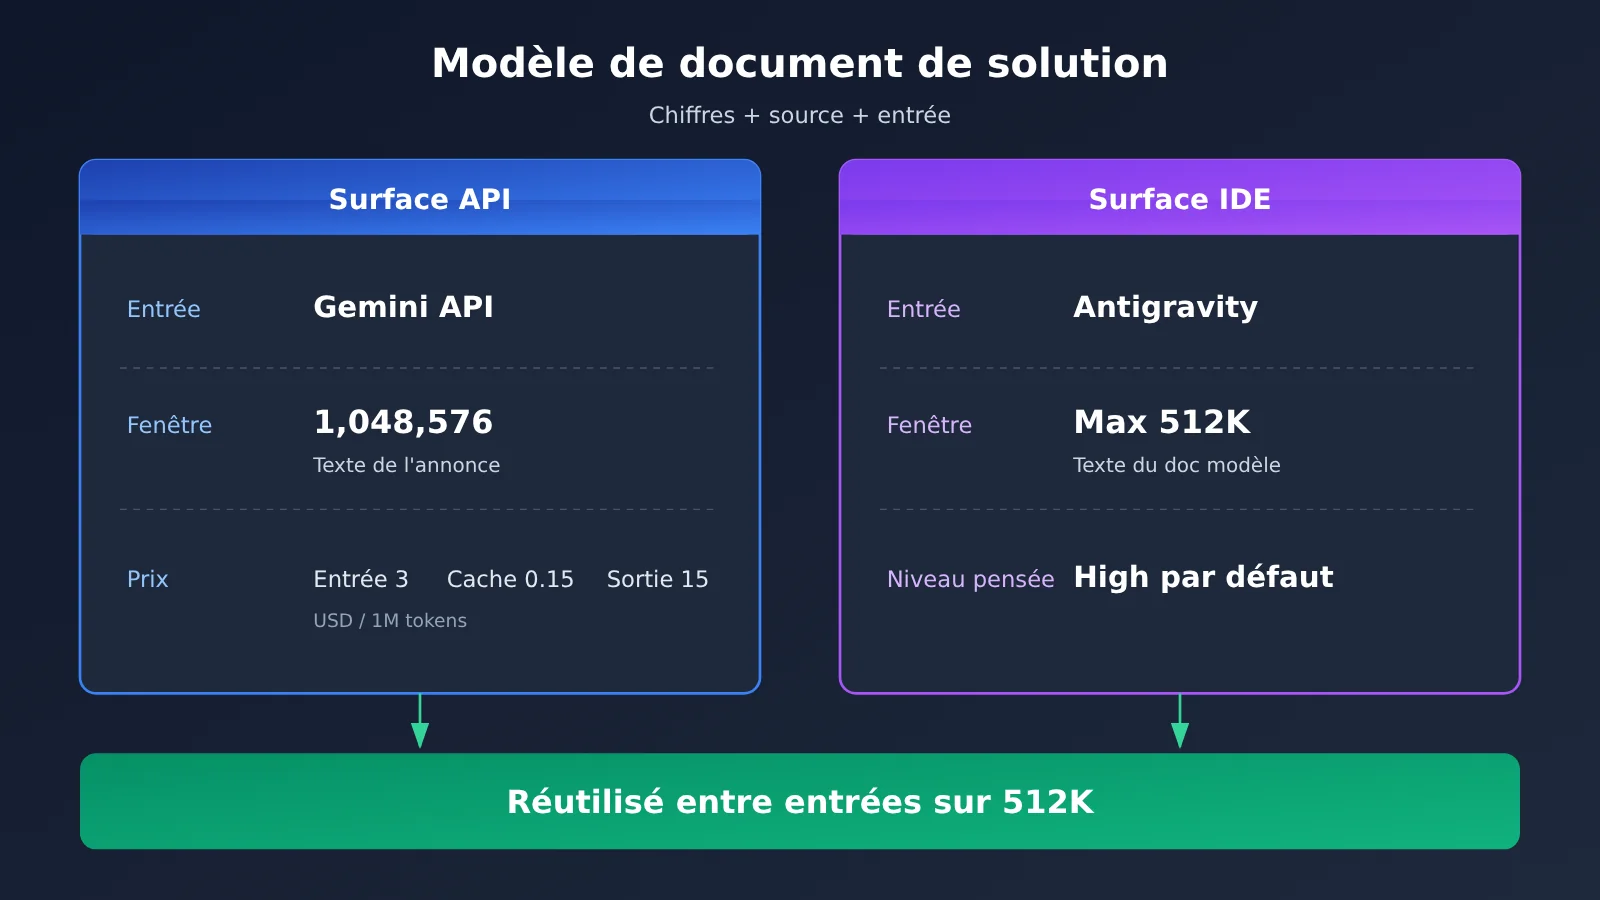
C’est la dernière ligne qu’on oublie le plus facilement. Si la même logique d’agent doit tourner à la fois dans Antigravity et via l’API, la démarche la plus sûre consiste à concevoir le processus commun sur 512K. Il fonctionnera alors directement sur l’API aussi, simplement sans exploiter toute la fenêtre. À l’inverse, si vous concevez sur 1M, il faudra réécrire la logique de segmentation en arrivant sur Antigravity.
Quand vous inscrivez les chiffres de fenêtre dans le plan, mieux vaut adopter le format « chiffre + source + entrée », par exemple « Documentation du modèle Antigravity : Gemini 4 Neon jusqu’à 512K token, niveau de réflexion par défaut High ». En revue, on voit d’un coup d’œil à quelle surface correspond ce chiffre, et lors des mises à jour ultérieures de la documentation, la vérification point par point reste simple.
Questions fréquentes (FAQ)
Q1 : quelle est vraiment la longueur de contexte de Gemini 4 Neon ?
Tout dépend du point d’entrée. L’annonce Gemini API / Google du 2026-11-18 indique un contexte unifié de `1,048,576` tokens ; la documentation du modèle Antigravity annonce un maximum de `512K` tokens. Les deux sont des textes officiels de Google, chacun correspondant à une surface d’appel différente.
Q2 : le 1M de l’API et le 512K d’Antigravity entrent-ils en conflit ?
Non. Les deux documents décrivent des surfaces produit différentes, publiées la même semaine, sans renvoi de page à page. Le conflit n’apparaît que dans vos plans : si vous prenez le chiffre de l’API pour planifier une tâche dans Antigravity, ça pose problème.
Q3 : les traces d’appels d’outils partagées en ligne peuvent-elles servir de référence pour la fenêtre ?
Non. L’article d’OrcaRouter du 2026-11-19 précise que le journal d’appels d’outils publié par @kimmonismus le 18 novembre est un post tiers, pas une explication de Google sur la fenêtre. Pour les chiffres de fenêtre, on ne cite que les annonces et les pages de documentation de Google.
Q4 : Carbon affiche aussi `1,048,576`, peut-on l’appliquer au Neon d’Antigravity ?
Non. Le `1,048,576` de la page du modèle Carbon est la fenêtre API de Carbon. Modèle différent, point d’entrée différent : sur les deux dimensions, ça ne correspond pas, et le Neon dans Antigravity reste à planifier selon le maximum de 512K indiqué dans sa documentation modèle.
Q5 : comment appeler rapidement Gemini 4 Neon via l’API ?
1. S’inscrire sur APIYI apiyi.com et récupérer une clé API ainsi qu’un quota d’essai gratuit
2. Régler le `base_url` du SDK sur `https://api.apiyi.com/v1`
3. Renseigner le modèle `gemini-4-neon`, puis lire le champ `usage` pour vérifier la consommation réelle
Vous passez ainsi par la surface API : la fenêtre se planifie selon les `1,048,576` tokens annoncés par Google.
Q6 : gemini-4-neon n’apparaît pas dans le tableau général des modèles, quel prix fait référence ?
Fiez-vous à l’endpoint de tarification. La version du tableau général datée du 2026-11-19 n’inclut pas encore ce modèle, mais l’endpoint de tarification le propose déjà : après conversion, entrée `$3`, lecture de cache `$0.15`, sortie `$15`, ce qui correspond aux tarifs affichés par Google. Pour vérifier, il suffit d’interroger l’endpoint de tarification d’APIYI apiyi.com.
Q7 : le niveau de réflexion par défaut d’Antigravity influence-t-il la planification ?
Oui. La documentation indique que le niveau par défaut est High : sans modifier les réglages, le modèle tourne à ce niveau. Le niveau de réflexion influe sur le coût d’inférence et le temps de réponse, il faut donc estimer le budget selon le niveau réellement utilisé ; la façon exacte dont c’est comptabilisé dépend de la documentation Antigravity.
Q8 : quelles limites faut-il garder en tête avec Gemini 4 Neon ?
– La fenêtre varie selon le point d’entrée, il n’existe pas de chiffre universel
– Les entrées longues font grimper le coût et la latence ; une grande fenêtre ne signifie pas qu’il faut la remplir à chaque fois
– La documentation peut évoluer : dans vos plans, indiquez la source des chiffres et la date de vérification
Gemini 4 Neon : les points clés
- Les deux chiffres viennent bien des documents officiels : l’annonce API indique
1,048,576tokens, la documentation Antigravity plafonne à 512K tokens - Identifier d’abord l’entrée, ensuite écrire le chiffre : on cite la documentation de la surface depuis laquelle la requête part
- Le niveau de réflexion par défaut est High : dans Antigravity, si vous ne touchez pas aux réglages, c’est High — donc on budgète sur cette base
- Les posts de tiers ne valent pas spécification : les traces d’appels d’outils ne remplacent pas l’explication de Google sur la fenêtre
- Les fenêtres ne se prêtent pas entre modèles : la fenêtre API de Carbon ne s’applique pas au Neon d’Antigravity
- Pour un usage multi-entrées, on calibre sur la petite fenêtre : un pipeline qui tourne des deux côtés se conçoit sur 512K
- Vérifier le prix via l’interface de tarification : appelez
gemini-4-neonvia APIYI et calibrez votre budget avec le champusage
En résumé
Les points essentiels pour planifier le contexte de Gemini 4 Neon :
- L’entrée détermine la fenêtre : côté API on retient
1,048,576tokens, côté Antigravity 512K maximum, chaque chiffre avec sa source - Un ordre de vérification fixe : d’abord l’entrée, puis la valeur par défaut du niveau de réflexion, et seulement ensuite on inscrit le nombre de tokens dans le plan
- Calibrer sur l’usage réel : fiez-vous au champ
usageretourné, et maîtrisez les coûts avec du découpage, des résumés et de la mise en cache des entrées
Quand vous rédigez un plan d’agent, traitez « chiffre + source + entrée » comme un tout : vous éviterez ainsi de planifier 1M sur une entrée limitée à 512K. Je vous conseille de faire tourner gemini-4-neon via APIYI apiyi.com sur un cas réel, puis de figer votre plan une fois les données d’usage en main — la plateforme propose un quota gratuit et une interface unifiée pour plusieurs modèles.
📚 Références
-
API Gemini / annonce Google (2026-11-18) : contexte unifié et tarification API de Gemini 4 Neon
- Précision : source originale de la fenêtre de
1,048,576tokens ainsi que des prix d’entrée, d’entrée mise en cache et de sortie
- Précision : source originale de la fenêtre de
-
Documentation des modèles Antigravity : contexte et niveaux de réflexion de Gemini 4 Neon dans Antigravity
- Lien :
antigravity.google/docs/models - Précision : source du maximum de 512K tokens et des niveaux de réflexion Low, Medium, High (par défaut) et Extra
- Lien :
-
Article OrcaRouter (2026-11-19) : met en évidence l’écart entre les chiffres de fenêtre des deux documents
- Précision : explique également que les journaux d’appels d’outils tiers ne peuvent pas servir de description de la fenêtre
-
Tableau général des modèles et interface de tarification APIYI : point d’entrée pour vérifier les modèles et les prix
- Précision : voir les deux adresses de la section « Troisième étape : vérifier le modèle et le prix » ci-dessus ; pour
gemini-4-neon, c’est l’interface de tarification qui fait référence
- Précision : voir les deux adresses de la section « Troisième étape : vérifier le modèle et le prix » ci-dessus ; pour
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com