Note de l’auteur : pour les développeurs qui, après avoir vu la démo d’animation Three.js de Gemini 4 Neon, ont envie de s’y mettre, le premier problème à régler n’est pas la rédaction de l’invite, mais la maîtrise de la facture. Cet article propose une méthode d’expérimentation : « d’abord fixer les critères d’acceptation, puis limiter le nombre d’essais, puis choisir le niveau de réflexion ».
Récemment, un clip d’animation Three.js de 15 secondes a beaucoup circulé dans le milieu des développeurs. Son auteur affirme qu’il a été réalisé par Gemini 4 Neon uniquement avec three.js. Beaucoup, après l’avoir vu, ont d’abord eu envie de « tenter le même truc ». Mais une fois lancés, ils découvrent que c’est justement une expérimentation créative sans critères d’acceptation qui fait le plus facilement exploser le budget à force de recommencer.
Ce n’est pas un article qui vous apprend à reproduire ce clip, mais un guide pratique pour vous aider à garder le contrôle sur les coûts d’une expérimentation avec Gemini 4 Neon. Le clip lui-même ne publie aucune donnée de tokens ; nous ne donnerons donc pas, et nous ne pouvons pas donner, un montant en dollars pour celui-ci.
L’essentiel : après avoir lu cet article, vous saurez pourquoi on ne peut pas déduire les coûts à partir du résultat final, comment écrire des critères d’acceptation avant de vous lancer, limiter le nombre d’essais et le niveau de réflexion, et pourquoi les coûts d’une même invite dans l’API et dans Antigravity ne peuvent pas être estimés en les mélangeant.
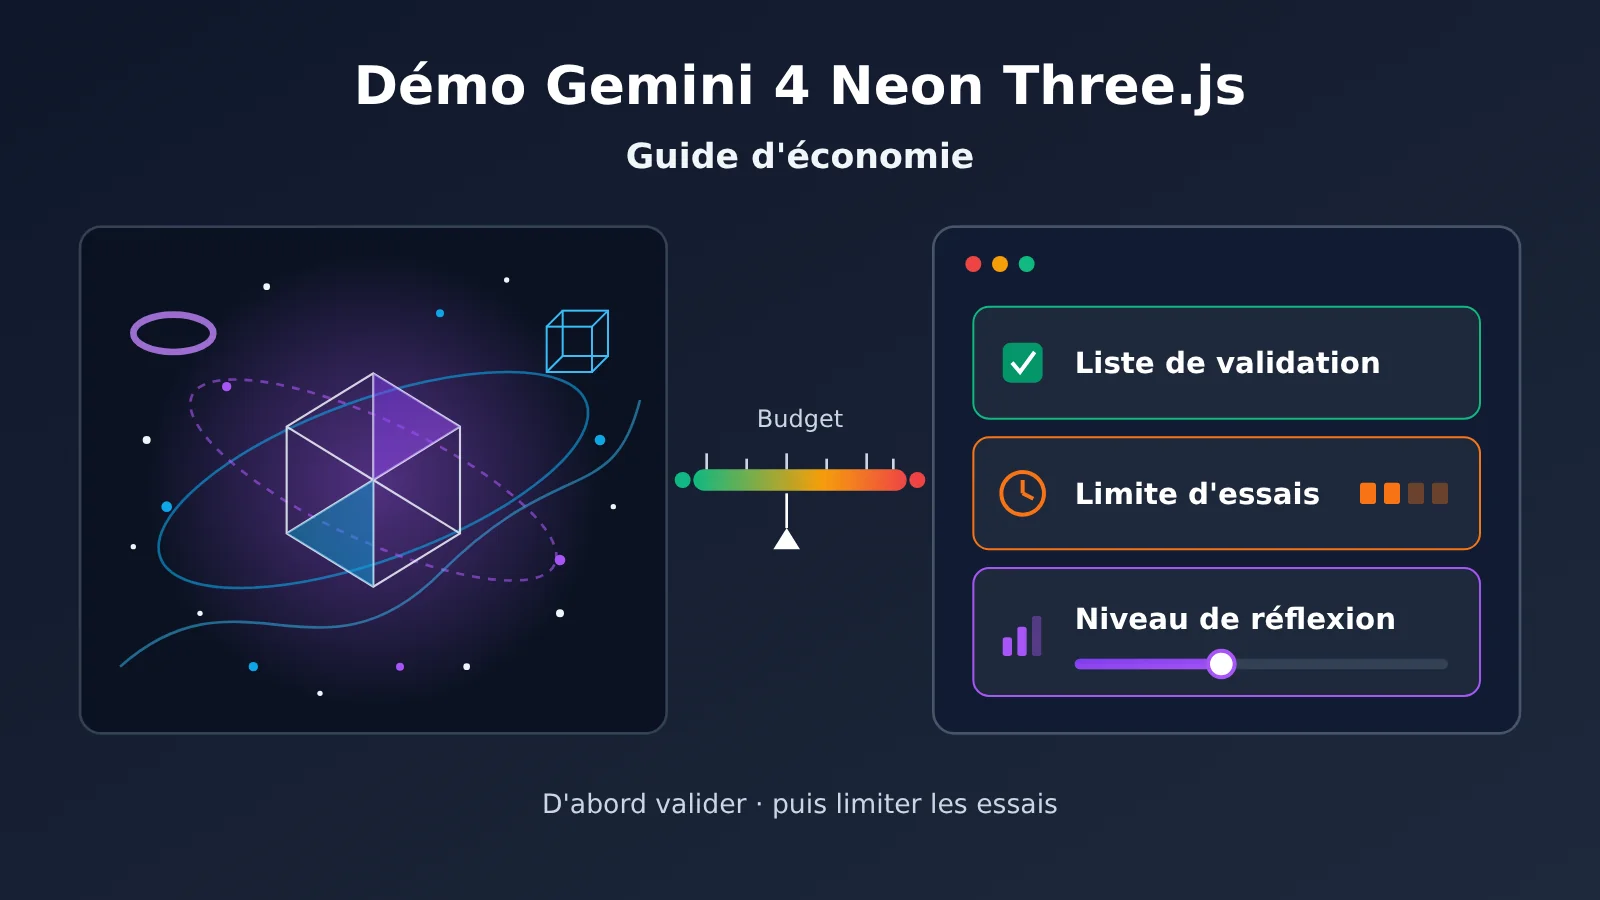
Démo Gemini 4 Neon Three.js : les points clés pour économiser
| Point clé | Explication | Intérêt |
|---|---|---|
| Le rendu final ne permet pas de déduire le coût | Cette vidéo de 15 secondes ne fournit ni invite, ni fichiers sources, ni niveau de réflexion, ni nombre de tokens | Éviter de prendre l’œuvre de quelqu’un d’autre comme base budgétaire |
| Écrire d’abord les critères d’acceptation | Avant de commencer, décomposer « ce qui compte comme réussite » en éléments vérifiables | Savoir à chaque tour s’il faut continuer ou non |
| Limiter le nombre d’essais | Fixer un nombre maximal de tours par critère d’acceptation ; en cas de dépassement, changer d’approche | Éviter les recommencements sans fin |
| Choisir le niveau de réflexion selon le besoin | Les tokens de réflexion sont facturés comme des tokens de sortie ; plus le niveau est élevé, plus la sortie augmente | Cela influe directement sur le poste le plus lourd de la facture |
| Fenêtre de contexte variable selon le point d’entrée | Environ 1M de fenêtre de contexte avec l’API Gemini, jusqu’à 512K avec Antigravity | Les coûts des différents points d’entrée ne peuvent pas être mélangés |
Pourquoi on ne peut pas déduire le coût d’une vidéo de 15 secondes de Gemini 4 Neon
D’après la synthèse d’OrcaRouter du 19 novembre 2026, cette vidéo a été publiée par @chetaslua le même jour à 16:51 UTC. Ses caractéristiques : 15 secondes, 1920×1080. L’auteur du post affirme qu’il s’agit d’un motion design réalisé par Gemini 4 Neon uniquement avec three.js. Mais le post ne contient ni invite, ni fichiers sources, ni indication du niveau de réflexion utilisé, ni nombre de tokens. Il ne précise même pas si le rendu a été exécuté dans l’API, AI Studio ou Antigravity.
Cela signifie que « Gemini 4 Neon a réalisé cette vidéo » n’est qu’une attribution de l’auteur, pas une mesure. Vous ne savez pas combien de tours il a fallu, ni combien de modifications humaines ont été apportées en cours de route, ni quelle part de la sortie correspond à des tokens de réflexion. Estimer « combien je vais probablement payer » à partir d’un tel résultat peut donner une erreur de plusieurs ordres de grandeur.
Les démos officielles de Gemini 4 Neon par Google ne fournissent pas non plus de facture
Et ce n’est pas seulement le cas des œuvres de la communauté. Dans son annonce de lancement du 18 novembre 2026, Google a présenté un simulateur de ski, le « Turing Study », un tableau à 100 000 cellules et un banc d’essai Blender MCP, sans publier non plus de facture de tokens. Le parkour 3D de Shibuya, dans la publication officielle de Google sur X du 19 novembre, mentionne l’utilisation de données OpenStreetMap représentant près d’un million de tokens. Il s’agit d’une taille d’entrée déclarée par Google, pas d’une facture complète ; les sorties et la réflexion restent inconnues.
L’annonce cite également des classements tiers : l’Artificial Analysis Intelligence Index affiche 61 au niveau xhigh et se classe 3e au classement général ; le Vals Index se classe 2e avec un score de 70,9 %. Ce sont des classements tiers cités dans l’annonce de Google : ils indiquent un positionnement en termes de capacités et ne contiennent pas non plus d’information sur « combien coûte la réalisation d’une démo ». Les démos et les scores peuvent vous aider à juger si cela vaut la peine d’essayer, mais ils ne peuvent pas établir un budget à votre place.
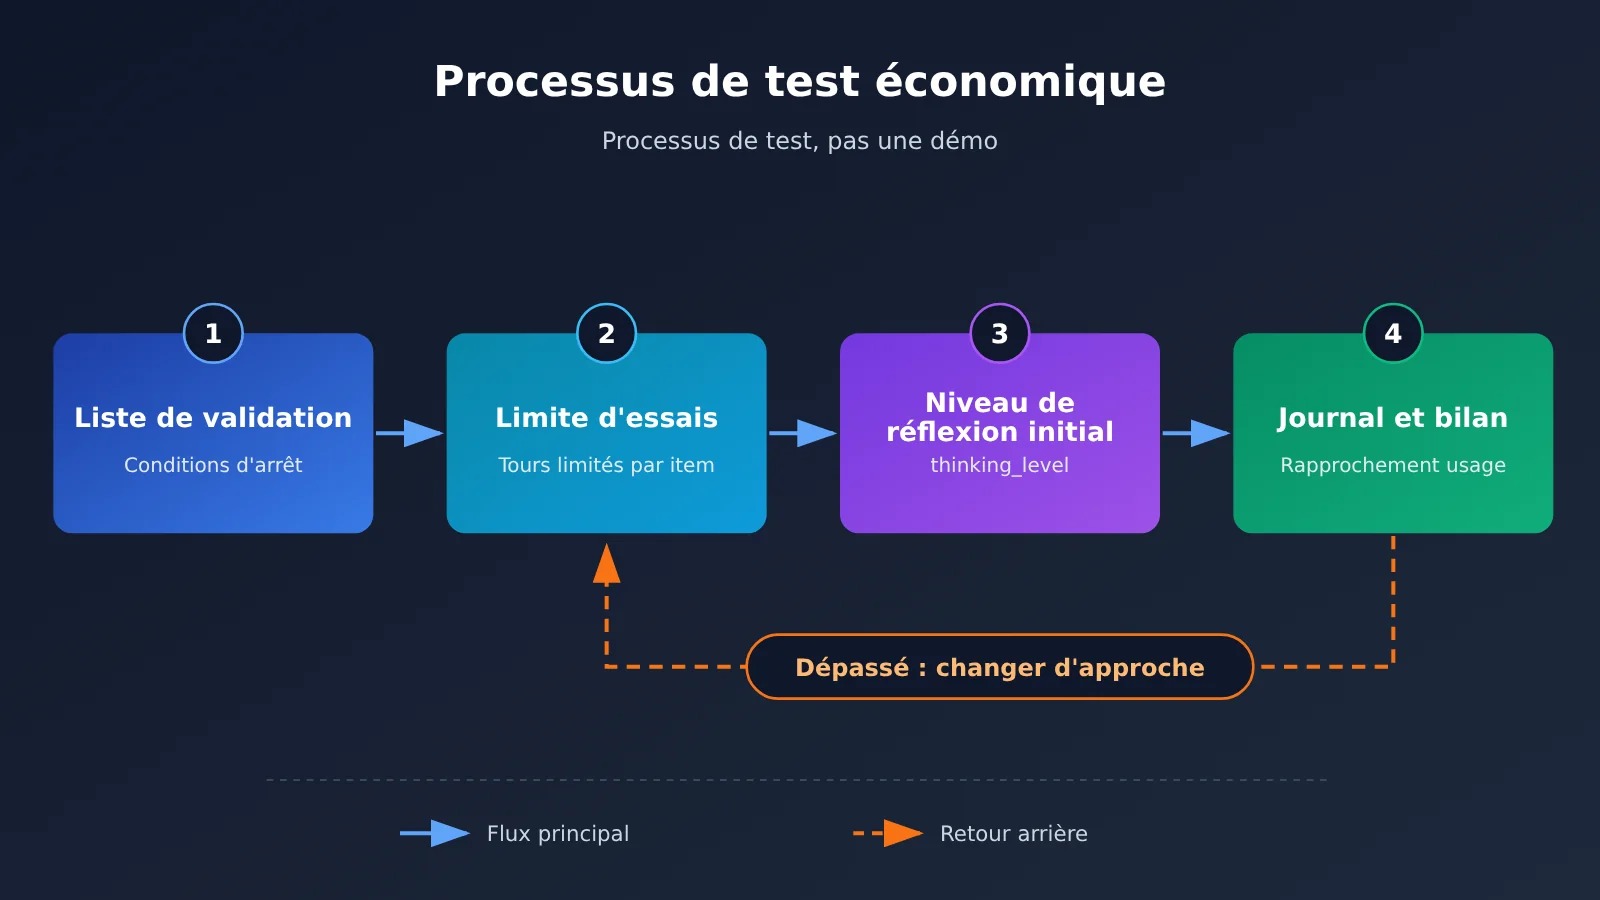
Démo Gemini 4 Neon Three.js : écrire les critères d’acceptation avant de se lancer
Le plus gros piège de coût dans une tâche créative, c’est le « il manque juste un petit quelque chose ». Sans critères, on trouve toujours un défaut à chaque nouvelle version, et on recommence sans fin. Écrire les critères d’acceptation dès le départ, c’est en fait se donner une condition d’arrêt : chaque appel a un résultat clairement validé ou rejeté.
Les critères d’acceptation doivent être autant que possible vérifiables, et éviter les termes subjectifs du type « joli » ou « avec du caractère ». Voici une manière de décomposer les critères pour un test de graphisme animé avec Three.js :
| Critère d’acceptation | Formulation vérifiable | Formulation à éviter |
|---|---|---|
| Exécution | Un seul fichier HTML, s’ouvre dans le navigateur sans erreur | Tant que ça tourne |
| Dépendances | Uniquement three.js, sans autre bibliothèque d’animation | Limiter les dépendances |
| Durée et rythme | Durée de boucle d’environ 15 secondes, en trois plans | Bon rythme |
| Éléments visuels | Nombre de particules spécifié, type de géométrie, palette de couleurs | Il faut que ça en jette |
| Performances | Lecture fluide sur un ordinateur portable ordinaire, sans chute de frames perceptible | Pas trop de lag |
| Périmètre de livraison | Pas besoin d’exporter une vidéo, seulement le code source exécutable | Faire un truc plus complet |
Une fois ce tableau écrit, vous verrez que beaucoup d’idées peuvent en réalité être réparties sur plusieurs tours et validées séparément. Par exemple, au premier tour, on peut ne demander que « ça tourne + uniquement three.js + composition de base », puis ajouter progressivement le rythme et les détails visuels, au lieu d’exiger que tout soit parfait dès le départ.
Comment limiter les tentatives avec Gemini 4 Neon pour en faire moins
Avec la checklist de validation en main, l’étape suivante consiste à fixer un nombre maximal de tours pour chaque critère. À vous de définir la limite selon votre budget, mais une approche pratique consiste à arrêter un critère qui échoue plusieurs tours d’affilée et à changer d’approche, plutôt qu’à empiler les invites en se disant « on retente encore une fois ». Changer d’approche peut vouloir dire découper la tâche en sous-tâches, fournir une structure de référence, ou recoller uniquement l’extrait de code fautif en demandant au modèle de ne modifier que cet endroit.
Un autre point souvent négligé est l’accumulation de contexte. Dans une conversation à plusieurs tours, chaque tour renvoie le code et les échanges précédents comme entrée : plus les tours s’enchaînent, plus l’entrée de chaque tour devient lourde. L’approche la plus économique consiste à procéder ainsi : dès qu’un critère de validation passe, rassembler le code source utilisable dans un nouveau point de départ propre et ouvrir une nouvelle session pour continuer, plutôt que de s’acharner dans une conversation de plus en plus longue.
- Ne demander qu’un ou deux critères de validation par tour.
- À la fin de chaque tour, noter les tokens d’entrée et de sortie dans usage et calculer le coût du tour.
- S’arrêter une fois la limite de tours atteinte, puis analyser les causes de l’échec avant de décider s’il faut continuer.
- Dès qu’un critère passe, « archiver » le code source et avancer vers le suivant dans une nouvelle session.
🎯 Conseil pour les tests : si vous voulez voir clairement le coût de chaque tour, vous pouvez lancer vos tests sur APIYI (apiyi.com) avec la même clé API. La facturation à l’usage permet de vérifier les tokens consommés à chaque appel, ce qui est plus contrôlable qu’une estimation approximative faite au feeling dans l’interface interactive.
Comment choisir le niveau de réflexion de Gemini 4 Neon, et quand s’arrêter
Le niveau de réflexion est le levier de facturation le plus direct dans l’expérimentation Gemini 4 Neon. D’après la documentation Google Cloud, thinking_level de Neon propose quatre niveaux : LOW, MEDIUM, HIGH (par défaut) et XHIGH, et les tokens de réflexion sont facturés comme des tokens de sortie. Le prix de sortie étant déjà cinq fois celui de l’entrée, plus le niveau est élevé et plus la réflexion est longue, plus la facture grimpe vite. À noter : le paramètre thinking_budget et le niveau MINIMAL renvoient directement une erreur HTTP 400 sur Neon ; ne reprenez pas les anciennes syntaxes utilisées pour d’autres modèles.
Les niveaux de réflexion ne sont pas non plus communs à toute la gamme : faites attention au changement de modèle.
| Modèle | Niveaux de réflexion disponibles | Niveau par défaut | Usage recommandé (doc Neon) |
|---|---|---|---|
gemini-4-neon |
low / medium / high / xhigh | high | LOW : résumés et classification ; MEDIUM : codage courant ; HIGH : boucles d’outils multi-étapes ; XHIGH : preuves les plus lourdes et ingénierie multi-fichiers |
gemini-4-hydrogen |
low / medium / high / xhigh | high | Dispose du niveau xhigh |
gemini-4-carbon |
low / medium / high | medium | Pas de xhigh |
Pour un graphique animé Three.js dans un seul fichier, on reste plus proche du « codage courant » : partir de MEDIUM est raisonnable. Ne montez au HIGH pour un critère d’acceptation donné que s’il échoue régulièrement en MEDIUM et que la cause de l’échec tient vraiment à une logique complexe (par exemple l’orchestration temporelle de plusieurs segments de caméra). XHIGH convient mieux aux projets multi-fichiers ; une animation sur une seule page en a rarement besoin.
La décision d’arrêter la montée en niveau doit aussi figurer dans les règles : si le même critère échoue encore après une montée de niveau, le problème vient probablement moins d’un « manque de réflexion » que d’une exigence mal décrite ; continuer à monter ne fera qu’augmenter les frais de sortie.
💡 Conseil de niveau : lorsque vous appelez Gemini 4 Neon via APIYI apiyi.com, vous pouvez exécuter le même critère d’acceptation une fois avec
MEDIUMet une fois avecHIGH, comparer les tokens de sortie dans l’usage et le taux de réussite, puis décider quel niveau utiliser par défaut par la suite.
Gemini 4 Neon : différences de fenêtre de contexte entre l’API et Antigravity
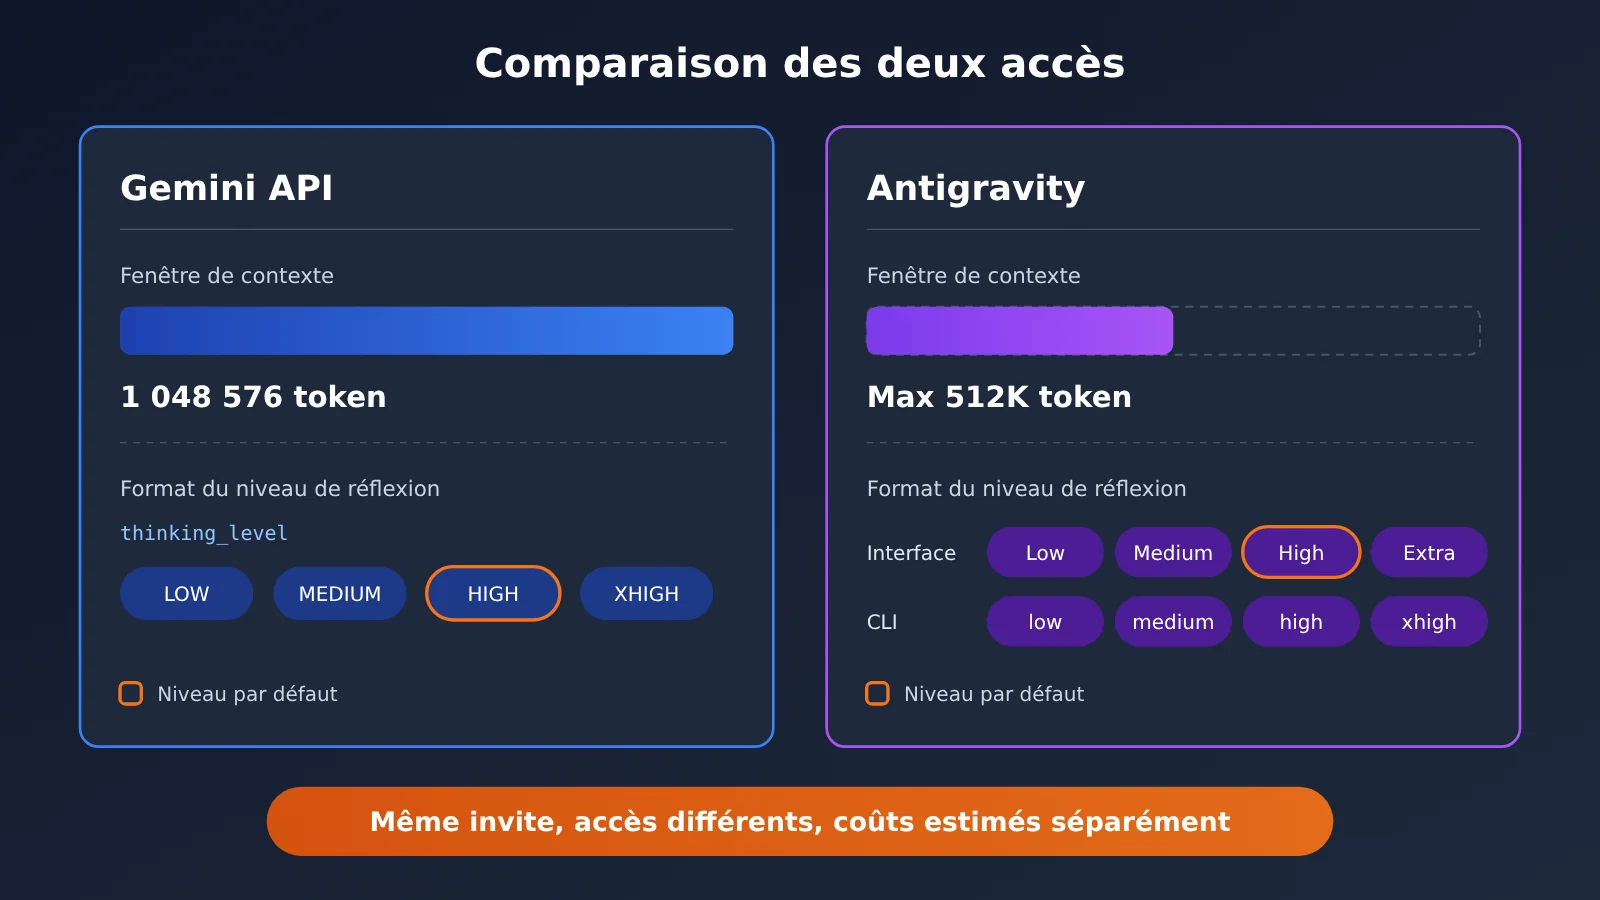
Un même modèle, mais un point d’entrée différent : la quantité de contenu qu’on peut y faire tenir change. Dans l’API Gemini, la fenêtre de contexte de Neon est de 1,048,576 tokens, tandis que la documentation d’Antigravity indique un maximum de 512K tokens pour Gemini 4 Neon, soit à peu près du simple au double. La façon d’écrire les niveaux de réflexion diffère aussi : dans l’interface Antigravity, on parle de Low, Medium, High (par défaut), Extra ; en CLI, on écrit low, medium, high, xhigh.
| Élément de comparaison | API Gemini | Antigravity |
|---|---|---|
| Fenêtre de contexte | 1,048,576 tokens | Jusqu’à 512K tokens |
| Écriture du niveau de réflexion | thinking_level : LOW / MEDIUM / HIGH / XHIGH |
Interface : Low / Medium / High / Extra ; CLI : low / medium / high / xhigh |
| Niveau de réflexion par défaut | HIGH | High |
| Comment lire le coût | Chaque appel est facturé au token, avec un rapprochement direct possible | Les règles internes au produit font foi ; mieux vaut ne pas les mélanger avec le prix unitaire de l’API |
L’intérêt de ce tableau : une même invite, envoyée à deux points d’entrée différents, ne dispose pas de la même fenêtre ni de la même gestion du contexte, et la consommation diffère donc naturellement. Un budget estimé sur l’API ne se transpose pas directement à Antigravity ; à l’inverse, avoir l’impression de « ne pas dépenser beaucoup » dans Antigravity ne signifie pas que le même usage sera aussi économique via l’API. Un scénario comme Shibuya Parkour, avec un volume d’entrée proche d’un million de tokens, ne rentre tout simplement pas dans une fenêtre de 512K : il faut soit découper les données, soit changer de point d’entrée.
Gemini 4 Neon : démarrage rapide et premier essai Three.js via l’API
Configuration minimale d’une requête Gemini 4 Neon
APIYI met à disposition une interface compatible OpenAI, avec deux endpoints, chat et gemini, et deux groupes, Default et SVIP. Pour ce premier essai, il suffit de valider les quelques paramètres suivants :
- Adresse de l’endpoint :
base_urldéfini surhttps://api.apiyi.com/v1 - ID du modèle :
gemini-4-neon - Clé API : à créer dans la console puis à renseigner ; dans les exemples, elle apparaît sous la forme
YOUR_API_KEY - Niveau de réflexion : commencez par
MEDIUMcomme suggéré plus haut ; sur l’endpoint gemini, utilisez le champthinking_level, et pour l’endpoint chat, référez-vous à la documentation de la plateforme pour le mapping des champs - Contenu de l’invite : collez directement votre checklist de validation, en précisant « livrer un seul fichier HTML, n’utiliser que three.js »
À la fin de chaque appel, notez le champ usage renvoyé dans la réponse. Le coût d’un tour peut s’estimer avec cette formule : tokens d’entrée × prix unitaire d’entrée + tokens ayant touché le cache × prix du cache + (sortie visible + réflexion) tokens × prix unitaire de sortie.
Un point à clarifier sur les tarifs : dans la version du tableau général des modèles d’APIYI datée du 2026-11-19 10:59 (UTC+8), gemini-4-neon n’apparaissait pas encore, et Neon n’a pas non plus de page modèle dédiée ; en revanche, l’interface de tarification interrogée le 2026-11-20 le référence déjà, avec, après conversion, 3 USD par million de tokens en entrée, 15 USD par million de tokens en sortie et 0,15 USD par million de tokens pour la lecture de cache, ce qui correspond aux tarifs affichés par Google. Les prix réels font foi selon la liste des modèles de la plateforme.
🚀 Démarrage rapide : inscrivez-vous d’abord sur APIYI apiyi.com et récupérez le quota d’essai gratuit réservé aux nouveaux utilisateurs. Servez-vous-en pour boucler le premier point de validation et obtenir de vraies données usage avant de planifier le budget suivant : c’est bien plus fiable que de se fier à l’aveugle aux rendus déjà publiés par d’autres.
Comment la facture de Gemini 4 Neon évolue-t-elle quand on passe à Carbon ou Hydrogen ?
Si certains critères d’acceptation n’ont pas besoin des capacités de Neon, passer à un modèle voisin déjà disponible permet de réduire directement le prix unitaire. Voici les tarifs des trois modèles sur APIYI :
| Modèle | Entrée | Lecture du cache | Sortie | Contexte / Remarques | Plateforme disponible |
|---|---|---|---|---|---|
gemini-4-neon |
3 USD par million de tokens |
0.15 USD par million de tokens |
15 USD par million de tokens |
API Gemini, environ 1M | APIYI apiyi.com |
gemini-4-carbon |
2 USD par million de tokens |
0.1 USD par million de tokens |
10 USD par million de tokens |
Contexte 1048576, sortie max. 65536 | APIYI |
gemini-4-hydrogen |
1.5 USD par million de tokens |
0.075 USD par million de tokens |
7.5 USD par million de tokens |
Niveau xhigh disponible |
APIYI |
À en juger par le prix unitaire, l’entrée et la sortie de Carbon représentent environ deux tiers de celles de Neon, et Hydrogen environ la moitié. Mais au moment de changer, trois éléments doivent être adaptés en même temps. D’abord, Carbon n’a pas de niveau xhigh : les requêtes où XHIGH était écrit ne peuvent pas être reprises telles quelles. Ensuite, le niveau par défaut de Carbon est medium, alors que Neon et Hydrogen utilisent high par défaut ; sans définir explicitement le niveau, la quantité de réflexion pour une même invite changera. Enfin, le prix actuel de Carbon correspond au tarif de lancement de Google valable jusqu’au 30 novembre 2026 ; à partir du 1er décembre, le tarif standard de Google sera de 4 USD par million de tokens en entrée et de 20 USD par million de tokens en sortie. Pour un budget à long terme, il faut donc surveiller si les tarifs de la plateforme sont ajustés.
Le changement lui-même est simple : base_url reste https://api.apiyi.com/v1, il suffit de modifier le champ model. Une répartition pragmatique consiste à utiliser Hydrogen ou Carbon pour les cas d’usage de base et les petites corrections de bugs, et à ne revenir à Neon que pour les points difficiles comme l’orchestration du rythme.
FAQ – Questions fréquentes
Q1 : La démo Three.js de Gemini 4 Neon est-elle une référence officielle ?
Non. Cette vidéo de 15 secondes a été publiée par un membre de la communauté, et l’attribution du modèle vient de l’auteur du post lui-même. On n’a ni le prompt, ni les fichiers sources, ni le niveau de réflexion utilisé, ni le nombre de tokens : c’est une démonstration, pas une mesure. Elle ne peut donc pas servir de référence officielle ni de base de calcul des coûts.
Q2 : Peut-on estimer, à partir de la vidéo finale, combien coûterait une démo similaire ?
Non. On ignore combien d’essais ont été nécessaires, quel niveau de réflexion a été utilisé et s’il y a eu des retouches manuelles. Or les tokens de réflexion sont facturés comme des tokens de sortie, et chacun de ces paramètres peut faire varier le coût dans des proportions considérables. La seule méthode fiable consiste à lancer son propre essai et à calculer à partir des données d’usage.
Q3 : Que nous apprennent les scores de Gemini 4 Neon dans les classements ?
L’annonce de Google cite des classements tiers : l’Artificial Analysis Intelligence Index à 61 en mode xhigh, soit la 3ᵉ place au classement général, et la 2ᵉ place au Vals Index avec 70,9 %. Ces chiffres reflètent un positionnement en termes de capacités : ils peuvent vous aider à décider si le modèle vaut la peine d’être testé, mais ils ne contiennent aucune information sur les coûts.
Q4 : Quel niveau de réflexion choisir pour des animations Three.js ?
Une animation dans un fichier unique se rapproche du codage classique. Je conseille de commencer avec `MEDIUM`, et de passer à `HIGH` uniquement si un critère d’acceptation complexe échoue à plusieurs reprises. `XHIGH` est pensé pour les projets multi-fichiers et les raisonnements les plus lourds ; pour une animation d’une seule page, il est généralement inutile.
Q5 : Comment tester Gemini 4 Neon rapidement via l’API ?
Inscrivez-vous sur APIYI apiyi.com et récupérez une clé API, définissez `base_url` sur l’adresse de la plateforme, `model` sur `gemini-4-neon`, précisez explicitement le niveau de réflexion, puis envoyez votre liste de critères d’acceptation. Les nouveaux utilisateurs disposent d’un quota d’essai gratuit, idéal pour lancer un premier critère d’acceptation et obtenir des données d’usage réelles.
Q6 : Quels sont les pièges à éviter lors des tests de Gemini 4 Neon ?
– Paramètres : `thinking_budget` et `MINIMAL` renvoient une erreur HTTP 400.
– Fenêtre : Antigravity plafonne à 512K, ne planifiez donc pas vos entrées sur la base du 1M de l’API.
– Changement de modèle : Carbon n’a pas de mode xhigh, et son niveau par défaut diffère également.
– Tarifs : la version du 19 novembre du tableau général ne mentionne pas Neon ; référez-vous à la liste des modèles de la plateforme.
Gemini 4 Neon : les points clés pour économiser sur la démo Three.js
- La vidéo finie n’est pas la facture : une vidéo de 15 secondes ne fournit aucune donnée de tokens, impossible d’en déduire le coût.
- Les démos officielles n’ont pas de facture non plus : aucune des démos de Google ne publie son relevé de tokens.
- La validation avant l’invite : découpez « c’est fait » en points vérifiables avant de vous lancer.
- Plafonnez les essais : fixez un nombre maximal de tours pour chaque élément ; au-delà, changez d’approche plutôt que de persévérer.
- Le niveau de réflexion est le bouton principal : les tokens de réflexion sont facturés comme de la sortie ; commencez par MEDIUM.
- Estimez séparément les points d’entrée : environ 1M de fenêtre de contexte via l’API, jusqu’à 512K sur Antigravity.
- Répartissez les modèles : Carbon et Hydrogen ont un prix unitaire plus bas ; attention aux différences de niveaux quand vous basculez.
En résumé
Les points essentiels pour maîtriser le coût de la démo Three.js de Gemini 4 Neon :
- Ne vous laissez pas impressionner par le rendu final : ni les vidéos de la communauté ni les démos officielles ne publient leur facture ; votre budget ne peut venir que de vos propres données d’usage.
- Définissez d’abord les critères de validation, puis limitez le nombre d’essais : la checklist de validation donne la condition d’arrêt, le plafond de tours évite de recommencer à l’infini ; c’est la combinaison des deux qui contrôle vraiment la dépense.
- Gérez séparément les niveaux et les points d’entrée : le niveau de réflexion détermine le volume de sortie, le point d’entrée détermine la taille de la fenêtre ; en changeant de modèle, vérifiez aussi les niveaux disponibles et ceux par défaut.
Dix minutes passées à écrire votre checklist de validation avant de commencer vous feront souvent économiser plus que plusieurs essais supplémentaires. Je vous conseille de valider le premier point de la checklist avec le quota gratuit via APIYI apiyi.com, puis d’utiliser une seule clé API pour répartir les tâches entre Neon, Carbon et Hydrogen, les prix étant ceux de la liste des modèles de la plateforme.
📚 Références
-
OrcaRouter – Récapitulatif du motion design Three.js de Gemini 4 Neon : date de publication, caractéristiques techniques et zones d’ombre du clip communautaire
- Lien :
orcarouter.ai/blog/gemini-4-neon-threejs-motion-graphic - Description : documente l’absence d’invite, de fichier source, de niveau de réflexion et de nombre de tokens dans le clip
- Lien :
-
Blog Google – Annonce de la sortie de Gemini 4 Neon : tarification officielle, fenêtre de contexte et classement tiers cité
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Description : contient la présentation des démos officielles ainsi que les prix unitaires d’entrée, de cache et de sortie
- Lien :
-
Google Cloud – Guide du modèle Gemini 4 Neon : niveaux de réflexion et limites des paramètres
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Description : explique les quatre niveaux de thinking_level et les paramètres qui déclenchent une erreur HTTP 400
- Lien :
-
Documentation des modèles Antigravity : fenêtre d’entrée et syntaxe du niveau de réflexion
- Lien :
antigravity.google/docs/models - Description : indique que Neon dispose dans Antigravity d’une fenêtre de contexte allant jusqu’à 512K
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : contactez-nous depuis la page d’accueil du site APIYI ; pour découvrir d’autres modèles et obtenir plus de détails sur les appels, consultez le centre de documentation docs.apiyi.com