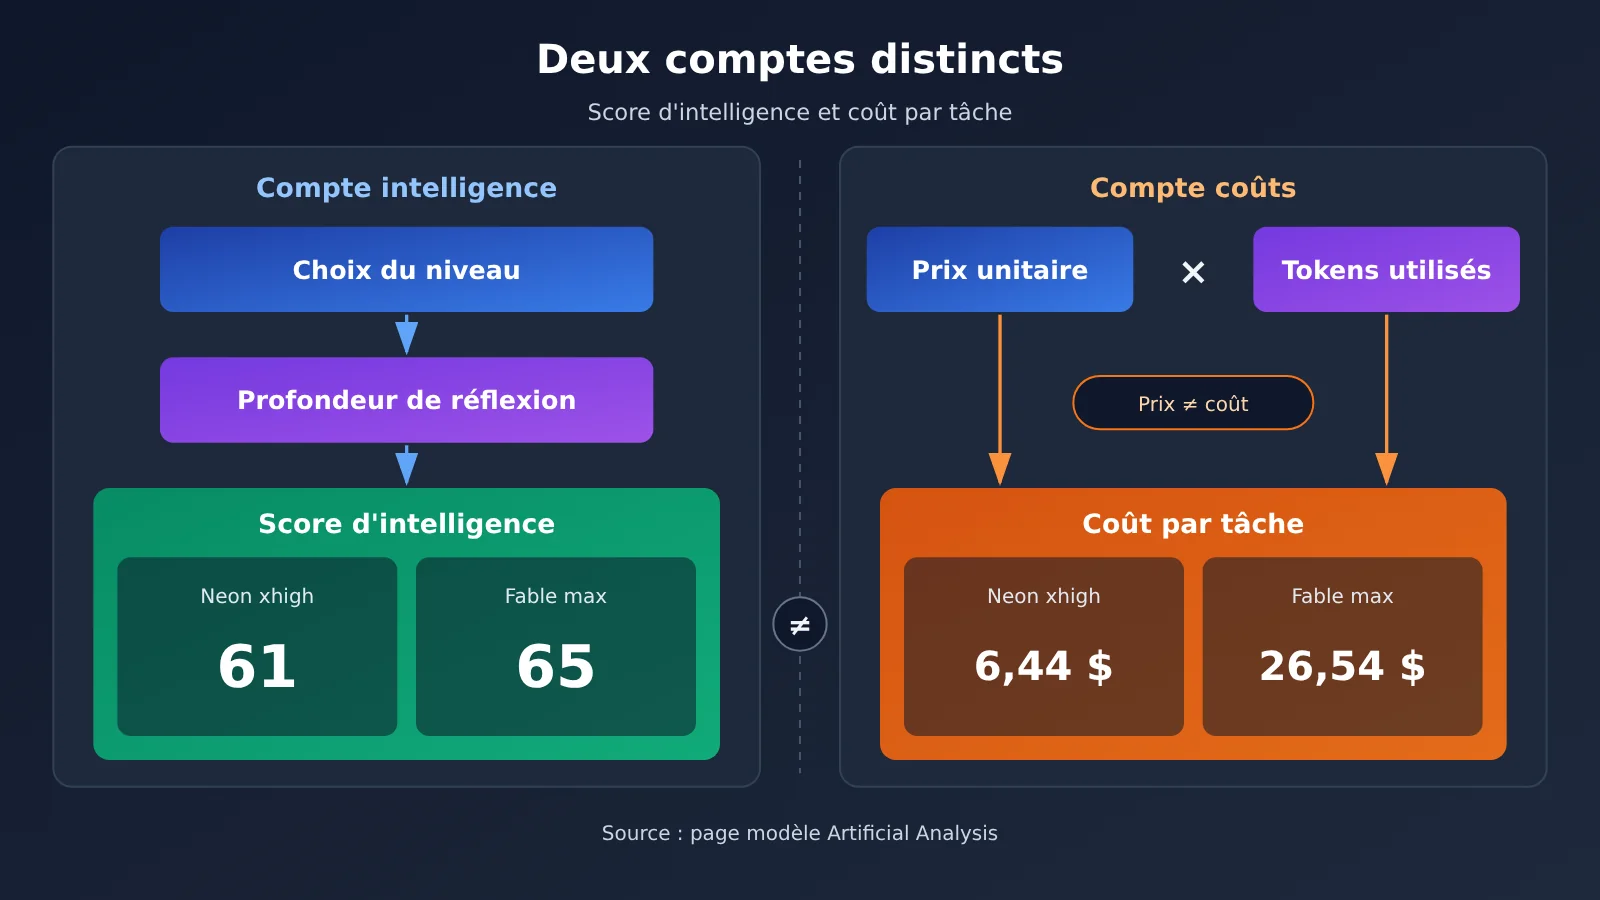
Note de l’auteur : sur le classement général d’Artificial Analysis, Claude Fable 5.2 devance Gemini 4 Neon. Cet article distingue deux comptes : le score d’intelligence et le coût par tâche. Il aligne ensuite chaque élément selon le palier, pour mieux voir où se situe précisément l’écart entre les deux.
Gemini 4 Neon est sorti le 18 novembre 2026. D’après le classement publié dans l’article Artificial Analysis, Neon se classe 3e au classement général avec 61 points dans le palier xhigh ; devant lui figurent GPT-6.2 Astra (max) et Claude Fable 5.2 (max). En voyant ce classement, beaucoup de développeurs se demandent d’où vient l’avance de Fable 5.2 : du score d’intelligence, ou des coûts plus élevés que l’on est prêt à payer ?
Ces deux comptes doivent être examinés séparément. Le score d’intelligence correspond au palier max de Fable et au palier xhigh de Neon ; dans l’indice de codage, Fable est évalué avec le palier xhigh. La fiche modèle de Google ne contient même pas de colonne Fable, donc les sous-scores de Fable ne peuvent pas être empruntés à un autre modèle. Cet article ne s’appuie que sur les indicateurs présents à la fois dans l’article Artificial Analysis et dans les pages des deux modèles sur Artificial Analysis ; chaque chiffre est accompagné de sa source. Pour vérifier les modèles et les tarifs, vous pouvez consulter directement la liste des modèles sur APIYI apiyi.com.
L’essentiel : après lecture, vous saurez quels sont le score d’intelligence, le coût par tâche, la durée d’exécution, la vitesse de sortie et le temps avant le premier token de Gemini 4 Neon et de Claude Fable 5.2, à quel palier chacun correspond, et quels chiffres ne peuvent pas être soustraits ou combinés entre eux. Date de vérification des données : 19 novembre 2026.
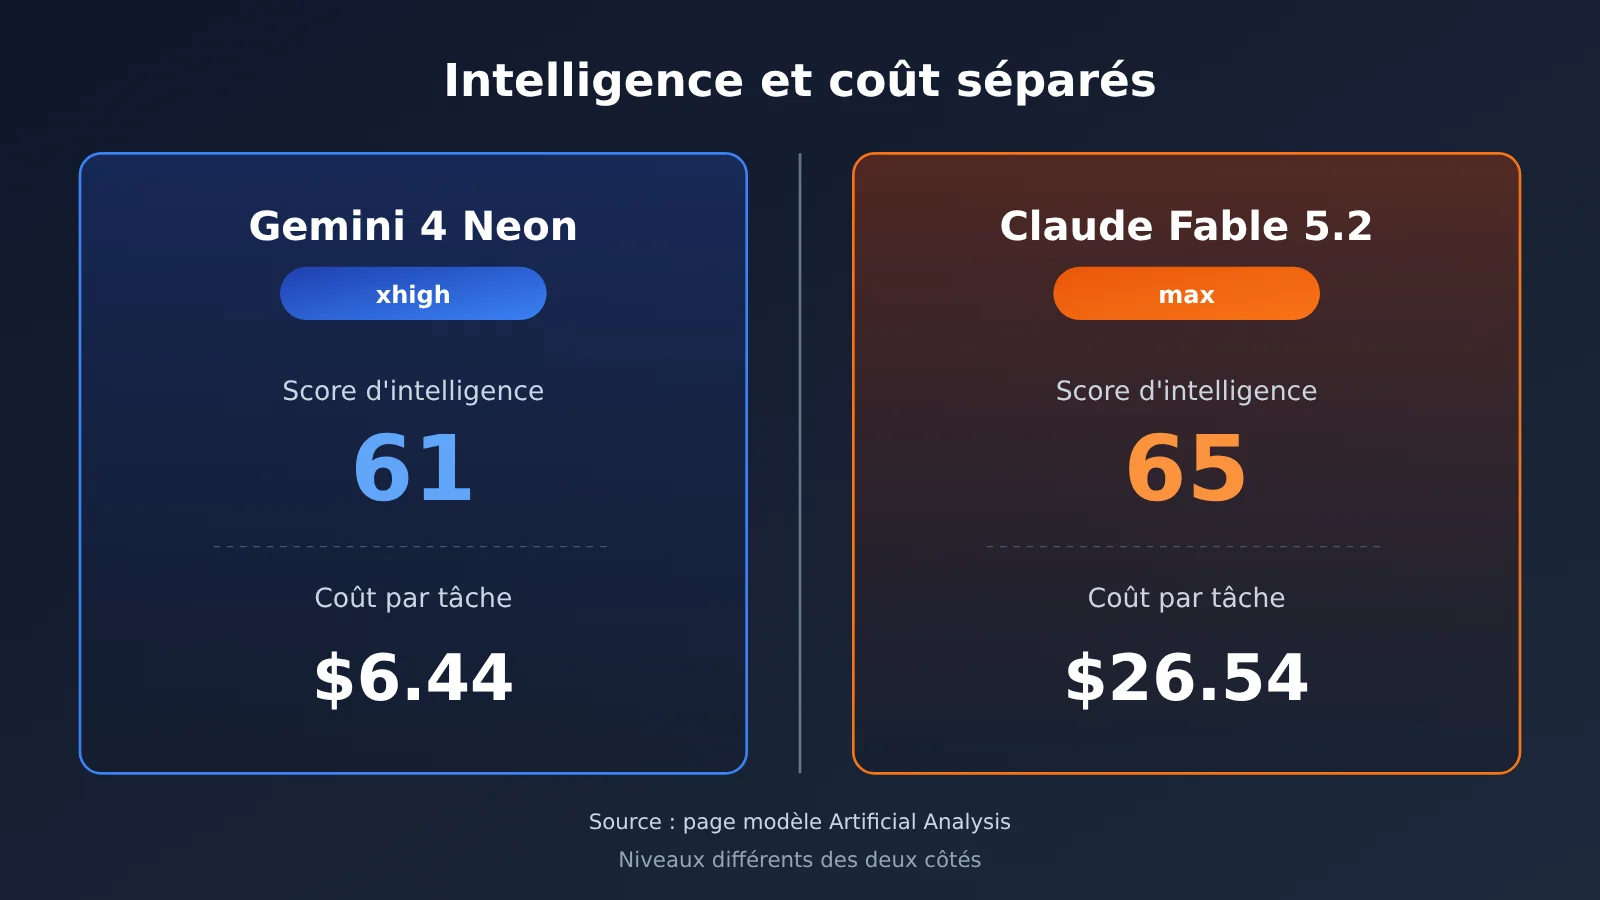
Gemini 4 Neon et Claude Fable 5.2 : l’essentiel à retenir, avec deux comptes séparés — le score d’intelligence et le coût
Les données du tableau ci-dessous proviennent toutes de la page modèle d’Artificial Analysis (consultée le 19 novembre 2026, indice v5.0.1). À noter : les niveaux ne sont pas les mêmes des deux côtés. Fable est évalué en max (également le Default Fallback de cette page), Neon en xhigh.
| Indicateur | Gemini 4 Neon (xhigh) | Claude Fable 5.2 (max) | Source |
|---|---|---|---|
| Score d’intelligence | 61 | 65 | Page modèle d’Artificial Analysis |
| Coût par tâche | 6.44 USD | 26.54 USD | Page modèle d’Artificial Analysis |
| Temps par tâche | 21.5 minutes | 41.6 minutes | Page modèle d’Artificial Analysis |
| Vitesse de sortie | 110 tokens/s | 110 tokens/s | Page modèle d’Artificial Analysis |
| Temps jusqu’au premier token de réponse | 56.51 secondes | 247.46 secondes | Page modèle d’Artificial Analysis |
| Tarif (entrée/sortie, par million de tokens) | 3.00 / 15.00 USD | 8.00 / 40.00 USD | Page modèle d’Artificial Analysis |
Le compte du score d’intelligence : Gemini 4 Neon vs Claude Fable 5.2
Sur la ligne du score d’intelligence, on lit 61 contre 65, avec les niveaux Neon xhigh face à Fable max. Selon l’article d’Artificial Analysis, Neon xhigh dépasse de 1 point Gemini 4 Carbon high et se classe 3e au classement général, derrière GPT-6.2 Astra (max) et Claude Fable 5.2 (max). Le blog de Google indique aussi que l’Artificial Analysis Intelligence Index atteint 61 en xhigh, mais il s’agit d’une auto-déclaration officielle ; les 61 concordent entre le blog de Google, la fiche modèle et Artificial Analysis.
Sur sa page modèle, Fable ne publie que les données du niveau max. On ne peut donc pas le comparer à niveau égal avec les autres niveaux de Neon. Le niveau de raisonnement par défaut de Neon est high, comme l’indiquent le guide développeur Google Cloud et la dernière page modèle d’AI Studio. Sur la page modèle d’Artificial Analysis, Neon high obtient 60. Si votre appel ne précise pas de niveau, vous obtenez en pratique high, pas xhigh.
Le compte du coût par tâche : Gemini 4 Neon vs Claude Fable 5.2
Le coût par tâche est de 6.44 USD contre 26.54 USD, et le temps par tâche de 21.5 minutes contre 41.6 minutes. L’article d’Artificial Analysis parle d’« environ 21 minutes » pour Neon, tandis que la page modèle indique 21.5 minutes : on garde les deux chiffres tels quels. La vitesse de sortie est la même des deux côtés, à 110 tokens/s, mais le temps jusqu’au premier token de réponse est très différent : 56.51 secondes pour Neon xhigh, 247.46 secondes pour Fable max.
Il ne faut pas confondre le prix unitaire et le coût par tâche. Sur la page modèle d’Artificial Analysis, GPT-6.2 Astra affiche le même tarif de 8.00/40.00 USD, mais son coût par tâche au niveau max est de 4.00 USD, parce qu’il produit beaucoup moins de tokens lors de l’évaluation sur l’indice. Pour juger du coût par tâche, il faut donc regarder à la fois le prix unitaire et la consommation de tokens, pas seulement le tarif affiché.
Gemini 4 Neon et Claude Fable 5.2 : indices de codage, précisions sur les paliers
Les données de cette partie codage proviennent d’un article d’Artificial Analysis. Les paliers et l’environnement d’exécution méritent d’être notés séparément : Neon a été mesuré sur Antigravity CLI, tandis que Fable et Opus 5.5 l’ont été sur Claude Code. Les deux harness ne sont donc pas identiques.
| Modèle et palier | Coding Agent Index | Coût par tâche de codage | Environnement d’exécution | Source |
|---|---|---|---|---|
| Gemini 4 Neon xhigh | 59 | 6,86 dollar | Antigravity CLI | Article Artificial Analysis |
| Claude Fable 5.2 xhigh | 58 | 15,47 dollars | Claude Code | Article Artificial Analysis |
| Claude Opus 5.5 max | 58 | 12,61 dollars | Claude Code | Article Artificial Analysis |
| Gemini 4 Carbon high | 55 | non indiqué dans l’article | Antigravity CLI | Article Artificial Analysis |
Ici, Fable est en palier xhigh, alors que la colonne du score d’intelligence utilise le palier max : ces deux chiffres ne se lisent pas dans les mêmes conditions. Autre point : le blog de Google annonce un Neon Coding Agent Index de 58,6, là où l’article d’Artificial Analysis indique 59. Le premier est une valeur déclarée par l’éditeur, le second vient d’un article tiers. Nous gardons les deux, sans arbitrer ni faire la moyenne.
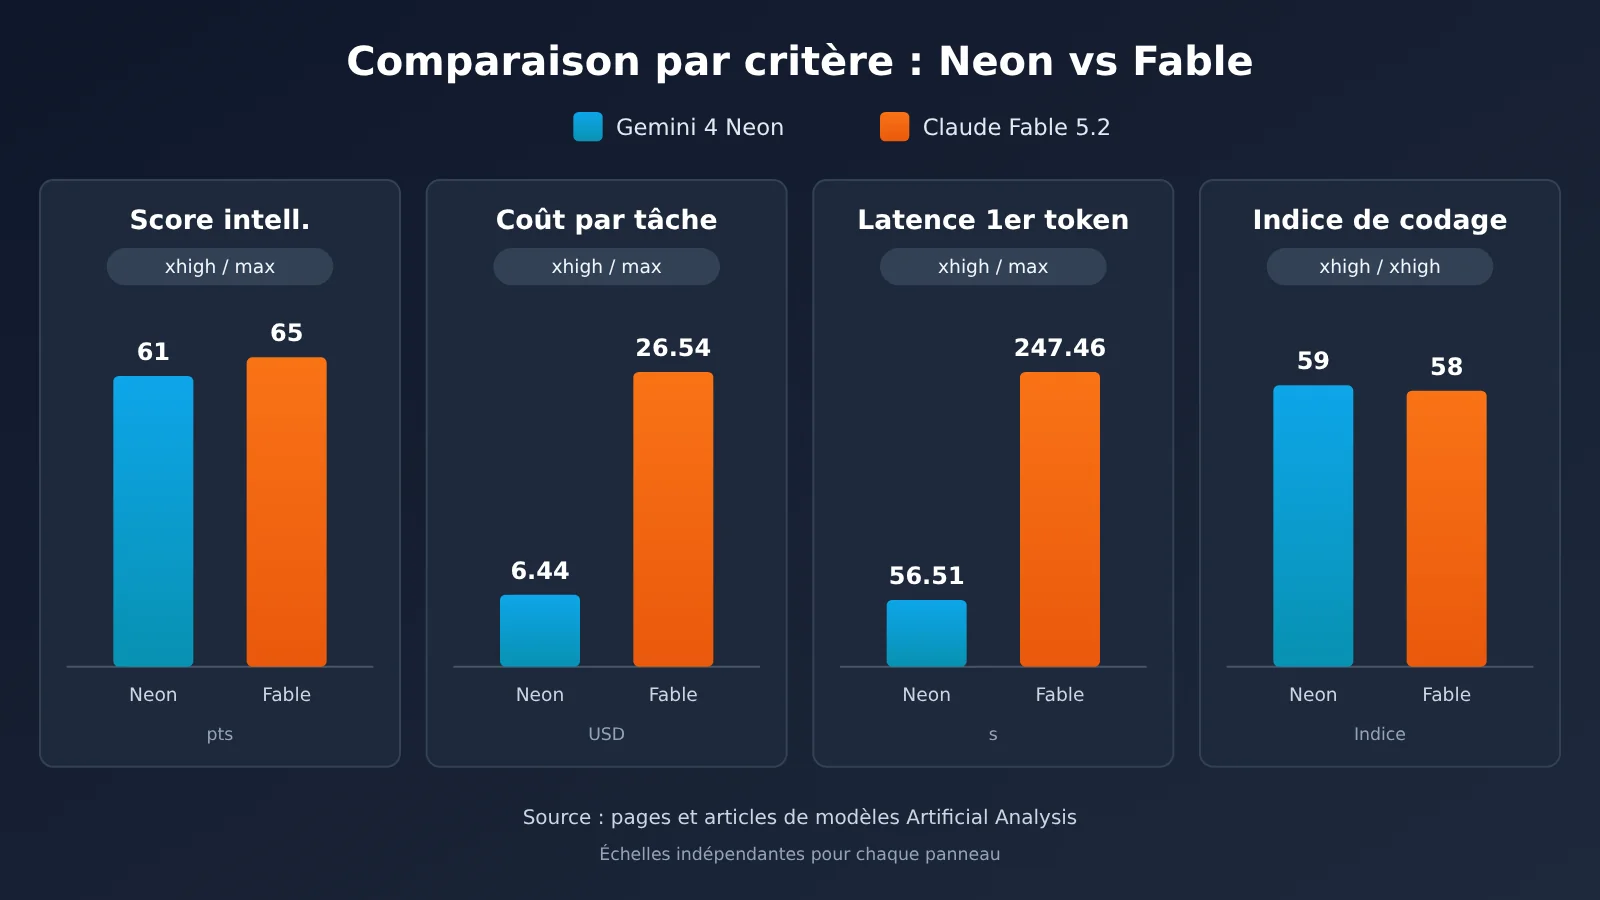
Note sur les données : les chiffres du graphique ci-dessus proviennent respectivement des pages modèles d’Artificial Analysis et de son article, et les paliers sont indiqués dans le graphique. Pour les prix d’appel des deux modèles, voir le tableau de tarifs APIYI plus bas.
Pourquoi la fiche du modèle Gemini 4 Neon ne peut pas remplacer les scores détaillés de Claude Fable 5.2
Le tableau comparatif de la fiche du modèle Gemini 4 Neon de DeepMind ne comporte que trois colonnes : Gemini 4 Neon, Claude Opus 5.5 et GPT-6.2 Sol. Claude Fable 5.2 n’y figure pas. Le PDF explicatif des évaluations qui accompagne la fiche précise que, par défaut, les résultats des modèles non-Gemini proviennent de ce que chaque éditeur déclare lui-même. Ce tableau n’est donc qu’une synthèse officielle : les modèles n’ont pas été retestés par le même laboratoire le même jour.
Opus 5.5 et Fable 5.2 sont deux modèles distincts. Sur la page du modèle chez Artificial Analysis, le score d’intelligence de Opus 5.5 max est de 59, celui de Fable 5.2 max de 65, et leurs tarifs affichés diffèrent aussi (4,00/20,00 contre 8,00/40,00). Les pourcentages de la colonne Opus dans la fiche du modèle ne valent que pour Opus 5.5 : impossible de les utiliser comme scores détaillés de Fable 5.2.
Voici un récapitulatif de plusieurs jeux de chiffres faciles à confondre :
| Affirmation | Chiffre | Source et méthodologie |
|---|---|---|
| Coût par tâche de Neon high inférieur à Carbon | 32 % | Déclaration officielle (blog Google), sans préciser si Carbon est facturé au tarif de lancement ou au tarif standard |
| Neon xhigh dépense moins par tâche que Carbon | environ 17 % (6,44 contre 7,76 dollars) | Article d’Artificial Analysis, Carbon calculé au tarif non remisé |
| Coût par tâche de Carbon high | 4,90 dollars | Page du modèle Artificial Analysis, tarif de lancement |
| Indice Coding Agent de Neon | 58,6 / 59 | Déclaration officielle / article d’Artificial Analysis |
| MKA de Neon | 56,5 % / 56 % | Fiche du modèle / article d’Artificial Analysis |
| SWE-sweep de Neon | 12,8 % / 39,0 % | Déclaration officielle, correspondant respectivement au harness mini-SWE et à Google Antigravity |
Les trois chiffres de coût du tableau ci-dessus viennent de trois comptabilités différentes : ils ne se soustraient pas et ne se fusionnent pas en un seul nombre. Pour l’écart de 12,8 % à 39,0 % sur SWE-sweep, le blog de Google l’explique par le gain apporté par le harness, et non par un modèle trois fois supérieur.
Gemini 4 Neon et Claude Fable 5.2 : recommandations par scénario – commencez par choisir la métrique qui compte
Les données des deux modèles figurent dans le même tableau, mais les indicateurs qui intéressent les lecteurs diffèrent. Voici un regroupement par « quel indicateur vous importe le plus » ; chaque groupe indique simplement quelle colonne consulter, sans trancher à votre place.
Scénarios où le score d’intelligence est prioritaire
- Raisonnement longue durée, analyse complexe : consultez la colonne du score d’intelligence, et notez en même temps le niveau (Fable max 65, Neon xhigh 61) ; pour l’évaluation, reproduisez les tests au même niveau.
- Besoin d’un classement transversal : l’article d’Artificial Analysis fournit un classement global, que vous pouvez citer, mais précisez bien à quel niveau ce classement correspond.
Scénarios où le coût par tâche et la latence sont prioritaires
- Appels à haute fréquence, tâches par lots : consultez le coût par tâche (6,44 contre 26,54 dollars) et le temps par tâche (21,5 contre 41,6 minutes).
- Produits interactifs : consultez le temps jusqu’au premier token de réponse (56,51 contre 247,46 secondes). La vitesse de sortie est identique des deux côtés ; la différence de latence se lit donc sur le temps jusqu’au premier token.
- Agent de codage : consultez le tableau dédié au codage, et notez que Neon et Fable sont tous deux au niveau xhigh, mais que leurs environnements d’exécution sont respectivement Antigravity CLI et Claude Code.
Les performances de Neon à chacun de ses niveaux méritent aussi d’être examinées séparément. Les données ci-dessous proviennent du tableau récapitulatif de la page modèle d’Artificial Analysis ; pour le temps jusqu’au premier token, les chiffres des trois derniers niveaux sont tirés de la FAQ de la même page, et ne figurent donc pas dans la même colonne que le tableau récapitulatif.
| Niveau de Neon | Score d’intelligence | Temps par tâche | Vitesse de sortie | Premier token de réponse |
|---|---|---|---|---|
| xhigh | 61 | 21,5 minutes | 110 tokens/s | 56,51 secondes |
| high (par défaut) | 60 | 14,8 minutes | 101 tokens/s | 40,64 secondes (FAQ) |
| medium | 55 | 8,3 minutes | 101 tokens/s | 20,14 secondes (FAQ) |
| low | 44 | 3,7 minutes | 97 tokens/s | 13,93 secondes (FAQ) |
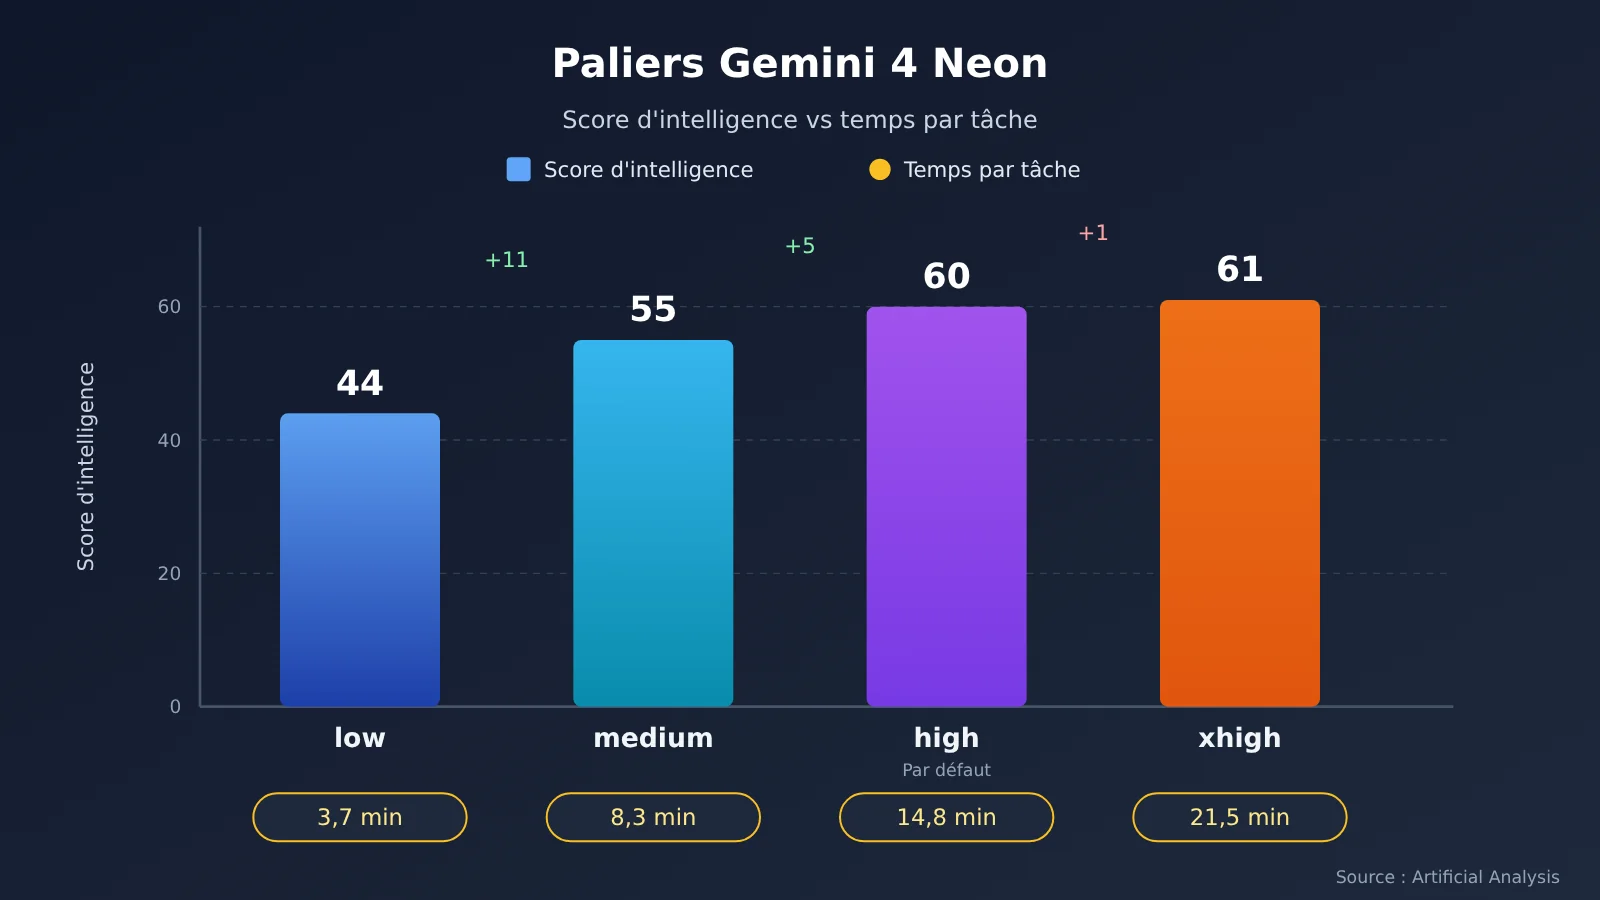
Par ailleurs, les données de l’article d’Artificial Analysis concernant GDP.pdf indiquent : Neon high à 33,4 %, Neon xhigh à 28,0 %. Cela montre que dans ce test, un niveau plus élevé ne garantit pas un meilleur score.
Tarifs et disponibilité de Gemini 4 Neon et Claude Fable 5.2
Côté tarification officielle, d’après la page de tarifs de Google AI Studio, gemini-4-neon n’a pas de palier gratuit. Les tarifs payants sont les suivants : entrée à 3.00 USD par million de tokens, sortie à 15.00 USD par million de tokens (tokens de réflexion inclus), cache à 0.15 USD par million de tokens, avec prise en charge du cache implicite uniquement. Le prix affiché de Fable 5.2 sur la page du modèle Artificial Analysis est de 8.00/40.00 USD, avec une remise de 98 % sur le cache.
Dans le tableau récapitulatif d’APIYI (apiyi.com) — page indiquée comme mise à jour le 2026-11-16 à 09:39 (UTC+8) — et dans l’interface de tarification (consultée le 2026-11-19, version shell-api-modelmak-v1, 285 modèles au total), voici les informations pour les modèles concernés. Selon les conventions de l’interface de tarification, une valeur model_ratio de 1 correspond à 2 USD en entrée par million de tokens, et une valeur completion_ratio de 5 signifie que le prix de sortie vaut 5 fois celui de l’entrée.
| ID du modèle | Entrée | Lecture du cache | Sortie (USD/million de tokens) | Endpoint | Plateforme disponible |
|---|---|---|---|---|---|
claude-fable-5-2 |
8 | 0.2 | 40 | chat, messages | APIYI (disponible) |
claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | APIYI (disponible) |
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | APIYI (disponible) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | APIYI (disponible) |
gemini-4-neon |
— | — | — | — | Google AI Studio officiel |
gemini-4-neon n’apparaît ni dans le tableau récapitulatif ni dans l’interface de tarification d’APIYI : il n’est pas encore disponible, mais nous le mettrons en ligne dès que possible ; les identifiants de modèle et les prix font foi selon la liste de modèles de la plateforme. Les 2/10 USD indiqués pour gemini-4-carbon dans le tableau correspondent au prix de vente actuel d’APIYI, identique au tarif de lancement de Google valable jusqu’au 2026-11-30, et différent du tarif standard de 4/20 USD appliqué ensuite par Google.
Les noms de groupes de claude-fable-5-2 diffèrent entre les deux sources ; voici les deux listes : le tableau récapitulatif d’APIYI indique ClaudeCode, Claude_Reverse, Claude_Enterprise, Default et SVIP ; les identifiants de groupe de l’interface de tarification sont ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default et svip. Au moment de configurer les groupes, fiez-vous à ce que renvoie réellement l’interface que vous appelez.
Comment appeler Claude Fable 5.2 via APIYI : prise en main rapide
APIYI propose une interface compatible avec OpenAI. Pour appeler claude-fable-5-2, il suffit de modifier base_url et le nom du modèle. Voici la marche à suivre :
- Récupérez une clé API sur APIYI et placez-la dans une variable d’environnement, par exemple
APIYI_API_KEY. Ne faites pas apparaître la clé en clair dans le code. - Dans le SDK OpenAI, définissez base_url sur
https://api.apiyi.com/v1. L’initialisation du client peut s’écrire ainsi :OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"]). - Envoyez la requête :
client.chat.completions.create(model="claude-fable-5-2", messages=[{"role": "user", "content": "..."}]). Si vous avez besoin de la version avec réflexion, remplacez le nom du modèle parclaude-fable-5-2-thinking. Les deux sont au même prix : 8 USD en entrée, 0.2 USD pour la lecture du cache et 40 USD en sortie, par million de tokens. - Si votre projet utilise le format de requête de style Anthropic, vous pouvez passer par le point de terminaison messages ; le modèle et le prix restent inchangés.
- La série Gemini peut être appelée nativement : l’adresse est
https://api.apiyi.com, la version d’API estv1beta, et les modèles disponibles incluentgemini-4-carbonetgemini-4-hydrogen.
Une fois l’intégration en place, je vous conseille de consigner dans les journaux de requêtes, pour chaque appel, les tokens d’entrée, les tokens de sortie et la durée totale. Vous pourrez ainsi calculer un coût par tâche à partir de vos propres cas d’usage, puis le comparer aux 26.54 USD d’Artificial Analysis. Attention toutefois : la composition des tâches n’est pas la même de chaque côté.
🚀 Démarrage rapide : après inscription sur APIYI (apiyi.com), les nouveaux utilisateurs reçoivent un crédit d’essai gratuit. Vous pouvez commencer par lancer quelques échantillons métier réels avec
claude-fable-5-2, noter la consommation de tokens et le temps d’exécution, puis choisir le palier et le budget.
Recommandation : choisir entre Gemini 4 Neon et Claude Fable 5.2 d’après le tableau
💡 Conseil de choix : déterminez d’abord ce qui compte le plus pour votre activité — le score d’intelligence, le coût par tâche ou le délai avant le premier token — puis cherchez la colonne correspondante dans le tableau et vérifiez le palier.
- Vérifier le palier : le score d’intelligence correspond à Fable max et à Neon xhigh ; l’indice de codage correspond à xhigh des deux côtés. Si vous passez en production avec d’autres paliers, il faut aller rechercher les données du palier concerné.
- Vérifier la base de mesure : les données déclarées par l’éditeur lui-même, celles des fiches modèle, des articles d’Artificial Analysis et des pages modèle d’Artificial Analysis doivent chacune conserver leur source ; ne les convertissez pas les unes en les autres.
- Vérifier les paramètres d’appel : d’après le guide développeur de Google Cloud, Neon ne propose que quatre paliers de réflexion — low, medium, high et xhigh ; passer
thinking_budgetouMINIMALrenvoie une erreurHTTP 400. Neon ne prend pas en charge le cache de contexte explicite ; le cache implicite s’active automatiquement pour les préfixes partagés de plus de 4096 tokens. - Retester avec vos propres tâches : les données publiques ne servent qu’à réduire le champ des choix ; le coût et la latence finaux doivent être mesurés sur vos propres échantillons.
FAQ — Questions fréquentes
Q1 : Qu’est-ce que Gemini 4 Neon ?
Gemini 4 Neon est un modèle publié par Google le 18/11/2026. D’après sa fiche modèle, il est dérivé de Gemini 4 Carbon, ses connaissances s’arrêtent à mars 2026, il accepte les entrées texte, image, audio et vidéo, et sa fenêtre de contexte unifiée peut atteindre 1 million de tokens. Dans la gamme de produits Google, Neon se situe entre Hydrogen (exécution rapide au quotidien) et Carbon (tâches longues et complexes).
Q2 : Les chiffres d’Opus 5.5 dans la fiche modèle de Gemini 4 Neon peuvent-ils représenter Claude Fable 5.2 ?
Non. La fiche modèle ne contient que trois colonnes — Neon, Opus 5.5 et GPT-6.2 Sol — sans Fable 5.2, et les résultats des modèles non-Gemini proviennent par défaut des déclarations de chaque éditeur. Les données qu’on peut citer pour Fable 5.2 sont le score d’intelligence, le coût, la durée, la vitesse et l’indice de codage indiqués sur la page du modèle Artificial Analysis et dans l’article.
Q3 : Quand Gemini 4 Neon est-il disponible et sur quels canaux ?
D’après la publication de Sundar Pichai (déclaration officielle de l’éditeur), Neon est déployé à partir du 18/11/2026 sur les canaux suivants : l’API Gemini de Google AI Studio, Gemini for business, Google Antigravity dans les offres payantes Google AI Pro et Ultra, ainsi que l’application Gemini App en versions Pro et Ultra. L’ID de modèle indiqué dans le guide développeur Google Cloud est `gemini-4-neon`.
Q4 : Les deux affichent 110 tokens/seconde en sortie, alors pourquoi le temps par tâche diffère-t-il ?
La page du modèle Artificial Analysis donne des résultats agrégés : les durées sont respectivement de 21,5 minutes et 41,6 minutes, et les temps jusqu’au premier token de 56,51 secondes et 247,46 secondes. La page ne détaille pas les raisons de cet écart. Ce qui est certain, c’est qu’une vitesse de sortie identique n’implique pas un temps total identique, et que l’attente du premier token fait aussi partie du temps total.
Q5 : Comment appeler rapidement Claude Fable 5.2 via l’API ?
Après avoir récupéré une clé sur APIYI apiyi.com, utilisez l’adresse compatible OpenAI donnée plus haut comme base_url, indiquez `claude-fable-5-2` ou `claude-fable-5-2-thinking` comme nom de modèle, et les deux endpoints chat et messages fonctionnent. Les tarifs sont de 8 en entrée, 0,2 en lecture de cache et 40 en sortie par million de tokens ; les noms de groupes suivent la notation du tableau récapitulatif et de l’interface de tarification.
Q6 : Un prix unitaire bas implique-t-il un coût par tâche bas ?
Les deux ne sont pas directement équivalents. Sur la page du modèle Artificial Analysis, le prix affiché de GPT-6.2 Astra est de 8,00/40,00 dollars, mais le coût par tâche en mode max n’est que de 4,00 dollars, car il génère bien moins de tokens lors de l’exécution de l’indice. Le coût par tâche est déterminé conjointement par le prix unitaire et le nombre de tokens consommés.
Q7 : Quelles sont les limitations connues de Gemini 4 Neon ?
– **Tarification** : pas d’offre gratuite sur AI Studio, seule la mise en cache implicite est prise en charge.
– **Paramètres** : passer `thinking_budget` ou `MINIMAL` renvoie `HTTP 400`, et la mise en cache explicite du contexte n’est pas prise en charge.
– **Longueur de sortie** : par défaut, une sortie unique est limitée à 65536 tokens ; le décodage long est plafonné à 1048576 moins la longueur de l’entrée.
– **Version cybersécurité** : la version cybersécurité ne sera ouverte que quelques jours plus tard, et uniquement aux défenseurs de confiance du Fairwind Program, sans ID de modèle public (déclaration officielle de l’éditeur).
Gemini 4 Neon vs Claude Fable 5.2 : points clés (Key Takeaways)
- Le score d’intelligence dépend du palier : sur la page modèle d’Artificial Analysis, Neon xhigh affiche 61 et Fable max 65.
- Le coût par tâche se lit séparément : 6.44 $ pour Neon xhigh, 26.54 $ pour Fable max, avec des durées de 21.5 et 41.6 minutes.
- La latence se juge au temps du premier token : les deux affichent une vitesse de sortie de 110 token/s, avec un temps jusqu’au premier token de 56.51 s et 247.46 s.
- L’indice de codage note un autre palier : 59 pour Neon xhigh, 58 pour Fable xhigh, avec un coût par tâche de codage de 6.86 $ et 15.47 $.
- La fiche modèle n’inclut pas Fable : les sous-scores d’Opus 5.5 dans la fiche modèle ne doivent pas être pris pour les données de Fable 5.2.
- Chaque mesure garde son propre référentiel : 32 %, environ 17 %, 4.90 $, 58.6 et 59 relèvent de comptes différents.
- Point d’accès :
claude-fable-5-2est déjà disponible sur APIYI,gemini-4-neonne l’est pas encore.
Résumé
En comparant Gemini 4 Neon et Claude Fable 5.2, trois points méritent votre attention :
- Le compte de l’intelligence : sur la page modèle d’Artificial Analysis, c’est 61 contre 65, avec des paliers respectifs Neon xhigh et Fable max.
- Le compte coût et latence : coût par tâche de 6.44 contre 26.54 $, durée par tâche de 21.5 contre 41.6 minutes, temps jusqu’au premier token de 56.51 contre 247.46 secondes, et les deux avec une vitesse de sortie de 110 token/s.
- Le compte du codage : les deux en palier xhigh, indice de 59 contre 58, coût par tâche de 6.86 contre 15.47 $, dans des environnements d’exécution respectifs Antigravity CLI et Claude Code.
Le choix du modèle dépend du « compte » qui pèse le plus dans votre activité. Je vous conseille d’abord de réduire le champ avec les données publiques, puis de retester coûts et latence sur vos propres échantillons. Vous pouvez commencer par tester claude-fable-5-2 sur APIYI apiyi.com avec le quota gratuit ; une fois gemini-4-neon disponible, il suffira de changer le nom du modèle dans la même interface pour comparer directement.
📚 Références
-
Post de Sundar Pichai : annonce de Gemini 4 Neon et canaux de déploiement (auto-déclaration officielle)
- Lien :
x.com/sundarpichai/status/2123167780988125621
- Lien :
-
Blog Google Introducing Gemini 4 Neon : évaluations, prix et positionnement tels qu’annoncés officiellement
- Lien :
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon
- Lien :
-
Fiche modèle DeepMind : tableau comparatif à trois colonnes et spécifications du modèle
- Lien :
deepmind.google/models/model-cards/gemini-4-neon/
- Lien :
-
Guide développeur Google Cloud : ID du modèle, niveaux de réflexion et règles de cache
- Lien :
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon
- Lien :
-
Page tarifaire Google AI Studio : prix payants de gemini-4-neon
- Lien :
aistudio.google.com/docs/pricing
- Lien :
-
Article Artificial Analysis : score d’intelligence de Neon, coûts et indice de codage
- Lien :
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain
- Lien :
-
Page modèle Artificial Analysis : données par paliers de Neon et Fable 5.2
- Lien :
artificialanalysis.ai/models/gemini-4-neon - Lien :
artificialanalysis.ai/models/claude-fable-5-2
- Lien :
-
Tableau récapitulatif et API de tarification APIYI : modèles déjà disponibles, groupes et prix
- Lien :
docs.apiyi.com/models.md - Lien :
api.apiyi.com/api/pricing
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter via la page d’accueil du site APIYI ; pour plus de ressources, consultez le centre de documentation docs.apiyi.com