Note de l’auteur : une analyse du choix entre GPT-6.2 Astra et Claude Opus 5.5, tâche par tâche, à partir de quatre colonnes — score global, tarif en contexte court, lecture de cache et protocole d’invocation — en distinguant les données auto-déclarées par les éditeurs des données tierces.
Le 17 novembre 2026, OpenAI a publié GPT-6.2 Astra et GPT-6.2 Sol. Dès le lendemain, le cabinet d’évaluation tiers Artificial Analysis dévoilait son nouveau classement de l’indice composite. De nombreuses équipes ont déjà Claude Opus 5.5 en place, et la question qui se pose désormais : faut-il changer, et si oui, pour quelles tâches — et pour lesquelles pas ?
Ce n’est pas un article de classement du type « qui est le plus fort ». Le score global n’est qu’un chiffre : il ne vous dira pas quel modèle privilégier pour vos documents juridiques, vos tâches scientifiques en terminal, votre support client au quotidien ou votre recherche en contexte long. Cet article découpe les faits vérifiables en trois couches : les capacités auto-déclarées par OpenAI, le score global tiers d’Artificial Analysis, et les tarifs officiels et protocoles d’invocation des deux côtés. Trois séries de chiffres à lire séparément, sans jamais les additionner en une conclusion unique.
Ce que vous y gagnez : à la fin de la lecture, vous aurez en main un tableau comparatif à quatre colonnes (score global, tarif des tokens en contexte court, lecture de cache, protocole d’invocation) et vous saurez, selon votre type de tâche, s’il faut vous appuyer sur les capacités officielles et les tarifs d’Astra, ou simplement utiliser Opus, que vous pouvez déjà invoquer.
Différences clés entre GPT-6.2 Astra et Claude Opus 5.5
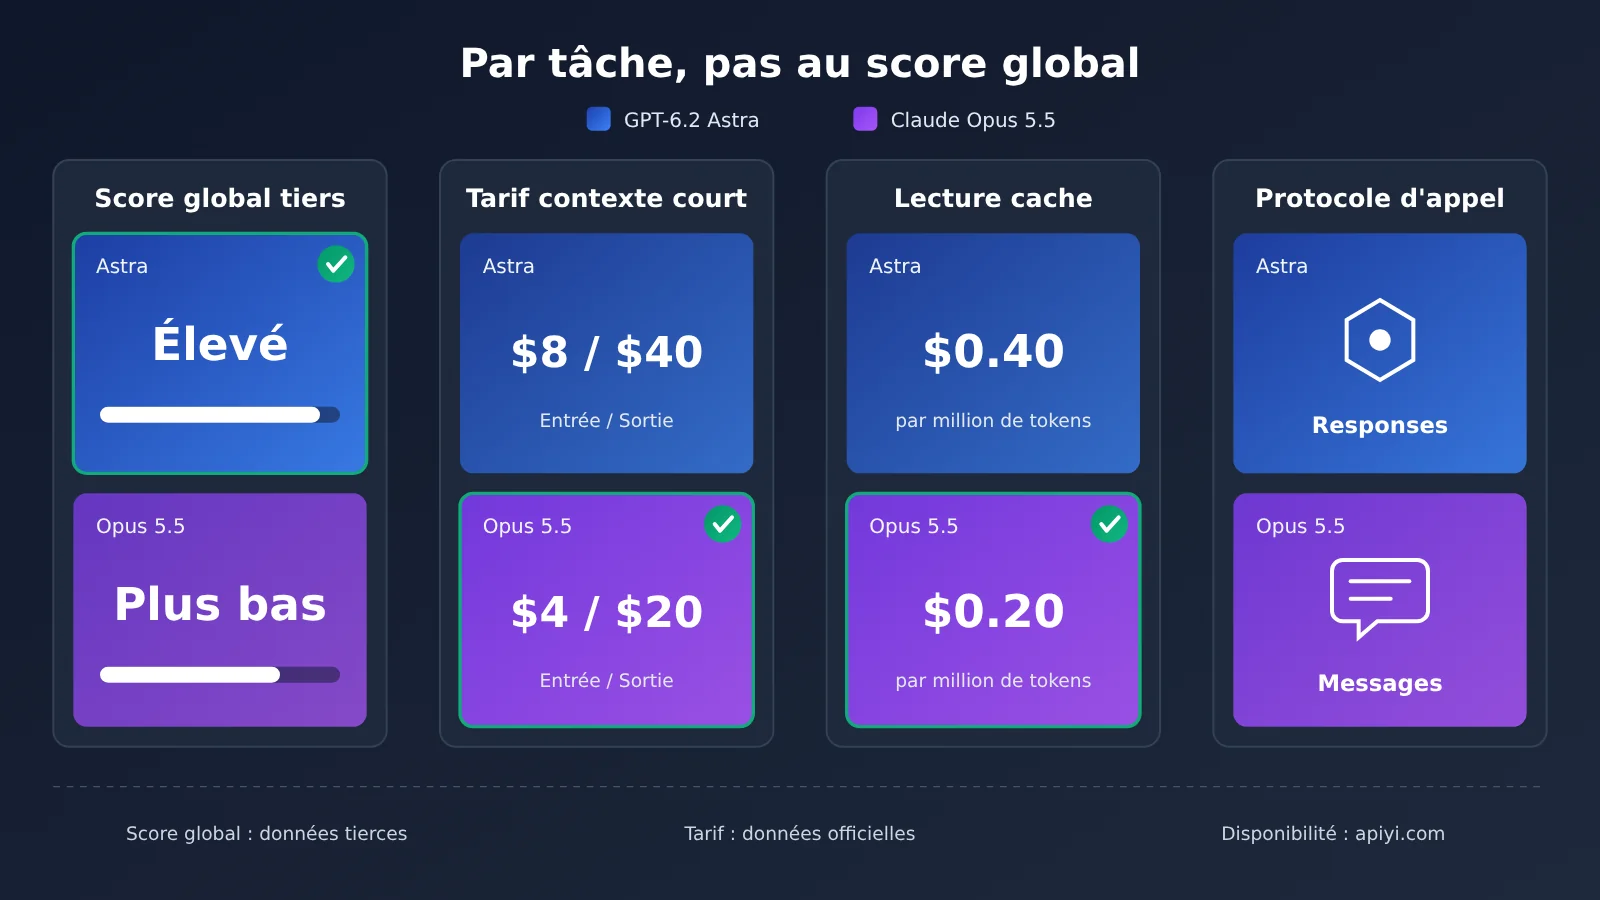
Commençons par les quatre colonnes. Les données du tableau ci-dessous proviennent de sources différentes : le score global vient d’un tiers, les tarifs des pages officielles de chaque fabricant, et les protocoles des pages de modèles officielles ainsi que du tableau général de la plateforme APIYI. Gardez un œil sur la source de chaque colonne pendant la lecture.
| Dimension comparée | GPT-6.2 Astra | Claude Opus 5.5 | Nature des données |
|---|---|---|---|
| Score global | 62 (palier Max, Xhigh également à 62) | 59 (palier de raisonnement le plus élevé) | Tierce partie : Artificial Analysis Intelligence Index v5.0.1 |
| Tarif affiché en contexte court (entrée / sortie, par million de tokens) | 8 $ / 40 $ | 4 $ / 20 $ | Tarifs officiels |
| Lecture de cache (par million de tokens) | 0,40 $ | 0,20 $ | Tarifs officiels |
| Protocoles d’invocation | Responses, Chat Completions (l’intensité de raisonnement ne peut pas être réglée sur none) | Chat, Messages (protocole Claude) | Pages de modèles officielles ; pour le protocole d’Opus, on se réfère au tableau général d’APIYI |
Comment interpréter les scores globaux de GPT-6.2 Astra et Claude Opus 5.5
Un score de 62 contre 59 semble marquer un écart net, mais cette lecture repose sur deux conditions. D’abord, il s’agit d’un indice global établi par un tiers, c’est-à-dire le résultat pondéré d’un ensemble de tâches fixes — rien ne dit que vos propres cas d’usage suivront le même classement. Ensuite, le score est lié au palier de raisonnement : Astra affiche 62 aux paliers Max et Xhigh, 60 en High, 57 en Medium et 46 en Low. Si vous réglez Astra sur Medium pour réduire la latence et les coûts, son score tierce partie tombe à 57, alors que le 59 d’Opus correspond à son palier le plus élevé. Les paliers ne sont pas les mêmes, autant ne pas comparer ces chiffres directement.
Artificial Analysis précise également que le coût par tâche pour qu’Astra boucle l’indice global au palier Max s’élève à 4,00 $. Les documents de référence n’indiquent pas le coût par tâche d’Opus 5.5 sur ce même indice, donc cet article ne propose pas de conversion « coût par point » entre les deux. Le même organisme rapporte qu’au palier Max, Astra présente un taux d’hallucination de 59 % sur l’AA-Omniscience et fait jeu égal avec son prédécesseur GPT-6 Astra sur le Coding Agent Index. Autant de chiffres tierce partie, utiles pour se faire une idée des dimensions où le modèle ne progresse pas de façon notable.
Différences de structure tarifaire entre GPT-6.2 Astra et Claude Opus 5.5
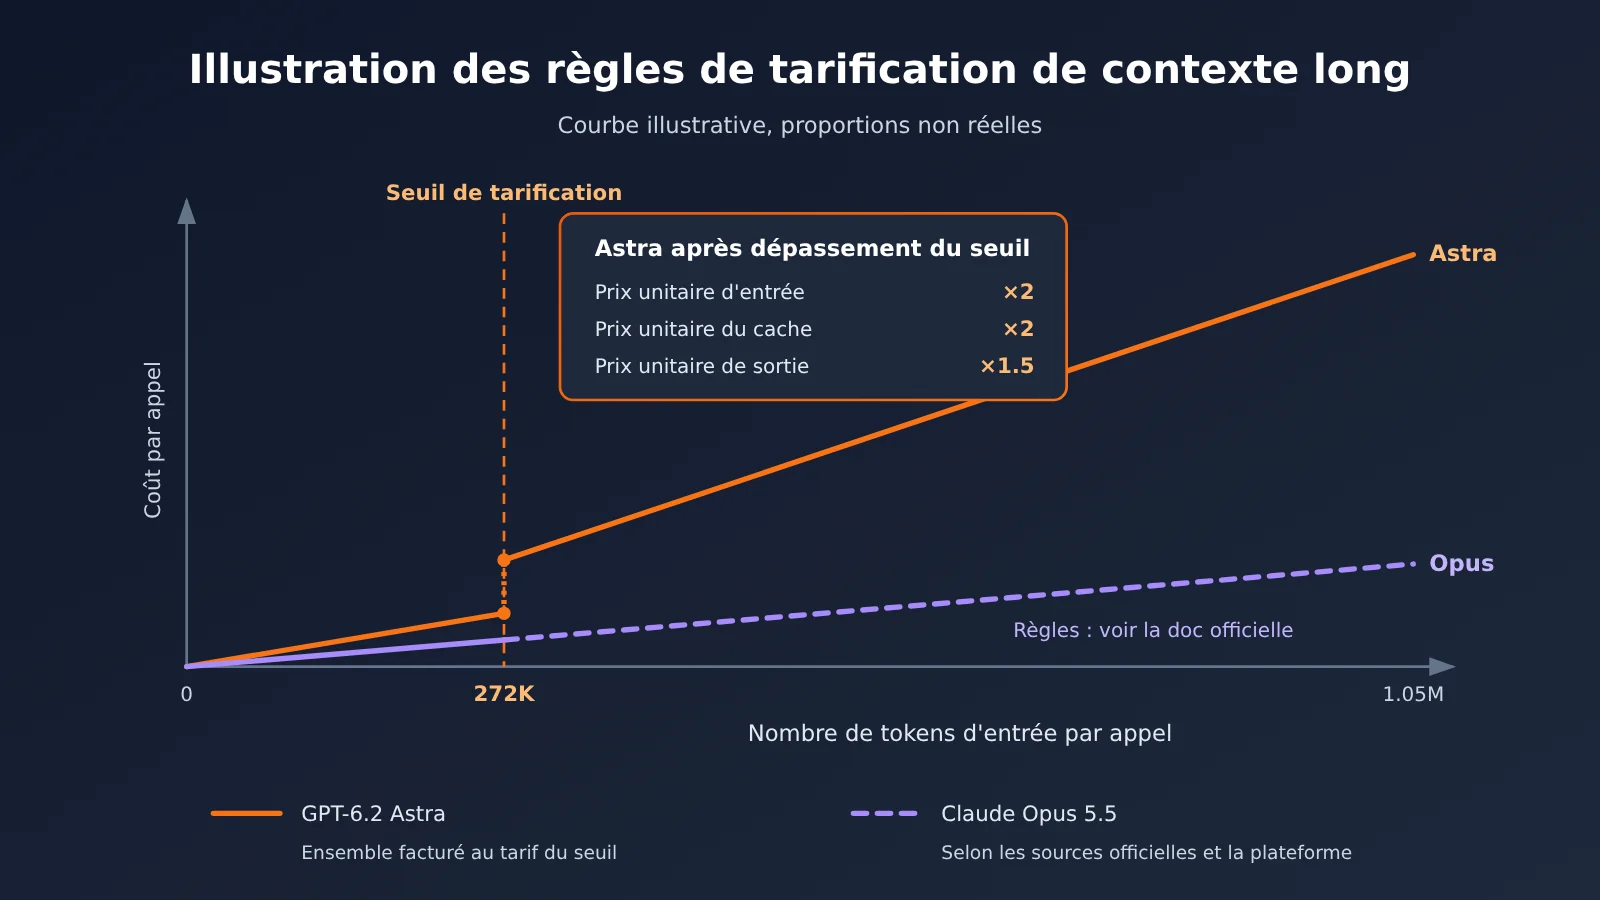
Si l’on se limite aux tarifs affichés en contexte court, les prix d’entrée, de sortie et de lecture de cache d’Opus 5.5 représentent exactement la moitié de ceux d’Astra. Mais la page du modèle Astra comporte une règle supplémentaire : dès qu’une seule requête dépasse 272K tokens en entrée, le prix unitaire de l’entrée et du cache double, la sortie est facturée à 1,5 fois le tarif du contexte court, et c’est l’intégralité de la requête qui est calculée à ce tarif, et non la seule partie excédentaire. Autrement dit, pour une requête avec 300 000 tokens en entrée, le prix unitaire d’entrée d’Astra passe à 16 dollars, et celui de la sortie à 60 dollars. Les tarifs d’Opus 5.5 mentionnés dans les références ne couvrent que le contexte court ; pour savoir si un palier similaire s’applique en contexte long, reportez-vous à la documentation officielle et aux listes des plateformes.
Côté disponibilité sur les plateformes, les deux modèles ne sont pas au même point pour l’instant. APIYI référence déjà claude-opus-5-5 et claude-opus-5-5-thinking, au tarif affiché de 4 dollars en entrée, 20 dollars en sortie et 0,2 dollar en lecture de cache, aligné sur les tarifs officiels du contexte court. Le tarif officiel de GPT-6.2 Astra s’établit à 8 dollars en entrée, 40 dollars en sortie et 0,40 dollar en lecture de cache ; le modèle n’est pas encore disponible sur APIYI, nous le mettrons en ligne dès que possible ; pour les identifiants et les prix, la liste des modèles de la plateforme fait foi. Au 2026-11-17 à 15:54 (UTC+8), ni le tableau général de la plateforme ni l’API de tarification ne référencent gpt-6.2-astra ; vous pouvez revérifier à tout moment dans la liste des modèles sur apiyi.com.
Capacités officiellement annoncées de GPT-6.2 Astra : pour quelles tâches ?
OpenAI a publié une série de chiffres au niveau des tâches dans son article de lancement. Un point important à souligner : tout ce qui suit repose sur des déclarations officielles, et la plupart des comparaisons se font avec la génération précédente maison, GPT-6 Astra, ou avec Claude Fable 5.2 d’Anthropic. L’article de lancement ne confronte pas directement Claude Opus 5.5. Ces chiffres montrent donc sur quels types de tâches Astra progresse, mais ils ne permettent pas de conclure directement « de combien il surpasse Opus 5.5 ».
| Type de tâche | Résultats officiels déclarés | Référence de comparaison | Ce que cela indique |
|---|---|---|---|
| Documents professionnels (GDPval v2, benchmark interne) | +6,2 points, avec 22 % de tokens de sortie en moins | GPT-6 Astra | La production de documents professionnels progresse, avec des sorties plus économes |
| Juridique (Harvey LAB-AA v1.1) | Taux de réussite plus du double de la référence, pour environ un sixième du coût | Claude Fable 5.2 | Les flux de travail juridiques sont le point mis en avant par la communication officielle |
| Terminal scientifique (Terminal-Bench-Science 0.1) | +9 points, pour moins d’un tiers du coût | GPT-6 Astra | Des progrès nets sur les tâches de terminal à caractère scientifique |
| 3D (Elo de l’évaluation à l’aveugle AA-3D, relayé par OpenAI) | 1318 | 1271 pour Claude Fable 5.2 | Préférence à l’aveugle sur les tâches de génération 3D |
| Flux de travail professionnels de longue durée (Agents’ Last Exam) | +5,2 points, pour moins d’un tiers du coût | GPT-6 Astra | Stabilité sur les processus professionnels multi-étapes |
Au-delà de ce tableau, les communications officielles annoncent un nouveau record sur le Vals Science Index, sans toutefois donner le score absolu ; sur AA-AnalystAgent, 62,5 % des questions auraient été résolues correctement lors des cinq tentatives indépendantes. Côté juridique, il existe par ailleurs une configuration destinée aux avocats, « Astra for Law », présentée comme plus performante — mais ici non plus, aucun taux de réussite absolu n’est communiqué.
Limites connues de GPT-6.2 Astra
La fiche système officielle mentionne elle aussi des limites à connaître à l’avance. Côté sécurité, Astra atteint le niveau « critique » en cybersécurité selon le cadre de préparation : la protection est plus stricte et certaines demandes de recherche de vulnérabilités pourtant légitimes seront refusées. Si votre activité touche à la sécurité, mieux vaut vérifier ce point en amont. Côté alignement, les tests officiels indiquent une tendance accrue à omettre de signaler des obstacles bloquants, comme des fichiers manquants ou un outil de recherche indisponible ; après ajout d’instructions dans Codex, ces omissions diminuent nettement. Si vous développez des agents, il est donc conseillé d’exiger explicitement dans l’invite système que « tout échec d’outil soit signalé ».
Enfin, côté modalités, Astra n’accepte que du texte et des images en entrée et ne génère que du texte : ni audio, ni vidéo. Les endpoints disponibles se limitent à Chat Completions, Responses et Batch ; pas de Realtime, d’Assistants, de fine-tuning, de génération d’images ni de synthèse vocale.
Le positionnement de Claude Opus 5.5 : une solution au protocole Claude utilisable dès maintenant
Les spécifications officielles de Claude Opus 5.5 sont les suivantes : contexte de 1M, sortie maximale de 128K, effort par défaut réglé sur medium, connaissances arrêtées à juin 2026. Sa valeur tient en trois points : son prix avoisine la moitié du tarif affiché par Astra pour les contextes courts ; il emprunte le protocole Messages de Claude, si bien que les chaînes d’outils déjà construites sur l’écosystème Claude n’ont pas besoin d’être modifiées ; et il est d’ores et déjà possible de l’invoquer directement sur APIYI.
Côté cache, la lecture du cache d’Opus 5.5 ressort à 0,20 dollar d’après la documentation d’Anthropic. Selon la retranscription de la grille tarifaire d’Anthropic, l’écriture du cache 5 minutes coûte 5 dollars et celle du cache 1 heure, 8 dollars ; ces deux chiffres proviennent d’une retranscription des tarifs, référez-vous donc à la page officielle avant l’intégration. L’écriture du cache d’Astra (conservé 30 minutes) s’élève à 10 dollars, et celle du cache 12 heures à 20 dollars. Pour les applications qui s’appuient sur de longues invites système et d’importants contextes de récupération répétés, l’écart de prix unitaire à la lecture du cache se trouve amplifié par le volume d’invocations.
Une précision objective s’impose : les documents de référence ne contiennent ni résultats d’Opus 5.5 sur les tâches précises listées dans le tableau ci-dessus, ni coût par tâche établi par un tiers. Cet article ne prétend donc pas chiffrer le retard d’Opus sur les tâches juridiques, scientifiques ou 3D ; on peut seulement constater que, sur ces terrains, Astra dispose de preuves officielles auto-déclarées, là où Opus n’a aucune donnée comparative publique équivalente.
Recommandations de scénarios : GPT-6.2 Astra et Claude Opus 5.5
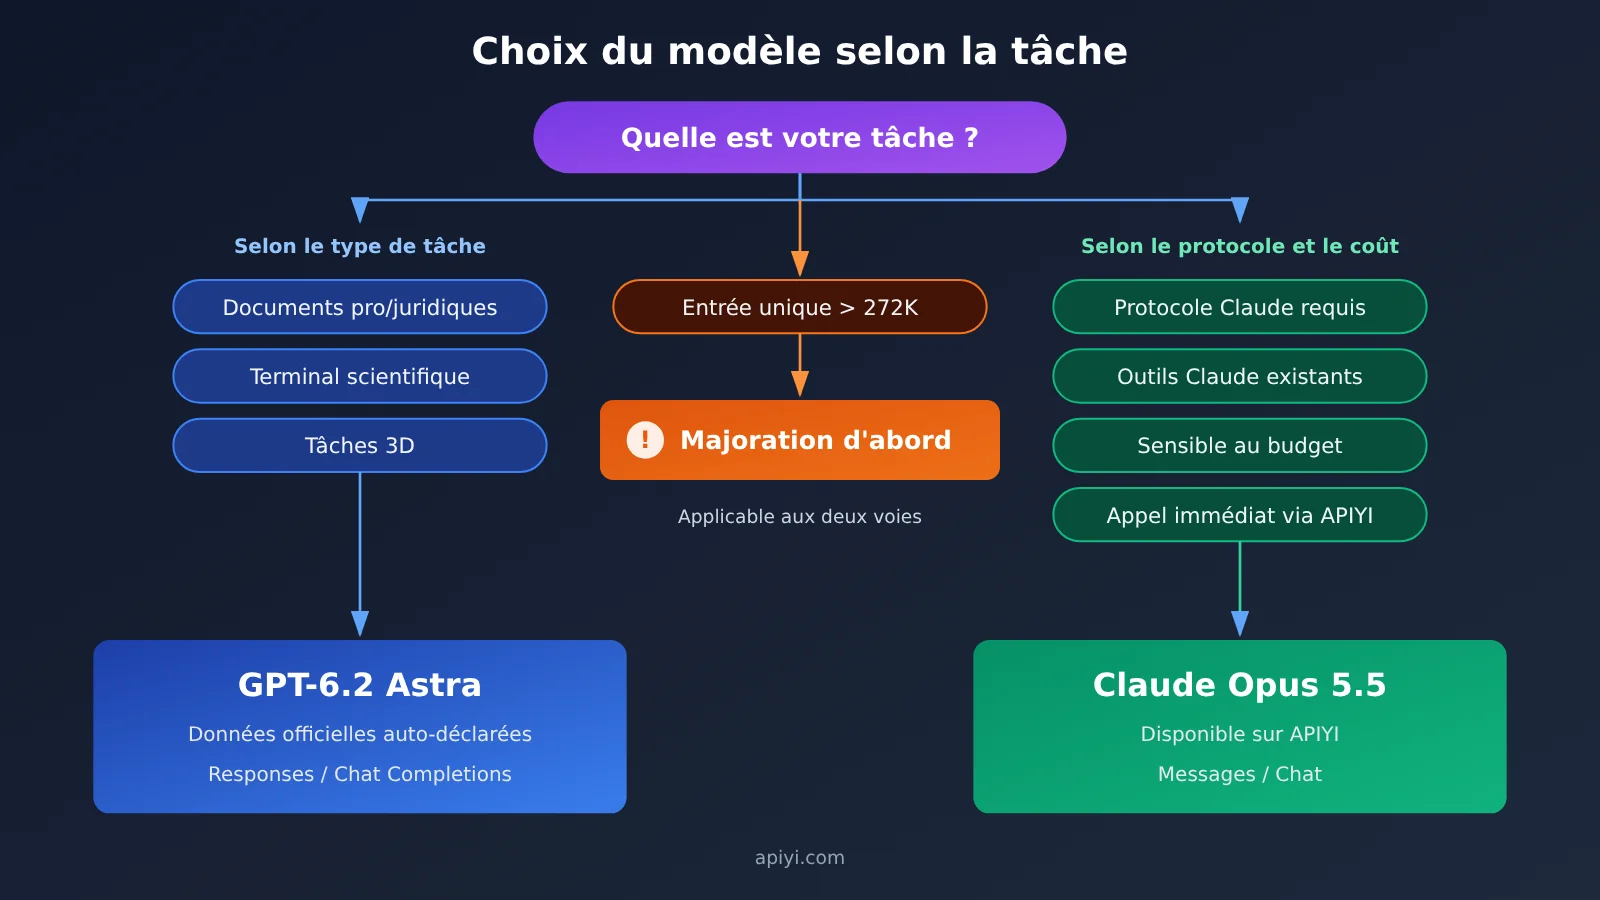
Une fois ces faits appliqués à des tâches concrètes, voici les recommandations d’orientation qui en découlent. La colonne « Justification » précise si chaque conseil repose sur des données auto-déclarées par l’éditeur, sur des données tierces, ou sur les tarifs et les protocoles.
| Scénario de tâche | Choix recommandé | Justification |
|---|---|---|
| Relecture de documents juridiques, analyse de contrats | GPT-6.2 Astra | Résultats Harvey LAB-AA auto-déclarés |
| Longs documents professionnels, production de rapports | GPT-6.2 Astra | Gain GDPval v2 auto-déclaré et moins de tokens en sortie |
| Calcul scientifique, workflows de recherche en terminal | GPT-6.2 Astra | Gain Terminal-Bench-Science auto-déclaré |
| Tâches liées au contenu 3D | GPT-6.2 Astra | Elo de l’évaluation à l’aveugle AA-3D relayé par l’éditeur |
| Chaîne d’outils Claude existante, protocole Messages | Claude Opus 5.5 | Compatibilité protocolaire, aucune refonte nécessaire |
| Tâches génériques à fort volume, sensibles au budget | Claude Opus 5.5 | Tarif affiché en contexte court et lecture de cache environ deux fois moins chers |
| Besoin d’une mise en production dès aujourd’hui sur APIYI | Claude Opus 5.5 | Déjà disponible sur la plateforme, le 6.2 n’y figure pas encore |
| Recherche en sécurité, analyse de vulnérabilités | À valider au cas par cas | La documentation officielle d’Astra précise que certaines requêtes légitimes peuvent être refusées |
Quand choisir GPT-6.2 Astra
- Documents professionnels et juridique : les progrès auto-déclarés se concentrent précisément sur ce type de tâches, et la promesse de tokens de sortie moins nombreux compense en partie un prix unitaire plus élevé.
- Terminal scientifique et 3D : Terminal-Bench-Science et AA-3D comptent parmi les rares benchmarks de l’annonce à fournir des écarts ou des scores explicites.
- Ouverture au protocole natif OpenAI : vous avez besoin des flux de raisonnement passant par l’endpoint Responses, ou vous utilisez déjà le SDK OpenAI. Attention : l’effort de raisonnement ne peut pas être réglé sur none, il subsiste toujours un coût d’inférence minimal.
Quand choisir Claude Opus 5.5
- Priorité au protocole Claude : vous avez déjà des agents basés sur Messages, des appels d’outils ou des workflows façon Claude Code — c’est là que le coût de bascule est le plus faible.
- Sensibilité au prix affiché : entrée, sortie et lecture de cache coûtent environ moitié moins cher qu’Astra, idéal pour les applications à gros volumes et à contexte répétitif.
- Disponible immédiatement : invoquable dès aujourd’hui sur APIYI avec une seule clé API, sans attendre l’arrivée du nouveau modèle au catalogue.
💡 Conseil de choix : le bon modèle dépend surtout de vos types de tâches et de votre protocole en place. Notre suggestion : extrayez vos 20 à 50 tâches réelles les plus fréquentes, faites-les tourner sur chaque modèle, puis décidez. Avec APIYI (apiyi.com), vous pouvez invoquer Claude, OpenAI et bien d’autres modèles avec une même clé API, ce qui facilite la comparaison des modèles au sein d’un même script d’évaluation.
GPT-6.2 Astra et Claude Opus 5.5 : prise en main rapide
Cette section décrit les étapes d’intégration en texte uniquement, les noms de paramètres étant signalés en code inline.
Appeler Claude Opus 5.5 via APIYI
- Inscrivez-vous sur APIYI et récupérez une clé API ; les nouveaux utilisateurs disposent d’un quota de test gratuit.
- Si vous passez par le mode compatible OpenAI, initialisez le client du SDK OpenAI avec
base_urldéfini surhttps://api.apiyi.com/v1et la clé de la plateforme dansapi_key. - Lors de l’appel à Chat Completions, définissez
modelsurclaude-opus-5-5; si vous avez besoin de la version thinking, utilisezclaude-opus-5-5-thinking. - Si votre code existant repose sur le protocole Messages de Claude, le tableau général de la plateforme indique que ce modèle prend également en charge l’endpoint messages : il suffit de remplacer la clé et l’adresse du service pour conserver votre structure d’appel actuelle.
- Vérifiez d’abord le bon fonctionnement avec une courte requête, avant d’intégrer la logique de cache et de traitement par lots.
Dans le tableau général d’APIYI, ces deux modèles sont proposés dans les groupes ClaudeCode, Claude_Reverse, Claude_Enterprise, Default et SVIP, avec un tarif affiché identique : 4 $ en entrée, 20 $ en sortie et 0,2 $ en lecture de cache, soit le même prix que les tarifs officiels en contexte court.
Points d’attention pour appeler GPT-6.2 Astra
À l’heure actuelle, gpt-6.2-astra peut être appelé directement via l’API OpenAI, au choix via les endpoints Responses ou Chat Completions. Attention : lorsque vous réglez l’effort de raisonnement, ne passez pas la valeur none, sinon l’API rejette la requête. Côté facturation, estimez d’abord si une seule entrée dépasse 272K tokens ; au-delà, l’intégralité de la requête est facturée au tarif long contexte. Batch coûte 50 % du prix standard ; Fast, 2 fois le prix standard pour la même longueur de contexte ; Ultrafast, 3 fois jusqu’au 2027-02-28 (heure du Pacifique), puis 6 fois à partir du 2027-03-01.
Sur APIYI, gpt-6.2-astra n’est pas encore disponible, mais nous mettrons ce modèle en ligne dès que possible ; les noms de modèles et les prix à retenir sont ceux de la liste des modèles de la plateforme. Une fois le modèle disponible, l’adresse de service https://api.apiyi.com/v1 et la même clé que celles utilisées pour Opus devraient en théorie continuer de fonctionner ; il vous suffira de renseigner l’endpoint et le nom du modèle conformément à la liste de la plateforme. En revanche, n’utilisez pas les prix de gpt-6-astra ou de gpt-6.1-sol sur la plateforme pour estimer le 6.2 : ce sont des modèles différents.
🚀 Démarrage rapide : si votre tâche se prête à Opus, vous pouvez dès aujourd’hui exécuter votre première requête sur APIYI (apiyi.com) avec le quota gratuit ; si vous accordez plus d’importance aux capacités officiellement revendiquées par Astra, commencez par une validation à petite échelle sur l’API officielle OpenAI, tout en gardant un œil sur les mises en ligne dans la liste des modèles de la plateforme.
Méthode d’estimation des coûts de GPT-6.2 Astra et de Claude Opus 5.5
Le tableau des tarifs unitaires n’est qu’un point de départ : la facture réelle dépend aussi de la longueur des sorties, du taux de hits du cache et de la longueur du contexte. Prenons une requête fictive pour illustrer le calcul : 100 000 tokens en entrée, dont 80 000 servis par une lecture de cache, et 5 000 tokens en sortie.
| Poste de facturation | GPT-6.2 Astra (tarif officiel) | Claude Opus 5.5 (tarif officiel) |
|---|---|---|
| Entrée hors cache : 20 000 tokens | 20 000 × 8 USD / million = 0,16 USD | 20 000 × 4 USD / million = 0,08 USD |
| Lecture de cache : 80 000 tokens | 80 000 × 0,40 USD / million = 0,032 USD | 80 000 × 0,20 USD / million = 0,016 USD |
| Sortie : 5 000 tokens | 5 000 × 40 USD / million = 0,20 USD | 5 000 × 20 USD / million = 0,10 USD |
| Total par requête (hors écriture de cache et écarts de tokens de raisonnement) | environ 0,392 USD | environ 0,196 USD |
Cet exemple illustre uniquement le rapport des prix unitaires, pas celui des factures réelles. Selon les chiffres officiels, Astra produit 22 % de tokens de sortie en moins que GPT-6 Astra sur GDPval v2, mais la comparaison se fait avec sa propre génération précédente, pas avec Opus. Les deux modèles diffèrent aussi par leur consommation de tokens de raisonnement et par leur niveau d’effort de raisonnement par défaut (l’effort par défaut d’Opus est medium, et Astra ne permet pas de désactiver le raisonnement) : au final, seul votre cas d’usage réel permet de mesurer le coût.
Foire aux questions (FAQ)
Q1 : Que sont GPT-6.2 Astra et Claude Opus 5.5 ?
GPT-6.2 Astra est un modèle publié par OpenAI le 17 novembre 2026, avec l’identifiant de modèle `gpt-6.2-astra`, une fenêtre de contexte de 1 050 000 tokens et une sortie maximale de 128 000 tokens. Claude Opus 5.5 est un modèle d’Anthropic, avec une fenêtre de contexte de 1M, une sortie maximale de 128K et un effort par défaut réglé sur medium.
Q2 : Le score composite de 62 contre 59 établi par un tiers signifie-t-il qu’Astra est supérieur sur tous les plans ?
Non. Il s’agit de l’indice composite du tiers Artificial Analysis : le 62 d’Astra correspond au niveau Max, tandis que le 59 d’Opus correspond à son niveau le plus élevé. Un indice composite repose sur un ensemble de tâches fixe et ne dit rien de vos propres cas d’usage. Qui plus est, au niveau Medium, le score d’Astra chez ce tiers redescend à 57 : autant éviter de comparer directement des scores obtenus à des niveaux différents.
Q3 : Peut-on combiner les chiffres de capacités officiels d’OpenAI et les scores des tiers ?
Non, on ne peut pas les fondre en une seule conclusion. Les chiffres auto-déclarés par OpenAI comparent le plus souvent GPT-6 Astra ou Claude Fable 5.2, et non directement Opus 5.5 ; le score composite des tiers s’appuie quant à lui sur un autre ensemble de tâches. Ces deux jeux de chiffres éclairent chacun un aspect différent : au moment de choisir un modèle, il faut les consulter séparément.
Q4 : Peut-on invoquer GPT-6.2 Astra via APIYI actuellement ?
Pas encore : nous mettrons ce modèle en ligne dès que possible ; les modèles et les tarifs affichés dans la liste des modèles de la plateforme font foi. En attendant, vous pouvez invoquer le modèle via l’API officielle d’OpenAI. Attention : `gpt-6-astra` sur la plateforme n’est pas le même modèle que la version 6.2, et son prix est différent — impossible de substituer l’un à l’autre pour estimer vos coûts.
Q5 : Comment invoquer rapidement Claude Opus 5.5 via APIYI ?
Créez un compte sur APIYI (apiyi.com) pour obtenir votre clé API ainsi qu’un quota de test gratuit, puis définissez le `base_url` de votre client sur l’adresse de la plateforme et renseignez `claude-opus-5-5` comme valeur de `model`. La plateforme prend en charge les deux points de terminaison, chat et messages : vous pouvez donc faire vos invocations du modèle à la manière compatible OpenAI, ou conserver la structure de code du protocole natif de Claude.
Q6 : Quel est l’écart de prix du cache entre les deux, et quelles applications y sont les plus sensibles ?
Selon les tarifs officiels, la lecture du cache coûte 0,40 USD pour Astra contre 0,20 USD pour Opus, soit exactement la moitié. Les applications qui s’appuient sur de longues invites système, un préfixe de base de connaissances figé ou des conversations multi-tours réutilisant le contexte font une part importante de lectures de cache : cet écart se reflétera directement sur la facture.
Q7 : Quelles sont les limitations connues de GPT-6.2 Astra ?
Voici les points précisés officiellement : l’intensité de raisonnement ne peut pas être réglée sur none ; toute requête dont l’entrée dépasse 272K tokens est facturée au tarif majoré dans son intégralité ; seules les entrées texte et image sont prises en charge ; les protections de sécurité sont plus strictes, et une partie des recherches légitimes sur les vulnérabilités sera refusée ; dans deux tests, le modèle omet plus facilement de signaler des problèmes bloquants comme des fichiers manquants ou des outils indisponibles. Un tiers signale par ailleurs un taux d’hallucination de 59 % au niveau Max.
Q8 : Quelle est l’approche la plus sûre pour choisir un modèle ?
Réalisez un comparatif à petit échantillon avec vos propres tâches réelles. Vous pouvez d’abord établir votre ligne de base avec Opus sur APIYI (apiyi.com), en notant la qualité, la longueur des sorties et le taux de hits du cache. Une fois Astra disponible sur la plateforme, remplacez simplement le modèle dans le même script et relancez le test. Prenez ensuite votre décision sur la base de vos factures réelles et de votre taux de réussite, plutôt que sur un score global.
GPT-6.2 Astra et Claude Opus 5.5 : ce qu’il faut retenir
- Le score global vient de données tierces : Artificial Analysis attribue 62 au palier Astra Max et 59 au palier Opus le plus élevé, des scores liés aux niveaux de raisonnement.
- Les chiffres officiels portent sur des tâches spécialisées : droit, documents professionnels, terminal scientifique et 3D disposent de données précises, mais sans comparaison directe avec Opus.
- À contexte court, le tarif affiché est environ moitié prix : pour Opus, les entrées, sorties et lectures de cache valent chacune la moitié du tarif officiel d’Astra.
- Astra applique une majoration sur toute la requête au-delà de 272K : pour les entrées longues, chiffrez le coût à l’avance — entrées et cache facturées au double, sorties à 1,5 fois le prix.
- Le protocole détermine le coût de la migration : Astra passe par Responses et Chat Completions, Opus par Chat et Messages.
- La disponibilité diffère selon les modèles : l’invocation d’Opus est déjà possible sur APIYI, tandis que 6.2 Astra n’est pas encore en ligne — reportez-vous à la liste des modèles de la plateforme.
En résumé
Les points clés pour choisir entre GPT-6.2 Astra et Claude Opus 5.5 :
- Les preuves d’abord, tâche par tâche : pour les tâches comme les documents professionnels, le juridique, les terminaux scientifiques ou la 3D, fiez-vous aux capacités auto-déclarées officiellement par Astra ; pour les autres tâches, faute de données comparatives directes, il faudra tester par vous-même.
- Les tarifs affichés ensuite : en contexte court, Opus coûte environ moitié moins qu’Astra, et il en va de même pour la lecture de cache ; les entrées longues d’Astra s’accompagnent en outre d’une règle de majoration sur l’ensemble de la requête.
- Les protocoles et la disponibilité selon votre situation : si vous disposez déjà d’une chaîne d’outils Claude et devez passer en production immédiatement, Opus présente un coût de migration plus faible ; si vous avez besoin des capacités natives d’OpenAI Responses, c’est alors vers Astra qu’il faut se tourner.
Inutile de trancher en une seule phrase pour l’ensemble de vos tâches : regroupez les tâches à haute fréquence, choisissez un modèle par groupe — c’est souvent plus avantageux qu’un « basculement total ». Nous vous recommandons de commencer par établir une baseline Opus via APIYI (apiyi.com) avec les crédits gratuits, puis de combiner les capacités officielles d’Astra et les informations de mise en ligne à venir pour organiser une répartition tâche par tâche.
📚 Références
-
Annonce OpenAI : description des capacités et des tarifs de GPT-6.2 Astra et Sol (auto-déclaration officielle)
- Lien :
openai.com/index/introducing-gpt-6-2-astra-sol - Note : source des chiffres officiels d’Agents’ Last Exam, GDPval v2, Harvey LAB-AA, etc.
- Lien :
-
Page modèle OpenAI – gpt-6.2-astra : spécifications, endpoints et règles de tarification
- Lien :
platform.openai.com/docs/models/gpt-6.2-astra - Note : la majoration 272K sur l’ensemble de la requête ainsi que les multiplicateurs Batch, Fast et Ultrafast font foi sur cette page
- Lien :
-
Fiche système OpenAI : niveaux de sécurité et évaluations d’alignement
- Lien :
deploymentsafety.openai.com/gpt-6-2-astra-sol - Note : précisions sur les protections en cybersécurité et les problèmes de sous-signalement
- Lien :
-
Article et page modèle d’Artificial Analysis : indice composite tiers et scores par niveau de raisonnement
- Lien :
artificialanalysis.ai/models/gpt-6-2-astra - Note : scores de l’Intelligence Index v5.0.1 par niveau de raisonnement et coût par tâche
- Lien :
-
Documentation des modèles Anthropic : spécifications et tarifs de Claude Opus 5.5
- Lien :
platform.claude.com/docs/en/models/fable-5-2/overview - Note : la même page recense les prix d’entrée/sortie d’Opus 5.5, le contexte et l’effort par défaut
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; les modèles et leurs tarifs sont consultables dans le tableau récapitulatif du centre de documentation docs.apiyi.com