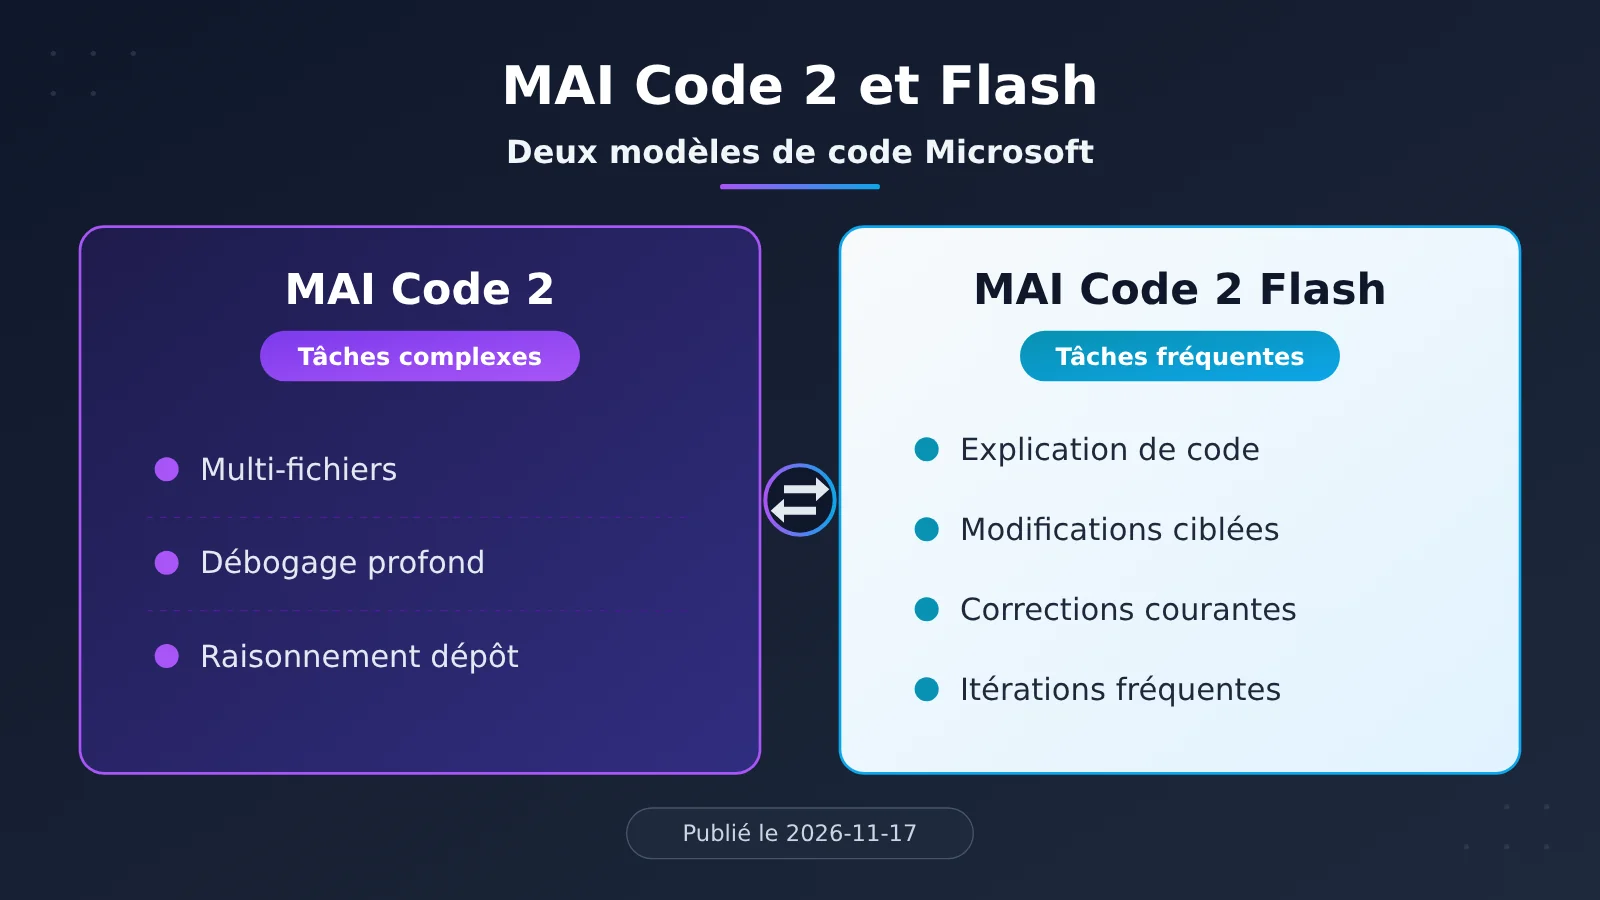
Réponse directe : Microsoft répartit la gamme MAI Code 2 en deux niveaux — l’un pour les tâches complexes, l’autre pour les tâches simples à haute fréquence. Le 17 novembre 2026, Microsoft a publié MAI Code 2 et MAI Code 2 Flash. MAI Code 2 est destiné aux modifications multi-fichiers, au débogage approfondi et au raisonnement à l’échelle du dépôt ; MAI Code 2 Flash vise l’explication de code, les modifications ciblées, les corrections courantes et les itérations à haute fréquence. Pour la plupart des développeurs et des petites équipes, notre recommandation est d’utiliser Flash par défaut pour les petites tâches du quotidien, puis de passer à Code 2 dès qu’il y a des dépendances entre fichiers ou un bug difficile à localiser.
Ce que vous apprendrez en lisant cet article
- Le positionnement officiel des deux niveaux de modèles, et le type de tâches de programmation auquel chacun correspond.
- Les modalités d’entrée et de sortie ainsi que les spécifications de contexte publiées dans les fiches modèles, et la manière d’interpréter ces chiffres.
- Les points d’accès disponibles aujourd’hui, les canaux encore annoncés comme « bientôt disponibles », et la date de fin du tarif promotionnel Copilot.
- Une méthode pratique pour démarrer avec Flash et passer à Code 2 en fonction de signaux observés.
Sommaire : consultez d’abord le tableau des concepts « To Know » et l’aperçu des impacts pour repérer rapidement ce qui vous concerne. La première partie, « Faits objectifs », passe en revue, dans l’ordre, les informations de lancement, le positionnement des deux niveaux, les spécifications des fiches modèles, les points d’accès disponibles, la nature des évaluations et les tarifs promotionnels ; elle ne présente que des éléments sourcés. La deuxième partie, « Analyse et jugement », est un point de vue de la rédaction : elle aborde la signification de cette segmentation, les recommandations de choix, les limites concrètes du contexte long, ainsi que les points à vérifier avant toute intégration API.
MAI Code 2 et Flash : les notions à connaître avant de commencer (To Know)
| Concept | Explication rapide |
|---|---|
| Raisonnement à l’échelle du dépôt | Le modèle doit comprendre la structure de tout le dépôt de code et les dépendances entre fichiers, et pas seulement le fichier ou l’extrait courant |
| Modification ciblée | Apporter une modification de faible portée à un endroit connu, par exemple changer une fonction ou corriger une erreur |
| Fenêtre de contexte | Nombre maximal de tokens que le modèle peut traiter en une seule fois, entrée et sortie comprises |
| Fiche modèle (Model Card) | Document descriptif publié par le fournisseur, qui consigne la portée des capacités, les spécifications, les évaluations et les limites |
| Microsoft Foundry | Plateforme Microsoft destinée aux entreprises pour construire des modèles et applications d’IA, issue de l’ancien ensemble Azure AI Foundry |
| limited-access preview | Aperçu à accès limité : il faut en faire la demande ou remplir certaines conditions pour y accéder, ce n’est pas une ouverture générale |
| Évaluations du fournisseur | Résultats de tests publiés par l’éditeur du modèle lui-même, qui ne valent pas mesure indépendante par un tiers ou par un utilisateur |
MAI Code 2 et Flash : l’essentiel de l’impact de la sortie
| Public concerné | Impact principal |
|---|---|
| Utilisateurs de GitHub Copilot | Les deux modèles sont déjà proposés dans Copilot, mais avec des formules d’abonnement différentes ; il faut vérifier la formule, les politiques de l’organisation et le quota actuel |
| Développeurs indépendants, petites équipes | Une option de plus pour choisir un modèle selon la difficulté de la tâche : les petites modifications quotidiennes n’ont plus besoin d’être confiées à un modèle lourd |
| Entreprises utilisant Azure / Foundry | Flash est en aperçu à accès limité et nécessite de suivre la procédure de demande ; la date d’ouverture officielle fait foi selon l’annonce officielle |
| Développeurs qui appellent via des plateformes tierces | Les canaux comme OpenRouter ou Vercel sont indiqués comme « bientôt disponibles » dans le communiqué ; on ne peut donc pas supposer qu’ils sont déjà utilisables |
I. Faits objectifs : ce que MAI Code 2 et Flash ont réellement publié
1.1 Date de publication et sources d’information de MAI Code 2
Microsoft a publié MAI Code 2 et MAI Code 2 Flash le 17 novembre 2026 via la page d’actualités officielle sur microsoft.ai. Au même moment, Microsoft a détaillé dans le blog de la communauté technique Azure AI Foundry la manière dont les modèles sont proposés côté Foundry, et a rendu public un PDF de fiche de modèle (model card) commun aux deux modèles. Cet article recoupe également le journal des modifications officiel sur GitHub et la documentation de facturation, avec une date d’arrêté au 18 novembre 2026.
1.2 MAI Code 2 et Flash : deux niveaux de positionnement
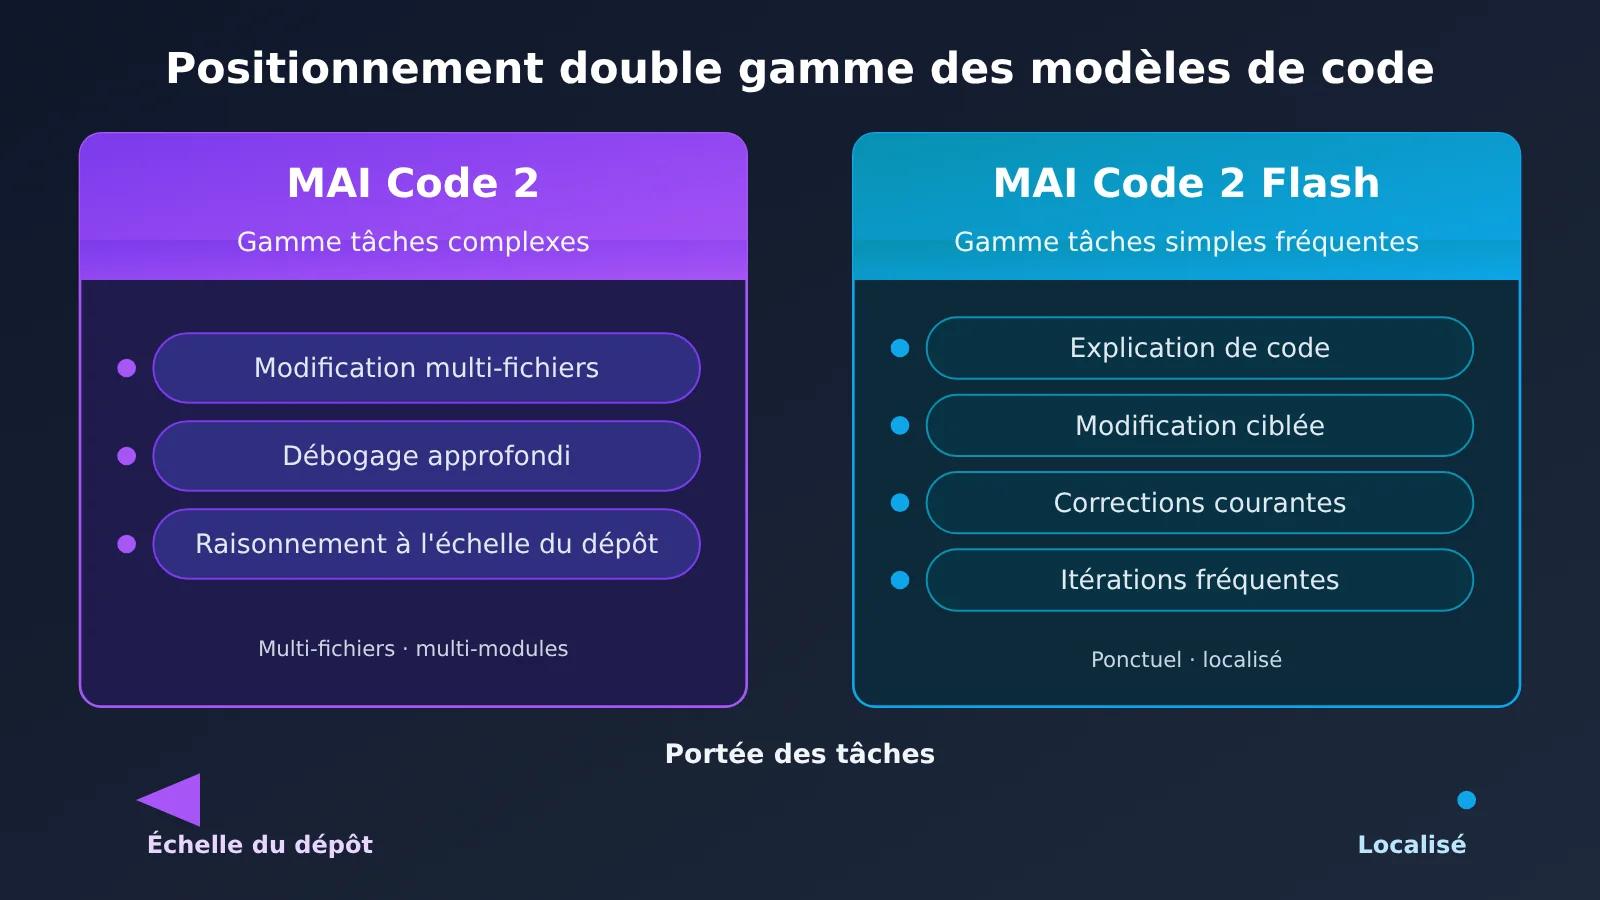
La répartition des rôles entre les deux modèles est très claire dans la documentation officielle : l’un prend en charge les tâches complexes qui nécessitent une compréhension globale, l’autre les tâches fréquentes et de portée limitée.
| Dimension | MAI Code 2 | MAI Code 2 Flash |
|---|---|---|
| Positionnement officiel | Tâches de programmation complexes | Tâches de programmation fréquentes et courantes |
| Tâches typiques | Modifications multi-fichiers, débogage approfondi, raisonnement à l’échelle du dépôt | Explication de code, modifications ciblées, corrections courantes, itérations fréquentes |
| Portée des tâches | Multi-fichiers, multi-modules | Ponctuelle, locale |
| GitHub Copilot | Disponible | Disponible |
| Foundry | Non précisé dans les références | Aperçu à accès restreint |
1.3 Spécifications publiques de la fiche modèle de MAI Code 2
La fiche modèle donne les chiffres liés aux modalités et au contexte. À noter : elle précise aussi que les limites réelles dans le produit peuvent différer de ces valeurs.
| Élément | Données de la fiche modèle |
|---|---|
| Modalité d’entrée | Texte, images |
| Modalité de sortie | Texte |
| Contexte du modèle | 1.05M tokens |
| Entrée maximale | 922k tokens |
| Sortie maximale | 128k tokens |
Concernant le nombre total de paramètres, les sources disponibles présentent des versions incohérentes. Cet article ne cite donc pas de chiffre précis ; il faudra se référer aux mises à jour officielles.
1.4 Points d’accès disponibles pour MAI Code 2 et Flash
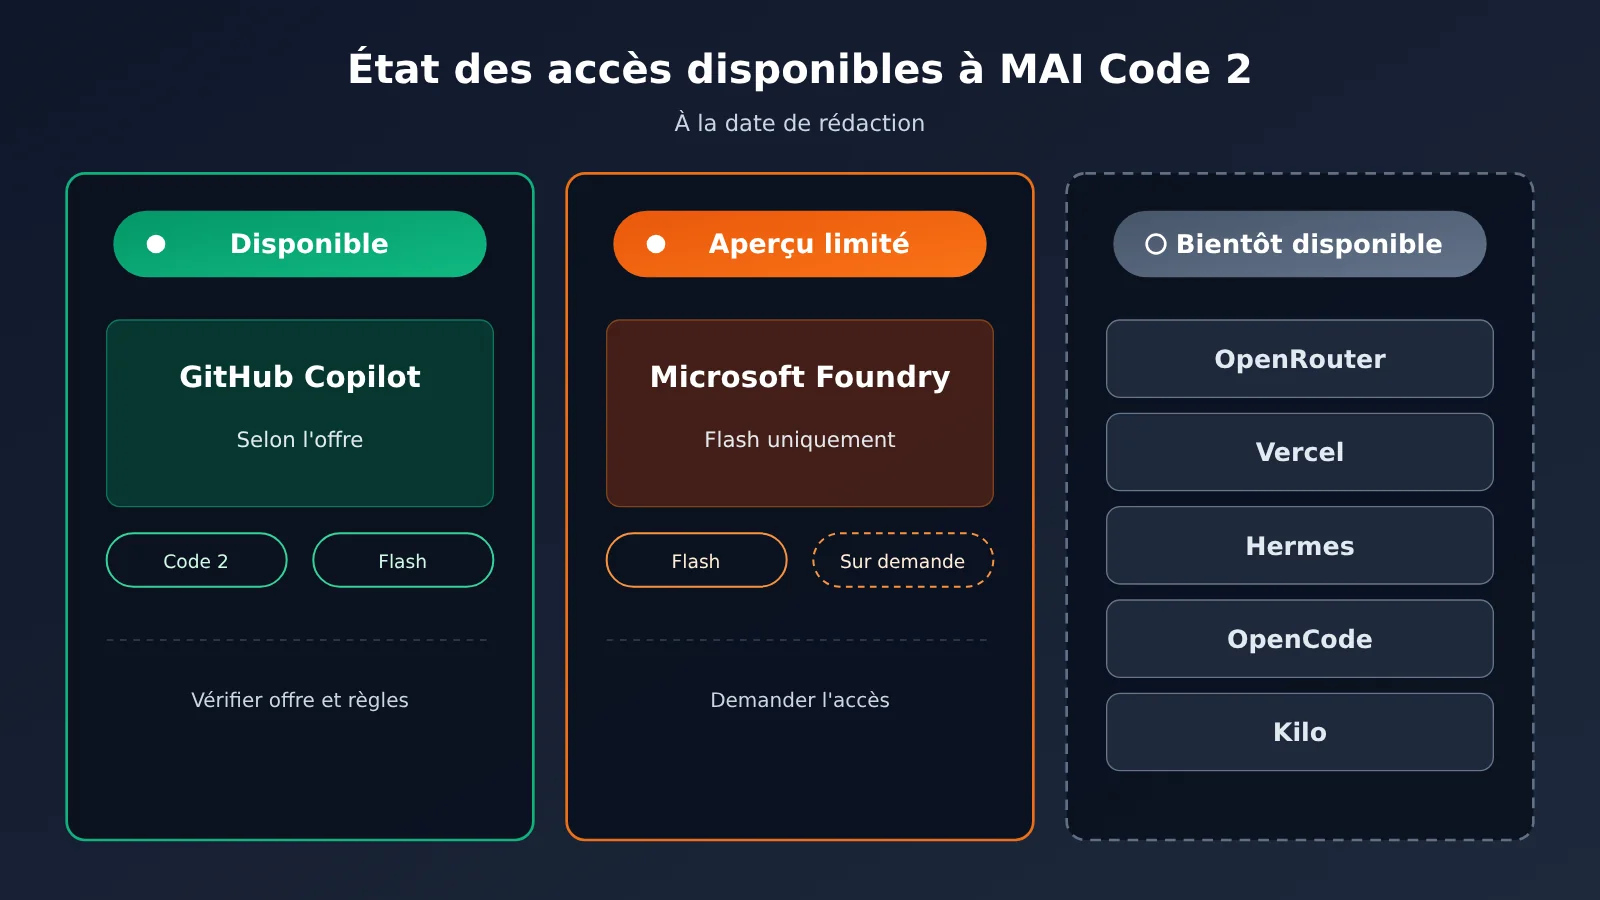
Le journal des modifications officiel de GitHub le précise : Code 2 est destiné à Copilot Pro, Pro+, Max, Business et Enterprise ; Flash couvre en plus Free et Student. Les abonnements annuels remplissant les conditions y ont également droit. Les administrateurs d’entreprise ou d’organisation peuvent contrôler l’accès via des politiques de modèles : il ne faut donc pas comprendre « déjà déployé » comme « disponible sans condition pour chaque compte ». Côté Foundry, la note de publication ne confirme que Code 2 Flash en limited-access preview (aperçu à accès restreint), sans annoncer une ouverture complète de Code 2 sur Foundry.
La note de publication mentionne aussi des canaux comme OpenRouter, Vercel, Hermes, OpenCode et Kilo, mais leur statut est « bientôt disponible » (soon). Autrement dit, à la date de rédaction de cet article, ces canaux ne peuvent pas être considérés comme pleinement disponibles.
1.5 Nature des données d’évaluation de MAI Code 2
Cet article ne s’appuie sur aucun test indépendant. La comparaison compilée par Microsoft mêle évaluations internes et données externes : DeepSWE 1.1, TerminalBench 2.1 et SWE Atlas ont été exécutés sur MSBench de Microsoft via Copilot CLI, sans sous-agents ; les scores et coûts de FrontierCode 1.1 proviennent d’Artificial Analysis. Les modèles concernés sont réglés sur une intensité de raisonnement maximale (max), et le coût de MAI utilise le tarif promotionnel de 50 %. Il ne faut pas prendre ces résultats, obtenus dans des conditions précises de tâches, de configuration et de prix, pour une conclusion générale applicable à tous les dépôts de code. Microsoft indique également clairement que ces deux modèles n’ont pas encore été ajustés pour la recherche scientifique fondamentale ni pour les tâches d’agent à très longs enchaînements.
1.6 Tarif promotionnel Copilot : il faut regarder à la fois le tarif et la date d’entrée en vigueur
Les tarifs promotionnels actuels listés dans la documentation de facturation GitHub sont les suivants, en dollars par million de tokens ; il s’agit des règles de facturation propres à Copilot, qu’on ne peut pas prendre directement pour les tarifs de Foundry ou d’une API tierce.
| Modèle | Entrée | Entrée mise en cache | Sortie | Entrée / entrée mise en cache / sortie à partir du 17 mai 2027 |
|---|---|---|---|---|
| MAI Code 2 | $0.50 | $0.025 | $2.50 | $1.00 / $0.05 / $5.00 |
| MAI Code 2 Flash | $0.05 | $0.005 | $0.25 | $0.10 / $0.01 / $0.50 |
La note de bas de page officielle précise que la promotion court jusqu’au 17 mai 2027 et que les prix de la colonne de droite s’appliquent à partir de cette date ; ensuite, il faut se référer à la documentation en temps réel. Le comptage quotidien est converti en GitHub AI Credits ; le quota inclus dans l’offre, le budget d’utilisation supplémentaire et les anciennes modalités de facturation des abonnements annuels doivent être vérifiés séparément. Il ne s’agit pas d’un usage gratuit illimité, et on ne peut pas présenter le rapport de coûts de la période promotionnelle comme une remise permanente. Documentation officielle de facturation GitHub
2. Analyse : ce que les deux paliers MAI Code 2 et Flash impliquent pour les développeurs
Ce qui suit est une analyse éditoriale, dérivée des faits présentés dans la première partie ; elle ne représente pas la position officielle de Microsoft. Les contenus relatifs aux tendances futures sont des prévisions.
2.1 Pourquoi MAI Code 2 est divisé en deux paliers
Dans les scénarios de codage, la plupart des requêtes sont en réalité très « petites » : expliquer un morceau de code, changer un paramètre, corriger une erreur manifeste. Ce type de tâche n’exige pas une grande compréhension globale de la part du modèle ; ce qui compte davantage, c’est une réponse rapide et la possibilité d’appels fréquents. À l’inverse, les tâches telles que la refactorisation inter-modules ou la traque de bugs profonds sont peu nombreuses, mais chacune est plus complexe et exige que le modèle comprenne la structure d’ensemble du dépôt.
Répartir ces deux types de besoins entre deux modèles, c’est permettre aux utilisateurs de « payer selon la difficulté de la tâche ». GitHub positionne officiellement Flash comme un modèle de développement quotidien, léger et économique ; la documentation tarifaire actuelle indique également des prix unitaires par token distincts pour les deux modèles (voir 1.6). Mais une différence de prix unitaire ne signifie pas une différence de coût par tâche : la vitesse de réponse, la consommation de tokens et le nombre de reprises doivent toujours être vérifiés dans vos propres tâches.
2.2 Conseils : partir de Flash, puis monter vers MAI Code 2 selon les signaux
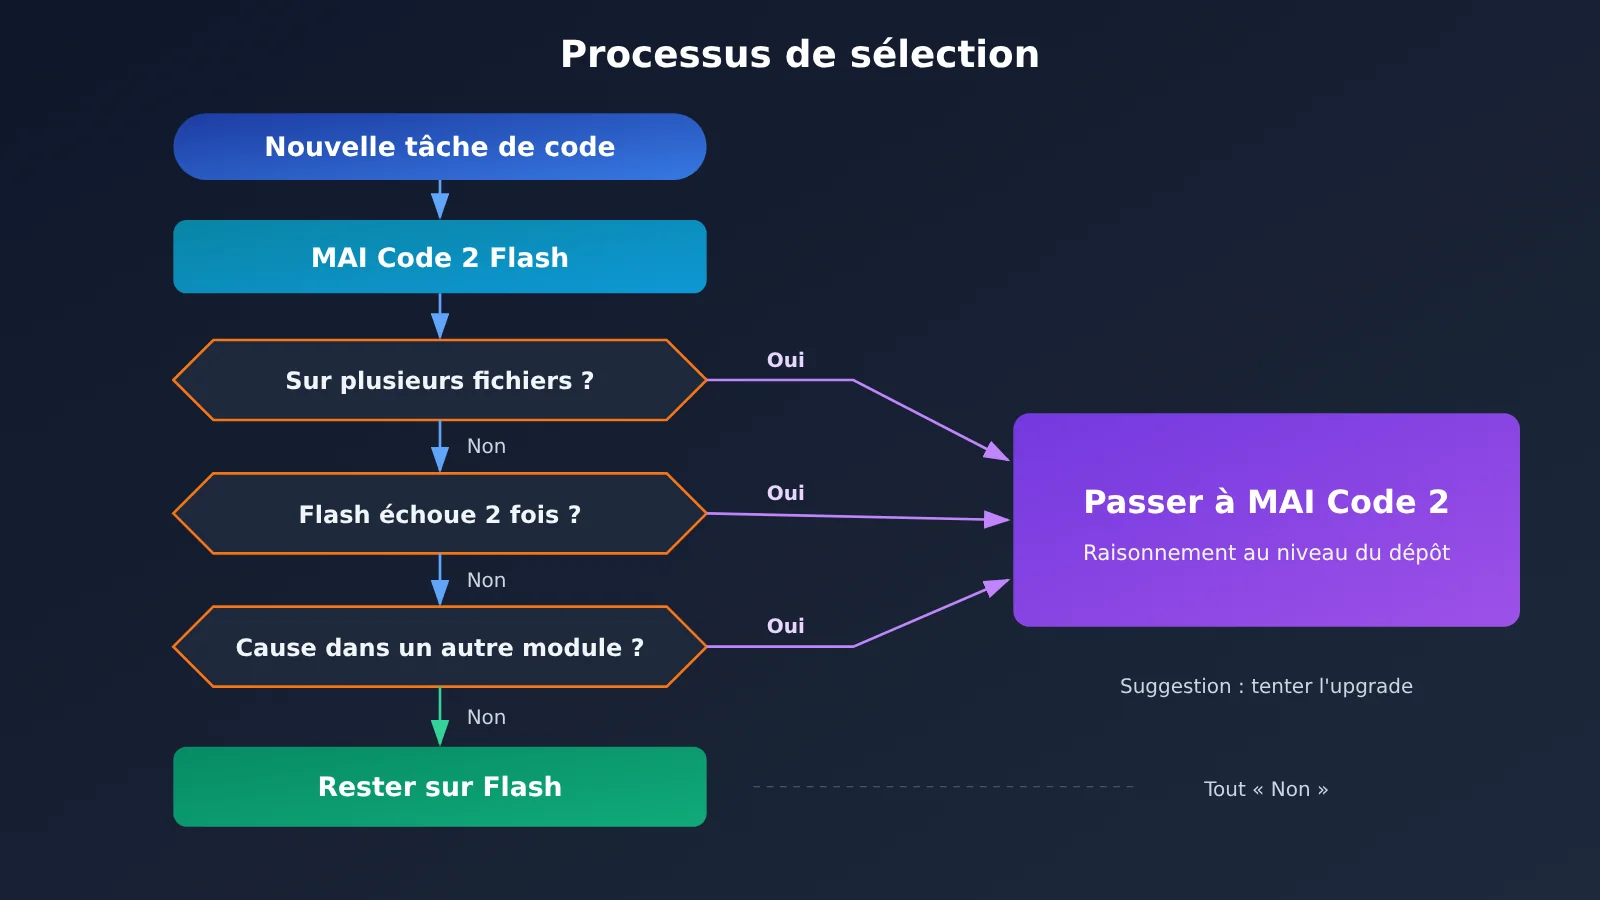
Pour les développeurs et les petites équipes, nous recommandons de faire de Flash le niveau par défaut et de ne passer à Code 2 qu’en présence de signaux clairs. Il s’agit d’une stratégie de routage à valider : elle ne garantit ni que Flash soit plus rapide, ni que Code 2 corrige forcément le problème. Il faut en parallèle noter le taux de réussite des tâches, le temps de relecture humaine et le coût réel.
Les seuils ci-dessous ne sont que des conseils, des points de départ faciles à tester, et non des limites officielles ou des règles optimales déjà validées :
- La modification touche au moins 3 fichiers, ou exige de modifier en même temps la définition d’interface et les appelants.
- Flash a proposé deux corrections d’affilée sans résoudre le problème, ce qui suggère que le problème n’est peut-être pas local.
- La cause racine du bug se trouve dans un autre module, par exemple la configuration, la version des dépendances ou l’amont du flux de données.
- Il faut comprendre l’architecture globale du projet, par exemple cartographier les relations entre modules ou planifier une refonte.
- Vous ne savez pas vous-même où se situe le problème et avez besoin que le modèle fasse d’abord un diagnostic global.
À l’inverse, pour des tâches comme expliquer du code, écrire des exemples de tests unitaires, renommer, ajouter des commentaires ou corriger des erreurs de compilation, vous pouvez essayer Flash en priorité, puis décider de le conserver ou non selon les tests et la relecture humaine.
2.3 Une fenêtre de contexte de 1.05M ne signifie pas qu’on peut l’exploiter pleinement dans les outils
La fiche du modèle indique une fenêtre de contexte de 1.05M, une entrée maximale de 922k et une sortie maximale de 128k, tout en précisant que les limites réelles du produit peuvent différer. Notre analyse est que, dans des produits comme GitHub Copilot, la longueur de contexte réellement disponible et le plafond de sortie par requête peuvent dépendre des règles propres au produit.
Il ne faut donc pas compter sur le fait de « faire tenir tout le dépôt » dans le contexte pour résoudre le problème. L’approche la plus prudente reste de commencer par montrer au modèle les répertoires pertinents et les fichiers clés, puis d’élargir progressivement le périmètre. C’est aussi là que réside la valeur du « raisonnement à l’échelle du dépôt » mis en avant par Code 2 : il doit pouvoir trouver les relations essentielles dans une grande masse de code, et pas seulement absorber plus de texte.
2.4 Pour appeler MAI Code 2 via API : d’abord vérifier, ensuite tester
Aujourd’hui, les points d’entrée confirmés pour la série MAI Code 2 sont GitHub Copilot et Foundry (aperçu limité de Flash), et les canaux d’agrégation tiers ne sont pas encore tous disponibles. Si vous envisagez une intégration via API, la première étape n’est pas d’écrire le code métier, mais de vérifier si la plateforme cible propose réellement ces deux modèles, et quel est leur identifiant de modèle.
Le code ci-dessous illustre uniquement la démarche d’intégration : il n’a pas été exécuté ici, et nous n’avons pas vérifié qu’APIYI propose ces deux modèles. Un nom contenant « mai » indique seulement un candidat possible ; cela ne remplace pas la vérification du nom officiel du modèle, des capacités de l’interface et des autorisations. L’exemple commence par lister les modèles, puis filtre les entrées potentiellement pertinentes :
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # interface compatible OpenAI d'APIYI ; la disponibilité des modèles dépend de la liste en temps réel
)

# Lister les modèles actuellement disponibles et filtrer les entrées susceptibles d'être liées à MAI Code 2
models = client.models.list()
mai_models = [m.id for m in models.data if "mai" in m.id.lower()]
print(mai_models or "当前列表中未找到 MAI 相关模型")
Si le modèle correspondant apparaît bien dans la liste, vous pouvez écrire un routage simple par paliers selon l’approche de la section 2.2. Les identifiants de modèle doivent être ceux de la liste de la plateforme ; on utilise ci-dessous des espaces réservés :
Voir l’exemple de code pour un appel par paliers selon la difficulté de la tâche
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # utiliser l'interface unifiée d'APIYI
)

# Espaces réservés : à remplacer par les identifiants réellement présents dans la liste des modèles
FLASH_MODEL = "YOUR_FLASH_MODEL_ID"
CODE2_MODEL = "YOUR_CODE2_MODEL_ID"

def pick_model(files_touched: int, failed_attempts: int, cross_module: bool) -> str:
    """Choisir le modèle selon les signaux de la section 2.2 : Flash par défaut, montée vers Code 2 si l'une des conditions est remplie"""
    if files_touched >= 3 or failed_attempts >= 2 or cross_module:
        return CODE2_MODEL
    return FLASH_MODEL

def ask(prompt: str, files_touched=1, failed_attempts=0, cross_module=False) -> str:
    model = pick_model(files_touched, failed_attempts, cross_module)
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": "你是资深工程师,先说明改动范围,再给出代码。"},
            {"role": "user", "content": prompt},
        ],
    )
    return f"[{model}]\n" + resp.choices[0].message.content

print(ask("解释这个函数的作用:def add(a, b): return a + b"))
🎯 Conseil d’intégration : les canaux tiers de la série MAI Code 2 sont encore en cours de déploiement. Je vous recommande de vérifier d’abord la prise en charge réelle et les identifiants de modèle dans la liste des modèles ou la documentation d’APIYI sur apiyi.com, avant de décider d’intégrer ou non. Si ces modèles ne sont pas encore disponibles, vous pouvez commencer par mettre en place le routage par paliers avec le même code compatible OpenAI, sur un modèle de programmation déjà pris en charge par la plateforme. Il faudra ensuite vérifier les paramètres de l’interface, la prise en charge de l’appel d’outils, les coûts et les tests de non-régression : rien ne garantit qu’un simple changement d’identifiant de modèle suffira pour rester compatible.
2.5 MAI Code 2 : les évolutions à suivre
Les jugements ci-dessous sont prospectifs et devront être confirmés par les faits :
- Calendrier de mise en ligne des canaux tiers : savoir quand OpenRouter, Vercel et les autres canaux marqués « bientôt disponible » ouvriront leurs accès déterminera directement le seuil d’entrée pour les utilisateurs qui ne passent pas par Copilot.
- Périmètre d’accès à Foundry : Flash passera-t-il d’un aperçu restreint à une disponibilité publique ? Et Code 2 arrivera-t-il dans Foundry ?
- Résultats de tests indépendants : les performances observées par la communauté et par des tiers sur de vrais dépôts en disent plus sur l’écart réel entre les deux gammes que les benchmarks des éditeurs.
- Quotas réels dans les produits : les limites effectives de contexte et de sortie dans Copilot et les autres produits déterminent jusqu’où le « raisonnement à l’échelle du dépôt » peut réellement aller.
Pour comparer côte à côte différents modèles de programmation dans un même code, une plateforme d’agrégation sera plus pratique. APIYI apiyi.com propose une interface unifiée compatible OpenAI : une seule clé API suffit pour basculer entre OpenAI, Claude, Gemini et d’autres modèles, ce qui permet de préparer le processus de comparaison avant même la sortie d’un nouveau modèle.
L’apparition de deux gammes de modèles revient finalement à reconnaître une vérité simple : aucun modèle ne convient à toutes les tâches de programmation, et répartir les outils selon la lourdeur de la tâche est un usage plus économique. Comme le dit le Chu Ci, section « Bu Ju » :
« Un pied a ses défauts, un pouce a ses qualités. »
📚 Références
- Annonce officielle de GitHub : forfaits et politiques d’administration.
-
Tarifs officiels GitHub et notes de bas de page promotionnelles : tarifs, dates de fin de promotion et règles de facturation.
-
Publication officielle Microsoft : Introducing MAI Code 2 and MAI Code 2 Flash : annonce de lancement et positionnement
- Lien :
microsoft.ai/news/introducing-mai-code-2-and-mai-code-2-flash/ - Description : positionnement des tâches des deux modèles, conditions de disponibilité dans GitHub Copilot et informations « bientôt disponible » sur les canaux tiers
- Lien :
-
Blog de la communauté technique Azure AI Foundry : From model choice to your durable advantage
- Lien :
techcommunity.microsoft.com/blog/azure-ai-foundry-blog/from-model-choice-to-your-durable-advantage-build-ai-that-keeps-improving/4573609 - Description : mode de disponibilité côté Foundry, explication de la prévisualisation à accès limité pour MAI Code 2 Flash
- Lien :
-
Fiches modèles MAI Code 2 et MAI Code 2 Flash (PDF) : spécifications des modèles et détails des évaluations
- Lien :
microsoft.ai/pdf/MAI-Code-2-And-MAI-Code-2-Flash-Model-Card.pdf - Description : modalités d’entrée et de sortie, longueur de contexte, entrées et sorties maximales, ainsi que les mentions précisant que les limites produit peuvent varier
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : pour en savoir plus sur l’intégration des modèles et les conditions de support, n’hésitez pas à nous contacter via la page d’accueil d’APIYI apiyi.com. Pour plus de documentation sur l’intégration, consultez le centre de documentation docs.apiyi.com