Note de l’auteur : quand les nouveaux modèles arrivent en rafale, commencez par vérifier s’ils sont disponibles dans le catalogue. Si c’est le cas, changez uniquement l’ID du modèle ; avant de basculer, vérifiez le prix, le point de terminaison et le groupe. Une même clé API suffit pour faire les tests, sans ouvrir un compte supplémentaire chez chaque fournisseur.
Le 2026-11-09, Anthropic a publié Claude Fable 5.2. Une semaine plus tard, le 2026-11-16, Alibaba Cloud a ajouté Qwen4-Max à sa liste de modèles disponibles. Pour les développeurs d’applications qui veulent intégrer de nouveaux modèles, la difficulté ne vient généralement pas du code d’appel, mais du processus : à chaque nouveau modèle publié par un fournisseur, il faut créer un compte, demander une clé API, associer un moyen de paiement, puis modifier à nouveau la configuration. Cet article présente la méthode de test en trois étapes : une seule clé, on change l’ID du modèle, pour vous aider à tester d’abord, avec le même code d’appel, les modèles déjà disponibles au catalogue.
Ce n’est pas un énième résumé de conférence de lancement. Pour les modèles et les prix cités, la référence est le tableau récapitulatif des modèles d’APIYI apiyi.com (la page indique une mise à jour des données au 2026-11-16 09:39, UTC+8, avec pour source l’API de tarification en temps réel du système) et la documentation des fournisseurs. Nous ne présentons pas de benchmarks maison : nous expliquons seulement ce qu’il faut vérifier, ce qu’il faut modifier et ce qu’il faut contrôler avant de lancer les tests.
L’essentiel : à la fin de cet article, vous saurez utiliser la même clé API, stockée dans une variable d’environnement, pour tester tour à tour claude-fable-5-2 et la série Qwen, et vérifier avant de basculer quel impact ce changement de modèle aura sur votre facture.
Comment tester un nouveau modèle : l’essentiel pour changer d’ID de modèle avec une seule clé
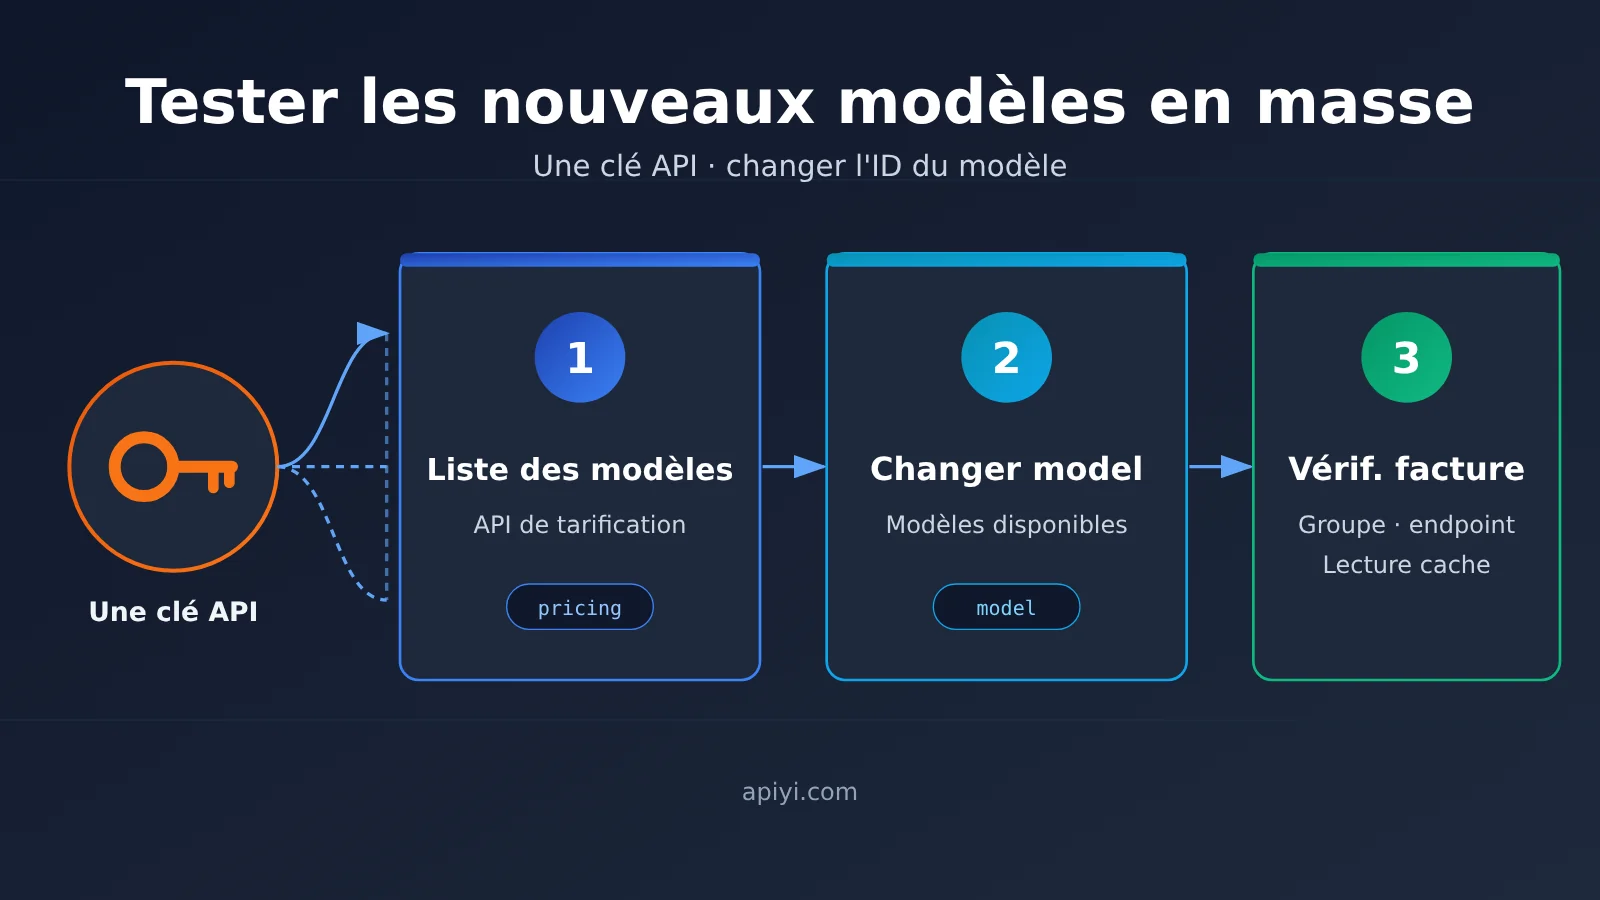
Quand les nouveaux modèles arrivent en rafale, ce qui plante le plus souvent, ce n’est pas le code : c’est le fait d’avoir modifié le champ model sans vérifier si « ce modèle est réellement appelable, et à quel tarif ». Le tableau ci-dessous donne la structure de la méthode en trois étapes ; on détaille ensuite point par point.
| Étape | Ce qu’on fait | Pourquoi |
|---|---|---|
| ① Consulter le catalogue et l’API de tarification | Chercher l’ID du modèle cible dans le tableau récapitulatif des modèles et dans l’API de tarification | D’abord vérifier qu’il est bien disponible, et que le prix de référence est bien cette ligne |
② Pour un modèle disponible, changer seulement model |
Garder base_url et la clé API inchangés, remplacer uniquement le champ model |
Un seul et même jeu d’appels suffit pour couvrir plusieurs fournisseurs |
| ③ Vérifier groupe, endpoint, lecture du cache | Contrôler le prix d’entrée, le prix de sortie, la lecture du cache, l’endpoint et le groupe | Changer de modèle change la facture, et parfois aussi le protocole d’appel |
Pourquoi « une seule clé, on change l’ID de modèle » fonctionne
La documentation des jetons d’APIYI le précise : si aucun liste blanche de modèles n’est définie sur le jeton, on peut utiliser les plus de 200 modèles sélectionnés du site ; si une liste blanche est définie, seuls les modèles indiqués sont appelables. Donc « une seule clé pour changer de modèle » suppose une chose : que votre jeton ne bloque pas le modèle cible en dehors de sa liste blanche. Si vous avez l’habitude d’isoler par projet, la documentation prévoit aussi de créer des jetons indépendants par projet, avec un suivi séparé du quota, de la validité et des logs.
Un autre concept qu’on oublie facilement, c’est le groupe. La documentation l’explique ainsi : un groupe est un canal de ressources, et différents modèles peuvent nécessiter différents groupes ; un jeton peut configurer au maximum 1 groupe par défaut et 2 groupes de secours, et en cas de doute on utilise Default. Autrement dit, pour savoir si un changement d’ID de modèle aboutira à un appel qui fonctionne, il ne suffit pas de regarder si le modèle est disponible : il faut aussi vérifier que le groupe auquel il appartient couvre bien le paramétrage de groupe de votre jeton.
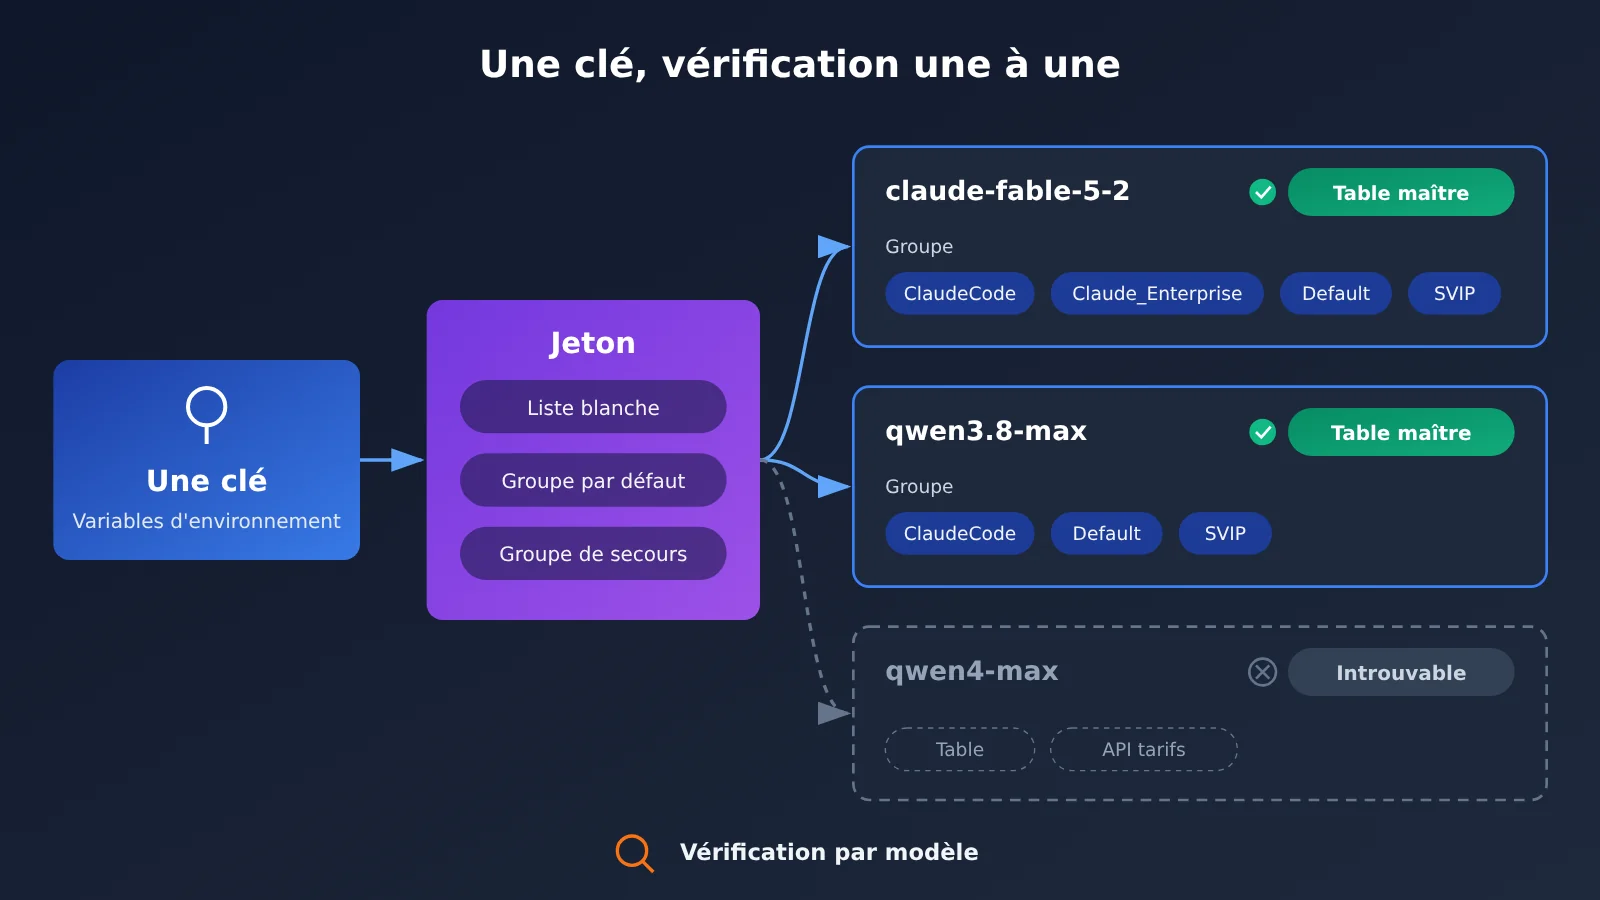
Comment tester un nouveau modèle, étape 1 : consulter le tableau récapitulatif des modèles et l’interface de tarification
Avant de toucher au code, faites deux vérifications : d’abord le tableau récapitulatif des modèles docs.apiyi.com/models.md, puis l’interface de tarification https://api.apiyi.com/api/pricing. Le tableau est pratique pour comparer les prix à la main, tandis que l’interface de tarification est faite pour être appelée depuis un script, afin de vérifier automatiquement dans une CI ou un centre de configuration que « ce modèle figure bien dans la grille tarifaire ». Si les deux sources concordent, passez à l’étape suivante.
Prenons pour exemple les deux nouveaux modèles de cette semaine : les résultats des vérifications sont très différents :
| ID du modèle | Annonce du fournisseur | Tableau récapitulatif des modèles APIYI | Interface de tarification au 2026-11-17 | Recommandation de test |
|---|---|---|---|---|
claude-fable-5-2 |
Annonce Anthropic du 2026-11-09 | Disponible (ainsi que claude-fable-5-2-thinking) |
Présent | Modifier directement le modèle et tester |
qwen4-max |
Inscription à la mise en ligne Alibaba Cloud du 2026-11-16 | Absent de la section Alibaba | Aucun qwen4 dans la réponse | Faire d’abord tourner la chaîne avec un modèle proche |
qwen3.8-max |
Modèle existant | Disponible | Présent | À utiliser comme alternative pour tester la chaîne Qwen |
Un détail à garder en tête : claude-fable-5-2 n’a pas de page de description dédiée dans la documentation APIYI, et l’adresse correspondante renvoie une 404. Son prix ne peut donc être établi qu’à partir de cette ligne du tableau récapitulatif, sans aller le reconstituer ailleurs.
🎯 Conseil technique : faites de la « vérification de l’interface de tarification » une étape de contrôle avant chaque mise en production. Lorsqu’une nouvelle chaîne de modèle apparaît dans la configuration, commencez par appeler l’interface de tarification d’APIYI sur apiyi.com pour confirmer son existence : vous éviterez ainsi de recevoir une erreur « modèle inexistant » seulement après la mise en ligne.
Claude Fable 5.2 est disponible : changez directement l’ID du modèle pour tester
Selon l’annonce d’Anthropic du 2026-11-09, l’ID du modèle pour les développeurs est claude-fable-5-2. L’annonce indique que sa vitesse de génération est jusqu’à 30 % plus rapide que celle de Fable 5.1, avec un prix officiel de $8 en entrée et $40 en sortie par million de tokens. Anthropic propose aussi un fast mode optionnel, au prix de $16 en entrée et $80 en sortie. Le tableau récapitulatif d’APIYI ne comporte pas de ligne fast mode ; ne rédigez donc pas votre configuration en partant du principe que le fast mode est disponible.
La même annonce précise aussi que Fable et Mythos partagent la même base : Fable est ouvert à tous les utilisateurs, tandis que Mythos exige de passer par un programme de vérification en sciences de la vie ou en cybersécurité. Dans la vue d’ensemble des modèles d’Anthropic, les modèles actuels sont Claude Fable 5.2, Claude Opus 5.5, Claude Sonnet 5.5, Claude Haiku 5.5, ainsi que Mythos 5.2, qui nécessite une vérification. Aucun modèle nommé Fable 5.5 n’existe. La recommandation de l’annonce est la suivante : pour la plupart des tâches de codage et de connaissance, commencez par Claude Opus 5.5, puis passez à Fable si ce n’est pas suffisant ; pour des tâches plus légères, utilisez Sonnet 5.5 ou Haiku 5.5.
Chez APIYI, claude-fable-5-2 et claude-fable-5-2-thinking sont tous deux des modèles texte à facturation à l’usage : $8 en entrée, $40 en sortie, $0.2 en lecture du cache (par million de tokens). Le point d’accès prend en charge à la fois chat et messages, et les groupes sont ClaudeCode, Claude_Enterprise, Default et SVIP. Ces tarifs ne s’appliquent qu’à ces deux modèles Fable et ne représentent pas les prix des autres modèles Claude.
Comment tester Qwen4-Max : commencer par valider toute la chaîne Qwen avec qwen3.8-max, déjà en ligne
Commençons par les informations côté éditeur. La page de modèles d’Ali Cloud indique l’ID d’appel qwen4-max : en entrée, texte, image et vidéo ; en sortie, du texte ; longueur de contexte de 1 000 000 ; entrée maximale de 991 808, sortie maximale de 131 072 ; en mode réflexion, entrée maximale de 983 616, sortie maximale de 262 144 et chaîne de pensée maximale de 262 144. Le modèle prend en charge l’appel d’outils, les sorties structurées, le cache explicite et le cache implicite, et il est compatible avec OpenAI Chat Completions, Responses et Anthropic Messages — en revanche, pas d’inférence par lots ni de réglage fin du modèle. La page « Mise en ligne et mises à jour des modèles » d’Ali Cloud le date du 2026-11-16, avec un déploiement de service en Chine continentale.
Côté tarifs, il faut distinguer la source et la devise : on ne peut pas tout fusionner en un seul chiffre. La page de modèles de Bailian (Aliyun) affiche des prix libellés en yuan : même tarif pour le mode non-réflexion et le mode réflexion ; pour les déploiements en Chine continentale et « global », 10 yuans par million de tokens en entrée et 30 yuans en sortie ; pour le déploiement international, 10,938 yuans en entrée et 32,813 yuans en sortie. La même page mentionne aussi un quota gratuit de 1 million de tokens, valable 90 jours à compter de l’activation de Bailian, de la publication du modèle ou de l’acceptation de la demande (la date la plus tardive étant retenue). Il s’agit des tarifs et du quota de Bailian, sans lien avec APIYI. De son côté, le compte officiel Qwen, dans un post du 2026-11-16, annonce une autre grille en dollars : 1,5 $ en entrée, 4,5 $ en sortie, 0,075 $ pour le cache implicite (par million de tokens), en précisant que l’API est fournie sur QwenCloud. Chez APIYI, qwen4-max n’est pas encore disponible ; nous allons mettre ce modèle en ligne dès que possible. Les modèles et les tarifs de référence sont ceux de la liste des modèles de la plateforme.
La démarche pour la ligne Qwen est donc la suivante : commencez par utiliser qwen3.8-max, déjà présent dans le tableau récapitulatif, pour valider de bout en bout la chaîne d’appel, les modèles d’invite, la logique d’analyse et le suivi de facturation. Chez APIYI, son tarif est de 1,65 $ en entrée, 4,95 $ en sortie et 0,20625 $ en lecture de cache (par million de tokens), avec les points de terminaison chat et messages et les groupes ClaudeCode, Default et SVIP. Dès que qwen4-max apparaîtra dans l’interface de tarification, il suffira généralement de changer le champ model, puis de refaire une vérification selon l’étape 3.
Changer d’ID de modèle avec une seule clé : prise en main rapide
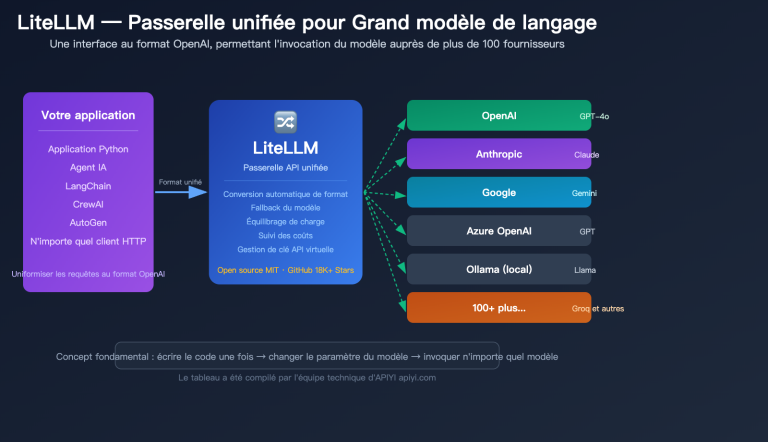
Ci-dessous, la configuration minimale présentée avec du code en ligne : une seule clé du début à la fin.
- Placez la clé dans une variable d’environnement : par exemple
export APIYI_API_KEY=你的密钥. N’inscrivez pas la clé dans le dépôt et ne la committez pas dans un fichier de configuration. - N’initialisez le client qu’une seule fois : en Python, vous pouvez écrire
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"), l’endpoint Chat Completions correspondant est/v1/chat/completions. - Faites de l’ID du modèle une option de configuration : par exemple
MODEL=claude-fable-5-2, et lors de l’appel, écrivezclient.chat.completions.create(model=os.environ["MODEL"], messages=[...]). - Pour tester un autre modèle, ne modifiez qu’un seul endroit : remplacez
MODELparqwen3.8-maxet relancez la même série de cas de test ; le base_url, la clé et la structure des messages restent inchangés. - Consignez le champ model de chaque requête : indiquez clairement dans les logs l’ID du modèle utilisé cette fois-ci, afin de pouvoir ventiler les coûts par modèle lors de la réconciliation ultérieure.
L’avantage de cette approche : dans un test comparatif, la seule variable restante est le modèle lui-même. Avec le même jeu d’invites et le même code d’analyse, il suffit de changer une chaîne pour voir les différences de sortie entre les modèles, et vous pouvez aussi intégrer directement les résultats dans votre tableau d’évaluation.
🚀 Démarrage rapide : si vous n’avez pas encore de clé, vous pouvez vous inscrire sur APIYI apiyi.com ; les nouveaux utilisateurs disposent d’un crédit de test gratuit. Je vous conseille de créer d’abord un jeton indépendant dédié à « l’évaluation de nouveaux modèles », avec un quota, une durée de validité et des logs séparés de l’environnement de production.
Troisième étape avant de changer d’ID de modèle : vérifier les groupes, les points de terminaison et la lecture du cache
Changer le champ model est très simple, mais cela peut modifier discrètement deux choses : la facture et le protocole. La liste ci-dessous mérite d’être passée en revue avant chaque bascule :
| Élément à vérifier | Où vérifier | Piège fréquent |
|---|---|---|
| Prix des tokens d’entrée / de sortie | Ligne correspondante du tableau récapitulatif des modèles | Les écarts de prix entre différents modèles d’un même fournisseur sont importants ; on ne peut pas les estimer en se basant sur la « même série » |
| Prix de lecture du cache | Colonne « lecture du cache » du tableau récapitulatif | Dans les scénarios avec de longues invites système, le prix de lecture du cache influence directement le coût |
| Point de terminaison | Colonne des points de terminaison du tableau récapitulatif (chat / messages) | Si le code passe par /v1/chat/completions, il faut confirmer que le modèle prend en charge chat |
| Groupe | Colonne Groupe du tableau récapitulatif + réglage des groupes du jeton | Les différents modèles peuvent nécessiter des groupes différents ; ne partez pas du principe qu’ils sont tous dans Default |
| Liste blanche | Réglages du jeton | Si une liste blanche est définie sur le jeton, un nouvel ID de modèle qui n’y figure pas sera refusé |
En comparant côte à côte les deux modèles concernés, les différences sautent aux yeux :
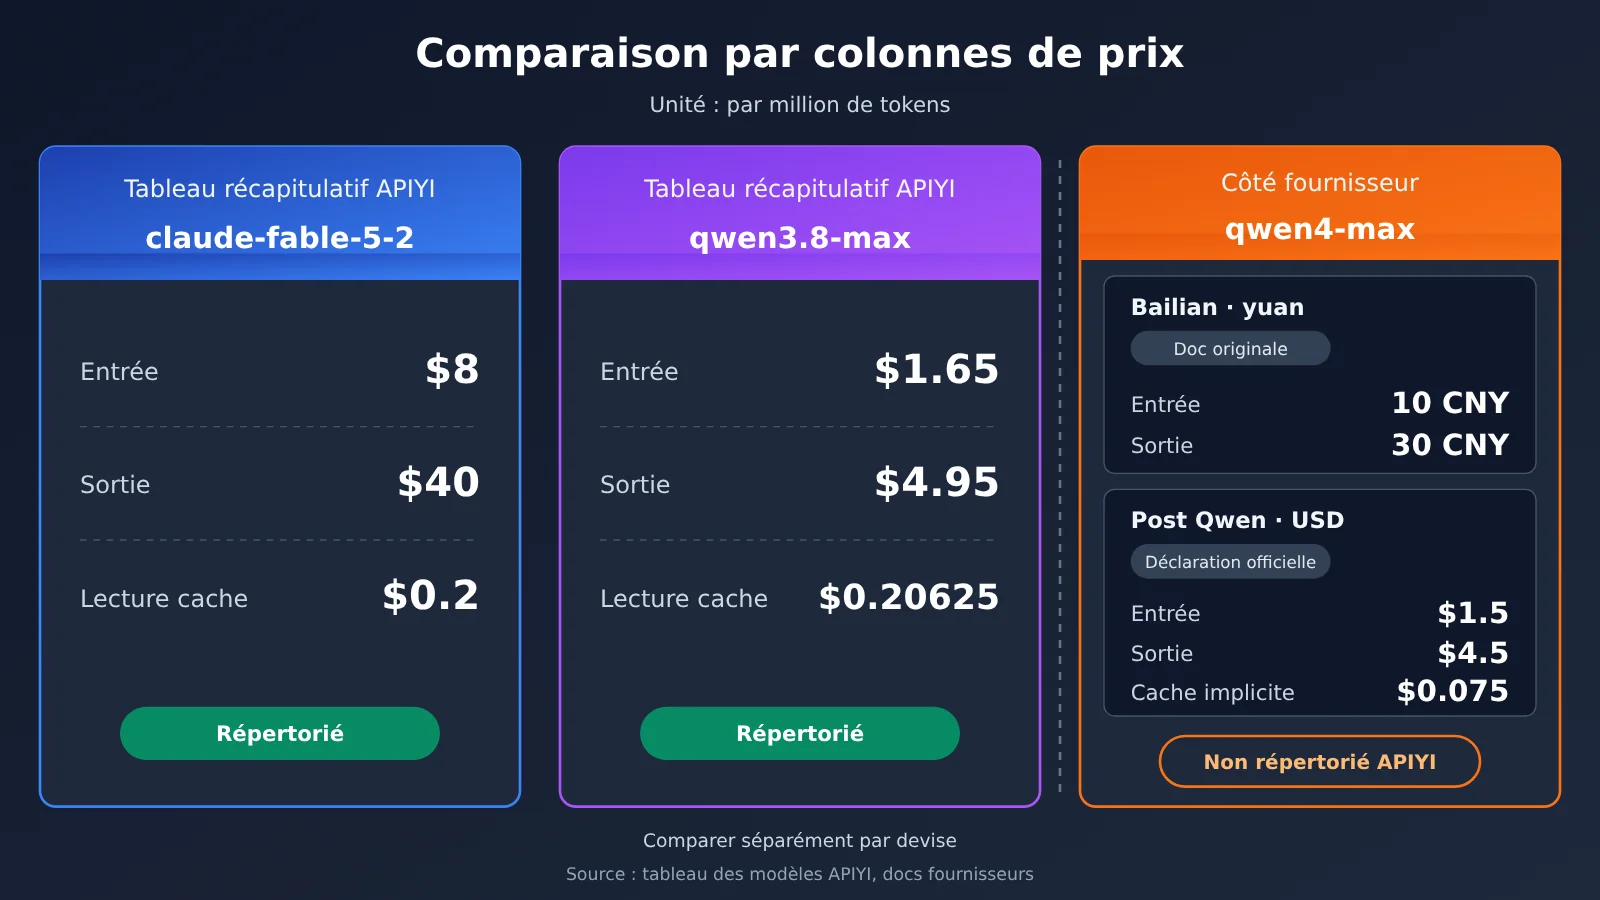
| ID de modèle | Source du prix | Entrée | Sortie | Lecture du cache | Point de terminaison | Plateforme disponible |
|---|---|---|---|---|---|---|
claude-fable-5-2 |
Tableau récapitulatif APIYI | $8 | $40 | $0.2 | chat, messages | APIYI apiyi.com, Anthropic officiel |
qwen3.8-max |
Tableau récapitulatif APIYI | $1.65 | $4.95 | $0.20625 | chat, messages | APIYI |
qwen4-max |
Texte original de la page du modèle Bailian (Chine continentale / international) | 10 CNY | 30 CNY | — | Côté fournisseur, compatible avec plusieurs protocoles | Alibaba Cloud Bailian |
qwen4-max |
Auto-description dans la publication officielle Qwen | $1.5 | $4.5 | cache implicite $0.075 | — | QwenCloud |
Les prix du tableau sont tous exprimés par million de tokens. Les prix en dollars et en yuans proviennent de sources différentes : comprenez-les séparément, sans les convertir pour les additionner ni les comparer directement. Les groupes doivent eux aussi être vérifiés un par un : claude-fable-5-2 dispose d’un groupe Claude_Enterprise, alors que qwen3.8-max n’en a pas. Si le groupe par défaut de votre jeton est Claude_Enterprise, lorsque vous passez à Qwen, il faut que vos groupes de secours incluent celui auquel il appartient.
💡 Conseil de sélection : En phase d’évaluation, il est conseillé de définir le groupe par défaut du jeton sur Default et de configurer 1 à 2 groupes de secours couvrant les modèles que vous souhaitez tester. Pour connaître les groupes de chaque modèle, référez-vous au tableau récapitulatif des modèles APIYI.
FAQ — questions fréquentes
Q1 : « Une seule clé, on change l’ID du modèle », ça veut dire quoi exactement ?
Cela signifie que le `base_url`, la clé et la structure de la requête restent identiques : on remplace uniquement le champ `model` pour basculer d’un modèle à un autre. Encore faut-il que le modèle visé soit déjà référencé sur la plateforme, que le jeton ne soit pas bloqué par une liste blanche et que le groupe auquel il appartient soit disponible.
Q2 : Peut-on tester qwen4-max dès maintenant ?
À la date du 17 novembre 2026, `qwen4-max` est introuvable, que ce soit dans le tableau récapitulatif d’APIYI ou dans l’interface de tarification. Le conseil : commencez par faire tourner toute la chaîne Qwen avec `qwen3.8-max`, puis interrogez régulièrement l’interface de tarification d’APIYI (apiyi.com) pour vérifier son apparition avant de changer le `model`.
Q3 : Les 1 million de tokens offerts par Bailian sont-ils utilisables sur APIYI ?
Non. Il s’agit du quota Bailian mentionné tel quel sur la page du modèle chez Alibaba Cloud, et il ne s’applique que dans Bailian. APIYI dispose de son propre crédit d’essai gratuit pour les nouveaux utilisateurs : ce sont deux choses bien distinctes.
Q4 : Peut-on appeler le fast mode de Claude Fable 5.2 via APIYI ?
Le tableau récapitulatif d’APIYI ne contient aucune ligne « fast mode » ; les modèles disponibles sont `claude-fable-5-2` et `claude-fable-5-2-thinking`. Les tarifs de 16 $ / 80 $ du fast mode correspondent aux prix officiels d’Anthropic.
Q5 : Une erreur survient après avoir changé le model, par quoi commencer ?
À vérifier dans l’ordre : le modèle figure-t-il dans le tableau récapitulatif ; la liste blanche du jeton le contient-elle ; le groupe du jeton couvre-t-il bien le groupe de ce modèle ; l’endpoint prend-il en charge le chemin que vous utilisez. Si vous n’arrivez pas à trancher, consultez sur APIYI (apiyi.com) les logs d’appel du jeton concerné pour identifier précisément l’élément rejeté.
Q6 : Peut-on utiliser le groupe Default pour tous les modèles ?
Ce n’est pas une hypothèse à faire. La documentation recommande d’utiliser Default en cas de doute, mais précise aussi que différents modèles peuvent nécessiter différents groupes. Pour chaque modèle, c’est le tableau récapitulatif qui fait foi ; configurez un groupe de secours si nécessaire.
Comment tester de nouveaux modèles : une clé, un changement d’ID de modèle — points clés
- Vérifier d’abord, modifier ensuite : recherchez l’ID cible à la fois dans le tableau récapitulatif des modèles et dans l’interface de tarification, puis seulement après, modifiez la configuration.
- Ne changer que
model: pour les modèles déjà en service, conservezbase_urlet la clé API inchangés. - Prix de Fable à lire séparément : les $8 / $40 / lecture du cache $0.2 de
claude-fable-5-2ne s’appliquent pas aux autres modèles Claude. - Qwen : commencez par l’ancien parcours : utilisez
qwen3.8-maxpour valider le processus, puis basculez versqwen4-maxquand il sera disponible. - Lisez les devises séparément : le prix en yuan de Bailian et le prix en dollars de l’article Qwen viennent de sources différentes ; ne les fusionnez pas en un seul chiffre.
- Vérifiez les groupes un par un : un token peut avoir au maximum 1 groupe par défaut et 2 groupes de secours ; ne partez pas du principe qu’ils sont tous dans Default.
En résumé
Quand les nouveaux modèles arrivent en masse, l’efficacité des tests dépend du processus, pas du nombre de comptes ouverts :
- Consultez le tableau récapitulatif et l’interface de tarification : vérifiez que le modèle est disponible ; le prix qui fait foi est celui de la ligne correspondante dans le tableau récapitulatif.
- Pour un modèle déjà en service, ne changez que
model: avec la même clé API et les mêmes appels, vous couvrez plusieurs modèles. - Vérifiez les groupes, les points de terminaison et la lecture du cache : changer de modèle peut modifier la facturation et parfois le protocole ; contrôlez chaque point avant de basculer.
La situation de cette semaine illustre exactement deux parcours : claude-fable-5-2 peut être testé directement, tandis que pour Qwen, il faut d’abord valider le flux avec qwen3.8-max. Je vous recommande de passer par APIYI apiyi.com pour réaliser cette série de tests avec une seule clé API, et de garder votre énergie pour l’évaluation des modèles eux-mêmes.
📚 Références
-
Tableau général des modèles APIYI : base de vérification des prix, des endpoints et des groupes
- Lien :
docs.apiyi.com/models.md - Remarque : la page indique que les données ont été mises à jour le 2026-11-16 à 09:39 (UTC+8), avec pour source l’interface de tarification en temps réel du système
- Lien :
-
Explication des jetons et des groupes APIYI : liste blanche, jetons indépendants, groupes par défaut et de secours
- Lien :
docs.apiyi.com/faq/token-and-groups.md - Remarque : explique les conditions préalables pour « changer de modèle avec une seule clé API »
- Lien :
-
Annonce Anthropic Claude Fable et Mythos 5.2 : ID des modèles, prix officiels et fast mode
- Lien :
anthropic.com/claude-fable-and-mythos-5-2 - Remarque : contient les exigences de vérification de Mythos et des recommandations de sélection
- Lien :
-
Vue d’ensemble des modèles Anthropic : liste actuelle des modèles Claude
- Lien :
platform.claude.com/docs/en/about-claude/models/overview - Remarque : confirme les noms des modèles existants
- Lien :
-
Page du modèle Qwen4-Max sur Alibaba Cloud Bailian : spécifications, tarification en RMB et quota gratuit de Bailian
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max - Remarque : les prix et les quotas sont repris tels quels depuis la documentation Bailian
- Lien :
-
Mise en ligne et mises à jour des modèles Alibaba Cloud : date de mise en ligne de qwen4-max et périmètre de déploiement
- Lien :
help.aliyun.com/zh/model-studio/newly-released-models - Remarque : date enregistrée : 2026-11-16
- Lien :
-
Blog officiel Qwen et publications du compte officiel : prix en dollars annoncés et QwenCloud
- Lien :
qwen.ai/blog?id=qwen4-max - Remarque : le prix en dollars est une déclaration officielle, à distinguer du prix en RMB de Bailian
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site officiel APIYI ; pour plus de détails sur les modèles et les groupes, consultez le centre de documentation.