Résumé : à partir de rapports de test tiers publics, cet article analyse les performances de Qwen4-Max-Preview sur des tâches comme la machine à pinces, la réparation d’un service Python et la recherche dans 1 600 tickets, et précise ses limites en matière de temps d’exécution et de jugement scientifique.
Conclusion d’emblée : l’essentiel sur les capacités de programmation de Qwen4-Max-Preview
Les rapports de test publics montrent que Qwen4-Max-Preview sait faire avancer un développement en plusieurs étapes, compléter les tests et livrer des projets reproductibles. La preuve la plus solide vient d’une tâche de correction de code : le modèle commence par reproduire le bug, puis ajoute des tests, envoie de vraies requêtes HTTP et vérifie l’intégrité des données, pour aboutir à 57 tests tous au vert. Ses points faibles sont tout aussi nets : les tâches complexes prennent longtemps — environ 75 minutes pour la machine à pinces — et, sur une tâche de recherche scientifique, l’explication du modèle dépasse le cadre des preuves disponibles. Les livrables complexes comme les conclusions scientifiques demandent donc une relecture par un développeur.
Nous commencerons ci-dessous par la tâche de la machine à pinces, avant de parcourir un rapport couvrant 12 tâches, en nous concentrant sur deux ensembles de preuves vérifiables : la correction de code et la recherche dans les tickets. Nous illustrerons ensuite les limites du raisonnement du modèle avec le cas de la factorisation matricielle non négative, puis nous aborderons la question de l’efficacité en comparant le même défi de machine à pinces avec d’autres outils, pour finir par les types de tâches qu’il est raisonnable de lui confier. Cet article est une analyse d’évaluation fondée sur des rapports publics : nous n’avons pas réexécuté les projets des auteurs, et chaque chiffre est accompagné de sa source et de ses conditions de test.
À savoir : comprendre les 9 termes de l’évaluation de Qwen4-Max-Preview
| Terme | Explication |
|---|---|
| Agent | Mode de fonctionnement où le modèle planifie lui-même les étapes, appelle des outils et fait avancer la tâche progressivement. |
| Machine à états | Piloter le comportement d’un programme à l’aide d’un ensemble d’états et de règles de transition entre ces états, par exemple le « déplacer — saisir — remonter — régler » d’une machine à attraper les peluches. |
| Tests de régression | Revérifier les fonctionnalités existantes après une modification du code, pour confirmer que l’ancien comportement n’a pas été cassé. |
| Requête HTTP | Requête envoyée par un client à un serveur, pour vérifier ce que l’interface renvoie en conditions réelles d’exécution. |
| Vérification par hachage | Calculer la valeur de condensé (hash) du contenu d’un fichier, puis comparer avant et après pour déterminer si les données d’origine ou le fichier de test ont été modifiés. |
| Débit de tokens | Nombre de tokens traités ou générés par unité de temps ; la valeur dépend des outils, du réseau et de l’environnement d’exécution. |
| Récupération contextuelle | Localiser et mettre en relation les informations cibles parmi un grand volume de documents transportés dans une seule requête. |
| Factorisation matricielle non négative | Algorithme qui approxime une matrice de données non négative sous la forme du produit de deux matrices de facteurs non négatifs. |
| Solution localement optimale | Solution qu’il n’est plus possible d’améliorer dans son voisinage ; déterminer si une solution est localement optimale exige des conditions mathématiques supplémentaires ou une analyse. |
1 Réaliser une machine à pinces en 75 minutes : une tâche de programmation complexe pour Qwen4-Max-Preview
1.1 Ce qu’évalue la tâche de la machine à pinces
Le 12 novembre 2026, le média 人人都是产品经理 a publié un compte rendu de test de Qwen4-Max-Preview via Qoder. L’exercice le plus complexe portait sur un système interactif de machine à pinces. Cette tâche concentre plusieurs difficultés de programmation dans un même projet : interaction mécanique et retour de force, balancement pendulaire d’un câble, collisions entre les peluches, machine à états du flux de contrôle et, au final, logique de score.
Ce genre de tâche est difficile à réussir en une seule génération. Les effets physiques, les transitions d’état et les règles de score dépendent les uns des autres. Le modèle doit donc écrire, exécuter, observer et corriger de façon répétée. C’est donc la capacité d’un agent à avancer par étapes successives qui est évaluée.
1.2 Temps, vitesse et consommation relevés par l’auteur
| Indicateur | Relevé de l’auteur | Conditions de test et remarques |
|---|---|---|
| Temps total | Environ 75 minutes | Environnement Qoder, tâche unique |
| Vitesse de sortie | Environ 33 Tokens/s | Vitesse observée lors de cette tâche |
| Consommation de Credits | Environ 65 | Estimation de l’auteur, selon le comptage Token Plan |
| Qualité de livraison | Plutôt solide | Évaluation subjective de l’auteur, qui estime l’ensemble comparable à Kimi K3.1 |
Ces chiffres ne valent que pour cette tâche. Les Credits sont l’unité de mesure de l’abonnement Token Plan. La consommation réelle dépend de l’entrée, des hits de cache, de la sortie, des tokens de raisonnement et des appels d’outils ; 65 Credits ne donnent donc qu’un ordre de grandeur du coût de cette tâche. Les 33 Tokens/s sont aussi une valeur observée dans un environnement précis.
Le même rapport mentionne plusieurs autres tâches. Dans une tâche de peinture à l’encre utilisant uniquement NumPy et PIL, le modèle a généré plus de 1 000 lignes de code, tracé environ 4 019 traits de pinceau et s’est auto-vérifié grâce à des statistiques de luminosité des pixels et à un balayage de contours ASCII. Après avoir constaté que l’hirondelle chevauchait le bloc noir de l’ouverture de fenêtre, il a ajusté les coordonnées de sa propre initiative. L’auteur juge son organisation du code et sa capacité d’auto-vérification plutôt bonnes, tout en estimant que le rendu esthétique peut encore progresser.
2 Ce que couvrent les douze tâches réelles de Qwen4-Max-Preview
2.1 Un rapport de test plus complet
Le 16 novembre, le média 人人都是产品经理 a publié un rapport de test de Z Finance. L’auteur indique avoir réalisé 12 tâches et avoir procédé à des vérifications ponctuelles ainsi qu’à des recontrôles sur les résultats clés. Le tableau ci-dessous récapitule les tâches couvertes par le rapport :
| Catégorie | Tâche de test | Compétences principalement évaluées |
|---|---|---|
| Génération visuelle | SVG d’un pélican à vélo | Compréhension visuelle, génération de code |
| Analyse financière | Analyse croisée de trois rapports financiers | Compréhension de documents longs, conventions comptables |
| Lecture de graphiques | Graphique en barres des revenus des produits Apple | Lecture de graphiques, estimation numérique |
| Collaboration bureautique | Trois rounds de révision d’un compte rendu de réunion | Maintien du contexte, cohérence des modifications |
| Traitement de données | Nettoyage de 44 lignes de données de ventes | Déduplication, conversion d’unités, formules |
| Présentation | PPT sur l’introduction en bourse de Pingtouge | Recherche en temps réel, génération de fichiers |
| Recherche dans un long texte | 1,600 tickets d’assistance client | Corrélation entre enregistrements, filtrage conditionnel |
| Maintenance de code | Réparation d’un service de tickets en Python | Localisation des défauts, tests et régression |
| Reproduction scientifique | Algorithme de factorisation matricielle non négative | Implémentation d’algorithmes, validation numérique |
| Développement web | Page de présentation des documents de prospectus | HTML, livraison hors ligne, interaction |
| Système de simulation | Simulation d’un jardin de pluie | Conception interactive, calcul numérique |
| Développement de jeu | Petit jeu 3D sur le thème des quatre saisons | Scènes 3D, gestion d’état, interaction |
2.2 Cinq cas à retenir
Parmi ces 12 tâches, les cinq suivantes illustrent le mieux la capacité du modèle à livrer des « résultats exploitables » :
- Analyse financière : en entrant les rapports annuels FY2026 d’Apple et de Costco, ainsi que la deuxième version du prospectus d’Anthropic, la tâche a été réalisée en environ 8 minutes. Les 6 chiffres clés vérifiés par échantillonnage étaient tous corrects ; le modèle a distingué la perte d’exploitation de la perte nette, a signalé l’impact des variations de juste valeur des obligations convertibles sur la perte nette, et n’a pas inventé de prévisions futures non divulguées.
- Nettoyage Excel : parmi les 44 lignes de détail des ventes se trouvaient des enregistrements dupliqués, des doublons ne différant que par des espaces, deux unités (le yuan et la dizaine de milliers de yuans), trois formats de date et 5 commandes manquantes. Après nettoyage, il restait 35 lignes ; les quatre régions totalisaient 215,700 yuans, et les 5 cellules de synthèse utilisaient toutes de vraies formules, de sorte que les totaux se mettaient à jour automatiquement après modification des détails.
- Génération de PPT : grâce à une recherche en temps réel, le modèle a identifié les informations de l’annonce de scission, généré un PPT modifiable et distingué les prévisions de valorisation du prix d’émission ; après un deuxième ajustement du public cible, les 20 chiffres clés, dates et noms initiaux sont restés inchangés. L’auteur signale toutefois une omission concernant une gamme de produits.
- Recherche dans les tickets et réparation Python : ces deux éléments de preuve sont les plus concrets et sont détaillés respectivement dans la section 4 et la section 3.
Le point commun de ces tâches, c’est que les livrables peuvent être vérifiés : les formules se recalculent-elles en chaîne, les chiffres correspondent-ils au texte source, les tests passent-ils. Ce type de preuve est plus convaincant que « un morceau de code qui a l’air correct ».
3 57 tests réussis : la preuve d’ingénierie la plus convaincante pour Qwen4-Max-Preview
3.1 Reconstitution complète du processus de correction
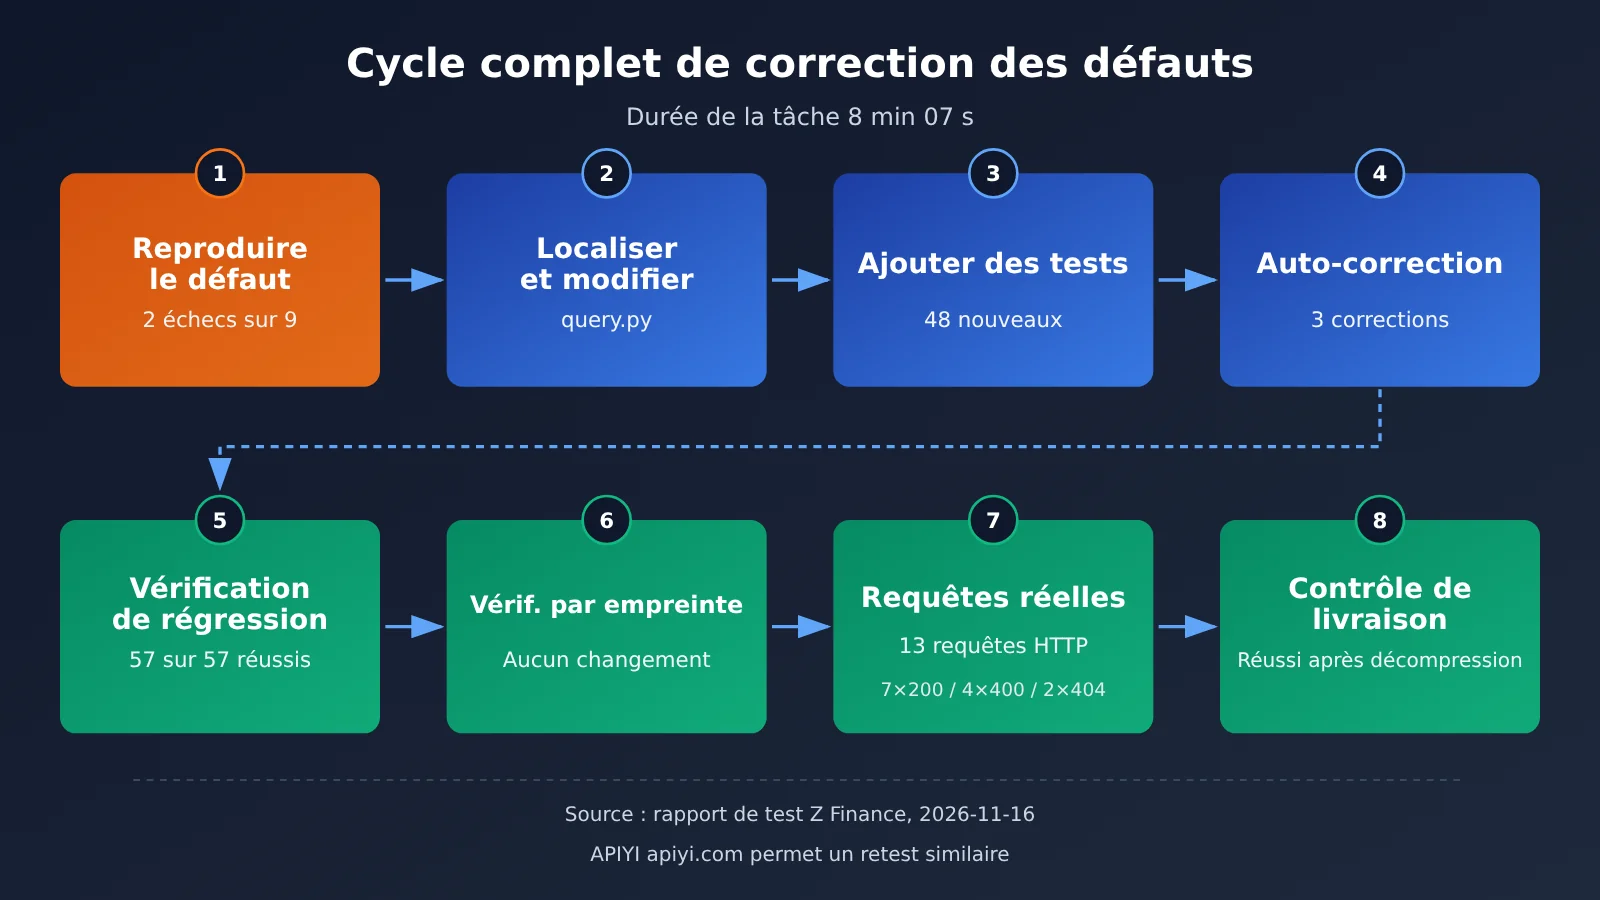
Le sujet testé est un service de consultation de tickets écrit avec la bibliothèque standard de Python ; les défauts concernent le filtrage combiné, le tri, la pagination et la validation des paramètres. La tâche demandait de corriger les défauts tout en préservant l’interface, les données d’origine et les tests existants. Le rapport indique que cette tâche a pris 8 minutes et 07 secondes, et le déroulement est le suivant :
| Étape | Action du modèle | Portée en ingénierie |
|---|---|---|
| Reproduction du défaut | Exécution des 9 tests existants, dont 2 échouent | Confirmer d’abord l’existence du problème, puis modifier |
| Localisation des modifications | Modifications principalement concentrées dans query.py | Périmètre d’intervention restreint, effets de bord réduits |
| Ajout de tests | 48 nouveaux tests | Couverture des cas limites non couverts par les tests initiaux |
| Autocorrection | Correction de 3 problèmes dans ses propres tests | Détection d’erreurs dans les tests eux-mêmes et correction immédiate |
| Vérification de non-régression | Les 57 tests passent tous au final | 9 tests existants plus 48 nouveaux tests |
| Contrôle d’intégrité | Hachage des données d’origine et des tests existants, valeurs inchangées | Preuve qu’aucune donnée ni aucun test n’a été falsifié pour « réussir » |
| Requêtes réelles | Démarrage du service local et envoi de 13 requêtes HTTP : 7 réponses 200, 4 réponses 400, 2 réponses 404 | Vérification des réponses normales et de la gestion des erreurs à l’exécution |
| Revalidation du livrable | Nouvelle exécution après décompression du paquet final, les tests passent | Confirmation que le livrable s’exécute de manière autonome |
3.2 Pourquoi c’est plus parlant que la génération de code
En programmation assistée par IA, deux modes d’échec sont fréquents : modifier les tests ou les données pour les faire « passer au vert », et un code qui réussit les tests mais échoue à l’exécution réelle. Le contrôle de hachage de cette tâche vise le premier risque ; les requêtes HTTP réelles et la revalidation du paquet livré visent le second. Les 4 réponses 400 et les 2 réponses 404 montrent que le modèle a aussi validé les chemins d’erreur : la validation des paramètres et le traitement d’une ressource inexistante ont été réellement testés.
Ce déroulement rejoint les habitudes d’un ingénieur chevronné qui corrige un bug : reproduction, correction, ajout de tests, non-régression, livraison. Cela prouve que Qwen4-Max-Preview dispose d’une boucle de maintenance complète sur un service aux règles claires et à l’échelle maîtrisée. Il s’agit toutefois du compte rendu d’une seule tâche, qui ne peut pas être converti en un taux de réussite universel de correction de code.
La valeur concrète d’un contexte de 4 millions de tokens : retrouver un indice à 741 lignes d’écart parmi 1 600 tickets
4.1 Conception et résultats du test
La fenêtre de contexte officiellement annoncée pour Qwen4-Max-Preview est de 1 000 000 de tokens. Mais la taille de la fenêtre n’est qu’un plafond de capacité : ce qui détermine sa valeur pratique, c’est la capacité du modèle à établir les bonnes corrélations dans une grande quantité de documents. Le test réalisé sur des tickets, relayé dans le rapport de Z Finance, répond justement à cette question.
Les données de test comprenaient 1 600 tickets de support client, soit environ 500 000 octets. Les indices clés étaient répartis entre deux enregistrements séparés par 741 lignes, et cinq questions ont été posées. Le rapport indique que les cinq réponses étaient toutes correctes, avec notamment les résultats suivants :
- Relier deux tickets dispersés pour retrouver un remboursement de 1 386 yuans ainsi que la personne qui l’a traité.
- Déterminer, à partir de la date d’approbation, si la nouvelle politique de bons de compensation s’appliquait à ce cas.
- Compter 62 tickets répondant aux conditions indiquées, avec un résultat identique à celui du script.
- Identifier deux ensembles de numéros de commande en doublon et distinguer lequel relevait d’un flux normal et lequel correspondait à un conflit d’informations client.
4.2 Octets et tokens : deux unités distinctes
Les quelque 500 000 octets correspondent à la taille du fichier. Le nombre de tokens, lui, dépend de la tokenisation et de la proportion de chinois et d’anglais : les deux mesures doivent donc être calculées séparément. Ce test démontre une capacité à établir des corrélations entre enregistrements et à filtrer selon des conditions dans un corpus de taille moyenne. Il reste toutefois bien en dessous du plafond de 1 000 000 de tokens de la fenêtre de contexte et ne constitue donc pas un test de charge à capacité maximale.
L’intérêt du troisième résultat tient à sa vérifiabilité : les 62 tickets correspondent au décompte du script, ce qui montre que le comptage effectué par le modèle peut être contrôlé par un programme déterministe. En pratique, il est recommandé d’adopter la même méthode : vérifier avec un script les résultats statistiques fournis par le modèle, puis réserver le modèle aux tâches de mise en relation et d’interprétation, celles que les scripts ont du mal à accomplir.
5 Un point faible à ne pas négliger : les conclusions excessives de Qwen4-Max-Preview en raisonnement scientifique
5.1 Les calculs sont justes, l’explication dépasse les preuves
La tâche de reproduction scientifique demandait d’implémenter l’algorithme de mise à jour multiplicative pour la factorisation matricielle non négative, à partir de l’article indiqué. La matrice d’entrée était de 48×36, avec trois jeux de valeurs initiales différents et 500 itérations par groupe. Le rapport indique un temps d’exécution de 10 min 06 s pour le modèle ; celui-ci a fourni le code, les résultats numériques, les graphiques et les journaux. Chaque groupe comptait 52 points de contrôle, les points de contrôle clés du groupe A concordaient avec les résultats de référence publics, et 63 vérifications internes ont également été consignées.
Le problème se situe au niveau de la conclusion. Le modèle a interprété la baisse continue de la fonction objectif comme une convergence vers un optimum local. L’auteur souligne qu’il s’agit là d’une surinterprétation.
5.2 Trois notions à évaluer séparément
Ce cas fait intervenir trois niveaux de jugement, chacun exigeant des preuves plus solides que le niveau précédent :
- Baisse de la fonction objectif : c’est une caractéristique de conception de la règle de mise à jour multiplicative, directement observable dans les journaux et les graphiques.
- Convergence de l’itération numérique : il faut vérifier si la variation des quantités itérées tend à se stabiliser et fixer un critère d’arrêt explicite.
- Convergence vers un optimum local : il faut valider les conditions d’optimalité, par exemple les conditions KKT ; la seule baisse de la valeur de la fonction ne permet pas de conclure.
Cela montre que la capacité d’exécution du modèle et la rigueur de son argumentation doivent être évaluées séparément. Les calculs numériques peuvent être vérifiés à l’aide de points de contrôle, tandis que les conclusions scientifiques doivent être examinées par une personne disposant du contexte pertinent. Dans le cadre de travaux de recherche, de reproduction d’articles ou de rapports techniques, le « paragraphe de conclusion » produit par le modèle doit être traité comme un brouillon.
6 Comparaison de Qwen4-Max-Preview avec d’autres outils de programmation sur la même tâche
6.1 Données comparatives du défi de la machine à pince
Le rapport du 12 novembre présente également les enregistrements du même défi de la machine à pince pour différents outils. Dans le tableau d’origine, la ligne Qwen est étiquetée Qwen4-Max, avec une date de test au 12 novembre, antérieure à la mise en ligne de la version officielle le 16 novembre, ce qui correspond au modèle de la phase de préversion.
| Outil/modèle | Durée | Volume total de tokens traités (estimation) | Tokens de sortie | Accès au retest |
|---|---|---|---|---|
| Codex | 8 minutes | 3,5 millions | 28 000 | Outil officiel correspondant |
| Claude Code | 17 minutes | 12,15 millions | 130 000 | Outil officiel ; le modèle Claude peut être appelé via APIYI apiyi.com |
| Gemini | 21 minutes | 13,94 millions | 81 000 | Outil officiel ; le modèle Gemini peut être appelé via APIYI |
| Kimi Code | 36 minutes | 9,5 millions | 59 000 | Outil officiel correspondant |
| DSH | 46 minutes | 46,44 millions | 281 000 | Outil officiel correspondant |
| MiniMax Code | 68 minutes | 40 millions | 198 000 | Outil officiel correspondant |
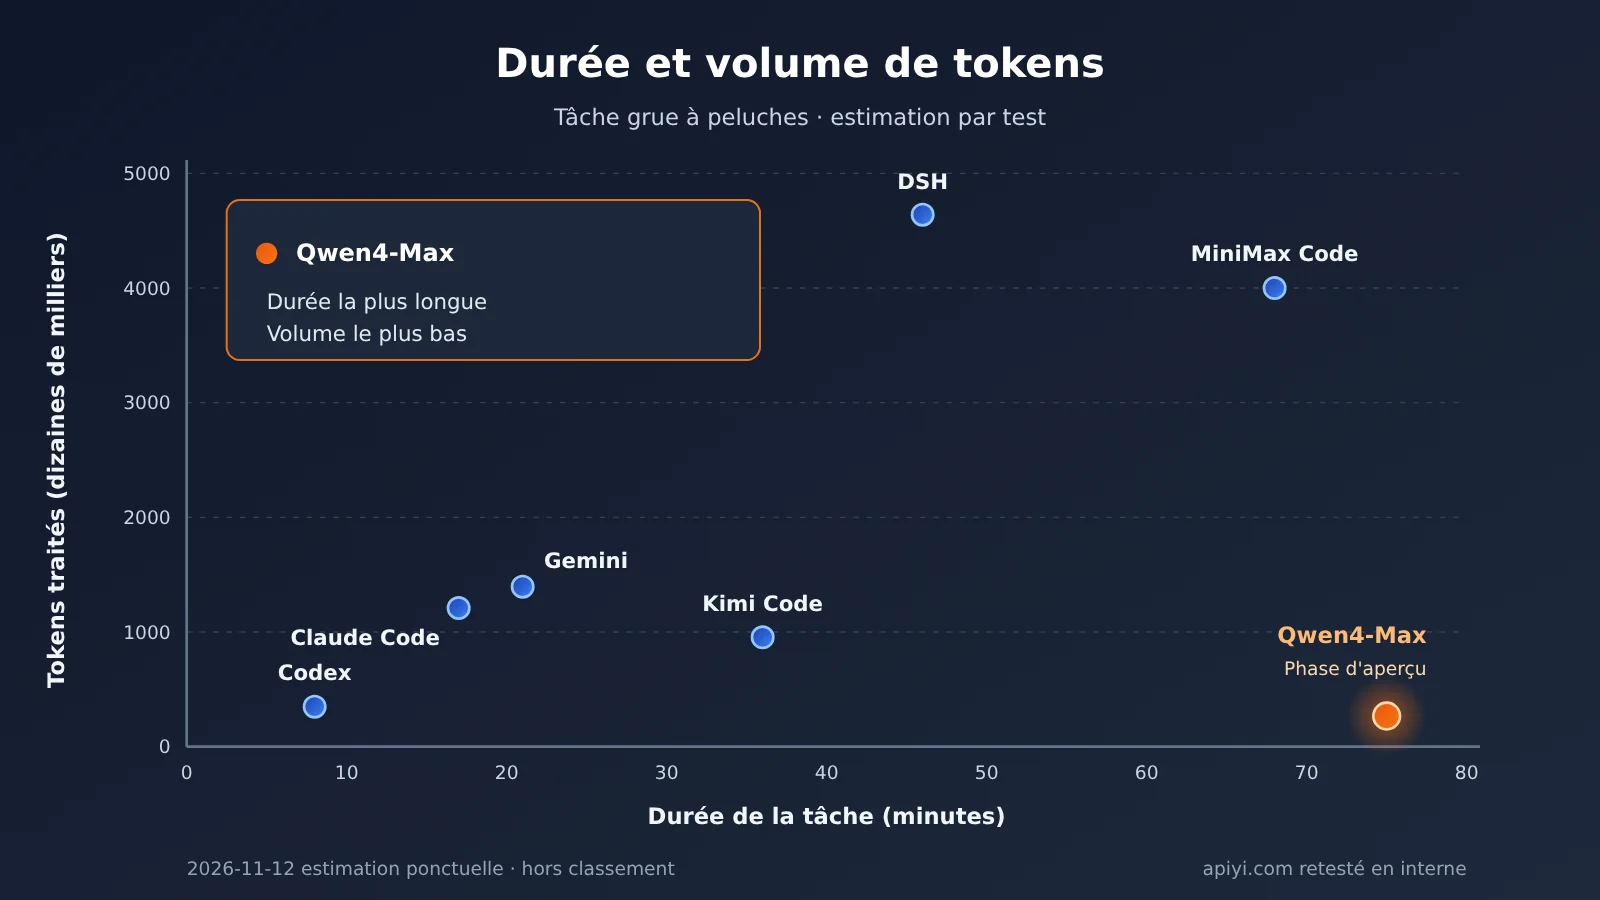
| Qwen4-Max (phase de préversion) | 75 minutes | 2,69 millions | 55 000 | Token Plan (Qoder) |
6.2 Comment lire ces données
Les données révèlent un contraste frappant : sur cette tâche, Qwen4-Max-Preview affiche le volume total de tokens traité le plus faible, environ 2,69 millions, mais aussi la durée la plus longue, environ 75 minutes. Combiné à la vitesse observée d’environ 33 tokens/s, on voit que le goulot d’étranglement de cette tâche se situe au niveau de la vitesse de génération, et non dans l’ampleur des tokens consommés.
Ces données ne se prêtent pas à un classement, pour trois raisons : le total de tokens est une estimation de l’auteur ; la part de cache de contexte, la stratégie d’appel et le mode d’exécution diffèrent d’un outil à l’autre ; et les versions précises des modèles du tableau ne sont pas uniformément documentées. Un volume de tokens traité faible peut venir de moins de relectures répétées, ou d’une différence de stratégie de cache au niveau de l’outil : les éléments disponibles ne permettent pas de distinguer les deux. Ce que ces données permettent d’affirmer, c’est que dans cet environnement d’outils, Qwen4-Max-Preview convient aux tâches pour lesquelles le temps d’attente importe peu et où l’on privilégie la complétude de la livraison.
7 Quels développeurs gagneraient à essayer Qwen4-Max-Preview
7.1 Scénarios adaptés et cas à manier avec prudence
En croisant les deux rapports, Qwen4-Max-Preview se montre plutôt stable sur les tâches suivantes :
- Maintenance de code aux règles bien définies : corrections et ajouts de tests sur des bases existantes, avec des frontières de problème claires.
- Recherche et mise en relation dans de longs documents : recherche croisée entre enregistrements dans les tickets, journaux, contrats et rapports financiers, avec vérification des résultats statistiques par script.
- Automatisation bureautique : nettoyage de données, Excel avec formules, PPT modifiables et retouches en plusieurs tours.
- Développement de prototypes interactifs : pages web en un seul fichier, systèmes simulés et prototypes de petits jeux — par exemple la page de démonstration hors ligne d’environ 46KB sans dépendance externe citée dans le rapport.
Trois familles de tâches appellent en revanche de la prudence : le développement interactif sensible au temps de réponse (une seule tâche peut durer plus d’une heure), les conclusions exigeant une démonstration mathématique ou scientifique rigoureuse, et les modifications en production à haute exigence de fiabilité. Les auteurs du rapport le résument d’ailleurs ainsi : « sur les tâches à large portée, certaines informations sont omises » et « le livrable final demande toujours une vérification humaine ».
Avant de vous lancer, gardez aussi en tête les restrictions officielles : Preview ne s’utilise de façon interactive que via le Token Plan d’Aliyun, dans des outils comme Claude Code, Cursor ou Qoder ; la facturation à l’usage n’est pas prise en charge, et la période de prévisualisation se termine le 25 novembre 2026 à 24h00 (heure de Pékin), après quoi le service sera retiré. La version officielle Qwen4-Max est disponible depuis le 16 novembre et il est recommandé de migrer vers celle-ci. Les paramètres diffèrent : en mode réflexion, la sortie maximale de la version officielle est de 262 144 Tokens, contre 393 216 Tokens pour Preview — il faudra donc réajuster votre budget de sortie lors de la migration.
7.2 Refaire une évaluation comparable avec vos propres tâches
Un rapport de seconde main peut tout au plus démontrer que « ce modèle en est capable ». Pour savoir s’il convient à votre équipe, la méthode la plus directe consiste à le confronter à votre propre code et à vos propres tests. L’exemple ci-dessous envoie une tâche de correction de code via l’interface compatible OpenAI et enregistre la durée ainsi que la consommation de tokens. Pour le nom du modèle, fiez-vous au nom réel figurant dans la liste des modèles de la plateforme.
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interface unifiée APIYI, compatible OpenAI
)

resp = client.chat.completions.create(
    model="qwen4-max",  # Se fier au nom réel dans la liste des modèles APIYI
    messages=[{"role": "user", "content": "Lisez le code et le test en échec ci-dessous et proposez un patch de correction minimal : ..."}]
)
print(resp.choices[0].message.content)
Voir le script de re-test comparatif multi-modèles
import time
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Une seule clé pour appeler plusieurs modèles
)

# Remplacer par les noms réels de la liste des modèles de la plateforme
MODELS = ["qwen4-max", "claude-sonnet-model-name", "gpt-model-name"]

TASK = """Vous allez recevoir le code source d'un service Python et les résultats des tests.
Exigences : 1) expliquez d'abord la cause de l'échec reproduit ; 2) ne modifiez que les fichiers nécessaires ;
3) ajoutez des tests couvrant les cas limites ; 4) ne modifiez ni les données d'origine ni les tests existants.
--- Code source et sortie des tests ---
{payload}
"""

def run_case(model: str, payload: str) -> dict:
    start = time.time()
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": TASK.format(payload=payload)}],
        max_tokens=32000,  # Les tokens de réflexion des modèles de raisonnement consomment aussi le budget de sortie : prévoyez de la marge
    )
    usage = resp.usage
    return {
        "model": model,
        "seconds": round(time.time() - start, 1),
        "prompt_tokens": usage.prompt_tokens,
        "completion_tokens": usage.completion_tokens,
        "answer": resp.choices[0].message.content,
    }

if __name__ == "__main__":
    payload = open("bug_context.txt", encoding="utf-8").read()
    for m in MODELS:
        r = run_case(m, payload)
        print(f"{r['model']}: {r['seconds']}s, "
              f"in={r['prompt_tokens']}, out={r['completion_tokens']}")
        # Appliquer le patch dans un répertoire isolé, lancer les tests et vérifier par hachage les données d'origine avant de noter
Le script ne sert qu’à collecter les propositions et la consommation ; l’étape de notation doit reprendre la méthode du rapport : appliquer le patch dans un répertoire isolé, exécuter les tests existants et les nouveaux tests, puis vérifier par hachage que les données et les anciens tests n’ont pas été modifiés. C’est à cette condition que les conclusions seront valables pour votre base de code.
🚀 Démarrage rapide : pour comparer plusieurs modèles sur un même ensemble de tâches, vous pouvez obtenir des crédits de test gratuits via APIYI apiyi.com. La plateforme propose une interface compatible OpenAI : une seule clé API suffit pour passer d’un modèle à l’autre parmi OpenAI, Claude, Gemini et autres modèles majeurs, ce qui facilite l’exécution du script de re-test dans un même pipeline d’évaluation.
8 Questions fréquentes sur l’évaluation de Qwen4-Max-Preview
Q1 : 75 minutes pour réaliser la machine à pince, cela signifie-t-il qu’il est lent ?
Dans cette tâche Qoder, son temps d’exécution était le plus long du tableau de comparaison, avec une vitesse de sortie observée d’environ 33 Tokens/s. Il ne s’agit que d’un relevé dans un seul environnement ; l’ordonnancement des outils et les conditions réseau influencent aussi le résultat. Si votre cas d’usage est sensible au temps d’attente, mieux vaut le tester avec vos propres tâches.
Q2 : Le passage de 57 tests représente-t-il son taux de réussite en correction de code ?
Cela représente un processus de correction complet et vérifiable, mais ne se convertit pas en taux de réussite. Pour évaluer ses performances sur votre propre projet, vous pouvez utiliser APIYI apiyi.com afin de comparer plusieurs modèles sur le même jeu d’échantillons de bogues, puis les noter selon le passage des tests et les résultats de la vérification de hachage.
Q3 : Le test des tickets a-t-il validé un contexte de 1 million de Tokens ?
Non. Ce test fait environ 500 000 octets ; le nombre de Tokens dépend de la tokenisation, et l’échelle reste bien en dessous de la limite de la fenêtre. Ce qu’il valide, c’est la capacité à corréler des enregistrements entre eux et à filtrer selon des conditions.
Q4 : Que faire une fois la Preview terminée ?
La version officielle Qwen4-Max est déjà en ligne, et son utilisation est recommandée. Elle prend en charge l’API à facturation à l’usage, la sortie maximale en mode réflexion est de 262 144 Tokens, et il faudra ajuster le budget de sortie lors de la migration. La disponibilité et les prix sur les plateformes tierces évoluent rapidement : vérifiez dans la liste de modèles d’APIYI apiyi.com les noms de modèles actuellement disponibles avant de vous connecter.
Q5 : Peut-on placer la clé du Token Plan dans le backend de sa propre application ?
Non. Les règles officielles stipulent que le Token Plan est réservé à un usage interactif dans les outils de programmation et les outils d’agents autorisés. Les appels par lots via des scripts automatisés et les backends d’applications auto-hébergés ne font pas partie du périmètre autorisé ; une infraction peut entraîner la suspension de l’abonnement ou le blocage de la clé. Pour une application auto-hébergée, il convient de choisir un produit API conforme au périmètre d’utilisation.
9 Points clés de l’évaluation de Qwen4-Max-Preview
- Boucle de livraison complète : les tâches de correction de code couvrent la reproduction, le correctif, les tests complémentaires, la vérification de hachage, les requêtes réelles et la re-vérification de la livraison, avec 57 tests réussis.
- Corrélation sur textes longs : sur 1 600 tickets, des indices corrélés sur 741 lignes, 5 questions sur 5 correctes, 62 statistiques cohérentes avec le script.
- Livrables bureautiques : les formules Excel restent liées entre elles, et après plusieurs rounds de modification du PPT, les 20 faits clés demeurent inchangés.
- Point faible : la vitesse : la tâche de la machine à pince demande environ 75 minutes, avec un faible volume de tokens traités et une durée longue.
- Limites du raisonnement : les calculs de reproduction scientifique concordent avec les résultats de référence, mais les conclusions vont au-delà des preuves et nécessitent une relecture humaine.
- Nature des preuves : tout ce qui précède provient de tests de tâches réalisés par un seul auteur, et ne constitue pas un classement standardisé.
- Pour démarrer : refaites vos propres tests avec votre code et vos suites de tests, et utilisez APIYI apiyi.com pour basculer entre plusieurs modèles au sein d’une même interface.
10 Conclusion : où les développeurs devraient utiliser Qwen4-Max-Preview
Le portrait dressé par le rapport public est assez clair. Qwen4-Max-Preview excelle dans les travaux dotés de règles explicites et de résultats vérifiables : maintenance de code avec tests, recherche croisée d’enregistrements dans de longs corpus, traitement de données avec formules et fichiers bureautiques éditables, ainsi que développement de prototypes interactifs. Sur ces tâches, il sait ajouter lui-même des tests, détecter ses erreurs et livrer des résultats que l’on peut vérifier.
Ses limites sont tout aussi concrètes : les tâches complexes prennent du temps, mieux vaut les lancer en arrière-plan ; les conclusions scientifiques dépassent facilement le cadre des preuves et exigent un examen par un expert ; la Preview n’est utilisable en interaction que via le Token Plan dans les outils désignés, et sera retirée le 25 novembre — pour un usage à long terme, il faut passer à la version officielle.
L’approche la plus pragmatique consiste à le considérer comme un assistant d’ingénierie capable de mener seul une boucle de maintenance, le développeur gardant la main sur la validation des conclusions et la fusion finale. Avant la mise en production, je recommande de faire une comparaison multi-modèles sur vos propres tâches réelles : l’interface unifiée d’APIYI apiyi.com permet de réaliser tests et comparaisons dans un même flux.
📚 Références
-
人人都是产品经理 : La version preview de Qwen4-Max est arrivée ! Test en conditions réelles, impressions partagées : Test du claw machine sur Qoder et comparaison entre outils, 2026-11-12
- Lien :
woshipm.com/ai/6492544.html - Description : Source des 75 minutes passées, des 33 Tokens/s, des 65 Credits et du tableau comparatif
- Lien :
-
人人都是产品经理 : Test réel de Qwen4-Max-Preview (rapport de test Z Finance) : Test complet sur 12 tâches, 2026-11-16
- Lien :
woshipm.com/evaluating/6494229.html - Description : Source des données sur la correction de code, la recherche de tickets, la reproduction scientifique et les tâches bureautiques
- Lien :
-
Alibaba Cloud Model Studio : Documentation de Qwen4-Max-Preview : Spécifications officielles et instructions d’utilisation
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max-preview - Description : Fenêtre de contexte, sortie maximale, période de preview et méthode d’accès
- Lien :
-
Alibaba Cloud Model Studio : Documentation de Qwen4-Max : Paramètres et facturation de la version officielle
- Lien :
help.aliyun.com/zh/model-studio/qwen4-max - Description : Budget de sortie de la version officielle et informations sur la facturation à l’usage
- Lien :
-
Alibaba Cloud : Permissions et règles d’utilisation de Token Plan : Limites du périmètre d’utilisation
- Lien :
help.aliyun.com/zh/model-studio/token-plan-permissions-and-usage - Description : Exigences d’utilisation interactive et scénarios interdits
- Lien :
Auteur : Équipe technique APIYI
Échanges techniques : N’hésitez pas à nous contacter depuis la page d’accueil du site APIYI apiyi.com. Pour plus de ressources d’intégration, consultez le centre de documentation docs.apiyi.com.