Note de l’auteur : ce comparatif décompose par tâche les scores auto-déclarés par Tencent, le coût par tâche, les prix officiels et les prix via le canal APIYI de Hy4 flash et DeepSeek-V4.1-Flash-1017, afin de vous aider à décider s’il faut basculer vos tâches quotidiennes.
Le 16 novembre 2026, Tencent Hunyuan a lancé Hy4 flash, que la publication officielle présente comme « le modèle de productivité quotidienne le moins cher ». Si vous utilisez déjà DeepSeek-V4.1-Flash-1017, vous vous demandez sans doute si cela vaut le coup de migrer vos tâches quotidiennes. Cet article confronte les deux modèles sur un même ensemble de tâches : lequel obtient les meilleurs scores, lequel affiche le coût par tâche le plus faible, et à quel niveau se situent les prix officiels et les prix via APIYI.
Il ne s’agit pas d’un article qui proclame « le nouveau modèle gagne sur tous les tableaux ». Les tests à l’aveugle, les scores WorkIndex, les scores en annexe et les témoignages produit cités ici proviennent de la page de recherche de Tencent : ce sont des chiffres auto-déclarés par Tencent, pas des données que l’auteur a mesurées lui-même. Tâche par tâche, le verdict est clair : pour la rédaction bureautique collaborative et les questions-réponses visuelles, on peut s’appuyer sur l’annexe de Tencent pour voir l’avantage de coût de Hy4 flash ; sur Terminal-Bench 4.0, ProgramBench, DeepSWE et la réparation de PPT, les scores de DeepSeek restent plus élevés.
Valeur clé : après lecture, vous pourrez décider, selon le type de tâche, quelles requêtes basculer vers Hy4 flash et lesquelles garder sur DeepSeek V4.1 Flash, tout en distinguant la source de chaque chiffre de prix.
Différences clés entre Hy4 flash et DeepSeek V4.1 Flash
Commençons par les spécifications de base des deux modèles. Celles de Hy4 flash proviennent de la page de recherche de Tencent : 224B de paramètres totaux, dont 64B de paramètres Engram, avec 12B activés par token. Il est nativement multimodal et dispose d’une fenêtre de contexte de 1M tokens. Celles de DeepSeek V4.1 Flash viennent de la page de tarifs officielle de DeepSeek : le nom d’appel est deepseek-flash, la version actuelle est DeepSeek-V4.1-Flash-1017, le contexte est de 1M avec une sortie maximale de 384K, le modèle a des capacités visuelles et propose à la fois des interfaces au format OpenAI et au format Anthropic.
Leur positionnement diffère aussi. La page de recherche de Tencent recommande Hy4 flash pour les tâches du quotidien : recherche approfondie, traitement de documents, création de diaporamas, démos front-end simples et opérations sur ordinateur. Pour les charges complexes, en particulier l’ingénierie logicielle de longue haleine, Tencent conseille lui-même de continuer avec Hy4. DeepSeek V4.1 Flash est un modèle Flash généraliste, dont le mode réflexion est activé par défaut, et peut aussi être désactivé.
| Dimension de comparaison | Hy4 flash | DeepSeek V4.1 Flash (1017) | Plateforme disponible |
|---|---|---|---|
| Taille des paramètres | 224B au total, 12B activés (page de recherche) | Non indiqué sur la page de tarifs officielle | — |
| Contexte | 1M de tokens | 1M, sortie maximale de 384K | — |
| Multimodal | Nativement multimodal | Prend en charge la vision | — |
| Protocole | ID de modèle API non fourni sur la page de recherche | Format OpenAI, format Anthropic | — |
| Canaux officiels | Tencent Cloud TokenHub, WorkBuddy, Yuanbao, etc., OpenRouter bientôt disponible | API officielle DeepSeek | — |
| Statut sur APIYI | Pas encore disponible | Déjà disponible, notamment deepseek-v4.1-flash |
APIYI apiyi.com |
Il faut le préciser : la page de recherche ne donne pas l’ID de modèle API de Hy4 flash. Cet article n’invente pas d’ID. Lors d’un appel sur Tencent Cloud, référez-vous au nom affiché dans la console TokenHub.
Pourquoi Hy4 flash est moins cher : l’explication technique de la page de recherche
La page de recherche décrit trois leviers de réduction des coûts. L’entraînement préalable a utilisé l’attention hybride, LatentMoE et Engram, et le cache KV représente 1/24 de celui de Hy3 et 1/6 de celui de Hy4. Le post-entraînement part d’une auto-distillation de Hy4, et l’apprentissage par renforcement a réduit de 50 % le nombre moyen de tokens de sortie de bout en bout. Côté inférence, megakernel, quantification 4 bits et DFly permettent une vitesse de décodage supérieure à 150 tokens/s.
Tous ces éléments convergent vers la même chose : moins de tokens produits par tâche, un coût par token plus faible et une exécution plus rapide. Cela explique aussi pourquoi, dans l’annexe, son coût est inférieur à celui de DeepSeek dans presque toutes les cases. Mais un faible coût ne signifie pas un score élevé ; examinons maintenant les tâches une par une.
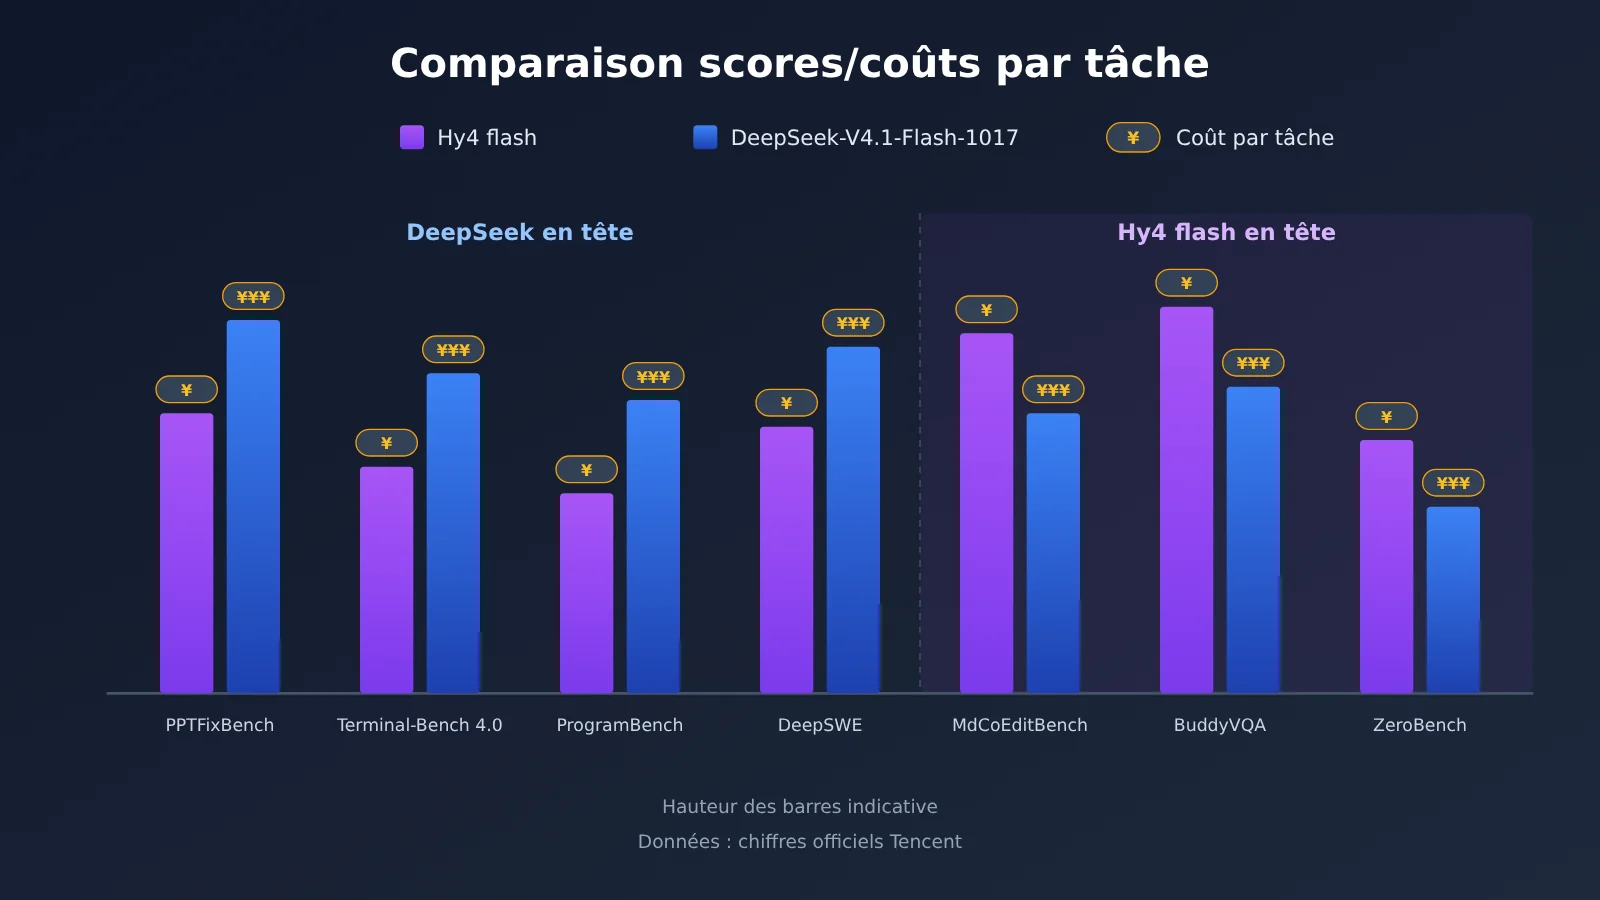
Données du graphique compilées à partir de l’annexe de la page de recherche de Tencent sur Hy4 flash (chiffres déclarés par Tencent lui-même). Les tarifs actuels des différentes offres DeepSeek peuvent être vérifiés un par un sur la page des prix d’apiyi.com.
Données de test en aveugle : Hy4 flash face à DeepSeek V4.1 Flash
La page de recherche de Tencent a publié une série de tests en aveugle menés par des humains : 85 utilisateurs internes de WorkBuddy, 259 tâches et 27 catégories. Les trois colonnes du tableau ci-dessous correspondent respectivement à la satisfaction sur une échelle de 4 points, au temps médian de bout en bout et au coût par tâche (en RMB). Toutes les données sont reprises telles quelles de la page de recherche.
| Modèle | Satisfaction (sur 4) | Temps médian de bout en bout | Coût par tâche (RMB) |
|---|---|---|---|
| DeepSeek-V4.1-Flash-1017 (high) | 3.09 | 10,3 minutes | 1,20 |
| Hy4 flash (niveau non précisé) | 2.79 | 6,7 minutes | 0,26 |
| Claude-Haiku-5.5 (high) | 2.81 | 6,8 minutes | 4,73 |
| GLM-5.3-Flash (high) | 2.53 | 7,6 minutes | 0,81 |
Trois points sont essentiels pour bien lire ce tableau. Premièrement, c’est DeepSeek qui obtient la meilleure satisfaction, avec 3,09, contre 2,79 pour Hy4 flash : on ne peut donc pas interpréter ce test en aveugle comme une preuve que Hy4 flash est plus agréable à utiliser. Deuxièmement, Hy4 flash se situe 0,02 point en dessous de Claude Haiku 5.5 ; la page de recherche emploie le terme « close to » (proche de), et non « dépasse ». Troisièmement, la « réduction du coût par tâche d’un facteur 18 » mentionnée dans le post officiel provient de 4,73 divisé par 0,26, soit environ 18,2 : la comparaison porte sur Haiku, pas sur DeepSeek.
Là où Hy4 flash est réellement en tête dans ce tableau, c’est sur le temps et le coût. Son temps de complétion médian est de 6,7 minutes, contre 10,3 minutes pour DeepSeek ; le coût par tâche est de 0,26 RMB contre 1,20 RMB. Si votre activité privilégie le temps d’attente et la facture, tout en acceptant une satisfaction légèrement inférieure, alors ces données ont un intérêt pour vous.
La page de recherche fournit par ailleurs un bilan au niveau du WorkIndex.
Sur le WorkIndex, le coût moyen par tâche de Hy4 flash correspond à 1/8 de celui de DeepSeek-V4.1-Flash-1017 (niveau Max, tarif heures de pointe).
Ce 1/8 ne concerne que le WorkIndex, et son périmètre est le niveau le plus élevé de DeepSeek au tarif heures de pointe : il ne peut pas remplacer les montants en RMB du tableau de test en aveugle. Le WorkIndex est composé de 8 ensembles internes, couvrant la génération de diaporamas, l’édition de diaporamas, la co-rédaction de diaporamas homme-machine, la co-rédaction Markdown homme-machine, l’édition de documents, la réparation de tableaux, le traitement audio/vidéo et la compréhension visuelle. Il s’agit d’une évaluation construite en interne par Tencent, et non d’un classement de leaderboard public.
Hy4 flash vs DeepSeek V4.1 Flash : comparaison tâche par tâche en annexe
L’annexe de la page de recherche donne, pour chaque tâche, le score et le coût par tâche. Les coûts sont calculés à partir des tarifs API officiels de chaque modèle, avec 1 USD pour 7,2 CNY. La colonne DeepSeek utilise les tarifs en heure de pointe, soit 2 CNY par million de tokens en entrée, 0,04 CNY en cas de succès du cache et 8 CNY en sortie. Cette grille en yuan est celle que Tencent a utilisée pour remplir son tableau : ce n’est pas le prix affiché par APIYI, et il ne faut pas la convertir en facture sur une quelconque plateforme. Tous les modèles sont pris dans leur niveau de raisonnement maximal.
| Tâche | Score / coût Hy4 flash | Score / coût DeepSeek-V4.1-Flash-1017 | Meilleur score |
|---|---|---|---|
| MdCoEditBench (co-rédaction Markdown) | 56,9 / 0,057 | 29,2 / 0,194 | Hy4 flash |
| BuddyVQA Atlas (sans outils) | 48,5 / 0,007 | 43,7 / 0,059 | Hy4 flash |
| ZeroBench-main (avec outils) | 45,8 / 0,077 | 16,5 / 0,095 | Hy4 flash |
| PPTCoEditBench (co-création de diaporamas) | 74,0 / 0,105 | 76,8 / 0,459 | DeepSeek |
| PPTFixBench (réparation de PPT) | 23,7 / 0,253 | 45,3 / 1,672 | DeepSeek |
| DeepSWE v1.1 | 64,6 / 0,290 | 73,8 / 1,304 | DeepSeek |
| ProgramBench (almost solved) | 16,0 / 0,561 | 29,0 / 9,214 | DeepSeek |
| Terminal-Bench 4.0 | 19,2 / 0,558 | 40,0 / 3,882 | DeepSeek |
| OSWorld 2.1 (partial score) | 68,1 / 0,451 | 68,4 / 2,073 | quasiment à égalité |
Le tableau fait ressortir deux familles de tâches. Du côté de la co-rédaction bureautique et des questions-réponses visuelles, Hy4 flash obtient de meilleurs scores sur la co-rédaction Markdown, BuddyVQA et ZeroBench, et coûte aussi moins cher. Sur la co-création de diaporamas, 74,0 contre 76,8 : l’écart de score reste modeste, mais le coût n’est qu’environ le quart de celui de DeepSeek.
Du côté de l’ingénierie et de la réparation, l’avantage de DeepSeek en score est net. Terminal-Bench 4.0 : 40,0 contre 19,2 ; ProgramBench : 29,0 contre 16,0 ; DeepSWE : 73,8 contre 64,6 ; réparation de PPT : 45,3 contre 23,7. Les autres lignes de l’annexe — PPTGenBench, WordEditBench, ExcelFixBench, AudioVideoBench, APEX-Agents, AutomationBench, HLE et MMMU-Pro — affichent elles aussi des scores DeepSeek légèrement ou nettement supérieurs ; sur ces items, le seul avantage de Hy4 flash est le coût.
Concernant la méthode de mesure de Terminal-Bench 4.0, la page de recherche précise l’utilisation du harness Claude Code, avec un maximum de 500 tours, une durée maximale de 13 heures par exécution, 16 CPU et 32 GB de mémoire, plus une H100 supplémentaire pour les trois tâches dépendant du GPU. Ce sont les réglages d’évaluation de Tencent, et ils ne préjugent pas du classement officiel final.
Déclarations des équipes produit : scénarios de comparaison avec DeepSeek
La page de l’étude recueille également les témoignages d’équipes produit internes à Tencent. Tous les propos ci-dessous sont des déclarations des équipes produit, et non des évaluations indépendantes. WeChat Pay affirme que, par rapport à DeepSeek-V4.1-Flash-1017, la note moyenne de ses quatre flux de travail est égale ou supérieure, avec environ 6 % d’étapes d’exécution en moins et environ 29 % de longueur de sortie par tour en moins. Marvis indique que la satisfaction pour l’installation d’applications, les réglages et diagnostics système, ainsi que les documents et rapports de recherche, est supérieure de 6,2 %, 4,4 % et 6,9 % respectivement, mais que la satisfaction globale reste équivalente.
L’équipe QQ mentionne comme point de comparaison DeepSeek-V4.1-Flash, sans préciser 1017. Elle affirme que, dans des scénarios comme la recommandation musicale et les interactions de canal, le taux de réponses satisfaisantes est supérieur de 0,92 à 6,16 points de pourcentage, et que la latence P90 des commentaires est inférieure de 39 %. L’équipe de Honor of Kings affirme que l’identification des causes racines est proche, avec 22,0 % à 39,1 % de requêtes au modèle en moins, mais davantage d’appels d’outils. Ces témoignages se concentrent surtout sur la conversation, l’accompagnement et les flux de travail légers, ce qui va dans le sens de la conclusion de l’annexe : « les tâches du quotidien font réaliser des économies, mais pour l’ingénierie lourde, on reste sur DeepSeek ».
Hy4 flash face à DeepSeek V4.1 Flash : tarifs officiels, canal APIYI et prix du site de recherche
Les prix se répartissent en trois blocs distincts, chacun avec sa source clairement indiquée, sans jamais les mélanger. L’unité utilisée partout est le dollar par million de tokens.
Tarifs officiels DeepSeek (page tarifs DeepSeek, consultée le 2026-11-16). Deux grilles : heures pleines et heures creuses. Les heures pleines couvrent du lundi au vendredi, de 01:00 à 04:00 UTC et de 06:00 à 10:00 UTC, soit environ 9h00–12h00 et 14h00–18h00 en heure de Pékin, hors jours fériés officiels chinois. Tout le reste du temps est en heures creuses, y compris les week-ends et l’ensemble des jours fériés, et le tarif creux vaut la moitié du tarif plein. Ce tarif creux ne concerne que l’API officielle DeepSeek.
Tarifs du canal APIYI (vérifiés le 2026-11-16). Pour les modèles déjà référencés chez APIYI, on utilise une clé apiyi.com et on envoie les requêtes vers https://api.apiyi.com/v1. Les entrées DeepSeek concernées par cet article se répartissent sur trois canaux : le canal principal, qui regroupe deepseek-v4.1-flash, deepseek-v4.1-flash-1017 et deepseek-flash, avec un prix aligné sur le tarif heures pleines officiel de DeepSeek ; puis deux canaux séparés, deepseek-v4-1-flash-260910 et la version économique deepseek-v4-1-flash-economy-261017, qu’il ne faut pas prendre pour le tarif du seul modèle 1017.
Le prix affiché sur la page de recherche Hy4 flash est celui publié par Tencent sur sa page de recherche ; ce n’est pas le tarif APIYI. Tencent Cloud TokenHub applique une réduction de 50 % jusqu’au 2026-11-30, et la page de recherche n’imprime pas de tableau de prix remisés séparé. Les chiffres remisés du tableau ci-dessous sont donc un calcul : prix affiché divisé par 2 ; après le 30 novembre, on revient au prix affiché.
| Source / Modèle | Entrée en cache | Entrée | Sortie |
|---|---|---|---|
| DeepSeek officiel · heures pleines | 0.006 | 0.30 | 1.20 |
| DeepSeek officiel · heures creuses | 0.003 | 0.15 | 0.60 |
APIYI · deepseek-v4.1-flash / -1017 / deepseek-flash |
0.006 | 0.30 | 1.20 |
APIYI · deepseek-v4-1-flash-260910 (autre canal) |
0.003 | 0.15 | 0.60 |
APIYI · deepseek-v4-1-flash-economy-261017 (version économique) |
0.006 | 0.24 | 0.96 |
| Prix affiché page de recherche Hy4 flash | 0.003 | 0.070 | 0.281 |
| Hy4 flash TokenHub −50 % (estimé, jusqu’au 11-30) | 0.0015 | 0.035 | 0.1405 |
Sur APIYI, le canal principal correspond bien au tarif heures pleines officiel de DeepSeek, mais pas au tarif creux. Si vous devez appeler dès aujourd’hui, je vous conseille deepseek-v4.1-flash ou deepseek-v4.1-flash-1017. Les deux sont au même prix ; la différence se joue sur les groupes : le premier dispose des groupes ClaudeCode, CodexResponses, Default et SVIP, le second n’a pas CodexResponses. Les deux prennent en charge le point de terminaison chat, et deepseek-v4.1-flash gère en plus le point de terminaison messages.
Hy4 flash n’est pas encore référencé ; nous allons le mettre en ligne dès que possible. Les modèles et les prix font foi sur la liste des modèles de la plateforme. À noter aussi : hy4 sur APIYI désigne Hy4, pas Hy4 flash — son tarif est de 0.85 en entrée, 2.55 en sortie et 0.045 en lecture de cache, alors que le prix affiché de Hy4 sur la page de recherche est de 0.834, 2.501 et 0.042. Ce sont deux séries de chiffres distinctes ; chacune fait foi selon sa propre source.
Hy4 flash face à DeepSeek V4.1 Flash : recommandations par scénario
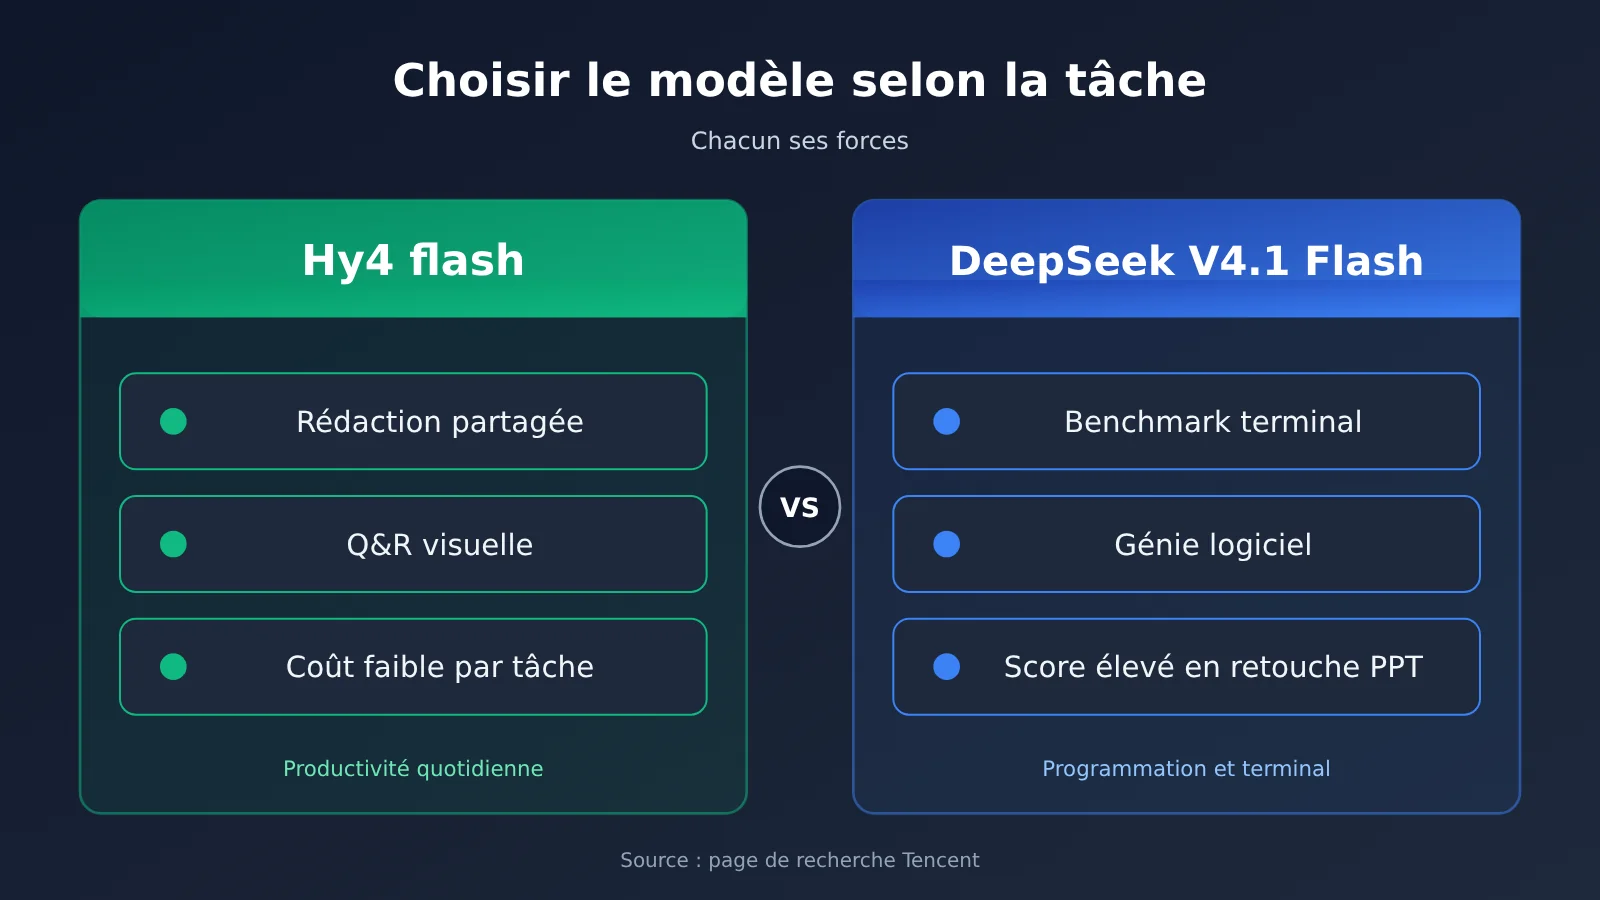
En croisant les tests à l’aveugle, les annexes et les tarifs, on peut orienter les usages selon le type de tâche, plutôt que de choisir un seul modèle pour tout.
Scénarios pour lesquels passer à Hy4 flash (une fois disponible)
- Rédaction collaborative de Markdown et de documents : dans l’annexe, MdCoEditBench affiche 56.9 contre 29.2, pour un coût de 0.057 yuan contre 0.194 yuan.
- Questions-réponses visuelles : sur BuddyVQA et ZeroBench, Hy4 flash obtient de meilleurs scores et un coût par tâche plus faible.
- Création collaborative de diapositives : le score est légèrement inférieur à celui de DeepSeek, mais le coût représente environ un quart, ce qui convient à la génération de premiers jets en série.
- Tâches légères sensibles au temps d’attente : lors du test à l’aveugle, le temps de complétion médian est de 6.7 minutes, contre 10.3 minutes pour DeepSeek.
Scénarios pour lesquels rester sur DeepSeek V4.1 Flash
- Agents d’opérations en terminal : Terminal-Bench 4.0 donne 40.0 contre 19.2, soit environ le double.
- Ingénierie logicielle et codage de longue haleine : sur ProgramBench et DeepSWE, DeepSeek obtient des scores plus élevés ; Tencent recommande d’ailleurs un modèle de gamme supérieure pour les projets d’ingénierie complexes.
- Tâches bureautiques de réparation : réparation de PPT 45.3 contre 23.7, réparation de feuilles de calcul 20.0 contre 15.6.
- Livrables généralistes à forte exigence de satisfaction : le score de satisfaction du test à l’aveugle, 3.09, est le plus élevé de tout le tableau.
| Type de tâche | Modèle recommandé | Justification (chiffres officiels communiqués par Tencent) |
|---|---|---|
| Markdown / rédaction collaborative de documents | Hy4 flash | Meilleur score sur MdCoEditBench, coût plus faible |
| Questions-réponses visuelles | Hy4 flash | Meilleurs scores sur BuddyVQA et ZeroBench |
| Premiers jets de diapositives en série | Hy4 flash | Écart de score faible, coût d’environ un quart |
| Agents terminal / ligne de commande | DeepSeek V4.1 Flash | Terminal-Bench 4.0 environ deux fois plus élevé |
| Codage et réparation | DeepSeek V4.1 Flash | Scores plus élevés sur ProgramBench, DeepSWE et PPTFix |
Hy4 flash face à DeepSeek V4.1 Flash : conseils de décision
💡 Recommandation : si vos requêtes concernent surtout des tâches d’ingénierie et de terminal, rester sur DeepSeek V4.1 Flash est le choix le plus sûr. Si elles relèvent principalement de la rédaction, de l’édition et des questions-réponses sur images, attendez la mise à disposition de Hy4 flash, puis lancez un test A/B sur un petit lot de tâches réelles avant de décider de la proportion de migration.
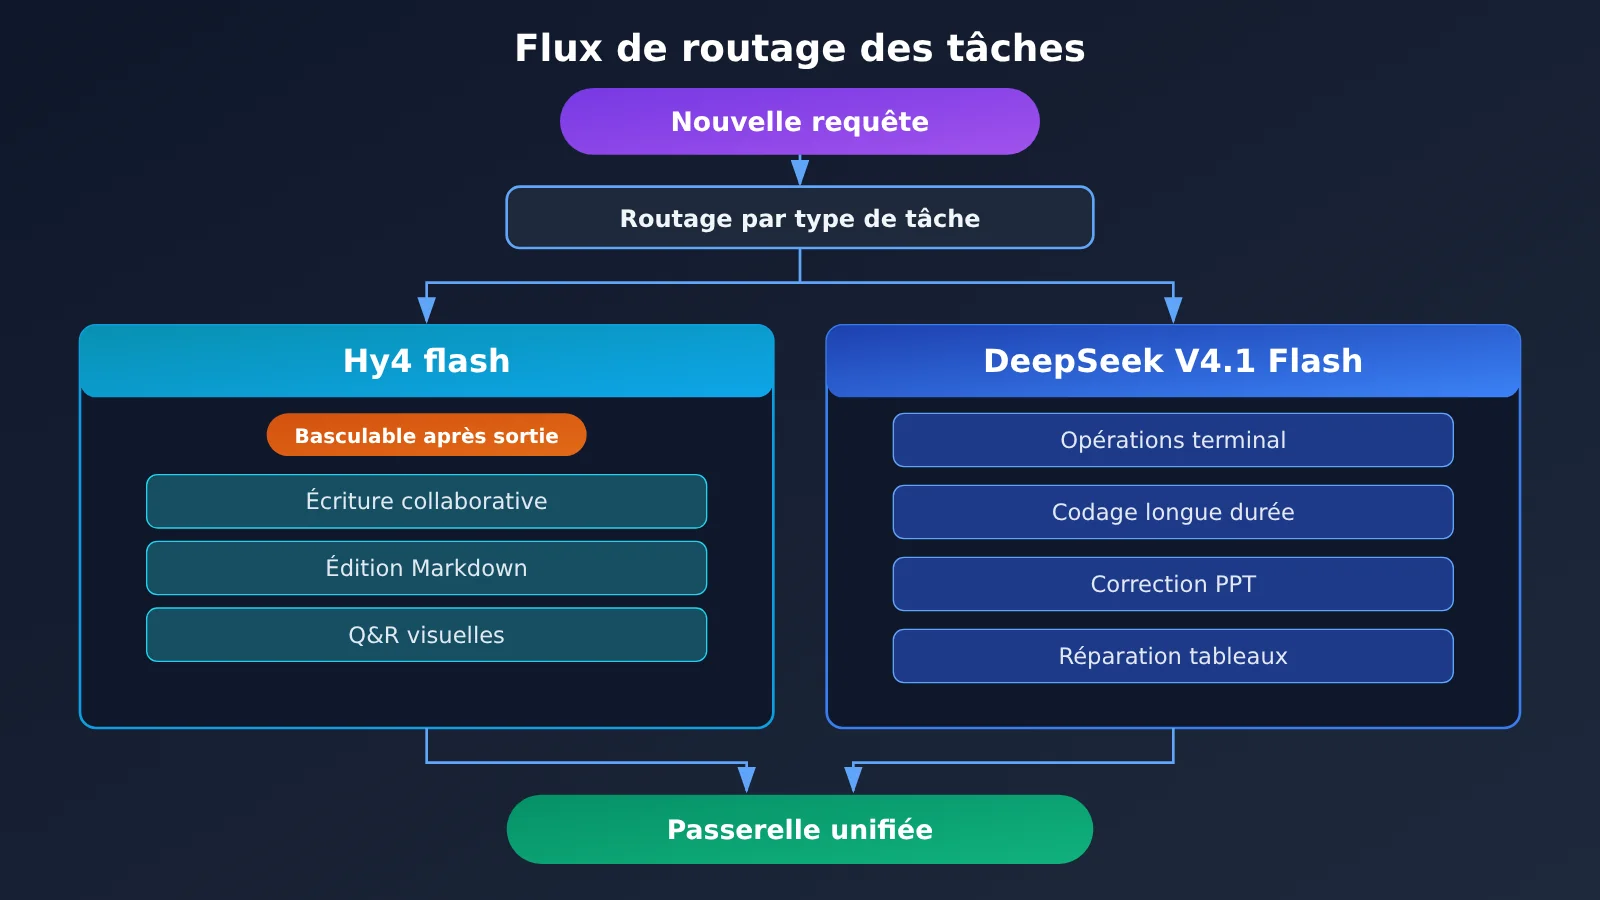
Ce que vous pouvez mettre en place dès maintenant, c’est une passerelle unifiée, avec le nom du modèle défini comme option de configuration. Dans le SDK compatible OpenAI, définissez base_url sur https://api.apiyi.com/v1 et renseignez model avec deepseek-v4.1-flash-1017 : vous pouvez conserver votre logique d’appel actuelle. Si votre chaîne d’outils utilise le protocole Anthropic Messages, vous pouvez choisir deepseek-v4.1-flash, qui prend en charge à la fois les points de terminaison chat et messages.
Dès que Hy4 flash sera disponible, il suffira de remplacer, dans la table de routage, la valeur du champ model des tâches bureautiques par le nom indiqué dans la liste des modèles de la plateforme, sans modifier la structure du code. L’intérêt : comparer les deux offres sur la même base de facturation, et éviter de mélanger le tarif heures creuses officiel de DeepSeek, le prix du canal APIYI et le tarif catalogue de Tencent.
Un autre détail mérite votre attention : DeepSeek divise par deux le prix officiel pendant les heures creuses, tandis que le canal principal APIYI facture au tarif des heures de pointe. Si vos traitements par lots peuvent être décalés le week-end ou la nuit, et que vous passez directement par DeepSeek officiel, le tarif heures creuses sera plus avantageux. Si, en revanche, vous préférez gérer plusieurs modèles avec une seule clé API, le coût d’exploitation d’une passerelle unifiée sera plus faible. À vous d’arbitrer selon vos plages d’appel et vos besoins de protocole.
Questions fréquentes (FAQ)
Q1 : Qu’est-ce que Hy4 flash ?
Hy4 flash est un modèle léger publié par Tencent Hunyuan le 16 novembre 2026. Les spécifications de la page de recherche indiquent 224B de paramètres totaux, 12B activés par token, un fonctionnement nativement multimodal et une fenêtre de contexte de 1M. Tencent le positionne comme une option à faible coût pour les tâches de productivité du quotidien.
Q2 : Hy4 flash est-il plus pratique que DeepSeek V4.1 Flash ?
On ne peut pas le dire ainsi. Dans les tests à l’aveugle rapportés par Tencent, DeepSeek-V4.1-Flash-1017 obtient un score de satisfaction de 3.09, supérieur à 2.79 pour Hy4 flash. Les atouts de Hy4 flash résident dans un temps d’achèvement plus court, un coût par tâche plus bas, et de meilleurs scores en annexe sur la co-écriture Markdown et la question-réponse visuelle.
Q3 : La réduction de coût de 18 fois mentionnée dans le post officiel est-elle une comparaison avec DeepSeek ?
Non. Le facteur 18 provient du tarif de Claude Haiku 5.5 dans le tableau des tests à l’aveugle (4.73 yuans) divisé par celui de Hy4 flash (0.26 yuan). Ce qui concerne DeepSeek, c’est le 1/8 sur WorkIndex, calculé sur la base du tarif le plus élevé de DeepSeek majoré du prix en heure de pointe.
Q4 : Lequel utiliser pour les tâches de terminal et de codage ?
Selon l’annexe de Tencent, DeepSeek V4.1 Flash obtient de meilleurs scores sur Terminal-Bench 4.0, ProgramBench et DeepSWE. La page de recherche de Tencent recommande d’ailleurs, pour l’ingénierie logicielle de longue haleine, de continuer avec des modèles dont le plafond d’intelligence est plus élevé, plutôt qu’avec Hy4 flash.
Q5 : Comment appeler ces deux modèles via API aujourd’hui ?
DeepSeek V4.1 Flash est déjà disponible sur APIYI. Après inscription sur apiyi.com pour récupérer une clé API, il suffit de renseigner le nom de modèle `deepseek-v4.1-flash` ou `deepseek-v4.1-flash-1017` ; les nouveaux utilisateurs bénéficient d’un quota d’essai gratuit. Hy4 flash n’est pas encore disponible sur APIYI ; pour le tester en avant-première, vous pouvez passer par Tencent Cloud TokenHub, le nom du modèle étant celui affiché dans la console.
Q6 : Quelles limitations de Hy4 flash faut-il garder à l’esprit ?
Premièrement, la page de recherche ne publie pas d’ID de modèle API, et les poids sont annoncés comme devant être open source, sans que la page précise qu’ils ont déjà été diffusés. Deuxièmement, la réduction de 50 % sur TokenHub ne s’applique que jusqu’au 30 novembre 2026, après quoi les tarifs catalogue reviennent. Troisièmement, tous les scores sont rapportés par Tencent lui-même : les tâches d’ingénierie, de terminal et de correction sont nettement en retrait par rapport à DeepSeek. Avant de migrer, validez avec vos propres échantillons de tâches.
Q7 : Comment se compare-t-il à Claude Haiku 5.5 ?
Haiku n’apparaît pas dans le tableau de l’annexe : on ne peut donc s’appuyer que sur les tests à l’aveugle, avec une satisfaction de 2.81 contre 2.79 pour Hy4 flash, et un coût par tâche de 4.73 yuans contre 0.26 yuan. Le tarif officiel d’Anthropic comporte deux paliers : lorsque l’invite ne dépasse pas 100 000 tokens, l’entrée est à 0.10 et la sortie à 0.50 ; au-delà, la requête complète est facturée à 0.50 en entrée et 2.50 en sortie. Le tableau récapitulatif d’APIYI indique 0.10, 0.50, 0.01, et la note de bas de page ne précise que le second palier pour l’entrée ; le détail réel de la facturation fait foi selon les indications de la plateforme.
Comparaison Hy4 flash et DeepSeek V4.1 Flash : points clés (Key Takeaways)
- Satisfaction en test à l’aveugle : avantage DeepSeek : 3,09 contre 2,79 ; Hy4 flash gagne sur le temps et le coût.
- Coût WorkIndex à 1/8 : le référentiel retenu est le tarif le plus élevé de DeepSeek additionné du prix en heures de pointe ; cela ne vaut que pour WorkIndex.
- Rédaction bureautique collaborative et questions-réponses visuelles : dans l’annexe, Hy4 flash obtient un meilleur score et un coût par tâche plus faible.
- Terminal et codage : avantage DeepSeek : Terminal-Bench 4.0, ProgramBench, DeepSWE, correction de PPT sont tous plus élevés.
- Le tarif heures creuses n’appartient qu’à DeepSeek officiel : le canal principal d’APIYI correspond au prix officiel en heures de pointe.
- Modèles disponibles dès aujourd’hui :
deepseek-v4.1-flashoudeepseek-v4.1-flash-1017; Hy4 flash attend encore sa mise en ligne.
En résumé
Conclusions clés de la comparaison Hy4 flash et DeepSeek V4.1 Flash :
- Répartir selon la tâche, pas remplacer en bloc : pour la rédaction bureautique collaborative et les questions-réponses visuelles, on peut envisager Hy4 flash ; pour le terminal, le codage et les tâches de correction, continuez avec DeepSeek.
- Bien préciser la source des données : test à l’aveugle, WorkIndex, annexe et témoignages sont tous des données autodéclarées par Tencent ; avant de migrer, vérifiez avec vos propres échantillons de tâches.
- Ne pas mélanger les référentiels de prix : DeepSeek officiel distingue heures de pointe et heures creuses, APIYI propose trois canaux, et Hy4 flash n’affiche que le tarif de sa page de recherche et une remise limitée de 50 %.
Si vous utilisez déjà DeepSeek-V4.1-Flash-1017, la solution la moins coûteuse consiste à passer d’abord par une passerelle unifiée, à rendre le nom du modèle configurable, puis, une fois Hy4 flash disponible, à lancer directement une comparaison sur un petit lot. Nous recommandons d’appeler deepseek-v4.1-flash-1017 via APIYI apiyi.com pour valider votre flux existant ; la plateforme propose une interface compatible OpenAI et un quota de test gratuit.
📚 Références
-
Page de recherche Tencent Hunyuan Hy4 flash : spécifications, tests à l’aveugle, WorkIndex, annexes et tarifs de grille
- Lien :
hy.tencent.ai/research/hy4-flash - Note : source de tous les scores et coûts de Hy4 flash cités dans cet article, tous rapportés officiellement par Tencent
- Lien :
-
Page tarifaire officielle DeepSeek : prix de DeepSeek-V4.1-Flash-1017 en heures de pointe et heures creuses
- Lien :
api-docs.deepseek.com/quick_start/pricing - Note : contient la définition des heures de pointe et les précisions sur les noms d’appel
- Lien :
-
Documentation officielle Claude Haiku 5.5 : spécifications du modèle et les deux niveaux de tarification
- Lien :
platform.claude.com/docs/en/models/haiku-5-5/overview - Note : sert à vérifier le contexte de comparaison de Haiku dans le tableau des tests à l’aveugle
- Lien :
-
Liste des modèles APIYI : modèles déjà disponibles, groupes et points de terminaison
- Lien :
docs.apiyi.com/models - Note : c’est ici que font foi la disponibilité de Hy4 flash et les prix de chaque canal DeepSeek
- Lien :
Auteur : équipe technique APIYI
Échanges techniques : n’hésitez pas à nous contacter depuis la page d’accueil du site APIYI ; pour suivre la mise en ligne des modèles, consultez les mises à jour de la liste des modèles de la plateforme.