Nota del autor: vamos a responder una duda recurrente sobre la facturación. Los precios de catálogo de los modelos han caído drásticamente en los últimos meses, pero los agentes de código siguen saliendo caros en el desglose mensual. Los precios que verás aquí se cotejaron el 26/10/2026 directamente con las listas oficiales y con la página de tarifas de APIYI. El dato del 96% es una estimación de un autor externo, no una medición realizada en este artículo.
Entre el 26/06/2026 y el 29/09/2026 —un periodo de unos cuatro meses—, OpenAI y Anthropic se turnaron para ajustar tarifas. Max Woolf documentó esta cronología el 25/10/2026 en minimaxir.com/2026/10/cheap-llms, destacando rebajas de hasta un 80% en su titular. En su artículo, Woolf explicaba que, en los agentes de generación de código, la lectura de caché representa entre el 96% y el 99% del gasto total en tokens. La razón es simple: en cada turno de conversación se vuelve a leer todo el historial en caché, logrando una tasa de aciertos (cache hit) de entre el 90% y el 100%, según el proveedor de inferencia. El artículo original no incluía registros de peticiones verificables, así que tomamos esa afirmación con cautela: es una referencia externa y no debe sustituir el análisis de tus propias métricas de consumo.
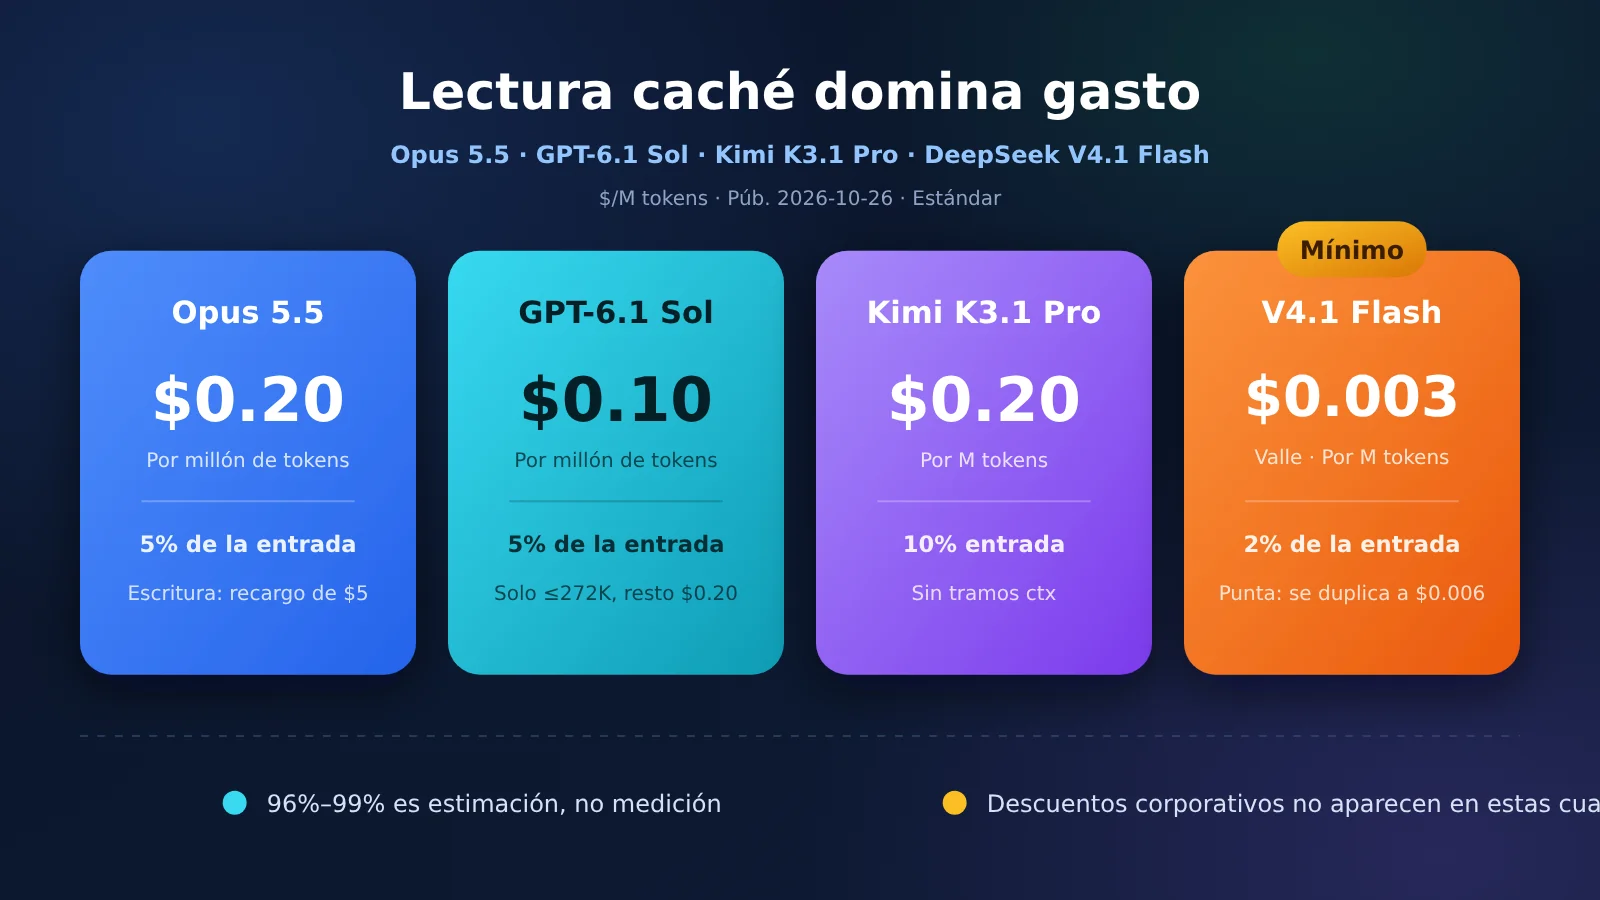
Bajo esa misma ventana, los costos actuales de lectura de caché que coinciden con las tarifas oficiales son: Claude Opus 5.5 a $0.20, GPT-6.1 Sol a $0.10 (para entradas de hasta 272K), Kimi K3.1 Pro a $0.20 y DeepSeek V4.1 Flash a $0.003 en horas valle y $0.006 en horas punta. Todos los valores están expresados en dólares por millón de tokens.
Esto no es una comparativa tibia donde todos empatan. Si tienes bucles de código con prefijos estables y entradas que rara vez superan los 272K tokens, entre las tres opciones propietarias la lectura de caché de GPT-6.1 Sol es el punto de partida obligado. Si buscas recortar otro orden de magnitud, la lectura de caché en horas valle de DeepSeek no tiene rival. Opus 5.5 y Kimi cobran exactamente lo mismo por la lectura de caché; la diferencia real entre ellos radica en el costo de los tokens de entrada no cacheados (cache miss), los tokens de salida y el recargo por escritura de caché.
Punto clave: Al terminar de leer esto, sabrás cómo elegir modelos basándote en la tasa de aciertos de caché y no solo en el precio base de entrada, además de entender por qué los descuentos corporativos que salen en las noticias no cuadran con las facturas de los equipos pequeños.
💡 Recomendación para elegir: Puedes probar las cuatro opciones en APIYI (apiyi.com) con una sola clave API, cambiando simplemente el nombre del modelo. Las cuentas nuevas incluyen saldo de prueba gratuito. Te aconsejo fijar bien los prefijos del prompt y revisar la lectura de caché en las métricas de consumo antes de sacar conclusiones basadas en una sola sesión corta.
¿En qué se diferencian los precios de lectura de caché de los cuatro proveedores?
Primero fijémonos en el costo de lectura de caché y luego en qué porcentaje representa respecto a una entrada sin acierto de caché. Ese porcentaje es el que determina qué tan «barata» resulta esta columna en sesiones largas. Tanto para Opus 5.5 como para GPT-6.1 Sol en contexto corto, el precio equivale al 5% del costo de entrada normal; para Kimi K3.1 Pro sube al 10%, mientras que en DeepSeek V4.1 Flash baja al 2%. La diferencia en precios absolutos es todavía más marcada: los $0.003 de Flash en horario valle son apenas 1/33 de los $0.10 de Sol en contexto corto, y 1/67 si lo comparamos con los $0.20.
| Modelo | Lectura de caché | % de entrada sin caché | Entrada sin caché | Salida |
|---|---|---|---|---|
| Claude Opus 5.5 | $0.20 | 5% | $4 | $20 |
| GPT-6.1 Sol, entrada ≤272K | $0.10 | 5% | $2 | $10 |
| GPT-6.1 Sol, entrada >272K | $0.20 | 5% | $4 | $15 |
| Kimi K3.1 Pro | $0.20 | 10% | $2 | $10 |
| DeepSeek V4.1 Flash (valle) | $0.003 | 2% | $0.15 | $0.60 |
| DeepSeek V4.1 Flash (pico) | $0.006 | 2% | $0.30 | $1.20 |
Todos los valores están expresados en dólares por millón de tokens para el nivel estándar, sin incluir Batch, Fast ni recargos regionales. Opus 5.5 se basa en el tarifario de Anthropic, donde el acierto de caché se factura a 0.05 veces el precio de entrada. GPT-6.1 Sol corresponde a las tarifas estándar de OpenAI; el contexto corto aplica cuando la entrada no supera los 272K tokens. Si se supera ese límite, el precio salta simultáneamente para lectura de caché, entrada y salida (esta última pasa a $15 en lugar de $20). Los datos de Kimi proceden de la ficha pública de Moonshot, que no segmenta por longitud de contexto. Por su parte, DeepSeek proviene de su página oficial de precios para el modelo deepseek-flash (versión DeepSeek-V4.1-Flash-1017). Sus horas pico van de lunes a viernes de 01:00 a 04:00 y de 06:00 a 10:00 UTC (09:00–12:00 y 14:00–18:00 hora de Beijing), excluyendo días festivos oficiales en China. El tramo intermedio de 12:00 a 14:00 se factura a tarifa valle, al igual que los fines de semana y festivos oficiales completos.
En la lista de precios de APIYI (docs.apiyi.com/models) del catálogo del 25-10-2026, claude-opus-5-5 figura a $4 / $20 / $0.20, gpt-6.1-sol a $2 / $10 / $0.10 (indicando que al pasar de 272 000 tokens la entrada sube a $4) y kimi-k3.1-pro a $2 / $10 / $0.20. DeepSeek se divide en dos opciones: deepseek-v4.1-flash y deepseek-flash están a $0.30 / $1.20 / $0.006 (igual que en las horas pico oficiales), mientras que deepseek-v4-1-flash-260910 figura a $0.15 / $0.60 / $0.003 (coincidiendo con el horario valle oficial). La API oficial alterna entre tarifas según la hora de llegada de la petición, pero el catálogo separa ambos costos en líneas de modelo independientes. Antes de realizar la invocación del modelo, conviene verificar el nombre exacto disponible en la consola.
La lectura de caché es solo la mitad de la ecuación. El precio de escritura en caché determina si tendrás que volver a pagar un recargo cada vez que el prefijo expire. Ten en cuenta que los tramos corto y largo de la siguiente tabla no se pueden comparar directamente en minutos: el tramo corto de OpenAI ya abarca 30 minutos, mientras que el de Anthropic y Kimi es de apenas 5 minutos.
| Modelo | Escritura corta | Escritura larga | Cómo entra el prefijo en caché |
|---|---|---|---|
| Opus 5.5 | 5 min, $5 (1.25x la entrada) | 1 hora, $8 (2x la entrada) | Debe incluir cache_control en la solicitud |
| GPT-6.1 Sol, ≤272K | 30 min, $2.50 (1.25x la entrada) | 12 horas, $5 (2.5x la entrada) | La tarifa desglosa la escritura; el prefijo debe ser estable |
| Kimi K3.1 Pro | 5 min, $2 (igual al precio de entrada) | 1 hora, $4 (calculado al 2x) | Automático por defecto (5 min); para intervalos mayores, especificar 1 hora |
| V4.1 Flash | Sin coste de escritura independiente | Ninguno | La primera vez cuenta como no acertada; después como lectura de caché |
En la tarjeta principal del sitio web de Kimi, la escritura en caché figura a $2, lo que corresponde al nivel por defecto de 5 minutos. El nivel de 1 hora a $4 proviene del precio de configuración en la documentación de Kimi en APIYI, donde se aclara que la facturación de este nivel de caché aún no ha sido verificada en pruebas reales recientes. En la documentación oficial de la generación anterior (Kimi K3), la escritura de 1 hora costaba el doble que la de 5 minutos; aplicando la misma proporción a K3.1 Pro, el resultado es $4. Si hay discrepancias con la consola, prevalece lo que indique la consola. En la versión de alta velocidad kimi-k3.1-pro-highspeed, los precios de entrada y salida se duplican, pero la lectura de caché se mantiene en $0.20. Cuando hay una tasa alta de aciertos del prefijo, la brecha entre ambos niveles se reduce notablemente.
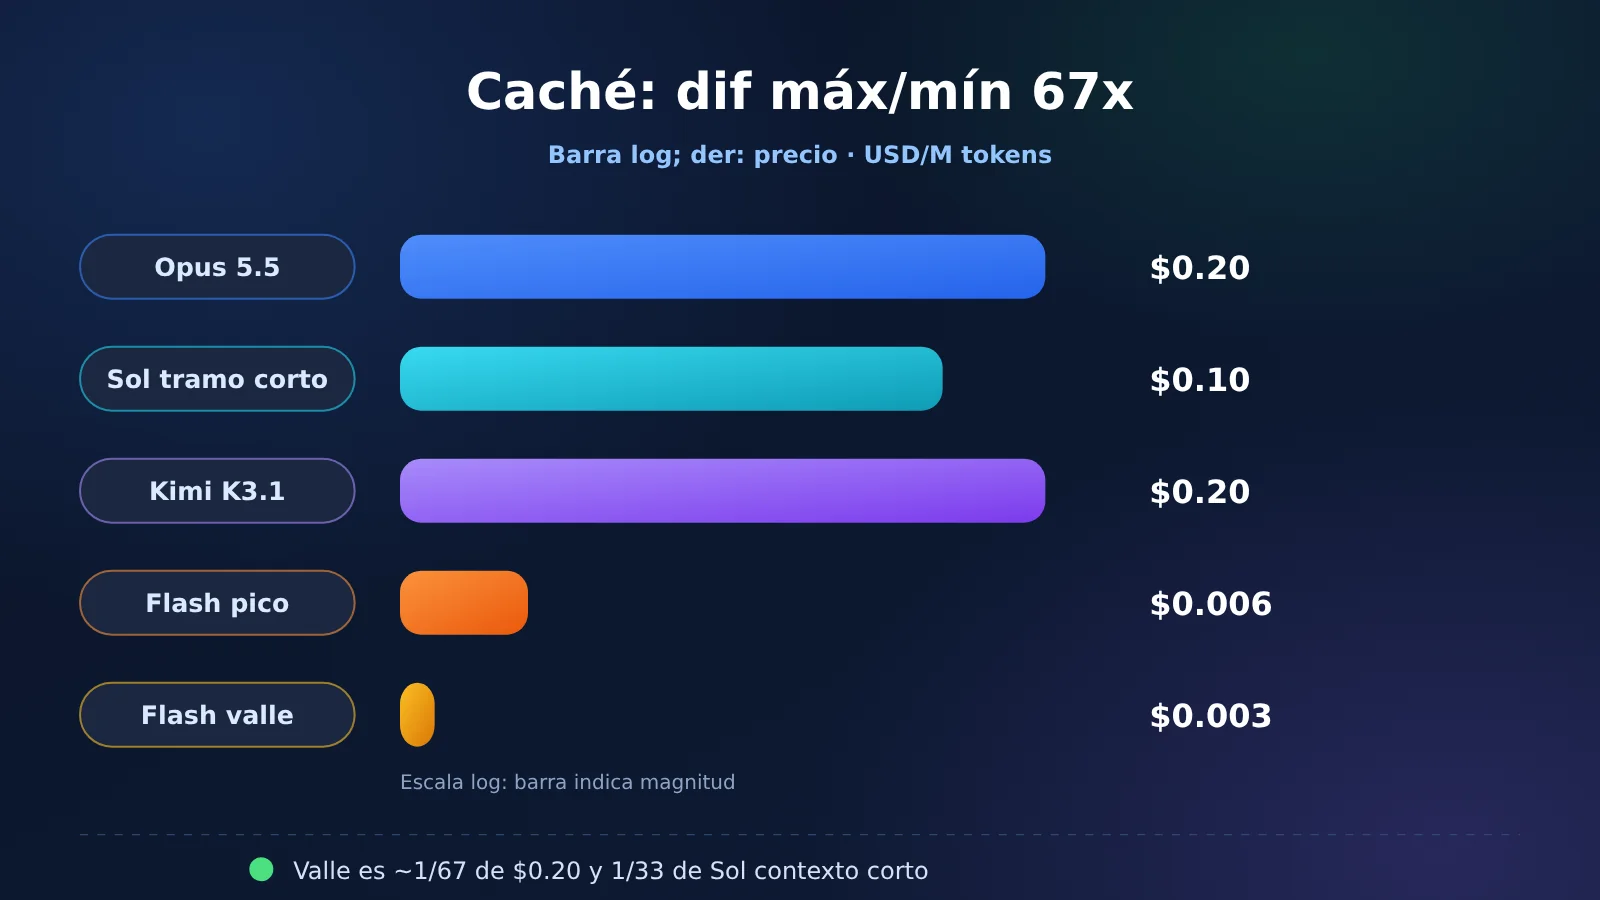
La longitud de las barras en el gráfico solo sirve para visualizar los órdenes de magnitud. La facturación real sigue calculándose multiplicando la tarifa base por la cantidad de tokens. Si cambias de modelo con una misma clave API, consulta siempre la columna de lectura de caché en la consola de APIYI; no uses este gráfico para calcular importes finales.
¿Por qué deberías desglosar las lecturas de caché en la factura de un agente de programación?
En cada turno, el agente vuelve a enviar las indicaciones del sistema, las definiciones de herramientas y el historial de la conversación previa. La parte del prefijo que no cambia tiene la oportunidad de facturarse como lectura de caché. Si el prefijo se modifica, a partir de ese cambio se cobra como fallo de caché (sin caché), y algunos proveedores incluso cobran una tarifa adicional por la escritura. Por eso, que el precio de entrada baje un 20% no significa que la factura final de una sesión de programación baje un 20%. Si las lecturas de caché representan el volumen más grande de tokens, la columna que realmente debes vigilar es la de lectura de caché.
El rango del 96% al 99% citado por Max Woolf se refiere al «gasto total de tokens». En inglés, el término expenditure puede interpretarse como costo monetario o como consumo de tokens. El texto original no especificaba el denominador. Otra medición independiente lo dejó mucho más claro: WorkloadBench reportó en su actualización del 16-10-2026 que, en tareas largas de programación, entre el 89% y el 96% de los tokens de indicación provienen de la caché. La mediana para GPT-6.1 Sol y Claude Opus 5.5 fue del 95% en ambos casos, con rangos del 91%–98% y 94%–99%, respectivamente (fuente: workloadbench.brenhq.com/cache). Esa cifra corresponde a la proporción sobre los tokens de indicación: el denominador no incluye la salida y mucho menos representa el porcentaje en dólares. No se pueden mezclar ambas fuentes para afirmar que equivale al «96% de la factura».
El porcentaje en dólares suele ser bastante más bajo, ya que el precio unitario de salida es decenas o incluso cientos de veces superior al de la lectura de caché. A continuación, recalculamos el escenario con una serie de supuestos explícitos para analizar la estructura de costos (no se trata del desglose original del autor ni de registros generados en este artículo). Supongamos 40 turnos: en cada turno hay 120 000 tokens de lectura de caché, 1500 tokens nuevos por fallo de caché y 800 tokens de salida; al inicio de la sesión se realiza una escritura única de 40 000 tokens. Estos 40 000 tokens no se vuelven a contabilizar como fallos. Dado que DeepSeek no cobra tarifa de escritura, esos 40 000 tokens se facturan como fallo de caché. La entrada ronda los 120 000 tokens por turno, ubicándose en el tramo de contexto corto de Sol.
El total asciende a 4 932 000 tokens, de los cuales 4 800 000 son lecturas de caché (alrededor del 97%). Esto demuestra que, bajo la premisa de «prefijos largos, muchos turnos y salidas cortas», el volumen de tokens sí puede situarse cerca del rango estimado por el autor.
| Modelo | Lectura de caché | Fallo de caché | Salida | Escritura o primer fallo | Total | % de lectura de caché en USD |
|---|---|---|---|---|---|---|
| Opus 5.5, escritura de 5 min | $0.96 | $0.24 | $0.64 | $0.20 | $2.04 | Aprox. 47% |
| GPT-6.1 Sol, ≤272K, escritura de 30 min | $0.48 | $0.12 | $0.32 | $0.10 | $1.02 | Aprox. 47% |
| Kimi K3.1 Pro, escritura de 5 min | $0.96 | $0.12 | $0.32 | $0.08 | $1.48 | Aprox. 65% |
| V4.1 Flash horas valle | $0.0144 | $0.009 | $0.0192 | $0.006 | $0.0486 | Aprox. 30% |
| V4.1 Flash horas punta | $0.0288 | $0.018 | $0.0384 | $0.012 | $0.0972 | Aprox. 30% |
Los cuatro precios unitarios de contexto corto entre Opus y Sol tienen exactamente una relación de 2 a 1, por lo que su proporción es idéntica y el total es justo la mitad. En Kimi, la lectura de caché representa el 10% del precio de entrada en lugar del 5%; con la misma estructura de tokens, la lectura de caché se lleva cerca del 65%, sumando $1.48, justo en el punto medio entre ambos. Flash ronda los $0.049 en horas valle y se duplica en horas pico. Como la lectura de caché aquí cuesta solo el 2% de lo que cuesta cuando no hay acierto (cache miss), en este escenario el gasto principal vuelve a recaer en la salida (alrededor del 40%), mientras que la lectura de caché representa cerca del 30%. Entre los tres modelos insignia, la lectura de caché sigue siendo la partida más grande en esta factura de ejemplo. Flash no solo replica esa misma distribución del 96% del gasto: reduce directamente el orden de magnitud de la factura completa.
Si el prefijo cambia en cada turno, la tabla anterior queda sin efecto. Marcas de tiempo (timestamps), listas de herramientas ordenadas al azar o nombres de usuario insertados en medio de la indicación del sistema arruinan por completo la tasa de aciertos de la caché. Cuando eso pasa, lo que toca comparar son los precios por fallo de caché y los de escritura. La escritura de 5 minutos de Opus cuesta 1.25 veces la entrada; la de 30 minutos de Sol también es de 1.25 veces, mientras que la de 12 horas sube a 2.5 veces. En Kimi, la escritura de 5 minutos cuesta lo mismo que el precio de entrada base, sin ningún recargo para el tramo corto. En DeepSeek, la primera llamada simplemente se cobra a precio de fallo de caché.
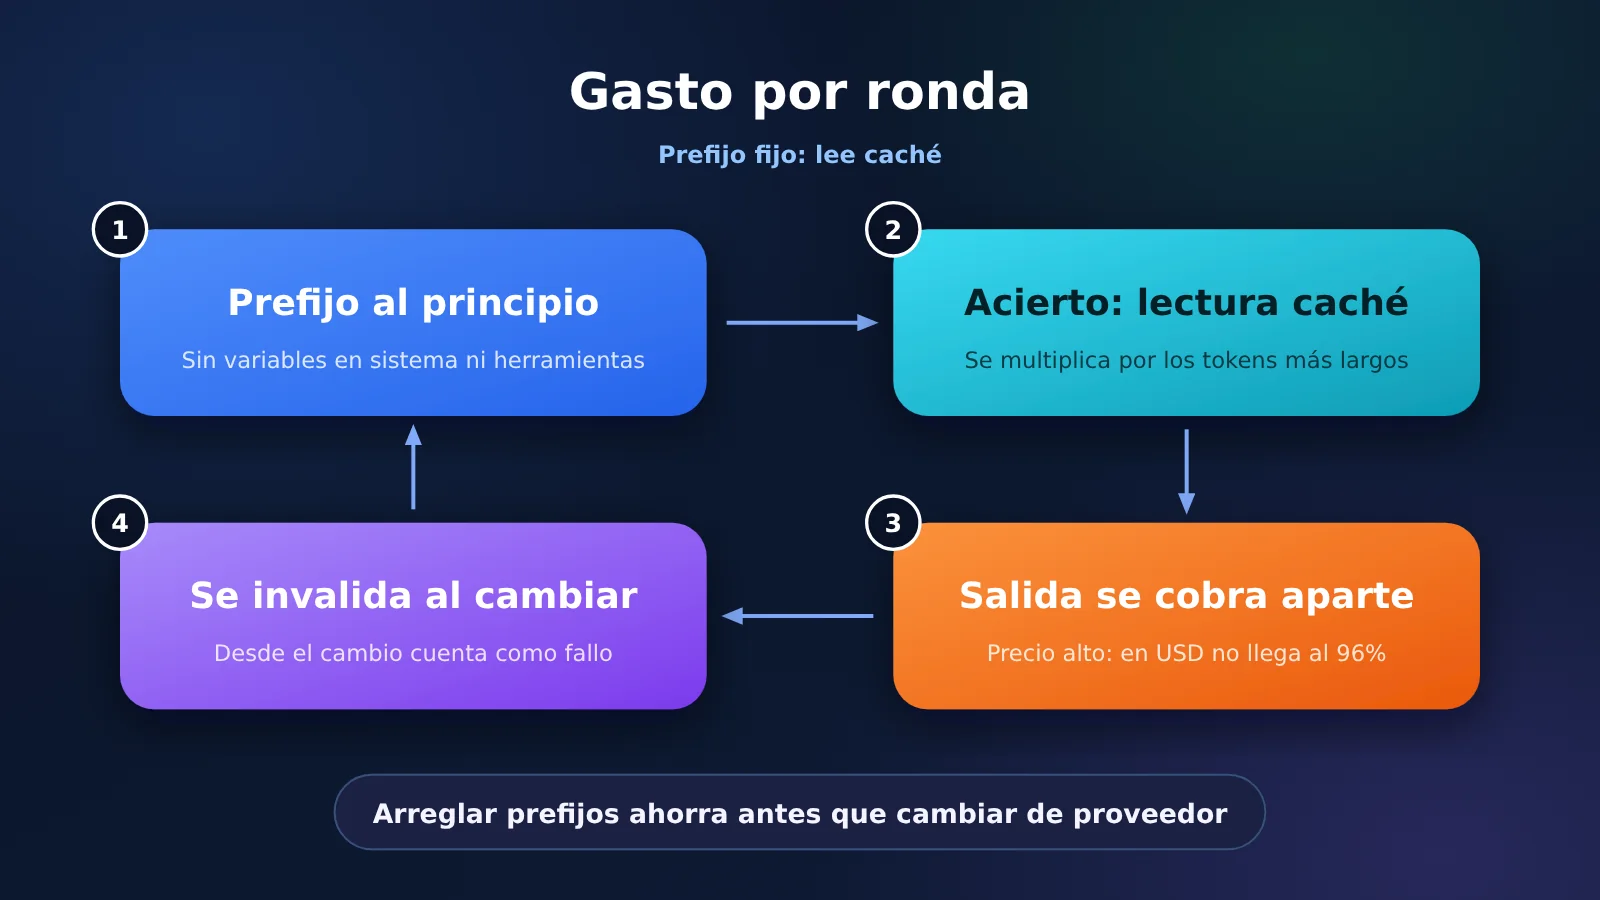
Optimizar los prefijos suele ahorrar dinero mucho antes que cambiar de proveedor. Mantén estable el orden de la lista de herramientas, coloca el contenido dinámico al final del mensaje y asegúrate de que los intervalos de una misma conversación no superen el TTL del tramo corto. Una vez resuelto esto, ya puedes tomar decisiones basándote en el precio unitario de lectura de caché.
¿Qué nos dice la cronología de bajadas de precios de estos cuatro meses?
Eso de que «bajaron hasta un 80%» encaja en dos casos puntuales, pero no hay que interpretarlo como si todos los modelos tuvieran de repente un descuento general del 80%. El primer caso lo registró Max Woolf: el 30 de julio de 2026, OpenAI redujo el precio de GPT-5.6 Luna de $1 / $6 / $0.10 a $0.20 / $1.20 / $0.02; tanto la entrada como la lectura de caché cayeron cerca de un 80%. El segundo caso se encuentra en la lectura de caché de la línea Sol: pasó de los $0.50 de GPT-5.6 Sol el 26 de junio de 2026 a los $0.10 de GPT-6.1 Sol el 29 de septiembre de 2026, lo que también supone un 80% menos. Eso sí, aquí la versión ya pasó de la 5.6 a la 6.1; no es simplemente que le hayan puesto una rebaja al mismo SKU.
| Fecha | Cambio registrado | Entrada / Salida / Lectura de caché |
|---|---|---|
| 2026-06-26 | OpenAI lanza GPT-5.6 Sol y Luna | Sol $5 / $30 / $0.50 |
| 2026-06-30 | Anthropic lanza Sonnet 5, indicando que el precio inicial era temporal | $2 / $10 / $0.20 |
| 2026-07-24 | Anthropic lanza Opus 5 | $5 / $25 / $0.50 |
| 2026-07-30 | GPT-5.6 Luna baja de precio | $0.20 / $1.20 / $0.02 |
| 2026-08-21 | GPT-5.6 Sol baja temporalmente cerca de un 20% durante tres meses | $4 / $20 / $0.40 |
| 2026-09-01 | Fable 5.1, con lectura de caché inferior a la de Fable 5 en junio | $10 / $50 / $0.25 |
| 2026-09-22 | Mismo día de lanzamiento para GPT-6 Sol y Opus 5.5 | Sol $2 / $10 / $0.20; Opus 5.5 $4 / $20 / $0.20 |
| 2026-09-29 | GPT-6.1 Sol, la lectura de caché se reduce a la mitad | $2 / $10 / $0.10 |
La tabla anterior es una recopilación de Max Woolf; en las cifras, el orden siempre corresponde a entrada, salida y lectura de caché. Lo que hemos verificado directamente en este artículo son los precios actuales de las dos últimas filas: los $4 / $20 / $0.20 de Opus 5.5 coinciden con la lista de precios oficial de Anthropic, y los $2 / $10 / $0.10 de GPT-6.1 Sol coinciden con la tarifa estándar de OpenAI para contextos cortos. En cuanto a las filas anteriores, no revisamos los comunicados oficiales uno por uno, así que si necesitas citarlas, conviene consultar su publicación original.
Woolf también comenta que el costo total de Opus 5.5 se redujo entre un 40% y un 60%. Lo que se puede comprobar en la lista de precios oficial son las tres tarifas unitarias: frente a Opus 5, la entrada y la salida bajaron un 20% cada una (de $5 a $4 y de $25 a $20), mientras que la lectura de caché pasó de $0.50 a $0.20, una reducción del 60%. Ese rango del 40% al 60% es una estimación propia basada en patrones de uso habituales, no un descuento oficial uniforme. La explicación literal de Anthropic fue que Opus 5.5 requiere menos cómputo de inferencia que Opus 5 y que el precio refleja esa optimización; una declaración que, naturalmente, proviene del propio proveedor.
También señala que DeepSeek V4.1 Flash ronda los $0.15 / $0.60 / $0.003 en la API directa de DeepSeek. Estas cifras coinciden con las tarifas oficiales en horas valle; en horas pico, el costo se duplica. Para Kimi K3.1 Pro indica $2 / $10 / $0.20, lo cual coincide con los datos de su web oficial. Por último, las puntuaciones de Artificial Analysis que cita (55 para Kimi, 58 para Opus 5.5 y 45 para Flash) son índices de terceros y no pruebas de desarrollo de este artículo. A la hora de elegir un modelo, no tomes decisiones basándote solo en esa diferencia de tres puntos.
¿Cómo elegir un modelo cuando un equipo pequeño no puede acceder a descuentos empresariales?
Más allá de las tarifas públicas, existe otro nivel de descuentos al que solo tienen acceso los grandes clientes. El 24 de octubre de 2026, AI Weekly citó a The Information: OpenAI ofreció un descuento superior al 30 % para cerrar un contrato anual de más de 100 millones de dólares, lo que llevó a Replit a transferir la mayor parte de su gasto en IA de Anthropic a OpenAI. Según el informe, Anthropic no renovó el descuento previo que ofrecía a Replit. La noticia no incluye confirmaciones públicas de ninguna de las tres empresas. En TechCrunch Disrupt, Amjad Masad, CEO de Replit, comentó que la decisión se basó en costos, alianzas y rendimiento. El mismo artículo menciona que los modelos de Claude siguen disponibles, pero OpenAI pasó a ser la opción predeterminada para sus agentes. También se señala que el uso de Rippling para generación de código migró de Anthropic a OpenAI, atribuyéndolo igualmente a los costos. Cabe aclarar que todo esto proviene de reportes periodísticos y no de una lista de precios oficial publicada por las compañías.
Para los equipos pequeños, este tipo de contratos está fuera de alcance. Sin un compromiso de 100 millones de dólares al año, es imposible conseguir ese 30 % del que hablan los medios. E incluso si aplicamos mecánicamente ese 30 % a la lectura de caché de Opus (pasando de $0.20 a $0.14), sigue siendo más caro que la tarifa pública de $0.10 de GPT-6.1 Sol para contextos cortos. El artículo no aclara si el descuento aplica a la lectura de caché, a los fallos de caché (cache miss) o al precio total, pero esta comparación sirve para ilustrar la escala: los precios públicos de lectura de caché son más que suficientes para que un equipo pequeño haga su primer filtro de selección.
| Perfil de la sesión | Por cuál empezar | Motivo |
|---|---|---|
| Prefijo estable, entrada generalmente inferior a 272K, se busca un modelo propietario para código | GPT-6.1 Sol | Lectura de caché a $0.10, la más baja de los tres |
| La entrada individual supera los 272K | No des por sentado los $0.10 | La lectura de caché de Sol sube a $0.20 y la salida a $15 |
| Mismo presupuesto de lectura de caché que Opus, pero buscando menor costo en fallos de caché y salida | Kimi K3.1 Pro | Lectura de caché idéntica a $0.20; entrada y salida a $2 / $10, sin tarifas por tramos |
| Alta tasa de aciertos de caché y tareas fuera de horas pico | DeepSeek V4.1 Flash en horas valle | Lectura de caché a $0.003; la factura se reduce en un orden de magnitud |
| Uso obligado en días hábiles de 9:00 a 12:00 y de 14:00 a 18:00 (hora de Pekín) | Recalcular con tarifa pico para Flash | La lectura de caché sube a $0.006 y el resto de los precios unitarios también se duplica |
| El prefijo cambia en cada turno | Modificar primero el prefijo | La columna de lectura de caché no aportará ventajas |
La capacidad no está clasificada en esta tabla. Max Woolf opina que Opus 5.5 supera al más costoso Fable 5.1, pero ese es su propio criterio de uso. DeepSeek especifica oficialmente que deepseek-flash ahora está respaldado por DeepSeek-V4.1-Flash-1017; el nombre antiguo deepseek-v4-flash sigue funcionando y se factura con la tarifa Flash, mientras que deepseek-v4-pro se sigue vendiendo por separado. Oficialmente no existe un ranking de rendimiento entre Flash y Pro. Si el costo de fallar supera la diferencia de precio por token, conviene usar el modelo más caro. Si el costo del fallo es menor que esa diferencia, lo ideal es usar Flash para completar todo el ciclo.
💰 Optimización de costos: El precio de catálogo es la tarifa por defecto. La consola de APIYI (apiyi.com) muestra los precios con descuento según el grupo en el que te encuentres; las promociones de recarga aplican por separado y las reglas están detalladas en la página de precios. Se trata de reglas públicas y transparentes, no de contratos corporativos negociados con un equipo de ventas. Los cargos reales se rigen siempre por lo que indique la consola.
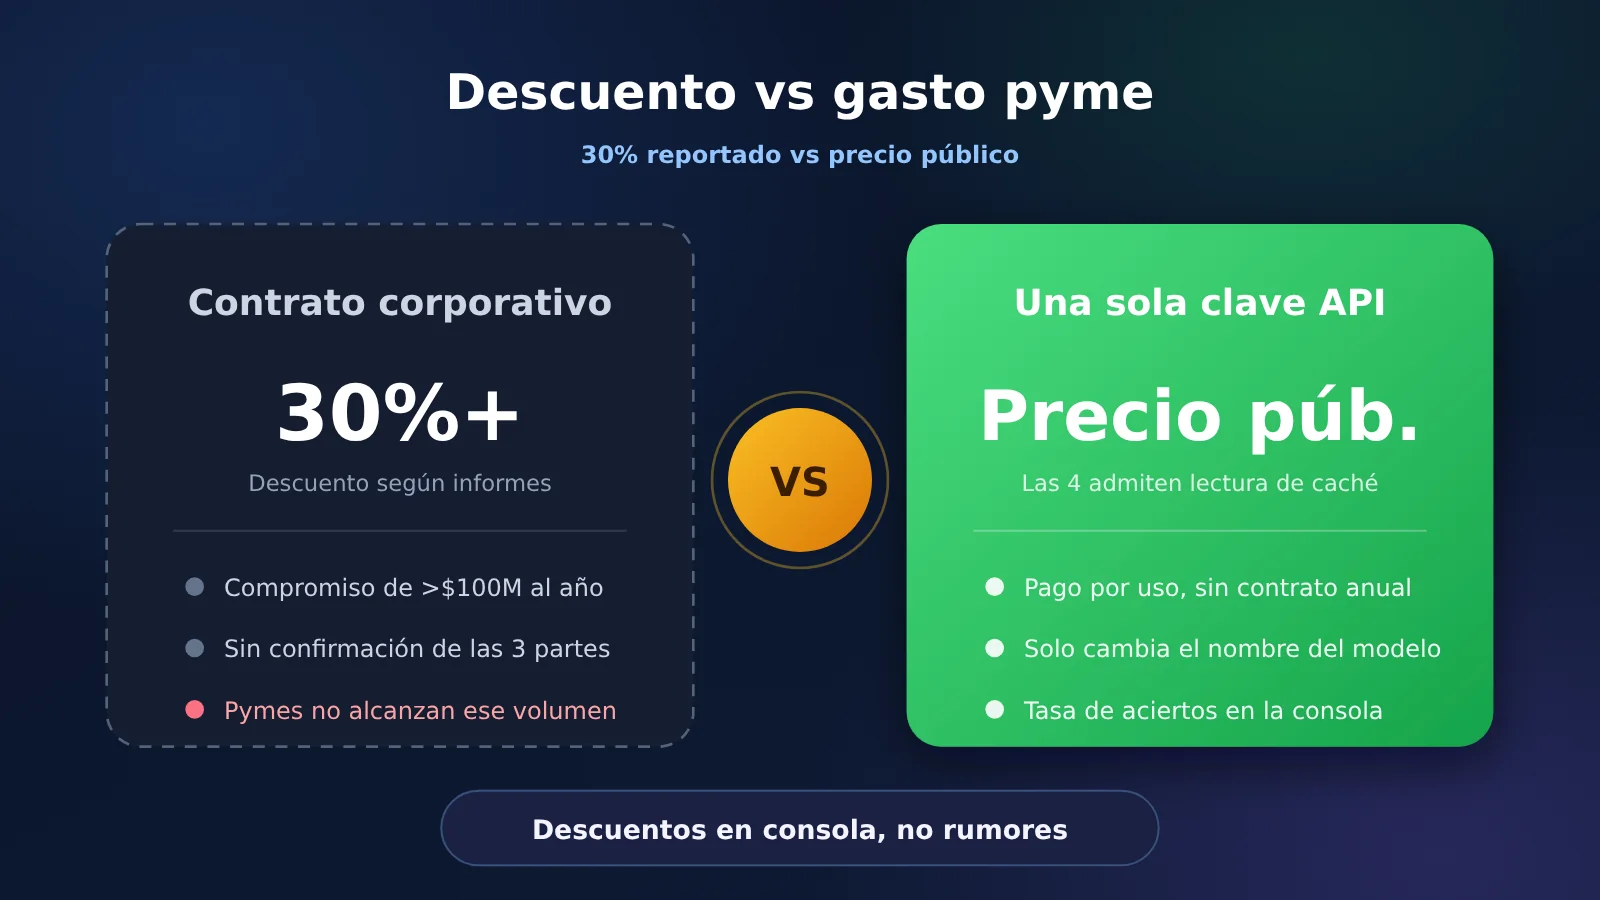
El 30 % y los 100 millones de dólares de la parte izquierda provienen de filtraciones de prensa; no son tarifas reales a las que cualquiera pueda suscribirse. La parte derecha representa la ruta viable y aplicable para equipos pequeños.
¿Cómo verificar la lectura de caché de cuatro proveedores con una sola clave?
La página de precios sugiere que, para GPT-5 y modelos posteriores, es preferible utilizar /v1/responses, ya que facilita acertar en la caché en interacciones de varios turnos. Chat Completions sigue estando disponible. En el siguiente ejemplo usamos Chat Completions para que puedas alternar entre gpt-6.1-sol, kimi-k3.1-pro y deepseek-flash simplemente cambiando el nombre del modelo. Ten en cuenta que la caché de Opus 5.5 no se activa por defecto en esta ruta: Anthropic requiere incluir un cache_control en el nivel superior de la solicitud o definir un punto de control en los bloques de contenido. APIYI ofrece tanto chat como messages para claude-opus-5-5. Si quieres aprovechar la tarifa con descuento por caché, utiliza messages e incluye cache_control. Si solo utilizas Chat Completions, no des por sentado que los $0.20 del catálogo ya se están aplicando.
- Instala lo básico: Si aún no tienes el SDK, ejecuta primero
pip install openai. Al principio de tu archivo escribeimport osyfrom openai import OpenAI. Guarda tu clave en la variable de entornoAPIYI_API_KEY, nunca directamente en el código de tu repositorio. - Crea el cliente: Con una sola línea:
client = OpenAI(api_key=os.environ["APIYI_API_KEY"], base_url="https://api.apiyi.com/v1"). Solo necesitas definir la URL base en este punto. - Fija el prefijo estático: En
STABLE_PREFIXcoloca las indicaciones del sistema y las definiciones de herramientas tal cual, sin alterar una sola letra; enuser_turnañade el contenido dinámico nuevo de cada turno, asegurándote de que siempre vaya al final. - Envía la solicitud:
resp = client.chat.completions.create(model="gpt-6.1-sol", messages=[{"role": "system", "content": STABLE_PREFIX}, {"role": "user", "content": user_turn}]). Para consultar a los otros dos proveedores, solo cambia el parámetromodelporkimi-k3.1-proodeepseek-flash. - Lee el consumo: Primero haz
details = resp.usage.prompt_tokens_details, luegocached = getattr(details, "cached_tokens", 0) or 0y finalmenteprint(resp.usage.prompt_tokens, cached, resp.usage.completion_tokens). Estos tres valores representan, en orden: tokens de indicación, tokens recuperados de la caché y tokens de salida.
Si ejecutas varias rondas consecutivas y divides los tokens recuperados de la caché entre los tokens de indicación, obtendrás tu tasa real de aciertos. Luego, multiplica esa cantidad por el precio unitario de lectura de caché de cada proveedor para ver el costo exacto en dólares. La documentación de Kimi aclara que su tarifa de caché es un precio configurable y que la facturación final se rige por su consola. En el caso de DeepSeek, si buscas la tarifa en horas valle, selecciona en el catálogo el nombre específico deepseek-v4-1-flash-260910; no des por sentado que deepseek-flash cambiará de precio automáticamente según el reloj.
Mantén tu clave API en la variable de entorno APIYI_API_KEY y no la subas a tus repositorios. El saldo gratuito de prueba viene perfecto para enviar el mismo prefijo a los cuatro modelos durante un par de turnos y comparar únicamente cómo estructuran el consumo. Si necesitas evaluar a fondo, ve sumando turnos poco a poco en lugar de saturar de golpe a los cuatro proveedores con repositorios gigantescos.
Preguntas frecuentes sobre la comparativa de lectura de caché
P1: ¿Ese 96% significa que la lectura de caché representa el 96% del importe de la factura?
No es la conclusión de este artículo. Lo que escribió Max Woolf es que la lectura de caché representa entre el 96% y el 99% del gasto total en tokens; no publicó el denominador, por lo que se trata de una estimación de terceros. WorkloadBench midió entre el 89% y el 96% de los tokens de indicación, sin incluir la salida. Según las estimaciones ilustrativas de este artículo, los tokens representan alrededor del 97%, mientras que en dinero equivale aproximadamente al 47% en Opus y Sol, cerca del 65% en Kimi y alrededor del 30% en Flash.
P2: ¿Por qué la lectura de caché de Sol a veces cuesta $0.10 y otras $0.20?
Depende de la longitud de entrada en cada petición individual. Cuando no supera los 272K tokens, la tarifa estándar de lectura de caché de OpenAI es de $0.10. Al superarlo pasa a ser de $0.20, mientras que la entrada sin acierto en caché (cache miss) sube a $4 y la salida a $15. En el catálogo de APIYI figura el precio para contexto corto de $2 / $10 / $0.10, indicando que por encima de los 272.000 tokens la entrada pasa a $4. Para la salida y la lectura de caché en contextos largos se aplica la tarifa estándar de OpenAI; si la consola muestra tramos diferenciados, prevalece lo que indique la consola.
P3: ¿Por qué DeepSeek tiene dos tarifas distintas para la lectura de caché?
Los precios oficiales se basan en tarifas de hora punta y hora valle; en hora valle cuesta la mitad que en punta. La lectura de caché en hora valle es de $0.003 y en punta de $0.006. El horario punta corresponde a los días laborables de 09:00 a 12:00 y de 14:00 a 18:00 (hora de Pekín), ya convertido desde las ventanas UTC oficiales, excluyendo los días festivos oficiales de China. Los fines de semana y festivos se consideran hora valle durante todo el día. El catálogo de APIYI desglosa estas dos tarifas en filas de modelos independientes.
P4: ¿Puede un equipo pequeño acceder al descuento del 30% para clientes empresariales?
Los descuentos que mencionan las noticias están vinculados a contratos anuales de más de 100 millones de dólares y, además, no cuentan con la confirmación pública de los tres proveedores. Un equipo pequeño no alcanza ese volumen de compromiso. Comparar los precios públicos de lectura de caché ya es suficiente para hacer una primera selección. Los precios con descuento por grupo y las promociones de recarga se rigen por lo indicado en la consola de APIYI; no hay que confundirlos con ese tipo de descuentos corporativos.
P5: ¿Cómo conectar los cuatro proveedores con una sola clave API?
Genera una clave API en APIYI (apiyi.com) y utiliza `https://api.apiyi.com/v1` como dirección base para tus peticiones. Modelos como `gpt-6.1-sol`, `kimi-k3.1-pro` y `deepseek-flash` pueden usar el endpoint de Chat Completions cambiando únicamente el nombre del modelo. Si quieres aprovechar la tarifa con caché en `claude-opus-5-5`, utiliza el endpoint `messages` e incluye `cache_control`. A partir de GPT-5, si buscas una mayor tasa de aciertos en múltiples turnos, la página de precios recomienda cambiar a `/v1/responses`.
P6: Si la lectura de caché es tan barata, ¿debería cambiar mi modelo por defecto a Flash?
Solo si el coste de un fallo es menor que la diferencia de precio. En la estimación para hora valle, la factura ronda una vigésima parte de la de Sol ($0.0486 frente a $1.02), y en hora punta aproximadamente una décima parte. Ahora bien, si Flash necesita más turnos para completar la misma tarea, ese número extra de iteraciones terminará devorando el ahorro. Lo mejor es aprovechar el saldo gratuito para comparar cuántos turnos requiere cada modelo con el mismo prefijo antes de decidir tu opción por defecto.
P7: ¿El precio de escritura en caché es más caro que el de lectura?
Ocurre cuando los prefijos caducan con frecuencia y hay muy pocos aciertos de caché. Tanto en Opus como en Sol, la escritura en el nivel corto cuesta 1,25 veces el precio de entrada, y el nivel de 12 horas de Sol sube a 2,5 veces. En Kimi, la escritura para la ventana de 5 minutos cuesta lo mismo que la entrada normal. Solo tras dos o tres rondas con aciertos, la lectura de caché pasa a ser el coste principal. Si tienes tareas con intervalos irregulares, primero asegúrate de elegir bien el TTL antes de ponerte a comparar la lectura de caché.
Puntos clave al comparar la lectura de caché
- El 96% es una estimación de terceros: Max Woolf no publicó los registros detallados. Para saber el impacto real en dólares, tendrás que multiplicar tú mismo por el precio unitario.
- Revisa primero la lectura de caché y luego si cambia de nivel: En Sol, al superar los 272K, la lectura de caché salta de $0.10 a $0.20.
- La lectura de caché cuesta lo mismo en Opus y Kimi ($0.20): Sin embargo, en Kimi el coste sin acierto (miss) y los tokens de salida son más bajos, y la escritura en el nivel corto no tiene recargo adicional.
- La ventaja de Flash está en el orden de magnitud: A $0.003 en horas valle y $0.006 en horas pico, la estructura de costes en dólares deja de estar dominada únicamente por la lectura de caché.
- El 30% corporativo no aplica a equipos pequeños: Esa cifra corresponde a acuerdos marco anuales citados en la prensa. Las tarifas públicas son más que suficientes para hacer la primera criba.
- Una sola clave para conectarte a los cuatro proveedores: Solo cambia el nombre del modelo en APIYI apiyi.com; la tasa real de aciertos siempre la verás reflejada en el consumo de la consola.
Resumen
En estos cuatro meses, las rebajas de precios oficiales llegaron hasta un 80 %, concentrándose sobre todo en el precio de lista de Luna y en la lectura de caché de la línea Sol, que cayó de $0.50 a $0.10. Para los agentes de programación, sigue siendo fundamental desglosar la lectura de caché por separado. Con los precios oficiales al 26-10-2026, en contextos cortos la lectura de caché de GPT-6.1 Sol cuesta $0.10, la de Opus 5.5 y Kimi K3.1 Pro está en $0.20, y la de DeepSeek V4.1 Flash se sitúa en $0.003 en horas valle y $0.006 en horas pico. La cifra del 96 %–99 % se cita únicamente como referencia de Max Woolf. En una factura estimada, el ahorro en tokens puede acercarse a ese rango, pero en dólares reales el descuento resulta algo menor.
Los descuentos empresariales que circulan en las noticias exigen compromisos anuales que un equipo pequeño difícilmente puede asumir. Conectar los cuatro proveedores a una misma clave API y calcular el coste multiplicando tu propia tasa de aciertos de caché por los precios públicos resulta mucho más práctico que esperar a negociar un contrato con 30 % de descuento. Te recomendamos probar primero el mismo prefijo estable en APIYI (apiyi.com) antes de decidir qué modelo usar por defecto.
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes ponerte en contacto a través de la página principal de APIYI. El precio unitario de cada modelo se rige por la página de precios en el centro de documentación de docs.apiyi.com.
Referencias
- Max Woolf: Cronología de bajadas de precio y estimaciones del 96 %–99 %
- Enlace:
minimaxir.com/2026/10/cheap-llms -
Nota: 25-10-2026. El rango del 96 %–99 % corresponde a una afirmación del autor original, no a mediciones propias de este artículo.
-
Precios de modelos de Anthropic
- Enlace:
platform.claude.com/docs/en/about-claude/pricing -
Nota: Costes de entrada, salida, lectura de caché y los dos niveles de escritura para Opus 5.5.
-
Precios de modelos de OpenAI
- Enlace:
developers.openai.com/api/docs/pricing -
Nota: Costes de contexto corto, contexto largo, lectura y escritura de caché para GPT-6.1 Sol. El umbral oficial entre contexto corto y largo se sitúa en 272K.
-
Precios de modelos de DeepSeek
- Enlace:
api-docs.deepseek.com/quick_start/pricing -
Nota: Precios de acierto en caché (horas pico y valle), fallos de caché y tokens de salida para
deepseek-flash. -
API de Kimi
- Enlace:
platform.kimi.ai -
Nota: Precios de entrada, salida, aciertos de caché y coste de escritura predeterminado para Kimi K3.1 Pro.
-
Cobertura de AI Weekly sobre el contrato de Replit
- Enlace:
aiweekly.co/alerts/replit-shifts-100m-ai-spend-to-openai-after-30-price-cut -
Nota: El descuento superior al 30 % y el gasto anual de más de 100 millones de dólares proceden de reportes de The Information; ninguna de las partes ha confirmado públicamente estas condiciones.
-
Porcentaje de tokens en caché según WorkloadBench
- Enlace:
workloadbench.brenhq.com/cache - Nota: 16-10-2026. Proporción de tokens de indicación provenientes de la caché, no expresada en dólares.