Nota del autor: Está previsto publicar los pesos de MiniMax M3.1 Flash el 23 de octubre. En este artículo explicamos qué nivel de hardware se necesita para desplegarlo localmente y comparamos, desde cuatro perspectivas, qué sale más a cuenta: desplegarlo por cuenta propia o llamar directamente a la API.
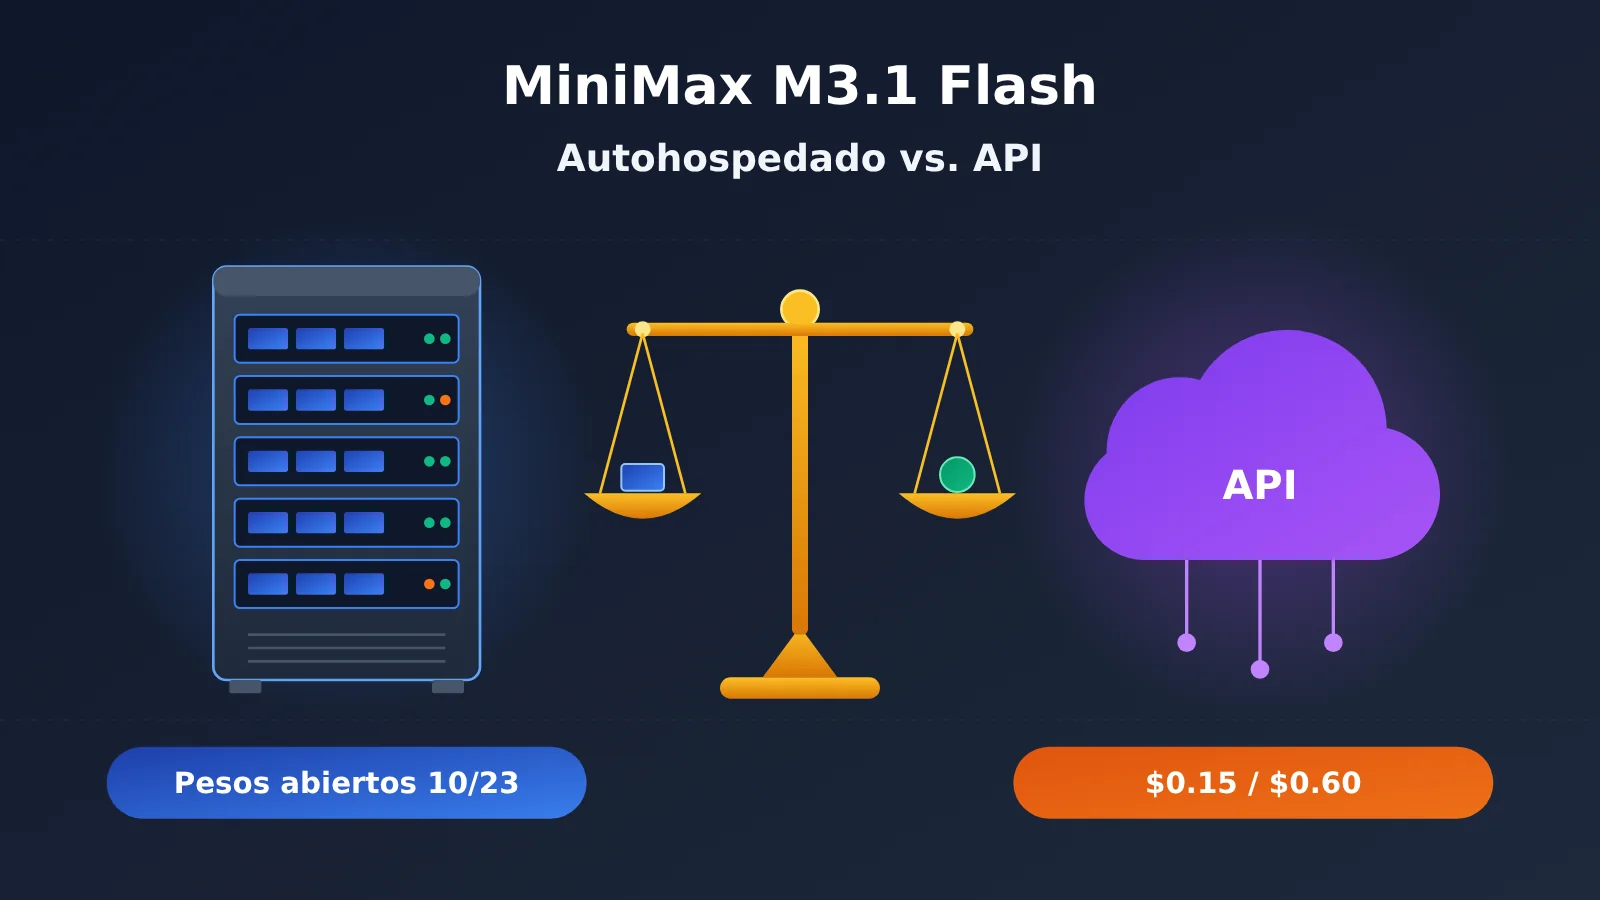
La conclusión, de entrada: para la gran mayoría de los desarrolladores individuales y los equipos pequeños, llamar directamente a la API, que cuesta 0,15 $ por cada millón de tokens de entrada y 0,60 $ por cada millón de tokens de salida, resulta mucho más económico y sencillo que desplegar el modelo por cuenta propia. Solo merece la pena plantearse el autodespliegue en tres casos: si las normas te impiden sacar los datos de la red interna, si el volumen de llamadas es tan alto que permite mantener un servidor con varias GPU funcionando a plena capacidad durante mucho tiempo, o si necesitas modificar o ajustar el propio modelo.
Este artículo no pretende disuadirte de usar modelos de código abierto. Los pesos abiertos son valiosos para el sector, pero «poder descargarlos» y «merecer la pena ejecutarlos por cuenta propia» son dos cosas distintas. En este sitio ya publicamos un artículo aparte sobre el anuncio de M3.1 Flash; aquí no repetiremos esa información. Solo responderemos a dos preguntas: qué configuración hace falta para desplegarlo localmente y qué sale más a cuenta, autodesplegarlo o llamar a la API.
Lo más importante: al terminar de leer, podrás decidir si te conviene esperar a que se publiquen los pesos y qué información deberías confirmar primero cuando estén disponibles.
Estado de los pesos abiertos de MiniMax M3.1 Flash: qué está confirmado y qué aún no se ha anunciado
Primero, aclaremos un término. Pesos abiertos significa que los archivos de parámetros con los que se ha entrenado un modelo se publican para que puedas descargarlos y ejecutarlos en tus propios servidores. No es lo mismo que el «código abierto» ni significa que puedas usar el modelo para cualquier fin comercial: eso depende de la licencia.
A fecha de publicación (22 de octubre de 2026), los pesos de M3.1 Flash todavía no se han publicado oficialmente. En una publicación de MiniMax en X se lee: «Model weights will arrive on Oct 23», es decir, que está previsto publicarlos el 23 de octubre. El blog oficial solo dice que se publicarán «más adelante». Además, según un informe de RITS, de la Universidad de Nueva York en Shanghái, el 20 de octubre todavía no había ningún repositorio de M3.1 Flash en la organización de MiniMax en Hugging Face.
Para distinguir la fiabilidad de la información, en este artículo la clasificamos en tres niveles: declaraciones oficiales (información publicada por MiniMax), evaluaciones de terceros (como las de Vals AI) e información desconocida o no publicada.
| Información | Estado | Nivel de información |
|---|---|---|
| Fecha de publicación de los pesos | Una publicación oficial en X indica el 23 de octubre; el blog oficial solo dice «más adelante» | Declaración oficial (es una fecha prevista; aún no se ha cumplido) |
| Tamaño del modelo | Arquitectura MoE, con 428B de parámetros totales y unos 23B activos, igual que M3 | Información oficial, difundida por los medios |
| Licencia | La licencia de M3.1 Flash aún no se ha anunciado | Desconocido/no publicado |
| Requisitos de hardware para el despliegue | La guía oficial de despliegue todavía no incluye M3.1 Flash | Desconocido/no publicado |
| Informe técnico | Aún no se ha publicado una explicación de los cambios de Flash respecto a M3 | Desconocido/no publicado |
| Modelo de referencia M3 | Sus pesos están disponibles en Hugging Face desde junio y utilizan una licencia comunitaria | Información oficial |
⚠️ Aviso: cuando se publiquen los pesos, consulta la página oficial del modelo de MiniMax en Hugging Face para confirmar las condiciones de la licencia, el tamaño de los archivos y el hardware recomendado. Las versiones cuantizadas que redistribuye la comunidad no están verificadas oficialmente; no las confundas con la configuración oficial.
Qué configuración hace falta para desplegar MiniMax M3.1 Flash localmente
El equipo oficial todavía no ha publicado los requisitos de hardware de M3.1 Flash, así que no vamos a especular sobre la memoria de GPU ni la cantidad de GPU necesarias. Podemos tomar como referencia la generación anterior, M3, que tiene el mismo número de parámetros totales (428B) y de parámetros activos (unos 23B). Esto sirve para estimar el orden de magnitud.
Primero, entendamos qué significan los «428B de parámetros totales y 23B activos» de MiniMax M3.1 Flash
MoE (mezcla de expertos) es una arquitectura en la que el modelo está compuesto por muchas subredes llamadas «expertos», pero solo se activa una parte de ellas durante cada inferencia. Los «23B de parámetros activos» indican cuántos parámetros participan realmente en el cálculo por cada token generado, lo que puede hacer que el modelo sea relativamente rápido.
Pero hay algo que puede llevar a confusión: tener pocos parámetros activos no significa que se necesite poca memoria de GPU. Los 428B parámetros deben estar cargados en la memoria dedicada de las GPU para poder recurrir a cualquier experto en cualquier momento durante la inferencia. Este es uno de los principales motivos por los que desplegar localmente modelos MoE grandes requiere tanto hardware.
Configuración de referencia para desplegar M3 según MiniMax (solo como orientación sobre el orden de magnitud)
Antes, conviene aclarar algunos términos. MXFP8 es un formato de almacenamiento de 8 bits que reduce el tamaño de los archivos del modelo y el uso de memoria de GPU. SGLang es un framework de inferencia de código abierto que permite ejecutar el modelo como un servicio de API compatible con el formato de OpenAI. TP (paralelismo de tensores) consiste en dividir un modelo entre varias GPU para ejecutarlo de forma coordinada.
| Modelo | Configuración de referencia oficial | Tamaño de los pesos | Estado |
|---|---|---|---|
| MiniMax-M3 | 8 × B200, precisión MXFP8, interfaz compatible con OpenAI de SGLang | La versión MXFP8 ocupa unos 440 GB | Experimental |
| MiniMax-M2.7 | 4 GPU NVIDIA con gran capacidad de memoria, TP 4 | No se ha publicado un requisito mínimo de memoria unificado | Preview |
| MiniMax-M3.1 Flash | La guía oficial de despliegue aún no lo contempla | No publicado | Desconocido / no publicado |
Insistimos: los datos de M3 de la tabla no son los requisitos oficiales de M3.1 Flash. Sirven para mostrar que la configuración de referencia oficial para un modelo de tamaño similar requiere 8 GPU de nivel de centro de datos y que solo los pesos MXFP8 ocupan unos 440 GB. Este nivel está muy por encima de lo que ofrecen las GPU de consumo y las estaciones de trabajo convencionales. No es realista esperar ejecutar una versión completa en casa con una o dos GPU para videojuegos.
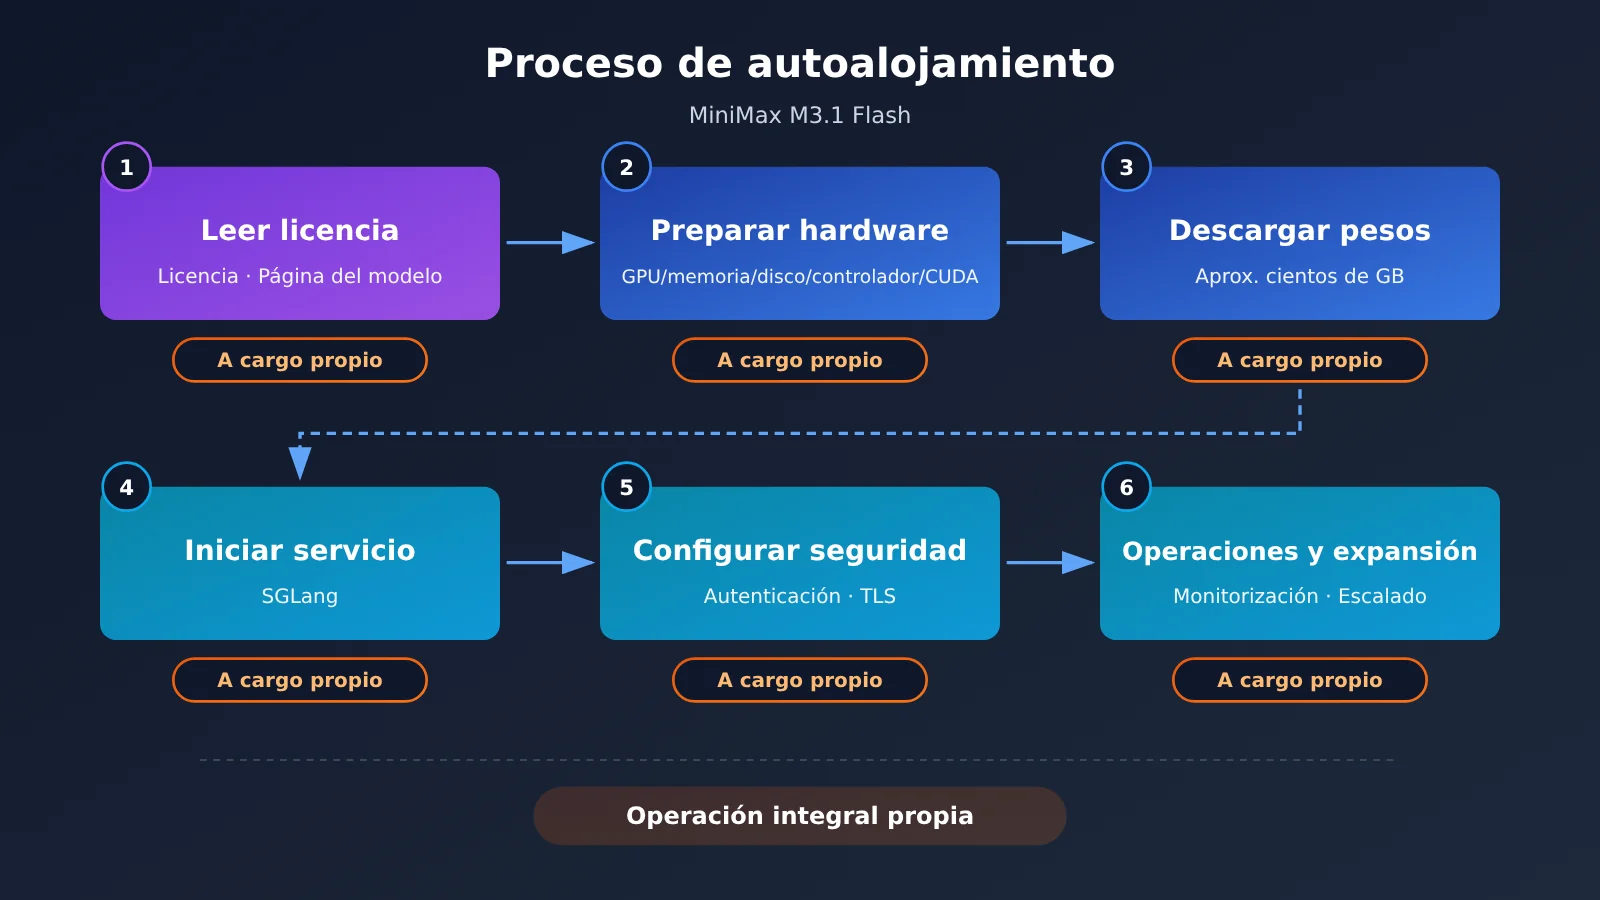
La documentación oficial de despliegue de MiniMax también ofrece algunas recomendaciones previas que se aplican a todos sus modelos de código abierto:
- Lee primero la licencia y el alcance de uso permitido para confirmar que tu caso de uso está autorizado.
- Prepara el hardware según la página del modelo, incluidas las GPU, la memoria, el disco, los controladores y la versión de CUDA.
- Fija las versiones: usa versiones concretas del modelo y del framework de inferencia, y evita seguir los cambios de las ramas
mainolatest. - Para descargar desde espejos en China, utiliza únicamente las fuentes oficiales indicadas en la página del modelo y evita descargar archivos que puedan haber sido manipulados.
¿Sale más a cuenta desplegar MiniMax M3.1 Flash por tu cuenta o usar su API?
Esta es la pregunta clave del artículo. Para decidir, compara tu situación con estos cuatro criterios.
| Criterio | Conviene usar directamente la API | Conviene desplegarlo por tu cuenta |
|---|---|---|
| Requisitos de cumplimiento de datos | Puedes enviar los datos a un proveedor de servicios en la nube para que los procese | La normativa o los contratos exigen que los datos no salgan de la red interna |
| Volumen de solicitudes | Volumen pequeño o mediano, con picos y valles marcados | Volumen alto y sostenido, suficiente para mantener varios servidores con GPU funcionando a plena capacidad |
| Capacidad de operación del equipo | No tienes personal dedicado a operar GPU | Hay alguien responsable del clúster, la monitorización y las guardias |
| Necesidad de modificar el modelo | Basta con usar sus capacidades generales | Necesitas ajustar el modelo, modificar su estructura o personalizarlo en profundidad |
Si al menos dos de los tres primeros criterios encajan con la columna de la izquierda, elegir la API suele ser una apuesta segura.
Cómo calcular el coste de la API de MiniMax M3.1 Flash
Los precios oficiales son fijos: $0.15 por la entrada, $0.60 por la salida y $0.015 por las lecturas de caché. Todos los precios son por millón de tokens y no hay recargo por ventanas de contexto largas. Un token es la unidad de texto que usa el modelo para calcular el coste. Según la equivalencia indicada por el proveedor, unos 750 términos en inglés equivalen a aproximadamente 1000 tokens. Las lecturas de caché son contenidos de prefijo idénticos que se envían repetidamente y se facturan a un precio más bajo.
Veamos un ejemplo calculado con las tarifas oficiales (no es una medición real): con 100 millones de tokens de entrada y 20 millones de tokens de salida al mes, el coste sería 100 × $0.15 + 20 × $0.60 = $27. Es un volumen considerable para una persona o un equipo pequeño: unas decenas de dólares al mes.
Para calcular el coste del despliegue propio hay que usar otro enfoque. Si tomamos como referencia la configuración de M3 con 8 × B200, tanto comprar como alquilar una máquina de este tipo implica un gasto fijo recurrente, incluso cuando nadie la está usando. Para amortizar ese coste, normalmente hace falta un volumen de llamadas lo bastante alto como para mantener la máquina ocupada durante largos periodos. La mayoría de las personas y los equipos pequeños no llegan a ese nivel.
Hay algo que conviene tener en cuenta: el proceso de razonamiento de M3.1 Flash no se puede desactivar. Si no se especifica el parámetro effort (nivel de razonamiento), se usa por defecto el nivel máximo. El contenido del razonamiento también cuenta como tokens de salida. Por eso, el coste de salida de la factura puede ser mayor de lo que esperas. Para ahorrar, puedes ajustar effort a low o medium.
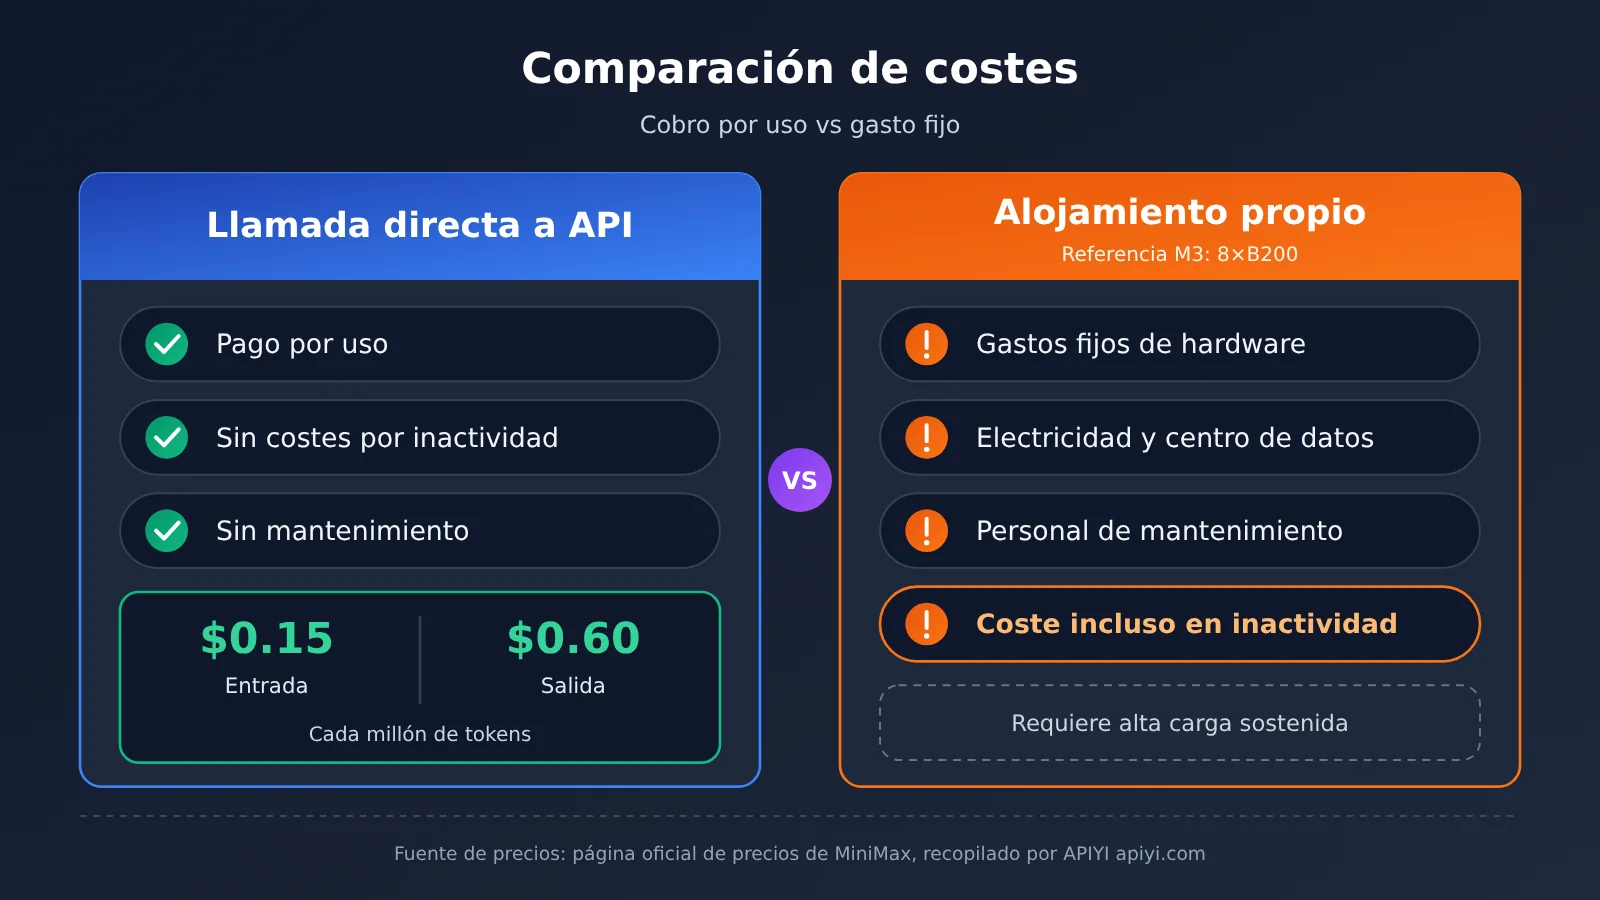
Los precios del gráfico anterior proceden de la página oficial de precios de MiniMax y los ha recopilado el equipo técnico de APIYI, apiyi.com. La siguiente tabla muestra los precios oficiales de algunos modelos que suelen compararse:
| Modelo | Precio de entrada (por millón de tokens) | Precio de salida (por millón de tokens) | Plataformas disponibles |
|---|---|---|---|
| MiniMax-M3.1-Flash | $0.15 | $0.60 | API oficial de MiniMax, M Plan; consulta la página de precios para saber si está disponible en APIYI |
| MiniMax-M3 (≤512K de entrada) | $0.30 | $1.20 | API oficial de MiniMax, APIYI apiyi.com |
| claude-opus-5-5 | $4 | $20 | API oficial de Anthropic, APIYI apiyi.com |
| claude-opus-5 | $5 | $25 | API oficial de Anthropic, APIYI apiyi.com |
💰 Consejo para ahorrar: Si quieres probar ya el rendimiento de la serie MiniMax, puedes empezar con MiniMax-M3, que ya está disponible en APIYI apiyi.com, y poner en marcha el flujo de trabajo. Consulta la página de precios para saber si M3.1 Flash está disponible en APIYI. También intentaremos incorporarlo lo antes posible.
De qué tendrás que encargarte al desplegar MiniMax M3.1 Flash por cuenta propia
La documentación oficial de MiniMax lo deja claro: los pesos de código abierto no incluyen funciones de la plataforma como el almacenamiento en caché o la seguridad de contenidos, y el servicio, de forma predeterminada, solo escucha en la máquina local. Antes de decidirte por un despliegue propio, asegúrate de que alguien se encargará de lo siguiente:
- Autenticación: añade una clave de acceso a la interfaz para evitar que otras personas la utilicen sin autorización;
- Cifrado TLS: si expones el servicio a Internet, usa HTTPS para cifrar la transmisión y evitar que intercepten los datos;
- Aislamiento de red: limita qué máquinas y subredes pueden acceder al servicio de inferencia;
- Supervisión y alertas: alguien debe vigilar el uso de la GPU y la memoria, la latencia y la tasa de errores;
- Planificación de capacidad y ampliación: prepara con antelación un plan de ampliación para cuando las solicitudes se acumulen en horas punta;
- Recuperación ante fallos y actualizaciones: define cómo recuperar el servicio si falla una máquina y cómo desplegar gradualmente las nuevas versiones;
- Seguridad de contenidos: tendrás que añadir por tu cuenta la moderación del contenido de entrada y salida;
- Cumplimiento de la licencia: lee la licencia completa y las políticas de uso antes de desplegar, redistribuir o usar el modelo con fines comerciales.
Si algún punto de esta lista se queda sin responsable, el ahorro en el coste de los tokens puede acabar absorbido por los costes de operación y mantenimiento.
Qué tal es MiniMax M3.1 Flash: datos oficiales frente a evaluaciones de terceros
Antes de decidir si te conviene desplegar el modelo por tu cuenta, conviene conocer su rendimiento real. La siguiente tabla organiza los datos según su nivel de fiabilidad:
| Indicador | Datos | Nivel de fiabilidad |
|---|---|---|
| Automation-Bench v1.0.6 | 62.2; Claude Opus 5 obtuvo 50.3 | Datos oficiales |
| BankerToolBench | 76.2, a la par de Claude Opus 5 | Datos oficiales |
| Terminal Bench 4.0 | 38.1; Claude Opus 5 obtuvo 51.8 | Datos oficiales |
| SWE Refactor Bench | 23.0; Claude Opus 5 obtuvo 31.0 | Datos oficiales |
| Velocidad de inferencia | El blog indica más de 200 TPS en el uso diario y más de 170 en P50; la página del producto habla de unos 150 tokens por segundo | Datos oficiales (cifras dispares) |
| Vals Index | 53.78 %; ocupa el puesto 15 entre 22 modelos y el 5 entre los modelos de pesos abiertos | Evaluación de terceros |
| Vals Terminal-Bench 4.0 | 25.25 %; ocupa el puesto 22 entre 51 modelos | Evaluación de terceros |
| «Cuesta un tercio que M3» | Se calcula por tarea, pero no se ha publicado el método concreto | Desconocido/no publicado |
TPS indica cuántos tokens genera el modelo por segundo: cuanto mayor sea la cifra, más rápido responde.
Hay que precisar la comparación con Claude: en la tabla oficial de MiniMax, el modelo de referencia es Claude Opus 5, no Opus 5.5. Claude Opus 5.5 sigue siendo el modelo insignia más potente de Anthropic, y la empresa no lo ha comparado punto por punto con M3.1 Flash. Por tanto, no se puede concluir que este último haya igualado o superado a Opus 5.5.
Incluso frente a Opus 5, M3.1 Flash queda claramente por detrás en tareas de programación con varios pasos y de refactorización, como las de Terminal Bench y SWE Refactor. Los resultados de terceros de Vals también indican que el modelo flojea en tareas de agente de varios pasos.
Cuándo no deberías usar MiniMax M3.1 Flash ni apresurarte a desplegarlo por tu cuenta
En estos casos, lo mejor es no hacer cambios todavía:
- Planificación compleja y grandes refactorizaciones: Tanto las evaluaciones publicadas por el equipo como las de terceros indican que el modelo flojea en tareas que requieren cadenas largas de pasos. Para este tipo de trabajo, es más seguro recurrir a modelos insignia como Claude Opus 5.5.
- Latencia extremadamente sensible y sin necesidad de razonamiento profundo: No se puede desactivar el modo de razonamiento; incluso en el nivel low genera una sobrecarga.
- Integraciones que analizan las etiquetas
<think>de M3: En M3.1 Flash, el contenido del razonamiento se devuelve en un campo independiente. Antes de cambiar de modelo, tendrás que actualizar la lógica de análisis antigua. - Licencia aún sin aclarar: La licencia todavía no se ha publicado junto con los pesos. No planifiques con antelación un despliegue propio para un proyecto comercial.
- No hay nadie de guardia: Si nadie se hace responsable de la lista de tareas operativas de la sección anterior, no pongas tu servicio en manos de una infraestructura propia.
- Quieres ejecutar la versión completa en una tarjeta gráfica de consumo: Por la escala de M3, no es realista. Espera a que se publiquen las especificaciones oficiales de hardware y desconfía de las versiones cuantizadas de procedencia dudosa.
Combinar MiniMax y Claude Opus 5.5 en APIYI
Para la mayoría de los desarrolladores, la pregunta más práctica no es «¿lo despliego por mi cuenta o uso una API?», sino cómo asignar las tareas de distinta dificultad a modelos diferentes.
APIYI permite usar una misma clave para invocar modelos internacionales como Claude, GPT y Gemini, así como modelos nacionales como DeepSeek y MiniMax. Actualmente, en APIYI puedes usar directamente MiniMax-M3 (compatible con los formatos de interfaz de OpenAI y Anthropic, y también disponible en el grupo ClaudeCode), la serie MiniMax-M2.7, además de claude-opus-5-5 y claude-opus-5. A fecha de publicación, MiniMax-M3.1-Flash aún no aparece en la página de precios de APIYI; consulta esa página para confirmar si está disponible.
Esta es la distribución recomendada:
- Deja las tareas repetitivas y económicas en manos de MiniMax: limpieza de datos, resúmenes por lotes, conversión de formatos, autocompletado de código sencillo y otras tareas de gran volumen y baja dificultad. Cuanto menor sea el precio por uso, más conviene.
- Reserva la planificación difícil y las refactorizaciones para Claude Opus 5.5: refactorizaciones entre varios archivos, diseño de arquitectura y planificación de tareas complejas de agentes. Cada invocación cuesta más, pero corregir errores también puede salir caro.
- Cambia de modelo con la misma clave: solo tienes que cambiar el nombre del modelo; no hace falta mantener varias cuentas ni distintas direcciones de interfaz.
🎯 Recomendación técnica: En APIYI apiyi.com, prueba MiniMax-M3 y claude-opus-5-5 con la misma clave y con tus tareas reales. Comparar los resultados y el costo te dará una referencia más fiable que cualquier puntuación de rendimiento.
Preguntas frecuentes
Q1: ¿Cuándo se podrán descargar los pesos de MiniMax M3.1 Flash?
La fecha prevista que aparece en la publicación oficial de X es el 23 de octubre; el blog oficial solo dice «más adelante». A fecha de publicación, todavía no están disponibles. Consulta la página oficial del modelo MiniMax en Hugging Face para conocer las últimas novedades.
Q2: ¿Se puede ejecutar MiniMax M3.1 Flash en una tarjeta gráfica de consumo?
El equipo oficial no ha publicado los requisitos de hardware de M3.1 Flash. Como referencia, la configuración recomendada oficialmente para M3, de tamaño similar, usa 8 × B200 y requiere unos 440 GB para los pesos MXFP8. Ejecutar la versión completa en una sola tarjeta gráfica de consumo es, en la práctica, inviable.
Q3: ¿Se podrá usar MiniMax M3.1 Flash con fines comerciales cuando se publique como código abierto?
La licencia aún no se ha anunciado. El equipo oficial advierte que publicar los pesos como código abierto no significa que todos los modelos tengan la misma licencia. Antes de implementar el modelo, redistribuirlo o usarlo con fines comerciales, hay que leer la licencia completa.
Q4: ¿Cuál es la forma más económica de probar los modelos de MiniMax ahora?
Lo más sencillo es usar la API directamente. Puedes acceder a M3.1 Flash mediante la API oficial de MiniMax o una suscripción a M Plan (consulta el sitio web oficial para ver el precio mensual). Si quieres gestionar varios modelos con una sola clave, puedes empezar usando MiniMax-M3, disponible en APIYI apiyi.com. Consulta la página de precios de APIYI para confirmar si se puede acceder a M3.1 Flash.
Q5: ¿Puede MiniMax M3.1 Flash sustituir a Claude Opus 5.5?
No es recomendable verlo así. El equipo oficial solo lo comparó con Claude Opus 5 y, en tareas de programación con cadenas de pasos largas, M3.1 Flash quedó por detrás. Lo más razonable es repartir el trabajo: usar MiniMax para tareas por lotes y Opus 5.5 para la planificación y la refactorización más complejas. En APIYI puedes combinar ambos con una sola clave.
Puntos clave sobre los pesos abiertos de MiniMax M3.1 Flash
- Los pesos aún no están disponibles: está previsto publicarlos el 23 de octubre; consulta la página oficial del modelo en Hugging Face para confirmar la fecha.
- La licencia y los requisitos de hardware todavía no se han anunciado: no compres equipos ni planifiques plazos basándote en suposiciones.
- Como referencia de escala, toma M3: requiere 8 GPU B200 y unos 440 GB de pesos MXFP8, por lo que pertenece al ámbito de los centros de datos.
- La API sale más rentable: con un precio de $0.15/$0.60 por unidad, para la mayoría de las personas y los equipos pequeños resulta mucho más sencillo que desplegar el modelo por cuenta propia.
- El despliegue propio tiene aplicaciones limitadas: está pensado sobre todo para casos con requisitos estrictos de cumplimiento, volúmenes de invocaciones muy altos o necesidad de modificar el modelo.
- La comparación es con Opus 5: Opus 5.5 sigue siendo el modelo insignia más potente de Anthropic; la empresa no ha publicado una comparación detallada punto por punto.
- Combina modelos: en APIYI, apiyi.com, puedes usar una sola clave para combinar MiniMax y Claude Opus 5.5.
Resumen
Puntos clave sobre los pesos abiertos de MiniMax M3.1 Flash:
- Situación actual: está previsto publicar los pesos el 23 de octubre. La licencia y los requisitos de hardware para el despliegue aún no se han anunciado; consulta siempre la página oficial del modelo.
- Configuración: como referencia, el M3, de escala similar, requiere 8 GPU de nivel B200 según la configuración oficial; no es algo que pueda asumir un equipo personal.
- Decisión: evalúa cuatro aspectos —cumplimiento, volumen de invocaciones, capacidad operativa y necesidad de modificar el modelo—. En la mayoría de los casos, usar la API sale más rentable.
Cuando se publiquen los pesos, lee primero la licencia y las especificaciones oficiales de hardware; después decide si te conviene desplegar el modelo por cuenta propia. En la práctica, suele ser más útil asignar modelos distintos a tareas de diferente dificultad. En APIYI, apiyi.com, puedes probar con una sola clave cómo funciona la combinación de la serie MiniMax y claude-opus-5-5.
📚 Referencias
- Blog oficial de MiniMax: anuncio de lanzamiento de M3.1 Flash y datos publicados por la empresa
- Enlace:
minimax.io/blog/minimax-m31f -
Nota: declaración oficial de que los precios, la velocidad y los pesos se publicarán «más adelante»
-
Página oficial de precios de MiniMax: tarifas por uso de cada modelo
- Enlace:
platform.minimax.io/docs/guides/pricing -
Nota: comparación de precios entre M3.1 Flash y M3
-
Guía oficial de implementación local de MiniMax: configuración de referencia para implementar modelos de código abierto
- Enlace:
platform.minimax.io/docs/guides/local-deploy -
Nota: configuración de referencia de 8 × B200 para M3 y aspectos que debes tener en cuenta al implementarlo por tu cuenta
-
Página de evaluación de Vals AI: resultados de evaluaciones independientes de M3.1 Flash
- Enlace:
vals.ai/models/minimax_MiniMax-M3.1-flash -
Nota: clasificación en Vals Index y puntuaciones de cada categoría
-
Hugging Face – MiniMax-M3: pesos de M3 y licencia de la comunidad
- Enlace:
huggingface.co/MiniMaxAI/MiniMax-M3 -
Nota: cuando se publiquen los pesos de M3.1 Flash, podrás consultarlos en la misma organización
-
Documentación de SGLang – MiniMax-M3: instrucciones para implementarlo con un framework de inferencia
- Enlace:
docs.sglang.io/cookbook/autoregressive/MiniMax/MiniMax-M3 - Nota: tamaño de la versión MXFP8 de M3 y cómo ejecutarla
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página de inicio del sitio web oficial de APIYI. También encontrarás más recursos en el centro de documentación de docs.apiyi.com