Hace poco un cliente preguntó en el grupo algo muy típico: «Nosotros con images2, ¿podemos generar un set de imágenes para ecommerce, no?» La respuesta es sí, pero no se obtiene un set completo con una sola llamada. La interfaz de gpt-image-2 funciona con «un prompt por generación», así que para conseguir un conjunto como imagen principal, imagen de beneficios, imagen de escena y página de detalles —cada una con contenido distinto—, hay que diseñar un poco la forma de hacer las llamadas.
En este artículo dividimos los sets de imágenes ecommerce con gpt-image-2 en dos rutas: una es usar una sola imagen para transmitir información multidimensional, ideal para las imágenes largas de página de detalles; la otra es primero usar un modelo de texto para desglosar los requisitos y generar el prompt de cada imagen, y luego invocar gpt-image-2 en paralelo, ideal para un set de varias imágenes en el sentido real. Al terminar tendrás el diseño completo del flujo, código ejecutable y varios trucos clave para mantener el estilo uniforme en todo el set.
La limitación clave de los sets ecommerce con gpt-image-2: una llamada, un prompt
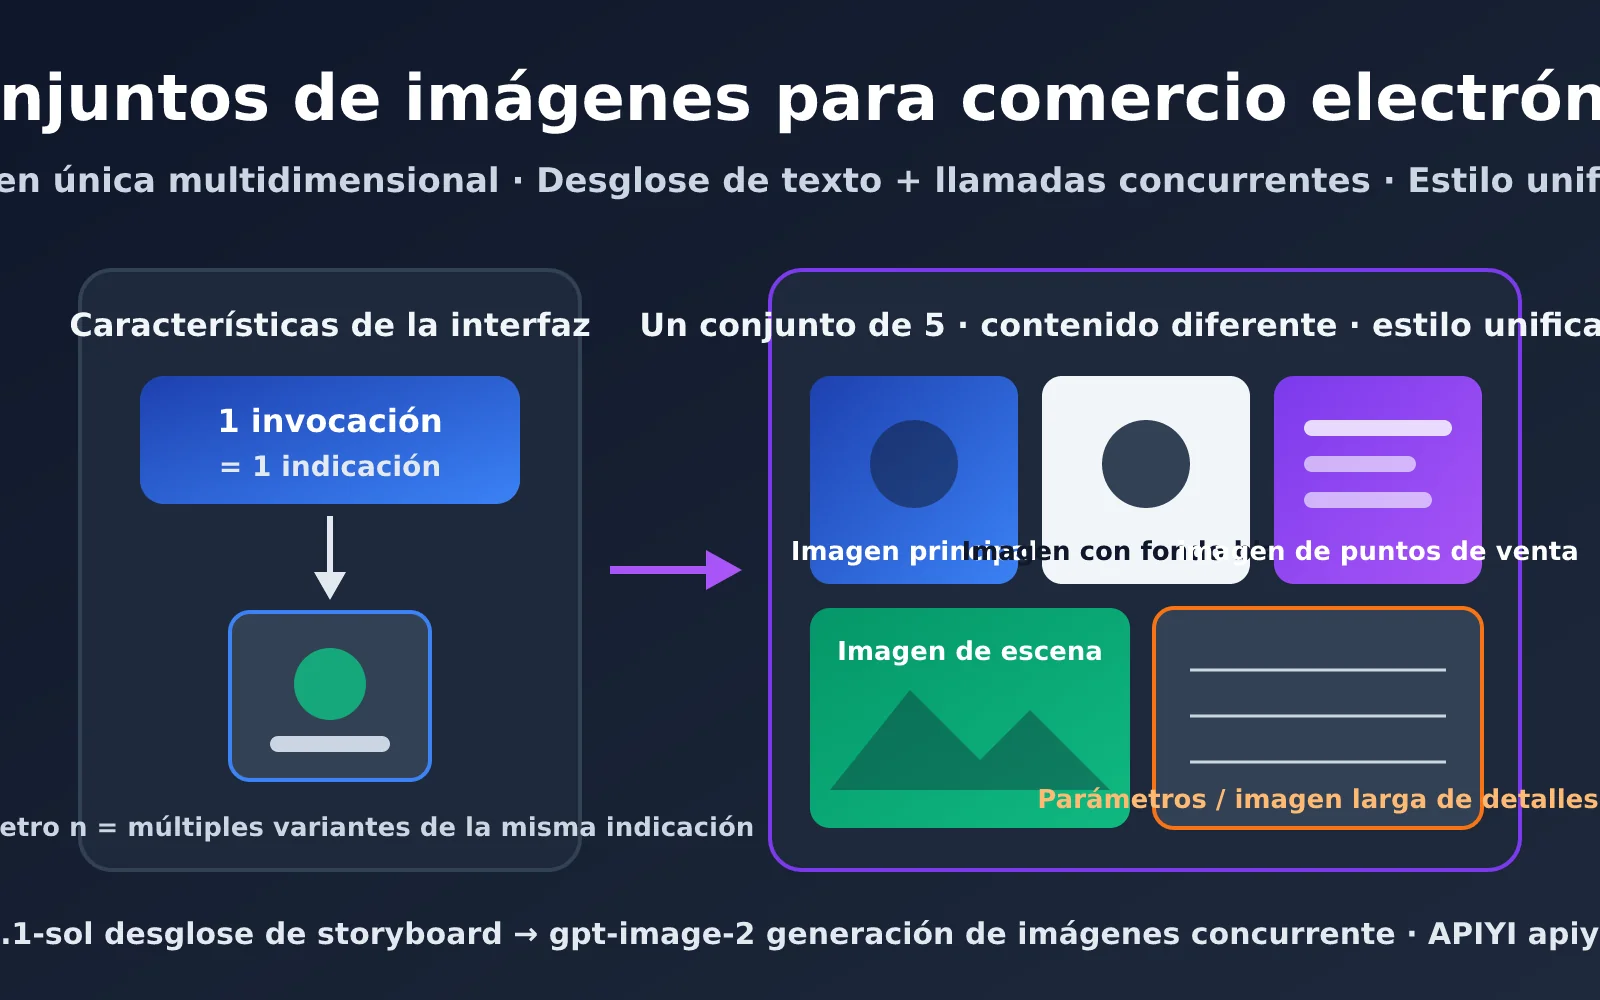
Primero dejemos claro el comportamiento de la interfaz, porque todo el diseño que viene después se apoya en esta premisa. Los endpoints /v1/images/generations y /v1/images/edits de gpt-image-2 solo aceptan un prompt por petición. La serie oficial gpt-image-2 y 2.5 admite el parámetro n, y APIYI también lo soporta por completo, pero el significado de n es «generar n variantes del mismo prompt», no «n prompts que generan 1 imagen cada uno».
Así que con n=5 obtienes 5 versiones del mismo encuadre, útil para «generar varias y quedarte con la mejor», pero no para un set. Un set de imágenes ecommerce es, en esencia, varias imágenes con contenido distinto y estilo uniforme: la principal debe destacar el producto, la de beneficios lleva copy, la de escena necesita un entorno de uso y la de parámetros requiere cotas de dimensiones. Cada imagen tiene un prompt diferente, así que por lógica hacen falta varias llamadas.
Los 3 verdaderos retos de los sets ecommerce con gpt-image-2
Cuando tienes clara la limitación, te das cuenta de que la dificultad del set no está en «generar varias», sino en estas tres cosas:
- Sujeto coherente: el producto de las 5 imágenes debe ser el mismo, sin que cambien el color, el logo ni la estructura en cada una.
- Estilo coherente: tono de color, iluminación, textura del fondo y estilo tipográfico deben parecer obra del mismo diseñador.
- Reparto de la información: cada imagen cumple una tarea de marketing distinta; no pueden ser 5 imágenes hablando del mismo beneficio.
Estas tres cosas determinan que un set no se resuelve con «lanzarle una frase al modelo»; hay que planificar antes de llamar. La siguiente tabla muestra la composición estándar de un set en las plataformas ecommerce habituales y sirve como punto de partida para la planificación.
| Posición en el set | Uso principal | Proporción recomendada | Densidad de información | ¿Necesita texto? |
|---|---|---|---|---|
| Imagen principal (primera) | Tasa de clics en resultados de búsqueda | 1:1 | Baja, destaca el producto | Opcional, poco texto |
| Imagen con fondo blanco | Normativa de la plataforma, publicidad | 1:1 | Muy baja | No |
| Imagen de beneficios | Comunicar 2-3 beneficios clave | 1:1 o 3:4 | Media | Sí |
| Imagen de escena | Crear ambiente de uso | 1:1 o 4:5 | Media | Opcional |
| Imagen de medidas/parámetros | Reducir consultas y devoluciones | 1:1 | Alta | Sí |
| Imagen larga de página de detalles | Explicar el producto por completo | 9:16 o más | Muy alta | Sí |
🎯 Consejo de planificación: antes de escribir código, define con la tabla de arriba cuántas imágenes necesita tu plataforma y qué tarea cumple cada una. Recomendamos probar primero a mano 2-3 imágenes sueltas con gpt-image-2 en APIYI apiyi.com, confirmar que la fidelidad del producto y el renderizado de texto cumplen lo esperado, y solo entonces pasar al flujo de set por lotes.
Solución 1: gpt-image-2, una sola imagen que concentra múltiples dimensiones de información (imagen larga para página de detalles)
El primer camino es «contar todo un discurso con una sola imagen». gpt-image-2 tiene una gran capacidad de renderizado de texto en chino y de comprensión de maquetación, así que distribuir por zonas la imagen principal, los puntos de venta y la tabla de especificaciones dentro de una única imagen vertical grande es totalmente viable. Para necesidades como imágenes largas de página de detalles, imágenes que agrupan puntos de venta o infografías, una sola invocación basta para obtener una pieza final con muchísima información.
La mayor ventaja de este camino es que no arrastra problemas de consistencia por naturaleza. Todo el contenido se genera de una vez en la misma imagen, el tono y el estilo quedan uniformes de forma natural y no hace falta código extra de orquestación. El inconveniente es que el espacio de una sola imagen es limitado: cuando hay demasiado contenido, el texto se hace más pequeño y se aprieta, y además no se puede separar en imágenes principales independientes para publicarlas.
Cómo escribir la indicación por zonas para una imagen larga de detalles con gpt-image-2
La clave de una sola imagen con múltiples dimensiones es describir por zonas. No escribas un párrafo largo mezclando todo; sigue el orden de la maquetación de arriba abajo y dile al modelo qué va en cada área. Abajo tienes un ejemplo de estructura de indicación para una imagen larga de detalles de un termo:
竖版 9:16 电商详情页长图,整体风格:简约北欧风,米白色背景,柔和自然光。
【顶部区域】产品主视觉:一只哑光墨绿色保温杯斜 45 度放置,标题文字“24 小时长效保温”。
【中部区域】三栏卖点,每栏一个线性图标加短文案:“316 不锈钢内胆”“一键弹盖单手开”“500ml 大容量”。
【底部区域】参数表格:容量 500ml、重量 320g、高度 22cm、材质 316 不锈钢。
所有文字使用清晰的无衬线中文字体,不要出现多余文字。
En cuanto a las dimensiones, para imágenes largas conviene el formato vertical 9:16, por ejemplo 1152x2048 del nivel 2K. Si necesitas material final con más resolución, puedes usar 2160x3840 del nivel 4K.
La solución de una sola imagen requiere solo 1 invocación, es la de menor coste y el estilo queda uniforme por naturaleza; el precio es que la capacidad de información es limitada: con más de 5 bloques el texto tiende a amontonarse y tampoco se puede separar para usarla sola como imagen principal de búsqueda. Encaja especialmente en páginas de detalles y colecciones de puntos de venta de productos estándar con muchas especificaciones, como electrodomésticos, accesorios digitales y artículos de uso diario.
💡 Consejo práctico: cuando hay más de 5 zonas, la tasa de errores de renderizado de texto sube de forma notable. Recomiendo dividir la imagen larga en 2-3 «imágenes de media pantalla» generadas por separado y luego unirlas verticalmente en la página de detalles. Esas medias pantallas ya son en sí un pequeño conjunto de imágenes, así que la transición a la solución 2 sale natural.
Solución 2: descomposición con un modelo de texto + varias invocaciones de gpt-image-2 para generar un conjunto de imágenes de e-commerce
Si lo que quieres es un conjunto real de varias imágenes (imagen principal, imagen de puntos de venta e imagen de escena, cada una independiente), necesitas una pequeña cadena de producción. La idea es dejar «entender la necesidad y planificar el guion gráfico» al modelo de texto y «producir las imágenes» a gpt-image-2, conectando ambos con un JSON estructurado.
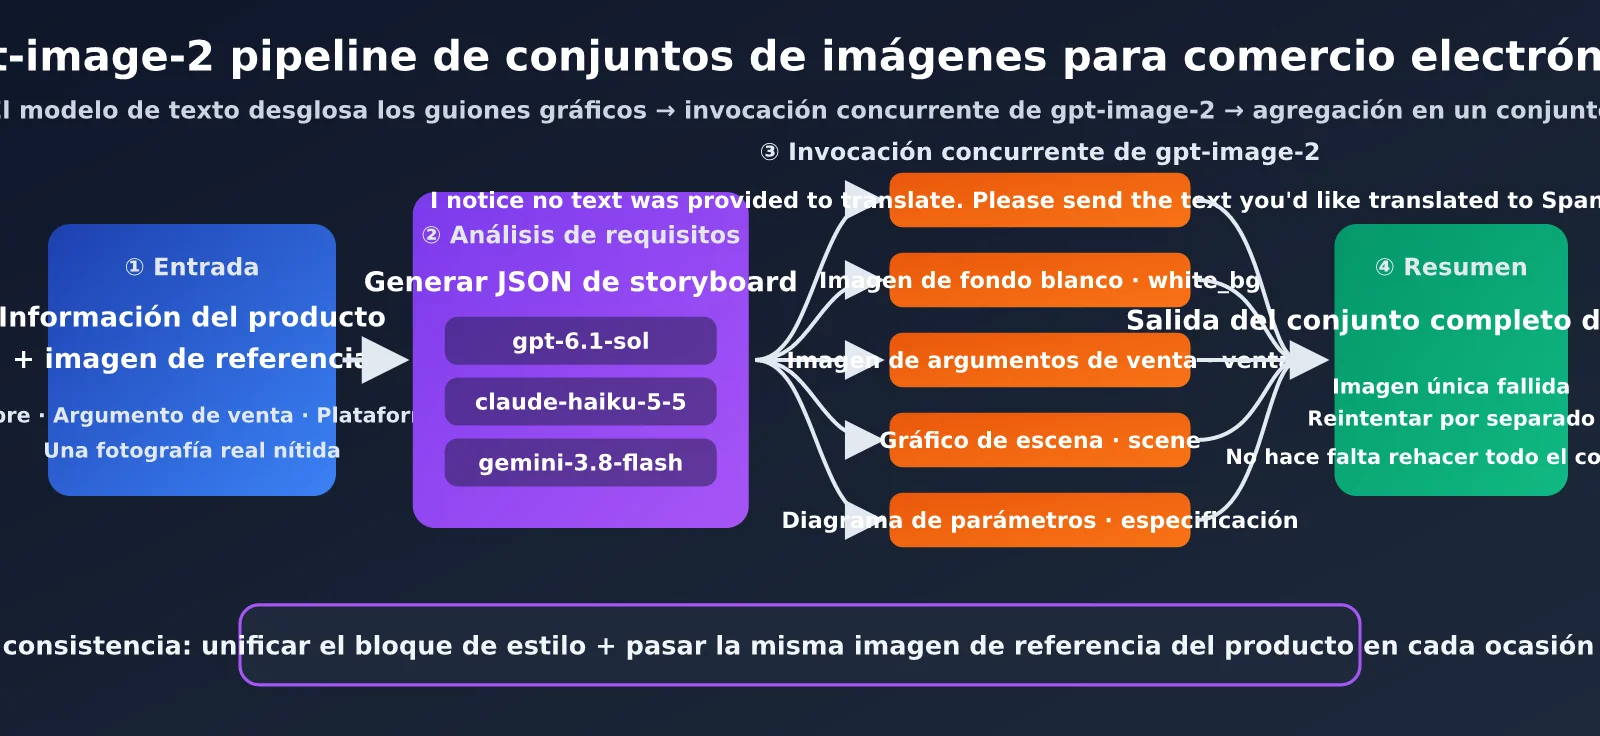
El flujo completo tiene 4 pasos:
- Entrada: el comerciante aporta el nombre del producto, los puntos de venta, la plataforma objetivo y al menos una foto nítida del producto real.
- Análisis de la necesidad: el modelo de texto genera, a partir de la entrada, un array JSON en el que cada elemento es el guion de una imagen: uso, indicación, tamaño y textos.
- Generación en paralelo: el programa recorre el array de guiones y llama una vez a gpt-image-2 por cada guion, llevando siempre la misma imagen de referencia del producto.
- Recopilación y verificación: se recogen todos los resultados, las imágenes fallidas se reintentan una a una y al final se entrega el conjunto completo en orden.
Cómo elegir el modelo de texto: el «cerebro» del conjunto generado con gpt-image-2
Lo que el paso de análisis de la necesidad exige al modelo de texto es: entender la lógica del marketing de e-commerce, producir JSON de forma estable y escribir indicaciones con mucha fuerza visual. Hoy varios de los modelos más recientes disponibles en APIYI están a la altura:
| Modelo | Posicionamiento | Escenario adecuado | Razón para elegirlo |
|---|---|---|---|
| gpt-6.1-sol | Recomendación insignia | Productos de ticket alto, extracción de puntos de venta complejos | La mejor calidad en copy de marketing y planificación de guiones |
| claude-haiku-5-5 | Bajo coste y alta velocidad | SKU masivos, categorías estandarizadas | Sigue instrucciones de forma estable y el JSON sale ordenado |
| gemini-3.8-flash | Bajo coste y alta velocidad | Grandes volúmenes, productos transfronterizos multilingües | Rápido y económico, textos multilingües naturales |
El análisis de la necesidad se invoca una sola vez por conjunto, así que el consumo de tokens es mínimo: el coste está casi todo en generar las imágenes. Recomiendo ajustar primero la plantilla de indicaciones con gpt-6.1-sol hasta quedar satisfecho y, cuando pases a producción masiva, cambiar a claude-haiku-5-5 o gemini-3.8-flash para reducir costes. Los tres modelos usan la interfaz compatible con OpenAI en APIYI apiyi.com, así que para cambiar solo tienes que modificar el parámetro model.
Diseño del JSON de guiones para un conjunto de e-commerce con gpt-image-2
Que el modelo de texto devuelva un JSON con estructura fija es la clave para que toda la cadena funcione de forma estable. Este es el diseño de campos recomendado:
| Campo | Tipo | Descripción | Ejemplo |
|---|---|---|---|
scene |
string | Identificador de la posición dentro del conjunto | main / white_bg / selling |
purpose |
string | La tarea de marketing de esta imagen | Destacar el aspecto del producto y mejorar el CTR |
prompt |
string | Indicación completa para gpt-image-2 | Termo verde mate sobre una mesa de madera… |
size |
string | Tamaño de salida | 2048x2048 |
text_overlay |
string | Texto que debe renderizarse en la imagen | 24 horas de conservación del calor |
Código mínimo para un conjunto de imágenes con gpt-image-2
Esta es la versión mínima ejecutable: primero el modelo de texto genera los guiones y luego se llama uno a uno al endpoint edits de gpt-image-2 (con la imagen de referencia del producto).
import json, base64
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

plan = client.chat.completions.create(
    model="gpt-6.1-sol",
    response_format={"type": "json_object"},
    messages=[{"role": "user", "content": "为墨绿色 316 保温杯规划 5 张淘宝套图,输出 {\"shots\": [...]},"
               "每项含 scene/purpose/prompt/size/text_overlay,统一风格:北欧简约、米白背景、柔和自然光"}],
)
shots = json.loads(plan.choices[0].message.content)["shots"]

for s in shots:
    img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                             prompt=s["prompt"], size=s["size"])
    open(f"{s['scene']}.png", "wb").write(base64.b64decode(img.data[0].b64_json))
Este código se ejecuta en serie, así que las 5 imágenes se esperan una tras otra; en la siguiente sección lo convertiremos en una versión concurrente.
Cómo mantener la coherencia de estilo en un conjunto de e-commerce con gpt-image-2
El problema más habitual al hacer varias invocaciones es que las 5 imágenes parezcan de 5 tiendas distintas. Combinando estos trucos puedes llevar la coherencia a un nivel comercialmente usable:
- Bloque de estilo unificado (style block): escribe el tono de color, la luz, el fondo y el lenguaje de cámara como un texto fijo y pégalo al final de la indicación de cada guion. No dejes que el modelo de texto improvise la descripción de estilo en cada imagen.
- Imagen de referencia del producto fija: en cada invocación pasa la misma foto del producto real a través del endpoint edits y especifica claramente en la indicación «mantén sin cambios el color, el logo y la estructura del producto de la imagen de referencia». Es el método más eficaz para garantizar la coherencia del sujeto.
- Parámetros fijos: usa el mismo nivel de
qualityen todo el conjunto y cambia el tamaño solo cuando sea necesario (por ejemplo, formato vertical para imágenes largas). - Usa el parámetro n para elegir lo mejor: en posiciones críticas como la imagen principal puedes poner
n=2on=3para generar varias variantes y escoger a mano la mejor. Este es justamente el uso correcto del parámetro n.
🎯 Consejo de coherencia: el style block es la «norma de marca» de todo el conjunto; conviene tener una plantilla fija por tienda. Cuando llames a gpt-image-2 a través de APIYI apiyi.com, puedes guardar el style block en un archivo de configuración, compartirlo entre todos los SKU y actualizarlo de una vez al cambiar de temporada.
Invocación concurrente de sets de imágenes de e-commerce con gpt-image-2: cómo acelerar y escalar
Si generas un set de 5 imágenes en serie, el tiempo de espera es la suma del tiempo de cada imagen: cuantas más imágenes, más lento. Y como cada toma del guion visual no depende de las demás, puedes lanzarlas perfectamente en paralelo y hacer que el tiempo total del set se acerque al de «la imagen más lenta».
APIYI no impone ningún límite de concurrencia en las invocaciones de gpt-image-2: por debajo de 500 RPM puedes usarlo directamente, sin solicitudes adicionales. Para la gran mayoría de comercios, incluso ejecutando en paralelo sets de imágenes de decenas de SKU, ni de lejos se llega a ese volumen.
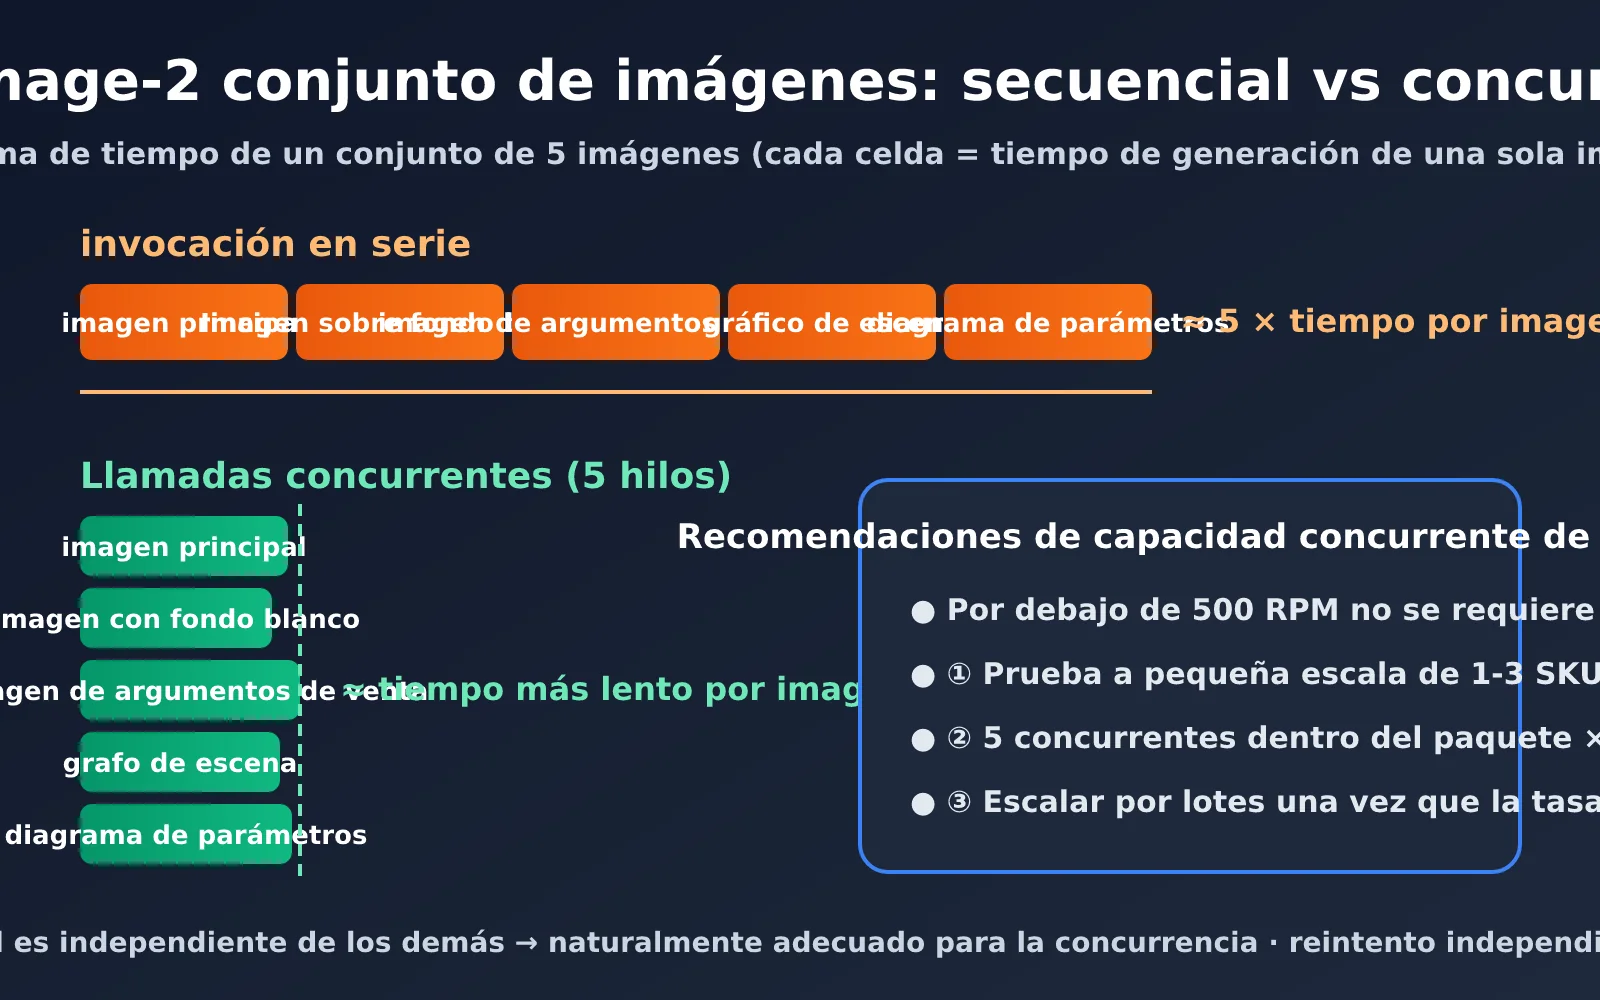
Código concurrente para sets de imágenes con gpt-image-2
Sustituye el bucle en serie de arriba por un pool de hilos y ya tienes generación concurrente. Añade además reintentos ante fallos para que una imagen que se rompa no te obligue a rehacer el set completo:
from concurrent.futures import ThreadPoolExecutor

def gen_one(s, retries=2):
    for i in range(retries + 1):
        try:
            img = client.images.edit(model="gpt-image-2", image=open("cup.png", "rb"),
                                     prompt=s["prompt"] + STYLE_BLOCK, size=s["size"])
            return s["scene"], img.data[0].b64_json
        except Exception as e:
            if i == retries:
                return s["scene"], None

with ThreadPoolExecutor(max_workers=5) as pool:
    results = dict(pool.map(gen_one, shots))
failed = [k for k, v in results.items() if v is None]
Ver el código completo (con style block, lotes multi-SKU, regeneración de fallos y guardado de resultados)
import json, base64, time
from pathlib import Path
from concurrent.futures import ThreadPoolExecutor
from openai import OpenAI

client = OpenAI(api_key="YOUR_APIYI_KEY", base_url="https://api.apiyi.com/v1")

STYLE_BLOCK = (
    "Estilo general: minimalismo nórdico, fondo blanco crudo, luz natural suave, "
    "paleta de baja saturación. Mantén exactamente el color, el logo y la estructura "
    "del producto de la imagen de referencia; el texto va en una tipografía sans serif clara."
)

PLAN_PROMPT = """Eres un planificador visual sénior de e-commerce. A partir de la siguiente información del producto, planifica un set de {count} imágenes para {platform}.
Información del producto: {product}
Devuelve JSON: {{"shots": [{{"scene": "...", "purpose": "...", "prompt": "...",
"size": "2048x2048", "text_overlay": "..."}}]}}
Requisitos: cada imagen asume una tarea de marketing distinta; el prompt describe solo el contenido de la escena, no el estilo general;
si hace falta texto, escribe el texto literal dentro del prompt y entre comillas."""


def plan_shots(product: str, platform: str = "Taobao", count: int = 5,
               model: str = "gpt-6.1-sol") -> list:
    """Divide el guion visual con un modelo de texto; en lotes puedes cambiar a claude-haiku-5-5 / gemini-3.8-flash"""
    resp = client.chat.completions.create(
        model=model,
        response_format={"type": "json_object"},
        messages=[{"role": "user", "content": PLAN_PROMPT.format(
            count=count, platform=platform, product=product)}],
    )
    return json.loads(resp.choices[0].message.content)["shots"]


def gen_one(shot: dict, ref_image: str, retries: int = 2):
    """Genera una imagen; si falla, reintenta con backoff exponencial"""
    for attempt in range(retries + 1):
        try:
            with open(ref_image, "rb") as f:
                img = client.images.edit(
                    model="gpt-image-2",
                    image=f,
                    prompt=shot["prompt"] + STYLE_BLOCK,
                    size=shot.get("size", "2048x2048"),
                )
            return shot["scene"], img.data[0].b64_json
        except Exception as e:
            print(f"[{shot['scene']}] Intento {attempt + 1} fallido: {e}")
            time.sleep(2 ** attempt)
    return shot["scene"], None


def gen_image_set(sku: str, product: str, ref_image: str, workers: int = 5):
    shots = plan_shots(product)
    out_dir = Path("output") / sku
    out_dir.mkdir(parents=True, exist_ok=True)
    (out_dir / "plan.json").write_text(json.dumps(shots, ensure_ascii=False, indent=2))

    with ThreadPoolExecutor(max_workers=workers) as pool:
        results = dict(pool.map(lambda s: gen_one(s, ref_image), shots))

    # Una ronda extra para las imágenes que fallaron
    failed = [s for s in shots if results.get(s["scene"]) is None]
    for s in failed:
        results[s["scene"]] = gen_one(s, ref_image, retries=3)[1]

    for scene, b64 in results.items():
        if b64:
            (out_dir / f"{scene}.png").write_bytes(base64.b64decode(b64))
    print(f"{sku}: correctas {sum(1 for v in results.values() if v)}/{len(shots)} imágenes")


if __name__ == "__main__":
    gen_image_set(
        sku="cup-green-500",
        product="Termo de acero inoxidable 316 verde botella, 500 ml, mantiene el calor 24 h, tapa con apertura de un botón",
        ref_image="cup.png",
    )
Las 3 fases para escalar la concurrencia
Aunque no hay límite de concurrencia, seguimos recomendando escalar por fases: primero validar los resultados y luego ampliar, para no acabar generando cientos de imágenes inservibles de golpe:
- Prueba a pequeña escala: elige 1-3 SKU y ejecútalos en serie o con poca concurrencia. Revisa a mano la fidelidad del producto, la tasa de acierto del texto y la consistencia de estilo.
- Concurrencia media: cuando el resultado sea estable, sube a 5 concurrentes por set y 5-10 SKU a la vez, y vigila la tasa de fallos y el tiempo medio.
- Escalado masivo: con la tasa de fallos bajo control, sube la concurrencia según tu volumen de negocio. Por debajo de 500 RPM puedes ejecutar directamente.
| Modo de invocación | Tiempo de un set de 5 | Estabilidad | Fase recomendada |
|---|---|---|---|
| Llamadas en serie | ~5 veces el tiempo de una imagen | Lo más estable, fácil de depurar | Ajuste de indicaciones |
| Concurrencia dentro del set (5 hilos) | Aprox. el de la imagen más lenta | Estable | Lanzamientos diarios |
| Multi-SKU + concurrencia interna | Similar a un solo set | Requiere reintentos | Lanzamientos masivos en campaña |
🚀 Consejo para escalar: si tu caso es lanzar muchos productos justo antes de una gran campaña, te recomendamos usar el modo «multi-SKU + concurrencia dentro del set» a través de APIYI (apiyi.com). La plataforma no requiere ninguna solicitud por debajo de 500 RPM y, junto con el mecanismo de regeneración de imágenes fallidas, puedes completar los sets de decenas de SKU en muy poco tiempo.
Cómo elegir el conjunto de imágenes de e-commerce con gpt-image-2
Las dos opciones no son excluyentes; en la práctica se combinan con frecuencia. Estas son las recomendaciones según las plataformas y escenarios más habituales:
| Plataforma/escenario | Opción recomendada | Cantidad sugerida | Descripción |
|---|---|---|---|
| Imagen principal de Taobao/Tmall | Opción 2 | 5 imágenes | Una para imagen principal, fondo blanco, puntos de venta, escena y parámetros |
| Página de detalles de Taobao/Pinduoduo | Opción 1 + Opción 2 | 3-6 imágenes de media pantalla | Generar por secciones y unirlas verticalmente |
| Listing de Amazon | Opción 2 | 7 imágenes | La imagen principal con fondo blanco debe cumplir estrictamente la normativa; las demás para puntos de venta y escenas |
| Página de producto de tienda independiente | Opción 2 | 4-6 imágenes | Las imágenes de escena tienen más peso; destacar la personalidad de marca |
| Recomendaciones en Xiaohongshu | Opción 2 | 3-6 imágenes | Formato vertical 3:4, principalmente escenas cotidianas |
| Póster de campaña / recopilación de puntos de venta | Opción 1 | 1 imagen | La información se concentra en una sola imagen; alta eficiencia de difusión |
El principio central para elegir es simple: las imágenes que necesitan publicarse o mostrarse de forma independiente usan la Opción 2; el contenido que se lee de forma continua en una sola página usa la Opción 1. Si tienes dudas, primero usa la Opción 2 para generar la imagen principal y las imágenes de escena, y luego usa la Opción 1 para una imagen larga con la recopilación de puntos de venta; así cubres más.
💡 Consejo de combinación: ambas opciones usan el mismo modelo gpt-image-2 y la misma clave API. Recomendamos encapsular los dos flujos en un solo servicio y elegir la opción automáticamente según el tipo de producto; el comerciante solo necesita subir una foto del producto y unas líneas de puntos de venta.
Preguntas frecuentes
¿El parámetro n de gpt-image-2 permite generar directamente un conjunto de imágenes para e-commerce?
No. La familia oficial gpt-image-2 y 2.5 admite el parámetro n, y APIYI también lo admite, pero lo que hace es generar n variantes con la misma indicación. Cada imagen del conjunto tiene contenido distinto y requiere una indicación diferente, así que hay que hacer varias llamadas. n es más útil para elegir la mejor variante en posiciones clave, como la imagen principal.
¿Qué hacer si el producto se ve diferente en las distintas imágenes generadas?
Este es el problema más común en los conjuntos de imágenes. La práctica más eficaz es usar siempre la interfaz edits en cada llamada, pasando la misma foto real del producto, y especificar en la indicación «mantener sin cambios el color, el logo y la estructura del producto en la imagen de referencia». Además, fija la descripción de estilo en un style block y no dejes que el modelo de texto improvise. Para la imagen de referencia, se recomienda una foto real con fondo limpio e iluminación uniforme; así se obtiene el mejor resultado.
¿Cómo manejar los errores de renderizado de texto en chino en las imágenes?
La capacidad de gpt-image-2 para renderizar chino ya es bastante buena, pero cuantas más palabras, mayor es la probabilidad de error. Se recomienda limitar el texto de cada imagen a 2-3 frases cortas y marcar el texto original entre comillas en la indicación. Si el texto de una imagen sale mal, basta con regenerar esa imagen; no hace falta rehacer todo el conjunto.
¿Qué modelo conviene más para desglosar el texto?
Para depurar la plantilla de indicaciones, usa gpt-6.1-sol: ofrece la mejor calidad de planificación. Cuando la plantilla esté estable y vayas a producir en lote, puedes cambiar a claude-haiku-5-5 o gemini-3.8-flash: menor coste y más velocidad. Este paso se ejecuta una sola vez por conjunto de imágenes, así que el gasto es muy inferior al de la generación de imágenes. Los tres modelos se pueden invocar con la misma clave API en APIYI apiyi.com.
¿Hay que solicitar cuota para llamadas concurrentes?
No. APIYI no ha fijado un límite de concurrencia para gpt-image-2; puedes usarlo directamente por debajo de 500 RPM. Recomendamos probar primero con 1-3 SKU a pequeña escala y, cuando confirmes los resultados, aumentar gradualmente la concurrencia y el volumen.
Resumen
Para generar conjuntos de imágenes para e-commerce con gpt-image-2, la clave está en entender su característica de interfaz: «una llamada, una indicación». El parámetro n resuelve el problema de elegir la mejor opción, pero un conjunto de imágenes requiere varias llamadas con indicaciones distintas. Bajo esta premisa, los contenidos de lectura continua —como las páginas de detalle o las recopilaciones de puntos de venta— pueden generarse de una sola vez con el enfoque de una sola imagen con múltiples dimensiones; mientras que los conjuntos que necesitan exhibirse de forma independiente —como la imagen principal o las imágenes de escena— se completan en lote con una tubería de desglose mediante modelo de texto + llamadas concurrentes.
El núcleo común de ambas rutas es el control de consistencia: un bloque de estilo (style block) fijo junto con la misma imagen de referencia del producto es la clave para que varias imágenes parezcan salidas del mismo equipo de diseño. En cuanto a la concurrencia, por debajo de 500 RPM se puede escalar directamente; lo más seguro es avanzar en tres pasos: «prueba a pequeña escala → concurrencia media → escalado por lotes».
Recomendamos completar toda la tubería de una sola vez a través de APIYI apiyi.com: gpt-6.1-sol, claude-haiku-5-5 y gemini-3.8-flash se encargan del desglose de requisitos, gpt-image-2 se encarga de la generación de imágenes, y una sola clave API conecta todas las etapas, lo que permite montar rápidamente tu propio servicio de generación de conjuntos de imágenes para e-commerce.
Autor: APIYI Team | Especializados en compartir conocimiento técnico sobre APIs de Modelos de Lenguaje Grande; para más tutoriales de integración de modelos, visita APIYI apiyi.com