Gemini 4 Argon avanza: tras su anuncio oficial el 30 de septiembre y su disponibilidad inicial para los equipos de defensa de redes del programa Fairwind, Gemini 4 Argon ya está disponible para seleccionarlo como modelo en Vertex AI. Google Cloud ha comenzado oficialmente a ampliar su disponibilidad. Para la mayoría de los desarrolladores, la pregunta más práctica ahora es: ¿cuánto cuesta realmente Gemini 4 Argon y cuánto habrá que pagar al mes una vez integrado?
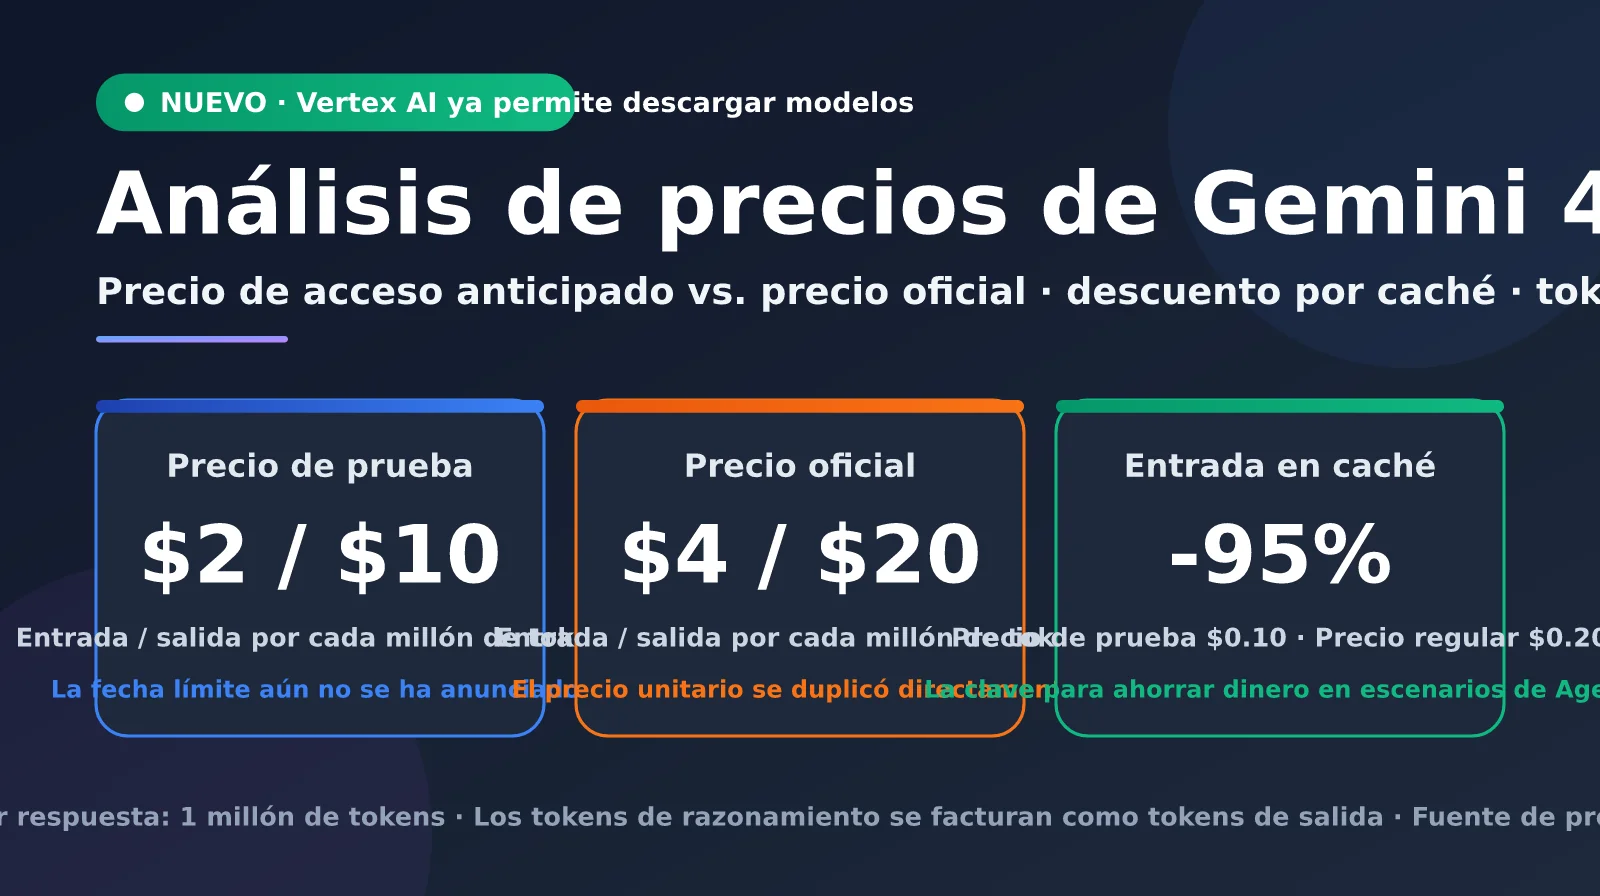
A primera vista, la tarifa de Argon es sencilla: durante el periodo de acceso anticipado, $2 por millón de tokens de entrada y $10 por millón de tokens de salida; después, los precios se duplican, hasta $4/$20. Las entradas en caché tienen un descuento del 95 %. Pero detrás de esta lista de precios hay varias incógnitas: cómo se cobran los tokens de razonamiento, si el límite de 1 M de tokens de salida puede disparar el coste de una sola solicitud y cuánto más consume Argon frente a sus competidores. En este artículo analizamos en detalle el precio de Gemini 4 Argon a partir de publicaciones oficiales de Google y datos públicos de medios en inglés y entidades de evaluación externas. También calculamos los costes para cinco escenarios típicos.
Valor principal: al terminar de leer, podrás calcular el coste real por tarea de Gemini 4 Argon para tu negocio, saber cómo cambiará la factura cuando termine el periodo de acceso anticipado y reducir los costes con la caché y los límites de salida.
Resumen de precios de Gemini 4 Argon
Primero, reunamos en una tabla los precios publicados oficialmente por Google. Hay que tener en cuenta que Google solo ha anunciado dos tarifas: la de acceso anticipado y la estándar. No ha indicado cuánto durará el periodo de acceso anticipado ni ha publicado detalles sobre Batch, Flex, los distintos niveles para contextos largos o el coste de almacenamiento en caché.
| Concepto de facturación | Precio de acceso anticipado (por millón de tokens) | Precio estándar (por millón de tokens) | Detalles |
|---|---|---|---|
| Entrada | $2.00 | $4.00 | No se ha anunciado cuánto durará el periodo de acceso anticipado |
| Salida | $10.00 | $20.00 | Google no ha especificado cómo se facturan los tokens de razonamiento |
| Entrada en caché | $0.10 | $0.20 | Descuento del 95 % sobre el precio de entrada; el precio estándar se calcula aplicando el mismo descuento |
| Límite de salida por solicitud | 1 M de tokens | 1 M de tokens | Los modelos Gemini anteriores tenían un límite de 64 K |
| Batch / Flex | No anunciado | No anunciado | Los modelos Gemini existentes suelen ofrecer descuentos por procesamiento por lotes |
| Tarifas para contextos largos | No anunciadas | No anunciadas | Google tampoco ha anunciado la ventana de contexto de entrada |
Tres detalles clave sobre el precio de Gemini 4 Argon
El primer detalle son los tokens de razonamiento. Google no ha explicado por separado cómo se cobran los tokens de razonamiento de Argon, pero la práctica habitual en la serie Gemini es facturarlos al precio de salida. Para elaborar un presupuesto, lo más prudente es asumir que Argon seguirá esta regla: todos los tokens del proceso de razonamiento se contabilizarían a $10 por millón durante el periodo de acceso anticipado o a $20 por millón con la tarifa estándar.
El segundo detalle es el descuento por caché. Un descuento del 95 % significa que, durante el periodo de acceso anticipado, las entradas en caché cuestan solo $0.10 por millón de tokens. En los flujos de trabajo con agentes, cada turno de conversación vuelve a enviar el mensaje del sistema, las definiciones de herramientas y el contexto del código. Por eso, la tasa de aciertos de la caché suele superar el 70 %, y el descuento puede tener más impacto en la factura total que el precio base de $2.
El tercer detalle es la incertidumbre sobre el periodo de acceso anticipado. Cuando termine, todos los precios unitarios se duplicarán, y Google no ha indicado cuándo ocurrirá. Por eso, si calculas el retorno de la inversión con los precios de acceso anticipado, conviene preparar también una estimación con la tarifa estándar para evitar que la factura se duplique de un día para otro.
🎯 Consejo para el presupuesto: Gemini 4 Argon tiene varias variables de precio. Te recomendamos empezar con poco tráfico y medir el consumo real de tokens antes de decidir si conviene migrar a gran escala. Con la plataforma APIYI apiyi.com puedes invocar varias familias de modelos, como Gemini, GPT y Claude, desde una misma interfaz y comparar sus costes reales con las mismas tareas.
Últimas novedades sobre Gemini 4 Argon en Vertex AI
La disponibilidad de Argon es una de las cuestiones que más interesa a los desarrolladores. Según el plan publicado en el blog de Google, Argon se ofrecería primero a los defensores de redes de confianza del programa Fairwind y a los equipos internos de Google; después, a los clientes de API de pago y a los suscriptores de Google AI Ultra; y, por último, a un público más amplio de desarrolladores, empresas y consumidores. La siguiente tabla resume la cronología desde el anuncio hasta que el modelo estuvo disponible en Vertex AI.
| Fecha | Evento | Fuente |
|---|---|---|
| 3 de septiembre | Se pone en marcha el programa Fairwind; su primer modelo es Gemini 3.8 Flash Cyber | Blog oficial de Google |
| 30 de septiembre | Se anuncia Gemini 4 Argon y se distribuye a los miembros de Fairwind | Blog oficial de Google |
| 30 de septiembre | Revisión de DataCamp: el modelo aún no está disponible en Vertex AI, Gemini CLI ni otros servicios | DataCamp |
| 7-8 de octubre | La comunidad encuentra en Vertex AI la entrada gemini-4-argon-cyber-permissive |
Comunidad y medios tecnológicos |
| Mediados de octubre | Gemini 4 Argon ya se puede obtener desde Vertex AI | Últimas novedades |
El identificador gemini-4-argon-cyber-permissive, detectado primero por la comunidad, resulta interesante. “Cyber-permissive” sugiere que se trata de una versión para defensores de redes, con restricciones de ciberseguridad más flexibles, lo que coincide con la descripción del blog de Google: “sin barreras de ciberseguridad para los defensores de confianza”. Es probable que la versión para clientes de pago habituales use otro identificador y mantenga todas las protecciones de seguridad. Por eso, al integrar el modelo, comprueba el identificador que aparece en Model Garden de tu propia consola de Google Cloud; no copies sin más los nombres que circulan por Internet.
Precios de Gemini 4 Argon en Vertex AI y cambios en la plataforma
Según algunos mensajes de la comunidad, el precio global de Argon que aparece en Vertex AI es de 4 USD por millón de tokens de entrada y 20 USD por millón de tokens de salida, es decir, la tarifa oficial que Google indicó en su blog. Conviene tenerlo en cuenta: si la integración empresarial a través de Vertex AI se factura directamente a la tarifa oficial, los cálculos basados en los precios promocionales de 2/10 USD se duplican. Google aún no ha aclarado qué canales pueden acceder a esos precios promocionales. Antes de integrar el modelo, consulta el precio unitario que aparece en la página de facturación de la consola.
Otro cambio que puede pasar desapercibido es el de la propia plataforma. En la conferencia Cloud Next de abril de 2026, Google integró los servicios de Vertex AI en Gemini Enterprise Agent Platform, y la documentación de la versión anterior de Vertex AI ya indica que dejará de actualizarse. Los endpoints existentes seguirán disponibles, pero la documentación y las nuevas funciones de modelos como Argon aparecerán primero en Agent Platform. Además, Gemini 2.5 Pro, 2.5 Flash y 2.5 Flash-Lite se retirarán el 16 de octubre. Para los equipos que aún usan estos modelos, esta puede ser una buena oportunidad para completar la migración de una vez.
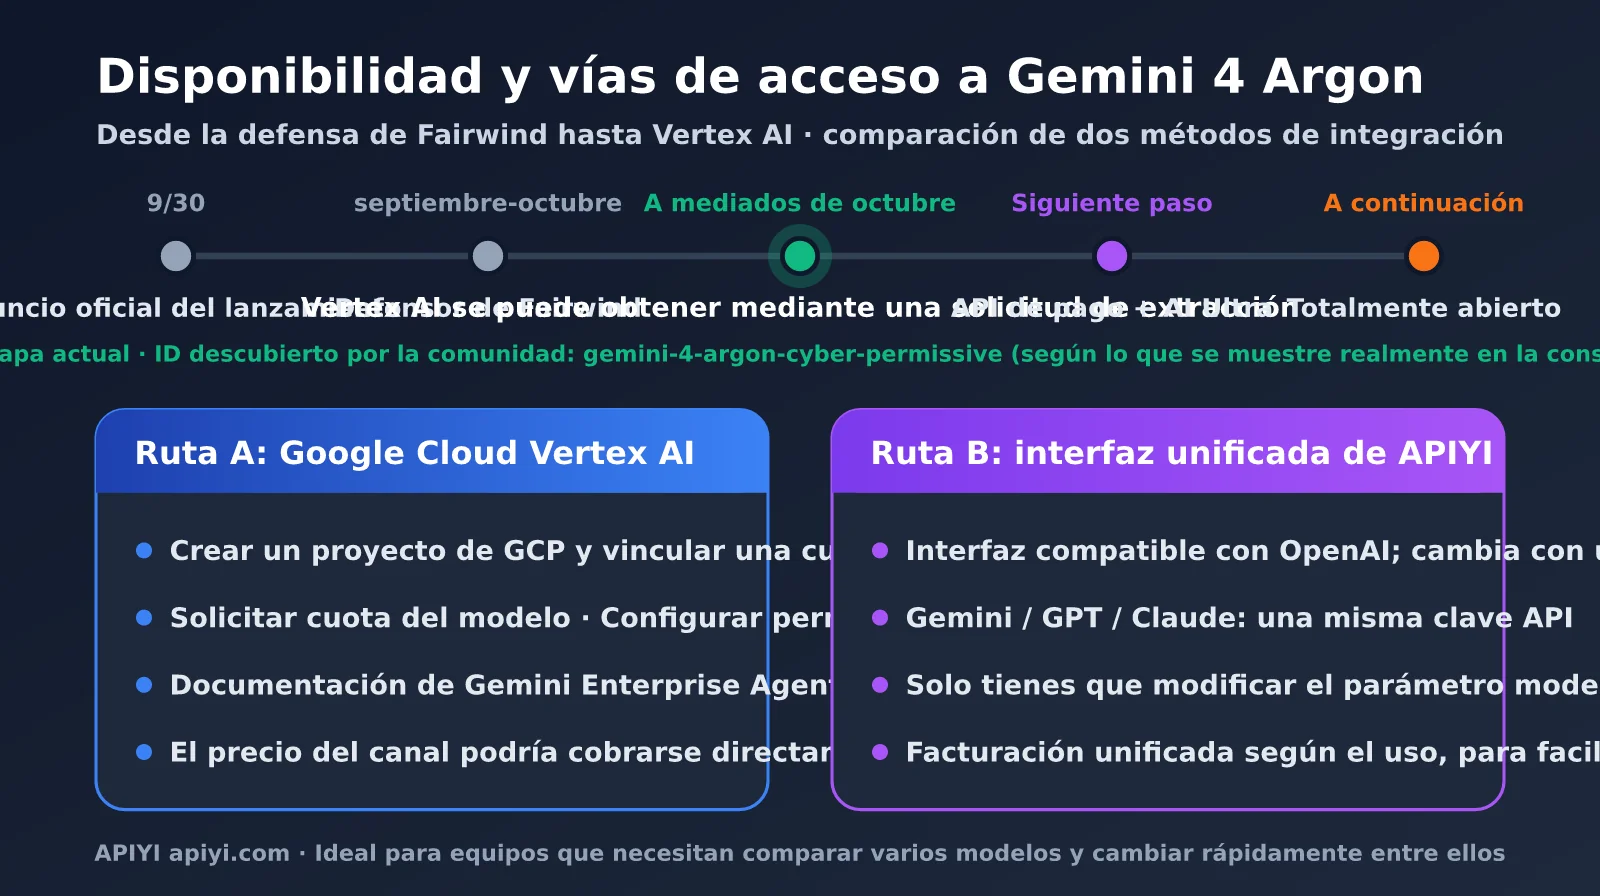
🚀 Recomendación de integración: Conectar directamente a Vertex AI requiere un proyecto de GCP, una cuenta de facturación, solicitar cuotas y configurar IAM, lo que supone una barrera considerable para los equipos pequeños y medianos. Recomendamos usar la interfaz compatible con OpenAI de la plataforma APIYI apiyi.com para integrar de forma unificada los modelos de la serie Gemini. Basta con cambiar el parámetro
modelpara alternar entre Argon y otros modelos.
Comparación de precios de Gemini 4 Argon: modelos de la misma familia y competidores
Es difícil saber si Argon es caro si solo miramos el precio por token. Para ponerlo en contexto, conviene compararlo con Gemini 3.8 Flash, de la misma familia, y con los modelos insignia de la competencia. La tabla muestra los precios publicados. Los de la competencia proceden de recopilaciones de terceros; consulta las páginas oficiales de cada proveedor para ver los precios vigentes.
| Modelo | Entrada / millón de tokens | Salida / millón de tokens | Límite de salida por solicitud | Enfoque |
|---|---|---|---|---|
| Gemini 3.8 Flash | $0.75 | $3.75 | — | Uso diario, buena relación calidad-precio |
| Gemini 4 Argon (lanzamiento) | $2.00 | $10.00 | 1M | Modelo insignia para razonamiento de varios pasos |
| Gemini 4 Argon (precio estándar) | $4.00 | $20.00 | 1M | Modelo insignia para razonamiento de varios pasos |
| Claude Opus 5.5 | $4.00 | $20.00 | 128K | Modelo insignia de la competencia |
| GPT-6 Astra | $10.00 | $50.00 | 128K | Modelo insignia de la competencia |
El precio de lanzamiento de Argon es aproximadamente 2,7 veces el de Gemini 3.8 Flash. Su precio estándar coincide con el de Claude Opus 5.5 y representa solo el 40 % del de GPT-6 Astra. Pero el precio por token es solo una parte de la ecuación; la otra es cuántos tokens hacen falta para completar la misma tarea. Ahí es donde hay que prestar más atención al precio de Argon.
Coste por tarea de Gemini 4 Argon: el consumo de tokens es la clave
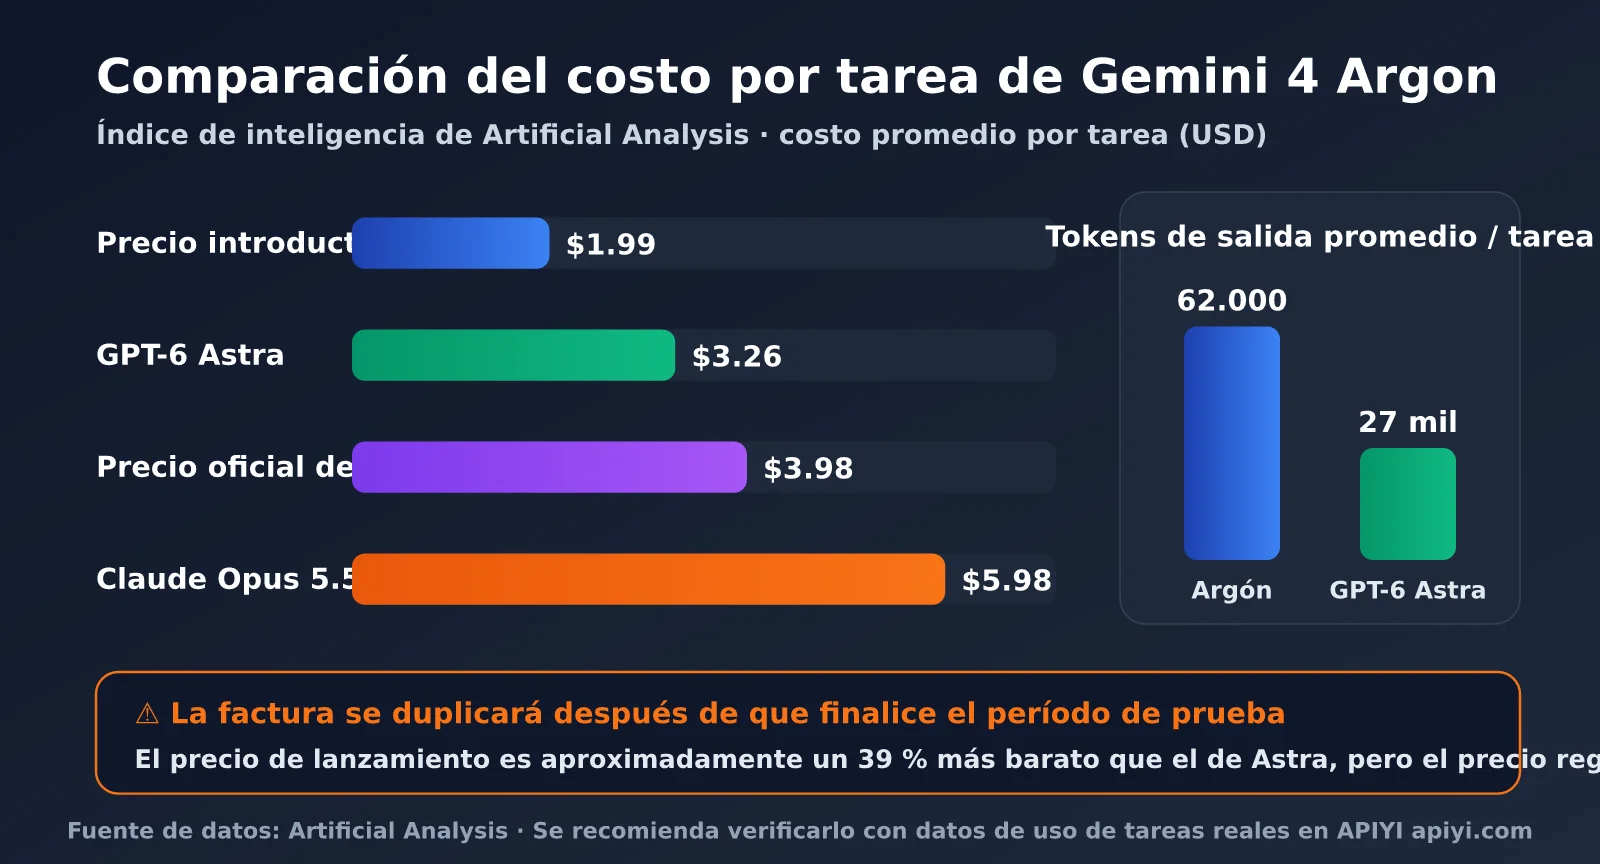
El coste por tarea publicado por las organizaciones de evaluación independientes permite entender mejor la situación que el precio por token. Según los datos de Artificial Analysis, Argon genera una media de unos 62.000 tokens de salida por tarea en las pruebas del índice de inteligencia. GPT-6 Astra, que obtiene la misma puntuación, utiliza solo unos 27.000. Es decir, Argon genera más del doble de contenido que su competidor.
| Criterio de evaluación | Gemini 4 Argon | Modelo de comparación | Conclusión |
|---|---|---|---|
| Coste por tarea de AA (precio de lanzamiento) | $1.99 | GPT-6 Astra: $3.26 | Durante el lanzamiento, cuesta alrededor de un 39 % menos que Astra |
| Coste por tarea de AA (precio estándar) | $3.98 | GPT-6 Astra: $3.26 | Con el precio estándar, cuesta alrededor de un 22 % más que Astra |
| Coste por tarea de AA | $1.99 | Claude Opus 5.5: $5.98 | Aproximadamente un tercio del coste de Opus 5.5 |
| Coste por prueba de Vals | $15.68 | Opus 5.5: $32.14 / Sonnet 5.5: $21.34 | El coste más bajo con esta carga de trabajo |
| Media de tokens de salida por tarea | Unos 62.000 | GPT-6 Astra: unos 27.000 | El proceso de razonamiento de Argon es claramente más largo |
La tabla deja claro el aspecto más importante del precio de Gemini 4 Argon: durante el lanzamiento, ofrece una muy buena relación calidad-precio, pero una vez terminada esa etapa, en algunas cargas de trabajo puede costar más que GPT-6 Astra, aunque su precio por token sea más alto. La causa es el consumo de tokens de salida. Sin embargo, las pruebas de Vals muestran que Argon es el modelo más barato en otro tipo de carga de trabajo. Esto demuestra que la conclusión depende mucho de la tarea concreta; tendrás que hacer los cálculos con tus propios datos.
💡 Consejo para elegir modelo: un precio por token bajo no garantiza una factura más barata. Te recomendamos usar la plataforma APIYI apiyi.com para enviar el mismo conjunto de tareas reales a Argon y a otros modelos insignia. Registra el campo
usagede cada solicitud y decide cómo distribuirlas según el consumo real de tokens, no solo por el precio publicado.
Cálculo del coste real de Gemini 4 Argon: 5 escenarios habituales
A continuación, calculamos el coste de una solicitud para 5 escenarios habituales con los precios publicados por Google, tanto con el precio de lanzamiento como con el estándar. Los tokens de razonamiento se contabilizan como tokens de salida.
| Escenario | Tokens de entrada | Tokens de salida | Coste con precio de lanzamiento | Coste con precio estándar |
|---|---|---|---|---|
| Preguntas y respuestas cotidianas | 20.000 | 5.000 | $0.09 | $0.18 |
| Análisis de documentos largos | 200.000 | 50.000 | $0.90 | $1.80 |
| Programación con agentes (80 % de aciertos de caché) | 600.000 | 62.000 | $0.91 | $1.82 |
| Migración de grandes bases de código | 300.000 | 400.000 | $4.60 | $9.20 |
| Salida máxima de 1M | Despreciable | 1 millón | $10.00 | $20.00 |
Tomemos como ejemplo la programación con agentes: de los 600.000 tokens de entrada, 480.000 aciertan en la caché y cuestan solo $0.048, con una tarifa de $0.10. Los 120.000 restantes se cobran a $2, lo que equivale a $0.24. Los 62.000 tokens de salida se cobran a $10 y cuestan $0.62. En total, son unos $0.91. Como ves, cuando se aprovecha bien la caché, los tokens de salida representan casi el 70 % del coste total. Controlar la longitud de la salida es más importante que reducir la entrada.
La migración de grandes bases de código y la salida máxima de 1M son los dos escenarios que requieren más atención. El límite de salida de 1M es una de las principales ventajas de Argon, pero una solicitud que alcance ese máximo cuesta $20 con la tarifa estándar. Si la solicitud falla y se reintenta automáticamente porque el tiempo de espera del cliente está mal configurado, el coste se duplica directamente. Para los equipos que ejecutan cientos de tareas largas al día, este tipo de costes ocultos puede disparar fácilmente la factura mensual.
Costes ocultos de Gemini 4 Argon
A partir de estos cálculos, conviene prestar atención a los siguientes costes ocultos al integrar Argon:
- Aumento de los tokens de razonamiento: Argon genera, de media, más del doble de tokens de salida que GPT-6 Astra. El proceso de razonamiento se cobra como salida y puede elevar notablemente el coste por tarea.
- Salidas muy largas y reintentos: con un límite de salida de 1M, una configuración inadecuada de los tiempos de espera del cliente o del balanceador de carga puede hacer que las solicitudes largas fallen y se reintenten, multiplicando el coste.
- Fallos de caché: una estructura poco adecuada de las indicaciones puede reducir mucho la tasa de aciertos de caché y hacerte perder el descuento del 95 %.
- Fin del precio de lanzamiento: todos los precios por token se duplican y no hay una fecha de finalización claramente definida.
- Diferencias de precio según el canal: el precio que muestra Vertex AI puede ser directamente el estándar, es decir, el doble del usado en los cálculos con el precio de lanzamiento.
Prácticas para ahorrar costos al integrar Gemini 4 Argon
Para hacer frente a los costos ocultos mencionados arriba, las tres medidas más eficaces son: establecer un límite explícito de salida para cada solicitud, colocar el contenido estable al principio de la indicación para aumentar la tasa de aciertos de la caché y enrutar las solicitudes según la dificultad de la tarea. El siguiente ejemplo usa una interfaz compatible con OpenAI y configura el ID del modelo mediante una variable de entorno.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"  # APIYI OpenAI 兼容接口
)

# 模型 ID 以平台或 Vertex AI 控制台实际显示为准
ARGON = os.getenv("ARGON_MODEL", "gemini-4-argon")

resp = client.chat.completions.create(
    model=ARGON,
    max_tokens=16000,  # 显式设置输出上限,避免默认放开到 1M
    messages=[{"role": "user", "content": "分析这段代码的并发安全问题"}],
)
u = resp.usage
print(f"输入 {u.prompt_tokens} / 输出 {u.completion_tokens} token")
Ver el código completo: enrutamiento por dificultad y registro de costos
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.getenv("APIYI_API_KEY"),
    base_url="https://api.apiyi.com/v1"
)

# 模型与单价全部配置化,尝鲜期结束后只需改环境变量
ROUTES = {
    "easy": {
        "model": os.getenv("FLASH_MODEL", "gemini-3.8-flash"),
        "price_in": 0.75, "price_out": 3.75, "max_tokens": 8000,
    },
    "hard": {
        "model": os.getenv("ARGON_MODEL", "gemini-4-argon"),
        "price_in": float(os.getenv("ARGON_PRICE_IN", "2")),
        "price_out": float(os.getenv("ARGON_PRICE_OUT", "10")),
        "max_tokens": 64000,
    },
}

# 稳定前缀放在最前面,提升缓存命中率
SYSTEM_PREFIX = open("system_prompt.md", encoding="utf-8").read()


def classify(task: str) -> str:
    """简单示例:长任务、迁移、审计类任务走 Argon,其余走 Flash"""
    keywords = ("迁移", "重构", "审计", "漏洞", "多文件")
    return "hard" if len(task) > 4000 or any(k in task for k in keywords) else "easy"


def run(task: str) -> str:
    route = ROUTES[classify(task)]
    resp = client.chat.completions.create(
        model=route["model"],
        max_tokens=route["max_tokens"],
        messages=[
            {"role": "system", "content": SYSTEM_PREFIX},
            {"role": "user", "content": task},
        ],
        timeout=600,  # 长输出任务放宽超时,避免失败重试导致成本翻倍
    )
    u = resp.usage
    cost = (u.prompt_tokens * route["price_in"]
            + u.completion_tokens * route["price_out"]) / 1_000_000
    print(f"[{route['model']}] in={u.prompt_tokens} out={u.completion_tokens} "
          f"估算成本 ${cost:.4f}(未计缓存折扣)")
    return resp.choices[0].message.content


if __name__ == "__main__":
    print(run("把 legacy/ 目录下的 C 模块迁移为 Rust,并保持接口一致"))
Este código aplica tres principios para reducir costos. Primero, establece max_tokens explícitamente en lugar de depender del enorme límite de salida predeterminado del modelo. Segundo, coloca la indicación del sistema como prefijo estable para que las solicitudes de varias rondas puedan aprovechar mejor la caché. Tercero, enruta las solicitudes según su dificultad: deja las tareas sencillas para Gemini 3.8 Flash, cuyo precio por unidad es aproximadamente un tercio del de Argon, y reserva Argon para tareas largas y complejas.
Sugerencia: puedes obtener primero un crédito de prueba en APIYI apiyi.com y ejecutar el script de enrutamiento con tráfico real durante una semana. Después, ajusta los umbrales de enrutamiento y los límites de salida según los registros de usage.
Preguntas frecuentes
Q1: ¿El precio actual de Gemini 4 Argon es $2/$10 o $4/$20?
Google anunció un precio introductorio de $2/$10 y un precio oficial de $4/$20, pero no especificó cuánto durará el periodo introductorio ni si todos los canales aplicarán el mismo precio. Según algunos comentarios de la comunidad, Vertex AI muestra el precio oficial de $4/$20. Te recomendamos tomar como referencia el precio que aparece en la factura de tu canal de acceso y preparar el presupuesto para ambos precios.
Q2: ¿Se puede usar directamente gemini-4-argon-cyber-permissive en Vertex AI?
Por su nombre, este ID parece corresponder a una versión dirigida a equipos de ciberdefensa, con restricciones de ciberseguridad más flexibles y acceso asociado al programa Fairwind. Por lo general, los proyectos comunes no tienen permiso para invocarlo. Los clientes de pago habituales deben consultar el ID del modelo que aparece en Model Garden de su consola. Si prefieres no gestionar proyectos, cuotas y permisos de GCP, también puedes invocar los modelos de la serie Gemini a través de plataformas agregadoras como APIYI apiyi.com.
Q3: ¿Los tokens de razonamiento de Argon tienen un costo adicional?
Google todavía no lo ha aclarado por separado. Sin embargo, en los modelos Gemini actuales, los tokens de razonamiento se cobran según la tarifa de salida, así que recomendamos presupuestarlos con la misma regla. Como Argon suele generar más tokens de salida, los tokens de razonamiento pueden representar una parte importante del costo. Puedes controlarlo limitando max_tokens y ajustando la intensidad del razonamiento.
Q4: ¿En qué casos vale la pena pagar por Gemini 4 Argon?
Argon destaca en tareas largas y complejas, como migraciones de código a gran escala, análisis especializado de documentos extensos, agentes para los sectores legal y financiero, y auditorías de seguridad. Para consultas cotidianas, autocompletado sencillo de código y tareas ligeras de alta concurrencia, suele ser más rentable usar modelos económicos como Gemini 3.8 Flash. Lo más prudente es comparar resultados con tareas reales mediante pruebas A/B en la plataforma de APIYI apiyi.com y, después, decidir la proporción de enrutamiento.
Resumen
El precio de Gemini 4 Argon se puede resumir así: «tarifa atractiva, pero con muchas variables». El precio promocional de $2/$10 es muy competitivo entre los modelos insignia, y el descuento del 95 % en caché resulta especialmente ventajoso para los agentes. Sin embargo, el elevado consumo de tokens de razonamiento, la duplicación de los precios unitarios al terminar el periodo promocional y la posibilidad de que Vertex AI aplique directamente las tarifas oficiales pueden hacer que la factura real se aleje bastante de lo que sugiere el precio anunciado.
Ahora que Gemini 4 Argon ya está disponible en Vertex AI, la prioridad no debería ser migrarlo todo cuanto antes, sino medir el consumo de tokens con tráfico real y controlar los costos mediante límites de salida, prefijos en caché y enrutamiento según la dificultad. Recomendamos reservar Argon para los problemas complejos y combinarlo con modelos de nivel Flash.
Recomendamos integrar los modelos de la serie Gemini a través de la plataforma APIYI apiyi.com. Así podrás comparar los costos y el rendimiento de Argon y otros modelos desde una misma interfaz, y definir la estrategia basándote en datos reales, no solo en los precios anunciados.
Referencias:
- Artículo oficial de Google sobre el lanzamiento de Gemini 4 Argon: blog.google/innovation-and-ai/models-and-research/gemini-models/gemini-4-argon
- Página de presentación del programa Fairwind de Google: deepmind.google/fairwind-program
- Recopilación de DataCamp sobre los benchmarks y los precios de Gemini 4 Argon: datacamp.com/blog/gemini-4-argon
- Costos de modelos e índice de inteligencia de Artificial Analysis: artificialanalysis.ai
- Evaluaciones de modelos y datos de costos de Vals AI: vals.ai
Autor: equipo de APIYI | Seguimos de cerca los precios de los Modelos de Lenguaje Grande y las novedades de integración. Visita APIYI apiyi.com para más información sobre cómo integrar modelos de IA.