Nota del autor: este artículo responde a una pregunta concreta: ¿deepseek-v4-1-flash-economy-261017 es un modelo peor? La conclusión es que no. Usa los mismos pesos que deepseek-v4.1-flash; solo es más lento y más barato.
Después de que DeepSeek V4.1 Flash se dividiera en dos niveles de precios, qué valor poner en el campo model de la solicitud se ha convertido en una decisión ineludible para quienes ya usan este modelo. Este artículo compara deepseek-v4-1-flash-economy-261017 y deepseek-v4.1-flash, y ofrece recomendaciones claras desde cuatro perspectivas: precio, endpoint, grupos y velocidad.
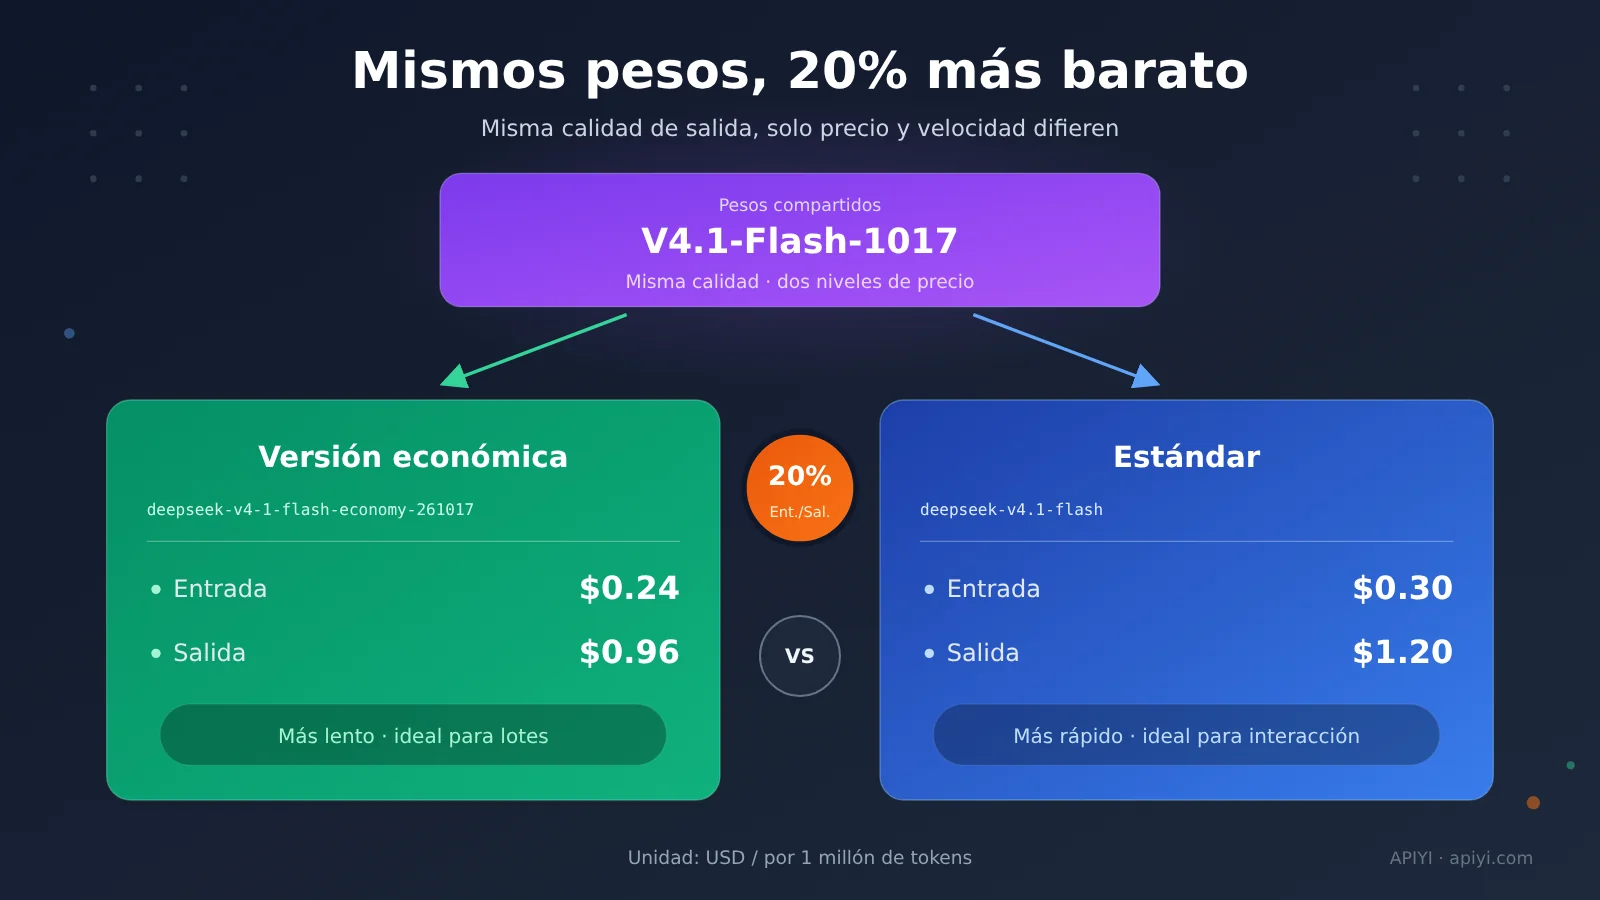
La conclusión, de entrada: la versión económica no es un modelo peor. Ambos ID cargan los mismos pesos V4.1-Flash-1017, y la calidad de salida que declara oficialmente es la misma. Solo hay dos diferencias: genera más lento y el precio unitario de entrada y salida equivale al 80% del de la versión estándar. No se trata de una evaluación de un modelo nuevo ni de una versión recortada, sino de los mismos pesos colocados en dos niveles de precios.
Valor clave: después de leer este artículo, tendrás claro qué ID elegir en escenarios como procesamiento por lotes offline, productos interactivos o flujos de trabajo en formato Anthropic. Ambos modelos ya están disponibles en APIYI (apiyi.com); cambiar de uno a otro solo requiere modificar una cadena.
¿Qué es deepseek-v4-1-flash-economy-261017?
La versión económica se lanzó el 2026-11-11 a las 12:22 (UTC+8), y al momento de revisar este artículo (2026-11-13) apenas habían pasado dos días. Su posicionamiento se puede resumir en una frase: los mismos pesos de V4.1-Flash-1017, precios de entrada y salida más bajos, y una velocidad de generación más lenta. No es una versión destilada ni cuantizada: APIYI, a través del canal oficial de BytePlus, ofrece los pesos completos de 552B, sin cuantización ni destilación, y la facturación se liquida en un solo tramo al precio pico.
Por ahora la versión económica no tiene página de detalles ni página de documentación propias, así que los parámetros clave se toman de la documentación de lanzamiento; los precios se contrastaron tanto con la lista oficial de modelos como con la interfaz de precios de apiyi.com, y ambos coinciden. Para ahorrarte el trabajo de revisar la documentación, primero resumamos lo esencial en una tabla:
| Punto clave | Descripción | Qué significa para ti |
|---|---|---|
| Los mismos pesos | Comparte V4.1-Flash-1017 con deepseek-v4.1-flash |
La calidad de salida es idéntica según lo indicado oficialmente; no hace falta reajustar las indicaciones |
| Entrada y salida con 20% de descuento | Entrada $0.24, salida $0.96 (por cada millón de tokens) | El costo de las tareas por lotes baja directamente un veinte por ciento |
| Generación más lenta | La documentación estima unos 2 segundos hasta el primer token y unos 15 milisegundos por token | Adecuado para procesamiento por lotes offline, no para interacción intensiva |
| Menos endpoints | Solo el endpoint Chat, grupos Default y SVIP | Basta usar la interfaz compatible con OpenAI |
Por qué deepseek-v4-1-flash-economy-261017 merece un ID de modelo propio
Porque lo que se ahorra es costo directo, y no hace falta compensar nada en calidad. En las tareas por lotes, la mayor parte de la factura corresponde a las tarifas de tokens de entrada y salida, y un 20% de descuento significa que con el mismo presupuesto se puede procesar aproximadamente una cuarta parte más de volumen. Como los pesos y la calidad de salida no cambian, el único precio a pagar es la espera, así que la pregunta deja de ser «¿debo cambiar?» y pasa a ser «¿mi tarea puede esperar?»; esa es justo la diferencia que analizaremos en la siguiente sección.
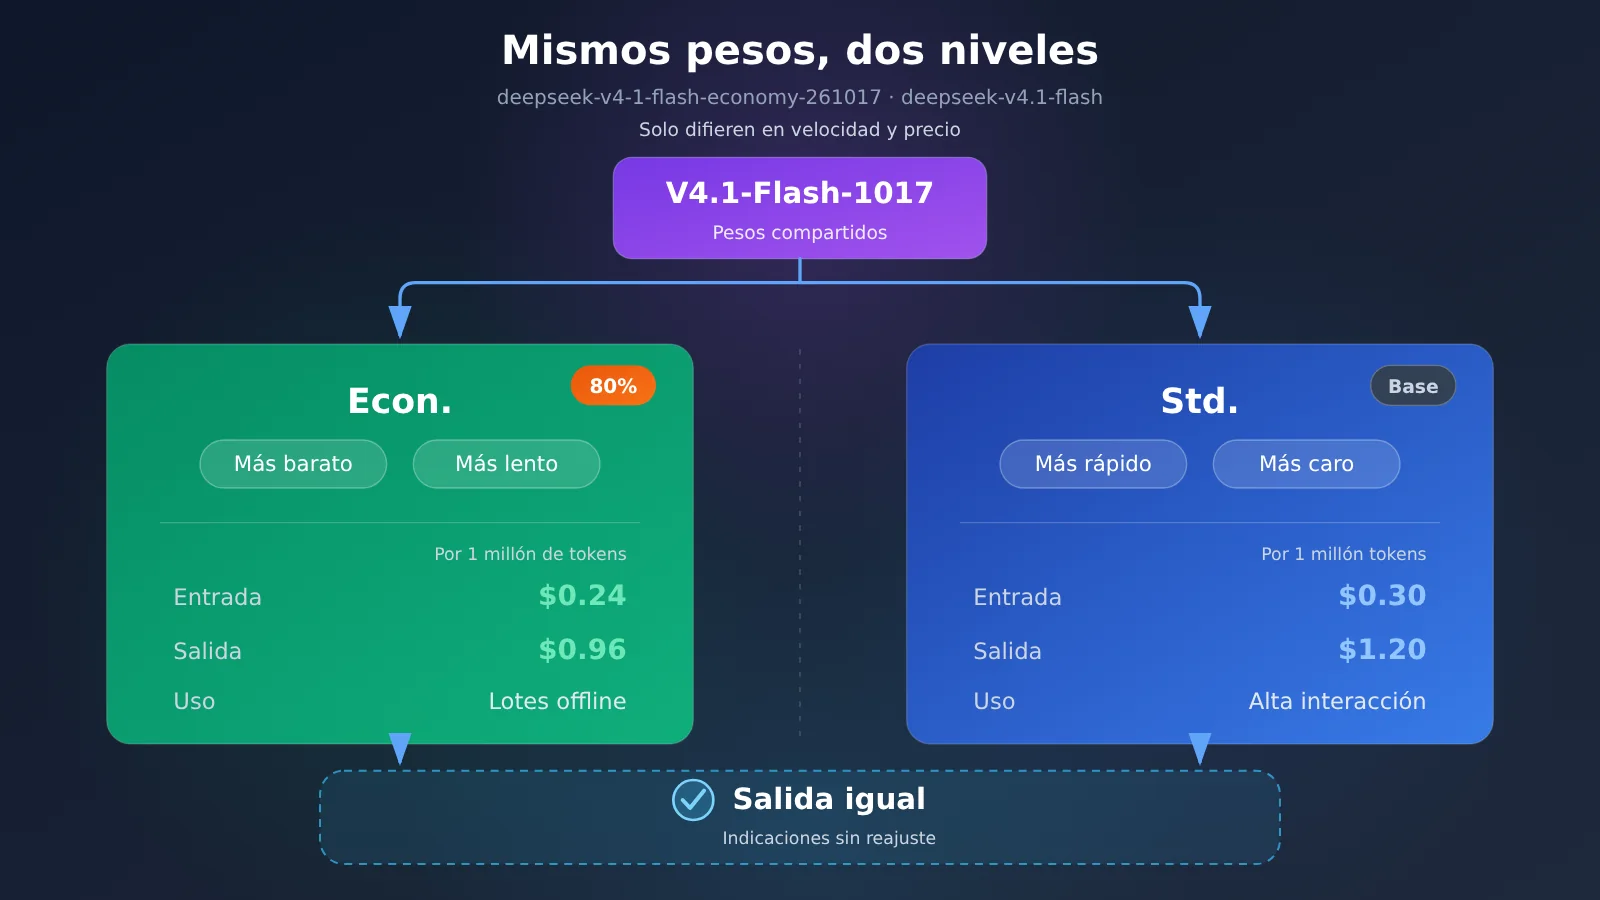
Diferencias clave entre deepseek-v4-1-flash-economy-261017 y deepseek-v4.1-flash
Las diferencias entre las dos versions se concentran en tres puntos: precio, endpoint y agrupación, y velocidad. Los pesos y la calidad no entran en esta lista de diferencias: ambos comparten V4.1-Flash-1017.
Diferencias de precio: entrada y salida con 20 % de descuento, lectura de caché al mismo precio
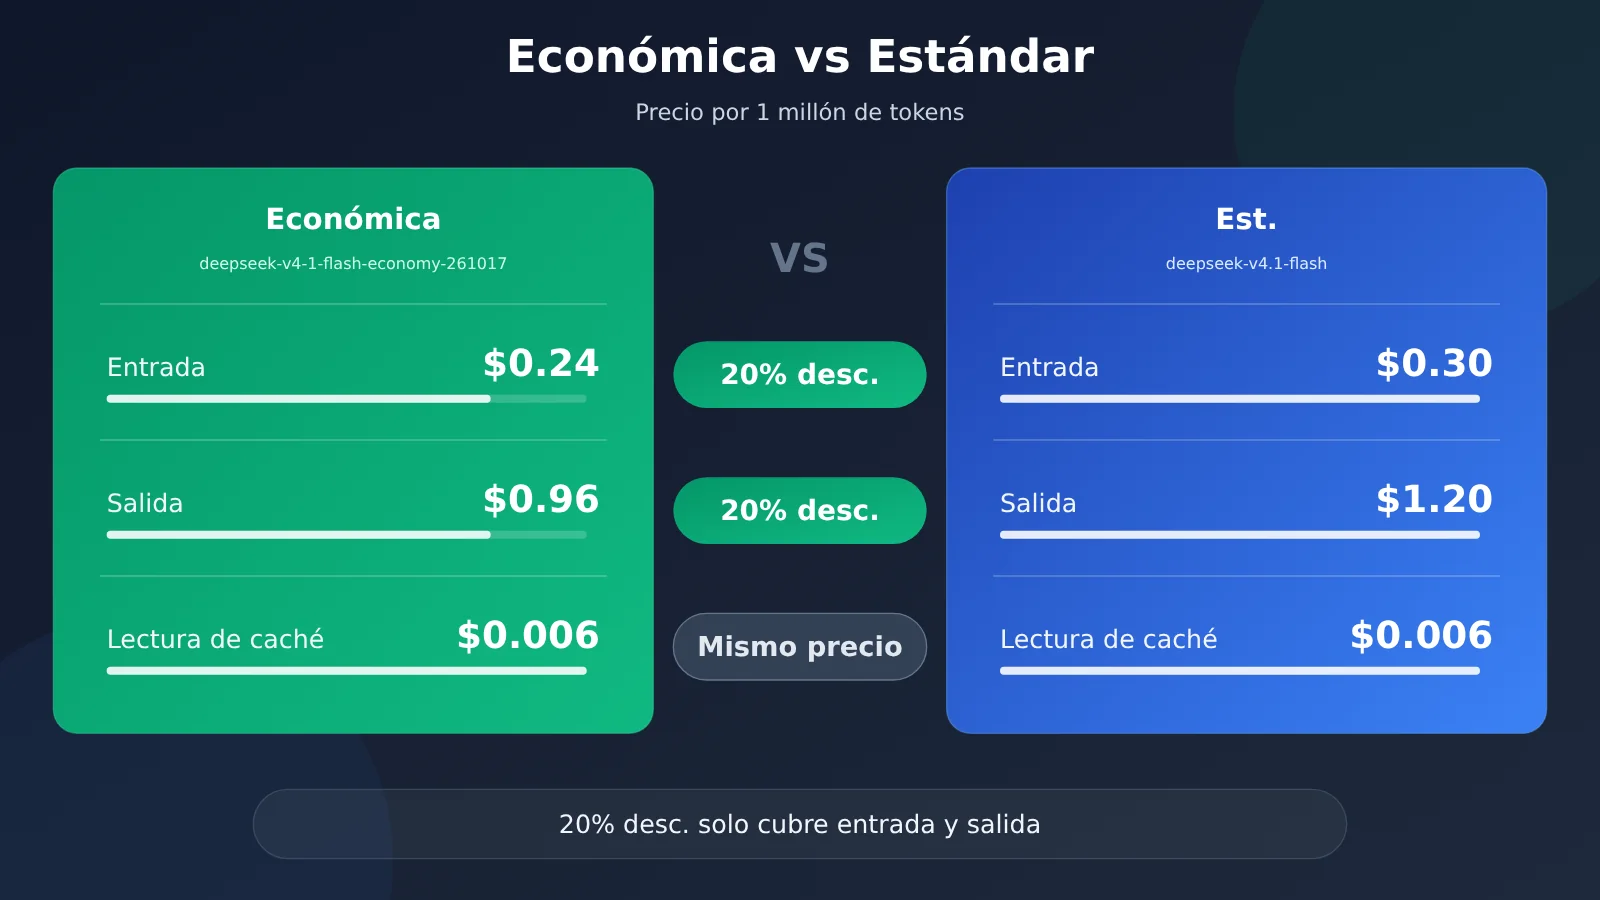
| Concepto de facturación (por 1 millón de tokens) | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash | Descuento |
|---|---|---|---|
| Entrada | $0.24 | $0.30 | 20 % de descuento |
| Salida | $0.96 | $1.20 | 20 % de descuento |
| Lectura de caché | $0.006 | $0.006 | Mismo precio |
0.24 dividido por 0.30 es 0.8, y 0.96 dividido por 1.20 también es 0.8. Por eso, el descuento del 20 % solo aplica a los dos conceptos de facturación de entrada y salida de la versión económica frente a la estándar; la lectura de caché cuesta $0.006 en ambas versions, sin descuento. Si tus tareas tienen una alta tasa de aciertos de caché, este concepto no supone diferencia de precio entre las dos versions y el ahorro global se diluye. A la hora de calcular costes, conviene sacar la lectura de caché y calcularla por separado.
También hay un punto que se presta a confusión y conviene aclarar: este descuento del 20 % es una diferencia fija entre los precios de lista de los dos modelos, no una promoción por tiempo limitado. Los descuentos de cuenta de APIYI funcionan mediante recargas con crédito extra; el crédito de regalo no modifica los precios unitarios de la tabla anterior, y la facturación se realiza según el tramo de precio pico, sin fluctuaciones por promociones.
💰 Consejo de costes: en tareas por lotes, puedes establecer reasoning_effort en none para desactivar el razonamiento y sumar el descuento del 20 % en entrada y salida de la versión económica; así ahorras por partida doble. Si quieres hacer números antes de empezar, puedes comparar los precios unitarios de ambos modelos y simular costes en APIYI apiyi.com.
Diferencia de endpoints: deepseek-v4-1-flash-economy-261017 solo tiene Chat
Esta es la única diferencia crítica entre las dos versiones en cuanto a “si se puede usar”. La versión económica solo expone el endpoint Chat, y sus grupos son únicamente Default y SVIP. La versión estándar, además de Chat, también funciona con el formato Anthropic, y entre sus grupos aparecen ClaudeCode y CodexResponses.
| Dimensión | deepseek-v4-1-flash-economy-261017 | deepseek-v4.1-flash |
|---|---|---|
| Endpoint | Chat | Chat, formato Anthropic |
| Grupos | Default, SVIP | Default, SVIP, ClaudeCode, CodexResponses |
En la práctica, en el flujo de trabajo esto significa lo siguiente: si el cliente construye solicitudes con el formato de mensajes de Anthropic, o si la orquestación se ejecuta dentro de los grupos ClaudeCode y CodexResponses, solo se puede usar deepseek-v4.1-flash; las aplicaciones habituales que utilizan la interfaz compatible con OpenAI pueden elegir cualquiera de las dos versiones. Al invocar, el base_url se escribe de forma uniforme como https://api.apiyi.com/v1, y para cambiar de nivel solo hay que modificar el campo model.
Diferencia de velocidad: deepseek-v4-1-flash-economy-261017 es más lento, pero solo más lento
La estimación de velocidad que aparece en la documentación de lanzamiento indica unos 2 segundos hasta el primer token y unos 15 milisegundos por token. Conviene aclarar que se trata de una estimación recogida en la documentación, no de un ranking de pruebas reales; la experiencia real variará según la longitud de la tarea y el momento del día, así que si vas a usarla para planificación de capacidad, deja margen. En cuanto a la calidad, no hay que preocuparse: la documentación oficial indica que la calidad de salida de ambas versiones es la misma, porque en realidad cargan exactamente el mismo V4.1-Flash-1017.
En otras palabras, no conviene tratar los dos ID como dos modelos distintos al hacer evaluaciones de calidad. Lo único que realmente hay que evaluar es una cosa: si tu tarea puede tolerar una generación más lenta.
Recomendaciones de escenarios para deepseek-v4-1-flash-economy-261017
La lógica de selección en una frase: si no eres sensible a la latencia y usas el endpoint Chat, opta por la versión económica; en caso contrario, usa la versión estándar. A continuación lo desglosamos por escenario.
Cuándo elegir deepseek-v4-1-flash-economy-261017
Adecuado para escenarios donde el precio unitario es lo primero y nadie está esperando frente a la pantalla:
- Procesamiento por lotes offline: resumen de logs, etiquetado de documentos, limpieza de corpus, traducción por lotes; mucho volumen, se puede encolar y reintentar
- Tareas programadas nocturnas: lo acumulado durante el día se ejecuta de noche; 2 segundos hasta el primer token pasan totalmente desapercibidos
- Pasos intermedios sensibles al costo: nodos de pipeline como clasificación, extracción o conversión estructurada, que no necesitan interacción con personas
- Reejecución con prefijos largos: se llama una y otra vez sobre el mismo lote de contexto; la parte que acierta en caché cuesta igual en ambas versiones, y la entrada que no acierta cuesta un 80 % en la versión económica
El procesamiento por lotes trae además un pequeño interruptor que vale la pena recordar: poner reasoning_effort en none desactiva el razonamiento y ahorra tokens de salida. Es algo independiente del descuento del 80 %, pero se pueden combinar.
Cuándo seguir usando deepseek-v4.1-flash
- Productos interactivos: interfaces de chat o tipo Copilot, donde la latencia del primer token afecta directamente la experiencia
- Flujos de trabajo con formato Anthropic fijo: el cliente arma las solicitudes según el protocolo Anthropic, y la versión económica no puede atenderlas
- Grupos ClaudeCode y CodexResponses: la orquestación depende de estos dos grupos, y solo la versión estándar los ofrece
- Prioridad al throughput en línea: preferir un ritmo de generación más rápido aunque cueste más
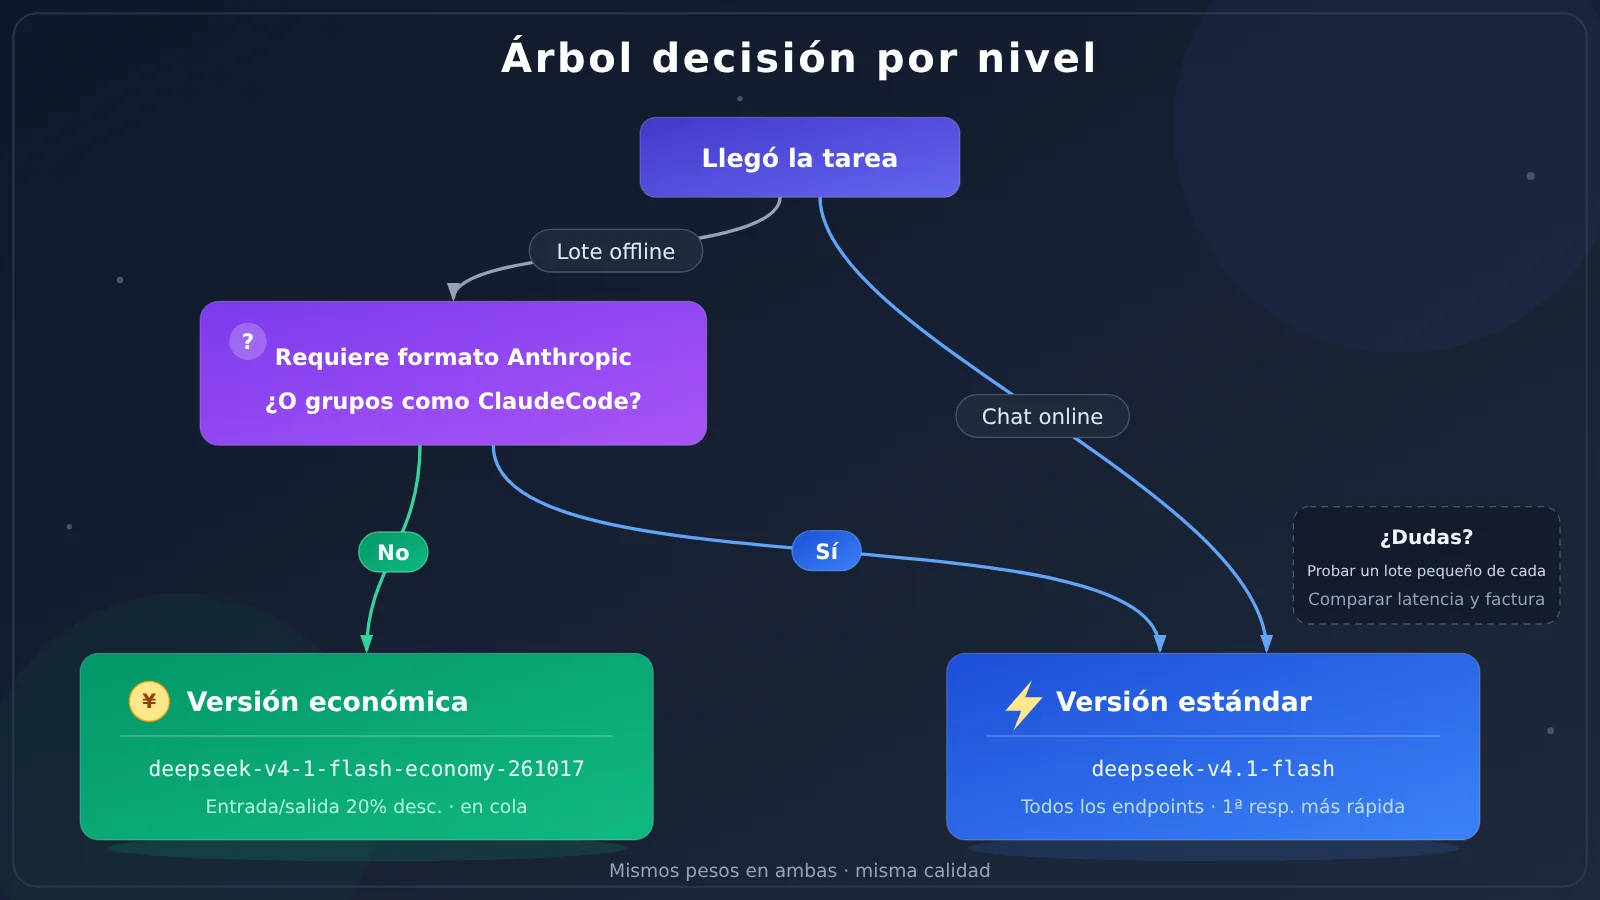
| Tu escenario | Recomendación | Motivo |
|---|---|---|
| Lotes offline, tareas programadas | deepseek-v4-1-flash-economy-261017 |
Entrada y salida al 80 %, latencia imperceptible |
| Interfaces de chat o Copilot | deepseek-v4.1-flash |
Prioridad a la velocidad de primera respuesta |
| Formato Anthropic o grupos ClaudeCode y CodexResponses | deepseek-v4.1-flash |
La versión económica solo tiene el endpoint Chat |
| Encolable, sensible al costo | deepseek-v4-1-flash-economy-261017 |
Mismos pesos, misma calidad |
🎯 Recomendación por escenario: si no lo tienes claro, ejecuta un lote pequeño de las mismas tareas en cada uno de los dos niveles, compara latencia y factura, y luego decide. APIYI apiyi.com permite cambiar directamente el campo model con una sola clave API, sin tocar el resto de la configuración.
deepseek-v4-1-flash-economy-261017: recomendaciones de decisión y método de cambio
El cambio no tiene ningún coste. La estructura de la solicitud no cambia, el base_url sigue siendo https://api.apiyi.com/v1; basta con cambiar el campo model de deepseek-v4.1-flash a deepseek-v4-1-flash-economy-261017 para completar el cambio de nivel. La facturación se distingue automáticamente según el modelo, no hace falta cambiar la clave API, y tanto el grupo Default como el SVIP pueden usar la versión económica.
| Campo | Versión económica | Versión estándar |
|---|---|---|
| model | deepseek-v4-1-flash-economy-261017 |
deepseek-v4.1-flash |
| base_url | https://api.apiyi.com/v1 |
https://api.apiyi.com/v1 |
| Endpoint | Chat | Chat, formato Anthropic |
| Precio unitario de entrada y salida | $0.24, $0.96 | $0.30, $1.20 |
Un detalle fácil de pasar por alto: en el ID de la versión estándar hay un punto —deepseek-v4.1-flash, no un guion—; si se escribe mal cualquiera de los dos ID, se devolverá un error de que el modelo no existe. Se recomienda guardar esta tabla de referencia rápida en las notas de configuración de modelos del equipo, para evitar errores de tecleo.
💡 Recomendación de selección: para el procesamiento por lotes offline, use la versión económica; para la interacción en línea, use la versión estándar; solo la versión estándar admite el formato Anthropic o los grupos ClaudeCode y CodexResponses. Para tareas nuevas, puede probar primero cada uno de los dos niveles con una pequeña tanda usando el crédito de prueba gratuito en APIYI apiyi.com, y luego definir cuál usar.
Preguntas frecuentes sobre deepseek-v4-1-flash-economy-261017
P1: ¿Qué es deepseek-v4-1-flash-economy-261017?
Es la versión económica de DeepSeek V4.1 Flash, lanzada el 2026-11-11 a las 12:22 (UTC+8). Carga los mismos pesos V4.1-Flash-1017 que la versión estándar `deepseek-v4.1-flash`, pero el precio de entrada y salida es un 80 % del de la estándar (es decir, un 20 % de descuento), y la generación es más lenta.
P2: ¿En qué se diferencia deepseek-v4-1-flash-economy-261017 de deepseek-v4.1-flash?
En tres cosas: precio (entrada y salida al 80 %, lectura de caché al mismo precio), velocidad (la económica es más lenta) y endpoints y grupos (la económica solo ofrece Chat y Default, SVIP; la estándar además tiene formato Anthropic y ClaudeCode, CodexResponses). Los pesos y la calidad de salida son idénticos.
P3: ¿Cuándo salió la versión económica? ¿Se puede usar ya?
Salió el 2026-11-11 a las 12:22 (UTC+8) y ya está disponible en APIYI apiyi.com, utilizable en los grupos Default y SVIP. Por ahora no tiene una página de detalles de modelo propia; los parámetros se rigen por la documentación de lanzamiento y la lista oficial de modelos.
P4: ¿Para qué escenarios de aplicación es más adecuado deepseek-v4-1-flash-economy-261017?
Para tareas poco sensibles a la latencia que van por el endpoint Chat: resúmenes masivos de logs, etiquetado de documentos, limpieza de corpus, traducción por lotes, tareas programadas nocturnas y pipelines de clasificación y extracción sensibles al coste. En procesos offline por lotes también puedes poner reasoning_effort en none para desactivar el razonamiento y ahorrar aún más tokens.
P5: ¿Cómo llamo a deepseek-v4-1-flash-economy-261017 mediante la API?
Regístrate en APIYI apiyi.com y obtén tu clave API, pon base_url como `https://api.apiyi.com/v1`, escribe `deepseek-v4-1-flash-economy-261017` en el campo model y lanza una invocación Chat con la interfaz compatible con OpenAI. Los usuarios nuevos tienen crédito de prueba gratuito, así que puedes verificar directamente la diferencia de latencia y de factura entre las dos versiones.
P6: ¿Qué limitaciones conocidas tiene deepseek-v4-1-flash-economy-261017?
Hay tres cosas que conviene tener presentes: la generación es más lenta (según la documentación, aproximadamente 2 segundos hasta el primer token y unos 15 milisegundos por token); solo tiene endpoint Chat, así que si necesitas formato Anthropic usa la versión estándar; la lectura de caché no tiene descuento y cuesta lo mismo que en la estándar, $0.006. Es «más lenta pero más barata», no «peor».
P7: ¿El 80 % es una promoción? ¿Volverá al precio original más adelante?
No es una promoción. El 80 % se refiere a la diferencia fija entre los precios de lista de los dos modelos: entrada $0.24 frente a $0.30, salida $0.96 frente a $1.20. En APIYI apiyi.com, los descuentos de cuenta van por bonificaciones de recarga y no alteran estos dos precios unitarios; la facturación se hace con el precio máximo en un solo tramo.
deepseek-v4-1-flash-economy-261017: puntos clave
- Mismos pesos: comparte V4.1-Flash-1017 con
deepseek-v4.1-flash; la calidad de salida es idéntica según la documentación oficial. - El descuento del 20%: entrada $0.24 y salida $0.96 (por millón de tokens), el 80% del precio de la versión estándar; la lectura de caché cuesta $0.006 en ambas.
- El precio en velocidad: la documentación estima unos 2 segundos hasta el primer token y unos 15 ms por token; apto para procesos offline, no para interacción.
- Diferencia de endpoints: la versión económica solo ofrece Chat (Default, SVIP); la estándar añade el formato Anthropic y los grupos ClaudeCode y CodexResponses.
- Coste de cambio: la estructura de la petición no cambia; basta modificar el campo model para alternar entre los dos niveles.
- Regla para decidir: si puedes esperar, ahorras; si no, elige velocidad.
Resumen
La relación entre los dos modelos se explica en una frase: deepseek-v4-1-flash-economy-261017 y deepseek-v4.1-flash son dos niveles del mismo peso V4.1-Flash-1017 — misma calidad, velocidad distinta y una diferencia de precio de entrada/salida del 20%.
- Coste: las tareas por lotes se benefician directamente; entrada y salida al 80%, lectura de caché al mismo precio.
- Capacidad: los 552B completos de pesos se sirven por el canal oficial de BytePlus, sin cuantización ni destilación.
- Límites: la versión económica solo tiene el endpoint Chat y los grupos Default y SVIP; el formato Anthropic y ClaudeCode/CodexResponses están disponibles únicamente en la estándar.
Elegir es sencillo: si la latencia no es un problema, usa la versión económica; si necesitas interacción en línea o un formato Anthropic fijo, usa la estándar. Te recomendamos usar APIYI (apiyi.com) con el crédito de prueba gratuito para ejecutar una pequeña tanda en cada nivel y dejar que la factura tome la decisión final.
📚 Referencias
- Documento de lanzamiento de DeepSeek V4.1 Flash, versión económica
- Enlace:
docs.apiyi.com/live/2026-11/deepseek-v4-1-flash-economy-launch.md -
Descripción: Fuente primaria de pesos, precios, endpoints, grupos y estimaciones de velocidad
-
Lista de modelos de APIYI
- Enlace:
docs.apiyi.com/models -
Descripción: Punto de consulta para verificar el precio unitario publicado de ambos modelos
-
Interfaz de precios de APIYI
- Enlace:
api.apiyi.com/api/pricing - Descripción: Datos de precios legibles por máquina, ideales para conciliación automatizada
Autor: Equipo técnico de APIYI
Contacto técnico: Escríbenos desde la página principal del sitio de APIYI; encontrarás más materiales en el centro de documentación docs.apiyi.com