
Resumen de las pruebas de escritura de GPT, Claude y Kimi: primero la conclusión
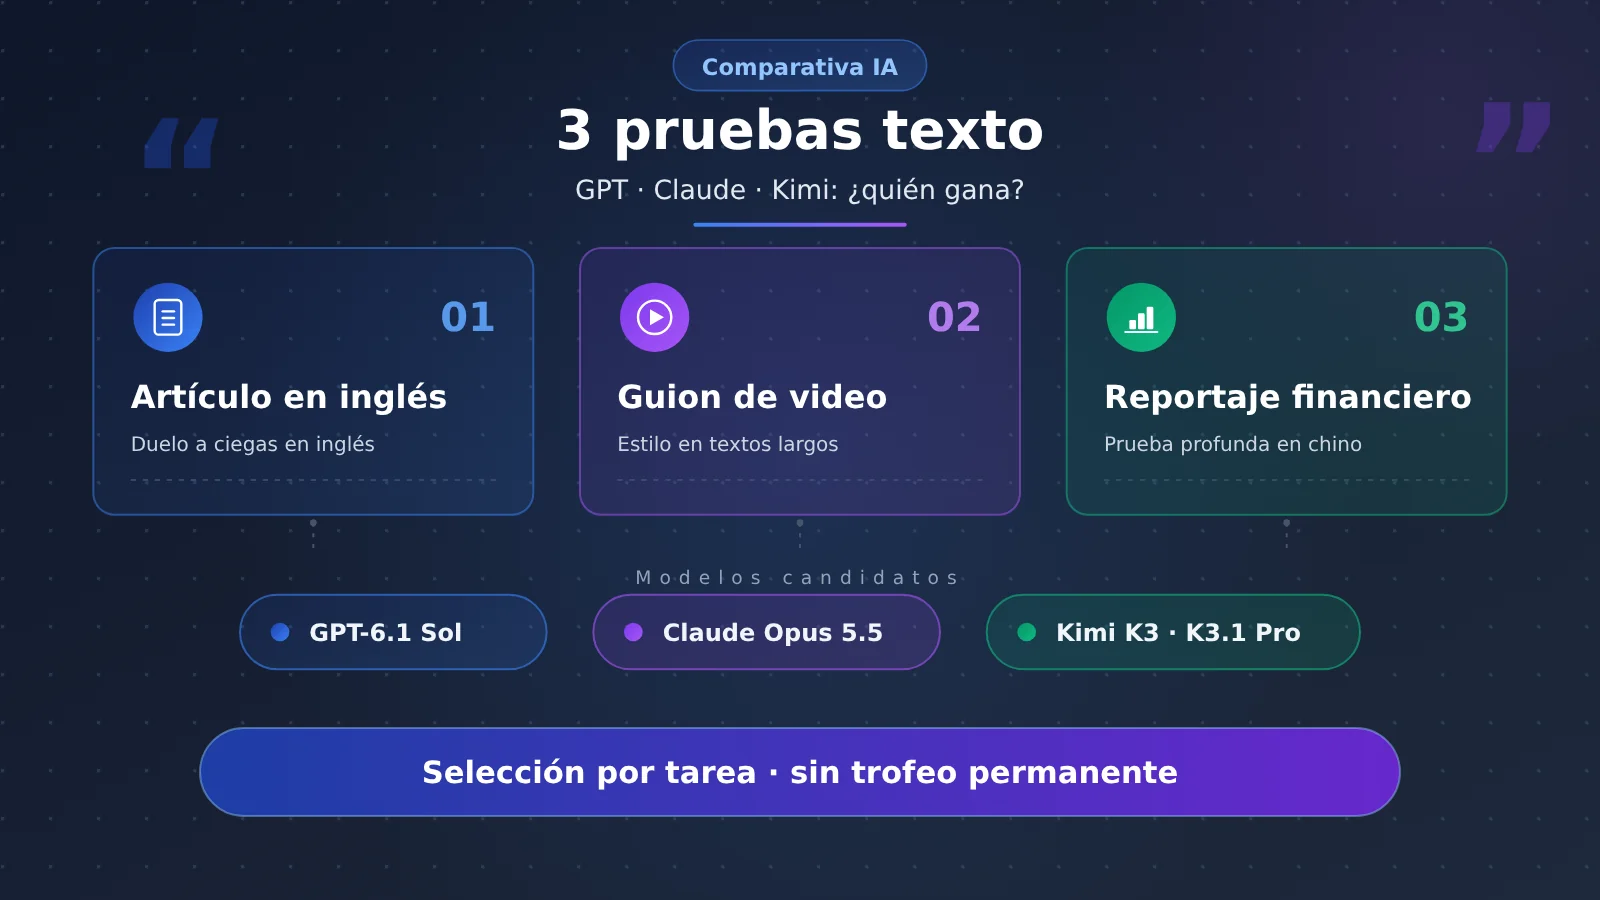
Para artículos en inglés, conviene probar primero GPT-6.1 Sol; para textos largos que exigen un estilo cuidado, Claude Opus 5.5; y para divulgación explicativa merece la pena incluir a Kimi K3. El desempeño general de Kimi K3.1 Pro en inglés también es muy sólido, cercano a GPT en ToneBench.
Las tres pruebas cubren tareas, idiomas y métodos de evaluación distintos. La conclusión más útil es armar una lista de candidatos y luego validarla con tus propios textos, en lugar de otorgar un trofeo permanente a tres familias de modelos.
Consejo para empezar: puedes invocar los modelos candidatos a través de la interfaz unificada de APIYI apiyi.com y comparar los borradores iniciales con el mismo paquete de materiales. La cuota de prueba gratuita para nuevos usuarios se rige por las reglas vigentes de la plataforma.
Pruebas de escritura con GPT, Claude y Kimi: ¿qué veremos a continuación?
En este artículo desglosamos, uno por uno, el ranking de escritura en inglés, la prueba de textos largos para videos estilizados y una prueba real con un artículo financiero profundo en chino. Al final presentamos la selección de escenarios, los pasos de la prueba ciega y ejemplos de invocación, con especial atención a la calidad del texto y al costo de edición humana.
Primero acordemos dos términos: benchmark de escritura es una prueba que evalúa las respuestas según una tarea definida; evaluación ciega es comparar textos ocultando la identidad del modelo. La evaluación ciega puede realizarla una persona o un modelo; al leer los resultados, hay que distinguir quién es el evaluador.
Prueba de escritura con GPT, Claude y Kimi 1: artículos en inglés, enfoque en GPT
AI Writing Benchmark es un proyecto de escritura en inglés mantenido por Johannes Eva, que declara no haber recibido pagos de fabricantes de modelos. Este artículo utiliza los resultados actualizados el 11 de noviembre de 2026 y consultados el 12 de noviembre.
El proyecto abarca 115 modelos y registra 131,507 comparaciones ciegas públicas. Evalúa la escritura mediante la comparación de textos anónimos, y muestra por separado la clasificación de la evaluación por IA y la de los votos humanos.
| Modelo | Puntuación global en inglés | Criterio del resultado |
|---|---|---|
| GPT-6.1 Sol | 95.3 | Primer lugar en la clasificación general |
| Claude Opus 5.5 | 92.9 | Segundo lugar en la clasificación general |
| Kimi K3.1 Pro | 91.9 | Tercer lugar en la clasificación general |
La puntuación global resume varios tipos de tareas; la puntuación por categoría refleja solo un tipo de enunciado. La puntuación por categoría de GPT-6.1 Sol en artículos, blogs y contenido editorial es 98.5, y debe registrarse por separado de la puntuación global de 95.3.
Estas son puntuaciones relativas dentro del benchmark. El proyecto define 50 como la probabilidad estimada —de uno entre dos— de superar al modelo promedio actual en el idioma y la categoría correspondientes; los lectores deben fijarse en la posición competitiva, no interpretar la puntuación como el porcentaje de contenido publicable.
Dicho sin rodeos: si la tarea es un blog o un artículo editorial en inglés, GPT-6.1 Sol tiene motivos suficientes para entrar en la primera ronda de pruebas. Para artículos en chino, hace falta buscar evidencia específica en chino.
Otro resultado que vale la pena destacar: Kimi K3 lidera la categoría de explicación y divulgación científica con 94.9. Aquí gana K3; el tercer puesto de la clasificación general es K3.1 Pro, así que el nombre de la versión debe guardarse junto con la puntuación.
GPT, Claude y Kimi: segunda prueba de escritura — Claude destaca en el estilo de textos largos
ToneBench hace que los modelos lean un brief creativo, un dosier de investigación y una guía de estilo, y después generen un guion completo para YouTube. Los modelos no pueden ver el texto final del autor original, ni conectarse a internet ni usar herramientas externas.
Este artículo utiliza material actualizado el 10 de noviembre de 2026. La tarea consiste en un guion largo de vídeo para un creador específico; el material proporcionado no enumera claramente todos los idiomas de la tarea, por lo que aquí se interpreta como un escenario de guion.
La prueba incluye 87 modelos y 151 configuraciones. Cada configuración completa 10 tareas, y cada tarea se genera de forma independiente 5 veces. En total se generaron 7,550 borradores, y cuatro evaluadores de IA realizaron 30,200 valoraciones.
Se fija especialmente en la coincidencia de estilo, es decir, si el tono, el ritmo y la forma de expresarse se acercan al creador objetivo. La coincidencia de estilo tiene un peso del 19%; la profundidad, exactitud y valor del contenido, un 15%; también se evalúan la coherencia y el control de la extensión.
La siguiente tabla usa el Writing Score de la mejor configuración de cada modelo y el ranking de modelos que figura en el material. Claude corresponde a xhigh; el material no indica los nombres concretos de configuración de razonamiento de los otros dos modelos, así que conviene completarlos al repetir la prueba.
| Modelo | Ranking del modelo | Writing Score | Coste estimado por guion en la prueba |
|---|---|---|---|
| Claude Opus 5.5 | 1 | 85.8 | $1.003 |
| GPT-6.1 Sol | 8 | 82.4 | $0.239 |
| Kimi K3.1 Pro | 9 | 82.5 | $0.251 |
Writing Score es el indicador que resume el rendimiento de escritura en esta prueba, mientras que el ranking sigue el criterio Elo. Por eso, que Kimi tenga 0.1 puntos más y esté un puesto por debajo debe entenderse como un rendimiento similar entre ambos.
Claude lidera este conjunto de resultados, con un coste estimado en la prueba de aproximadamente 4.2 veces el de GPT. Es una estimación de coste de ToneBench y no debe trasladarse directamente al precio de artículos en otras plataformas.
Para entender el ranking, conviene poner las tareas y la evaluación en el mismo diagrama. Al repetir la prueba con APIYI apiyi.com, se recomienda guardar el registro de configuración y luego volver a la tabla original para comprobar el criterio de comparación.
Los intervalos de confianza del primer y segundo puesto de ToneBench se solapan, y eliminar cualquiera de los guiones de referencia también cambiaría el primer puesto. El estudio también encontró cierto sesgo hacia determinados proveedores en la evaluación; aun así, al excluir las evaluaciones individuales, Claude sigue en cabeza.
La conclusión central es: para textos largos que requieren absorber material y mantener la voz del creador, vale la pena probar Claude primero. Este resultado sirve para orientar la selección de candidatos, pero la magnitud de la ventaja aún debe verificarse con tus propios guiones.
También hay que tener en cuenta que la puntuación individual Least Slop de GPT-6 Sol pertenece a otra versión y a otro indicador, y no puede usarse para sustituir el Writing Score de GPT-6.1 Sol.
Prueba de escritura GPT, Claude, Kimi III: ¿qué observar en los artículos de fondo en chino?
La prueba de OmniTools se llevó a cabo del 26 de octubre al 3 de noviembre de 2026, y tuvo como objeto artículos de fondo financieros en chino de PANews. Comparó 10 modelos y 26 artículos.
| Modelo | Puntuación ciega de IA | Artículos de prueba | Puntuación de naturalidad |
|---|---|---|---|
| Claude Opus 5.5 | 8.25 | 7 | 8.3 |
| GPT-6.1 Sol | 6.33 | 3 | 5.5 |
En esta prueba, Claude obtuvo una puntuación general y una naturalidad más altas. Para artículos de fondo financieros en chino, Claude Opus 5.5 es el candidato que vale más la pena probar primero.
Pero la muestra es pequeña, el número de artículos por modelo es desigual y, además, Kimi no participó. Por eso, este material solo puede complementar la evidencia de GPT y Claude en escenarios en chino; no permite establecer una clasificación completa de los tres en chino.
La evaluación utilizó Claude Opus 5.5 y DeepSeek V4 Pro, con la regla de no evaluar el propio modelo. El publicador tiene un trasfondo comercial de servicio de enrutamiento de API, así que conviene tener presente esta información sobre la fuente al leer.
La valoración editorial es otro conjunto de registros. La tasa de adopción editorial del 100% de Claude corresponde apenas a 1/1 ronda, por lo que sirve como observación de caso; la adopción a largo plazo todavía necesita más manuscritos para sustentarse.
Resumen en una frase: aquí se ofrece una señal positiva de que Claude escribe artículos largos de finanzas en chino, y el alcance de la evidencia se limita justamente a este escenario.
Pruebas de escritura de GPT, Claude y Kimi: elige candidatos según el escenario
Al reunir los tres resultados, deberías formar una tabla de selección en lugar de sumar las puntuaciones. El idioma del artículo, la tarea y el estilo objetivo determinan qué evidencia es relevante para ti.
| Escenario de escritura | Candidato prioritario | Criterio de selección |
|---|---|---|
| Blogs y artículos editoriales en inglés | GPT-6.1 Sol | Lidera la categoría de artículos en inglés |
| Guiones largos de video estilo creador | Claude Opus 5.5 | Lidera actualmente en ToneBench |
| Artículos financieros de fondo en chino | Claude Opus 5.5 | Lidera en pruebas reales con muestras pequeñas en chino |
| Explicaciones y divulgación científica en inglés | Kimi K3 | Lidera la categoría de explicación y divulgación |
| Contenido largo impulsado por un paquete de materiales | Prueba ciega conjunta de los tres | GPT y Kimi están cerca en ToneBench |
| Plataforma para validar invocaciones | APIYI apiyi.com | Interfaz unificada que facilita cambiar de modelo |
Escenarios como tutoriales técnicos en chino e introducciones de productos no están cubiertos por completo por las tres evidencias disponibles. Un enfoque más seguro es probar los candidatos en paralelo y ver quién puede explicar la tecnología con claridad y escribir los hechos con precisión.
Pruebas de escritura de GPT, Claude y Kimi: ¿cómo hacer tu propia comparación?
Se recomienda elegir temas reales y dar a cada modelo exactamente los mismos materiales, planificación, extensión y permisos de herramientas. Cada uno debe generar de forma independiente al menos tres veces; luego, oculta el nombre del modelo y entrega los resultados al editor para su evaluación.
La evaluación puede comenzar con cinco criterios: precisión factual, ejecución de la planificación, naturalidad de la expresión, claridad estructural y valor del contenido. Los pesos los determina la tarea del equipo, e indica claramente que se trata de reglas propias.
Además, registra el costo de edición humana: el trabajo necesario para dejar el texto listo para publicar. Lo ideal es registrar también el tiempo de modificación, los párrafos reescritos, los errores de hecho y la situación final de adopción.
Sugerencia de configuración: en APIYI apiyi.com, usa una sola clave API para cambiar de modelo, lo que reduce el trabajo de integración repetido. Durante la prueba, conserva la versión del modelo, los parámetros y el uso real de tokens para facilitar la reproducción.
A continuación se muestra un ejemplo mínimo de invocación. Coloca el mismo paquete real de materiales en brief y cambia el nombre del modelo para generar un borrador comparativo; la clave debe ser proporcionada de forma segura por el entorno de ejecución.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1",
)

brief = """请依据以下资料和策划生成文章。
只使用资料支持的事实,遵守目标篇幅与文风。
这里替换为各模型共同使用的实际资料包和策划。
"""

for model in [
    "gpt-6.1-sol",
    "claude-opus-5-5",
    "kimi-k3.1-pro",
]:
    result = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": brief}],
    )
    print(model, result.choices[0].message.content)
Este código sirve para empezar; una prueba ciega formal también debería repetir la generación, presentar los resultados de forma anónima y registrar la configuración. Para verificar el modelo líder en la categoría de explicación, hay que añadir además Kimi K3.
Preguntas frecuentes sobre la prueba de escritura de GPT, Claude y Kimi
En la prueba de escritura de GPT, Claude y Kimi, ¿qué versión de Kimi debería probar?
Para contenido divulgativo, prioriza incluir Kimi K3; al comparar el ranking general de este artículo con los resultados de ToneBench, usa K3.1 Pro. Antes de invocar mediante APIYI apiyi.com, revisa la lista de modelos y el nombre exacto del modelo para evitar mezclar versiones.
En la prueba de escritura de GPT, Claude y Kimi, ¿cómo comparar el costo real?
Compara el «costo por artículo aceptable»: el gasto acumulado de las invocaciones más la carga de edición. Cuando pruebes en APIYI apiyi.com, registra el uso real y el número de reintentos, y luego calcula con los precios del momento; así te acercas más a la producción que si solo miras el costo del primer borrador.
Cierre de la prueba de escritura de GPT, Claude y Kimi: elegir el modelo que ahorre más edición
Para artículos en inglés, prueba primero GPT; para textos largos con estilo propio y artículos financieros profundos en chino, prueba primero Claude; y para contenido divulgativo, suma a Kimi. Estas son prioridades para tareas concretas, no un ranking permanente de toda la familia de modelos.
Recomendamos validar el rendimiento con APIYI apiyi.com usando el mismo paquete de materiales. Al final, elige el que complete el plan con más precisión, conserve más párrafos utilizables y haga que el editor no tenga que quedarse una ronda extra de horas extra.
Referencias para pruebas de escritura con GPT, Claude y Kimi
-
AI Writing Benchmark: aiwritingbenchmark.com
Clasificación general y clasificaciones por categoría en inglés, con datos actualizados al 11 de noviembre de 2026. -
Towards AI ToneBench: benchmark.towardsai.com/models/
Pruebas de guiones para videos, ranking de modelos, configuración y estimación de costos, con información del 10 de noviembre de 2026. -
Prueba práctica de OmniTools para escritura de artículos largos y profundos: omnitools.ai/evals/longform-writing
Prueba de artículos financieros profundos en chino de PANews, realizada del 26 de octubre al 3 de noviembre de 2026.
Autor: equipo de contenido técnico de APIYI. Te invitamos a compartir configuraciones de modelos, métodos de pruebas ciegas y experiencias de edición a través de APIYI apiyi.com.


