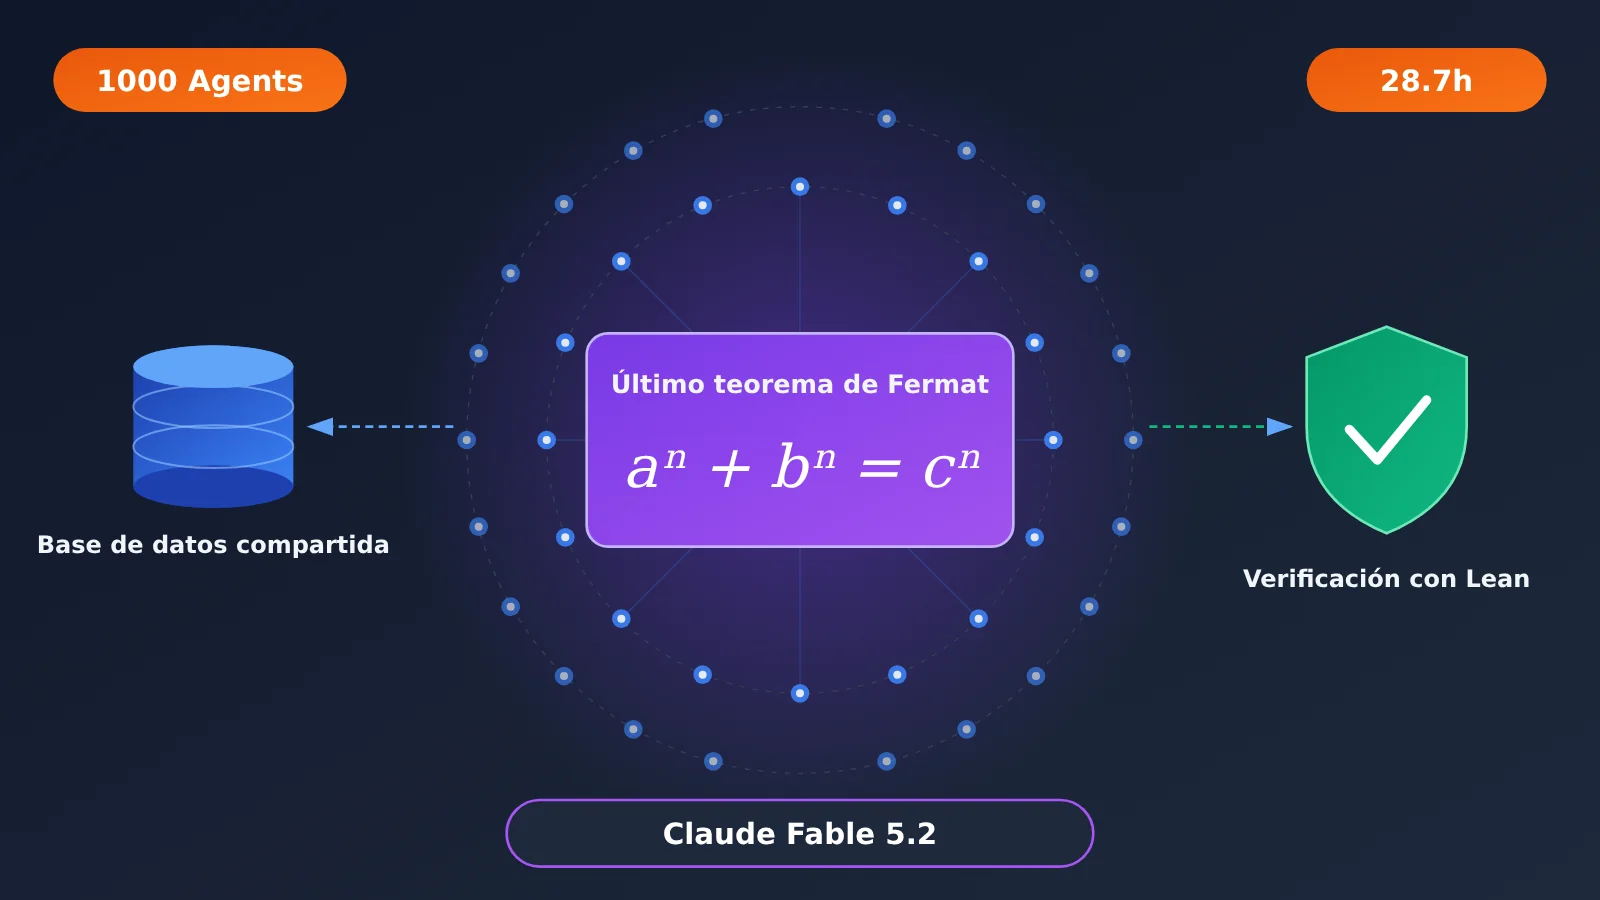
El 9 de noviembre de 2026, Anthropic publicó en su blog oficial de ingeniería un experimento con múltiples agentes: 1000 agentes Claude Fable 5.2 colaboraron para completar en 28,7 horas la formalización computacional del último teorema de Fermat, y la demostración final superó la comprobación del núcleo oficial de Lean. Dos meses antes, en el primer experimento de formalización, participaron decenas de agentes y se necesitaron 11 días.
Esto no significa que «la IA haya demostrado el último teorema de Fermat en 30 horas». Andrew Wiles y Richard Taylor ya habían demostrado el teorema en la década de 1990. Lo que hizo este experimento fue traducir una demostración existente a una forma que una computadora pudiera verificar paso a paso. Por tanto, la pregunta que este artículo busca responder es: ¿cómo colaboraron 1000 agentes de IA para completar un proyecto tan complejo en menos de 30 horas?
Valor principal: al terminar de leer, conocerás los datos clave del experimento de formalización del último teorema de Fermat, cómo se organizaron los 1000 agentes y qué mecanismos de verificación se utilizaron, así como las posibles aplicaciones y los límites de esta experiencia para los sistemas de agentes empresariales.
Resumen de los datos clave del experimento de formalización del último teorema de Fermat
Empecemos con una tabla que resume los datos básicos del experimento con Claude Fable 5.2. Conviene aclarar algunos detalles que pueden prestarse a confusión: se utilizó una versión temprana del modelo, el experimento partía de información predefinida y la propia empresa lo describió como un toy experiment (una demostración experimental).
| Dato | Detalle |
|---|---|
| Fecha de publicación | 9 de noviembre de 2026, en el blog oficial de ingeniería de Anthropic |
| Modelo utilizado | Una versión temprana de Claude Fable 5.2, que aún no había completado las evaluaciones de alineación previas a su lanzamiento oficial |
| Tamaño del equipo | 1 agente líder + 999 agentes auxiliares |
| Tiempo hasta completarlo | 28,7 horas; el teorema final superó la comprobación del núcleo oficial de Lean (el anuncio oficial redondeó la cifra a 30 horas) |
| Información predefinida | 60 proposiciones, un resumen de una frase de la demostración clásica, definiciones pertinentes y 47 lemas ya demostrados en una formalización anterior |
| Entorno de herramientas | Cadena de herramientas de Lean, Mathlib, Git, base de datos PostgreSQL compartida y entornos aislados en máquinas virtuales |
| Descripción oficial | Toy experiment; no fue la primera demostración del último teorema de Fermat |
Formalización del último teorema de Fermat: primero, aclaremos las condiciones del experimento
Los investigadores no se limitaron a decir «demuestra el último teorema de Fermat» y dejar que el agente se las arreglara solo. Le proporcionaron 60 proposiciones —el teorema final y 59 hitos intermedios—, un resumen de la estrategia, definiciones y 47 lemas que ya se habían demostrado en el experimento anterior. Además, los investigadores definieron de antemano los roles del agente líder y los agentes auxiliares.
Así que el experimento evaluaba otra capacidad: partiendo de unas bases matemáticas y unas herramientas determinadas, ¿puede un equipo grande de agentes organizarse por su cuenta y convertir una estrategia conocida en una demostración completa que pueda comprobarse mediante una máquina? Esta pregunta se acerca más a un problema de ingeniería que a «¿puede la IA hacer matemáticas?».
Por qué es tan difícil formalizar el último teorema de Fermat
El enunciado del último teorema de Fermat es sencillo: para todo entero (n > 2), no existen enteros positivos (a), (b) y (c) que cumplan (a^n + b^n = c^n). Pierre de Fermat lo formuló en el siglo XVII y el problema quedó sin resolver durante más de 350 años. Wiles anunció una demostración en 1993; en 1994, junto con Taylor, corrigió un fallo importante, y la versión definitiva se publicó en 1995. La demostración original tenía unas 129 páginas y se apoyaba ampliamente en resultados de teoría de números moderna y geometría algebraica.
Al escribir una demostración, un matemático puede decir «se deduce claramente de lo anterior» y confiar en que el lector complete los pasos intermedios. Una computadora no puede dar nada por sentado: necesita saber qué definición, teorema o regla de inferencia se aplicó en cada paso. Ahí está la dificultad de formalizar: algo que para una persona es «evidente» puede convertirse en cientos o miles de líneas de código.
Lean, Mathlib y la formalización matemática
Para entender este experimento, conviene distinguir tres conceptos:
- Lean: un asistente interactivo de demostraciones que comprueba si una prueba cumple estrictamente las reglas de la lógica formal.
- Mathlib: la biblioteca matemática de Lean, que reúne numerosas definiciones y teoremas ya formalizados; es como una «biblioteca estándar» a la que se puede recurrir.
- Formalización matemática: convertir una demostración matemática legible para las personas en una estructura lógica que una computadora pueda verificar por completo.
Lo más importante es que la IA construye la demostración y el núcleo de Lean la comprueba. Que el modelo diga «lo he demostrado» y que Lean acepte la prueba son dos cosas muy distintas. Este experimento merece tomarse en serio precisamente porque el resultado final no depende de la valoración del propio modelo, sino de una comprobación independiente por computadora.
Cómo colaboran 1000 agentes de IA: un sistema de gestión de proyectos ejecutado por IA
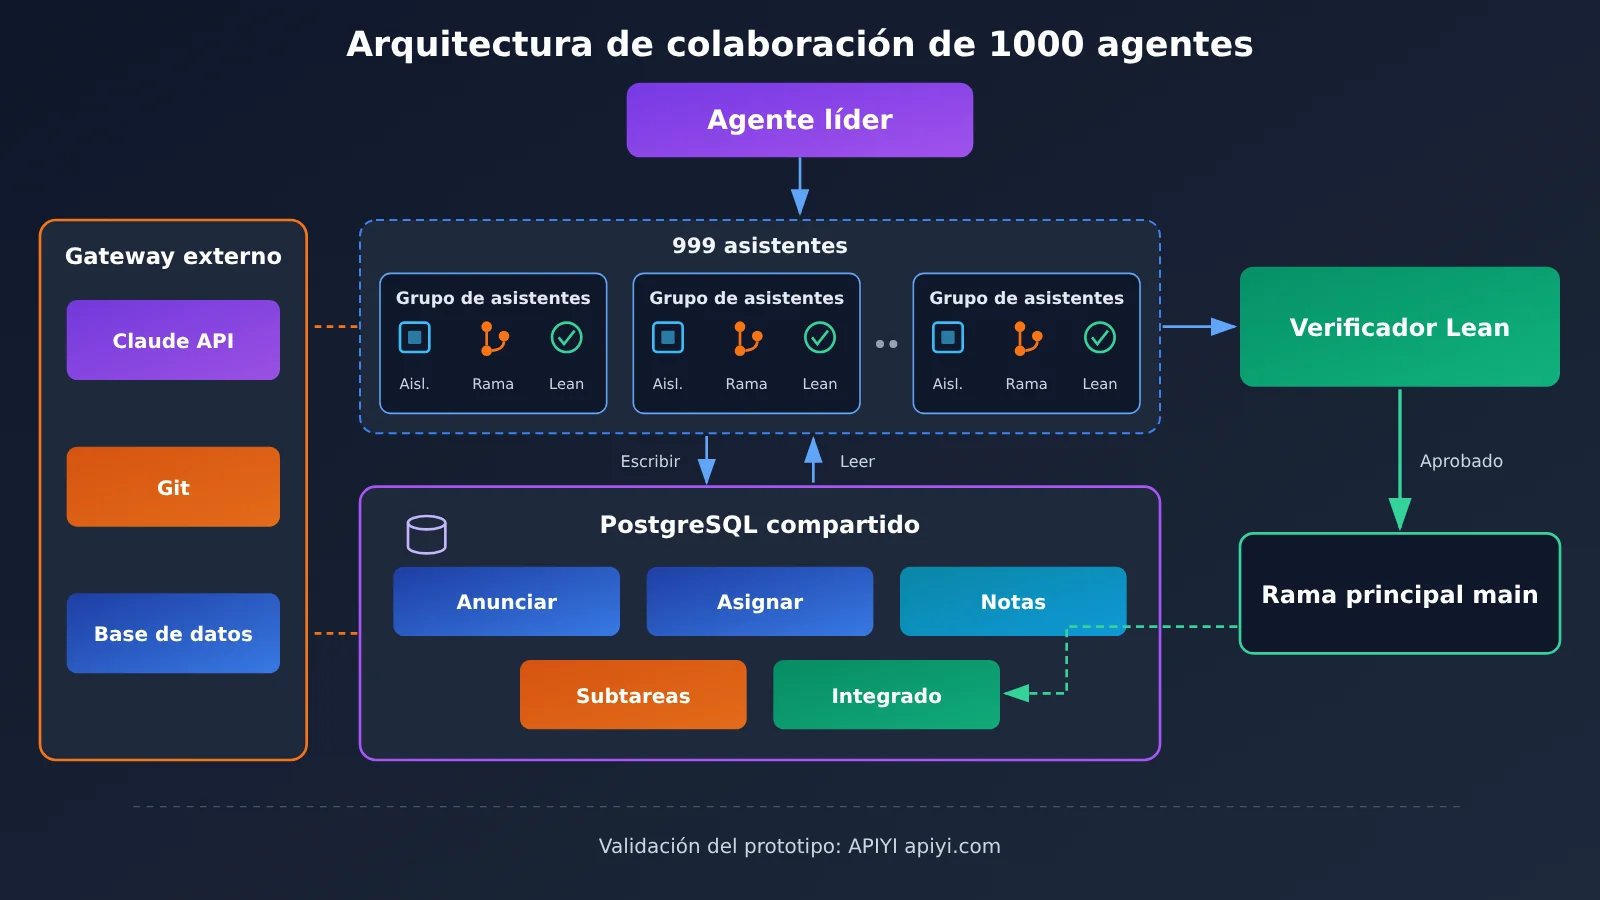
Esta es una de las partes más interesantes del experimento Claude Fable 5.2. Los 1000 agentes no trabajan por separado, cada uno concentrado en resolver un problema, sino que forman un sistema colaborativo con gestión de tareas, asignación de recursos y ajustes dinámicos.
Estructura del equipo Claude Fable 5.2
El equipo tiene una estructura jerárquica sencilla: un agente líder se encarga de la planificación general, la división de tareas y el seguimiento del progreso; los otros 999 agentes ayudan con las demostraciones concretas. Cada agente dispone de su propio entorno aislado en una máquina virtual ligera, donde puede usar Shell, un editor de archivos, la cadena de herramientas de Lean y Mathlib. También tiene su propia rama de Git y puede enviar solicitudes de merge a la rama principal.
Ningún agente tiene acceso directo a Internet. Toda comunicación con Claude API, Git y las bases de datos debe pasar por una pasarela externa. Los entornos aislados y las ramas independientes permiten que los 1000 agentes modifiquen código al mismo tiempo sin sobrescribir los archivos de los demás.
PostgreSQL compartido: el centro de colaboración de los agentes de IA
Si 1000 agentes colaboran enviándose mensajes entre sí, el volumen de comunicación se descontrola rápidamente. La estrategia del agente líder consiste en crear cinco tablas compartidas en la base de datos durante los primeros 10 minutos del experimento y convertir la comunicación en «leer y escribir en el mismo tablero».
| Nombre de la tabla | Función | Papel en la colaboración |
|---|---|---|
| Announce | Publicar instrucciones para el equipo | Difusión para todos, como un tablón de anuncios del proyecto |
| Assign | Asignar tareas y responsables | Deja claro «quién hace qué» y evita duplicar esfuerzos |
| Notes | Registrar avances, problemas y planes de trabajo | Comparte el contexto y reduce los silos de información |
| Subtasks | Gestionar subtareas para que los agentes puedan tomarlas | Grupo de tareas que permite que los agentes se asignen trabajo por iniciativa propia |
| Landed | Registrar el trabajo terminado y aprobado en las comprobaciones | Lista de resultados fiables: solo incluye contenido verificado |
El valor de este mecanismo está en que los agentes no necesitan ponerse en contacto uno por uno con los otros 999: basta con consultar la base de datos para saber qué tareas hay, cuáles se han completado y cuáles dependen de otras. Los resultados se incorporan a la rama principal mediante una fusión de Git. Según los datos publicados oficialmente, el proceso registró unas 36.612 escrituras y 311.734 lecturas en la base de datos. De las escrituras, unas 20.600 correspondieron a Notes y unas 14.800 a Subtasks (la estadística no incluye la mayoría de las llamadas a scripts). El número de lecturas, muy superior al de escrituras, también indica que los agentes pasan la mayor parte del tiempo «consultando el estado global».
Asignación dinámica de tareas: de la distribución fija al trabajo autogestionado
El proceso de coordinación de este experimento no fue siempre igual. La siguiente cronología muestra cómo fue evolucionando la organización:
| Momento | Evento clave |
|---|---|
| Minuto 10 | Lead crea cinco tablas en una base de datos compartida |
| Alrededor del minuto 27 | Se demuestran 3 proposiciones |
| Poco después | Lead aparca temporalmente las 47 proposiciones que se consideraban difíciles de completar dentro del presupuesto y concentra los recursos en otras 10 |
| Alrededor del minuto 70 | Se completan las 10 proposiciones y Lead vuelve a asignar agentes para abordar proposiciones más difíciles |
| Alrededor de la hora 3 | Lead permite que los agentes inactivos se asignen tareas por su cuenta, sin esperar a que se les asignen |
| Hora 5,6 | 73 Helper han creado 756 tareas |
| Alrededor de la hora 18 | Se reanuda la ejecución desde el último estado guardado y continúa durante 12 horas |
| Hora 28,4 | Se completa la proposición relacionada con Langlands–Tunnell |
| Hora 28,7 | Se completa el último teorema de Fermat y supera la comprobación del kernel oficial |
Hay dos detalles que conviene tener en cuenta. Primero, el paso de «Lead asigna las tareas» a «los agentes las reclaman por su cuenta» equivale a que el equipo pase de una coordinación centralizada a un modelo de bolsa de tareas, lo que reduce el riesgo de que Lead se convierta en un cuello de botella. Segundo, el experimento se reanudó desde un estado guardado alrededor de la hora 18, así que las 28,7 horas no significan que todos los agentes trabajaran sin interrupciones desde el principio hasta el final.
Además, las 47 proposiciones aparcadas temporalmente no son lo mismo que los 47 lemas de la entrada predefinida. No hay que confundirlos al leer la documentación oficial.
Langlands–Tunnell: 750 agentes se unen para superar el obstáculo más difícil de la formalización del último teorema de Fermat
Al acercarse al final, el equipo se encontró con el obstáculo más difícil: las proposiciones relacionadas con Langlands–Tunnell, un resultado matemático importante en la ruta de demostración de Wiles. Al principio, el agente encargado de esta parte estimó que podía requerir entre 700.000 y 1.000.000 de líneas de código Lean, y consideró que la probabilidad de completarla en el tiempo restante era inferior al 1 %.
Después, Lead concentró en esta tarea a unos 750 agentes Helper. Los agentes crearon por su cuenta un árbol de tareas con varios niveles:
- Se dividió en 10 áreas principales.
- Se crearon 2.418 subtareas.
- El árbol de tareas alcanzó una profundidad de 10 niveles.
- Cientos de agentes trabajaron a la vez en distintas subtareas.
Langlands–Tunnell se completó en la hora 28,4, y el último teorema de Fermat, 0,3 horas después. Este caso muestra que el valor del paralelismo a gran escala no se reduce a que «muchas personas calculen más rápido». Lo fundamental es descomponer un problema demasiado grande para abordarlo directamente en muchas tareas pequeñas que puedan avanzar de forma independiente, verificarse por separado y combinarse al final. Si la descomposición no se hace bien, los 750 agentes solo se quedarán esperando unos a otros o repetirán el mismo trabajo.
Por qué tuvo éxito la formalización del último teorema de Fermat: verificación de Lean y medidas de seguridad
Desde el punto de vista de la fiabilidad de ingeniería, el experimento se apoyó en tres capas de protección.
La primera capa fue la verificación de los resultados. Cada subproposición tenía que superar la comprobación de Lean antes de incorporarse a la rama principal. La tabla Landed solo registraba el trabajo que había pasado esa comprobación. La prueba final fue verificada por el comprobador oficial del kernel. Lead Agent dejó constancia de lo siguiente: «El último teorema de Fermat está en la rama principal, verificado por el comprobador oficial del kernel».
La segunda capa fue el aislamiento durante la colaboración. Los entornos aislados y las ramas de Git independientes redujeron al mínimo los conflictos entre archivos y las interferencias entre agentes.
La tercera capa fueron los límites de seguridad. El experimento utilizó un modelo temprano cuya evaluación de alineación aún no había concluido antes de su lanzamiento oficial. Por eso, Anthropic estableció varias restricciones:
- Se prohibió el acceso a Internet y el acceso directo a los entornos aislados de otros agentes.
- Los comandos se ejecutaron con cuentas sin privilegios.
- Un Gateway externo gestionó las comunicaciones con la API, Git y la base de datos.
- Un clasificador en tiempo real comprobó los comandos de Shell y las modificaciones de archivos, mientras que un monitor fuera de línea revisó los registros de operaciones.
El experimento generó más de un millón de llamadas a herramientas, y ninguna llegó al nivel que exigía bloquearla. Anthropic también indicó que, después del experimento, añadió un sistema paralelo de supervisión de la cadena de pensamiento. La conclusión es que, para evaluar un sistema de agentes fiable, no basta con comprobar si el modelo puede completar la tarea: también hacen falta verificación independiente, límites de permisos y un entorno de ejecución rastreable.
De 11 días a 28,7 horas: comparación de dos experimentos de Claude Fable 5.2
Los dos experimentos de formalización del último teorema de Fermat emplearon criterios distintos, así que conviene analizarlos por separado:
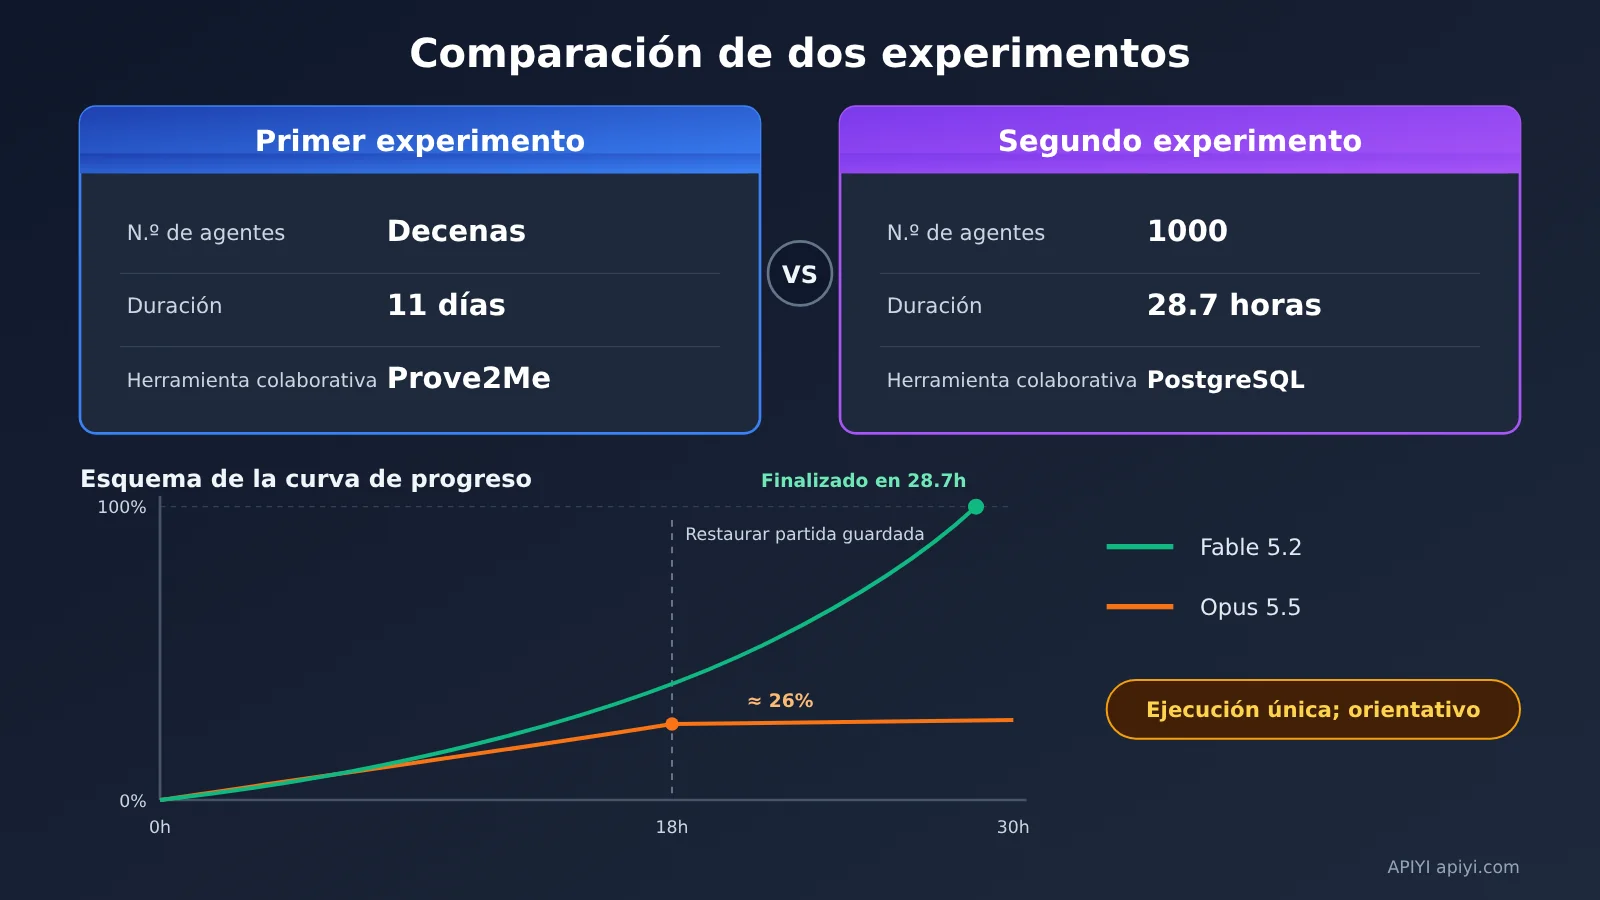
| Indicador | Primero (anunciado en septiembre de 2026) | Segundo (anunciado el 9 de noviembre de 2026) |
|---|---|---|
| Modelo | Modelo de investigación interno (aproximadamente del mismo nivel que Fable 5.1) | Versión preliminar de Fable 5.2 |
| Número de agentes | Decenas | 1000 |
| Tiempo de ejecución | 11 días | 28,7 horas |
| Tokens de salida | Aproximadamente 6000 millones | Según la empresa, alrededor de un tercio de los del primer experimento |
| Longitud de la prueba | Referencia (aproximadamente 13 millones de líneas de código Lean) | Aproximadamente 1/7 de la del primer experimento |
| Plataforma de colaboración | Prove2Me + Claude Code Multi-Agent Harness | Herramientas generales + PostgreSQL |
| Orientación humana | Tianyi Peng, investigador, proporcionó algunas indicaciones de alto nivel | Sin orientación matemática continua |
Cabe destacar que los 6000 millones de tokens, los 13 millones de líneas de código y los aproximadamente 30.300 teoremas corresponden al primer experimento. La empresa no ha publicado cifras absolutas de tokens, el costo total ni el número exacto de líneas de código del segundo experimento.
Al principio, el primer experimento también tuvo algunos tropiezos: a los agentes les costaba mantener una visión global del estado, no sabían qué habían terminado los demás y duplicaban trabajo. Más adelante se incorporó la plataforma Prove2Me, que usaba un DAG para gestionar las dependencias entre teoremas y ofrecía seguimiento del estado de las tareas, búsqueda de teoremas y compilación acelerada. El cambio en el segundo experimento fue dejar de usar esa plataforma especializada y permitir que los agentes crearan sus propios mecanismos de colaboración con una base de datos genérica y Git. Cinco tablas desempeñaban funciones similares.
Anthropic también hizo una comparación con la misma configuración de 1000 agentes: Opus 5.5 completó alrededor del 26 % en 18 horas y, para las 30 horas, apenas había avanzado; Fable 5.2 completó la prueba final en 28,7 horas. Ambos equipos reanudaron el trabajo desde un estado guardado alrededor de las 18 horas. Sin embargo, cada modelo se ejecutó una sola vez, por lo que estos resultados no permiten concluir que haya una diferencia general entre ambos para todo tipo de tareas complejas.
Análisis del impacto de 1000 experimentos con agentes de IA en las empresas
Para desarrolladores: cuatro capacidades clave de los sistemas multiagente
Si dejamos de lado las matemáticas, las capacidades que revela este experimento se pueden relacionar con situaciones empresariales habituales:
| Capacidad | Cómo se refleja en el experimento | Aplicación en la empresa |
|---|---|---|
| Descomposición de tareas complejas | 2,418 subtareas y un árbol de tareas de hasta 10 niveles | Grandes refactorizaciones de código e informes de investigación complejos |
| Asignación dinámica de recursos | Dejar en espera los problemas difíciles y concentrar a 750 Helpers en resolverlos | Redistribuir agentes y capacidad de cómputo según las prioridades |
| Gestión del estado compartido | Cinco tablas de PostgreSQL y fusiones con Git | Un tablero de tareas unificado para reducir el trabajo duplicado |
| Verificación independiente de resultados | El núcleo de Lean comprueba cada contribución | Pruebas unitarias, validación de datos y revisión manual |
La lección más práctica para los desarrolladores es que no hace falta empezar construyendo una plataforma especializada y compleja: una base de datos compartida bien diseñada, junto con control de versiones, puede sostener colaboraciones de una escala considerable. Este es un ejemplo mínimo de invocación del modelo:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

response = client.chat.completions.create(
    model="claude-fable-5-2",  # Consulta la lista de modelos de la plataforma para ver los nombres disponibles
    messages=[{"role": "user", "content": "把这个任务拆成可独立验证的子任务"}]
)
print(response.choices[0].message.content)
Ver código ilustrativo de la cola de tareas Lead / Helper
import sqlite3
import openai

# SQLite se usa aquí para simular localmente las tablas Subtasks / Landed del experimento (en el experimento se usó PostgreSQL)
db = sqlite3.connect("board.db")
db.execute("CREATE TABLE IF NOT EXISTS subtasks (id INTEGER PRIMARY KEY, goal TEXT, status TEXT, owner TEXT)")
db.execute("CREATE TABLE IF NOT EXISTS landed (task_id INTEGER, result TEXT)")

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

def lead_plan(goal: str):
    """Lead: descompone la tarea y la añade a la cola."""
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": f"将目标拆为3-5个子任务,每行一个:{goal}"}]
    )
    for line in resp.choices[0].message.content.splitlines():
        if line.strip():
            db.execute("INSERT INTO subtasks (goal, status) VALUES (?, 'open')", (line.strip(),))
    db.commit()

def verify(result: str) -> bool:
    """Verificador independiente: en un caso real, debería sustituirse por pruebas, un script de validación o una comprobación de Lean."""
    return len(result) > 0

def helper_claim(name: str):
    """Helper: reclama una tarea y solo la registra en landed si supera la verificación."""
    row = db.execute("SELECT id, goal FROM subtasks WHERE status='open' LIMIT 1").fetchone()
    if not row:
        return
    task_id, goal = row
    db.execute("UPDATE subtasks SET status='doing', owner=? WHERE id=?", (name, task_id))
    db.commit()
    resp = client.chat.completions.create(
        model="claude-fable-5-2",
        messages=[{"role": "user", "content": goal}]
    )
    result = resp.choices[0].message.content
    if verify(result):
        db.execute("INSERT INTO landed VALUES (?, ?)", (task_id, result))
        db.execute("UPDATE subtasks SET status='done' WHERE id=?", (task_id,))
    else:
        db.execute("UPDATE subtasks SET status='open', owner=NULL WHERE id=?", (task_id,))
    db.commit()

lead_plan("为一个开源库补全单元测试")
for i in range(3):
    helper_claim(f"helper-{i}")
🚀 Consejo para empezar: si quieres reproducir un prototipo pequeño con «descomposición por Lead + asignación por Helper + verificación independiente», puedes empezar solicitando una cuota de prueba gratuita en APIYI, en apiyi.com. La plataforma ofrece una interfaz compatible con OpenAI; con una sola clave puedes cambiar entre modelos como Claude, GPT y Gemini, y comparar la calidad de la descomposición cuando distintos modelos actúan como Lead.
Para el sector: los límites importan más que las cifras
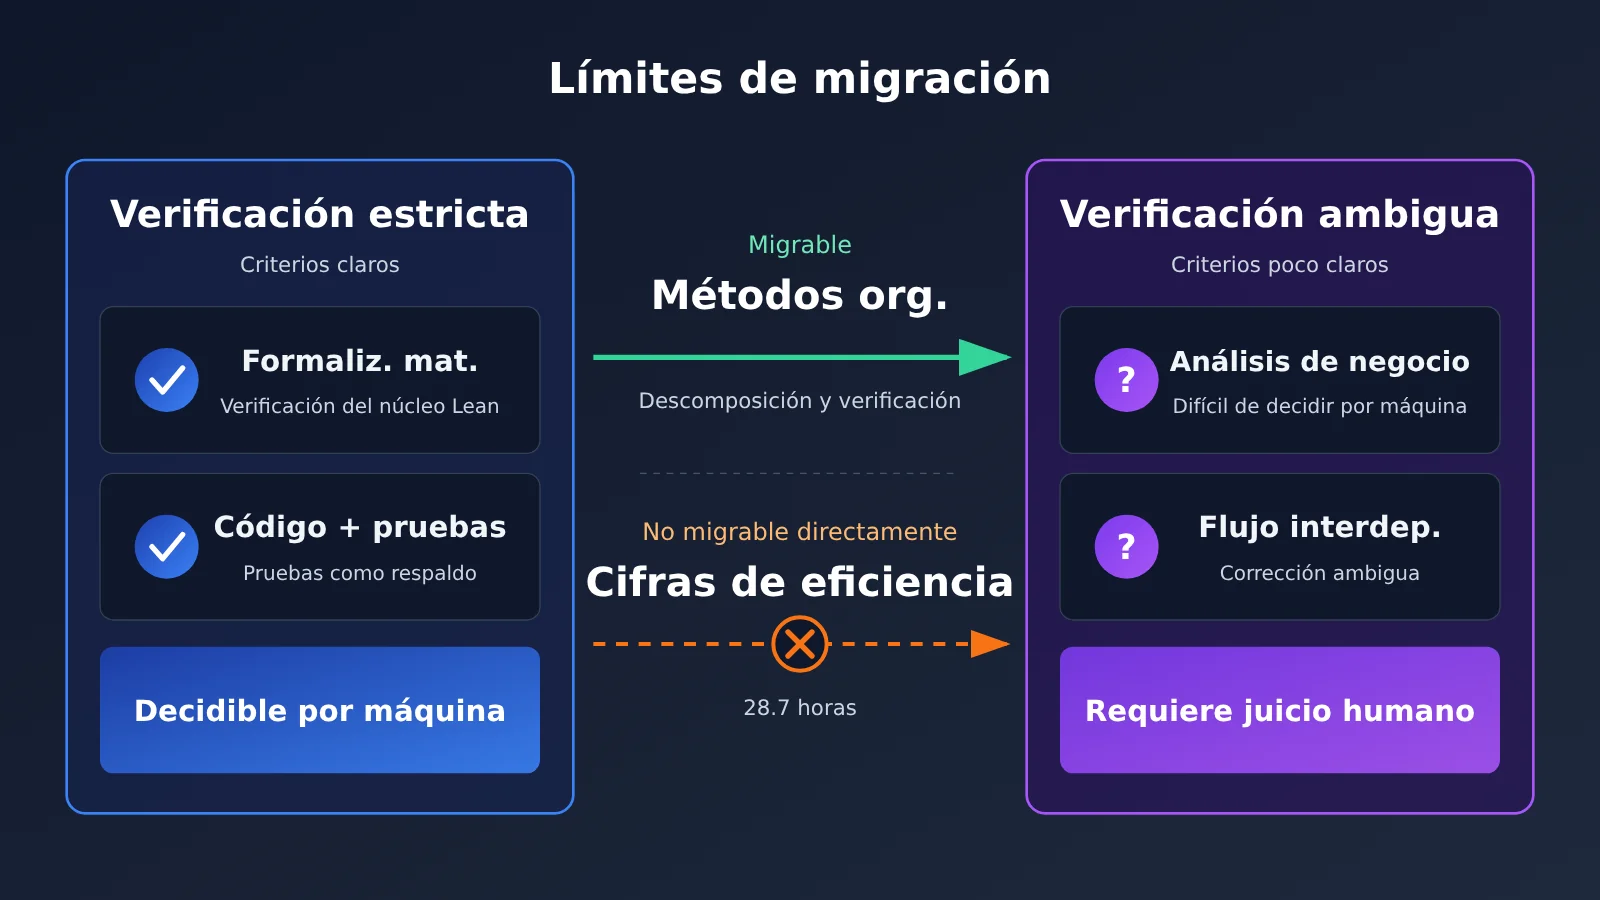
Conviene tener presente un aspecto: la formalización matemática cuenta con verificadores estrictos y objetivos como Lean, pero la mayoría de las tareas empresariales no tienen criterios de corrección igual de claros. El código puede respaldarse con pruebas, pero a menudo es difícil determinar automáticamente si un análisis de mercado o un proceso interdepartamental es «correcto». Por eso, las 28.7 horas y la tasa de éxito de este experimento no se pueden extrapolar directamente a los sistemas Agent empresariales.
Anthropic también señala varias limitaciones: los Agent pueden concluir demasiado pronto que una tarea es imposible. Por ejemplo, de las 47 proposiciones que se dejaron de lado al principio, la mayoría se acabó resolviendo. La orientación de las personas sigue siendo valiosa en los momentos difíciles, y herramientas especializadas en un dominio, como Prove2Me, aún podrían mejorar la compilación, la recuperación de información y la colaboración. El experimento no demuestra que cuantos más Agent haya, mejor, ni que ya no hagan falta expertos humanos y Harness especializados.
💡 Recomendación de ingeniería: Al probar soluciones multiagente en una empresa, conviene empezar por tareas con criterios de verificación claros, como cambios de código guiados por pruebas, y ampliar el alcance poco a poco. Con la facturación por uso de APIYI (apiyi.com), se puede empezar con un número reducido de Agent para evaluar las etapas de descomposición y verificación, y después decidir si merece la pena aumentar la inversión.
Preguntas frecuentes
P1: ¿Este experimento demuestra que la IA probó el último teorema de Fermat?
No. Wiles publicó formalmente la demostración del último teorema de Fermat en 1995, con la colaboración de Taylor para corregir un problema clave. Este experimento partió de 60 proposiciones, un esquema de la estrategia, definiciones y 47 lemas ya demostrados, y convirtió la estrategia de demostración existente en una prueba formal verificable por Lean.
P2: ¿Por qué solo 54 de las 60 proposiciones aparecen marcadas como demostradas?
En el recuento de la hora 30, cinco proposiciones alternativas ya no eran necesarias y otra se abandonó. El teorema final ya había superado la verificación en la hora 28,7, así que no hacía falta completar las 60 proposiciones iniciales.
P3: ¿Cuánto cuesta la API de Claude Fable 5.2?
El precio oficial es de 8 $ por millón de tokens de entrada y 40 $ por millón de tokens de salida. En Fast Mode, los precios son de 16 $ y 80 $, respectivamente. La lectura de caché cuesta 0,20 $ por millón de tokens, y Batch API ofrece un 50 % de descuento. La ventana de contexto es de 1 millón de tokens y la salida máxima, de 128 000 tokens. No se ha publicado el costo total del segundo experimento, así que no se puede estimar multiplicando los 6 000 millones de tokens del primero por el precio unitario.
P4: ¿Cómo puedo probar Claude Fable 5.2 rápidamente mediante la API?
Regístrate en APIYI, en apiyi.com, y obtén una clave API. Después, configura `base_url` como `https://api.apiyi.com/v1` y podrás usar directamente el código de ejemplo de este artículo. Los usuarios nuevos tienen un saldo gratuito para pruebas, ideal para empezar con un prototipo pequeño con varios agentes.
P5: ¿Un sistema multiagente necesita PostgreSQL?
No necesariamente. Lo importante es contar con una fuente de estado compartida a la que todos los agentes puedan acceder para leer y escribir, además de control de versiones y verificación independiente. Para un prototipo pequeño bastan SQLite o Redis. Si invocas el modelo mediante APIYI, en apiyi.com, el almacenamiento del estado queda a cargo de tu propio sistema, así que puedes combinar ambas cosas como prefieras.
P6: ¿Qué limitaciones conocidas tiene este experimento?
Los responsables lo describieron explícitamente como un experimento de juguete. La comparación entre Fable y Opus se ejecutó una sola vez en cada caso; se utilizaron modelos en fase temprana que necesitaban varias capas de protección; los agentes abandonaron tareas por error antes de tiempo, y la orientación humana y las herramientas especializadas en el dominio siguen siendo valiosas.
Conclusiones clave: 1000 agentes de IA formalizan el último teorema de Fermat
- En qué consistió el experimento: formalizar una demostración existente en código verificable por Lean; no demostrar por primera vez el último teorema de Fermat.
- Cifras clave: 1000 agentes de la versión preliminar de Fable 5.2 lo completaron en 28,7 horas y superaron la verificación del núcleo oficial de Lean.
- Organización central: 1 Lead y 999 Helper colaboraron mediante cinco tablas de base de datos compartidas y Git.
- Cómo abordaron el reto: unos 750 agentes descompusieron Langlands–Tunnell en 2418 subtareas, con una profundidad máxima de 10 niveles.
- De dónde viene la fiabilidad: verificación independiente de Lean y aislamiento en un entorno seguro; no hizo falta bloquear ninguna de las más de un millón de llamadas a herramientas.
- Límites de aplicación: en las tareas empresariales suele faltar un verificador como Lean, por lo que no se pueden extrapolar directamente estas cifras de eficiencia.
- Cómo empezar: con la interfaz unificada de APIYI apiyi.com se puede reproducir a pequeña escala un prototipo de colaboración entre Lead y Helper.
Resumen
Estos son los puntos centrales del experimento de los mil agentes de Claude Fable 5.2:
- El sistema importa más que un elemento aislado: la capacidad del modelo, la descomposición de tareas, el estado compartido, la ejecución en paralelo y la verificación automática contribuyeron al resultado de 28,7 horas.
- La verificación es la base de la confianza: la comprobación del núcleo de Lean permite distinguir rigurosamente entre «el modelo afirma que ha terminado» y «la tarea está realmente terminada».
- Hay que dejar claros los límites: los datos de entrada predefinidos, el uso de un modelo preliminar, la comparación de una sola ejecución y el carácter de experimento de juguete impiden interpretar el resultado de forma exagerada.
Este experimento deja sobre la mesa una pregunta importante para el sector: ¿la competencia de los sistemas de IA está pasando de las capacidades de un único modelo a la capacidad de organizar y coordinar numerosos agentes para resolver tareas complejas? Los desarrolladores pueden empezar probando un pequeño prototipo multiagente con verificación independiente. APIYI apiyi.com permite comprobar rápidamente los resultados con crédito gratuito para pruebas y una interfaz unificada para varios modelos.
📚 Referencias
- Blog de ingeniería de Anthropic: Safely scaling multi-agent teams with Claude Fable 5.2
- Enlace:
claude.dev/blog/safely-scaling-multi-agent-teams-with-fable-5-2 -
Descripción: organización del equipo, colaboración con bases de datos, mecanismos de seguridad y comparación con Opus en el segundo experimento
-
Artículo de investigación de Anthropic: Formalizing Fermat’s Last Theorem
- Enlace:
anthropic.com/research/formalizing-fermats-last-theorem -
Descripción: datos del primer experimento de formalización y método de colaboración con Prove2Me
-
Repositorio oficial de pruebas de Lean de Anthropic: primera versión de la prueba formal
- Enlace:
github.com/anthropics/fermats-last-theorem -
Descripción: código de prueba de la versión pública de septiembre; los datos del README no coinciden con las estadísticas del experimento de noviembre
-
Caso de uso oficial de Lean: Formalizing Fermat’s Last Theorem
- Enlace:
lean-lang.org/use-cases/flt -
Descripción: información sobre Lean y los fundamentos de las matemáticas formales
-
Documentación del modelo Fable 5.2: especificaciones del modelo y migración de API
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: ventana de contexto, límite de salida e información sobre precios
Autor: equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página de inicio de APIYI. Encontrarás más recursos en el centro de documentación docs.apiyi.com.