Nota del autor: con resultados y limitaciones oficiales, explicamos en qué destaca Claude Fable 5.2, hasta dónde conviene llevarlo y cuándo no deberías cambiarte desde Opus 5.5.
Claude Fable 5.2 es el modelo insignia orientado a tareas técnicas que Anthropic publicó el 2026-11-09. La recomendación de Anthropic es empezar con Opus 5.5 para la mayoría de las tareas de programación y trabajo con conocimiento. Fable 5.2 es adecuado para tareas técnicas de gran escala, más abiertas y de larga duración.
Esto no es una repetición de una clasificación. Todos los resultados del artículo proceden del anuncio de Anthropic del 2026-11-09, y las limitaciones, de la página oficial del modelo y las notas de actualización. Al terminar, tendrás claras cuatro fronteras: dónde es claramente superior, dónde no gana en todo, dónde intervienen las barreras de seguridad y dónde lo limitan los mecanismos del producto.
Valor principal: si ya usas la API de Claude, este artículo te ayudará a decidir si te conviene pasar de Opus 5.5 a Fable 5.2 y qué cambios tendrás que hacer en la factura y los parámetros de invocación.
Puntos clave de Claude Fable 5.2
Empecemos con una tabla que resume las preguntas más frecuentes. Todas las cifras proceden de la página oficial del modelo y del anuncio de lanzamiento. La información se verificó el 2026-11-10.
| Punto clave | Información oficial | Qué significa para ti |
|---|---|---|
| Posicionamiento | Modelo insignia orientado a tareas técnicas, pensado para los trabajos técnicos más complejos y abiertos | No es la opción predeterminada para el día a día; Opus 5.5 sigue siendo la opción habitual |
| Relación con Mythos | Es el mismo modelo subyacente, pero Fable tiene protecciones más estrictas y está disponible para todos los usuarios | Mythos no es un modelo distinto y más potente |
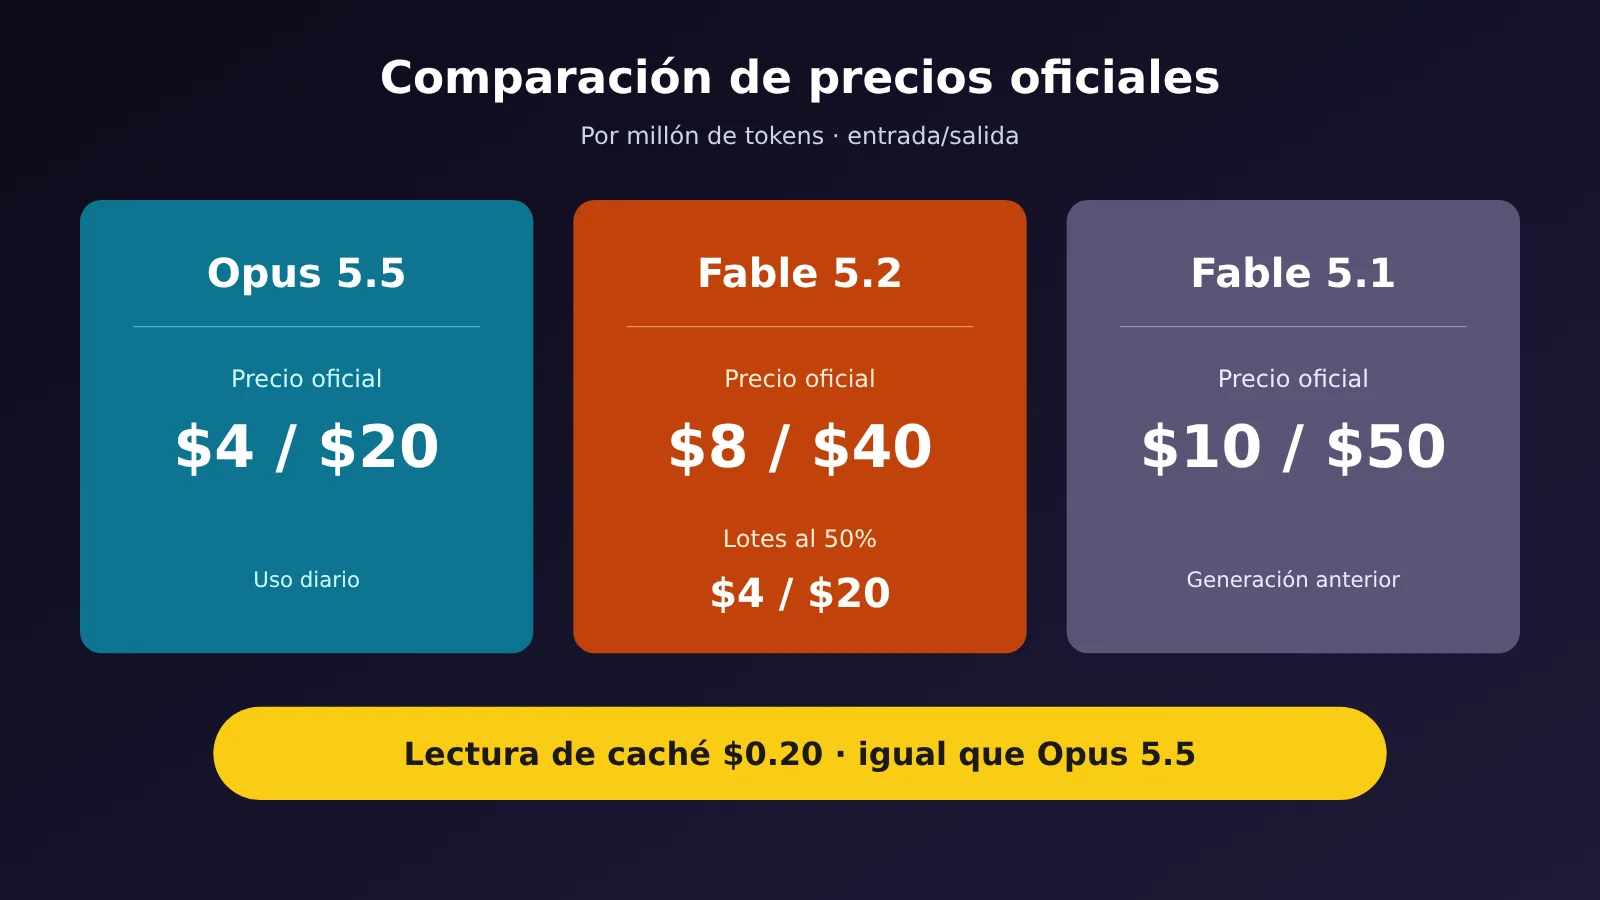
| Precio estándar | $8 por entrada y $40 por salida (por millón de tokens) | Cuesta el doble que Opus 5.5 y un 20 % menos que Fable 5.1 |
| Pensamiento | El pensamiento adaptativo está siempre activado y no se puede deshabilitar | Si quieres que el modelo dedique menos esfuerzo, solo puedes ajustar el nivel de esfuerzo |
| Retención de datos | De forma predeterminada, se exige conservar los datos durante 30 días | Si necesitas un escenario sin retención de datos, primero debes confirmar que tienes autorización |
¿Qué relación hay entre Claude Fable 5.2 y Mythos 5.2?
El anuncio de lanzamiento lo deja muy claro: Claude Fable y Claude Mythos son el mismo modelo subyacente. La diferencia es que Fable cuenta con protecciones más estrictas de ciberseguridad y bioseguridad, por lo que está disponible para todos los usuarios; Mythos solo se ofrece a organizaciones que han superado los procesos de verificación de proyectos de ciencias de la vida o ciberseguridad. Ambos tienen el mismo precio.
Por eso, decir que «Mythos es más potente» es una interpretación errónea. Algunas de las cifras de ciberseguridad y bioseguridad del anuncio, como el 76,3 % en CyScenarioBench, corresponden a Mythos 5.2, que no cuenta con protecciones equivalentes. No se deben atribuir a Fable. Para los usuarios habituales de la API, la opción disponible es Fable 5.2.
Especificaciones y precios oficiales de Claude Fable 5.2
La siguiente tabla compara tres modelos de la página oficial. No se pudieron obtener las especificaciones completas de Fable 5.1, así que sus precios aparecen más adelante.
| Especificación | Claude Fable 5.2 | Claude Opus 5.5 | Claude Sonnet 5.5 |
|---|---|---|---|
| Contexto | 1M tokens | 1M tokens | 1M tokens |
| Salida máxima (API Messages síncrona) | 128K | 128K | 128K |
| Precio estándar (entrada / salida) | $8 / $40 | $4 / $20 | $2 / $10 |
| Nivel de latencia | Moderate | Moderate | Fast |
| Esfuerzo predeterminado en Claude API | high | medium | high |
| Fecha de corte del conocimiento | junio de 2026 | junio de 2026 | junio de 2026 |
Fable 5.2 recibe texto e imágenes y genera texto. La página del modelo estima que 1M de tokens equivalen a unos 555.000 términos o 2,5 millones de caracteres Unicode. Esta equivalencia se basa en el tokenizador actual y no significa que necesariamente quepa esa cantidad de texto en chino.
Hay que tener en cuenta que algunos modelos pueden generar hasta 300K tokens de salida en la API Message Batches mediante un encabezado beta. Opus 5.5 aparece en la lista, pero Fable 5.2 no. Hasta que la documentación oficial indique lo contrario, calcula un máximo de 128K tokens para planificar salidas largas.
El resto de los precios oficiales, por cada millón de tokens:
- Caché: escribir en caché durante 5 minutos cuesta $10; durante 1 hora, $16; leer desde la caché cuesta $0.20. La lectura desde la caché equivale a 0,025 veces el precio estándar de entrada.
- Procesamiento por lotes: la entrada y la salida cuestan la mitad del precio estándar. Para Fable 5.2, el precio por lotes es de $4 para la entrada y $20 para la salida.
- Modo rápido: es el mismo modelo y mantiene la misma capacidad, pero alcanza una velocidad de salida de hasta 2,5 veces la estándar. Cuesta $16 para la entrada y $80 para la salida. El modo rápido de Opus 5.5 cuesta $8 / $40.
- Caché en modo rápido: la documentación no detalla estos precios; solo indica que los multiplicadores de caché se aplican sobre los precios del modo rápido. Según esos multiplicadores, la lectura desde la caché costaría alrededor de $0.40; escribir durante 5 minutos, $20; y durante 1 hora, $32.
- Campo del modo rápido: en Claude API, el campo es
speedy su valor esfast. En Microsoft Foundry se usa otro ID de modelo que termina en-fast; no incluyasspeeden la solicitud.
Hay otro detalle fácil de pasar por alto: los distintos modos de velocidad no comparten la caché de indicaciones. Al volver del modo rápido al estándar, se producirá un fallo de caché. El anuncio no incluye Amazon Bedrock entre los canales disponibles para el modo rápido, aunque el modelo estándar sí está disponible en Bedrock con el ID anthropic.claude-fable-5-2.
Datos oficiales de rendimiento de Claude Fable 5.2
Estas cuatro cifras muestran mejor que nada en qué destaca Fable 5.2. Anthropic las publicó el 2026-11-09. Salvo que se indique lo contrario, las puntuaciones de Fable 5.2, Fable 5.1 y Opus 5.5 se obtuvieron con las salvaguardas activadas. La metodología de la tabla es la siguiente: cada modelo se evaluó con el nivel de esfuerzo más alto disponible en ese momento, salvo que se indique otro nivel.
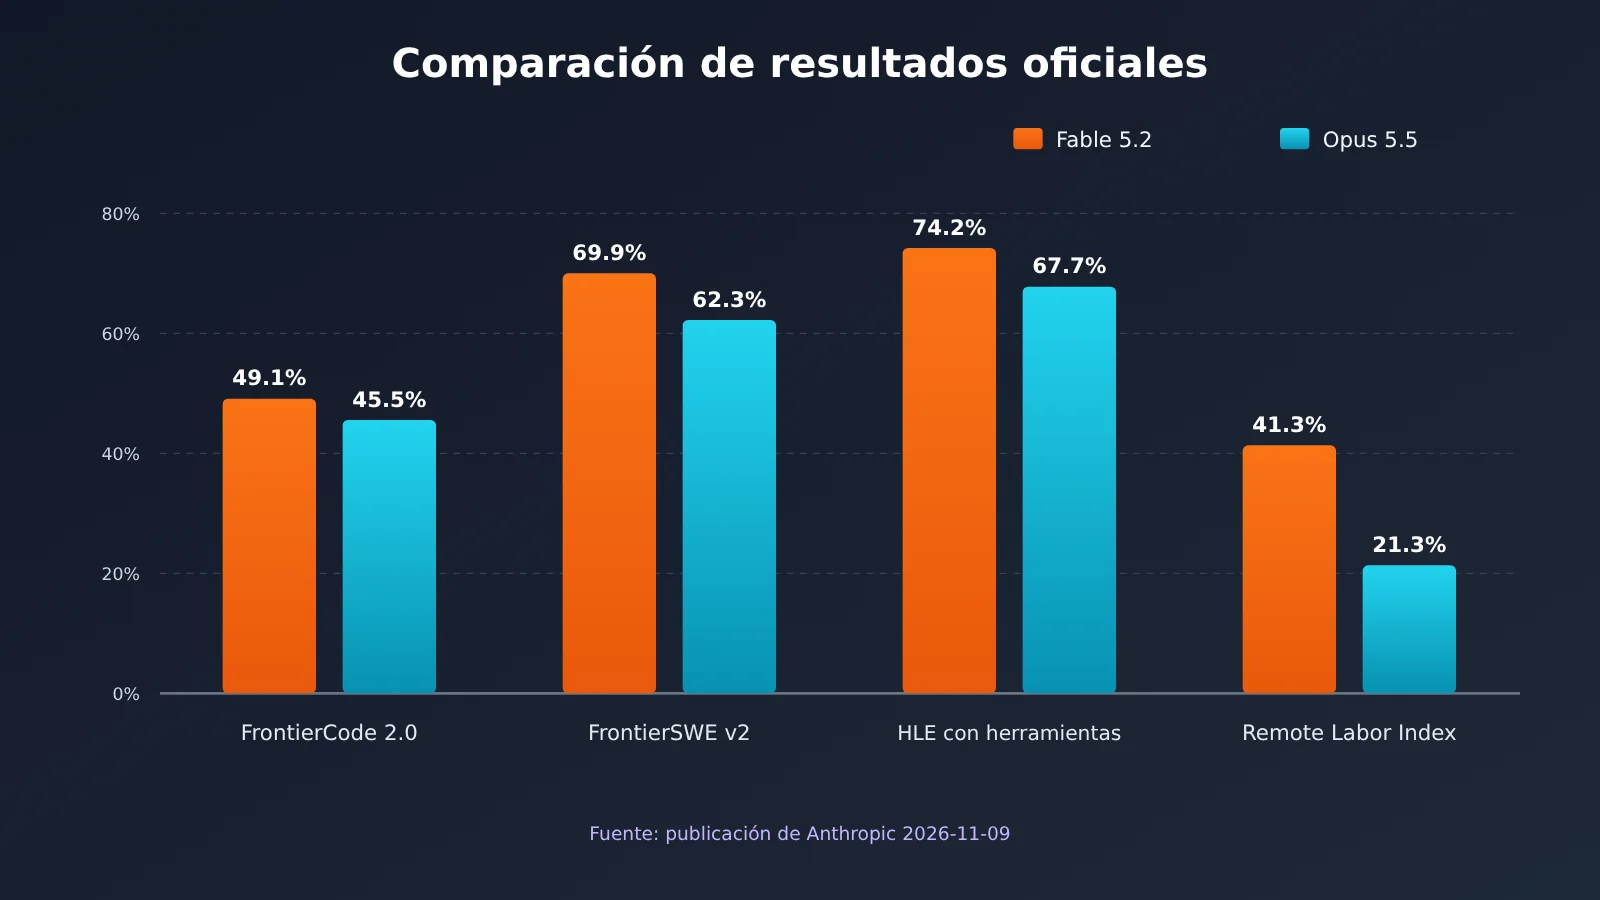
| Prueba de referencia | Fable 5.2 | Nota sobre el nivel | Comparación con Opus 5.5 |
|---|---|---|---|
| FrontierCode 2.0 | 49.1% | La tabla especifica el nivel Xhigh | 45.5% (criterio predeterminado de la tabla; corresponde a su nivel de esfuerzo más alto) |
| FrontierSWE v2 | 69.9% | No se especifica otro nivel; corresponde al nivel de esfuerzo más alto | 62.3% (nivel de esfuerzo más alto) |
| Humanity’s Last Exam (con herramientas) | 74.2% | No se especifica otro nivel; corresponde al nivel de esfuerzo más alto | 67.7% (nivel de esfuerzo más alto) |
| Remote Labor Index | 41.3% | La tabla especifica el nivel High, no el más alto | 21.3% (nivel de esfuerzo más alto) |
Cómo interpretar los resultados de Claude Fable 5.2 en programación
FrontierCode mide si los mantenedores de repositorios de código abierto aceptarían los cambios, así que se acerca más a la ingeniería real que limitarse a comprobar si pasan las pruebas. El 49,1 % del nivel Xhigh es la cifra más alta entre los modelos publicados que Anthropic ha evaluado. El anuncio también ofrece un dato más práctico: Fable 5.2 en el nivel High obtiene alrededor de un 45,3 %, casi lo mismo que el mejor resultado de Opus 5.5, un 45,5 %, con aproximadamente la mitad del costo por tarea.
Este dato es importante para quienes hacen cálculos de costos. Indica que el valor de Fable 5.2 no consiste solo en alcanzar una cifra más alta en el nivel máximo: en el nivel High también podría completar el mismo trabajo con menos tokens. Eso sí, es lo que Anthropic afirma sobre este benchmark; tendrás que comprobar por tu cuenta cómo se comporta en tus repositorios.
La diferencia más grande aparece en Remote Labor Index: 41,3 % frente a 21,3 %. Además, Fable 5.2 obtuvo esa cifra en el nivel High, no en el máximo. Este tipo de tareas se centra en completar trabajos remotos de principio a fin, lo que encaja con su enfoque en «trabajo técnico abierto y de larga duración».
Los casos de tareas largas de Claude Fable 5.2 son experimentos aislados
El anuncio incluye varias historias llamativas. Al leerlas, conviene fijarse en quién realizó el trabajo y cuántas veces se repitió el experimento:
- Sistema operativo prototipo: un ingeniero pidió a Fable 5.2 que empezara desde una carpeta vacía, coordinara a más de 1000 subagentes y trabajara durante unos 8 días seguidos para crear un sistema capaz de arrancar en una computadora portátil. El anuncio no indica que el experimento se repitiera, así que hay que considerarlo una prueba oficial aislada.
- Formalización del último teorema de Fermat: 1000 agentes de Fable 5.2 trabajaron durante 30 horas, con muy poca intervención humana. Con la misma configuración, Opus 5.5 completó alrededor del 26 % en 18 horas y apenas avanzó después de 30 horas. El pie de imagen especifica que cada modelo se ejecutó una sola vez.
- Migración de Python a Rust: la migración de un servicio de producción crítico a Rust, que arrancó unas 26 veces más rápido, la realizó un grupo de agentes de una versión anterior de Fable 5.2, no de la versión 5.2 publicada.
- El 90 % de los cambios aceptados: el anuncio señala que Claude escribió más del 90 % de los cambios aceptados en el código base principal, con orientación humana. El sujeto es Claude, no Fable 5.2 en particular.
Estos casos muestran el potencial, pero no son una garantía de resultados constantes. Si tu actividad depende de que el modelo trabaje durante varios días seguidos, considéralo una hipótesis que tendrás que reproducir por tu cuenta.
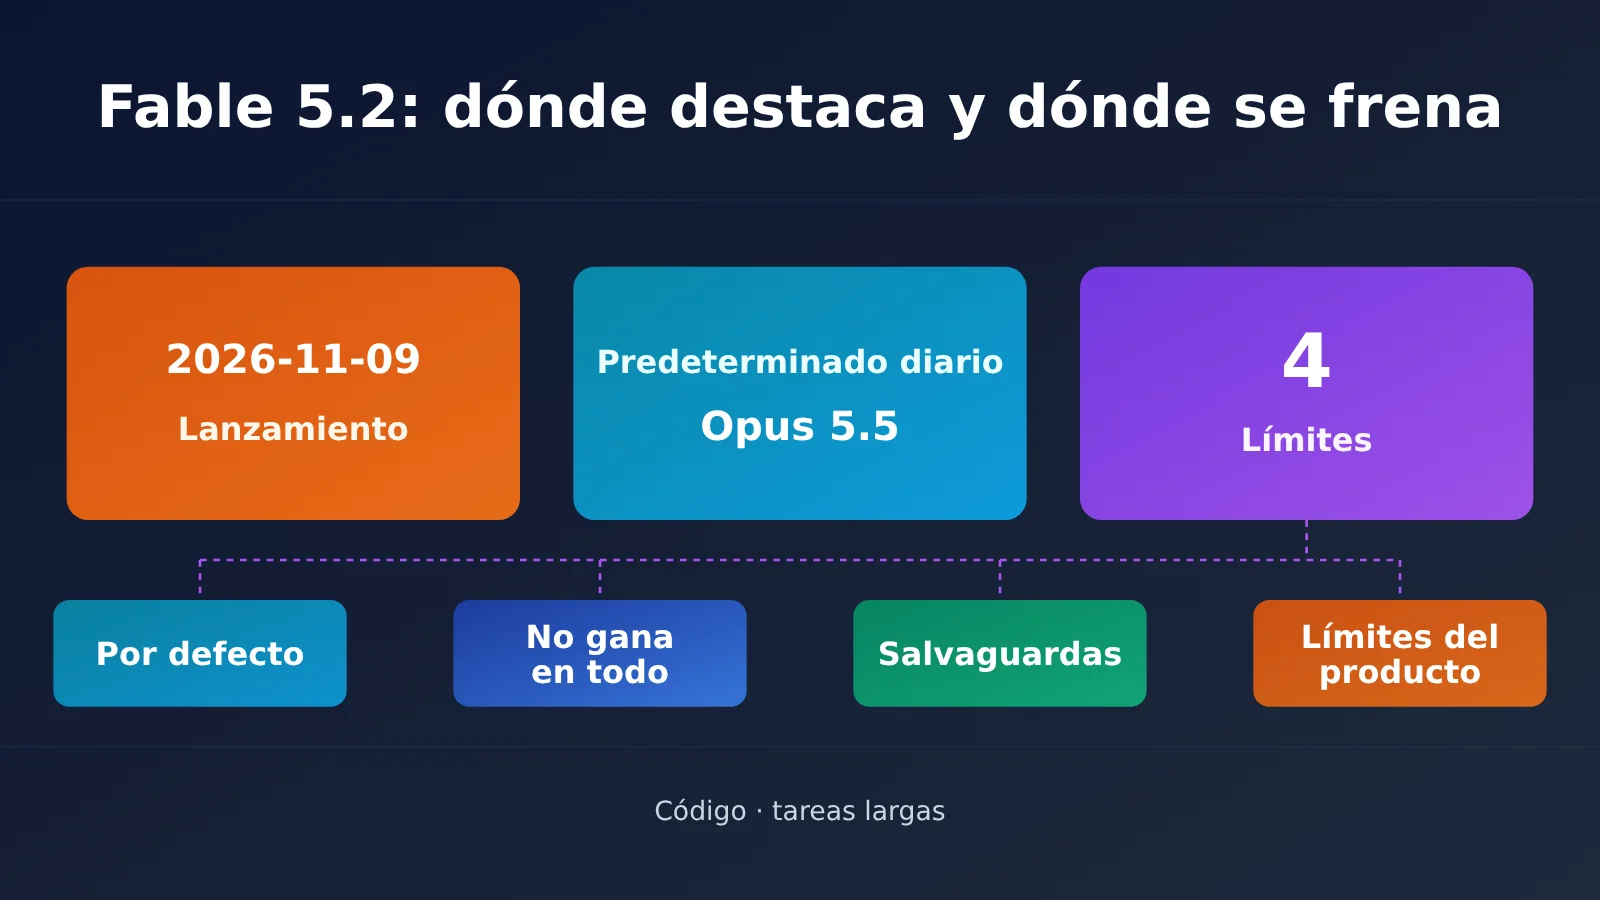
Los 4 límites de Claude Fable 5.2
Los resultados muestran en qué destaca. Estos cuatro puntos explican hasta dónde llega su ventaja y dónde conviene detenerse. El orden es: «selección del modelo → capacidades → seguridad → mecanismos del producto».
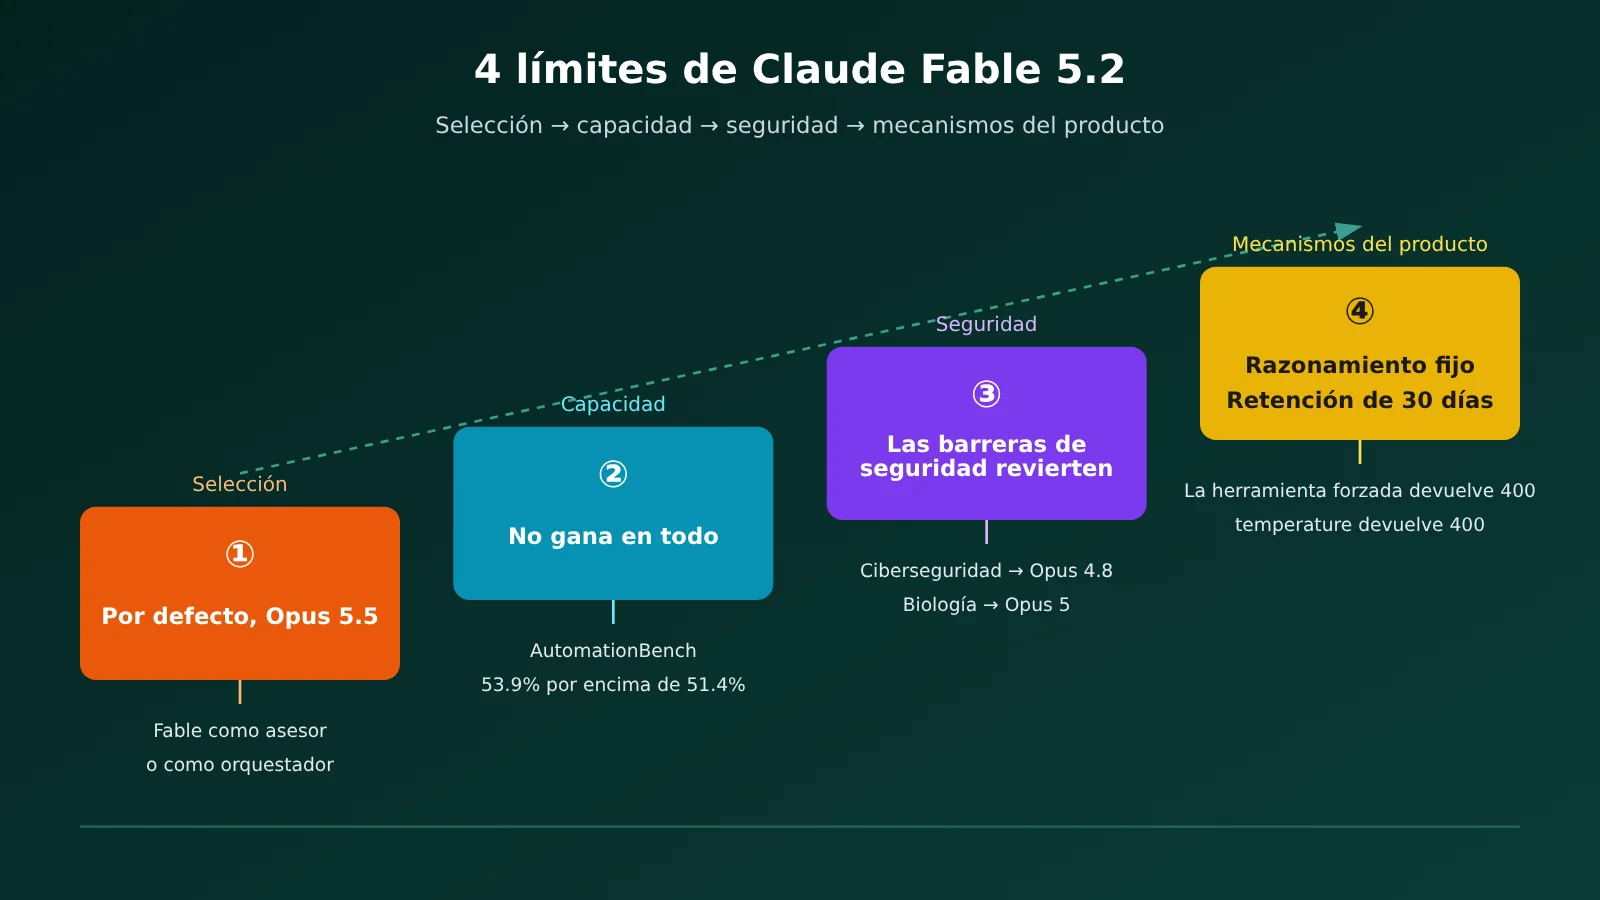
Límite 1: Claude Fable 5.2 no es la opción predeterminada para el día a día
La recomendación del anuncio es empezar con Opus 5.5 para la mayoría de las tareas de programación y conocimiento, subir a Fable o Mythos si la dificultad lo requiere, o bajar a Sonnet 5.5 o Haiku 5.5. Fable 5.2 es más adecuado para los trabajos técnicos más exigentes y abiertos.
También hay dos formas de usarlo con menos gasto. La primera es como asesor: los modelos más pequeños pueden consultarlo cuando se atasquen. La segunda es como coordinador: divide las tareas y asigna las partes sencillas a modelos más pequeños. Así, los tokens más caros se reservan para el paso más difícil.
Límite dos: el balance de Claude Fable 5.2 no es una victoria total
Los modelos de comparación de la publicación de lanzamiento son GPT-6 Astra y Gemini 4 Carbon. La tabla la elaboró Anthropic; no es una clasificación publicada por OpenAI o Google. Incluso en esta tabla, Fable 5.2 pierde en algunas categorías.
| Referencia | Fable 5.2 | Líder | Nota |
|---|---|---|---|
| AutomationBench | 51.4% | Gemini 4 Carbon 53.9% | Carbon obtiene una puntuación más alta |
| AA-Briefcase v1.1 Elo | 1785 | Opus 5.5 1800 | Opus lidera en Elo |
| Puntuación por reglas de AA-Briefcase v1.1 | 66.1% | Fable 5.2 | Opus 5.5 obtiene un 61.2% |
| Chartography (sin herramientas) | 73.4% | Fable 5.2 | Carbon alcanza el 72.5% y Astra, el 71.0%; la diferencia es pequeña |
Vale la pena mirar con más detalle la fila de AA-Briefcase. Fable lidera en la puntuación por reglas, pero Opus lo hace en Elo. Esto indica que, en evaluaciones más subjetivas y basadas en preferencias, un modelo más caro no necesariamente resulta más popular. Si tu tarea consiste en redactar informes breves o trabajar con documentos, Opus 5.5 no es una opción de segunda categoría.
Límite tres: las barreras de seguridad de Claude Fable 5.2 cambian quién responde
Cuando un clasificador de seguridad bloquea una solicitud, Fable 5.2 no se queda sin responder: las consultas de ciberseguridad pasan a Opus 4.8 y las de biología, a Opus 5. Las solicitudes rechazadas devuelven un HTTP 200 y tienen stop_reason con el valor refusal. Tu código debe comprobar este campo, no limitarse a revisar el código de estado. Que se cobre o no por una respuesta rechazada antes de generarse depende de la categoría del rechazo, pero en todos los casos consume cuota de velocidad.
Hay otra limitación menos evidente: las capacidades directamente relacionadas con la investigación y el desarrollo de IA están restringidas intencionalmente. En tareas de optimización de kernels para aceleradores y de mejora de la arquitectura de modelos de lenguaje grandes, el rendimiento se limita aproximadamente al nivel de Opus 5.5. En unos pocos temas, incluido el desarrollo de kernels para ciertos aceleradores no estándar, durante la inferencia se cambia de forma transparente a Opus 5; esto no significa que la llamada haya fallado. La programación con agentes, el desarrollo de hardware y la investigación en aprendizaje automático tradicional no están sujetos a esta limitación.
Las pruebas preliminares oficiales indican que Fable 5.2 bloquea alrededor de un 55 % menos de solicitudes que Fable 5.1 en claude.ai, Claude Code y Cowork; la reducción es de aproximadamente un 60 % en ciberseguridad y un 40 % en biología. Se trata de pruebas preliminares oficiales, no de una verificación independiente.
Límite 4: Claude Fable 5.2 tiene restricciones estrictas de producto
Estos puntos afectan directamente a tu código de invocación actual. Revísalos uno por uno antes de migrar:
- No se puede desactivar el pensamiento: el pensamiento adaptativo está siempre activado. En el nivel
mediumy superiores, escribir «no pienses, responde directamente» en la indicación no detiene el pensamiento. Si quieres que piense menos, solo puedes reducir el nivel deeffort. - Forzar la devolución de herramientas devuelve un error 400: se produce un error cuando
tool_choiceesanyotool. - Los parámetros de muestreo devuelven un error 400: no envíes
temperature,top_pnitop_k. - Retención de datos durante 30 días: no se puede optar por la retención cero salvo que Anthropic lo autorice expresamente. Las empresas que cumplen los requisitos pueden usar la retención cero antes de incorporarse a Enterprise Frontier Safeguards; para el resto de los clientes, los datos se conservan durante 30 días para supervisar la seguridad.
- Las tareas largas pueden detenerse por sí solas: a veces se detiene tras una sola ronda, deja una lista de tareas pendientes, dice que puede continuar o se queda bloqueado ante un obstáculo corriente. Esto es más habitual en el nivel
low. Durante una secuencia larga de invocaciones de herramientas, puede que diga muy poco al usuario. - Los bloques de pensamiento no son compatibles con todos los modelos: solo Fable 5.2 y Mythos 5.2 pueden leer los bloques de pensamiento de Fable 5.2. Si Fable 5.2 actúa como ejecutor, el modelo asesor también debe ser Fable 5.2 o Mythos 5.2.
Además, el anuncio de lanzamiento advierte que indicar en la indicación «quién es el propietario del código» influye en si modifica la estructura existente o empieza desde cero. Sigue las reglas de estilo al pie de la letra, pero si limitas demasiado la longitud de las frases, la respuesta puede quedar entrecortada.
Claude Fable 5.2: qué modelos están disponibles y cuáles todavía no
A fecha de 2026-11-10, comprobamos el catálogo completo de modelos y la interfaz pública de precios de APIYI apiyi.com. En ninguno de los dos aparece claude-fable-5-2, ni tampoco ningún modelo Mythos. Lanzaremos este modelo lo antes posible. Para consultar los modelos y sus precios, toma como referencia la lista de modelos de la plataforma.
Mientras llega, puedes usar Opus 5.5, que ya está disponible, para el trabajo diario y reservar Fable 5.2 para las tareas más difíciles. Si necesitas ahora mismo un modelo de la gama Fable, la lista incluye Fable 5.1, pero no es la versión 5.2: sus resultados y comportamiento son diferentes.
| ID del modelo | Estado en APIYI apiyi.com | Precio de lista (entrada / salida / lectura de caché, por millón de tokens) | Endpoints |
|---|---|---|---|
claude-opus-5-5 |
Disponible (también hay una versión -thinking) |
$4 / $20 / $0.2 | chat, messages |
claude-fable-5-1 |
Disponible (también hay una versión -thinking) |
$10 / $50 / $0.25 | chat, messages |
claude-fable-5-2 |
No disponible | Sin precio por ahora; consulta la lista de modelos de la plataforma | — |
claude-mythos-5-2 |
No disponible | Sin precio por ahora | — |
Los precios en dólares de la tabla son precios de lista. El cargo real también depende del multiplicador del grupo de tokens; consulta tu factura. Como Fable 5.2 no aparece en la lista, tampoco hay un precio al que aplicar ese multiplicador. No calcules por tu cuenta cuánto te cobrará APIYI a partir del precio oficial. Para conectarte, APIYI ofrece una interfaz compatible con OpenAI con base_url https://api.apiyi.com/v1. Con una sola clave puedes alternar entre Opus 5.5 y Fable 5.1. Si eres un usuario nuevo, tienes crédito de prueba gratuito para comparar ambos modelos en tu propio repositorio.
Resumen de ventajas y desventajas de Claude Fable 5.2
Ventajas
- Es mucho mejor en tareas abiertas y largas: en el nivel High del Remote Labor Index, su resultado casi duplica el de Opus 5.5.
- Buena relación calidad-precio en el nivel High: en FrontierCode alcanza aproximadamente un 45,3 %, a la altura del mejor resultado de Opus 5.5, y el costo por tarea es aproximadamente la mitad (según la información oficial).
- Más barato y rápido que la versión 5.1: el precio estándar es un 20 % menor y, según el anuncio de lanzamiento, genera respuestas hasta un 30 % más rápido que la versión 5.1.
- La lectura de caché no es cara: cuesta $0.20, lo mismo que en Opus 5.5.
Limitaciones
- El precio estándar duplica el de Opus 5.5: si lo usas para tareas cotidianas, la factura se duplicará.
- No gana en todas las pruebas: pierde ante Gemini 4 Carbon en AutomationBench y ante Opus 5.5 en la puntuación Elo de AA-Briefcase.
- Límites en las medidas de seguridad y en el techo de capacidad: las consultas sobre ciberseguridad y biología se responden con modelos anteriores; la optimización del kernel y las mejoras en la arquitectura del modelo son, más o menos, las mismas que en Opus 5.5.
- Tiene varias restricciones de uso: no se puede desactivar el razonamiento; el uso obligatorio de herramientas y ciertos parámetros de muestreo pueden provocar un error 400; los datos se conservan por defecto durante 30 días; y las tareas largas pueden detenerse por sí solas.
Preguntas frecuentes
Q1: ¿Qué diferencia hay entre Claude Fable 5.2 y Fable 5.1?
En cuanto al precio, la tarifa estándar de la versión 5.2 es de $8 por entrada y $40 por salida, un 20 % menos que los $10 / $50 de la versión 5.1. La lectura de caché también baja de $0.25 a $0.20. En cuanto a los resultados, FrontierSWE v2 pasa del 56,3 % al 69,9 %, y Remote Labor Index, del 17,9 % al 41,3 %. En cuanto al comportamiento, la versión 5.1 suele seguir las indicaciones de «no pienses», pero la 5.2 no lo hace en los niveles medium o superiores. Por ahora, en APIYI apiyi.com está disponible `claude-fable-5-1`, pero la versión 5.2 todavía no se ofrece.
Q2: ¿Claude Mythos 5.2 es un modelo más potente?
No. El anuncio de lanzamiento indica que Fable y Mythos utilizan el mismo modelo subyacente. Mythos tiene menos medidas de seguridad para ciberseguridad y biología, por lo que solo está disponible para organizaciones cuyos proyectos hayan sido verificados. Su precio es el mismo que el de Fable 5.2. Algunos resultados de ciberseguridad y biología del anuncio se atribuyen a Mythos, así que no deben citarse como resultados de Fable 5.2.
Q3: ¿Se puede desactivar el razonamiento de Claude Fable 5.2?
No. El razonamiento adaptativo está siempre activado y las indicaciones tampoco pueden detenerlo. Para controlar la cantidad de razonamiento y el costo, solo puedes bajar el nivel de effort. En Claude API, el valor predeterminado es high; en la aplicación Claude y en Claude Code, es Medium. Ten en cuenta que en el nivel low es más probable que el modelo se detenga tras una sola ronda y deje una lista de tareas pendientes, así que no se recomienda usarlo para tareas largas.
Claude Fable 5.2: puntos clave
- Posicionamiento: modelo insignia para tareas técnicas, lanzado el 9 de noviembre de 2026. Opus 5.5 sigue siendo la opción predeterminada para el día a día.
- Puntos fuertes: alcanza un 69,9 % en FrontierSWE v2 y un 41,3 % en el nivel High del Remote Labor Index.
- No gana en todo: queda por detrás de Carbon en AutomationBench y de Opus en el Elo de AA-Briefcase.
- Protecciones: las consultas de ciberseguridad pasan a Opus 4.8 y las de biología, a Opus 5. Para detectar rechazos, revisa
stop_reason. - Limitaciones del producto: el modo de razonamiento siempre está activado; forzar herramientas o parámetros de muestreo provoca un error 400. Los datos se conservan por defecto durante 30 días.
- Ejemplos de tareas largas: los casos del sistema operativo, de 8 días, y de Fermat, de 30 horas, son experimentos oficiales de una sola ejecución.
- Disponibilidad: al 10 de noviembre de 2026, APIYI aún no ofrece la versión 5.2. Mientras tanto, puedes usar Opus 5.5 y Fable 5.1.
Resumen: cuándo no conviene cambiar a Claude Fable 5.2
Fable 5.2 destaca de verdad, pero sobre todo en tareas técnicas abiertas y de larga duración. En estos cuatro casos, es mejor seguir con Opus 5.5 o usar Fable solo como asesor o coordinador:
- Si el presupuesto es ajustado: el precio estándar duplica el de Opus 5.5, y el modo rápido vuelve a duplicarlo.
- Si necesitas que no se conserven datos: la retención predeterminada es de 30 días; no es posible desactivarla sin autorización.
- Si necesitas realizar tareas de ciberseguridad o biología que activan las protecciones: una vez bloqueadas, Opus 4.8 u Opus 5 se hacen cargo, así que no podrás aprovechar las capacidades de Fable.
- Si solo necesitas programar para el día a día: la propia recomendación oficial es empezar con Opus 5.5.
Si tu tarea realmente requiere el máximo nivel de capacidad y apertura, primero puedes poner el flujo de trabajo a punto con Opus 5.5 y luego delegar el paso más difícil a Fable. Cuando la versión 5.2 esté disponible, consulta la lista de modelos de la plataforma para confirmar el modelo y el precio.
Autor: equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página de inicio de APIYI. Encontrarás más información en el centro de documentación, en docs.apiyi.com.