Nota del autor: una guía para clasificar los errores de una API de modelos por código, saber cuándo reintentar, cuándo cambiar a un modelo alternativo y cuándo detenerse a corregir la configuración. Incluye tablas de clasificación y verificación, además de una lista de comprobación para el lanzamiento.
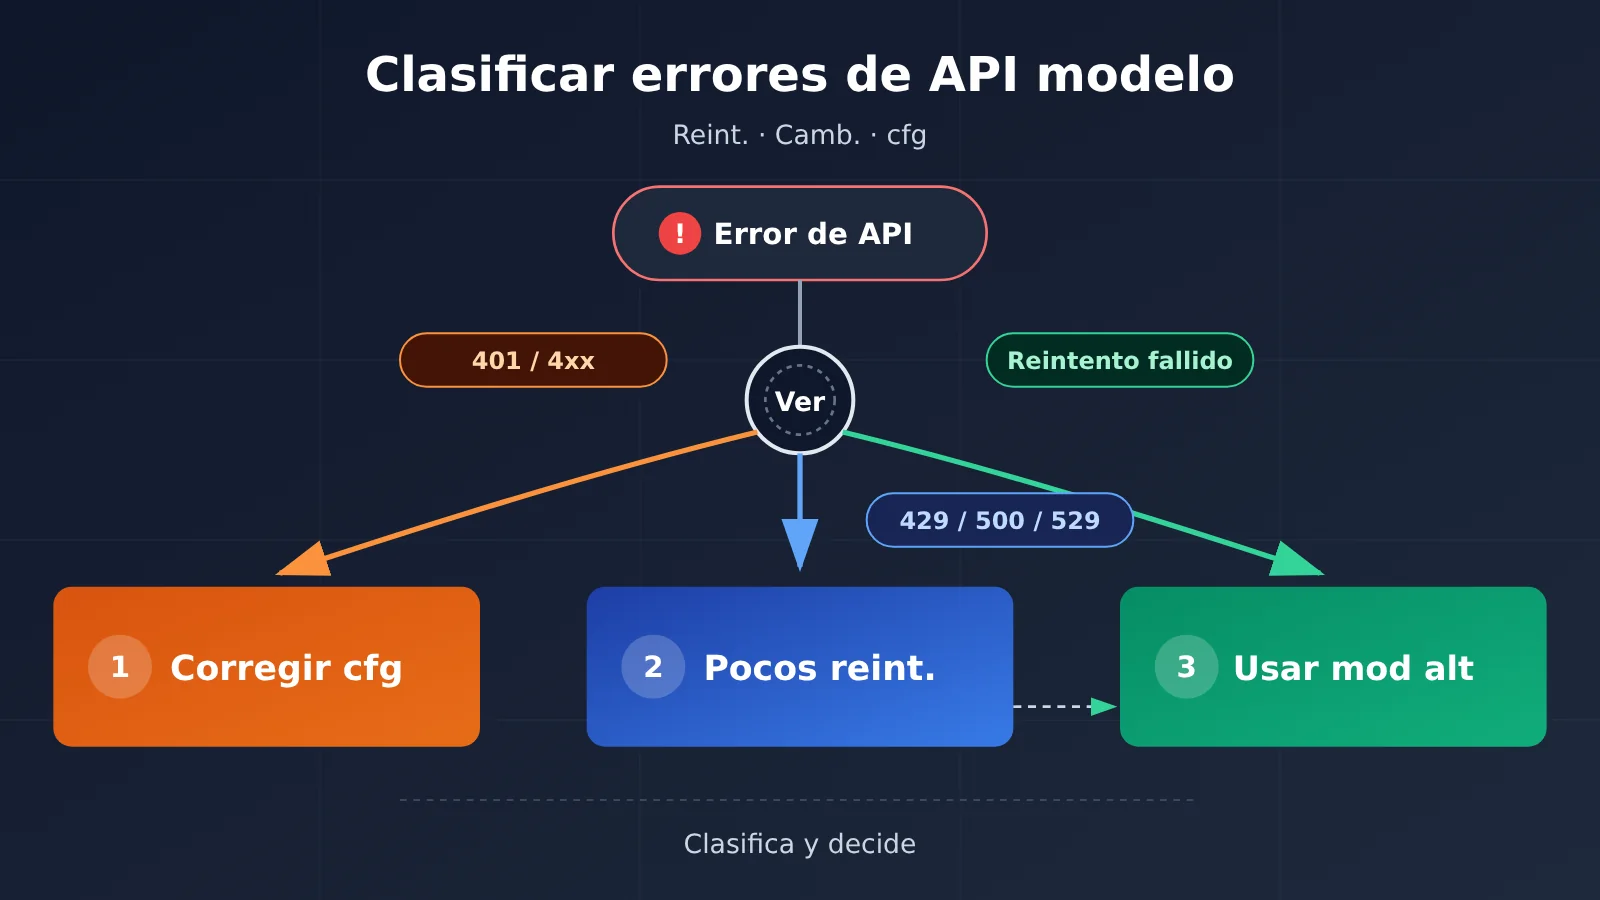
Cuando falle una API de modelos, identifica primero el tipo de error y después decide cómo actuar. La mayoría de los errores 4xx indican un problema en la solicitud o en la configuración: reintentar no lo solucionará. Los errores 5xx, 529 y los tiempos de espera agotados sí justifican un número limitado de reintentos; si siguen fallando, cambia a un modelo alternativo. No reintentes automáticamente las solicitudes que no tengan una garantía de idempotencia. Reintentar no debe ser la opción predeterminada, y cambiar de modelo tampoco resuelve todos los problemas. Muchos incidentes en producción no se deben a una caída del modelo, sino a una lógica de gestión de errores que convierte un fallo menor en cobros duplicados, escrituras duplicadas en la base de datos y límites de solicitudes en toda la cadena.
Este artículo no es una traducción de un diccionario de códigos de error. Está dirigido a desarrolladores que ya integraron una API de modelos en un entorno de producción o preproducción, y se centra en cómo evitar que un error empeore la situación. Al terminar, tendrás una tabla para clasificar errores, una estrategia de reintentos y recuperación, una tabla para verificar las capacidades del modelo alternativo y una lista de comprobación para seguir antes del lanzamiento. Todo se resume en una regla: ante un 4xx, corrige primero; ante un 5xx, considera reintentar; si la solicitud no es idempotente, detente.
Las 5 categorías de errores de la API de modelos: primero clasifica, luego decide si reintentar o cambiar
La conclusión primero: los errores de la API de modelos se dividen en cinco categorías, y cada una tiene una pauta de actuación bastante clara. Si primero clasificas el código de error, será más fácil decidir cuándo reintentar y cuándo cambiar de modelo o ruta.
| Categoría de error | Códigos de estado típicos | Origen del problema | Acción por defecto |
|---|---|---|---|
| Error de solicitud | 400, 404, 409, 422 |
Cuerpo de la solicitud, parámetros, ID del modelo o endpoint | No reintentar; corregir la solicitud |
| Error de autenticación o autorización | 401, 403 |
Clave, encabezados, permisos, región o políticas | No reintentar; comprobar la clave y los permisos |
| Cuota o límite de solicitudes | 402, 429 |
Saldo, concurrencia, tasa de solicitudes o cuota del modelo | Con 402, detenerse; con 429, revisar el cuerpo del error y aplicar una espera progresiva o cambiar |
| Fallo del servicio upstream | 500, 502, 503, 529 |
Gateway, servicio upstream o sobrecarga | Reintentar un número limitado de veces y, si falla, cambiar |
| Tiempo de espera agotado o interrupción del flujo | 408, 504, tiempo de espera de red agotado, desconexión del flujo |
Conexión, respuesta extensa o lentitud del servicio upstream | Confirmar primero si ya se ejecutó o facturó; reintentar solo si es idempotente |
La clave para clasificar los errores: distinguir entre «reintentar» y «cambiar»
Reintentar significa enviar de nuevo la solicitud al mismo modelo y por la misma ruta; sirve para resolver fallos transitorios. Cambiar significa usar otro modelo u otra ruta, y es útil cuando un servicio upstream permanece indisponible. Los costes son distintos: reintentar añade latencia y puede generar cargos duplicados; cambiar puede afectar la calidad de la respuesta, la compatibilidad con las llamadas a herramientas y el coste.
Por eso, el orden de clasificación consta de tres pasos: confirmar la categoría del error, comprobar si la solicitud es idempotente y, por último, elegir entre reintentar, cambiar o detenerse. Saltarse el segundo paso es lo más peligroso: ejecutar por segunda vez una llamada a una herramienta que ya se completó puede tener consecuencias que van más allá de «gastar un poco más».
Por qué «reintentar todo» agrava los errores de la API del modelo
En resumen: reintentar todos los errores puede parecer una medida prudente, pero en realidad amplifica los costos, los efectos secundarios y las limitaciones de tasa. En producción, los incidentes causados por esta lógica suelen ser más difíciles de investigar que el error original.
El primer problema es el cobro duplicado. Una interrupción de la respuesta en streaming no significa necesariamente que la solicitud haya fallado: el proveedor puede haber generado ya algunos tokens, y estos pueden haberse cobrado. Repetir la solicitud a ciegas equivale a pagar dos veces por la misma tarea, algo especialmente notable cuando la salida es larga.
El segundo problema es la ejecución duplicada. En un escenario con agentes, una solicitud al modelo puede activar escrituras en la base de datos, envío de mensajes, creación de tareas e incluso pagos. Si se agota el tiempo de espera durante la invocación de una herramienta, no sabes si esta llegó a ejecutarse; si repites la solicitud completa en ese momento, podrías terminar con dos pedidos o dos correos electrónicos.
El tercer problema es que se agravan las limitaciones de tasa. Un 429 es, en esencia, la forma que tiene el proveedor de decir «más despacio». Si el cliente responde con reintentos concurrentes e inmediatos, solo aumenta la presión. Otro error habitual es reintentar todos los 4xx: un 401 puede deberse a una clave incorrecta, pero, tras varias rondas de reintentos, el volumen de solicitudes alcanza el límite y los registros acaban llenos de errores 429, lo que oculta la causa real.
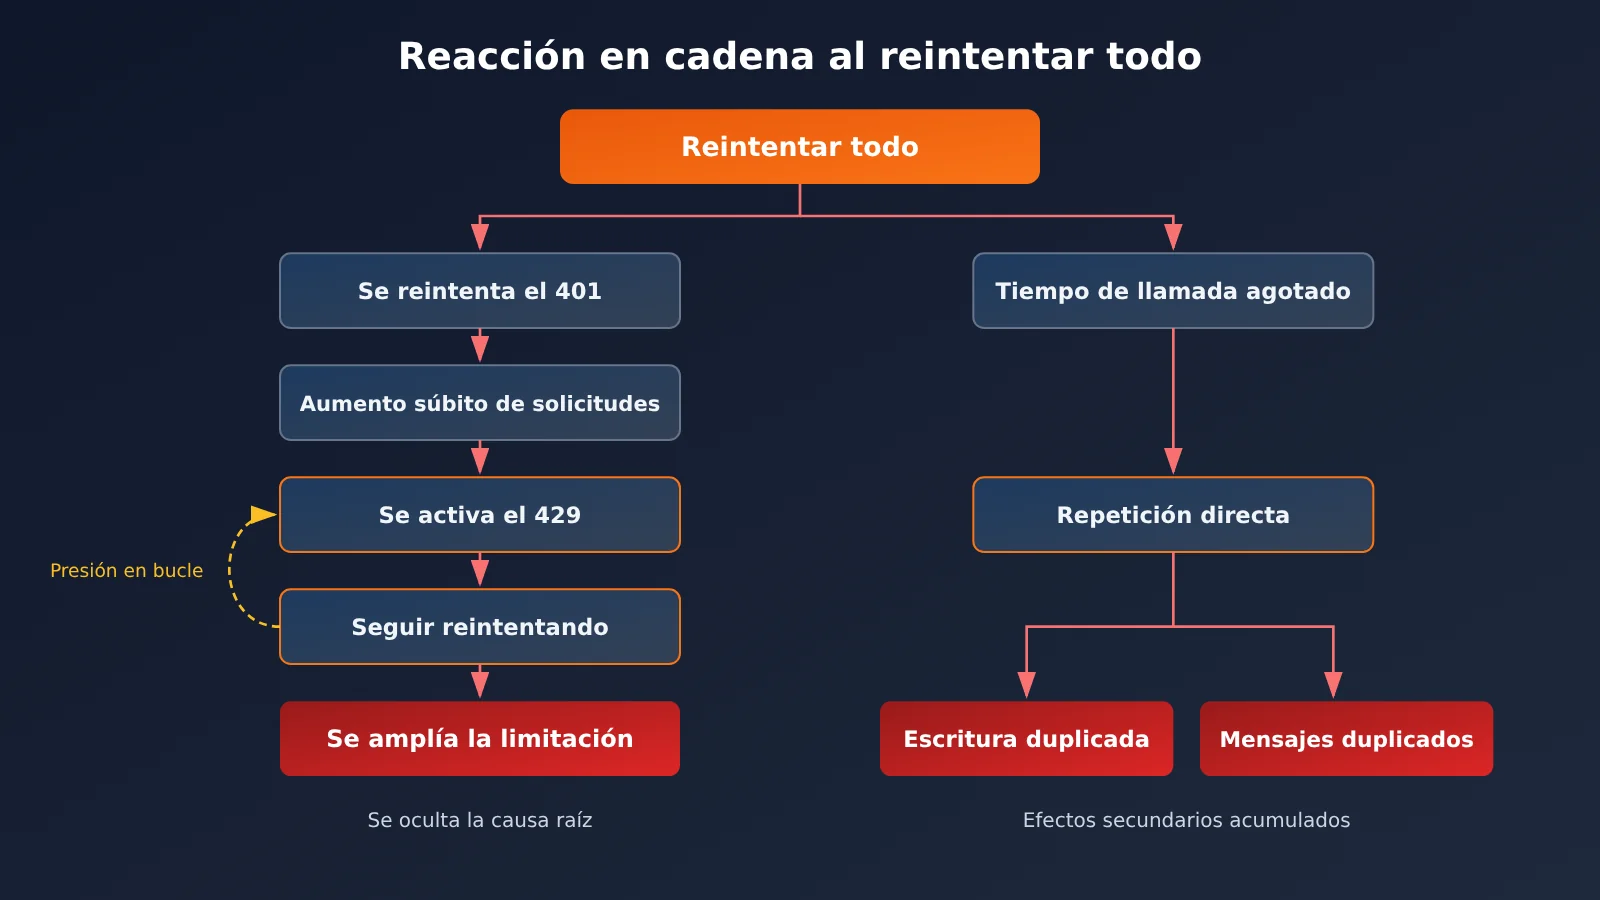
Tabla de diagnóstico de errores 401, 429, 500 y 529: cuándo reintentar y cuándo cambiar
En resumen: la siguiente tabla cubre los 14 códigos de estado más comunes en producción. Solo unos pocos justifican un reintento; cambia de alternativa cuando hayas confirmado que reintentar no funciona. La columna «¿Cambiar?» se refiere a usar un modelo o una ruta de respaldo. El significado concreto depende del cuerpo del error y de la documentación de cada proveedor.
| Código de estado | Significado habitual | ¿Reintentar? | ¿Cambiar? | Acción |
|---|---|---|---|---|
400 |
Formato o parámetros de la solicitud incorrectos | No | No | Corrige el cuerpo de la solicitud y revisa los campos y sus tipos |
401 |
Clave no válida o fallo de autenticación | No | No | Revisa la clave, el encabezado Authorization y la URL base |
402 |
Saldo insuficiente o cuota agotada | No | Cambiar de ruta según el caso | Recarga saldo o cambia a una ruta con cuota disponible y genera una alerta |
403 |
Acceso denegado por permisos, región o políticas | No | No | Revisa los permisos de la cuenta, la autorización del modelo y las restricciones regionales |
404 |
El modelo o el endpoint no existe | No | No | Comprueba el ID del modelo y la ruta del endpoint |
408 |
Tiempo de espera de la solicitud agotado | Reintentos limitados si la operación es idempotente | Opcional | Confirma que no se ejecutó y reintenta una vez |
409 |
Conflicto o estado inconsistente | No | No | Revisa el estado de la operación y evita escrituras concurrentes |
422 |
Fallo de validación de parámetros | No | No | Corrige los parámetros; es habitual con el esquema de salida estructurada |
429 |
Límite de velocidad, concurrencia o cuota | Reintentar tras una espera progresiva | Cambiar si falla el reintento | Lee primero el cuerpo del error y Retry-After |
500 |
Error interno del proveedor | Reintentos limitados | Cambiar si los fallos son consecutivos | Registra el ID de la solicitud y el cuerpo del error |
502 |
Error de gateway | Reintentos limitados | Se puede cambiar | Distingue entre un problema del gateway y uno del proveedor |
503 |
Servicio no disponible | Reintentos limitados | Se puede cambiar | Respeta Retry-After y reduce la funcionalidad si es necesario |
504 |
Tiempo de espera del gateway agotado | Solo si la operación es idempotente | Se puede cambiar | Comprueba primero si la tarea ya se ejecutó |
529 |
Sobrecarga del proveedor | Reintentos limitados | Se puede cambiar | Usa esperas progresivas con variación aleatoria y cambia si la sobrecarga persiste |
Un 429 no siempre indica un límite de velocidad: lee el cuerpo del error antes de decidir
El código 429 es fácil de interpretar mal. Puede indicar un límite de velocidad, un exceso de concurrencia o que se agotó la cuota del modelo; en algunos casos, también puede estar relacionado con el saldo. Un límite de velocidad suele resolverse tras esperar unos segundos, pero si la cuota está agotada, reintentar no servirá de nada. Cambiar directamente al modelo más caro solo duplicará los costos sin resolver el problema.
Para gestionar un 429, sigue estos pasos:
- Revisa el encabezado
Retry-Afterde la respuesta; si está presente, espera el tiempo indicado. - Lee el campo de tipo de error en el cuerpo para distinguir entre límite de velocidad, concurrencia y cuota.
- Si el problema es de velocidad o concurrencia, reintenta una o dos veces con espera progresiva y reduce la concurrencia local.
- Si el problema es la cuota, deja de reintentar, genera una alerta y cambia a una ruta con cuota disponible.
Con 500 se aplica una lógica similar. No significa necesariamente que el modelo esté fallando: el problema puede estar en el gateway o en el proveedor. Registra primero el ID de la solicitud y un resumen del cuerpo del error; los necesitarás tanto para investigar como para conciliar los registros.
Estrategia de reintentos ante errores de la API del modelo: número de intentos, espera, Retry-After e idempotencia
En resumen: reintenta solo ante errores transitorios, limita los reintentos a 1 o 2, aplica espera exponencial con variación aleatoria y automatízalos únicamente para solicitudes idempotentes. Si no se cumplen estas cuatro condiciones, no reintentes automáticamente.
| Parámetro | Valor recomendado | Explicación |
|---|---|---|
| Errores reintentables | 429, 500, 502, 503, 504, 529, tiempos de espera de red |
Entre los errores 4xx, solo 408 y 429 son excepciones |
| Número máximo de reintentos | 1-2 | Una vez alcanzado el límite, cambia de alternativa o genera una alerta; no sigas intentando lo mismo |
| Intervalo de espera | 1s, 2s, 4s, con incremento exponencial | Añade una variación aleatoria en cada intento para evitar que varias instancias reintenten al mismo tiempo |
| Retry-After | Si está presente, respétalo | Tiene prioridad sobre el algoritmo de espera local |
| Requisito de idempotencia | Obligatorio | Las operaciones de escritura, llamadas a herramientas, envíos de mensajes y pagos no se reintentan automáticamente por defecto |
Pasos para implementar la estrategia de reintentos
- Crea una función de clasificación de errores. Debe recibir el código de estado y el cuerpo del error, y devolver una de cinco categorías. El resto de la lógica debe basarse en esa clasificación, en lugar de comprobar códigos por todo el código de negocio.
- Etiqueta las solicitudes según su idempotencia. La generación de texto puro, los resúmenes y las traducciones suelen poder considerarse idempotentes. Si una solicitud activa herramientas o produce operaciones de escritura externas, márcala como no idempotente.
- Comprueba el estado antes de reintentar solicitudes no idempotentes. Si una llamada a una herramienta agota el tiempo de espera, consulta primero el estado de la tarea o de la base de datos. Reintenta solo después de confirmar que no se ejecutó y, si hace falta, usa una clave de idempotencia de la aplicación para evitar duplicados.
- Establece un límite de tiempo total. El tiempo acumulado de los reintentos de cada solicitud debe tener un límite. De lo contrario, la solicitud del usuario podría haber agotado su tiempo de espera mientras el sistema sigue reintentando en segundo plano.
- Registra cada intento. Guarda, como mínimo, el request id, el ID del modelo, el código de estado, la clase de error, la latencia, el consumo de tokens y el número de reintentos.
El último paso suele pasarse por alto, pero es imprescindible tanto para conciliar los cargos como para diagnosticar errores. Si accedes a través de APIYI apiyi.com, puedes consultar el uso y los registros de llamadas por clave en la consola. Al cotejar el request id registrado localmente con la información de error de la plataforma, podrás determinar si el fallo ocurrió en la puerta de enlace, en el proveedor upstream o en el cuerpo de tu propia solicitud.
Trata las interrupciones del flujo por separado. Si se desconecta una solicitud de streaming, comprueba primero cuántos tokens has recibido y si el contenido ya es utilizable. Después decide si conviene continuar la generación, descartarla o repetir la solicitud. Antes de repetir una tarea de salida larga, ten presente que la generación anterior podría haberse facturado.
🎯 Consejo para diagnosticar errores: ante errores como
500o529, cuyo origen puede ser difícil de identificar, guarda primero el cuerpo original del error y el request id. Después, consulta el uso y los registros del mismo periodo en la consola de APIYI apiyi.com. No saques conclusiones basándote solo en el código de estado.
Estrategia de cambio a un modelo de respaldo: niveles de capacidad, mapeo de modelos y comprobación de compatibilidad
En resumen: antes de cambiar al modelo de respaldo, hay que confirmar que puede resolver las mismas tareas. Si la ruta de respaldo se usa por primera vez durante una incidencia, es muy probable que se produzca un segundo fallo.
Empieza por clasificar los modelos en tres niveles: de alta gama, de uso general y ligeros. Asigna a cada tipo de tarea un modelo principal y uno de respaldo del mismo nivel o de un nivel adyacente. No redirijas todas las solicitudes al modelo más caro: una sola interrupción del proveedor podría disparar la factura y, además, muchas tareas sencillas no se benefician de usar un modelo de alta gama.
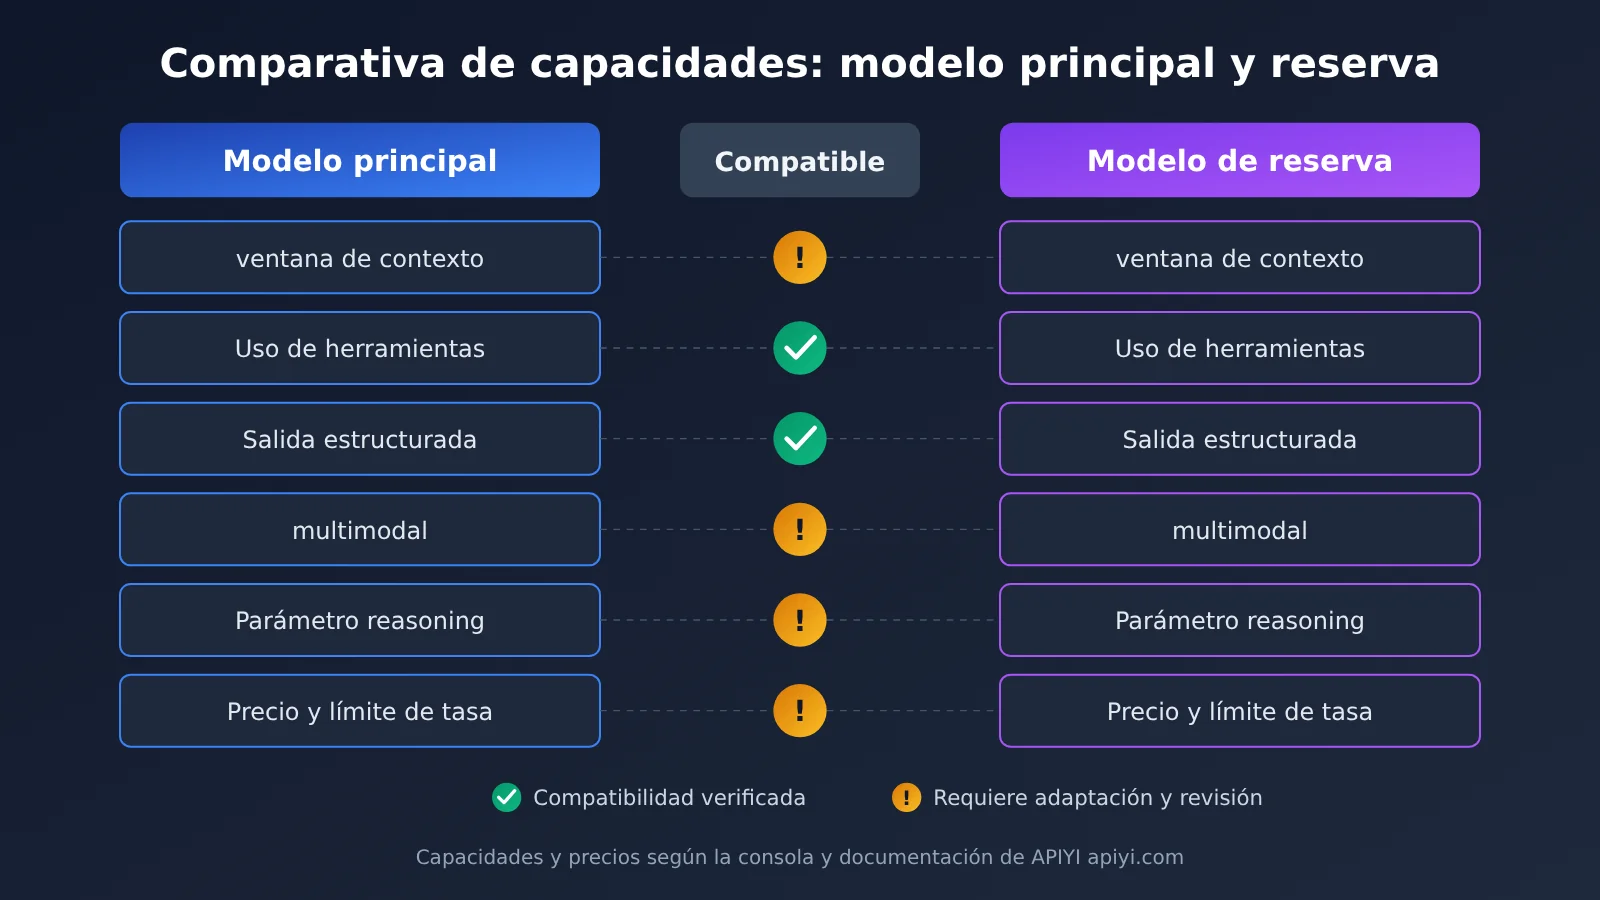
| Capacidad | Modelo principal | Modelo de respaldo | ¿Compatible? | Qué hacer antes del cambio |
|---|---|---|---|---|
| Ventana de contexto | Indicar el límite real | Indicar el límite real | Pendiente de comprobar | Confirmar que cabe la entrada real más larga; si no, definir primero una estrategia de truncamiento |
| Llamadas a herramientas | Schema de herramientas, llamadas en paralelo | Lo mismo | Pendiente de comprobar | Validar el formato de devolución del ID de llamada y la estructura de los parámetros |
| Salida estructurada | JSON schema o JSON estricto | Lo mismo | Pendiente de comprobar | Probar la tasa de éxito con el mismo schema para evitar errores 422 |
| Entrada multimodal | Imágenes, audio y video | Lo mismo | Pendiente de comprobar | Confirmar los formatos de entrada y los límites de tamaño |
| Parámetros de reasoning | Nivel de razonamiento o campo de pensamiento | Lo mismo | Pendiente de comprobar | Eliminar o adaptar durante el cambio los parámetros no admitidos |
| Precio y límites de tasa | Según la consola | Según la consola | Pendiente de comprobar | Estimar el costo tras el cambio y confirmar que los límites sean suficientes |
| Región y cumplimiento normativo | Alcance permitido | Alcance permitido | Pendiente de comprobar | Confirmar que la ruta de respaldo opera en las regiones permitidas y cumple los requisitos normativos de la empresa |
Conviene completar una tabla por cada tipo de tarea. En la columna «¿Compatible?», registra solo resultados que hayas verificado, no lo que recuerdes. Los parámetros de reasoning son especialmente propensos a causar problemas: un campo de nivel de razonamiento admitido por el modelo principal puede provocar directamente un error 400 o 422 en el modelo de respaldo. La lógica de cambio debe incluir una capa de adaptación de parámetros, en lugar de reenviarlos sin modificaciones.
Mapeo de modelos: consulta los ID de modelo en la consola
Uno de los errores más comunes al cambiar de modelo es escribir mal el ID y recibir un 404. Conviene mantener una tabla que relacione los nombres lógicos de los modelos con sus ID reales, y hacer que el código de la aplicación use solo los nombres lógicos. Al realizar llamadas a través de APIYI apiyi.com, consulta la consola y la documentación para conocer el ID exacto, la disponibilidad y el precio de cada modelo. Usa https://api.apiyi.com/v1 como base_url común para la integración. Después de modificar la tabla de mapeo, ejecuta una solicitud canary antes de publicar los cambios.
Validación de modelos de respaldo y gateways multimodelo: canarios, registros y degradación automática
En resumen: antes de poner en producción un modelo de respaldo, hay que validarlo con tareas reales. Tras una conmutación, también hay que comprobar la calidad de la salida, no solo si el código de estado es 200. Un gateway multimodelo puede reducir el costo de cambiar de modelo, pero no sustituye la validación de calidad.
Validación del modelo de respaldo en tres pasos
- Solicitudes canario. Elige un conjunto de tareas reales y envíalas tanto al modelo principal como al de respaldo, con la misma indicación, las mismas herramientas y las mismas entradas.
- Comparación de resultados. Compara la tasa de éxito, la latencia, el tiempo hasta el primer token, el costo de tokens y la tasa de fallos. En tareas con invocación de herramientas, verifica también que el ID de llamada, la estructura de los parámetros y la estructura de la respuesta sean compatibles.
- Validación tras la conmutación. Cuando se produzca un cambio real, comprueba la salida automáticamente: por ejemplo, si se puede analizar el JSON, si están todos los campos obligatorios y si los parámetros de las herramientas son válidos. Registra también el motivo del cambio y el resultado de la validación.
La ruta de recuperación debe ponerse a prueba periódicamente. Por ejemplo, cada semana puedes desviar manualmente una pequeña parte del tráfico al modelo de respaldo para confirmar que la integración sigue funcionando y evitar que dependencias, parámetros o ID de modelo dejen de funcionar sin que nadie lo note.
Es recomendable incluir al menos estos campos en los registros:
- ID de solicitud, ID de modelo, endpoint, código de estado, tipo de error y resumen del cuerpo del error
- Latencia, tiempo hasta el primer token, tiempo total, número de reintentos y destino de la conmutación
- Tokens de entrada, tokens de salida, aciertos de caché y costo estimado
- Nombre de la herramienta invocada, ID de llamada y resultado de la ejecución
- Motivo de la conmutación y resultado de la validación posterior
El papel de los gateways multimodelo en la recuperación ante fallos
Si integras por tu cuenta varios proveedores para preparar la recuperación ante fallos, tendrás que mantener al menos varias claves, varios SDK y distintos formatos de error. Con un gateway de agregación como APIYI apiyi.com, una sola clave permite invocar modelos populares como OpenAI, Claude, Gemini, DeepSeek y Qwen. Su interfaz es compatible con el estándar de OpenAI y también admite los formatos nativos de Claude y Gemini. Puedes integrar los modelos principal y de respaldo en el mismo código: al cambiar, solo modificas el ID del modelo, no toda la integración.
La plataforma también ofrece despliegue en múltiples nodos, enrutamiento inteligente, degradación automática y balanceo de carga, lo que puede absorber parte de las fluctuaciones de los proveedores. Sin embargo, la degradación automática del gateway no sustituye las decisiones de la aplicación: las comprobaciones de idempotencia, la deduplicación de llamadas a herramientas y la validación de la salida siguen siendo responsabilidad de tu código. Una distribución prudente es que el gateway se encargue de la disponibilidad de conexiones y nodos, mientras que la aplicación se ocupa de que las tareas produzcan resultados correctos.
💡 Consejo de recuperación ante fallos: al diseñar la estrategia de modelos principal y de respaldo, puedes usar primero la misma clave en APIYI apiyi.com para ejecutar el mismo conjunto de tareas canario en ambos modelos. Después, añade las combinaciones que superen la validación a la tabla de asignación de modelos. Los nuevos usuarios pueden empezar con el crédito de prueba gratuito.
Preguntas frecuentes sobre errores de la API de modelos
En resumen: estas cinco preguntas cubren los escenarios que más dudas generan en producción. Todas siguen el mismo principio: primero evalúa y después actúa.
P1: ¿Hay que reintentar un error 401?
No. `401` indica un fallo de autenticación. Reintentar solo aumentará el volumen de solicitudes e incluso podría convertir el problema en un `429`. Comprueba que la clave API sea válida, que el encabezado `Authorization` tenga el formato correcto y que la URL base y la clave pertenezcan a la misma plataforma. Si usas APIYI apiyi.com, puedes confirmar el estado de la clave en la consola.
P2: ¿Hay que cambiar de modelo inmediatamente ante un 429?
No se recomienda cambiar de inmediato. Primero revisa el cuerpo del error y `Retry-After`: si se trata de un límite de tasa o de concurrencia, normalmente basta con esperar y reintentar 1 o 2 veces. Cambia de ruta solo cuando se haya agotado la cuota. Al hacerlo, elige un modelo de respaldo del mismo nivel; no recurras siempre al más caro.
P3: Si se interrumpe la salida en streaming, ¿hay que repetir la solicitud?
No te apresures. Una interrupción del flujo no significa que la solicitud haya fallado: es posible que ya se haya generado contenido y que se hayan producido cargos. Primero comprueba cuántos tokens has recibido y si el contenido se puede usar: si sirve, consérvalo o continúa la generación; si no sirve y la solicitud es idempotente, repítela 1 vez. Consulta el uso en la consola para conocer la facturación real.
P4: ¿Qué hacer si una llamada a una herramienta se ejecuta varias veces?
La solución de fondo es implementar la idempotencia en la capa de herramientas: usa una clave de idempotencia del negocio o un ID de tarea para eliminar duplicados, de modo que cada ID se ejecute una sola vez. Si una llamada a una herramienta agota el tiempo de espera, consulta primero el estado de la tarea y reintenta solo después de confirmar que no se ejecutó. Si ya hay duplicados, revisa los registros usando el ID de llamada y compensa o revierte las operaciones adicionales.
P5: ¿Qué hacer si el modelo de respaldo devuelve 200, pero el resultado es incorrecto?
Un 200 solo indica que la solicitud se procesó correctamente, no que la tarea se haya completado bien. Valida la salida de forma automática: por ejemplo, comprueba la estructura JSON, los campos obligatorios y la validez de los parámetros de las herramientas. Los fallos de validación deben contar en la tasa de errores y activar una alerta o una revisión manual. Si una combinación de respaldo falla con frecuencia en las comprobaciones de aceptación, retírala de la tabla de mapeo y vuelve a ejecutar una prueba canary.
Lista de comprobación antes de producción y resumen: cuándo reintentar, cambiar o detenerse
En resumen: comprobar cada punto de esta lista antes de pasar a producción es mucho más fiable que añadir lógica sobre la marcha después de un fallo. Recuerda esta regla: ante un 4xx, primero corrige; con un 5xx, considera reintentar; y ante una solicitud no idempotente, detente primero.
| N.º | Comprobación | Criterio de aprobación |
|---|---|---|
| 1 | Identificar primero el tipo de error | Todos los códigos de estado encajan en una de cinco categorías; los errores desconocidos no se reintentan por defecto |
| 2 | No reintentar automáticamente los 4xx | Ante 400, 401, 402, 403, 404, 409 y 422, generar una alerta o corregir el problema directamente |
| 3 | Decidir si reintentar o cambiar | Reintentar solo los errores transitorios, como máximo 1 o 2 veces, con espera progresiva y variación aleatoria |
| 4 | Respetar Retry-After | Si existe la cabecera de respuesta, priorizar el tiempo de espera que indica |
| 5 | Comprobar la idempotencia | Ante llamadas a herramientas, operaciones de escritura, envío de mensajes y pagos, detenerse por defecto y consultar el estado antes de decidir |
| 6 | Gestionar interrupciones del flujo | Revisar primero los tokens recibidos y el costo, sin repetir la solicitud a ciegas |
| 7 | Comprobar el modelo alternativo | La tabla de capacidades está completa y validada para cada tipo de tarea |
| 8 | Mapeo de modelos | El mapeo de nombres lógicos a ID de modelos coincide con la consola |
| 9 | Validar la salida final | Después del cambio, comprobar la estructura y los campos, no solo el código 200 |
| 10 | Registros y simulacros | Los campos clave están completos y la ruta de respaldo se prueba periódicamente |
Puntos clave para gestionar errores de la API de modelos
- Cuándo reintentar: ante
429,500,502,503,529y solicitudes idempotentes que agotan el tiempo de espera, con un número limitado de intentos y espera progresiva. - Cuándo cambiar: si los reintentos siguen fallando, el proveedor continúa sin estar disponible o se agota la cuota, siempre que el modelo alternativo ya esté validado.
- Cuándo detenerse: ante errores de configuración 4xx como
401y solicitudes no idempotentes cuyo estado se desconoce. - Cambiar no significa tener éxito: aunque el modelo alternativo devuelva 200, hay que validar la salida.
- Reparto de responsabilidades entre gateway y aplicación: deja la disponibilidad de las rutas al gateway y la corrección de las tareas al código de negocio.
Una buena gestión de errores no depende de reintentar con insistencia, sino de tomar la decisión correcta cada vez que aparece un fallo. Conviene empezar por completar la clasificación de errores, las etiquetas de idempotencia y los campos de registro, para después incorporar modelos alternativos de forma gradual. Como ruta de respaldo, puedes considerar APIYI apiyi.com: una sola clave da acceso a modelos de varios proveedores importantes, lo que facilita validar el modelo principal y el alternativo y cambiar entre ellos con el mismo código. Consulta la consola y la documentación para conocer los precios y la disponibilidad.
📚 Referencias
- Centro de documentación de APIYI: métodos de integración, lista de modelos y facturación
- Enlace:
docs.apiyi.com -
Nota: consulta la documentación y la consola para conocer los ID, precios y disponibilidad actuales de los modelos.
-
Semántica de los códigos de estado HTTP: significado de las cabeceras de respuesta estándar, como
Retry-After - Enlace:
developer.mozilla.org/docs/Web/HTTP/Status - Nota: sirve para entender el significado general de los códigos 4xx y 5xx. Para conocer el significado concreto, consulta el cuerpo del error de cada plataforma de modelos.
Autor: Equipo técnico de APIYI
Consultas técnicas: puedes contactarnos desde la página principal de APIYI, apiyi.com. Encontrarás más recursos de integración en el centro de documentación docs.apiyi.com.