Nota del autor: tomando como ejemplo Iceman, el modelo gratuito y anónimo de OpenCode que nadie ha reclamado, desglosamos tres capas de información —las declaraciones oficiales, los parámetros del catálogo y las pistas no confirmadas—, presentamos una lista de verificación de 5 puntos antes de integrarlo y explicamos cómo combinar varios id para interpretar los rankings de uso.
Gratis, sin límite de solicitudes y con una ventana de contexto enorme, pero nadie sabe quién lo hizo. Este tipo de modelos gratuitos y anónimos se ha vuelto muy habitual últimamente en herramientas de programación, y la primera reacción de muchos desarrolladores es «lo conecto al proyecto y pruebo». En este artículo usamos Iceman, en OpenCode, como caso práctico para responder a una pregunta concreta: ¿qué necesitas comprobar antes de enviar código o datos de negocio a un modelo gratuito de origen desconocido?
Este no es un artículo para disuadirte de usarlo: los modelos gratuitos y anónimos pueden servir perfectamente para validar prototipos y hacer experimentos con código público. La clave está en distinguir qué información puede servirte de base para usarlos y qué es solo un rumor, y en entender qué impacto real tendrán en tus datos las cláusulas de entrenamiento y retención.
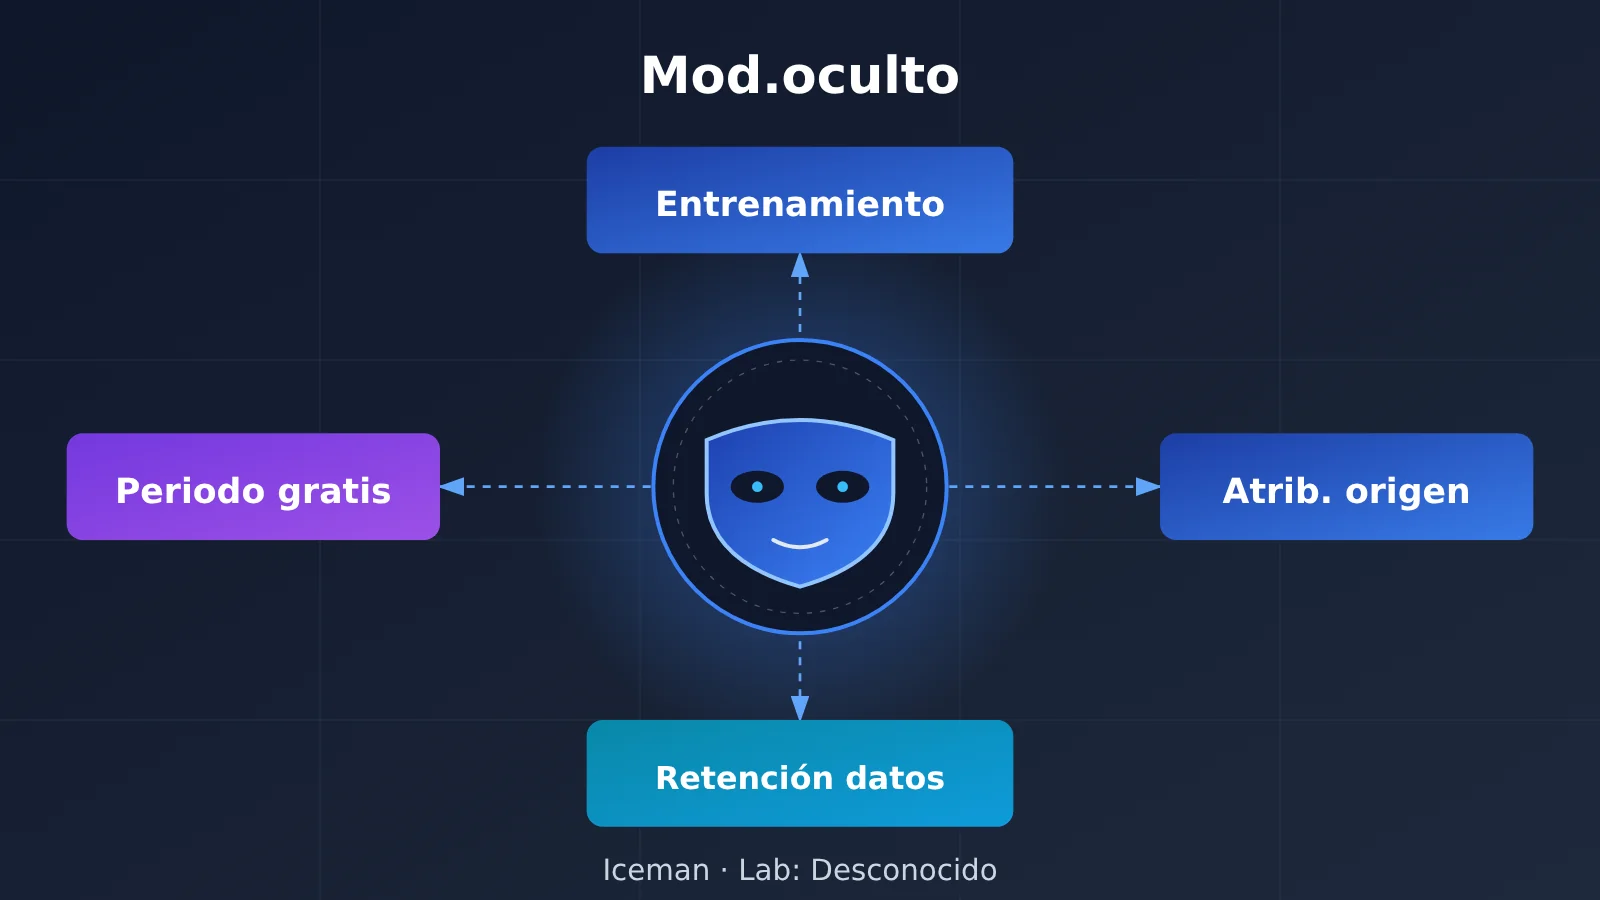
Valor principal: al terminar el artículo tendrás una lista de verificación reutilizable para modelos anónimos, que cubre cuatro dimensiones: entrenamiento con datos, retención cero de datos, duración de la gratuidad y atribución del origen. También aprenderás a detectar malinterpretaciones de los rankings, como el «crecimiento falso provocado por cambiar de id».
Puntos clave del modelo sigiloso gratuito Iceman
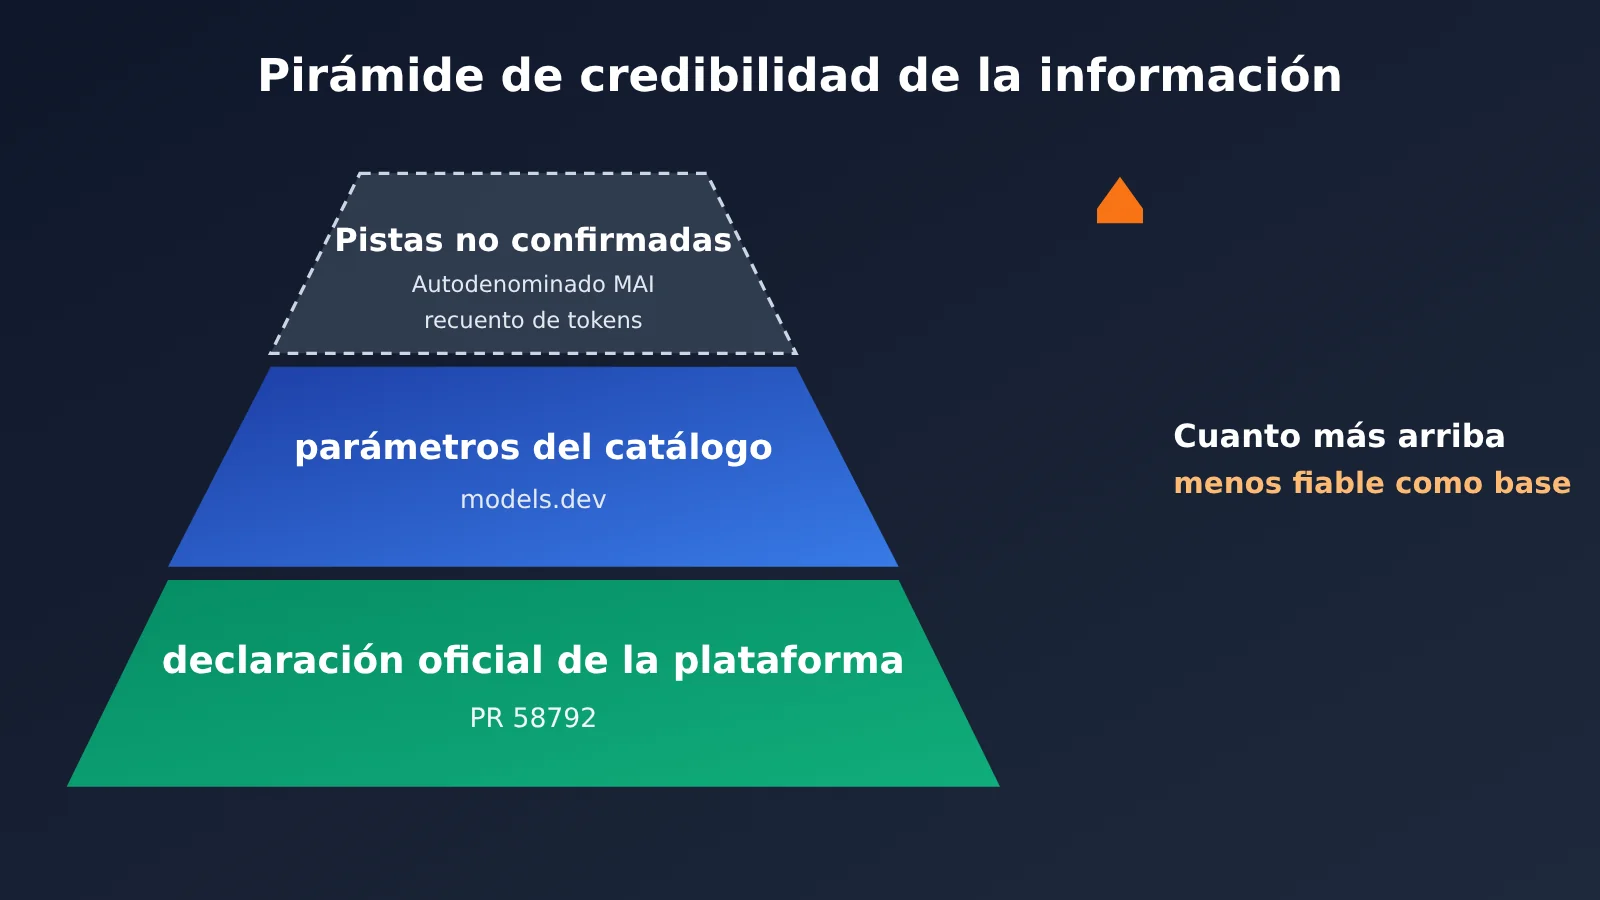
Hasta el 4 de noviembre de 2026 a las 18:31 UTC, Iceman seguía sin ser reclamado por ningún laboratorio de IA. Según los datos de uso de OpenCode, desde el 23 de octubre ha acumulado aproximadamente 3,37 billones de tokens bajo dos identificadores. La siguiente tabla clasifica primero la información sobre él en tres niveles según su credibilidad, y esta es la base de todos los juicios posteriores.
| Nivel de información | Contenido concreto | ¿Sirve como base para su uso? |
|---|---|---|
| Declaración oficial de la plataforma | PR 58792 fusionado por OpenCode: gratis por tiempo limitado, sin límite de solicitudes, las indicaciones se usan para entrenamiento, retención de datos distinta de cero | ✅ Sí, es un hecho a nivel de términos |
| Parámetros del catálogo | Catálogo de models.dev: contexto de 262.144, hasta 131.072 tokens de salida, compatible con razonamiento e invocación de herramientas, entrada y salida solo de texto | ✅ Sí, para la selección técnica |
| Pistas no confirmadas | Seguimientos de terceros afirman que se identifica como Microsoft MAI y que el conteo de tokens coincide con MAI Thinking 1 | ❌ No, solo se puede tomar como rumor |
Detalle de los términos oficiales del modelo sigiloso Iceman
El 24 de octubre, OpenCode añadió Iceman al plan Go de 10 dólares mensuales, correspondiente al pull request 58792 del repositorio, fusionado a las 20:24 UTC. El nombre del modelo es Iceman Contributor Free y los términos indican «gratis por tiempo limitado, sin límite de solicitudes». Ese mismo cambio señala dos cosas a la vez: las indicaciones que se le envían se usarán para entrenamiento, y la política de retención de datos no es de retención cero.
Estos dos puntos son los que más deberían importar a los desarrolladores, ya que determinan de forma más directa que la ventana de contexto y la longitud de salida qué datos se pueden enviar. Además, ese PR añadió este identificador a la lista de modelos sigilosos de OpenCode, por lo que la columna del laboratorio en la página de uso aparece como Unknown. En otras palabras, la propia plataforma te dice claramente: origen desconocido.
El verdadero significado de Contributor en el nombre del modelo sigiloso
Muchos interpretan el Contributor de iceman-contributor como el nombre de algún laboratorio o colaborador. En realidad se refiere a un modo de intercambio de OpenCode: cambiar datos de entrenamiento por acceso gratuito. Las versiones Contributor de Muse Spark 1.3 y 1.2 de Meta también existen, lo que demuestra que es una etiqueta genérica a nivel de plataforma, no una pista sobre el origen del modelo.
Así que cuando veas la palabra Contributor, la interpretación correcta es «los datos de este canal entrarán en el entrenamiento», no «esta es la versión aportada por algún laboratorio». Esto se usará como primera comprobación en la lista de verificación que viene más adelante.
Impacto de las cláusulas de entrenamiento de los modelos gratuitos opacos en el código y los datos privados
“La indicación se usa para entrenar” suena abstracto, pero en un proyecto se traduce en un problema muy concreto: cada fragmento de contexto que envías puede acabar como muestra de entrenamiento del modelo de otra persona. En el caso de las herramientas de programación, el contexto no suele ser solo la pregunta que escribes, sino también el contenido de archivos incluidos automáticamente, logs de errores, archivos de configuración e incluso variables de entorno.
La retención de datos distinta de cero implica que el contenido de la solicitud se conserva en el servidor durante un tiempo. Cuánto tiempo, dónde se almacena y quién lo procesa no se puede confirmar cuando se desconoce el origen del modelo. En proyectos empresariales, esto suele chocar directamente con las cláusulas de confidencialidad del contrato o con los requisitos de cumplimiento de datos. La siguiente tabla enumera los riesgos reales según el tipo de dato.
| Tipo de dato | Origen típico | Riesgo con entrenamiento + retención distinta de cero | Recomendación |
|---|---|---|---|
| Código abierto o público | Repositorios públicos, proyectos de ejemplo | Bajo, el contenido ya era público | Se puede usar |
| Código de negocio privado de la empresa | Repositorios internos, algoritmos principales | Alto, podría filtrar detalles de implementación y arquitectura | No se recomienda enviarlo |
| Claves y configuración | .env, archivos de configuración, scripts de CI |
Extremadamente alto, las credenciales podrían conservarse y usarse en entrenamiento | Debe excluirse |
| Datos privados de usuarios | Logs, muestras de bases de datos, tickets | Extremadamente alto, implica cumplimiento de datos personales | Prohibido enviarlos |
| Datos sintéticos o anonimizados | Fixtures de prueba, datos Mock | De bajo a medio, según la calidad de la anonimización | Se pueden usar tras anonimizarlos |
Aquí conviene advertir especialmente sobre el problema del “contexto implícito” en las herramientas de programación. Muchos agentes leen automáticamente archivos del espacio de trabajo; tú crees que solo preguntaste cómo escribir una función, pero en realidad toda la estructura de directorios y los archivos vecinos pueden empaquetarse en la solicitud. Cuando uses canales con entrenamiento, lo más seguro es trabajar en un espacio de trabajo independiente que solo contenga datos públicos o sintéticos.
Cómo verificar un modelo furtivo gratuito: lista de comprobación de 5 puntos antes de integrarlo
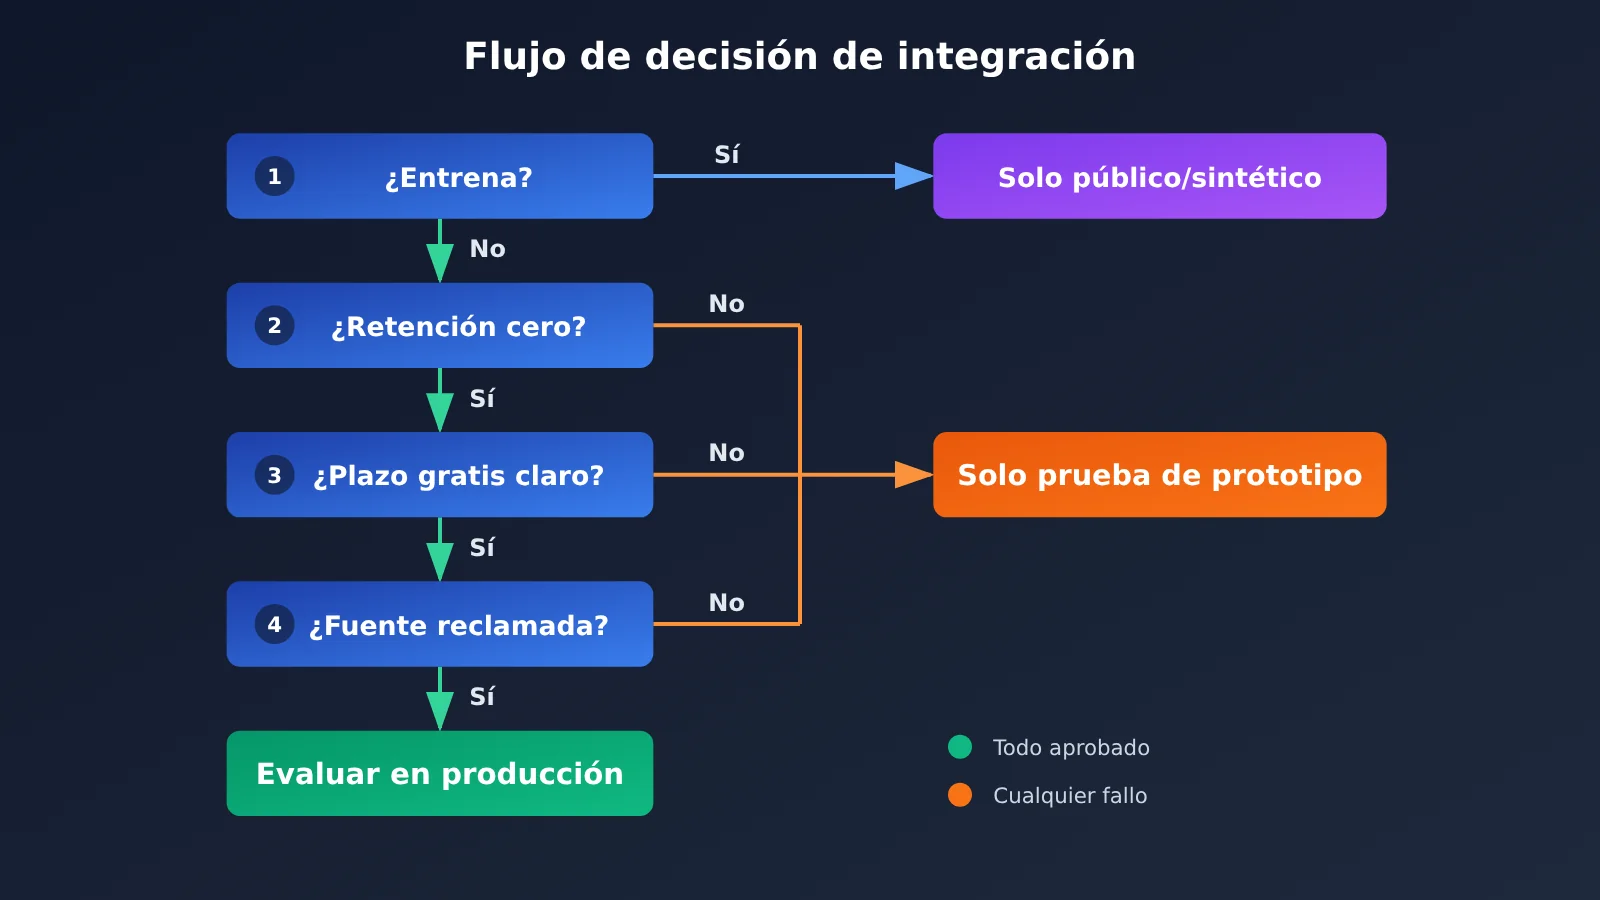
Esta lista no está pensada solo para Iceman, sino que sirve para cualquier modelo gratuito cuyo origen no haya sido reclamado. Los cuatro primeros puntos provienen de los términos y la atribución; el quinto, de la interpretación de los datos. Se recomienda convertirla en un proceso de revisión fijo dentro del equipo.
| N.º | Punto de comprobación | Dónde confirmarlo | Estado actual de Iceman |
|---|---|---|---|
| 1 | ¿Las indicaciones se usan para entrenamiento? | Términos de la plataforma, historial de cambios de configuración del modelo | Sí, se usan para entrenamiento |
| 2 | ¿Hay retención cero de datos? | Términos de la plataforma, aviso de privacidad | No, no es retención cero |
| 3 | ¿Cuánto dura el periodo gratuito? | Anuncios de la plataforma, descripción de los planes | Solo dice «por tiempo limitado», duración desconocida |
| 4 | ¿Se ha confirmado la atribución del origen? | Declaración oficial del laboratorio | No confirmada, el laboratorio aparece como Unknown |
| 5 | ¿Los datos de uso están divididos por id? | Todos los id relevantes de la clasificación de uso | Sí, se dividen en iceman e iceman-contributor |
Atribución del origen de un modelo furtivo: por qué una pista no equivale a una confirmación
Sobre el origen de Iceman, el sitio de seguimiento stealthmodels.com informó que la cuenta de X @aitrackerbot descubrió que Iceman se autopresenta como MAI de Microsoft y que su forma de contar los prompt tokens coincide exactamente con la de MAI Thinking 1. Sin embargo, las pruebas del propio sitio revelaron que también coincide con MAI Thinking 1 y, del mismo modo, con la serie GPT-6 de OpenAI. Esto significa que el conteo de tokens no permite distinguir entre estos modelos.
Que un modelo «diga quién es» tampoco es fiable: los modelos repiten información de identidad presente en sus datos de entrenamiento y también pueden ser configurados deliberadamente mediante el prompt del sistema. Hasta la fecha, Microsoft no ha emitido ninguna declaración. Por lo tanto, la posición correcta de esta información es la de «una pista», y no debe escribirse en tu documento de selección técnica como si fuera un hecho.
Precedentes históricos de reclamación de modelos furtivos
Si miramos los modelos furtivos anteriores de OpenCode, la reclamación suele producirse en el momento del lanzamiento o en las semanas siguientes. ox-alpha fue reclamado por Z.ai como GLM-5.3 Flash, cat-jam fue reclamado por Reflection AI como Beam, y Space Bunny fue reclamado por MiniMax como M3.1 Flash 26 días después de su primera aparición. A fecha del 4 de noviembre, Iceman lleva 11 días en línea y sigue sin ser reclamado.
El valor de los precedentes está en ofrecer expectativas, no predicciones. Te dicen que la reclamación puede tardar semanas y que, durante ese tiempo, la escala, el origen y la duración de la gratuidad del modelo son incógnitas que tu solución no puede dar por sentadas.
Modelo sigiloso gratuito para empezar rápido: leer la tabla de uso combinando varios id
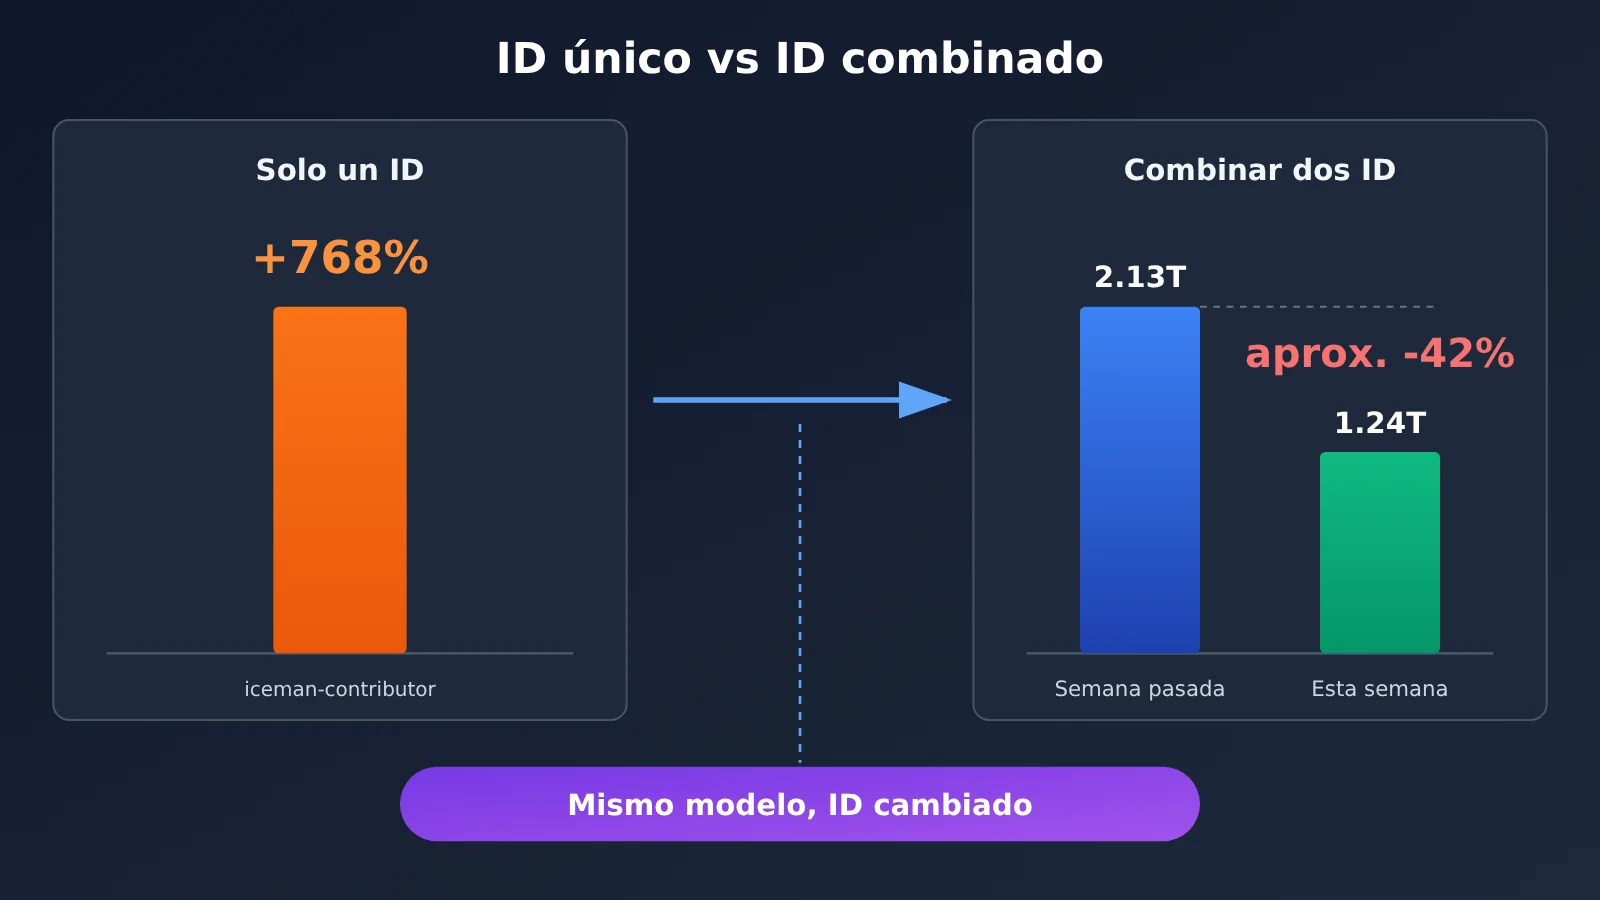
El rendimiento de Iceman en la tabla semanal de OpenCode es un caso muy típico de mala interpretación de un ranking. Si solo miras un id, llegas a la conclusión de que hay un «crecimiento explosivo»; si juntas los dos id, la conclusión es justo la contraria.
| id | Puesto en la tabla semanal | Tokens de esta semana | Variación semanal |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| Total | — | aprox. 1.24T | aprox. -42% (aprox. 2.13T la semana pasada) |
El +768% no es un crecimiento, sino el tráfico del mismo modelo pasando de un id a otro. Los dos id juntos suman unos 1.24 billones de tokens en los últimos 7 días, alrededor de un 42% menos que los aproximadamente 2.13 billones de la semana anterior. El uso diario alcanzó su pico el 28 de octubre con unos 653 mil millones de tokens, y entre el 29 de octubre y el 3 de noviembre se mantuvo cada día entre 162 mil millones y 251 mil millones.
Ejemplo minimalista: combinar id para calcular la variación real
El siguiente fragmento de Python demuestra la lógica de combinación, con datos tomados de las cifras públicas del texto anterior. Los valores de cada id de la semana pasada se derivan a la inversa a partir del valor de esta semana y su variación, así que son aproximados.
# Varios id del mismo modelo, tokens de esta semana (unidad: miles de millones) y variación semanal
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# Deducir el valor de la semana pasada a partir de la variación: last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
Al ejecutarlo se obtiene del orden de 1.237B para esta semana, unos 2.100B para la semana pasada y una variación combinada de entre -41% y -42%, lo que encaja bastante bien con los datos agregados que dio el reportaje. La deducción inversa arrastra errores de redondeo, así que en un análisis real conviene leer directamente los datos semanales originales de cada id.
Ver la implementación completa: la puerta de política del modelo antes de la integración
El código siguiente convierte la lista de verificación en una sencilla «puerta de política». No llama a la interfaz de ninguna plataforma concreta: solo decide, a partir de los metadatos que tú rellenas tras la verificación manual, si cierto tipo de datos puede enviarse a un modelo determinado. Puedes colocarla delante de tu propia capa de enrutamiento de peticiones.
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # Punto de verificación 1
    zero_data_retention: bool        # Punto de verificación 2
    free_until: Optional[str]        # Punto de verificación 3; None indica que el plazo es desconocido
    lab_confirmed: bool              # Punto de verificación 4
    related_ids: tuple = ()          # Punto de verificación 5; sirve para agrupar estadísticas

# Nivel de sensibilidad de los datos: 0 público, 1 anonimizado/sintético, 2 código privado, 3 secretos o datos personales
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """Devuelve el nivel máximo de sensibilidad permitido según los términos del modelo"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # Entrenamiento o retención distinta de cero: solo se permiten datos públicos y sintéticos
    if not p.lab_confirmed:
        return 1          # Origen no reclamado: igualmente limitado a datos de baja sensibilidad
    return 2              # Solo después de confirmar los términos y la titularidad se considera el código privado

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # Los secretos y los datos personales nunca se envían a canales externos gratuitos
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """Devuelve la lista de problemas que bloquean el uso en producción; una lista vacía indica que puede pasar a evaluación"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("非零数据保留")
    if p.free_until is None:
        issues.append("免费期限未知,存在突然收费或下线风险")
    if not p.lab_confirmed:
        issues.append("来源未认领,无法评估模型规模与长期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
Consejo práctico: mantén los metadatos del bloque anterior como una configuración compartida dentro del equipo y actualízalos cada vez que cambien los términos de la plataforma o el estado de reclamación del modelo. De esta forma, cuando un compañero nuevo integre cualquier modelo gratuito, podrá reutilizar el mismo criterio de decisión en lugar de improvisar según su intuición.
Preguntas frecuentes (FAQ)
P1: ¿Qué es un modelo stealth gratuito?
Un modelo stealth es un modelo que se publica en la plataforma bajo un nombre en clave y cuya identidad de laboratorio todavía no se revela. La página de uso de la plataforma suele mostrar su origen como Unknown. Iceman es uno de los integrantes de la lista de modelos stealth de OpenCode y, a fecha de 2026-11-04, nadie lo ha reclamado.
P2: ¿Cuál es la diferencia entre Iceman e iceman-contributor?
A juzgar por los datos públicos, son dos id que la lista de uso de OpenCode emplea para rastrear un mismo modelo; en la clasificación semanal uno se dispara y el otro se desploma, cuando en realidad es tráfico que se traslada de un id al otro. El término Contributor se refiere al modelo de intercambio de la plataforma —«entregas datos de entrenamiento a cambio de acceso gratuito»—, no al nombre de un laboratorio.
P3: ¿Cuánto durará el periodo gratuito de Iceman?
Por ahora no hay respuesta pública. Los cambios de OpenCode solo indican «gratis por tiempo limitado, sin límite de peticiones», sin fecha de finalización. El tamaño del modelo, quién lo desarrolla y cuánto dura la gratuidad son datos que hoy desconocemos, así que no conviene que un plan de producción dependa de su estado gratuito.
P4: ¿Para qué escenarios encaja mejor un modelo stealth gratuito?
Siempre que los términos especifiquen claramente «usado para entrenamiento, retención distinta de cero», los escenarios más adecuados son:
– **Experimentación con proyectos open source**: trabajar con código que ya es público, por ejemplo escribir ejemplos o tests para una librería open source.
– **Evaluación de capacidades**: probar su razonamiento y su uso de herramientas con preguntas sintéticas, para entender cómo se comporta con contextos grandes.
– **Prototipos personales de aprendizaje**: montar una demo sin datos reales y validar si el flujo de interacción es viable.
P5: ¿Cómo llevar esta lista de verificación de modelos stealth al trabajo en equipo?
Propongo tres pasos: primero, incorporar las 5 comprobaciones al documento de admisión de modelos; después, bloquear en la capa de enrutamiento según el nivel de sensibilidad de los datos, igual que con la puerta de políticas del artículo anterior; y por último, configurar un espacio de trabajo independiente para las herramientas de programación, para que el Agent no arrastre archivos privados de forma automática. Cuando cambien los términos, basta con actualizar los metadatos.
P6: Si el modelo dice ser producto de tal empresa, ¿puedo creerlo?
No de forma directa. La autopresentación del modelo puede venir del corpus de entrenamiento o del system prompt, y además el método de conteo de tokens puede ser exactamente igual entre varios modelos. En el caso de Iceman, pruebas de terceros encontraron que su conteo coincide igualmente con MAI Thinking 1 y la serie GPT-6, así que no sirve para distinguirlos. La atribución solo vale si el laboratorio la confirma oficialmente.
P7: Cuando se reclama un modelo stealth, ¿qué pasa con los datos enviados antes?
El reclamo solo cambia la información sobre el origen; no modifica los términos que se aplicaban cuando enviaste los datos. Si en ese momento los términos decían que se usaban para entrenamiento y con retención distinta de cero, el tratamiento de esos datos ya está decidido. Por eso la verificación tiene que hacerse antes de enviar, y no esperar al reclamo para completarla.
Puntos clave del modelo sigiloso gratuito
- Primero los términos, después los parámetros: el uso para entrenamiento y la retención de datos determinan qué puedes enviar; la longitud del contexto solo determina cuánto puedes enviar.
- Contributor es un esquema de intercambio: implica cambiar datos de entrenamiento por acceso gratuito, no indica el origen del modelo.
- Una pista no es una confirmación: ni la identidad que el modelo dice tener ni el recuento de tokens demuestran su procedencia.
- Trata la gratuidad como algo de duración desconocida: «por tiempo limitado» no tiene fecha de fin, así que no dependas de ella en tu plan.
- Al leer los rankings, unifica los id: el +768% de Iceman, tras consolidarlo, en realidad es de aproximadamente -42%.
- Aísla siempre los datos sensibles: no envíes claves, datos privados ni código central privado a canales que se usan para entrenamiento.
Resumen
Que un modelo sigiloso gratuito pueda integrarse en un proyecto depende de qué datos vas a enviar, no de si es gratuito. En el caso de Iceman, lo que sí sirve como base son los términos de la plataforma y los parámetros del catálogo: se usa para entrenamiento, tiene retención de datos distinta de cero, es gratuito por tiempo limitado, ofrece 262,144 de contexto y admite razonamiento y llamadas a herramientas. Lo que no sirve como base son las distintas pistas sobre el desarrollador: antes de que haya un reconocimiento oficial, no son más que rumores.
La metodología reutilizable se puede resumir en tres puntos:
- Separa la información por capas: distingue entre declaraciones de la plataforma, parámetros del catálogo y pistas no confirmadas; toma decisiones solo con las dos primeras capas.
- Usa el modelo según el nivel de los datos: los canales de entrenamiento solo deben manejar datos públicos o sintéticos; el código privado y los datos privados se gestionan aparte.
- Unifica los criterios al leer los rankings: para un mismo modelo, primero hay que sumar los distintos id y luego calcular la tasa de crecimiento, para no dejarse engañar por crecimientos falsos provocados por el cambio de id.
No importa quién reconozca a Iceman más adelante: este método de verificación se puede aplicar a largo plazo al próximo modelo sigiloso que aparezca.
📚 Referencias
- ArtificialWatch – Análisis de uso y atribución de Iceman: fuente principal de los hechos de este artículo
- Enlace:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
Descripción: recopila el uso de los dos ids de Iceman, los cambios en los términos y las pistas de atribución, publicado el 2026-11-04
-
Página de uso de OpenCode Data: datos de uso de iceman e iceman-contributor
- Enlace:
opencode.ai/data -
Descripción: permite consultar directamente el ranking semanal y el uso de tokens de cada id
-
Catálogo de modelos de models.dev: parámetros técnicos de Iceman
- Enlace:
models.dev -
Descripción: ofrece información del catálogo como ventana de contexto, salida máxima, razonamiento y llamadas a herramientas
-
Seguimiento de modelos stealth de stealthmodels.com: fuente de los reportes sobre pistas de atribución
- Enlace:
stealthmodels.com - Descripción: registra pruebas sobre la identidad autoproclamada de Iceman y el conteo de tokens, solo como referencia de pistas
Autor: Equipo técnico de APIYI
Nota: Los hechos de este artículo están actualizados hasta el 2026-11-04; el estado de reclamación de Iceman y el período de gratuidad pueden cambiar en cualquier momento, por favor tome como referencia los términos más recientes de la plataforma.