Nota del autor: desde “arreglar un fallo” hasta “hacer que la aplicación deje de fallar”, este artículo desglosa los 5 cambios que el flujo de trabajo debe completar antes de entregar el resultado a la IA, y presenta un proceso de implementación sin escribir código.
Muchos equipos ya usan la IA a diario para escribir correos, retocar textos o hacer presentaciones, pero sienten que su valor debería ir más allá. El problema no suele estar en el modelo, sino en que lo que entregamos es demasiado pequeño: lo que entregamos es una tarea, no un resultado. Este artículo se apoya en las ideas prácticas que compartió recientemente Felix Rieseberg, desarrollador de Claude, para explicar cómo transformar el flujo de trabajo para pasar de “delegar tareas” a “delegar resultados”.
Este no es otro artículo más de trucos para indicaciones. Por muy bien escrita que esté una indicación, si la IA no puede acceder a los datos, no puede tocar el entorno y no tiene validación externa, solo podrá moverse dentro del pequeño marco que tú le has delimitado. Lo que hay que cambiar primero es el propio flujo de trabajo.
Valor clave: al terminar este artículo sabrás qué trabajos merecen que “entregues el resultado a la IA” y qué 5 condiciones básicas debes completar antes de hacerlo, para que la IA pueda operar de forma independiente durante mucho tiempo.
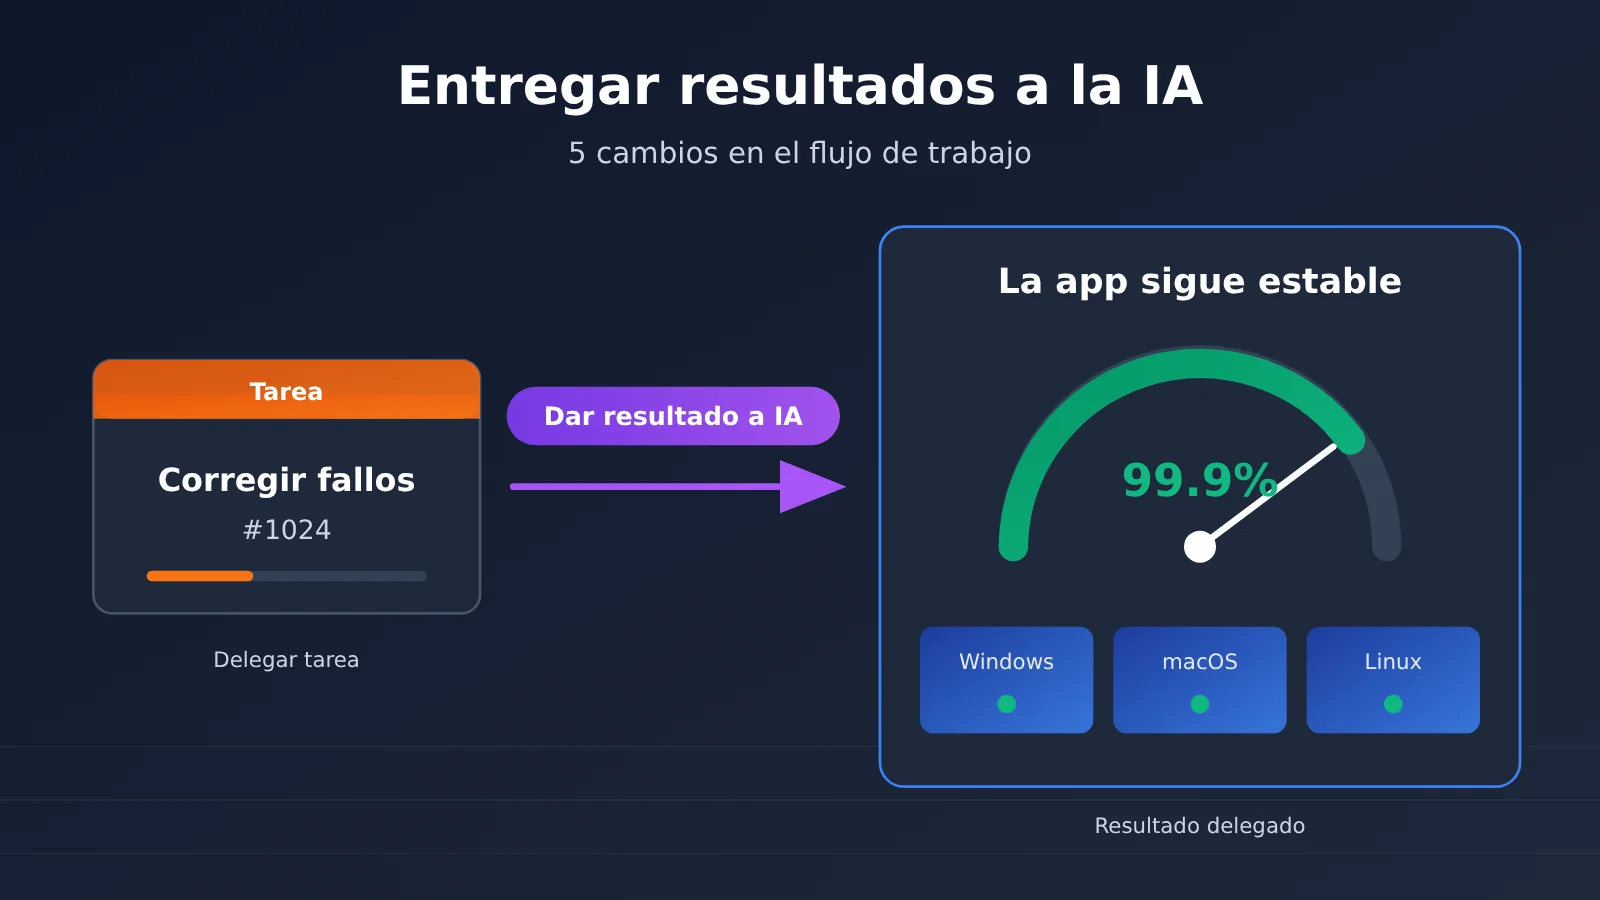
Puntos clave de delegar tareas a la IA frente a delegar resultados a la IA
Felix Rieseberg descompone la «ambición» al usar IA en cuatro dimensiones: velocidad, altura, profundidad y amplitud. La «velocidad» es el uso más maduro, mientras que «delegar resultados a la IA» corresponde principalmente a la dimensión de «altura»; la profundidad y la amplitud determinan el techo de calidad de los resultados.
| Dimensión | Significado | Práctica típica | Requisitos para el flujo de trabajo |
|---|---|---|---|
| Velocidad | Hacer el mismo trabajo en menos tiempo | Que la IA escriba código y documentos más rápido | Bajo, basta con el flujo actual |
| Altura | Centrarse en el resultado final, no en la tarea inmediata | Pasar de «arregla este bug» a «que la aplicación no se caiga» | Alto, requiere canales de datos y un entorno de validación |
| Profundidad | Pensar como un experto de primer nivel del dominio | Usar bases de datos y modelos estadísticos en lugar de tablas Markdown | Medio-alto, requiere datos en bruto y herramientas profesionales |
| Amplitud | Tomar prestados métodos de otros campos | Incorporar metodologías de periodistas, editores e inversores bajistas | Medio, requiere múltiples sesiones o subagentes |
Por qué delegar resultados a la IA es ante todo un problema de flujo de trabajo
Cuando le encargas una tarea a un modelo, lo que ejecuta en realidad es «el método que tú crees hoy que tiene más probabilidades de alcanzar el objetivo». Es decir, la tarea ya incorpora tu propio juicio y el modelo es solo el ejecutor. Para subir un nivel, hay que preguntarse: ¿qué es lo que realmente quiero que ocurra a continuación? Detrás de este objetivo inmediato, ¿qué objetivo mayor hay?
El artículo original ofrece un ejemplo muy concreto. Al principio, el autor le pedía a Claude que ayudara a arreglar problemas de caída puntuales, y más tarde directamente le encargó «mantener la aplicación estable y sin caídas». Pero este paso no se consigue cambiando una sola frase de la indicación: primero tuvo que asegurarse de que Claude pudiera acceder fácilmente a los informes de caída, supiera qué commit de Git corresponde a cada versión de la aplicación y, además, pudiera usar equipos con Windows, macOS y Linux. Solo así podría reproducir el problema de forma independiente y verificar si la corrección funcionaba.
Este es el juicio central del artículo: delegar resultados a la IA exige que la IA tenga las entradas, la capacidad de acción y los medios de verificación que necesita el ciclo cerrado. Si falta cualquier eslabón, la delegación de resultados degenera en delegación de tareas y vuelves al estado de estar asignándole trabajo una y otra vez.
El salto de tres niveles al entregar resultados a la IA: el caso de la revisión trimestral
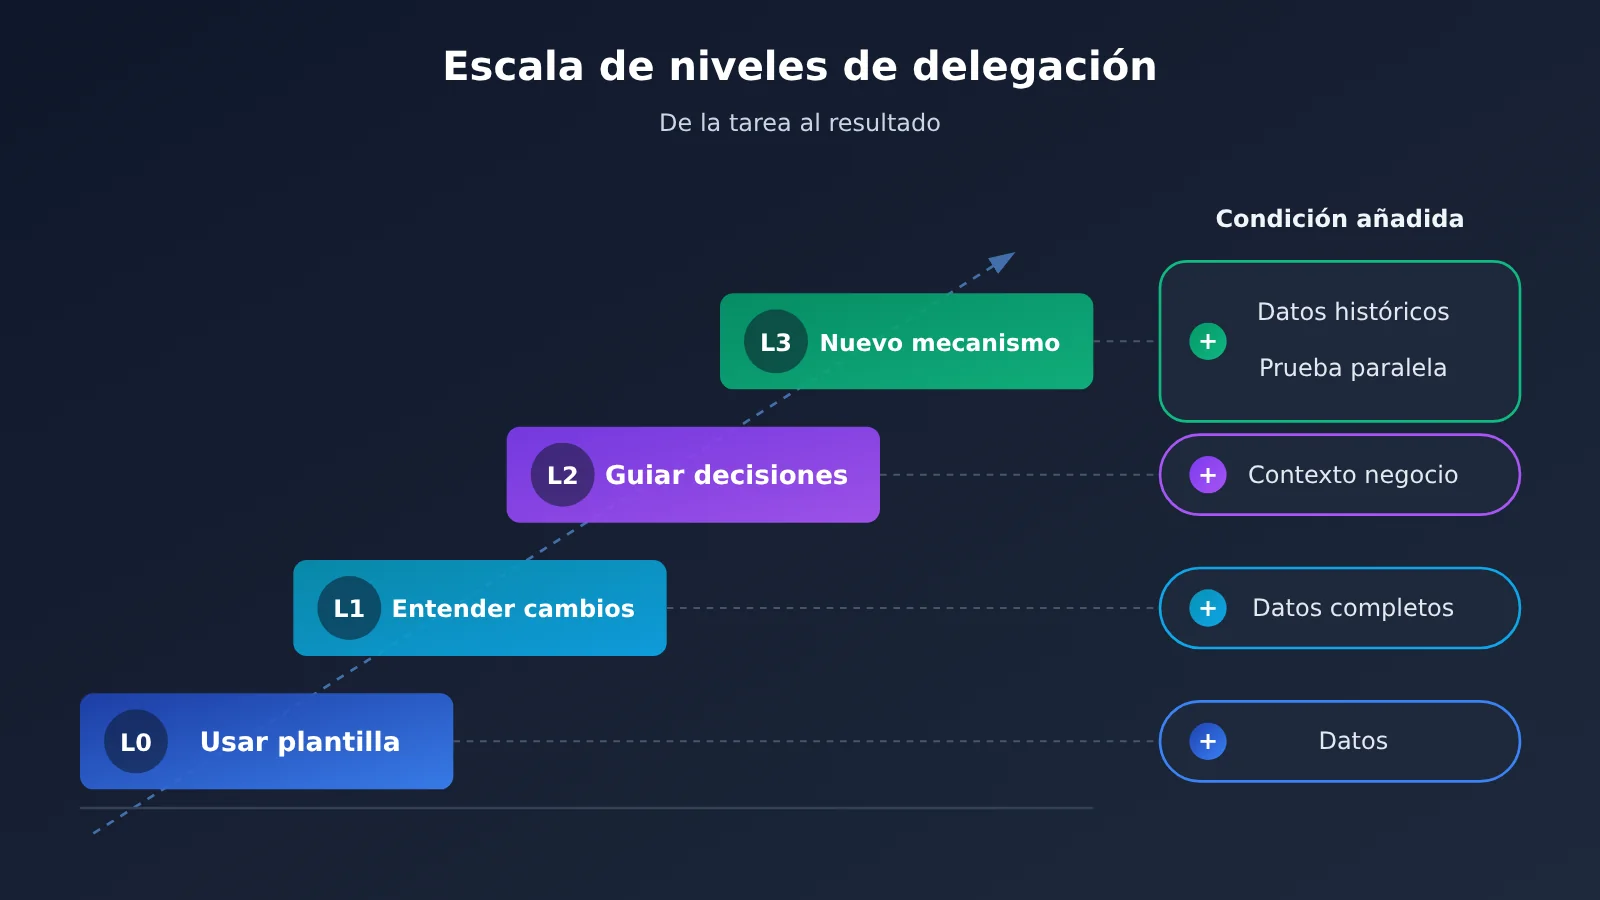
El artículo original usa una tarea de oficina «algo aburrida» como ejemplo: preparar las diapositivas de la revisión trimestral de negocio (QBR) de la empresa ficticia Acme. Una misma cosa se puede dividir en tres niveles, de menor a mayor.
| Nivel | Lo que le entregas a la IA | Frase típica | Qué necesita la IA |
|---|---|---|---|
| L0 Tarea | Rellenar números en una plantilla | «Convierte estos datos en diapositivas» | Un conjunto de datos ya ordenado |
| L1 Comprensión | Entender qué ha pasado | «Dime qué cambió este trimestre, por qué y qué deberíamos hacer» | Datos de negocio lo más completos posible |
| L2 Decisión | Impulsar que la reunión tome decisiones | «Identifica las tres decisiones más urgentes y enumera los argumentos a favor y en contra» | Datos más contexto de negocio y restricciones |
| L3 Mecanismo | Rediseñar la propia revisión | «Diseña una forma mejor que las diapositivas trimestrales, demuestra con datos históricos que detecta los problemas antes y hazla funcionar en paralelo con el proceso actual durante un trimestre» | Datos históricos, entorno de ejecución y validación por comparación |
Al llegar a L3, lo que entregas ya no es «un juego de diapositivas», sino el resultado de «que la dirección detecte los problemas cuanto antes y asigne el dinero y las personas al lugar adecuado». El artículo original ofrece una señal de juicio muy útil: si lo que estás haciendo todavía va a necesitar una reunión para discutirse, probablemente merece la pena subir el objetivo un nivel más.
Antes de entregar los resultados a la IA, hay 5 cosas que el flujo de trabajo debe cambiar primero
Combinando los dos casos del texto original —la gestión de fallos y la revisión trimestral— podemos resumir 5 elementos de infraestructura que hay que cambiar sí o sí. La siguiente tabla pone ambos casos uno al lado del otro para que puedas mapearlos a tu propio negocio.
| Elemento de mejora | Caso de gestión de fallos | Caso de revisión trimestral | Pregunta de autoevaluación |
|---|---|---|---|
| 1. Canal de datos originales | Puede leer directamente los informes de fallos | Acceso a los registros de negocio originales y a los datos de usuario | ¿La IA recibe material original o resúmenes de segunda mano? |
| 2. Mapeo trazable | El número de versión corresponde al commit de Git | La definición de las métricas corresponde a la fuente de datos | ¿Puede la IA rastrear desde el síntoma hasta la causa? |
| 3. Entorno donde poder actuar | Máquinas de prueba de los tres sistemas operativos principales | Puede instalar software, ejecutar bases de datos y modelos estadísticos | ¿Puede la IA reproducir y experimentar por sí misma? |
| 4. Evaluación externa | Tras la corrección, el fallo real ya no se produce | Validar la capacidad predictiva con datos que el modelo no ha visto | ¿Los resultados están demostrados por algo externo a la IA? |
| 5. Paralelismo y retirada | La corrección se verifica primero en el entorno de prueba | El nuevo mecanismo convive con el proceso antiguo durante un trimestre | ¿Se puede revertir sin pérdidas si algo falla? |
Mejora 1: abrir el canal de los datos en bruto para poder entregarle los resultados a la IA
El texto original insiste una y otra vez en la sección de «profundidad»: los profesionales de primer nivel parten de los materiales más primigenios, no de información que ya ha sido ordenada y procesada. En el mundo de los negocios, muchos «hechos aceptados» no son más que aproximaciones burdas de la realidad; si le das a la IA únicamente una tabla resumen preparada por otra persona, solo podrá razonar sobre esa aproximación.
En la práctica, puedes empezar por elaborar una «lista de datos legibles por IA»: logs, tickets, informes de fallos, cuentas de solo lectura de la base de datos, documentación histórica, etc. El texto original menciona que se puede dar acceso al modelo a los datos relevantes mediante conectores MCP u otras vías; hoy en día ya hay bastantes herramientas que ofrecen este tipo de capacidades, y elegir una resulta mucho más fiable que ponerse a pegar datos a mano una y otra vez.
Mejora 2: crear un mapeo trazable del síntoma a la causa
En el caso del fallo, «qué commit de Git corresponde a cada versión de la aplicación» parece un detalle, pero determina si la IA puede pasar de un informe de fallo al cambio de código concreto. Sin esa capa de mapeo, la IA solo puede adivinar, y si se equivoca tendrás que intervenir manualmente.
Llevado al terreno del negocio, esto significa que la definición de las métricas debe poder rastrearse hasta la fuente de datos. Por ejemplo, con qué ventana temporal y qué tipo de usuarios se calcula la «tasa de abandono» tiene que quedar transparente para la IA. Cuanto más claro sea el mapeo, menos se desviará la IA cuando trabaje en niveles de abstracción más altos.
Transformación 3: Darle a la IA una computadora con la que pueda actuar
El texto original lo dice sin rodeos: todos los enfoques anteriores parten de una premisa: el modelo necesita poder usar una computadora, instalar software y acceder a todo tipo de datos relevantes. Cuando Claude esté a punto de salir del paso con una tabla Markdown para el análisis, hay que insistir en que use bases de datos y modelos estadísticos, porque “hacer que el modelo parezca un experto” a menudo solo cambia el vocabulario, no la forma de trabajar.
Para los equipos de ingeniería, este paso implica entornos sandbox, máquinas de prueba y aislamiento de permisos; para los equipos de negocio, un espacio de trabajo donde puedan ejecutar herramientas de análisis. Se recomienda aplicar el principio de mínimo privilegio: primero solo lectura y, cuando se haya validado que es fiable, abrir poco a poco los permisos de escritura.
Transformación 4: Mantener la evaluación externa y no dejar que la IA se puntúe a sí misma
La recomendación del autor original es muy clara: al menos en este momento, en octubre de 2026, se aconseja firmemente mantener la validación externa y, preferiblemente, herramientas que el modelo pueda ejecutar por sí mismo y que devuelvan retroalimentación inmediata. Los casos de prueba, los resultados de reproducción reales y los conjuntos de datos de validación reservados son más fiables que “qué nota se pone el modelo a sí mismo”.
En la versión más avanzada del repaso trimestral, el texto original propone que Claude construya una simulación del comportamiento de los clientes a partir de los registros, identifique las señales que anticipan antes la pérdida de clientes y luego demuestre con datos que no ha visto que esa señal realmente tiene capacidad predictiva. Esta es la forma estándar de la evaluación externa: las conclusiones deben resistir una verificación fuera del modelo.
Reforma cinco: diseñar un periodo de operación en paralelo y las condiciones de salida
La delegación de nivel L3 tiene una acción clave: hacer que el nuevo mecanismo funcione en paralelo con el proceso existente durante un trimestre. No es solo prudencia, también es una evaluación externa: si el nuevo mecanismo realmente detecta los problemas antes, se puede comparar con el proceso antiguo del mismo periodo.
Al mismo tiempo, hay que reconocer las limitaciones. El texto original admite que, de cara a 2026, para la mayoría de las empresas todavía no funciona eso de decir simplemente «Claude, ponte a ganar dinero». Por eso, cada delegación de resultados debería especificar claramente los límites, los puntos de control y la forma de revertir, en lugar de entregarlo todo de una vez.
Cómo empezar rápido a delegar resultados en la IA: un proceso de delegación sin escribir código
Este proceso no depende de programación y sirve para que los equipos de producto, operaciones, análisis e ingeniería lo apliquen directamente.
Paso 1: Decidir si vale la pena entregarle el resultado a la IA
Primero filtra con tres preguntas: ¿este trabajo seguirá necesitando una reunión para discutirse después? ¿Tiene un resultado final claro, y no solo una producción creativa? ¿Se repite de forma periódica? El texto original señala que elevar el nivel del objetivo resulta más útil cuando se persigue un resultado final, y no tanto cuando se trata de trabajo creativo. Si respondes «sí» a dos de las tres preguntas, vale la pena intentarlo.
Paso 2: Rellenar un pliego de delegación de resultados
En lugar de escribir una indicación larga, conviene dividir la delegación en campos fijos. La estructura de este pliego se puede reutilizar tal cual.
| Campo | Qué se rellena | Ejemplo (gestión de fallos) |
|---|---|---|
| Resultado final | Lo que realmente quieres que ocurra | La aplicación se mantiene estable en las tres plataformas principales |
| Objetivo detrás del resultado | La intención un nivel por encima | Reducir la pérdida de usuarios por fallos |
| Datos disponibles | Lista de materiales en bruto y cómo obtenerlos | Informes de fallos, mapeo de versiones y commits |
| Entorno disponible | Máquinas y herramientas que la IA puede manejar | Equipos de prueba con Windows, macOS y Linux |
| Validación externa | Quién o qué demuestra que el resultado es correcto | Poder reproducir de forma estable y verificar que la corrección funciona |
| Límites y reversión | Las líneas que no se pueden cruzar y el plan para el fallo | Modificar solo la rama de pruebas; la fusión la hace una persona |
| Objetivo de desafío | Un estándar alto que parece irrazonable | Ejemplo del original: exigir que el tiempo de carga pase de 10 segundos a 200 milisegundos directamente |
La casilla «objetivo de desafío» viene de una recomendación de fondo del texto original: fija un objetivo que parezca irrazonable y dile al modelo que es totalmente razonable. Si el modelo cree que no se puede, vuelve a insistir en que el problema tiene solución y que solo tiene que seguir esforzándose. En psicología, la conclusión a la que llegaron Locke y Latham tras revisar 35 años de investigación sobre fijación de objetivos también lo respalda: los objetivos específicos y desafiantes son mejores que un vago «haz lo posible».
Tercer paso: reescribe tu delegación con las «cuatro preguntas profundas»
El autor original compartió una idea de indicación que usa con frecuencia: la clave está en que, antes de reescribir la tarea, primero hagas que el modelo responda cuatro preguntas. Con tus propias palabras, podría quedar así:
Quiero llevar esta tarea más a fondo, no hacerla más grande. Antes de ponerte manos a la obra, responde: primero, ¿qué cosas haría un profesional de primer nivel de este campo que yo no le he pedido? Segundo, ¿con qué materiales de la fuente más primaria empezaría? Tercero, ¿qué métodos y herramientas concretas usaría? Cuarto, aparte de tu criterio y el mío, ¿qué más puede demostrar que el resultado es correcto? Después, reescribe mi encargo a partir de eso.
Estas cuatro preguntas se corresponden con los puntos de mejora anteriores: datos originales, herramientas profesionales y evaluación externa. Las lagunas que el modelo deja al descubierto suelen ser justo esa pieza que falta en tu flujo de trabajo.
Cuarto paso: elige cómo acceder al modelo
Las delegaciones por resultados suelen implicar ejecuciones largas y de muchas rondas, así que la estabilidad del acceso al modelo y el costo de cambiar de proveedor afectan directamente la implementación. APIYI ofrece llamadas API a la serie Claude que aparece en este artículo y a otros modelos principales, y es compatible con los dos formatos de interfaz de OpenAI y Anthropic. Normalmente basta con reemplazar base_url y la clave API en el SDK o framework de Agent que ya tengas para integrarte; para direcciones y parámetros concretos, consulta la documentación de APIYI en docs.apiyi.com.
| Necesidad de acceso | Método recomendado | Descripción | Plataformas disponibles |
|---|---|---|---|
| Proyecto con SDK de OpenAI existente | Formato compatible con OpenAI | Modificar base_url y la clave API | APIYI apiyi.com, API oficial |
| Uso de capacidades nativas de Claude | Formato compatible con Anthropic | Mantener la estructura de mensajes de Anthropic | APIYI apiyi.com, API oficial |
| Comparación y validación de varios modelos | Cambiar el nombre del modelo desde una interfaz unificada | Contrastar distintos modelos en el mismo flujo de trabajo | APIYI apiyi.com |
| Cálculo de costos | Consultar la página de precios | El precio unitario de entrada, salida y caché se rige por la página de precios | Página de precios: https://docs.apiyi.com/models |
🚀 Consejo para empezar: conviene primero cerrar el ciclo en un alcance pequeño y luego ampliarlo poco a poco. Se recomienda usar APIYI apiyi.com para conectar uno o dos modelos con la interfaz unificada y hacer pruebas comparativas. Sobre precios de modelos, criterios de facturación, precio unitario de entrada y salida y precio de caché, este artículo no incluye cifras concretas: rige lo que indique la página de precios de APIYI https://docs.apiyi.com/models.
La expansión en amplitud de delegar el resultado a la IA: convoca a un equipo virtual
Cuando la altura y la profundidad ya están resueltas, la amplitud decide si el resultado puede llegar a sorprender. El texto original recomienda dos métodos que puedes plasmar directamente en la especificación de delegación de resultados.
El primero es cambiar sustantivos por verbos, una idea tomada de El arte de la innovación. Una revisión trimestral no es «un conjunto de diapositivas», sino «lograr que un grupo de personas ocupadas crea, en 30 minutos, en una explicación causal y tome decisiones en medio de la incertidumbre». Cuando describes el trabajo con acciones, tanto tú como la IA detectáis con más facilidad qué áreas pueden aportar una perspectiva única.
El segundo es convocar a tu equipo. Supón que esta revisión tiene que ser excepcional: ¿a quién llamarías? La respuesta del original son analistas, periodistas y editores y, si hace falta, un diseñador de motion graphics y un diseñador de audio, además de un «equipo rojo» formado por inversores en corto y contadores forenses. Con múltiples sesiones o subagentes, hoy esto ya no resulta caro.
Lo que hay que vigilar es la trampa del juego de roles: la conversación se vuelve cada vez más vistosa, pero el entregable no mejora. El recordatorio del original es no dejar que el modelo escriba imitando el tono de un inversor en corto, sino que adopte el método que un inversor en corto usa de verdad cuando investiga un valor.
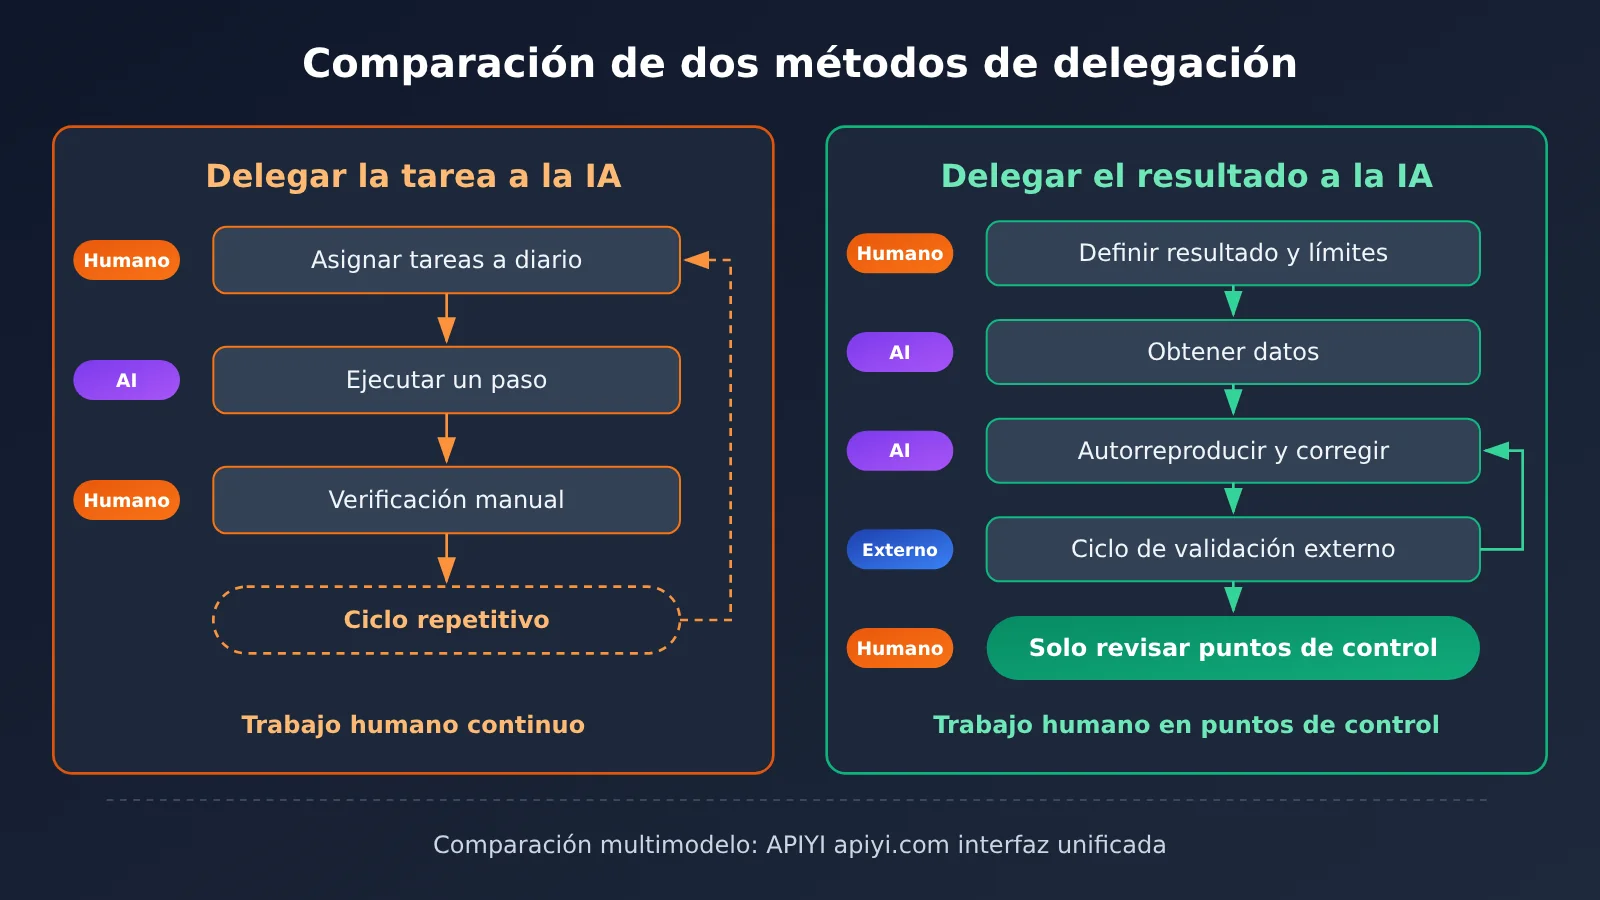
La imagen anterior compara la estructura de esfuerzo humano que exigen las dos formas de delegación. Si quieres comprobar las diferencias de estabilidad entre distintos modelos en escenarios de delegación de resultados, puedes usar APIYI apiyi.com para cambiar el nombre del modelo dentro del mismo flujo de trabajo y hacer la comparación, reduciendo así el trabajo de integración repetida.
Preguntas frecuentes (FAQ)
P1: ¿Qué significa «entregar el resultado a la IA»?
Se refiere a dejar de asignarle a la IA una tarea concreta y, en su lugar, darle un resultado final y las condiciones necesarias para que ella misma lo descomponga, lo ejecute y lo valide. Por ejemplo, pasar de «arregla este fallo» a «mantén la aplicación estable y sin fallos»; la persona solo define el objetivo, los límites y los puntos de control.
P2: ¿Qué diferencia hay entre entregar el resultado a la IA y la automatización convencional con agentes de IA?
La automatización suele encadenar pasos fijos, y esos pasos siguen siendo diseñados por personas. Entregar el resultado a la IA también implica cederle la decisión de «qué método elegir»: la IA puede rediseñar el proceso en sí, por ejemplo, rediseñar el mecanismo de revisión trimestral. Lo primero optimiza la eficiencia de ejecución; lo segundo eleva el nivel de abstracción del trabajo.
P3: ¿Los modelos actuales realmente pueden asumir la delegación de resultados?
En parte, sí. El autor del artículo original observa que, cuanto más capaces son los modelos, mejor pueden trabajar en un nivel de abstracción más alto, y que la gente está encontrando en esa dimensión procesos que funcionan a largo plazo sin intervención continua. Pero también admite que, para 2026, un objetivo totalmente abierto como «ve y gana dinero» seguirá sin funcionar para la mayoría de las empresas; necesita límites y validación externa.
P4: ¿Qué tipos de trabajo son los más adecuados para entregar el resultado a la IA?
Principalmente, los siguientes escenarios:
– **Gestión de estabilidad**: ciclo cerrado de monitoreo de fallos, reproducción y validación de correcciones
– **Análisis de negocio**: pasar de la revisión trimestral a un sistema continuo de alerta temprana de problemas
– **Investigación de abandono de usuarios**: buscar en los registros originales las primeras señales de abandono y validar su capacidad predictiva
– Señal para decidir: si después del entregable todavía hay que reunirse para discutirlo, normalmente merece la pena plantearlo en un nivel de abstracción superior
P5: ¿Cómo montar rápidamente un flujo de trabajo de delegación de resultados a través de la API?
Recomiendo empezar con una interfaz unificada para completar el circuito mínimo:
1. Regístrate en APIYI (apiyi.com) y obtén una clave API
2. Consulta la documentación de APIYI en docs.apiyi.com y configura base_url con el formato compatible con OpenAI o Anthropic
3. Usa la especificación de delegación de resultados de este artículo para definir un objetivo de alcance reducido y conectarlo a una fuente de datos
4. Añade validación externa y, tras completar un ciclo, amplía el alcance
P6: En una delegación de resultados de larga duración, ¿cómo estimar los costos?
La delegación de resultados genera muchas llamadas de varios turnos. Recomiendo registrar primero el consumo real de tokens en un alcance pequeño y luego hacer una estimación según el precio unitario. Para el precio unitario, los criterios de facturación y los precios de caché, guíate por los datos reales de la página de precios de APIYI: https://docs.apiyi.com/models; este artículo no ofrece cifras concretas. Para contextos largos que se reutilizan, consulta la información sobre facturación de caché en la página de precios.
P7: ¿Qué riesgos conocidos implica entregar el resultado a la IA?
Hay tres principales: primero, la autoevaluación del modelo no es fiable, así que hay que introducir una evaluación externa; segundo, ampliar la cobertura tiende a convertirse en juego de roles, con resultados llamativos pero inútiles; tercero, unos permisos demasiado amplios conllevan riesgo operativo. Recomiendo empezar con solo lectura y abrir poco a poco los permisos de escritura, y diseñar para cada delegación un periodo de ejecución en paralelo y un plan de reversión.
Puntos clave: entregar el resultado a la IA
- La tarea incluye tu criterio: solo al entregar el resultado puedes permitir que la IA elija un enfoque mejor que el tuyo
- Las reuniones son una señal para elevar el nivel: si el entregable aún necesita una reunión para discutirse, vale la pena subir el objetivo un nivel más
- Tres elementos de un ciclo cerrado: datos originales, un entorno donde se pueda actuar y validación externa; no puede faltar ninguno
- La profundidad depende de herramientas especializadas: apóyate en bases de datos y modelos estadísticos, no en tablas Markdown
- La amplitud se logra tomando prestados métodos: toma prestados métodos reales de otros campos, no imites el tono
- Ejecutar en paralelo reduce el riesgo: haz que el nuevo mecanismo y el proceso antiguo funcionen en paralelo durante un ciclo antes de cambiar
- Integración y facturación: se puede integrar mediante la interfaz unificada de APIYI; los precios se rigen por docs.apiyi.com/models
Resumen
Los puntos clave de «delegar la tarea a la IA no es tan importante como delegarle el resultado»:
- Primero, eleva el nivel: aclara qué resultado se espera realmente detrás de la tarea inmediata y avanza desde el L0 de rellenar plantillas hasta el L3 de rediseñar el mecanismo
- Después, cambia el flujo de trabajo: conecta los datos originales, crea un mapeo trazable, ofrece un entorno donde se pueda actuar, mantén una evaluación externa y diseña la ejecución en paralelo y la salida
- Por último, amplía profundidad y amplitud: usa las cuatro preguntas de profundidad para completar los métodos especializados y aprovecha un equipo virtual para incorporar perspectivas de otros campos
Se recomienda empezar por un escenario pequeño, periódico y que requiera reuniones para discutirse; usa el documento de delegación de resultados durante un ciclo completo y luego decide si ampliar el alcance. Para la integración de modelos, se recomienda validar resultados rápidamente a través de APIYI apiyi.com: ofrece llamadas API a modelos principales como Claude, es compatible con los formatos de interfaz de OpenAI y Anthropic; los detalles de integración están en la documentación docs.apiyi.com y los precios se rigen por https://docs.apiyi.com/models.
📚 Referencias
- Cómo fijar metas más ambiciosas: una guía práctica para usuarios de IA: traducción al chino de InfoQ
- Enlace:
infoq.cn/article/F1ms7x7KI1p7UfocCywh -
Descripción: origen de las ideas centrales de este artículo y de los casos sobre gestión de colapsos y revisión trimestral
-
How to be more ambitious: A tutorial for humans with models: texto original en inglés de Felix Rieseberg
- Enlace:
felixrieseberg.com/how-to-be-more-ambitious-a-tutorial-for-humans-with-models -
Descripción: análisis completo de las cuatro dimensiones: velocidad, altura, profundidad y amplitud
-
Centro de documentación de APIYI: formatos de interfaz e instrucciones de integración
- Enlace:
docs.apiyi.com -
Descripción: cómo configurar los formatos compatibles con OpenAI y Anthropic
-
Página de precios de modelos de APIYI: precio unitario y criterios de facturación
- Enlace:
docs.apiyi.com/models - Descripción: los precios de entrada, salida y caché se rigen por los datos reales de esta página
Autor: equipo técnico de APIYI
Contacto técnico: te invitamos a contactarnos desde la página principal de APIYI para compartir experiencias prácticas sobre encargos de resultados; para más recursos, visita el centro de documentación en docs.apiyi.com