Nota del autor: Un análisis de la factura de tokens en tareas largas de agentes: por qué los tokens de entrada representan casi todo el consumo y cómo organizar el contexto para reutilizar mejor la caché de prefijos.
Muchos equipos descubren el problema al revisar la factura de fin de mes, después de integrar agentes de varios pasos en sus productos: el usuario hizo una sola petición, pero el consumo de tokens fue decenas de veces mayor que en una conversación normal. La primera reacción suele ser pensar que «el modelo se extiende demasiado» y reducir la longitud de sus respuestas. En realidad, la mayor parte del consumo está en la entrada y proviene, sobre todo, del contexto histórico que debe volver a incluirse en cada ronda.
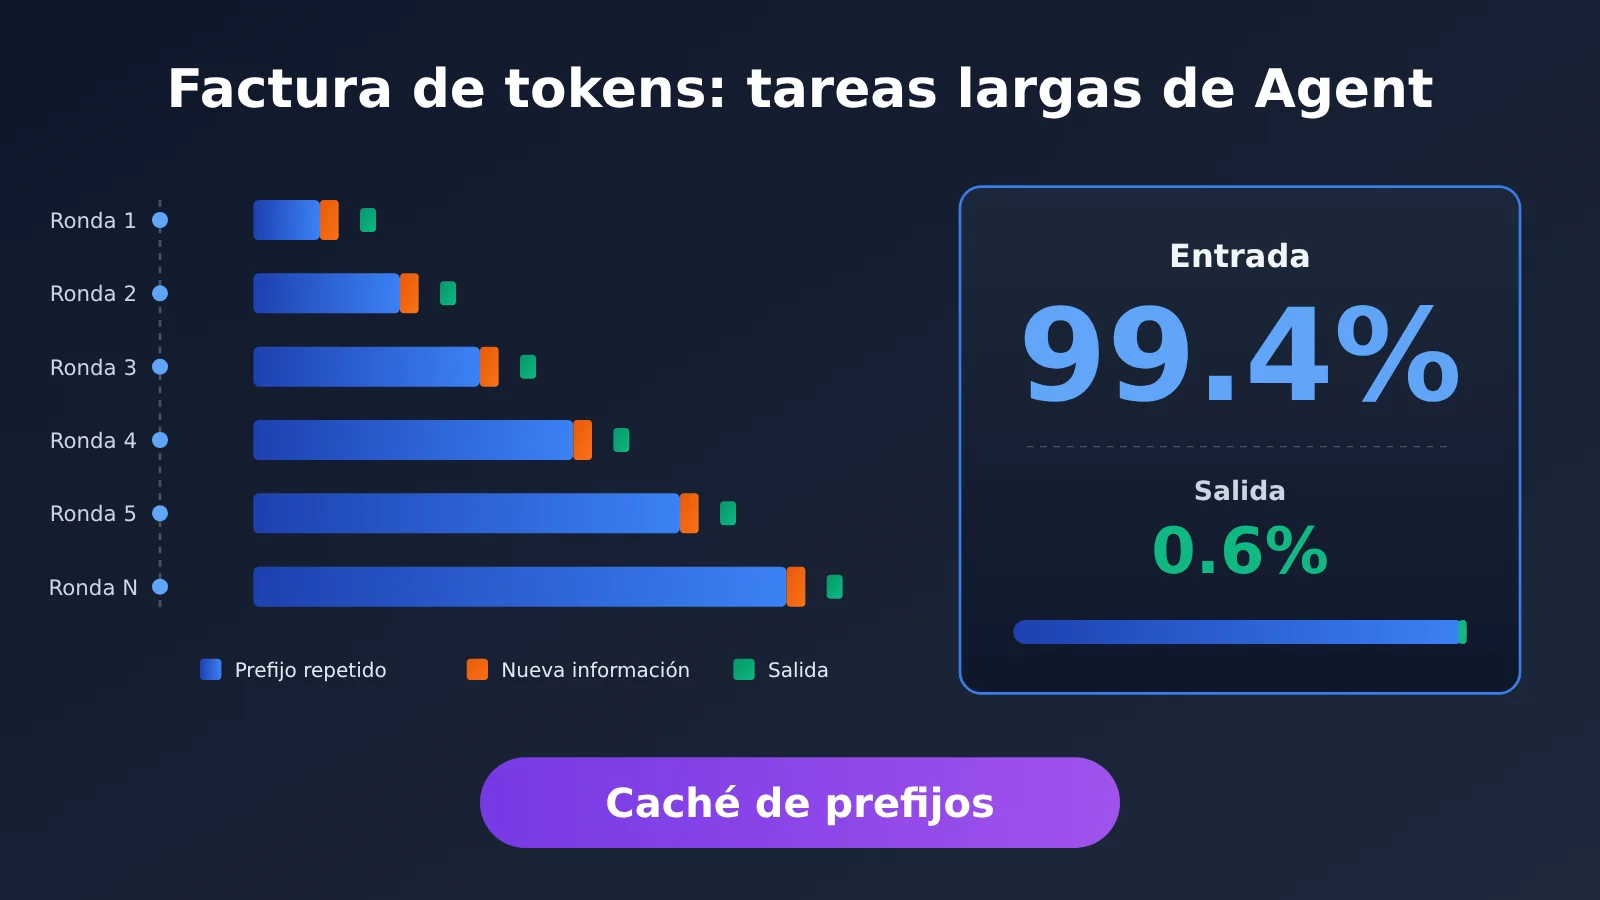
No es una suposición basada en la intuición. Algunas publicaciones técnicas recientes ofrecen datos concretos: en entornos de producción en China, una petición de usuario activa una media de unas 7,2 invocaciones del modelo; en una cadena de 50 pasos, los tokens de entrada representan aproximadamente el 99,4 % y los de salida, solo el 0,6 %. Los equipos de motores de inferencia describen las cargas de trabajo de los agentes de forma similar: prefijos largos, respuestas cortas y ciclos de varias rondas.
Qué te llevarás: al terminar este artículo, entenderás cómo se estructura la factura de tokens de las tareas largas de agentes, por qué la caché de prefijos puede reducir los costos y qué 5 métodos puedes aplicar en tu aplicación para organizar el contexto.
Claves de la factura de tokens en tareas largas de agentes
Esta tabla resume las conclusiones del artículo; después veremos cada punto en detalle.
| Punto clave | Explicación | Por qué te importa |
|---|---|---|
| Se multiplican las invocaciones | Una solicitud del usuario genera una media de unas 7,2 invocaciones del modelo; en tareas complejas no es raro superar los 50 pasos | Calcula el costo por «tarea», no por «solicitud» |
| La entrada concentra casi todo el costo | En una cadena de 50 pasos, la entrada representa aproximadamente el 99,4 % y la salida, el 0,6 % | Para reducir costos, prioriza la entrada; reducir la salida tiene un efecto limitado |
| El contexto repetido es la causa principal | En cada paso se vuelve a incluir el historial, por lo que el mismo contenido se factura una y otra vez | Identifica el verdadero origen del costo |
| La caché de prefijos permite reutilizar contenido | Si una parte del prefijo coincide con la caché, se evita repetir el cálculo de prefill | Un contexto con estructura estable resulta más económico |
| La estructura determina la tasa de aciertos de caché | Mantén estables las indicaciones y la estructura de las herramientas, coloca la información variable al final y comprime el historial cuando convenga | Puedes reducir costos sin cambiar de modelo |
En detalle: el costo de tokens en tareas largas de agentes
La principal diferencia entre un agente y un chat convencional es el «bucle». Para crear una presentación de PowerPoint, por ejemplo, el sistema debe leer el material, planificar el contenido, generar cada diapositiva, usar herramientas para crearla y revisar el resultado. Para el usuario es una sola tarea, pero el sistema realiza varias rondas de razonamiento e invoca herramientas en repetidas ocasiones. Además, en cada paso puede volver a leer el contexto y, si el resultado no es satisfactorio, tiene que volver atrás y corregirlo.
En cada invocación, el modelo recibe la «indicación del sistema + definiciones de herramientas + historial completo hasta el momento + información nueva de esta ronda». El historial crece cada vez más, aunque el contenido nuevo de cada ronda sea escaso. Tras decenas de rondas, el mismo prefijo se ha facturado decenas de veces. Así es como la entrada llega a representar el 99,4 %.
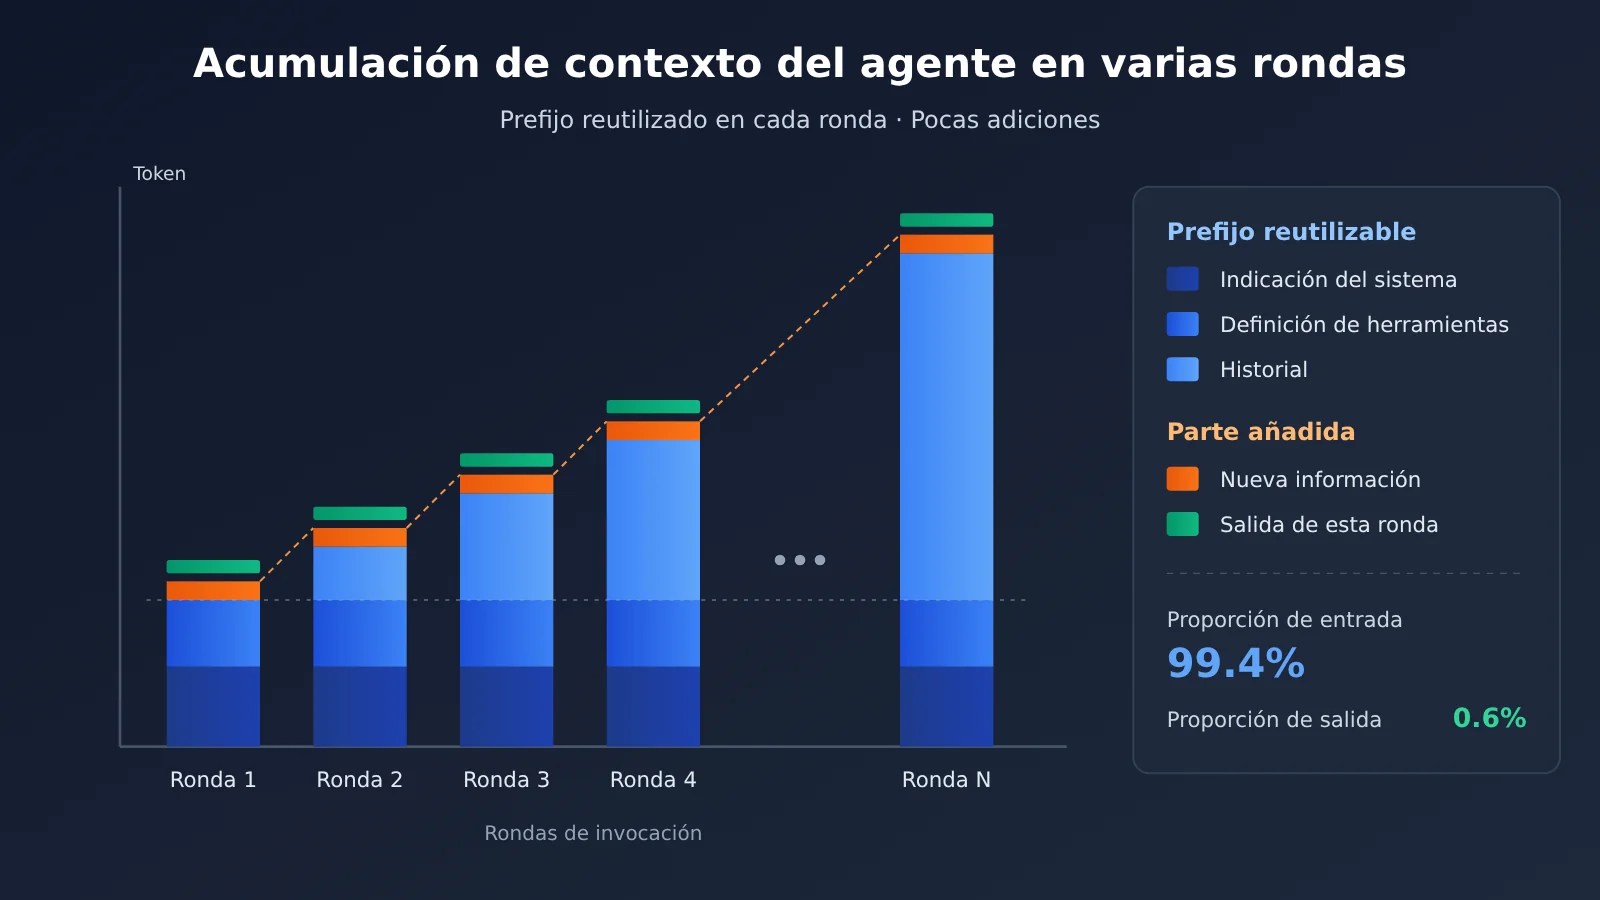
Por qué las tareas largas de los agentes consumen muchos más tokens de entrada que de salida
Desde el punto de vista del motor de inferencia, la estructura se ve más clara. En su presentación, TokenSpeed usa como ejemplo un agente de programación: el modelo razona, llama a herramientas, obtiene resultados y vuelve a razonar. Todo el proceso consiste en ciclos de varias solicitudes cortas. La primera solicitud puede incluir un contexto de prefijo de decenas de miles de tokens, mientras que la salida de cada ciclo posterior suele ser de apenas unos cientos de tokens.
La siguiente tabla compara las cargas de trabajo de chat y de agentes para ayudarte a identificar a cuál se parece tu aplicación.
| Dimensión | Carga de chat tradicional | Carga de tareas largas de agentes |
|---|---|---|
| Forma de las solicitudes | Una pregunta y una respuesta, generada de una sola vez | Ciclos de solicitudes cortas intercaladas con llamadas a herramientas |
| Longitud del prefijo | Normalmente corta | Puede empezar con decenas de miles de tokens y crecer en cada ciclo |
| Salida por ciclo | Relativamente larga | Suele ser de apenas unos cientos de tokens |
| Reutilización del contexto | Se carga una vez y después se libera | El mismo prefijo se envía repetidamente durante la tarea |
| Principal factor de costo | Tanto la entrada como la salida tienen un peso considerable | La entrada, especialmente el prefijo repetido, representa la gran mayoría |
Cómo funciona la caché de prefijos en las tareas largas de los agentes
El motor de inferencia procesa las solicitudes en dos fases: en la fase de prefill calcula toda la entrada y genera la KV Cache; en la fase de decode genera los tokens de salida uno a uno. En los escenarios con agentes, hay que procesar en prefill un prefijo de decenas de miles de tokens en cada ciclo, y ahí es donde se concentra el costo. Si un prefijo ya se ha calculado y el resultado sigue en caché, se puede reutilizar directamente y evitar ese trabajo de prefill.
Los equipos de motores de inferencia consideran que la tasa de reutilización de la KV Cache es una variable clave para determinar el costo de inferencia. Según se menciona en la presentación, la tasa de reutilización de caché de DeepSeek supuestamente supera el 99 %, mientras que la mayoría de los sistemas del sector se encuentran actualmente entre el 70 % y el 80 %. En las cargas de agentes, la tasa de aciertos de prefijo durante el prefill suele superar el 90 %; cuando hay un acierto, solo hace falta calcular unos cientos de tokens adicionales.
Hay otro detalle fácil de pasar por alto: la caché de prefijos se compara por segmentos y desde el principio. En sus inicios, TokenSpeed tomó como referencia a SGLang y utilizó un Radix Tree para gestionar la caché de prefijos. Cada nodo del árbol correspondía a una secuencia de tokens, y la solicitud se comparaba recorriendo el árbol desde la raíz. Aunque después se cambió a un diseño Flat KV, la reutilización sigue haciéndose en bloques lógicos de tamaño fijo de 128 tokens. Para quienes desarrollan aplicaciones, la conclusión es directa: si un solo token difiere al principio, el contenido posterior ya no se puede reutilizar.
Cómo organizar el contexto para mejorar los aciertos de la caché de prefijos en tareas largas de un agente
Una vez que entiendes cómo funciona la coincidencia en caché, la estrategia es clara: hacer que el inicio de cada solicitud sea lo más largo y estable posible. El equipo de WorkBuddy mantiene fijas las indicaciones y la estructura de las herramientas, coloca la información variable al final del contexto y comprime el historial cuando este crece demasiado. Aquí tienes cinco prácticas para ponerlo en marcha.
| Práctica | Acción concreta | Error frecuente |
|---|---|---|
| 1. Fijar la indicación del sistema | Mantener el texto de la indicación del sistema sin cambios y agrupar las actualizaciones de versión | Insertar la hora actual, el nombre de usuario o ejemplos aleatorios al principio |
| 2. Fijar la estructura de las herramientas | Mantener sin cambios el orden de la lista de herramientas y las descripciones de sus parámetros | Añadir o quitar herramientas en cada ronda, o usar un orden de serialización inestable |
| 3. Poner la información variable al final | Añadir al final las marcas de tiempo, las observaciones de la ronda y el estado dinámico | Escribir el «progreso actual» al principio de la indicación del sistema |
| 4. Solo añadir al historial, sin modificarlo | Mantener intacto el historial ya enviado y añadir el contenido nuevo al final | Cambiar el formato o reordenar los mensajes anteriores en cada ronda |
| 5. Comprimir el historial por etapas | Cuando el contexto sea demasiado largo, comprimirlo una vez en un punto de control y seguir añadiendo contenido después | Volver a generar el resumen en cada ronda, lo que hace que el prefijo cambie constantemente |
Tareas largas con agentes: mantener fijas las indicaciones y la estructura de herramientas
Los puntos 1 y 2 son los más fáciles de pasar por alto. Muchos frameworks añaden la fecha actual a la indicación del sistema o seleccionan herramientas dinámicamente en cada paso. Ambas prácticas hacen que el inicio cambie en cada ronda, por lo que la caché de prefijos deja de servir desde el primer token. Una opción más segura es incluir solo las reglas y el rol en la indicación del sistema, y colocar datos como la fecha en un mensaje normal al final. Para las herramientas, conviene enumerarlas todas de una vez y usar la indicación para limitar cuáles se pueden utilizar en cada fase, en lugar de modificar la lista.
También hay que prestar atención a la serialización. Si el orden de los campos JSON de una misma definición de herramienta cambia entre procesos, a nivel de bytes se trata de dos prefijos distintos. Conviene ordenar siempre las definiciones de herramientas antes de enviarlas y registrar el hash del prefijo en los logs. Así es más fácil investigar por qué no hubo un acierto de caché aunque, aparentemente, nada haya cambiado.
Tareas largas con agentes: equilibrar la compresión del historial y la reutilización de la caché
El punto 5 requiere encontrar un equilibrio. Comprimir el historial reduce la longitud de la entrada, pero también cambia el prefijo, por lo que la caché no se podrá aprovechar en esa ronda. Si se comprime en cada ronda, se renuncia a reutilizarla cada vez. Una estrategia más razonable es establecer un umbral y comprimir, por ejemplo, cuando el contexto alcance cierta longitud o termine una subtarea. La versión comprimida pasa entonces a ser el nuevo prefijo estable: a partir de ahí, solo se añade contenido, sin reescribirlo.
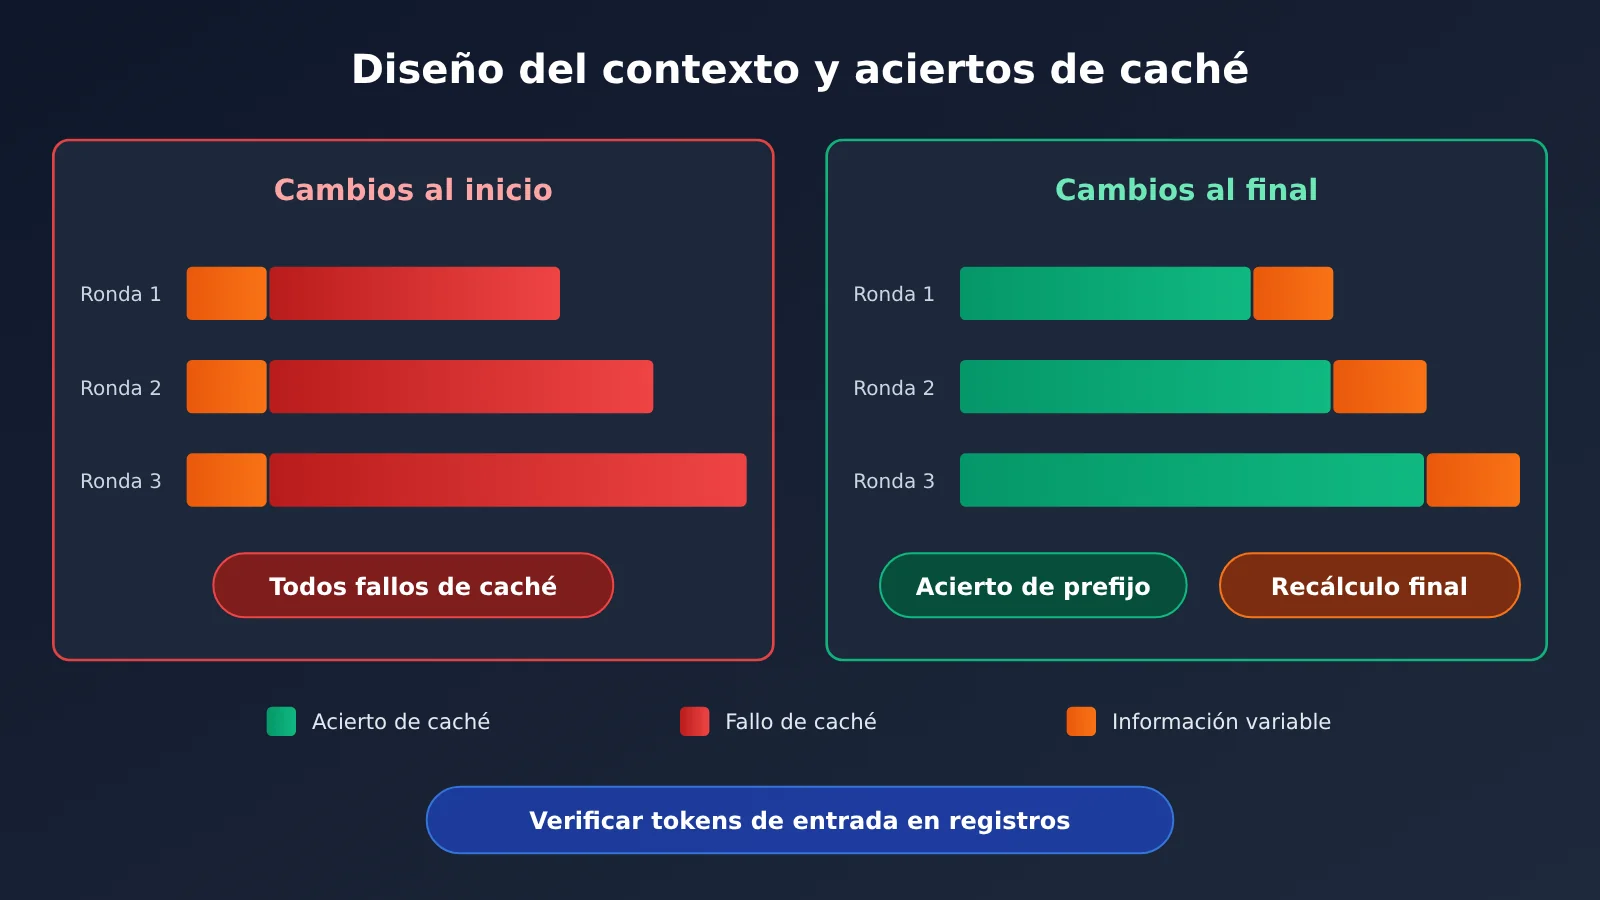
En una sola solicitud, las dos disposiciones de la imagen apenas muestran diferencias. Pero en una tarea larga de decenas de rondas, la diferencia en la factura puede ser considerable. Para saber cuál utiliza tu aplicación, lo más directo es revisar cómo cambian los tokens de entrada de cada ronda en los logs de llamadas. APIYI apiyi.com ofrece facturación unificada, estadísticas de uso y logs de llamadas. Permite comparar los datos de varios modelos en un mismo lugar, algo útil para analizar la estructura de la factura.
Guía rápida para optimizar la factura de tokens en tareas largas de agentes
Esta sección no incluye código: solo una serie de pasos prácticos que puedes seguir en orden.
Paso 1: Desglosa la factura de tokens por tarea
- Genera un ID para cada tarea de usuario y registra ese ID en cada invocación del modelo dentro de la tarea.
- Registra la cantidad de tokens de entrada y salida a partir de la información de
usagede cada respuesta. Algunos proveedores también devuelven por separado los tokens con acierto de caché; consulta la documentación oficial para conocer los nombres exactos de los campos. - Resume tres métricas por tarea: número de invocaciones, proporción entre entrada y salida, y porcentaje de aciertos de caché.
Si usas modelos de varios proveedores, es habitual que los registros no sigan los mismos criterios. Al unificar el acceso mediante APIYI, puedes consultar el detalle de uso y los registros de invocación de cada modelo en una sola consola. Combinados con los ID de tarea que hayas registrado, obtendrás una visión completa de cuánto cuesta cada tarea y en qué paso se gasta.
Paso 2: Localiza dónde se modifica el prefijo
- Selecciona dos solicitudes consecutivas de una misma tarea y compara, sección por sección, si las indicaciones del sistema, las definiciones de herramientas y el historial de mensajes son idénticos.
- Presta especial atención a la posición de campos dinámicos como marcas de tiempo, números aleatorios y estados del usuario.
- Comprueba que el orden de serialización de las definiciones de herramientas y los mensajes se mantenga estable entre solicitudes.
Paso 3: Ajusta según las 5 prácticas y vuelve a probar
- Mueve el contenido dinámico al final y mantén fijas las indicaciones del sistema y la lista de herramientas.
- Define un umbral para comprimir el historial y hazlo en puntos de control, en lugar de hacerlo en cada turno.
- Ejecuta el mismo conjunto de tareas de prueba con las versiones anterior y posterior a los cambios, y compara los tokens de entrada y el porcentaje de aciertos de caché por tarea.
🚀 Consejo para empezar: compara siempre el antes y el después con las mismas tareas y el mismo modelo; de lo contrario, los datos no serán comparables. Con la interfaz unificada de APIYI, puedes cambiar de modelo y repetir las pruebas sin adaptar cada interfaz por separado. Además, las estadísticas de uso están centralizadas, lo que facilita observar por separado la «optimización de la estructura» y las «diferencias entre modelos».
Límites de la estimación de costos
WorkBuddy publicó una estimación basada en la escala de sus tareas y las tarifas publicadas para el nivel insignia de TokenHub: con una tasa de aciertos de caché del 90 %, el costo estimado por tarea podría bajar de unos 21,06 yuanes a unos 3,36 yuanes. Ten en cuenta que estas cifras corresponden a condiciones concretas de longitud de contexto y precio. Como no se publicaron todas las condiciones, no es posible reproducir el cálculo y tampoco puedes aplicar esas cifras directamente a tu aplicación.
| Factor | Por qué cambia el resultado | Qué debes verificar |
|---|---|---|
| Longitud del contexto | Cuanto más largo sea el prefijo, mayor será el ahorro al reutilizar la caché | La longitud media del prefijo en tus tareas |
| Facturación de la caché | Cada proveedor aplica descuentos distintos a la parte recuperada de la caché | El precio de la caché en la documentación oficial del modelo elegido |
| Condiciones de activación de la caché | Las reglas, como la longitud mínima y el período de validez, varían | Las reglas de activación y caducidad en la documentación oficial |
| Intervalo entre invocaciones | Si pasa demasiado tiempo entre dos turnos, la caché puede haber caducado | Si el tiempo de ejecución de las herramientas es compatible con la validez de la caché |
| Número de pasos de la tarea | Cuantos más pasos haya, mayor será la acumulación de prefijos repetidos | La distribución del número de pasos en tareas reales |
Medidas complementarias para reducir el costo de tokens en tareas largas de agentes
Además de la estructura del contexto, en la misma presentación se mencionaron dos estrategias de aplicación que pueden usarse junto con la caché de prefijos.
- Elegir el modelo según el paso: el equipo de WorkBuddy señaló que cerca del 80 % de los pasos sencillos pueden delegarse a modelos ligeros, lo que reduce el costo por tarea alrededor de un 57 %. Pasos como organizar información o convertir formatos no siempre requieren un modelo de primer nivel.
- Gestionar los fallos según su causa: ante tiempos de espera agotados, solicitudes rechazadas o fallos del proveedor, se puede limitar el número de reintentos, ajustar el contexto o cambiar de modelo, según la causa. Los reintentos ilimitados pueden hacer que se facture repetidamente el mismo prefijo largo.
Conviene recordar que cambiar de modelo implica usar una caché diferente, por lo que la reutilización de prefijos debe comenzar de cero. Por eso, al diseñar el enrutamiento, es mejor mantener los pasos consecutivos de una misma subtarea en el mismo modelo siempre que sea posible, y reservar los cambios de modelo para los límites entre subtareas.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es la caché de prefijos en tareas largas de agentes?
La caché de prefijos permite que el servicio de inferencia guarde los prefijos de entrada ya calculados (KV Cache) y los reutilice cuando las solicitudes posteriores comienzan igual, evitando el cálculo de prefill de esa parte. Como los agentes incluyen un historial extenso y repetido en cada ronda, se prestan especialmente bien a esta reutilización.
Q2: ¿En qué se diferencia la caché de prefijos de comprimir el contexto histórico?
La caché de prefijos no reduce el contenido de entrada; solo abarata el cálculo de las partes repetidas. En cambio, comprimir el historial acorta la entrada, pero modifica el prefijo y provoca un fallo de caché en esa ronda. Conviene combinar ambas técnicas: normalmente, solo añadir contenido para favorecer los aciertos de caché y comprimirlo al llegar a un punto de control.
Q3: ¿El 99.4% de entrada se aplica a todos los agentes?
No necesariamente. Esa cifra procede de una experiencia compartida sobre una cadena de invocaciones de 50 pasos. En tareas con menos pasos y salidas más largas por ronda, la proporción de entrada será menor. Aun así, cuando la estructura es de «prefijo largo, salida corta y múltiples rondas», la entrada suele representar la mayor parte. Lo recomendable es comprobarlo con tus propios registros.
Q4: ¿En qué escenarios de agentes merece más la pena optimizar la caché de prefijos?
– **Agentes de programación**: el contexto del repositorio es largo y los ciclos de lectura de archivos, modificación de código y ejecución de pruebas son frecuentes
– **Generación de documentos o PPT**: tras leer los materiales, el contenido se genera página por página y el prefijo se repite en gran medida
– **Agentes de análisis de datos**: las estructuras de las tablas y las descripciones de los indicadores son fijas; en cada ronda solo se añaden los resultados de las consultas
Q5: ¿Cómo puedo ver rápidamente la composición de tokens de entrada y salida de mi aplicación?
La forma más sencilla es agrupar los datos de uso de cada ronda por ID de tarea. Si tu aplicación utiliza varios modelos, puedes invocarlos de forma unificada mediante APIYI apiyi.com. La plataforma ofrece estadísticas de uso y registros de invocaciones, lo que facilita consultar la composición de entradas y salidas por modelo y periodo. Para conocer la compatibilidad de la plataforma con la caché de indicaciones de cada modelo y sus métodos de facturación, consulta la documentación de la plataforma.
Q6: ¿Qué limitaciones conocidas tiene la caché de prefijos?
– Las condiciones de activación varían según el proveedor, por ejemplo, la longitud mínima y el periodo de validez; consulta la documentación oficial de cada uno
– Si una herramienta tarda demasiado en ejecutarse, la caché podría caducar antes de la siguiente ronda
– Cambiar de modelo o modificar la indicación del sistema invalida toda la caché
– El descuento aplicado a la parte que aprovecha la caché varía según el modelo; es necesario medir el ahorro real para confirmarlo
Puntos clave sobre la factura de tokens en tareas largas de agentes
- El costo se calcula por tarea: una solicitud implica unas 7,2 invocaciones, y una tarea larga puede superar los 50 pasos.
- La entrada es el principal factor de costo: en una cadena de 50 pasos, representa aproximadamente el 99,4 %; reducir la salida tiene un efecto limitado.
- La caché busca coincidencias desde el principio: si un solo token del inicio es distinto, no se puede reutilizar el contenido posterior.
- La estructura importa más que el modelo: mantén fijas las indicaciones y la estructura de las herramientas, y coloca la información variable al final.
- La compresión necesita un ritmo: comprime una vez en cada punto de control para evitar reescribir el prefijo en cada ronda.
- No extrapoles las estimaciones: las cifras de costos publicadas dependen de longitudes y precios concretos; conviene hacer tus propias pruebas.
- Observa antes de optimizar: usa las estadísticas de uso y los registros de invocación de APIYI para analizar la estructura de la factura.
Resumen
Estas son las conclusiones principales sobre la factura de tokens en tareas largas de agentes:
- Estructura de la factura: el costo proviene sobre todo del historial de contexto que se vuelve a incluir en cada ronda. Los tokens de entrada representan la mayor parte.
- Cómo reducir costos: la caché de prefijos evita repetir el cálculo de prefill para los prefijos reutilizados. La tasa de aciertos depende de la estructura del contexto.
- Cómo ponerlo en práctica: mantén fijas las indicaciones y las herramientas, coloca la información variable al final, limita los cambios en el historial a añadir contenido y comprímelo por etapas. Combina estas medidas con la elección del modelo según el paso.
Como primer paso, dedica una semana a desglosar los registros por tarea y comprobar qué proporción corresponde a la entrada y cuál es la tasa de aciertos de caché. Después, aplica una por una las cinco prácticas de este artículo. Si trabajas con varios modelos, puedes unificar el acceso a través de APIYI en apiyi.com y consultar de forma centralizada el uso y los registros de invocación. Así podrás evaluar el efecto real de cada optimización con el mismo conjunto de datos.
📚 Referencias
- Construcción de un motor de inferencia LLM de próxima generación para el razonamiento agéntico: resumen de la presentación de TokenSpeed en AICon 2026, Shenzhen
- Enlace:
infoq.cn/article/YwAayF1ylWb7oN4P0lyC -
Descripción: presenta las características de las cargas de trabajo de agentes, con «prefijos largos y salidas cortas», la tasa de reutilización de la caché KV y el diseño estructural de la caché de prefijos.
-
De la invocación del modelo a la entrega de tareas: cómo llega MaaS a la producción de agentes: resumen de la sesión dedicada a MaaS de Tencent Cloud
- Enlace:
infoq.cn/article/zZutPTX8bsr6NWQYNC3A - Descripción: incluye datos compartidos por WorkBuddy sobre el número de invocaciones, la proporción de entrada, la caché de prefijos y el enrutamiento de modelos.
Autor: Equipo técnico de APIYI
Intercambio técnico: Si tienes preguntas sobre la invocación de varios modelos o el análisis de uso, contáctanos a través de APIYI en apiyi.com. Encontrarás más información en el centro de documentación docs.apiyi.com.