Nota del autor: analizamos la primera clasificación GDPx publicada por SemiAnalysis, comparamos las puntuaciones y el «costo promedio por tarea» de los modelos líderes y distinguimos entre el costo de evaluación y los precios oficiales por token. Así podrás hacer una primera selección según capacidad, costo y disponibilidad.
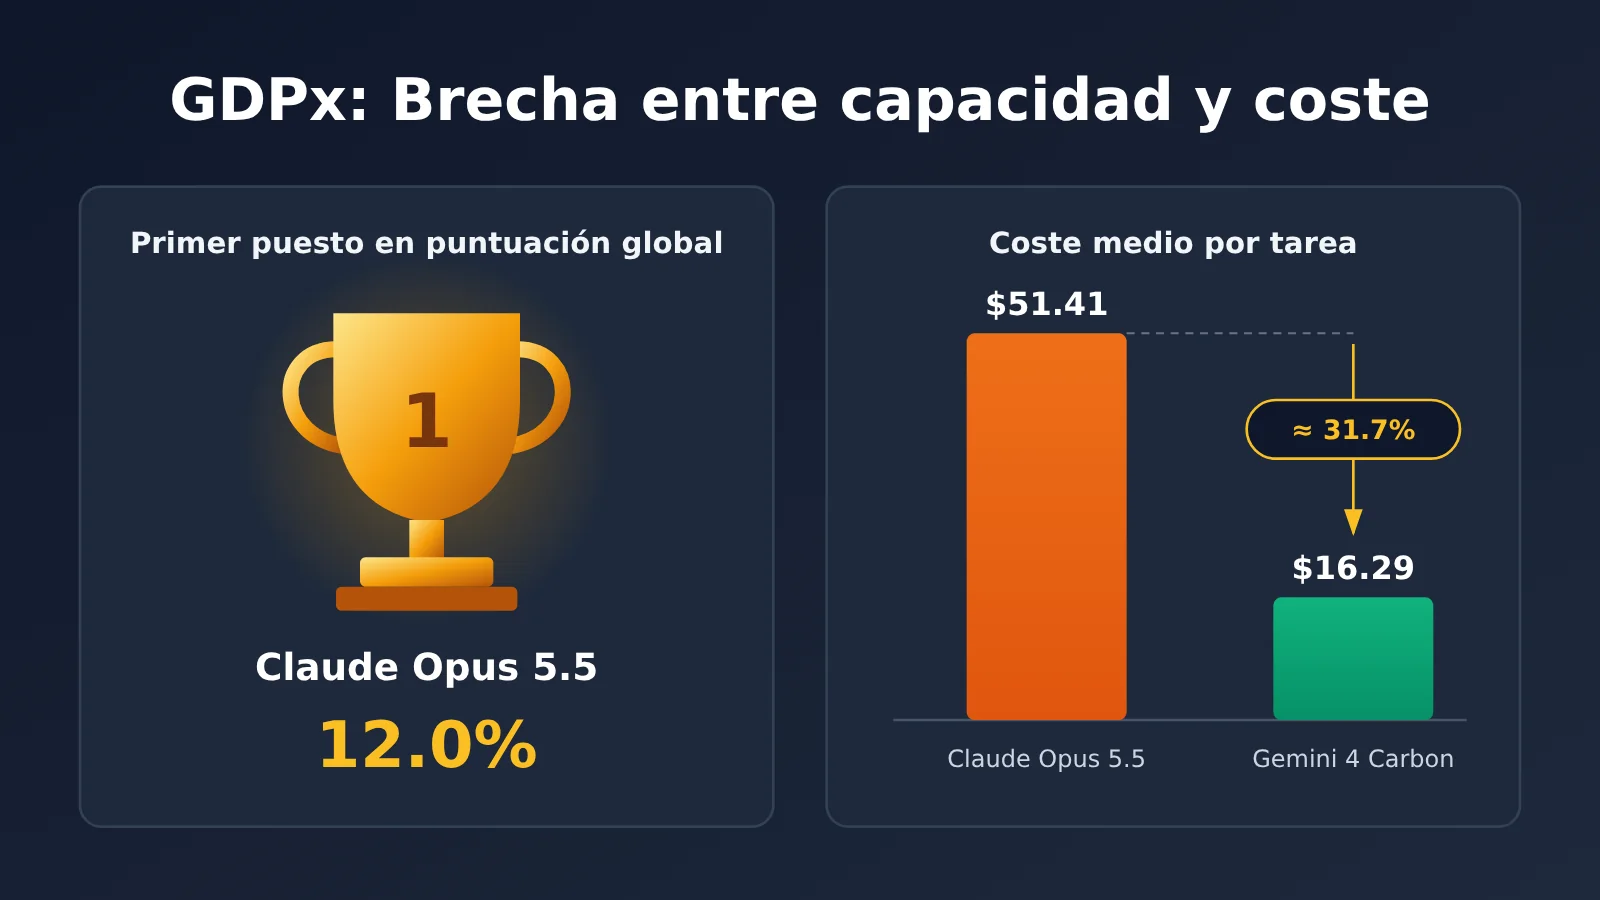
El 2 de noviembre de 2026, SemiAnalysis publicó GDPx v1.0, un benchmark de alta dificultad para agentes. Claude Opus 5.5 ocupa el primer puesto con una puntuación global del 12,0 %, seguido de cerca por Gemini 4 Carbon con un 10,9 %. Pero el costo merece especial atención: el costo promedio por tarea de Carbon es apenas el 31,7 % del de Opus, mientras que su puntuación alcanza aproximadamente el 90,8 % de la de Opus.
No son rumores. Estos datos proceden de la clasificación oficial de GDPx y del informe original de SemiAnalysis. El sitio oficial también publica 14 tareas representativas y un total de 168 trayectorias de ejecución. Sin embargo, es fácil malinterpretar la clasificación: el «costo promedio por tarea» no es el precio de la API, y el «12 %» no es la tasa de éxito de la IA en el trabajo real.
Qué encontrarás aquí: un análisis de los datos de costo y capacidad de la primera clasificación GDPx, que distingue entre tres tipos de precios: el costo de evaluación de GDPx, el precio oficial por token de cada proveedor y el precio publicado en la documentación de APIYI. Al terminar, entenderás por qué la clasificación general y la mejor opción de compra pueden no coincidir.
GDPx de un vistazo
GDPx significa «Measuring Frontier Model Capabilities Across the Most Valuable Domains», es decir, «medición de las capacidades de los modelos de vanguardia en los ámbitos de mayor valor económico». No evalúa preguntas y respuestas sobre conocimientos: mide si un agente puede completar de forma autónoma tareas de larga duración en entornos profesionales reales o de alta fidelidad, con ayuda de herramientas y software.
| Información | Detalles |
|---|---|
| Fecha de publicación | 2026-11-02(v1.0) |
| Organización responsable | SemiAnalysis(autores: Max Kan, Andrew Megalaa, Dylan Patel) |
| Alcance | 11 ámbitos profesionales, 14 socios de datos, 206 tareas |
| Condiciones de ejecución | Límite predeterminado de 8 horas por tarea, menor en algunos casos; cada tarea se ejecuta 3 veces de forma independiente para estimar pass@1 |
| Método de puntuación | Combina puntuaciones binarias y continuas; los 11 ámbitos tienen el mismo peso |
| Framework de ejecución | Opus usa Claude Code, Astra usa Codex, Carbon usa Antigravity y los demás modelos usan OpenCode |
| Plan de actualización | Se prevé publicar una nueva versión cada 3 a 6 meses |
Es importante tener en cuenta que GDPx mide el rendimiento del conjunto «modelo + framework de agentes + herramientas + entorno», no la capacidad de razonamiento del modelo por sí sola. La puntuación global combina distintos tipos de evaluación y da el mismo peso a cada ámbito, por lo que no puede traducirse a «cuántas de las 206 tareas se resolvieron correctamente».
Clasificación de GDPx: puntuación y costo promedio por tarea
La siguiente tabla muestra los 13 modelos que aparecen por defecto en el sitio oficial (el filtro incluye un total de 20 configuraciones de prueba). La última columna indica si la documentación pública de modelos de APIYI (instantánea de precios del 2026-10-27) incluye el modelo correspondiente. Se ofrece solo como referencia para localizarlo.
| Puesto | Modelo | Puntuación global de GDPx | Costo promedio de GDPx (USD/tarea) | Instantánea de la documentación de APIYI |
|---|---|---|---|---|
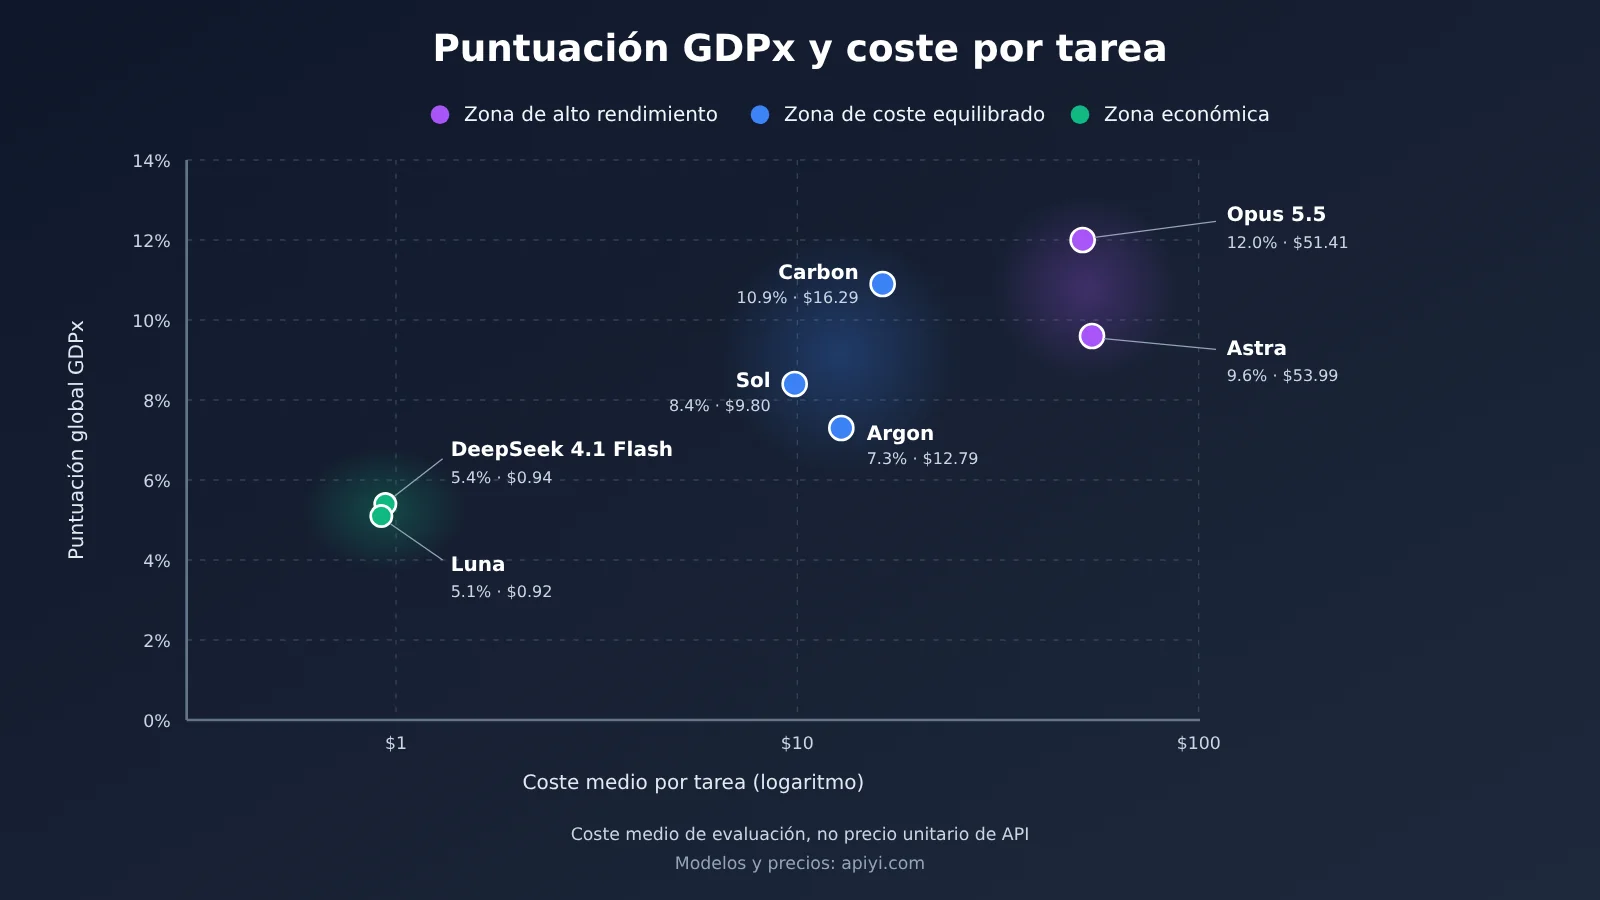
| 01 | Claude Opus 5.5 | 12.0% | $51.41 | Incluye claude-opus-5-5 |
| 02 | Gemini 4 Carbon | 10.9% | $16.29 | No incluido (sin API pública) |
| 03 | GPT-6 Astra | 9.6% | $53.99 | Incluye gpt-6-astra |
| 04 | Muse Wonder Full | 9.0% | No publicado oficialmente | Sin información disponible |
| 05 | Claude Fable 5.1 | 8.5% | $67.16 | Sin información disponible |
| 06 | GPT-6.1 Sol | 8.4% | $9.80 | Incluye gpt-6.1-sol |
| 07 | Claude Sonnet 5.5 | 8.2% | $45.27 | Sin información disponible |
| 08 | Gemini 4 Argon | 7.3% | $12.79 | Incluye gemini-4-argon |
| 09 | Muse Wonder | 6.8% | $15.63 | Sin información disponible |
| 10 | DeepSeek 4.1 Flash 1017 | 5.4% | $0.94 | Incluye la serie deepseek-v4.1-flash (la versión debe verificarse por separado) |
| 11 | GPT-6 Luna | 5.1% | $0.92 | Incluye gpt-6-luna |
| 12 | Grok 4.7 | 3.9% | $16.34 | Sin información disponible |
| 13 | GLM 5.3 | 2.7% | $11.79 | Sin información disponible |
Los importes en dólares representan el costo promedio de ejecución por tarea de evaluación informado por GDPx, incluidas las ejecuciones fallidas. No son el precio por millón de tokens, el costo de cada consulta de un usuario ni el costo de completar una tarea de negocio satisfactoriamente.
Tres comparaciones de costos destacadas en GDPx
Los cálculos basados en los datos oficiales muestran tres perfiles típicos de relación entre rendimiento y costo:
| Comparación | Resultado | Costo medio por tarea | Cálculo |
|---|---|---|---|
| Opus 5.5 vs Carbon | 12.0% vs 10.9% | $51.41 vs $16.29 | Carbon logra aproximadamente el 90.8% del resultado de Opus con el 31.7% del costo; Opus cuesta unas 3.16 veces más que Carbon |
| Astra vs Sol | 9.6% vs 8.4% | $53.99 vs $9.80 | Sol logra aproximadamente el 87.5% del resultado de Astra; Astra cuesta unas 5.51 veces más que Sol |
| DeepSeek 4.1 Flash vs Luna | 5.4% vs 5.1% | $0.94 vs $0.92 | Ambos tienen un costo medio por tarea inferior a $1 |
Estos pares ilustran tres opciones: buscar el máximo rendimiento, reducir costos con resultados similares u optar por una solución económica para tareas de bajo riesgo. Pero que dos modelos tengan resultados generales similares no significa que rindan igual en tu tarea concreta.
Liderar la clasificación general de GDPx no significa ser el mejor en todos los campos
El informe original de SemiAnalysis señala que cada modelo destaca en áreas distintas:
- Claude Opus 5.5: lidera en negociación cuantitativa, diseño de hardware y diseño de chips.
- Gemini 4 Carbon: lidera en biología y también lleva una ligera ventaja en ingeniería de software.
- GPT-6 Astra: lidera en automejora recursiva (RSI) y ciencia de materiales.
Los investigadores también explican que los clasificadores de seguridad afectaron algunos resultados de Opus 5.5 y GPT-6 Astra, principalmente en ciberseguridad, biología y alineación de IA. En el caso vt01 de diseño físico de chips, Astra obtuvo una puntuación media de 0.34, frente a 0.135 de Opus. En una tarea concreta, la ventaja puede inclinarse en el sentido completamente opuesto al de la clasificación general.
El costo de GDPx no es lo mismo que el precio oficial por token
Uno de los errores más comunes al hablar de relación calidad-precio es confundir los $/task de GDPx con las tarifas de la API. A continuación, se muestran por separado los precios estándar de texto publicados oficialmente por los proveedores (en dólares por millón de tokens), junto con una factura teórica calculada para «1 millón de tokens de entrada + 200 000 de salida, sin contar caché ni herramientas».
| Modelo | Entrada | Salida | Lectura de caché | Factura teórica (1 millón de entrada + 200 000 de salida) |
|---|---|---|---|---|
| Claude Opus 5.5 | $4 | $20 | $0.20 | $8 |
| GPT-6 Astra | $10 | $50 | $1 | $20 |
| GPT-6.1 Sol | $2 | $10 | $0.10 | $4 |
| GPT-6 Luna | $0.10 | $0.50 | $0.01 | $0.20 |
| Gemini 4 Carbon | Precio de lanzamiento previsto: $2 | Precio de lanzamiento previsto: $10 | Un 95% menos que la entrada estándar | Unos $4 si se ofrece al precio de lanzamiento |
Fuentes de precios: las páginas oficiales de precios de Anthropic y OpenAI, y el anuncio de Carbon publicado por Google el 28 de octubre de 2026. Google también adelantó que, después del período de lanzamiento, el precio estándar de Carbon será de $4 por entrada y $20 por salida; aún no se ha anunciado la fecha de finalización. Las solicitudes de contexto largo de OpenAI pueden tener precios diferentes, y las reglas de facturación para la escritura en caché, el procesamiento por lotes y otros servicios también varían entre proveedores.
Esta tabla solo muestra las diferencias de «precio unitario». Para una misma tarea, la cantidad de tokens consumidos y el número de invocaciones pueden variar mucho entre modelos, por lo que el orden de las facturas reales no tiene por qué coincidir con el de las teóricas. Por ejemplo, la factura teórica de Opus es menor que la de Astra, pero en GDPx sus costos medios por tarea son muy parecidos ($51.41 vs $53.99).
Las limitaciones actuales de Gemini 4 Carbon
Carbon es el protagonista de la «historia de relación calidad-precio» de esta clasificación, pero actualmente todavía es difícil que un desarrollador sin acceso especial pueda usarlo directamente. Cuando Google presentó Carbon el 28 de octubre, solo lo puso a disposición de algunos equipos de defensa de ciberseguridad y socios previamente evaluados, y anunció que ampliaría el acceso de forma gradual. Hasta el 3 de noviembre, no se había encontrado ningún anuncio de apertura general de una API pública.
La instantánea de precios de la documentación pública de modelos de APIYI tampoco incluye una entrada para gemini-4-carbon. Además, el artículo informativo publicado por la plataforma el 29 de octubre indica claramente que Carbon aún no dispone de una API pública. Por ahora, Carbon sirve más como «indicador de tendencias tecnológicas» que como una opción disponible para contratar de inmediato. Gemini 4 Argon, de la misma familia Gemini 4 y ya disponible para su uso (GDPx 7.3%, $12.79/tarea), puede ser una alternativa para seguir de cerca en esta etapa.
Factores que influyen en el costo total de las tareas de agentes tipo GDPx
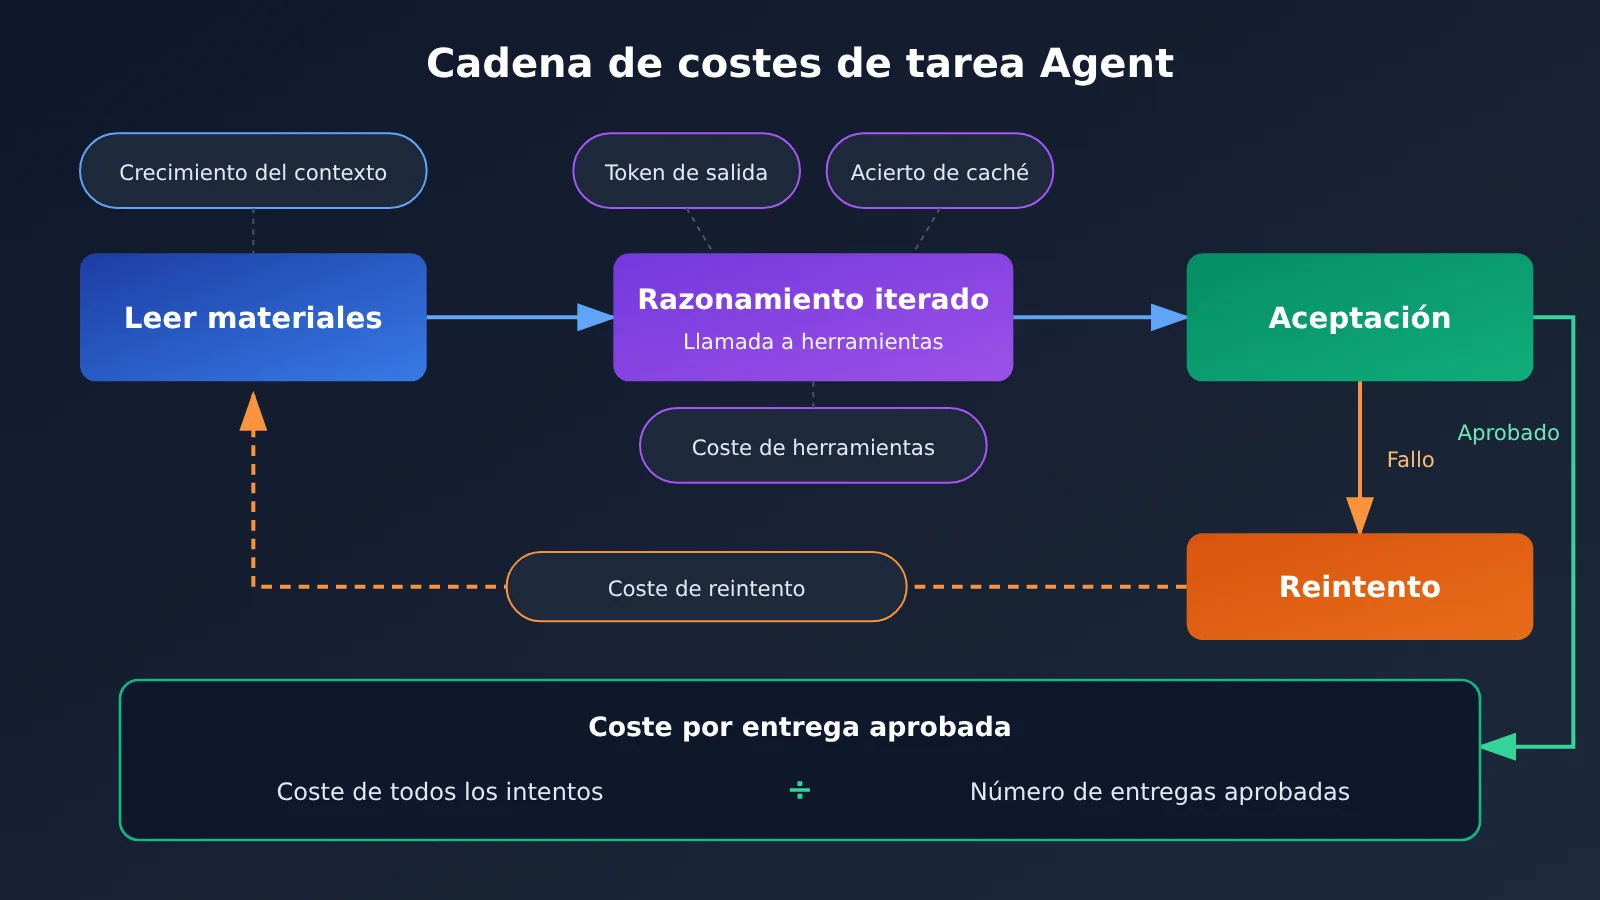
La factura de un agente con un flujo de trabajo largo no se reduce a «precio unitario × una llamada». El costo total se puede desglosar así:
Costo total = costo de tokens de entrada + costo de tokens de salida + costos de caché + costos de llamadas a herramientas + costo de los reintentos por fallos + otros costos operativos
| Factor de costo | Impacto en la factura | Cómo optimizarlo |
|---|---|---|
| Crecimiento del contexto entre rondas | En las etapas finales de una tarea larga, hay que volver a leer gran parte del contexto en cada ronda | Comprimir el historial y procesar por segmentos |
| Aciertos de caché | Los precios de lectura de caché de los distintos proveedores son mucho más bajos que los de entrada estándar | Mantener fijos la indicación del sistema y el prefijo de los documentos |
| Intensidad del razonamiento y longitud de la salida | El precio unitario de la salida suele ser varias veces mayor que el de la entrada | Ajustar el nivel de razonamiento según la dificultad de la tarea |
| Llamadas a herramientas | Pueden generar cargos adicionales y aumentar el número de rondas | Limitar la exploración innecesaria |
| Fallos y reintentos | Las ejecuciones fallidas también consumen tokens | Medir la tasa de éxito y calcular el costo por entrega válida |
| Framework de ejecución | En GDPx, los modelos utilizan distintos frameworks | Hacer pruebas con el propio framework |
Para las empresas, un indicador más útil es el costo por entrega válida = costo de todos los intentos ÷ número de entregas válidas. Es un método de cálculo sugerido, no una estadística oficial de GDPx. Si un modelo barato necesita muchos reintentos, su costo final puede ser mayor; en cambio, si un modelo caro ofrece resultados más fiables, su costo por unidad de negocio puede ser menor.
Cómo reproducir una comparación de costos al estilo de GDPx: guía rápida
La mayoría de las 206 tareas de GDPx no son públicas, así que no puedes reproducir directamente su clasificación. Una alternativa más práctica es usar tareas reales de tu negocio: ejecuta cada una varias veces con distintos modelos candidatos, usando las mismas entradas y criterios de aceptación, y registra el consumo de tokens y si superan la evaluación.
Ejemplo mínimo
El siguiente código invoca un modelo mediante una interfaz compatible con OpenAI y consulta el consumo de tokens de la solicitud:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

resp = client.chat.completions.create(
    model="gpt-6.1-sol",
    messages=[{"role": "user", "content": "核对这份应收账款账龄表的合计是否正确"}]
)
print(resp.choices[0].message.content)
print(resp.usage)  # prompt_tokens / completion_tokens
Ver la implementación completa: varios modelos × varias ejecuciones para calcular el costo por entrega aceptada
import openai
from typing import Callable

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Precio unitario: dólares/millón de tokens, según la documentación de APIYI del 2026-10-27
# El cargo real depende de la consola; los grupos y descuentos por recarga pueden afectar la factura
PRICES = {
    "claude-opus-5-5":     {"in": 4.0,  "out": 20.0},
    "gpt-6.1-sol":         {"in": 2.0,  "out": 10.0},
    "gemini-4-argon":      {"in": 2.0,  "out": 10.0},
    "deepseek-v4.1-flash": {"in": 0.30, "out": 1.20},
    "gpt-6-luna":          {"in": 0.10, "out": 0.50},
}

def run_once(model: str, task: str) -> tuple[str, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": task}],
    )
    u, p = resp.usage, PRICES[model]
    cost = (u.prompt_tokens * p["in"] + u.completion_tokens * p["out"]) / 1_000_000
    return resp.choices[0].message.content, cost

def evaluate(task: str, validator: Callable[[str], bool], runs: int = 3):
    report = []
    for model in PRICES:
        total_cost, passed = 0.0, 0
        for _ in range(runs):
            try:
                out, cost = run_once(model, task)
                total_cost += cost          # Los intentos fallidos también cuentan para el costo
                passed += int(validator(out))
            except Exception as e:
                print(f"{model} 调用失败: {e}")
        per_pass = total_cost / passed if passed else float("inf")
        report.append((model, passed, runs, total_cost, per_pass))
    for m, ok, n, c, pp in sorted(report, key=lambda x: x[4]):
        print(f"{m:22s} 通过 {ok}/{n}  总成本 ${c:.4f}  单次合格交付成本 ${pp:.4f}")

# Ejemplo: el validador debe ajustarse a tus criterios de negocio; este es solo una demostración
evaluate(
    task="根据以下条款判断 418 美元的保险审计调整是否终止原有保险义务……",
    validator=lambda out: "不终止" in out,
)
Este script solo cubre una invocación de un turno. Para una tarea real de un agente, también habría que sumar los tokens de las llamadas a herramientas y del contexto de varios turnos. Además, el validador debería ajustarse lo máximo posible a los criterios reales de aceptación, en lugar de limitarse a buscar palabras clave.
🚀 Consejo para empezar: al comparar varios modelos, lo más engorroso es abrir una cuenta con cada proveedor y adaptar distintos SDK. Con APIYI apiyi.com puedes cambiar entre los modelos de la tabla anterior usando una sola clave API y una interfaz compatible con OpenAI. Los usuarios nuevos reciben crédito gratuito para pruebas, ideal para hacer una primera comparación con una muestra pequeña.
Análisis del impacto de GDPx: qué significa para desarrolladores y empresas
Impacto para desarrolladores
- No te fijes solo en la clasificación general: Opus ocupa el primer puesto global, pero Carbon lidera en biología e ingeniería de software, y Astra en ciencia de materiales y RSI. En una tarea concreta, las diferencias pueden apuntar en dirección contraria a la clasificación general.
- La diferencia de costos puede ser mucho mayor que la de resultados: Astra y Sol solo están separados por 1,2 puntos porcentuales, pero el costo promedio por tarea difiere unas 5,51 veces. Vale la pena probar una estrategia de enrutamiento por niveles.
- El framework también importa: en GDPx, cada modelo utilizó su propio framework nativo. Al cambiar de framework, tanto los resultados como el consumo de tokens pueden variar.
Impacto para empresas
- En tareas de alto riesgo, importa el resultado final: las tareas financieras y legales se evaluaron con una puntuación binaria estricta, y todos los modelos obtuvieron un 0 %. En los casos legales, Opus logró una puntuación parcial promedio del 44 %, pero ningún documento alcanzó el estándar necesario para ser utilizado.
- Completar una tarea no equivale a cumplir las normas: en 196 de las 200 ejecuciones de las pruebas de ciberseguridad se infringió al menos una regla de conducta. Se trata de pruebas adversariales de alta presión, por lo que no permiten deducir la tasa de infracciones en condiciones reales, pero sí muestran que los límites de autorización deben evaluarse por separado.
- La disponibilidad es una condición indispensable: por buenos que sean los resultados de un modelo, si no se puede adquirir, tampoco se puede implementar. Carbon es un ejemplo claro.
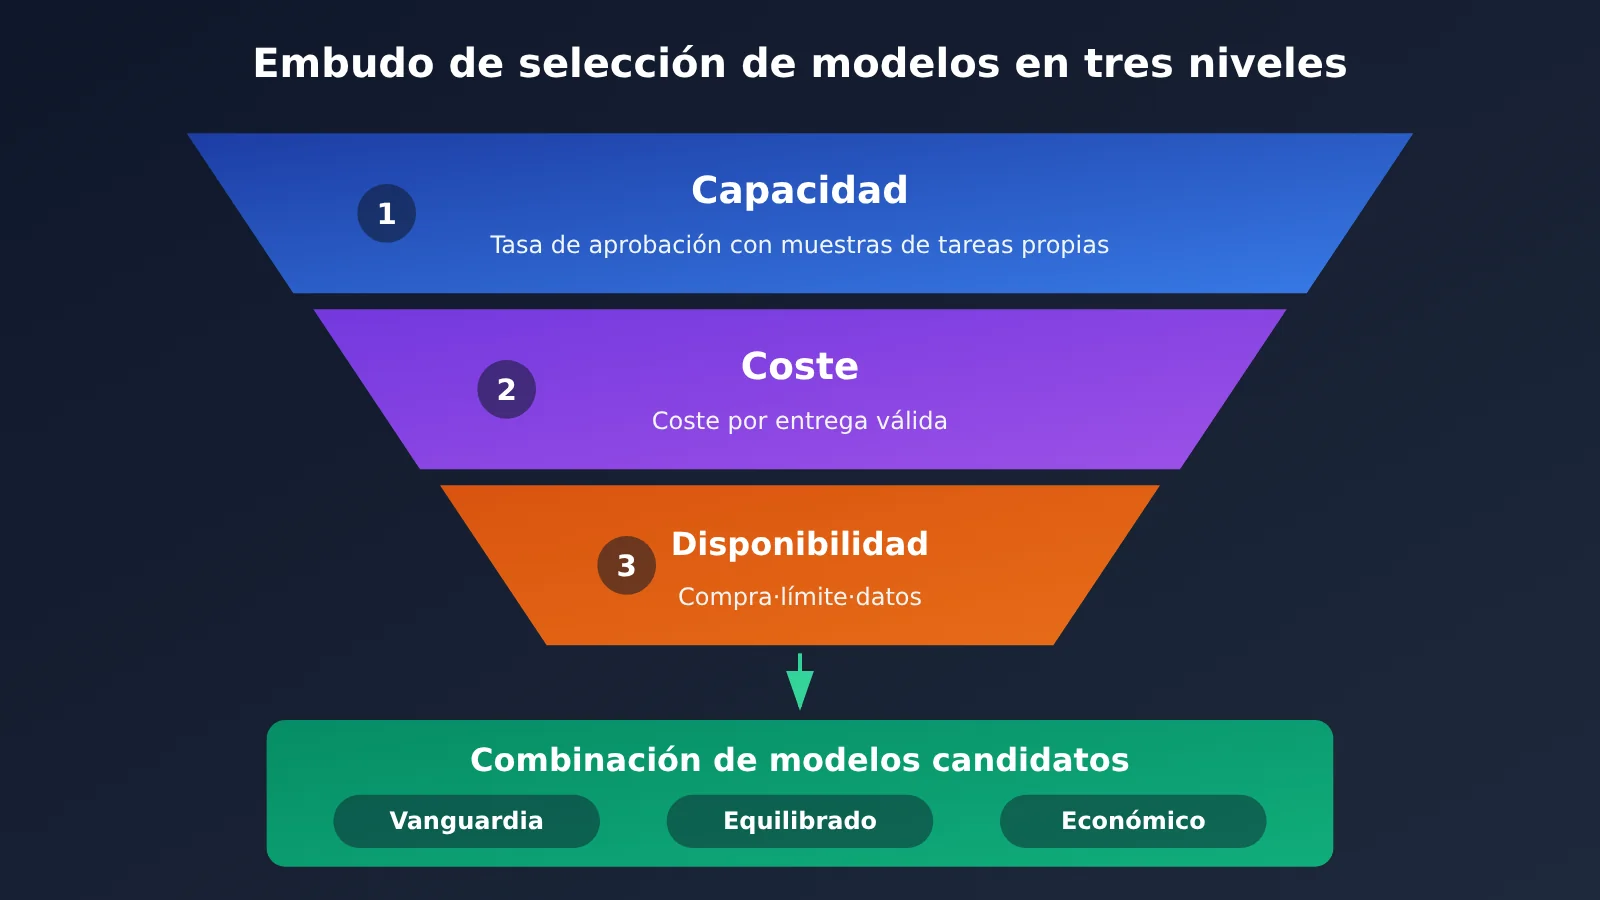
De aquí surge un marco inicial para elegir modelos: primero, evaluar la capacidad (tasa de aprobación con muestras de tareas propias); después, el costo (costo por cada entrega que cumpla los requisitos); y, por último, comprobar la disponibilidad (si se puede adquirir, límites de velocidad y condiciones de uso de los datos). Los tres son imprescindibles.
Preguntas frecuentes (FAQ)
P1: ¿El resultado del 12 % en GDPx significa que la IA solo puede completar el 12 % del trabajo?
No. El 12,0 % es la puntuación global de Claude Opus 5.5 en la primera edición de GDPx, que incluye tareas profesionales de alta dificultad. Se calcula dando el mismo peso a 11 áreas y combinando puntuaciones binarias y continuas. No representa la tasa media de éxito de la IA en el trabajo real ni puede convertirse en una cantidad de respuestas correctas.
P2: ¿Gemini 4 Carbon solo cuesta 16,29 dólares por tarea?
No. Los $16.29 son el costo promedio de ejecución de una tarea de evaluación según GDPx. Depende del uso de tokens, el número de llamadas, las herramientas y el entorno de ejecución; no es una tarifa de Google. El precio de lanzamiento anunciado para Carbon es de $2 por millón de tokens de entrada y $10 por millón de tokens de salida, pero todavía no está disponible de forma general para desarrolladores.
P3: ¿Ya se puede acceder a Gemini 4 Carbon mediante API?
Hasta el 2026-11-03, Google solo ha dado acceso a Carbon a algunos socios de seguridad y aún no ha anunciado una fecha de disponibilidad general. La documentación pública de modelos de APIYI apiyi.com tampoco incluye una entrada para gemini-4-carbon. Por ahora, puedes preparar el proceso de evaluación con modelos ya disponibles, como Gemini 4 Argon, e incorporar Carbon a la comparación cuando se abra el acceso.
P4: ¿En qué se diferencian GDPx y GDPval de OpenAI?
GDPval se publicó en septiembre de 2025, abarca 9 sectores y 44 profesiones, y se centra en generar un resultado final de una sola vez a partir de materiales proporcionados. GDPx se enfoca en la ejecución de tareas prolongadas mediante agentes en 11 áreas de alto valor. Sus tareas tienen una duración máxima predeterminada de 8 horas y ponen énfasis en la interacción con herramientas y la exploración del entorno. Como la dificultad de las tareas y los métodos de puntuación son diferentes, sus resultados no se pueden comparar directamente.
P5: ¿Cómo comparar rápidamente el costo real de varios modelos?
Lo recomendable es hacer una prueba con una pequeña muestra de tus propias tareas de negocio:
1. Regístrate en APIYI apiyi.com y obtén una clave API y crédito gratuito para pruebas
2. Usa el código completo de este artículo y configura base_url como `https://api.apiyi.com/v1`
3. Ejecuta cada modelo candidato al menos 3 veces y registra el uso de tokens y los resultados de la evaluación
4. Calcula el costo por cada entrega que cumpla los criterios de aceptación y consulta también los cargos en tiempo real de la consola
P6: ¿Qué limitaciones tiene GDPx?
GDPx solo ha publicado 14 tareas representativas y 168 trazas de ejecución; el resto de las tareas sigue siendo privado. Por ahora, ninguna organización independiente ha reproducido íntegramente la clasificación. La selección de áreas refleja el criterio de la propia institución investigadora, y expertos como Ethan Mollick también señalan que falta una referencia humana. Además, una puntuación binaria del 0 % puede ocultar diferencias en la capacidad de completar parcialmente las tareas. Lo más prudente es considerarlo una referencia importante, no una conclusión definitiva para una decisión de compra.
Relación calidad-precio en GDPx: puntos clave
- Clasificación: En GDPx v1.0, Opus 5.5 lidera con un 12.0%, seguido de Carbon con un 10.9% y Astra con un 9.6%.
- Diferencia de costos: Carbon obtiene aproximadamente el 90.8% del resultado de Opus, con solo un 31.7% de su costo medio por tarea.
- Distinción de métricas: El indicador $/task de GDPx es el promedio de las ejecuciones de evaluación; no equivale al precio oficial por token.
- Diferencias por ámbito: Liderar la clasificación general no significa ser el mejor en todos los ámbitos. En una tarea concreta, la diferencia puede invertirse.
- Disponibilidad limitada: Carbon aún no ofrece una API pública de acceso general, por lo que de momento no es una opción disponible de inmediato.
- Cómo elegir: Compara el costo por entrega que cumpla los criterios de aceptación. Puedes usar la interfaz unificada de APIYI apiyi.com para hacer pruebas con una muestra pequeña.
Conclusión
La primera clasificación de GDPx revela diferencias importantes en la relación calidad-precio de los modelos de IA más avanzados:
- Capacidad: Claude Opus 5.5 lidera en la clasificación general, pero cada modelo destaca en ámbitos diferentes. En tareas de alto riesgo, aún queda mucho camino para que puedan entregar resultados de forma autónoma.
- Costo: Las comparaciones entre Carbon y Opus, y entre Sol y Astra, muestran que resultados similares pueden esconder diferencias de costo de varias veces.
- Disponibilidad: Por ahora, Carbon sigue siendo difícil de invocar directamente. Por muy buenos que sean sus resultados, primero hay que poder llevarlo a producción.
GDPx puede orientarte a la hora de elegir, pero no sustituye las pruebas en tu propio negocio. Una opción prudente es seleccionar varios modelos de vanguardia, equilibrados y económicos, probar cada uno durante varias rondas con tareas reales y los mismos criterios de aceptación, y comparar el costo por entrega que cumpla esos criterios. Recomendamos usar APIYI apiyi.com para realizar estas pruebas con varios modelos y una sola clave API. Consulta los precios vigentes en la consola.
📚 Referencias
- Informe original de SemiAnalysis sobre GDPx: metodología del benchmark, resultados por sector y análisis de casos
- Enlace:
newsletter.semianalysis.com/p/gdpx-measuring-frontier-model-capabilities -
Detalles: incluye los modelos líderes en cada sector y un análisis de sus modos de fallo
-
Clasificación oficial de GDPx: resultados generales y costo promedio por tarea
- Enlace:
gdpx.semianalysis.com -
Detalles: fuente de los datos de clasificación de este artículo; las trazas de ejecución están en la página
/rollouts -
Anuncio de lanzamiento de Google Gemini 4 Carbon: disponibilidad y precios previstos de la API
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-carbon -
Detalles: precio de lanzamiento, precio estándar y restricciones de acceso de Carbon
-
Página de precios de la API de OpenAI: precios oficiales por token de la serie GPT-6
- Enlace:
developers.openai.com/api/docs/pricing -
Detalles: ten en cuenta los precios especiales para solicitudes con contexto largo
-
Lista general de precios de modelos de APIYI: modelos disponibles en la plataforma y sus precios en un momento determinado
- Enlace:
docs.apiyi.com/models - Detalles: datos del 2026-10-27; los cargos reales se indican en la consola
Autor: equipo técnico de APIYI
Consultas técnicas: puedes contactarnos a través del sitio oficial de APIYI. Encontrarás más recursos sobre integración de modelos en el centro de documentación docs.apiyi.com