Vamos directo a la conclusión. Por ahora, de Qwen4 solo hay declaraciones públicas y rastros en repositorios; la postura oficial de Alibaba por escrito sigue siendo que «está en entrenamiento». La opción de mayor nivel que puedes implementar ya es Qwen3.8. La integración de Qwen en la versión china del iPhone en diciembre es una noticia sobre canales de distribución: no añade ninguna capacidad de API para los desarrolladores.
Esto no significa que seamos pesimistas con Qwen4. En este artículo dividimos la información disponible en cuatro niveles de fiabilidad para determinar qué se puede incluir en la planificación y qué solo sirve como referencia. Después, repasamos los cuatro niveles de Qwen3.8, sus precios y los tres campos que hay que cambiar al migrar.
Qué te llevas: al terminar, podrás decidir si conviene esperar a Qwen4 o integrar ya Qwen3.8 en tu proyecto de agentes, redacción, atención al cliente o moderación. También conocerás el costo por millón de tokens de cada nivel.
Qué ha integrado Apple: Qwen llega a Apple Intelligence en China
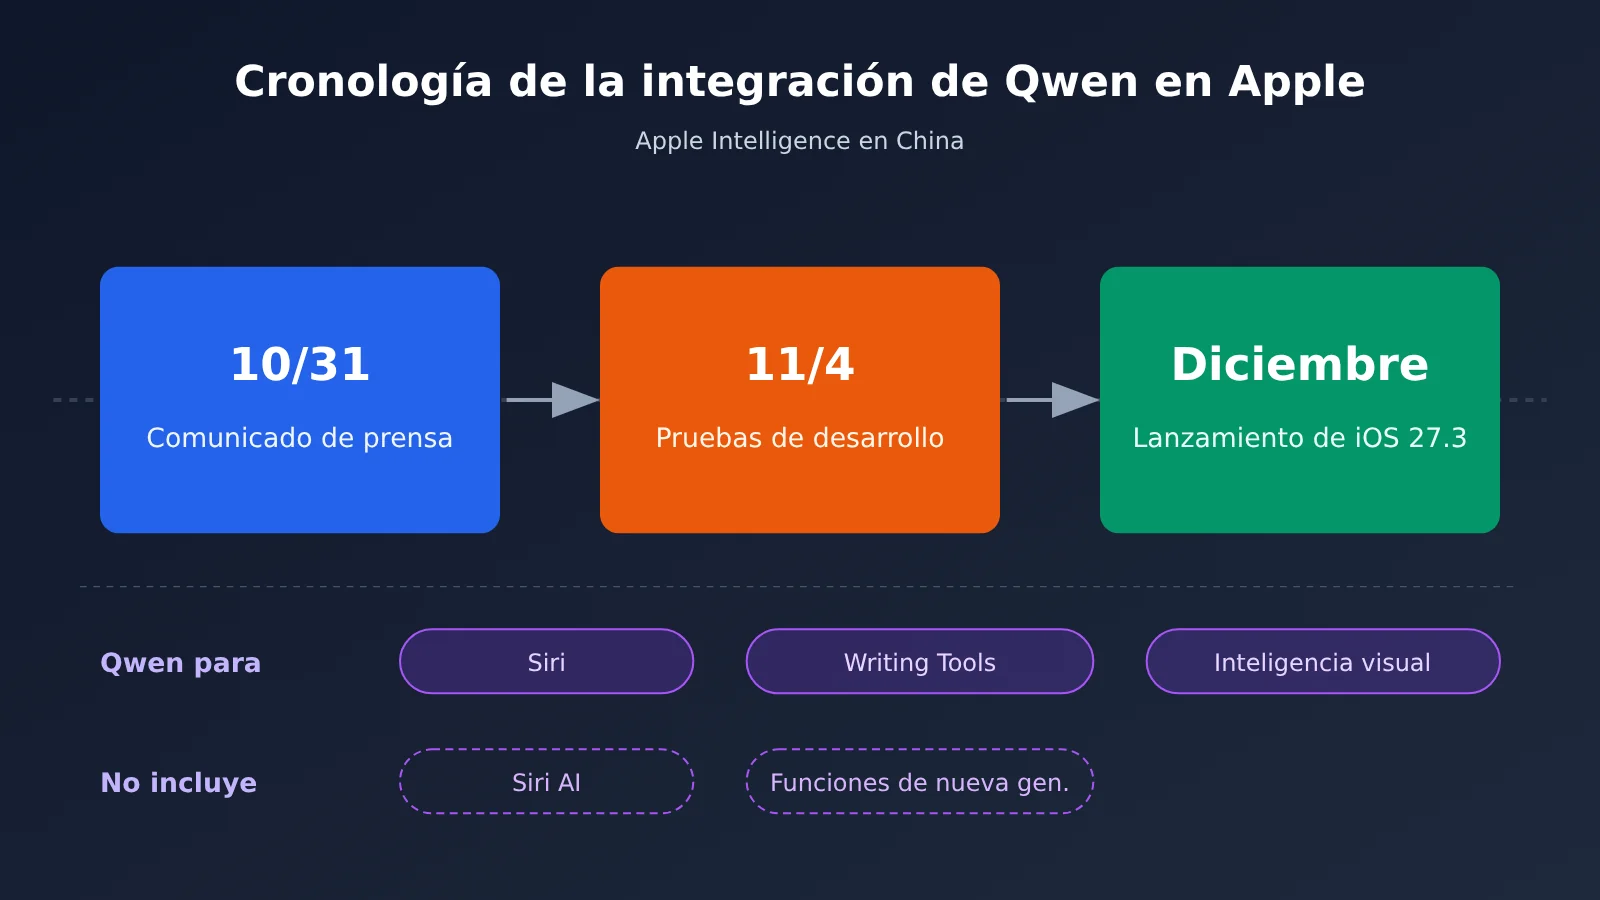
Apple ha integrado las capacidades de Qwen para usuarios particulares, pero no ha puesto a disposición de los desarrolladores una nueva API de Qwen. Según el comunicado de Apple China del 31 de octubre de 2026 (recogido por Tech Wire Asia el 2 de noviembre de 2026), las primeras funciones de Apple Intelligence llegarán en diciembre a los usuarios de iPhone de China continental con iOS 27.3. Los desarrolladores podrán probarlas a partir del 4 de noviembre. A día de hoy, 3 de noviembre, estas funciones siguen pendientes de lanzamiento y aún no están disponibles.
| Aspecto | Contenido del comunicado de Apple del 31 de octubre de 2026 |
|---|---|
| Fechas | Lanzamiento en diciembre con iOS 27.3; los desarrolladores podrán probarlo a partir del 4 de noviembre |
| Primeras funciones | Traducción en tiempo real en Mensajes, FaceTime y Teléfono; reescritura, corrección y resúmenes en Writing Tools; inteligencia visual con la cámara; Clean Up en Fotos; resúmenes de correo y notificaciones, mensajes prioritarios y resúmenes de transcripciones de llamadas |
| Papel de Qwen | Apple ejecuta sus propios modelos generativos y, al mismo tiempo, colabora con Alibaba para que los usuarios puedan usar Qwen directamente en Siri, Writing Tools e inteligencia visual para comprender textos e imágenes; Siri puede derivar algunas solicitudes a Qwen |
| Inicio de sesión | Cuenta de Qwen o cuenta de Apple |
| No incluye | Siri AI ni las funciones de nueva generación de Apple Intelligence presentadas en la WWDC 2026; según Bloomberg, Image Playground tampoco estará en el primer lanzamiento |
| Dispositivos compatibles | iPhone compatibles comprados en China, o dispositivos cuya región y la de la cuenta de Apple estén configuradas en China |
| Compromiso sobre los datos | Alibaba afirma que las solicitudes de los usuarios y el contenido generado por Qwen no se utilizarán para entrenar modelos |
Como contexto, Apple Intelligence figura entre los siete servicios de IA generativa cuyo registro completó la Administración del Ciberespacio de China el 15 de julio. Según el FT, Apple también había considerado antes a Tencent y ByteDance. Los datos de Counterpoint indican que, en el tercer trimestre de 2026, Apple ocupó el segundo lugar en envíos de smartphones en China, con una cuota del 19,5 %, por detrás de Huawei, con un 21,3 %. Los envíos totales cayeron un 10 % interanual.
Para los desarrolladores, el interés de esta noticia está sobre todo en los usuarios: más personas tendrán contacto con Qwen a nivel del sistema y se familiarizarán con su estilo de respuesta. En cuanto al modelo que uses en tu backend, su costo o su latencia, la colaboración de Apple no cambiará nada.
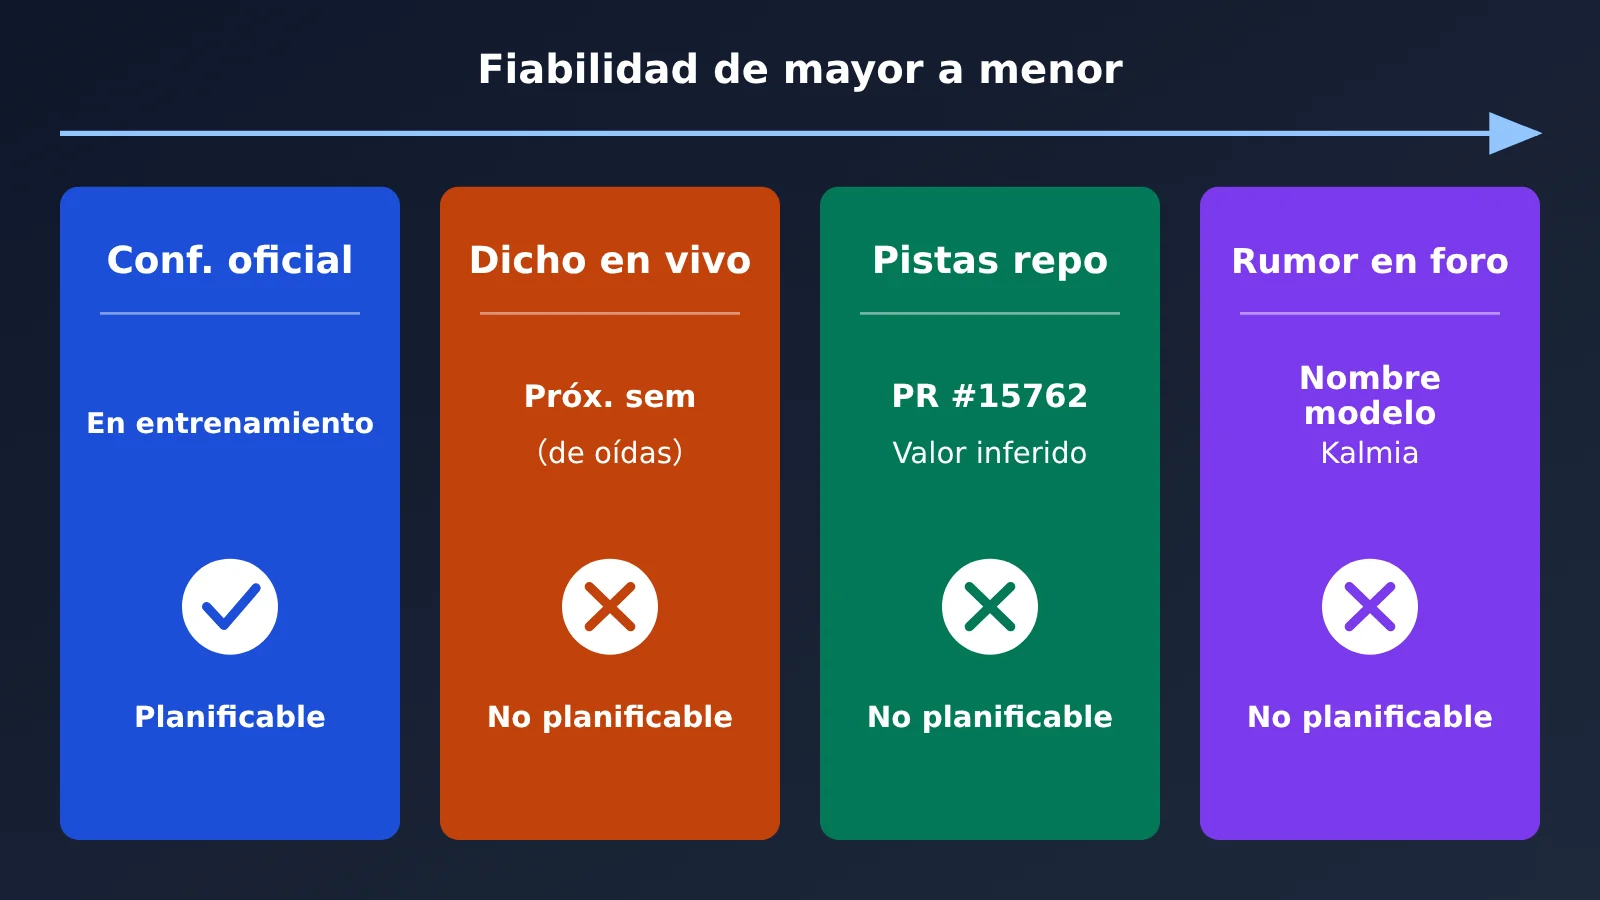
Las cuatro categorías de evidencia sobre Qwen4: cuáles son fiables y cuáles sirven para planificar
Solo las comunicaciones oficiales por escrito sirven como base para planificar y, por ahora, indican que el modelo «está en entrenamiento». En la siguiente tabla, la fiabilidad disminuye de izquierda a derecha.
| Aspecto | Confirmación oficial | Declaración presencial | Indicios en el repositorio | Rumores de la comunidad |
|---|---|---|---|---|
| Contenido | Comunicado de prensa de la conferencia Yunqi del 2026-09-22: Qwen 4 «currently in training»; la página del evento de Ámsterdam del 2026-10-29 solo menciona «Qwen foundation models», sin nombrar Qwen4 | Xudong Guo, investigador científico de Qwen, dijo en el evento de Ámsterdam del 2026-10-29 que la serie Qwen4 se lanzaría «la semana siguiente». Lo contó el asistente John T Davies y EOGEE lo publicó el 2026-10-30 | qwen-code integró el PR #15762 el 2026-10-28, que identifica por defecto una ventana de contexto de 1M de tokens para los ID de modelos que empiezan por qwen4 | Cuatro nombres de modelos: Qwen4-Max / Flash / Plus / 27B; se atribuye a Qwen4 el modelo anónimo Kalmia de Arena por la huella de su tokenizador |
| Tipo de fuente | Material escrito de Alibaba | Declaración oral de una persona, transmitida por un tercero | Repositorio oficial, pero el valor procede de la explicación de la revisión | Sitios web de terceros y deducciones en foros |
| ¿Tiene respaldo oficial? | Sí | No. EOGEE señala expresamente que los canales oficiales no habían publicado ningún anuncio | No. El propio PR indica que en ese momento ni models.dev ni el catálogo integrado tenían entradas de qwen4, por lo que se trata de un valor deducido | No |
| ¿Sirve para planificar? | Sí, pero solo permite concluir que «aún no se ha lanzado» | No, solo es una señal a la que conviene prestar atención | No. Indica que las herramientas se están adaptando con anticipación, pero no representa una especificación oficial | No |
Hay un detalle importante: una publicación de la comunidad TRAE del 2026-10-29 presentó esta declaración como un «anuncio del CTO», lo que no coincide con el relato original, que habla de un «investigador científico». Al citarla, conviene usar este último cargo.
La verificación de OmniaKey del 2026-11-01 aporta datos más concretos: hasta el 2026-11-01 a las 00:21 UTC, no aparecían ID de modelos, pesos ni precios de qwen4 en ninguno de estos tres lugares: la página de la organización Qwen en Hugging Face, Alibaba Cloud Bailian Model Studio y OpenRouter. La página de modelos de Bailian se actualizó por última vez el 10-28 y recomendaba los modelos de texto qwen3.8-max, qwen3.7-plus y qwen3.8-flash. El registro de lanzamientos se actualizó por última vez el 10-30 y su entrada más reciente era qwen-audio-3.1-realtime-flash, del 10-27.
La referencia oficial para la arquitectura de Qwen4: Qwen3.8-Flash-Next
Si quieres anticipar la dirección de la arquitectura de Qwen4, por ahora la única referencia oficial es Qwen3.8-Flash-Next. Su ficha de modelo en Hugging Face se creó el 2026-08-24 y se presenta oficialmente como una «vista previa experimental de la arquitectura de Qwen4». En su configuración, el tipo de modelo figura como qwen4_exp, y llama.cpp v0.6.0 ya admite la arquitectura Qwen4Exp. Eso sí, es un modelo preliminar: sus especificaciones no sirven para deducir la ventana de contexto, la escala de parámetros ni la licencia de la versión final de Qwen4.
Cómo elegir entre las cuatro opciones de Qwen3.8 según la tarea
Para proyectos nuevos, elige primero entre qwen3.8-flash y qwen3.8-27b; reserva qwen3.8-max para agentes complejos. Qwen3.8-Max se anunció en el blog oficial de Alibaba Cloud el 2026-08-03 y es su modelo insignia MoE de 2.4T parámetros. Más adelante, el blog oficial también anunció Qwen3.8-27B y publicó los pesos abiertos del modelo insignia Qwen3.8.
| Modelo | Posicionamiento | Casos de uso | Recomendación | Plataformas disponibles |
|---|---|---|---|---|
| qwen3.8-max | Modelo insignia oficial, MoE de 2.4T | Agentes de varios pasos, textos largos, razonamiento complejo | Úsalo cuando la calidad sea prioritaria y el volumen de invocaciones sea bajo | APIYI apiyi.com, Alibaba Cloud Bailian |
| qwen3.8-2.4t-a95b | El nombre corresponde a las especificaciones de los pesos abiertos del modelo insignia | Equipos que necesitan un comportamiento alineado con la versión autodesplegada | Úsalo como referencia si planeas un despliegue privado | APIYI apiyi.com |
| qwen3.8-27b | Tamaño intermedio, ya anunciado oficialmente | Atención al cliente, moderación de contenido, extracción estructurada | Opción predeterminada para equilibrar calidad y costo | APIYI apiyi.com |
| qwen3.8-flash | Modelo ligero y rápido | Atención al cliente con alta concurrencia, clasificación, resúmenes, filtrado inicial | Primera opción para grandes volúmenes y tareas sensibles a la latencia | APIYI apiyi.com, Alibaba Cloud Bailian |
Cada tipo de aplicación tiene prioridades distintas. En moderación y atención al cliente, lo habitual es tener «mucho volumen y tareas sencillas»: flash puede gestionar la mayor parte del tráfico y derivar los casos difíciles a 27b o max, lo que reduce el costo total. En redacción y agentes, en cambio, importa más la estabilidad en procesos largos. Puedes empezar con max para establecer una referencia de calidad y después comprobar si 27b es suficiente.
🎯 Recomendación: usa la misma clave API para ejecutar una prueba A/B con las mismas tareas en qwen3.8-max, qwen3.8-flash y qwen3.8-27b. Es más rápido que revisar clasificaciones. En APIYI apiyi.com solo tienes que cambiar el campo
model; el resto del código no necesita modificaciones. Las diferencias observadas con muestras de tu propio negocio son las que realmente te servirán de referencia.
Precios y niveles: comparación de costos entre Qwen3.8 y Qwen3.5
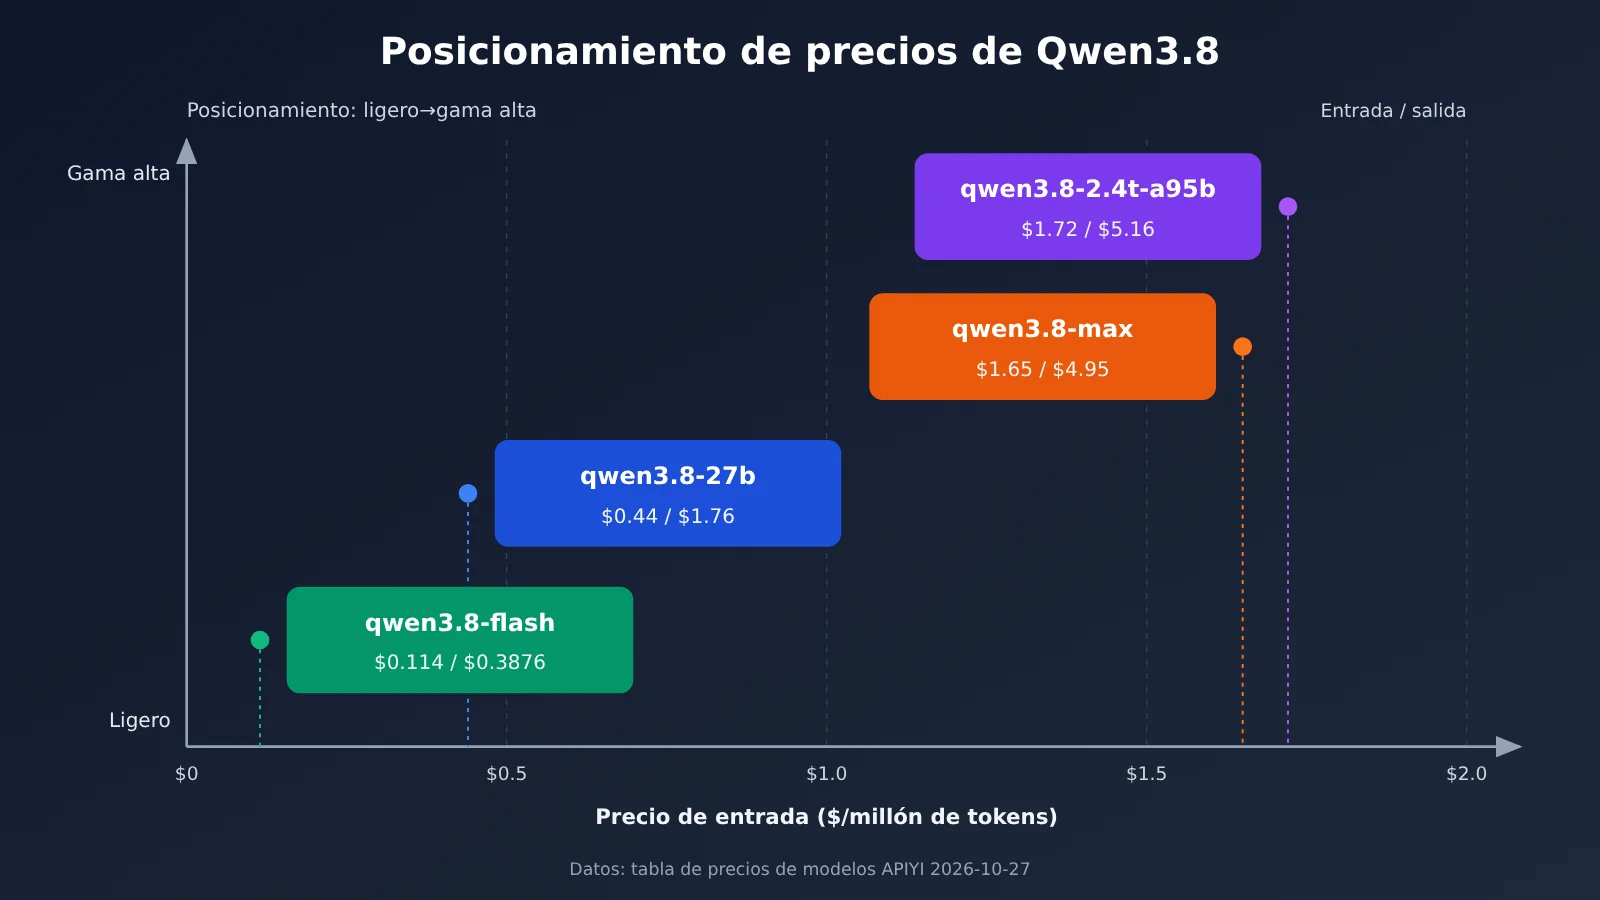
De los cuatro niveles de Qwen3.8, el precio de entrada de flash es aproximadamente 1/14 del de max. Es la diferencia más importante que conviene cuantificar al elegir un modelo. La siguiente tabla muestra los precios de 9 modelos Qwen en APIYI.
| Modelo | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| qwen3.8-max | $1.65 | $4.95 | $0.20625 |
| qwen3.8-2.4t-a95b | $1.72 | $5.16 | $0.215 |
| qwen3.8-27b | $0.44 | $1.76 | $0.088 |
| qwen3.8-flash | $0.114 | $0.3876 | $0.01425 |
| qwen3.5-plus | $0.114 | $0.684 | — |
| qwen3.5-flash | $0.03 | $0.3 | — |
| qwen3.5-397b-a17b | $0.18 | $1.08 | — |
| qwen3.5-122b-a10b | $0.12 | $0.96 | — |
| qwen3.5-35b-a3b | $0.06 | $0.48 | — |
Datos del 2026-10-27 a las 14:50 UTC+8, en dólares por millón de tokens, procedentes de la tabla general de precios de modelos de APIYI (docs.apiyi.com/models).
[Espacio para captura: tabla general de precios de modelos de APIYI, con el filtro qwen3.8]
Es más fácil verlo con una carga de trabajo concreta. Para «1 millón de tokens de entrada + 300.000 de salida», el costo estimado es de $3.14 con qwen3.8-max, $3.27 con qwen3.8-2.4t-a95b, $0.97 con qwen3.8-27b y $0.23 con qwen3.8-flash. Si la indicación de sistema es larga y se reutiliza, el precio de lectura de caché puede reducir aún más el costo de entrada. Los cuatro niveles de Qwen3.8 ofrecen esta tarifa.
Hay un detalle que merece atención: qwen3.8-flash y qwen3.5-plus tienen el mismo precio de entrada, $0.114, pero qwen3.8-flash cobra menos por la salida y también admite lectura de caché. Para tareas de redacción o resumen que generan mucha salida, cambiar de qwen3.5-plus a qwen3.8-flash resulta más barato sobre el papel. La diferencia de calidad, en cambio, hay que comprobarla con muestras propias.
Los 3 campos que debes cambiar para integrar Qwen3.8
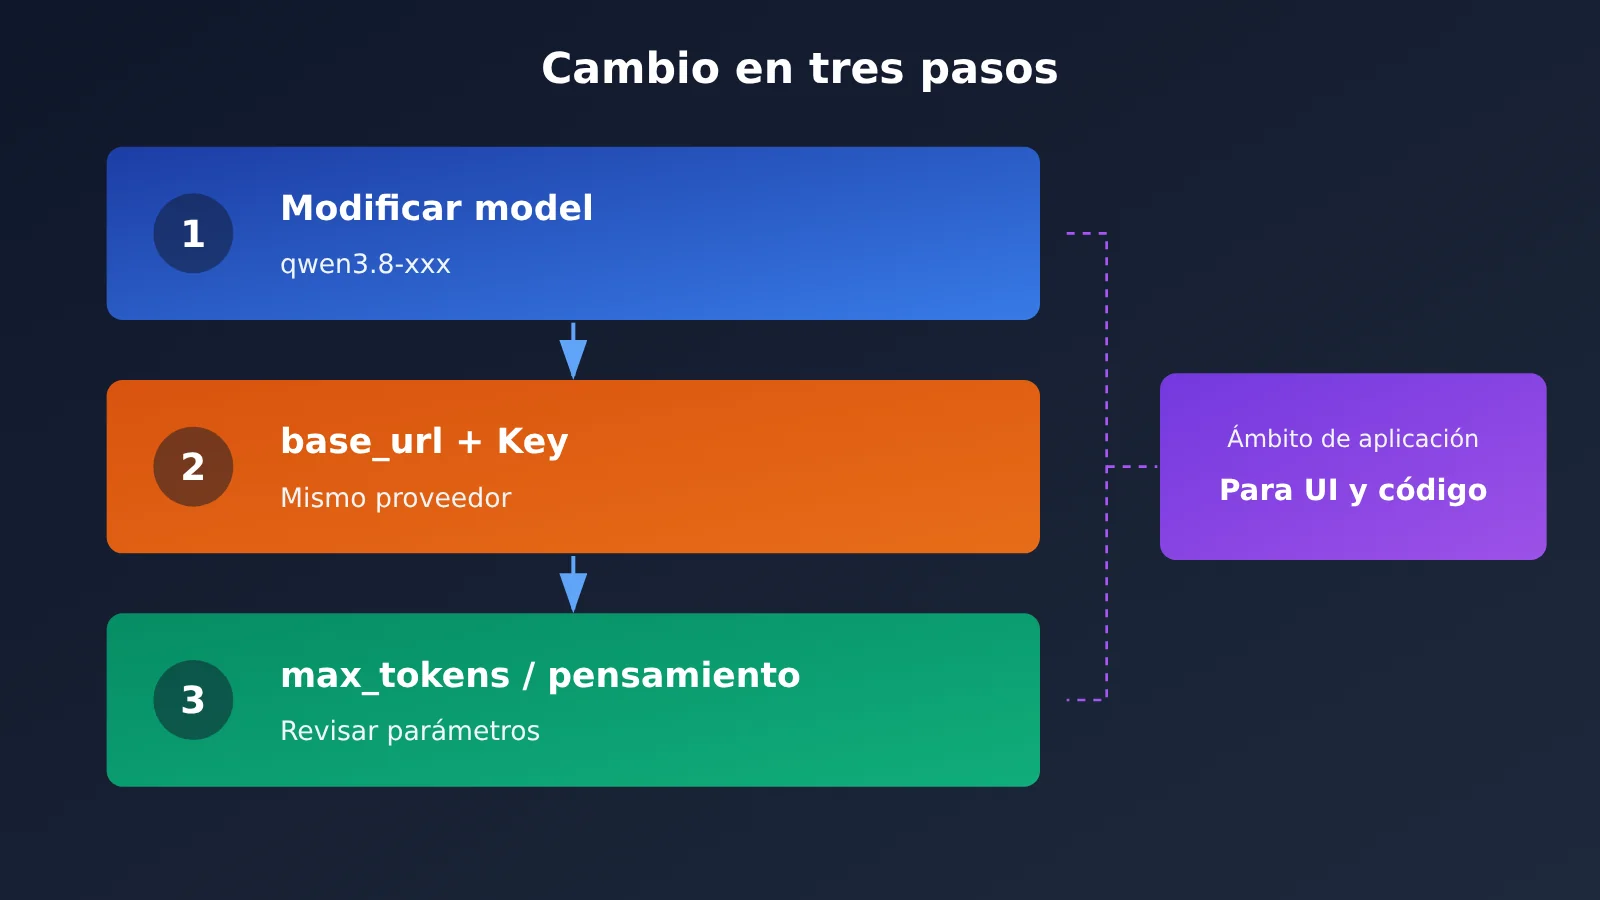
Al pasar de otro modelo o de Qwen3.5 a Qwen3.8, normalmente solo necesitas revisar tres ajustes. El proceso es el mismo tanto en herramientas con interfaz gráfica, como Cherry Studio, Dify y otros clientes de chat, como en proyectos de código.
| Orden | Campo | Qué cambiar | Dónde está en la interfaz gráfica |
|---|---|---|---|
| 1 | model | Cambiar a qwen3.8-flash, qwen3.8-27b o qwen3.8-max |
Menú desplegable «Modelo» o campo «ID del modelo» |
| 2 | base_url + API Key | Confirmar que ambos correspondan al mismo proveedor | Campos «Dirección de API / dirección de la interfaz» y «Clave» |
| 3 | Longitud de salida y parámetros de pensamiento | Revisar max_tokens y las opciones relacionadas con el razonamiento | Panel «Salida máxima» o «Parámetros avanzados» |
Primer paso: cambia el nombre de model. El nombre debe coincidir exactamente con el de la lista de modelos de la plataforma, incluidas las minúsculas y los puntos. Si lo escribes mal, recibirás un error de «modelo inexistente». Lo mejor es copiarlo directamente de la lista en lugar de escribirlo a mano.
Segundo paso: confirma que base_url y Key sean del mismo proveedor. Si usas APIYI, introduce https://api.apiyi.com/v1 como dirección de la API y utiliza la clave generada en el panel de APIYI apiyi.com. Muchos errores «401 sin autorización» ocurren porque se cambia la dirección, pero se mantiene la clave de la plataforma anterior, o viceversa. Para comprobar a qué modelos tiene acceso tu clave actual, puedes obtener la lista con curl https://api.apiyi.com/v1/models -H "Authorization: Bearer 你的Key".
Tercer paso: revisa la longitud de salida y los parámetros de pensamiento. La longitud de salida predeterminada y el comportamiento de razonamiento pueden variar entre generaciones de modelos. Un valor de max_tokens fijado en un proyecto anterior podría truncar las respuestas largas. Si activas el pensamiento en un modelo con capacidad de razonamiento, aumentarán tanto la latencia como los tokens de salida. En casos sensibles a la latencia, como atención al cliente o moderación, conviene probar primero con el pensamiento desactivado y activarlo después si hace falta. Consulta la documentación de la plataforma para conocer los nombres exactos de los parámetros.
Cuándo vale la pena esperar a Qwen4
La mayoría de los proyectos no necesitan esperar. Solo vale la pena seguir de cerca Qwen4 si el lanzamiento ya está previsto para dentro de uno o dos meses y, además, hay un requisito estricto sobre la generación del modelo.
Conviene empezar con Qwen3.8 si:
- El proyecto debe lanzarse este trimestre y el calendario no puede depender de un modelo sin fecha oficial.
- La actividad se centra en atención al cliente, moderación o resúmenes, y flash o 27b ya cubren las necesidades.
- La interfaz usa el formato compatible con OpenAI y, para cambiar de modelo más adelante, solo hay que modificar el campo model. Integrarlo ahora no supone un costo irrecuperable.
Puede valer la pena seguir de cerca Qwen4 si:
- El producto está en una fase de exploración técnica y todavía falta bastante para su lanzamiento.
- Necesitas pesos abiertos para un despliegue privado y quieres revisar las condiciones de licencia cuando se publique Qwen4.
- Ya estás usando Qwen3.8-Flash-Next para explorar la arquitectura.
Mientras esperas, lo más práctico es preparar el conjunto de evaluación y las métricas de negocio con Qwen3.8. Cuando Qwen4 se publique oficialmente, podrás compararlos con las mismas muestras y decidir si conviene cambiar. Al 2026-11-03, la serie Qwen4 todavía no está disponible en APIYI, pero la incorporaremos lo antes posible. Cuando esté disponible, podrás verla directamente en la lista de modelos de APIYI, en apiyi.com.
Preguntas frecuentes FAQ
Q1: ¿Cuándo se lanzará Qwen4?
Por ahora no hay una fecha oficial. La declaración escrita más clara de Alibaba aparece en el comunicado de prensa de la conferencia Yunqi del 2026-09-22: el modelo «está en entrenamiento». La afirmación de que se lanzaría «la próxima semana» procede de unas declaraciones hechas por un investigador durante el evento y transmitidas por asistentes; no hubo ningún anuncio oficial. Lo mejor es consultar las actualizaciones de la página de la organización Qwen en Hugging Face y el registro de lanzamientos de Bailian.
Q2: ¿Qué versión de Qwen3.8 conviene elegir para un proyecto nuevo?
Para escenarios con alta concurrencia y tareas individuales sencillas, empieza por qwen3.8-flash. Para atención al cliente, moderación o extracción, donde también importa la calidad, elige qwen3.8-27b. Para agentes de varios pasos y redacción de textos largos, usa qwen3.8-max como referencia de calidad. Consulta la lista de modelos de la plataforma para conocer las versiones y los precios. En APIYI apiyi.com puedes probar las tres opciones con la misma clave API antes de decidir.
Q3: ¿Qué aporta a los desarrolladores la integración de Qwen en la versión china de Apple?
El impacto directo es limitado. El anuncio de Apple del 2026-10-31 se refiere a funciones de usuario a nivel de sistema, que llegarán en diciembre con iOS 27.3. Los desarrolladores podrán probarlas a partir del 4 de noviembre, pero no se ha abierto ninguna API nueva. Indirectamente, más usuarios de iPhone se familiarizarán con el estilo de respuesta de Qwen, por lo que los productos dirigidos a ellos pueden incluirlo entre sus modelos candidatos.
Q4: Si ya uso Qwen3.5, ¿debería cambiarlo todo a Qwen3.8?
No hace falta cambiarlo todo de una vez; conviene evaluar cada tarea por separado. El precio de entrada de qwen3.5-flash sigue siendo el más bajo de la serie, con $0.03, así que no hay problema en seguir usándolo para tareas ultraligeras. Para proyectos que usan qwen3.5-plus para redactar o resumir, vale la pena comparar primero con qwen3.8-flash: ambos tienen el mismo precio de entrada, pero el segundo tiene un precio de salida más bajo. En APIYI apiyi.com, para cambiar solo hay que modificar el campo model; puedes empezar con un despliegue gradual en el 10% del tráfico.
Q5: Cuando se lance Qwen4, ¿tendré que cambiar mi clave API?
No. En una plataforma de agregación, la misma clave API permite invocar todos los modelos disponibles; cuando se incorpore uno nuevo, bastará con cambiar el nombre en model. Hasta el 2026-11-03, la serie Qwen4 aún no está disponible en APIYI. Incorporaremos este modelo lo antes posible y, cuando esté disponible, podrás invocarlo directamente con tu clave API actual de APIYI apiyi.com.
Claves para elegir entre Qwen4 y Qwen3.8
- Posición oficial sobre Qwen4: el comunicado del 2026-09-22 dice que «se está entrenando». Por ahora no hay fecha, ID ni precio.
- «Lanzamiento la próxima semana»: se atribuye a declaraciones de un científico investigador en un evento. Es información de segunda mano y no sirve como base para planificar.
- Indicios en el repositorio: la ventana de contexto de 1M que aparece en el PR #15762 de qwen-code es una estimación, no una especificación oficial.
- Colaboración con Apple: llegará en diciembre con iOS 27.3; los desarrolladores podrán probarla desde el 4 de noviembre. No implica una API nueva.
- La opción más avanzada disponible ahora: Qwen3.8. El precio de entrada de flash es aproximadamente 1/14 del de max.
- Costo de migración: cambiar
model, comprobarbase_urly la clave API, y revisar la longitud de salida y los parámetros de razonamiento.
Resumen
Las novedades sobre Qwen se pueden entender en tres niveles:
- Apple integrará Qwen en diciembre: es un avance en el canal de distribución que influye en el conocimiento de los usuarios, no en las capacidades que pueden invocar los desarrolladores.
- Qwen4: hay declaraciones en un evento e indicios en el repositorio, pero la posición oficial por escrito sigue siendo que «se está entrenando». No conviene incluirlo en la planificación.
- Qwen3.8: ya se lanzó oficialmente, tiene precios claros y sus cuatro niveles cubren los principales casos de uso, desde alta concurrencia hasta agentes complejos.
Una opción prudente es lanzar ahora con Qwen3.8 y guardar las muestras de evaluación para compararlas con Qwen4 cuando se publique oficialmente. Recomendamos usar APIYI apiyi.com para probar todos los niveles de Qwen3.8 con una sola clave API. Los usuarios nuevos cuentan con crédito gratuito de prueba, así que pueden completar una comparación A/B antes de elegir un nivel.
📚 Referencias
- Tech Wire Asia: resumen del comunicado de la sala de prensa de Apple China del 2026-10-31
- Enlace:
techwireasia.com/2026/11/apple-intelligence-china-alibaba-qwen-december/ -
Descripción: funciones de Apple previstas para diciembre, papel de Qwen y dispositivos compatibles
-
OmniaKey: «¿Cuándo se lanzará Qwen 4? ¿Qué ha confirmado Alibaba oficialmente hasta ahora?», 2026-11-01
- Enlace:
omniakey.com/zh/blog/qwen-4-release-date -
Descripción: verificación de los anuncios oficiales y resultados de búsqueda en tres plataformas
-
EOGEE: «Qwen anuncia el lanzamiento de Qwen4 para la próxima semana», 2026-10-30
- Enlace:
eogee.com/article/289 -
Descripción: fuente de las declaraciones realizadas en Ámsterdam
-
Blog oficial de Alibaba Cloud: lanzamiento de Qwen3.8-Max, 2026-08-03
- Enlace:
alibabacloud.com/blog/alibaba-unveils-qwen3-8-max-its-largest-and-most-capable-flagship-model-to-date_603420 -
Descripción: anuncio oficial del lanzamiento del modelo insignia Qwen3.8
-
Blog oficial de Alibaba Cloud: lanzamiento de Qwen3.8-27B y publicación de los pesos del modelo insignia
- Enlace:
alibabacloud.com/blog/alibaba-unveils-qwen3-8-27b-and-releases-weights-of-qwen3-8-flagship-model_603463 -
Descripción: información sobre la variante 27B y la publicación de código abierto
-
Tabla general de precios de modelos de APIYI
- Enlace:
docs.apiyi.com/models - Descripción: fuente de los datos de la tabla de precios de este artículo