Nota del autor: Este artículo explica los mecanismos centrales de la arquitectura orientada a eventos de DeepSeek Super-agent, distingue entre las funciones del prototipo de código abierto, los casos internos de DeepSeek y las ideas para una arquitectura futura, y analiza el valor y las concesiones técnicas de los agentes proactivos.
Imagina un chat de equipo de desarrollo. Alguien comenta de pasada: «La página de inicio de sesión vuelve a fallar en Safari». Nadie menciona al bot ni abre un issue. Al cabo de un rato, llega una breve notificación al grupo: el problema se ha reproducido, se ha identificado la causa y el PR con la corrección está listo para revisión. Según un artículo técnico oficial de DeepSeek, esta forma de «reproducir y corregir en silencio» ya es una estrategia de trabajo en los chats internos de DeepSeek Harness.
Esta no es una historia sobre una «IA que empieza a actuar por su cuenta». El cambio fundamental de DeepSeek Super-agent es que el sistema puede detectar continuamente eventos externos y, bajo permisos y reglas claramente definidos, identificar tareas, preparar el trabajo con antelación y entregar resultados en el momento adecuado. El control de permisos y la ejecución proactiva se han diseñado conjuntamente: ambos son indispensables.
Qué te llevarás: al terminar el artículo, conocerás los 5 mecanismos clave de la arquitectura orientada a eventos de Super-agent, distinguirás lo que ya está implementado en el prototipo de código abierto de los casos internos y las ideas arquitectónicas, y sabrás cómo aplicar este enfoque para diseñar agentes proactivos, controlados y que interrumpan lo menos posible.
DeepSeek Super-agent: información clave de un vistazo
Antes de entrar en detalles, esta tabla resume la información pública disponible sobre Super-agent. Es importante distinguir entre lo que ya está implementado y lo que todavía es una propuesta: esa diferencia es clave para entender el proyecto.
| Información | Detalle | Estado |
|---|---|---|
| Enfoque del proyecto | Explorar una arquitectura basada en eventos que pase de la respuesta pasiva a un agente proactivo | Artículo técnico oficial y documentación del prototipo de código abierto |
| Fuentes de eventos (Trigger) | Mensajería instantánea, issues y comentarios en PR de GitHub, revisión de código, CI, correo electrónico, calendarios y eventos de colaboración en proyectos | El prototipo público se centra en GitHub, con Feishu como integración opcional; el correo y los calendarios forman parte de una propuesta de arquitectura más amplia |
| Modos de aceptación de tareas | off, observe, auto |
Documentados en la documentación de autorización de código abierto; el modo predeterminado es observe |
| Mecanismo de autorización | Mandate, que registra el origen de la tarea, el nivel de autorización, el alcance y la versión de la política | Documentado en la documentación de autorización de código abierto |
| Tareas asíncronas | Al iniciar una tarea se devuelve Started y la ejecución continúa en segundo plano sin bloquear la interacción | Implementadas en DeepSeek Harness, pero aún no activadas de forma predeterminada |
| Caso interno | «Reproducir y corregir silenciosamente» un bug mencionado en un chat grupal | Caso de uso interno de DeepSeek, sin verificación independiente de terceros |
| Evidencia de la comunidad | El 1 de noviembre de 2026, un usuario informó que había completado el flujo Issue → PR | Surgieron varios problemas de configuración durante el despliegue |
Qué es la arquitectura orientada a eventos de DeepSeek Super-agent
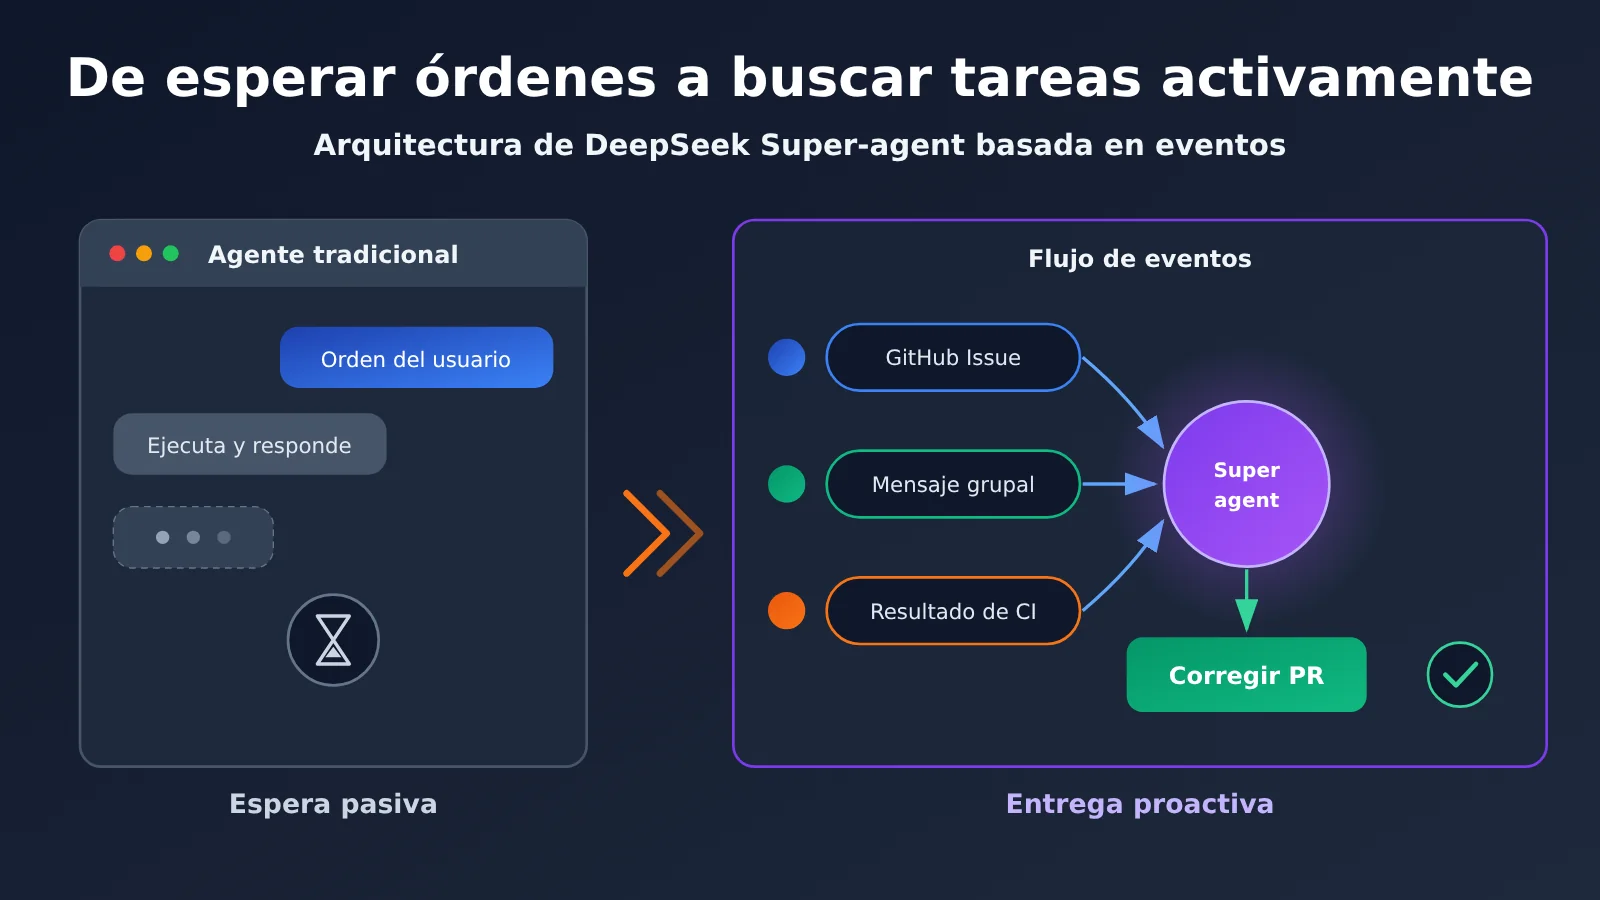
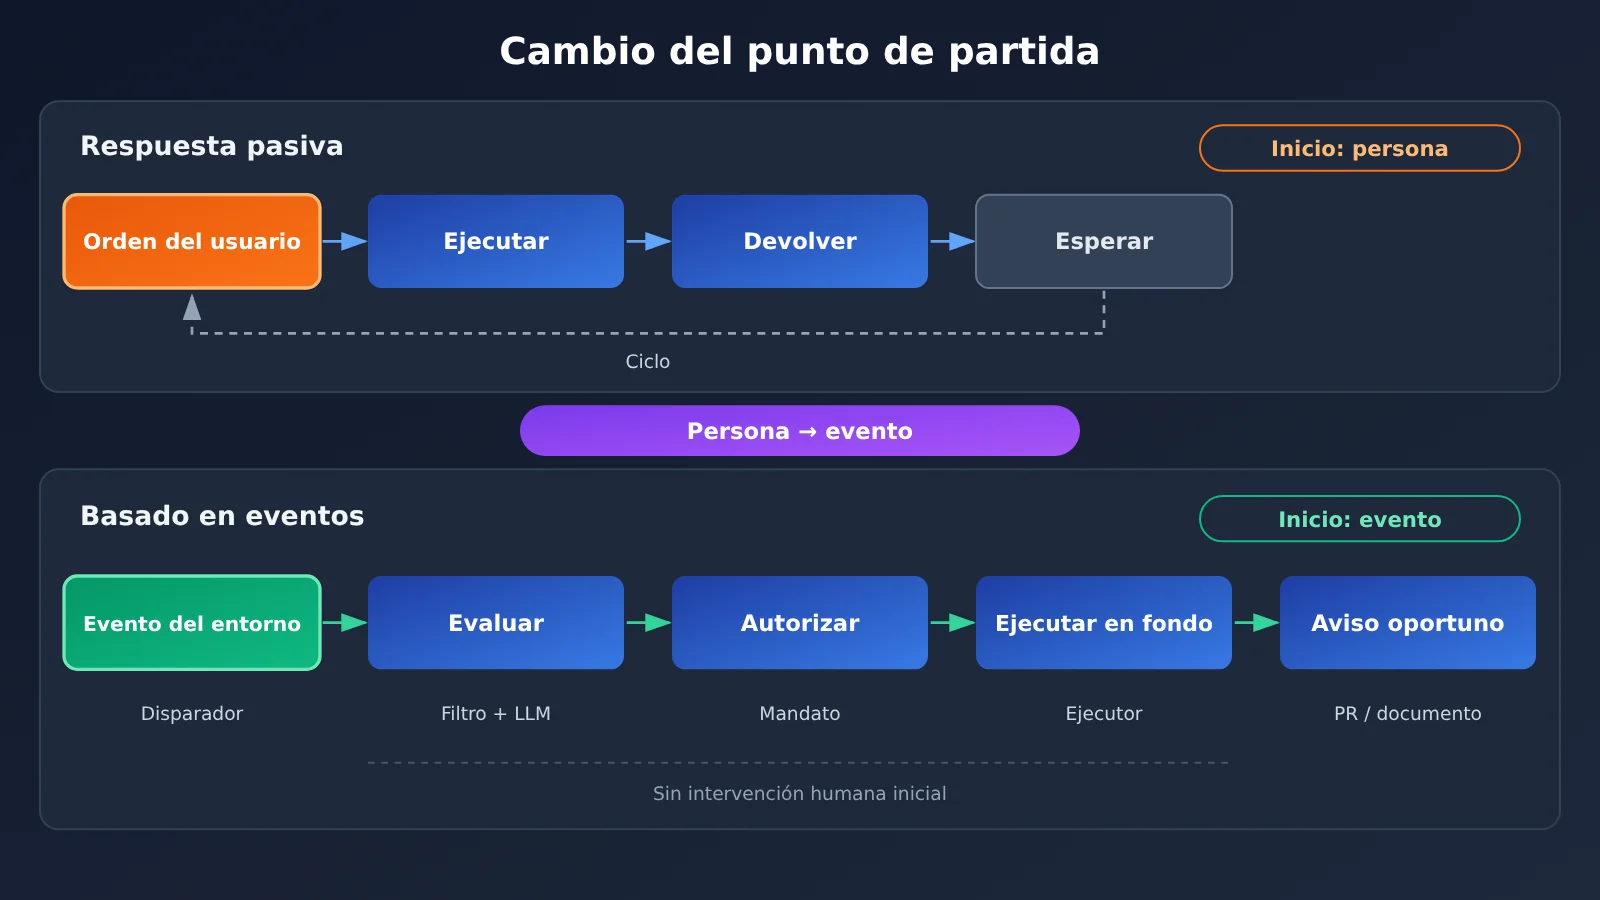
Un agente conversacional tradicional funciona en un ciclo cerrado: el usuario da una instrucción, el agente la ejecuta, devuelve el resultado y espera la siguiente instrucción. Por muy inteligente que sea el agente, su trabajo siempre comienza con una conversación iniciada por el usuario. Es la persona quien debe detectar el problema, describirlo con claridad y recordar que tiene que revisar el resultado.
DeepSeek Super-agent invierte esa cadena. El sistema recibe continuamente eventos del entorno, determina si hay trabajo que merece atención, crea tareas según los permisos otorgados, las ejecuta en segundo plano y notifica a las personas en el momento adecuado. En otras palabras, el propio entorno de trabajo se convierte en una fuente de entrada para el agente; la ventana de chat deja de ser el único punto de acceso.
| Aspecto | Agente de respuesta pasiva | Super-agent orientado a eventos |
|---|---|---|
| Punto de partida | El usuario inicia una conversación | Eventos del entorno externo (Trigger) |
| Detección de tareas | Una persona detecta y describe el problema | El sistema identifica indicios de tareas; la persona autoriza y valida |
| Ejecución | Normalmente síncrona, a la espera del resultado | Asíncrona en segundo plano, con posibilidad de preparación anticipada |
| Entrega | Resultados progresivos en la conversación | Notificación concisa o entrega estructurada (PR, documento) |
| Control | Cada paso depende de una instrucción del usuario | Modo de aceptación de tareas, alcance de autorización del Mandate y reglas de aprobación |
| Riesgos principales | Alta carga de gestión manual | Activaciones erróneas, avalanchas de tareas, extralimitación de permisos y ataques de inyección |
El papel de Trigger en Super-agent
DeepSeek llama Trigger a cualquier evento del entorno externo. Un mensaje en un chat grupal, un nuevo Issue o un fallo de compilación en CI pueden convertirse en un Trigger. La clave es que un Trigger es solo un «indicio», no una «tarea». Lo que realmente determina si se actúa son las etapas posteriores de filtrado, evaluación y autorización.
Cómo filtra eventos Super-agent: Gate programático y LLM Assessment
Los entornos de trabajo reales generan mucho ruido. En un grupo de desarrolladores puede haber a diario conversaciones informales, emojis y mensajes repetidos. Si cada mensaje se enviara a un Modelo de Lenguaje Grande para evaluarlo, el costo en tokens y la latencia aumentarían rápidamente. La solución de DeepSeek es un filtrado en dos niveles: primero, unas reglas deterministas y económicas descartan la mayoría de los eventos irrelevantes; después, el modelo evalúa semánticamente los pocos candidatos restantes.
| Nivel de filtrado | Criterios de evaluación | ¿Invoca un Modelo de Lenguaje Grande? | Función principal |
|---|---|---|---|
| Primer nivel: Gate programático | Origen del evento, usuario autorizado, pertenencia a un grupo o repositorio supervisado, mención explícita del Agent y alcance de eventos configurado | Se evita en la medida de lo posible | Bloquear eventos irrelevantes o no autorizados con un costo bajo |
| Segundo nivel: LLM Assessment | Contenido semántico y contexto de los eventos candidatos | Sí | Determinar si hay trabajo que merece atención, como una posible incidencia |
Tomemos como ejemplo: «La página de inicio de sesión volvió a dejar de funcionar en Safari». Si el mensaje aparece en un hilo de discusión autorizado del proyecto, el modelo podría identificarlo como una posible incidencia. Si solo forma parte de una conversación sin relación con el proyecto, el sistema podría no hacer nada. Esta estructura combina reglas de bajo costo con comprensión semántica de mayor costo, y es clave para que un Agent basado en eventos mantenga sus gastos bajo control.
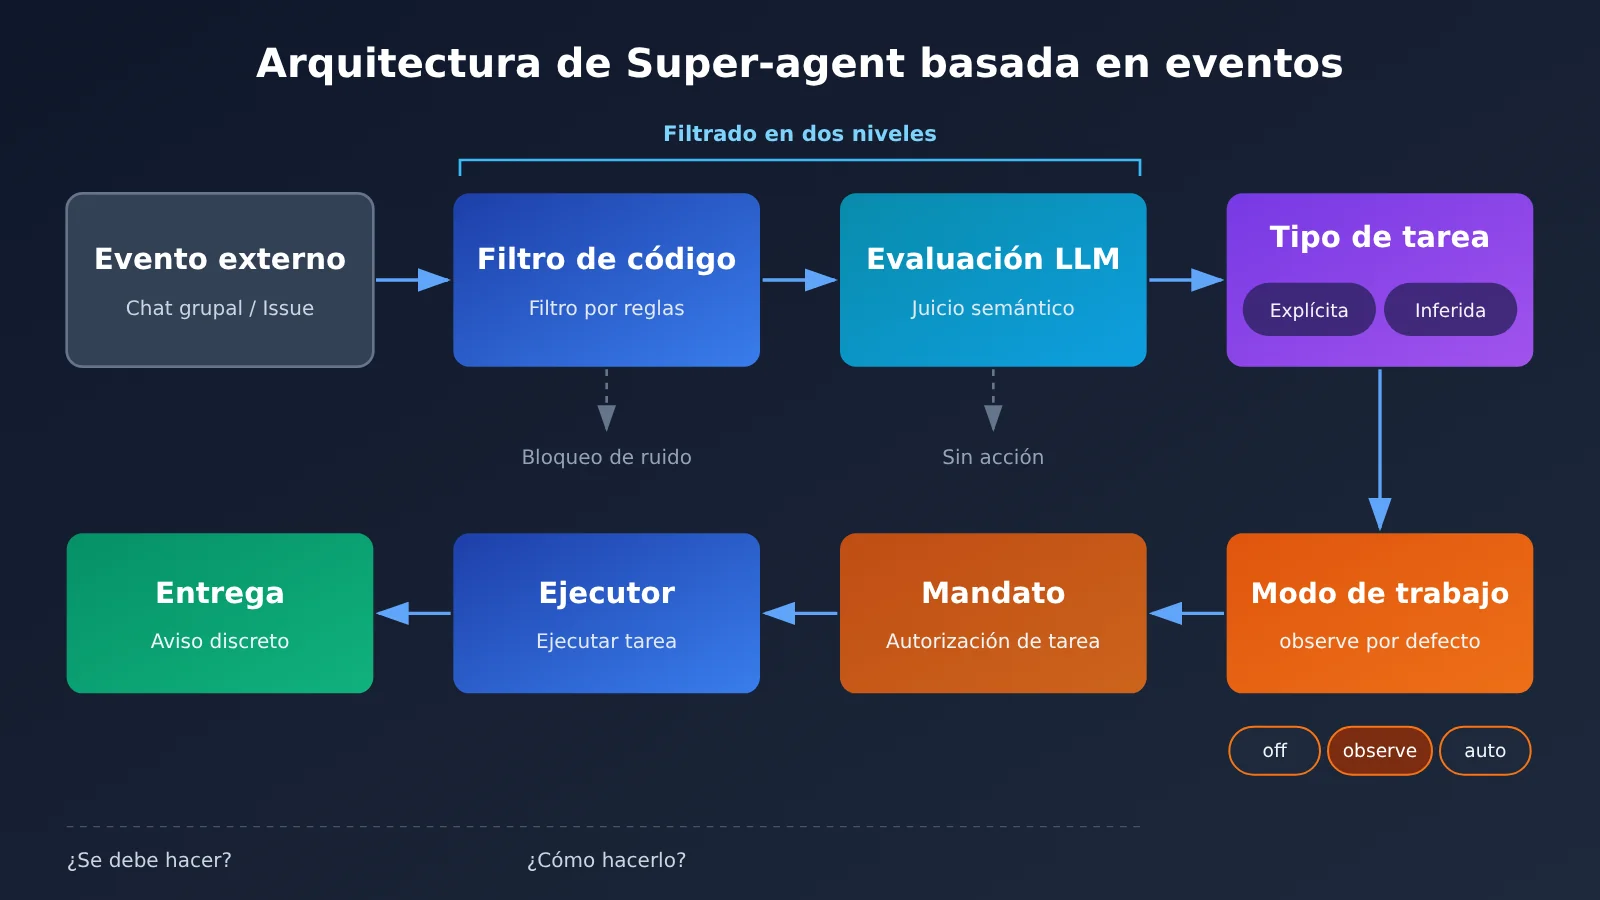
En el diagrama, tanto la evaluación semántica como la ejecución de tareas dependen de API de modelos. Para reproducir una arquitectura similar, los desarrolladores pueden usar interfaces compatibles con OpenAI, como APIYI apiyi.com, para acceder a distintos modelos desde un mismo punto y facilitar su configuración y comparación por nivel.
Explicit e Inferred: la diferencia entre solicitudes explícitas y tareas inferidas
La documentación oficial de autorización de DeepSeek divide las tareas en dos categorías. Una tarea Explicit es una solicitud autorizada de forma explícita, por ejemplo, cuando un desarrollador autorizado pide directamente al agente que corrija un bug en un Issue. Una tarea Inferred es una tarea inferida: alguien comenta en una conversación que «últimamente la compilación falla a veces», sin pedir formalmente una corrección, pero el sistema detecta una pista que podría valer la pena investigar.
Lo más importante es que inferir una tarea no implica tener permiso para ejecutarla. Las tareas Inferred siguen estando sujetas a las reglas de admisión, el alcance de ejecución y los requisitos de aprobación de la organización. Esta distinción evita que la «detección proactiva» derive en «acciones no autorizadas».
Los tres modos de aceptación de tareas de Super-agent: off, observe y auto
La documentación de autorización del proyecto de código abierto ofrece tres modos para gestionar las tareas inferidas:
| Modo | Tratamiento de las tareas inferidas | Etapa adecuada |
|---|---|---|
off |
No considera los eventos inferidos como tareas candidatas | Equipos que solo quieren atender solicitudes explícitas |
observe (predeterminado) |
Analiza y registra posibles tareas, pero no las acepta automáticamente | Despliegue inicial y evaluación de la calidad de las decisiones |
auto |
Puede aceptar tareas automáticamente si cumplen las reglas y superan la evaluación | Entornos donde ya se han revisado los registros de observe y existe un mayor nivel de confianza |
El valor predeterminado es observe, lo que significa que, al instalar por primera vez el prototipo público, el sistema no empezará a trabajar automáticamente por un simple mensaje en una conversación. La recomendación oficial es revisar primero los registros de decisiones del modo observe y después decidir si se activa auto. Las solicitudes autorizadas explícitamente se siguen procesando según las reglas correspondientes en todos los modos. El usuario mantiene siempre el control del «interruptor»: esa es la base para confiar en un agente proactivo.
Mandate: los mensajes pueden servir como entrada, pero no modificar la autorización
DeepSeek utiliza Mandate para representar la autorización de una tarea, incluyendo su origen, el nivel de autorización, el alcance y la versión de la política. Supongamos que un desarrollador autoriza a un Agent a corregir un Issue y, después, alguien comenta en el PR: «Ya de paso, migra también toda la base de datos». Ese comentario puede entrar en el contexto del Worker, pero la autorización original no se amplía por ello a la migración de la base de datos; las solicitudes fuera del alcance deben evaluarse de nuevo.
El principio que destaca DeepSeek es que los mensajes, comentarios o documentos citados pueden servir como entrada para una tarea, pero no pueden modificar directamente las reglas de autorización subyacentes. Para los sistemas que «escuchan» contenido externo de forma continua, esta es la defensa más importante contra Prompt Injection y las extralimitaciones de permisos.
Cómo ejecuta tareas de forma proactiva un Super-agent: ejecución especulativa, tareas asíncronas y mínimas interrupciones
El filtrado y la autorización resuelven la pregunta de «si se debe hacer». La siguiente es «cómo hacerlo sin hacer perder tiempo a las personas». DeepSeek propone tres líneas de diseño.
Ejecución especulativa: preparar primero y esperar la confirmación después
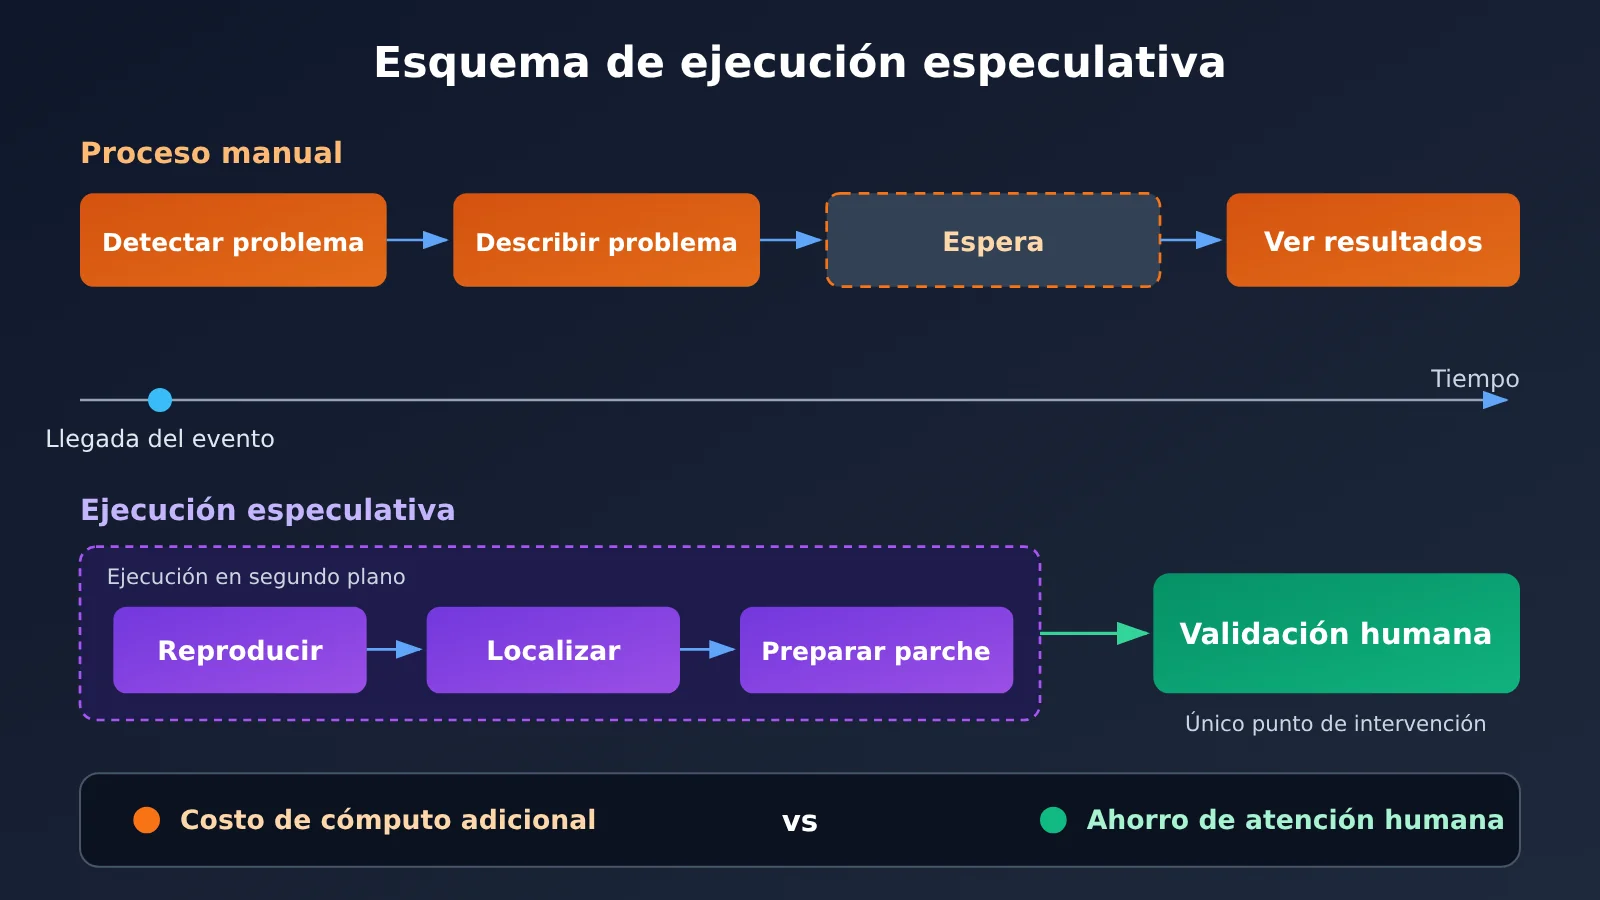
DeepSeek toma prestado el concepto de Speculative Execution (ejecución especulativa) de la arquitectura de computadoras: adelantar trabajo preparatorio de bajo riesgo sin saber todavía si el resultado se utilizará.
- Asistente personal: al recibir una invitación a una reunión, el Agent puede revisar la agenda, recopilar información de contexto, detectar conflictos de horario y redactar una respuesta, aunque enviar el correo todavía podría requerir la confirmación del usuario.
- Desarrollo de software: mientras el equipo debate un Bug, el Agent puede revisar los registros, intentar reproducirlo, localizar el código y preparar un parche candidato para entregar el resultado una vez que se cumplan las reglas de autorización.
El costo de este mecanismo es que puede consumir recursos de cómputo en trabajos que finalmente no se aprovechen. Según DeepSeek, la ejecución especulativa solo aporta valor si el ahorro en tiempo de espera y trabajo humano supera el costo adicional de cómputo. Es una decisión de ingeniería: no todas las tareas merecen ejecutarse por adelantado.
ReAct Loop asíncrono: las tareas en segundo plano no bloquean la interacción
En la ejecución síncrona tradicional, después de que un Agent inicia un comando que tarda en completarse, debe esperar a que la herramienta responda antes de procesar nuevos mensajes. El diseño asíncrono propuesto por DeepSeek funciona así: al iniciar una tarea, devuelve de inmediato el estado Started; la ejecución en segundo plano no bloquea las interacciones posteriores, y el resultado vuelve a entrar en el sistema como un nuevo evento. El usuario puede hacer otras preguntas mientras la tarea está en marcha, y el sistema también puede detener trabajos en segundo plano que ya no sean necesarios.
Conviene tener clara una limitación: según la información oficial, este mecanismo de tareas asíncronas ya está implementado en DeepSeek Harness, pero aún no está activado por defecto. El prototipo público tiene su propio mecanismo de Worker en segundo plano, pero no se debe confundir con la arquitectura asíncrona completa ni considerarla una función predeterminada.
Mínimas interrupciones: ser proactivo no significa llamar la atención
El documento sobre la filosofía de producto de DeepSeek propone reducir al mínimo el consumo de atención humana y, al mismo tiempo, generar el mayor valor útil posible. En la práctica, esto significa no informar de cada invocación de herramientas, no inundar los chats grupales, no exponer todos los razonamientos intermedios, priorizar la comunicación cuando se necesita una decisión o revisión y evitar mensajes de valor limitado.
También se distingue entre los canales de salida. La mensajería instantánea se utiliza para notificaciones breves, mientras que GitHub, el correo electrónico y los documentos se usan para entregas estructuradas que incluyen el contexto del problema, una explicación de los cambios y los resultados de la validación. Desde la perspectiva del producto, la proactividad y la frecuencia de las notificaciones son métricas distintas: un Agent que informa constantemente no es necesariamente un Agent útil.
Evidencia real de Super-agent: casos internos y pruebas de la comunidad
Para evaluar una arquitectura nueva, hay que separar su «potencial» de su «estado actual». Por ahora existen dos tipos de evidencia, con distinto grado de fiabilidad y alcance.
Los casos internos de DeepSeek muestran el potencial de la arquitectura. En un chat grupal interno de DeepSeek Harness, cuando se informa de un problema, el agente recibe el mensaje, decide si vale la pena investigarlo e intenta reproducirlo y buscar una solución en segundo plano. Si confirma el problema y encuentra una solución sencilla, prepara o envía una PR; si no obtiene resultados útiles, no interrumpe al equipo. Esta es la forma de funcionamiento interno que ha descrito oficialmente DeepSeek, no una validación independiente de terceros del prototipo público con su configuración predeterminada.
Las pruebas de la comunidad en GitHub muestran el estado actual del prototipo. El 1 de noviembre de 2026, un usuario informó que había desplegado el prototipo de código abierto en Ubuntu siguiendo SETUP.md y había conseguido que una solicitud planteada en un Issue entrara en el flujo de trabajo y terminara generando una Pull Request. Sin embargo, también encontró problemas: las notificaciones de GitHub no llegaban, el sistema mostraba un estado normal pero no recibía solicitudes de trabajo, fue necesario ajustar la configuración de Source para supervisar Issues y comentarios, y la configuración del idioma del sistema y de la cuenta de GitHub provocó incompatibilidades.
Este informe demuestra que el flujo de trabajo que convierte un evento en una tarea puede funcionar de principio a fin, pero no permite concluir que el proyecto ya detecte errores de forma fiable y automática las 24 horas. Generar una PR tampoco significa que los cambios hayan superado una revisión humana y se hayan integrado.
Crear la capa de decisión de un agente basado en eventos con una API de modelos
Si quieres tomar ideas de Super-agent, la parte más fácil de implementar es la capa de «Gate programático + evaluación con LLM». El siguiente ejemplo solo muestra la lógica de evaluación de eventos; no representa la implementación oficial de Super-agent ni es un producto de agente completo.
Ejemplo mínimo
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI
)

event = "登录页面在 Safari 上又打不开了"
resp = client.chat.completions.create(
    model="gpt-4o-mini",  # Consulta la lista de modelos de la plataforma
    messages=[{"role": "user", "content": f"判断以下消息是否为故障线索,只回答 yes 或 no:{event}"}]
)
print(resp.choices[0].message.content)
Ver el código de la implementación completa (Gate + evaluación + modo de aceptación de tareas)
import json
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Configuración del Gate programático: reglas deterministas, sin invocar al LLM
ALLOWED_SOURCES = {"github", "feishu"}
ALLOWED_USERS = {"alice", "bob"}
WATCHED_CHANNELS = {"repo/web-frontend", "group/dev-team"}
MODE = "observe"  # off / observe / auto

def gate(event: dict) -> bool:
    """Primer nivel: filtrado con reglas de bajo costo"""
    return (
        event["source"] in ALLOWED_SOURCES
        and event["user"] in ALLOWED_USERS
        and event["channel"] in WATCHED_CHANNELS
    )

def assess(event: dict) -> dict:
    """Segundo nivel: evaluación semántica del modelo, distingue explicit / inferred"""
    prompt = (
        "你是事件分类器。请判断消息是否包含值得处理的工作,"
        "并区分 explicit(明确请求)或 inferred(推断任务)。"
        '仅输出 JSON:{"actionable": bool, "kind": "explicit|inferred|none", "reason": "..."}\n'
        f"消息:{event['text']}"
    )
    resp = client.chat.completions.create(
        model="gpt-4o-mini",
        messages=[{"role": "user", "content": prompt}],
        max_tokens=200
    )
    try:
        return json.loads(resp.choices[0].message.content)
    except json.JSONDecodeError:
        return {"actionable": False, "kind": "none", "reason": "parse_error"}

def handle(event: dict) -> str:
    if not gate(event):
        return "dropped_by_gate"
    result = assess(event)
    if not result["actionable"]:
        return "ignored"
    if result["kind"] == "explicit":
        return "create_task_with_mandate"   # Aún hay que comprobar el alcance de la autorización
    # Gestionar las tareas inferidas según el modo de aceptación
    if MODE == "off":
        return "ignored"
    if MODE == "observe":
        return f"logged_for_review: {result['reason']}"
    return "auto_accept_if_policy_allows"

print(handle({
    "source": "feishu", "user": "alice",
    "channel": "group/dev-team",
    "text": "最近构建有时会失败"
}))
🚀 Consejo para empezar: Al probar la capa de evaluación de eventos, puedes obtener crédito gratuito de prueba en APIYI, apiyi.com. Usa el mismo código con distintos modelos para comparar la precisión de clasificación y el consumo de tokens antes de decidir qué modelo usar en cada capa.
Enfoque de orquestación por niveles de modelos
La estructura de Super-agent se puede resumir así: evento externo → filtrado programático → evaluación semántica del modelo → decisión de autorización → ejecución del Agent → entrega del resultado. No es necesario usar el mismo modelo en todos los niveles:
| Nivel | Naturaleza de la tarea | Criterio de selección del modelo |
|---|---|---|
| Gate programático | Comprobación del origen, el usuario y el alcance | No usa LLM |
| Clasificación de eventos | Alta frecuencia, textos breves y salida estructurada | Se puede considerar un modelo de bajo costo y baja latencia |
| Ejecución compleja | Reproducción y corrección de código, razonamiento con contextos largos | Un modelo de mayor capacidad |
| Resumen y notificación de resultados | Resúmenes y entrega estructurada | Se puede configurar de forma independiente |
💡 Recomendación: para saber si la orquestación por niveles realmente ahorra dinero, hay que comprobarlo con registros reales y pruebas del negocio. No se puede asumir que orquestar varios modelos siempre reduce los costos. Con la interfaz unificada de APIYI apiyi.com, puedes sustituir rápidamente los modelos de cada nivel sin modificar el código de negocio y hacer comparaciones A/B.
Análisis del impacto de la arquitectura de Super-agent basada en eventos
Impacto en equipos de I+D y desarrolladores de automatización
- El punto de entrada pasa del chat al flujo de trabajo: los Issues, los comentarios de PR, los resultados de CI y los mensajes de chats grupales se convierten en entradas naturales para el Agent. Los desarrolladores deben diseñar la recepción y el filtrado de eventos, no solo escribir indicaciones.
- El diseño de la autorización se vuelve esencial: la distinción Explicit/Inferred, el modo de aceptación de tareas y el alcance del Mandate determinan si el Agent puede ser aceptado en equipos reales.
- La evaluación debe cambiar: para medir un Agent proactivo no basta con contar «cuántas acciones ejecutó»; también hay que valorar la calidad de la detección de tareas, la proporción de retrabajo y la cantidad de notificaciones sin valor.
Impacto en los equipos de aplicaciones de IA empresariales
Los Agent proactivos tienen potencial en la colaboración de desarrollo, la resolución de incidencias y la automatización de procesos empresariales, pero la estructura de costos cambia. La evaluación de eventos consume tokens de forma continua, la ejecución especulativa puede generar trabajo que no se aproveche y las tareas complejas también requieren revisión humana. El siguiente marco de evaluación se basa en la arquitectura oficial; no son métricas de rendimiento oficiales publicadas por DeepSeek:
| Dimensión de evaluación | Indicadores recomendados |
|---|---|
| Calidad de detección de tareas | Tasa de identificación de eventos valiosos, tasa de activaciones erróneas y tasa de tareas duplicadas |
| Calidad de ejecución | Proporción de tareas completadas, proporción de retrabajo humano y proporción de resultados aprobados en la revisión |
| Experiencia de usuario | Número de intervenciones humanas por tarea válida, cantidad de notificaciones sin valor y tiempo desde que aparece el problema hasta que se obtiene un resultado aceptable |
| Costos operativos | Consumo de tokens por evaluación de evento, costo del modelo por tarea completada con éxito y costo de las tareas especulativas no aprovechadas |
| Gobernanza de seguridad | Proporción de tareas no autorizadas bloqueadas, eficacia de las aprobaciones en puntos clave y control de que la información sensible se mantenga dentro del alcance autorizado |
Riesgos que no se pueden ignorar
Los riesgos de los Agent proactivos incluyen activaciones erróneas, avalanchas de tareas, extralimitación de permisos, inyección de indicaciones, desperdicio de recursos y filtraciones de información. DeepSeek también reconoce en su artículo técnico que el aislamiento de contexto, la memoria a largo plazo, las comunicaciones seguras y la privacidad en organizaciones complejas siguen pendientes de resolver. Para los Agent que pueden acceder a repositorios privados y credenciales locales, evitar que la información sensible entre en el contexto del modelo o llegue a canales externos debe formar parte del diseño antes del despliegue.
Preguntas frecuentes (FAQ)
P1: ¿Qué es la arquitectura basada en eventos de DeepSeek Super-agent?
Es una arquitectura que permite a un agente recibir continuamente eventos del entorno externo (Trigger). Tras un filtrado programático y una evaluación del modelo, puede crear tareas dentro de los límites de autorización, ejecutarlas en segundo plano y avisar a una persona cuando corresponda. El punto de partida deja de ser una «instrucción del usuario» y pasa a ser un «evento del entorno», aunque las personas siguen controlando las autorizaciones y aprobaciones.
P2: ¿La inferencia proactiva de tareas significa que el usuario pierde el control?
No. Las tareas inferidas (Inferred) deben cumplir las reglas de admisión, los límites de ejecución y los requisitos de aprobación. El prototipo público utiliza por defecto el modo `observe`, que solo registra tareas potenciales sin aceptarlas automáticamente. El usuario puede elegir `off` para desactivar por completo las tareas inferidas o activar `auto` después de revisar los registros. El mecanismo Mandate también garantiza que mensajes como los comentarios no puedan ampliar directamente el alcance de la autorización.
P3: ¿Qué puede hacer actualmente el prototipo de código abierto?
El prototipo público admite principalmente GitHub y una integración opcional con Feishu, y ofrece tres modos de aceptación de tareas y el mecanismo de autorización Mandate. La comunidad ha informado de casos en los que se ha completado el flujo Issue → PR, aunque durante el despliegue se han detectado problemas como notificaciones que no llegan e incompatibilidades de configuración. Las fuentes de eventos como el correo electrónico y el calendario, así como una arquitectura asíncrona completa activada por defecto, siguen siendo parte de una visión más amplia o de implementaciones internas.
P4: ¿Cómo se controla el costo de tokens de un agente proactivo?
La clave está en un filtrado de dos niveles: primero, un Gate programático que no invoca un LLM descarta la mayoría de los eventos irrelevantes y solo envía unos pocos candidatos al modelo para su evaluación. Después, se usa la ejecución especulativa con cautela, preparando por adelantado solo las tareas que ofrecen un beneficio claro. Durante el desarrollo, puedes consultar las estadísticas de uso de APIYI apiyi.com para observar el costo del modelo por evaluación de evento y por tarea completada con éxito. Con esos datos, puedes ajustar las reglas de filtrado y la configuración del modelo.
P5: ¿Cómo se puede crear una capa similar de evaluación de eventos con una API de modelos?
Puedes tomar como referencia el ejemplo de este artículo: el Gate programático se encarga del filtrado por reglas, LLM Assessment devuelve una evaluación estructurada y las tareas inferidas se procesan según el modo de aceptación. Para la invocación del modelo basta con usar una interfaz compatible con OpenAI. Tras registrarte en APIYI apiyi.com, obtén una clave API y crédito de prueba; deja el base_url del ejemplo con la dirección indicada en este artículo y podrás ejecutarlo. Ten en cuenta que esto solo toma prestada la idea de la arquitectura: APIYI ofrece acceso a modelos mediante API, no un servicio Super-agent listo para usar.
P6: ¿Qué limitaciones conocidas tiene actualmente Super-agent?
Las principales son: el prototipo público cuenta con pocas fuentes de eventos y su configuración de despliegue presenta problemas de compatibilidad; los casos internos de «reparación silenciosa» aún no han sido verificados por terceros independientes; «ejecutarse en segundo plano» no garantiza un funcionamiento fiable las 24 horas; los PR generados todavía requieren revisión humana; y el propio equipo reconoce que quedan por resolver cuestiones como el aislamiento del contexto dentro de la organización, la memoria a largo plazo y la privacidad.
Puntos clave de DeepSeek Super-agent
- Cambio principal: el trabajo del Agent comienza con eventos del entorno, no solo con instrucciones del usuario. La ventana de chat deja de ser el único punto de entrada.
- Filtrado en dos niveles: Gate descarta el ruido mediante reglas de bajo costo y LLM Assessment se encarga de la evaluación semántica, equilibrando costo y precisión.
- Autorización primero: Explicit e Inferred se gestionan por separado,
observees el modo predeterminado y Mandate impide que los mensajes modifiquen los permisos. - Ejecución proactiva: la ejecución especulativa y las tareas asíncronas reducen la espera, pero es necesario sopesar el costo de cómputo frente al beneficio real.
- Entregas sin interrupciones innecesarias: solo se comunica cuando hace falta tomar una decisión o aceptar un resultado. Ser proactivo no significa enviar más notificaciones.
- Prudencia ante el estado actual: los casos internos muestran potencial y el prototipo de código abierto ya puede completar el flujo Issue → PR, pero su nivel de madurez aún es limitado.
- Cómo aprovecharlo: puedes empezar con una capa de evaluación de eventos basada en una API de modelos y comparar la clasificación y los costos de distintos modelos mediante APIYI apiyi.com.
Resumen
La arquitectura basada en eventos de DeepSeek Super-agent no responde a la pregunta «¿puede la IA tomar decisiones por sí sola?», sino a «¿cómo puede un Agent asumir trabajo de forma proactiva dentro de las reglas y los permisos establecidos?». Sus mecanismos principales se resumen en tres puntos:
- Detección y filtrado: Trigger convierte el entorno de trabajo en una fuente de entradas, mientras que el filtrado en dos niveles controla el ruido y el costo en tokens.
- Autorización y control: la distinción entre Explicit e Inferred, los tres modos de aceptación de tareas y el alcance de Mandate garantizan que actuar de forma proactiva no implique exceder los permisos.
- Ejecución y entrega: la ejecución especulativa, las tareas asíncronas y las notificaciones poco intrusivas permiten que las personas pasen de «gestionar tareas» a «tomar decisiones y aceptar resultados».
El valor de un Agent proactivo no está en cuántas acciones ejecuta, sino en cuánto trabajo de gestión manual elimina y cuántos resultados confiables entrega. El prototipo de código abierto aún se encuentra en una fase temprana, por lo que conviene empezar en modo observe, acumular registros de sus evaluaciones y generar confianza de forma gradual. Si estás diseñando un flujo similar de evaluación de eventos y ejecución de tareas, puedes usar APIYI apiyi.com para comprobar rápidamente el rendimiento de distintos modelos en cada capa y después tomar decisiones con datos reales de tu negocio.
📚 Referencias
- Estudio de la arquitectura DeepSeek Super-agent: análisis del diseño de agentes proactivos y basados en eventos
- Enlace:
blog2.eimoon.com/p/deepseek-super-agent-design/ -
Descripción: aborda Trigger, la ejecución especulativa, las tareas asíncronas y los casos internos
-
Documentación del mecanismo de autorización de DeepSeek: Explicit/Inferred, modos de aceptación de tareas y Mandate
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/002-authorization.md -
Descripción: fuente de referencia para entender los tres modos
off,observeyauto -
Filosofía de diseño de producto de DeepSeek: principios de mínima interrupción y respeto por la atención
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/000-philosophy.md -
Descripción: explica por qué un agente proactivo no debería llamar la atención constantemente
-
DeepSeek Domain Model: definición de los conceptos centrales del dominio
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/docs/001-domain.md -
Descripción: útil para comprender en profundidad la relación entre tareas, Worker y eventos
-
Instrucciones de despliegue de DeepSeek Setup: guía de instalación del prototipo de código abierto
- Enlace:
github.com/deepseek-ai/dsh-superagent-prototype/blob/main/SETUP.md -
Descripción: documento imprescindible antes de desplegar el prototipo
-
Informe de uso de la comunidad de GitHub: pruebas de Issue → PR y problemas de despliegue
- Enlace:
github.com/deepseek-ai/deepseek-harness/discussions/11706 - Descripción: permite conocer el estado real de funcionamiento del prototipo y sus limitaciones actuales
Autor: equipo técnico de APIYI
Contacto técnico: puedes comunicarte con nosotros desde la página principal de APIYI. Para más información sobre la integración de modelos, visita el centro de documentación en docs.apiyi.com