El 1 de noviembre, el equipo de DeepSeek Harness publicó en X el artículo «Explorando el diseño de superagentes», sobre la arquitectura de los superagentes (Super-agents). Unas 15 horas después, la publicación acumulaba alrededor de 1,3 millones de visualizaciones y 9,4 mil «me gusta». Es un artículo sobre conceptos de arquitectura, no una presentación de funciones de producto.
La conclusión en una frase: este diseño deja la gestión de sesiones en manos del sistema y ofrece al usuario un único punto de entrada. El Router (coordinador de primera línea) recibe solicitudes y asigna tareas; los Workers (sesiones que trabajan en segundo plano) las ejecutan en paralelo, y la persona solo toma decisiones de alto nivel y da la aprobación final.
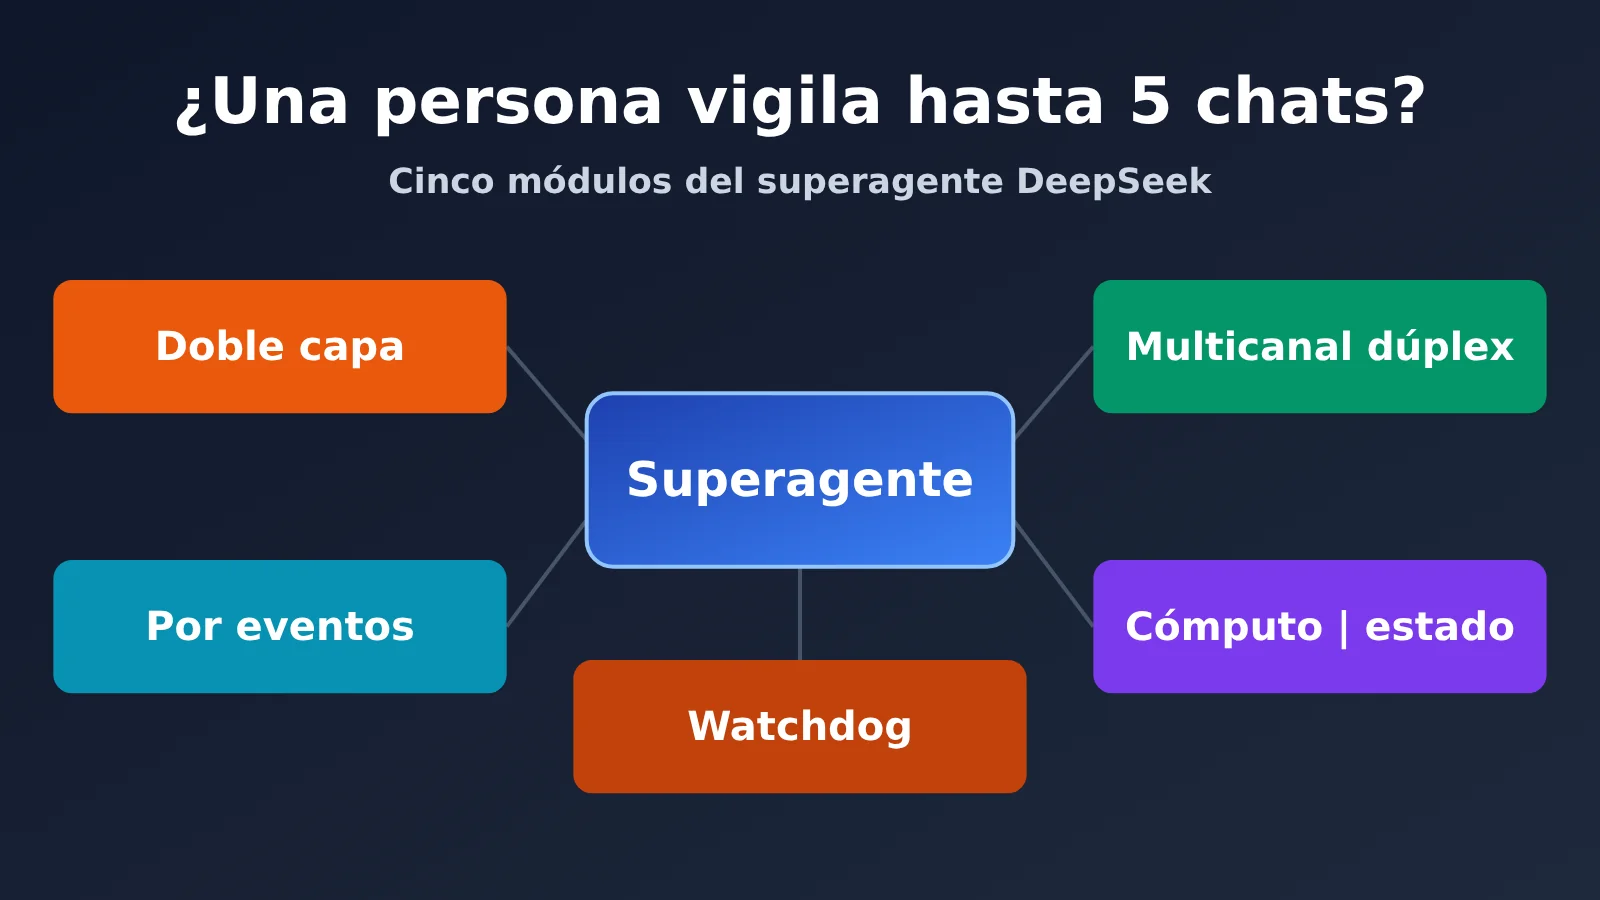
Por qué el superagente de DeepSeek necesita ir más allá de una sola sesión
Los agentes más utilizados todavía trabajan dentro de una sola sesión. Cuando un usuario ejecuta varias tareas a la vez, tiene que cambiar de sesión y recordar el contexto de cada una. Según la experiencia del equipo de DeepSeek Harness, una persona suele poder gestionar entre 3 y 5 sesiones activas al mismo tiempo. No es una estadística universal, sino una observación del equipo, pero señala un cuello de botella: una tarea individual está limitada por la capacidad del modelo, mientras que varias tareas están limitadas por la atención de la persona.
Añadir herramientas de línea de comandos y conectores externos a un agente local solo permite que reciba mensajes del exterior. Las tres limitaciones siguen ahí:
- Bloqueo síncrono: el ciclo ReAct clásico —que alterna entre razonamiento y llamadas a herramientas— espera a que terminen las operaciones largas y no puede responder a nuevos mensajes mientras tanto.
- Contaminación del contexto: los detalles intermedios de distintas tareas se mezclan en una misma ventana e interfieren entre sí.
- Dependencia del dispositivo: si el dispositivo local entra en reposo o se desconecta, el agente deja de trabajar.
Por eso, el artículo propone desvincular el agente de cualquier sesión individual gestionada manualmente y convertirlo en una entidad continua. Para ello, debe reunir las cuatro características siguientes. Un único ciclo ReAct no puede ofrecerlas: necesita el apoyo de la arquitectura del sistema que lo rodea.
| Característica del superagente | En pocas palabras | Módulos principales |
|---|---|---|
| Continuo | Se comunica por mensajería instantánea y GitHub como si fuera siempre el mismo agente | Arquitectura de dos capas e interacción multicanal |
| Eficiente | Recibe nuevas instrucciones sin esperar a que termine el comando anterior y ejecuta varias tareas en paralelo | Arquitectura de dos capas e interacción full-duplex |
| Proactivo | Escucha los eventos del entorno y actúa cuando merece la pena intervenir | Arquitectura orientada a eventos |
| Persistente | Está siempre en línea y puede recuperarse automáticamente ante errores | Separación entre capacidad de cómputo y estado, y Watchdog |
Los cinco módulos del superagente de DeepSeek, uno por uno
Empecemos con la tabla general. Presta especial atención a la columna «¿Se puede usar ahora?»: el artículo describe una dirección de diseño, no necesariamente funciones listas para usar.
| Módulo | Qué problema resuelve | Enfoque clave | ¿Se puede usar ahora? |
|---|---|---|---|
| Arquitectura de dos capas | Es difícil combinar continuidad y concurrencia | El Router se limita a interactuar y asignar tareas; los Workers las ejecutan de forma aislada | El prototipo tiene un flujo similar, pero hay que desarrollar la solución completa |
| Orientación a eventos | El agente solo puede esperar instrucciones y hay demasiado ruido de eventos | Filtrado rápido por código, evaluación detallada con el modelo y entrega directa mediante suscripciones a Threads | El prototipo puede escuchar eventos de GitHub y, opcionalmente, de Feishu |
| Multicanal full-duplex | Las tareas largas bloquean la conversación y los registros molestan al usuario | Llamadas asíncronas a herramientas y reglas de respuesta según el canal | DeepSeek Harness ya admite tareas asíncronas, pero no están activadas por defecto |
| Separación de cómputo, estado y entorno | Si el dispositivo se desconecta, el proceso se detiene y no puede acceder a otros entornos | El bucle se ejecuta en la nube, el estado se guarda en una base de datos y los endpoints permanecen donde están | El texto original no indica que esté disponible públicamente; hay que desarrollarlo |
| Watchdog | El proceso sigue activo, pero la tarea se atasca o se desvía | Una sesión independiente del sistema principal realiza comprobaciones periódicas | El texto original no indica que esté disponible públicamente; hay que desarrollarlo |
Módulo 1: la arquitectura de dos niveles Router/Worker del superagente DeepSeek
Analogía: el Router es como la recepción de un restaurante: recibe a los clientes y transmite los pedidos. Los Workers son la cocina: cada estación prepara un solo plato.
Si todos los eventos entran en una misma sesión, el contexto se mantiene coherente, pero la capacidad de procesamiento es baja. Si se abre una sesión nueva para cada evento, aumenta la concurrencia, pero se pierde el contexto global y varias sesiones pueden acabar respondiendo al usuario por separado. La arquitectura de dos niveles separa estas funciones: el Router permanece activo y se encarga de la interacción con las personas y de la coordinación global; incluso puede funcionar sin la herramienta Bash. Los Workers tienen contextos aislados, cada uno se ocupa de una sola tarea y no responde directamente al usuario: informan de su estado al Router. La idea del artículo original es que las sesiones sean un detalle de implementación del sistema, no algo que el usuario tenga que gestionar mentalmente.
El Router podría parecer un cuello de botella, pero los Trigger (eventos del entorno) que llegan durante una ronda de inferencia se ponen en cola y se procesan juntos en la siguiente. Sus solicitudes suelen tener entradas largas y salidas cortas. Los eventos agrupados se calculan en paralelo durante la fase de Prefill (la primera etapa, en la que el modelo procesa la entrada), por lo que el tiempo de una solicitud crece más lentamente que el tamaño del lote. Según la experiencia del equipo, el trabajo del Router suele ser más sencillo de lo que parece y, por lo general, basta con un modelo ligero. Para empezar, puedes acceder a deepseek-v4.1-flash a través de APIYI · apiyi.com, probarlo como Router y observar la precisión con la que asigna las tareas.
Los Workers determinan directamente el resultado de las tareas y la calidad del código, por lo que el artículo original recomienda usar, por lo general, el modelo más potente. Puedes comparar deepseek-v4-pro y claude-opus-5-5 con el mismo conjunto de tareas en APIYI · apiyi.com y después elegir el modelo predeterminado.
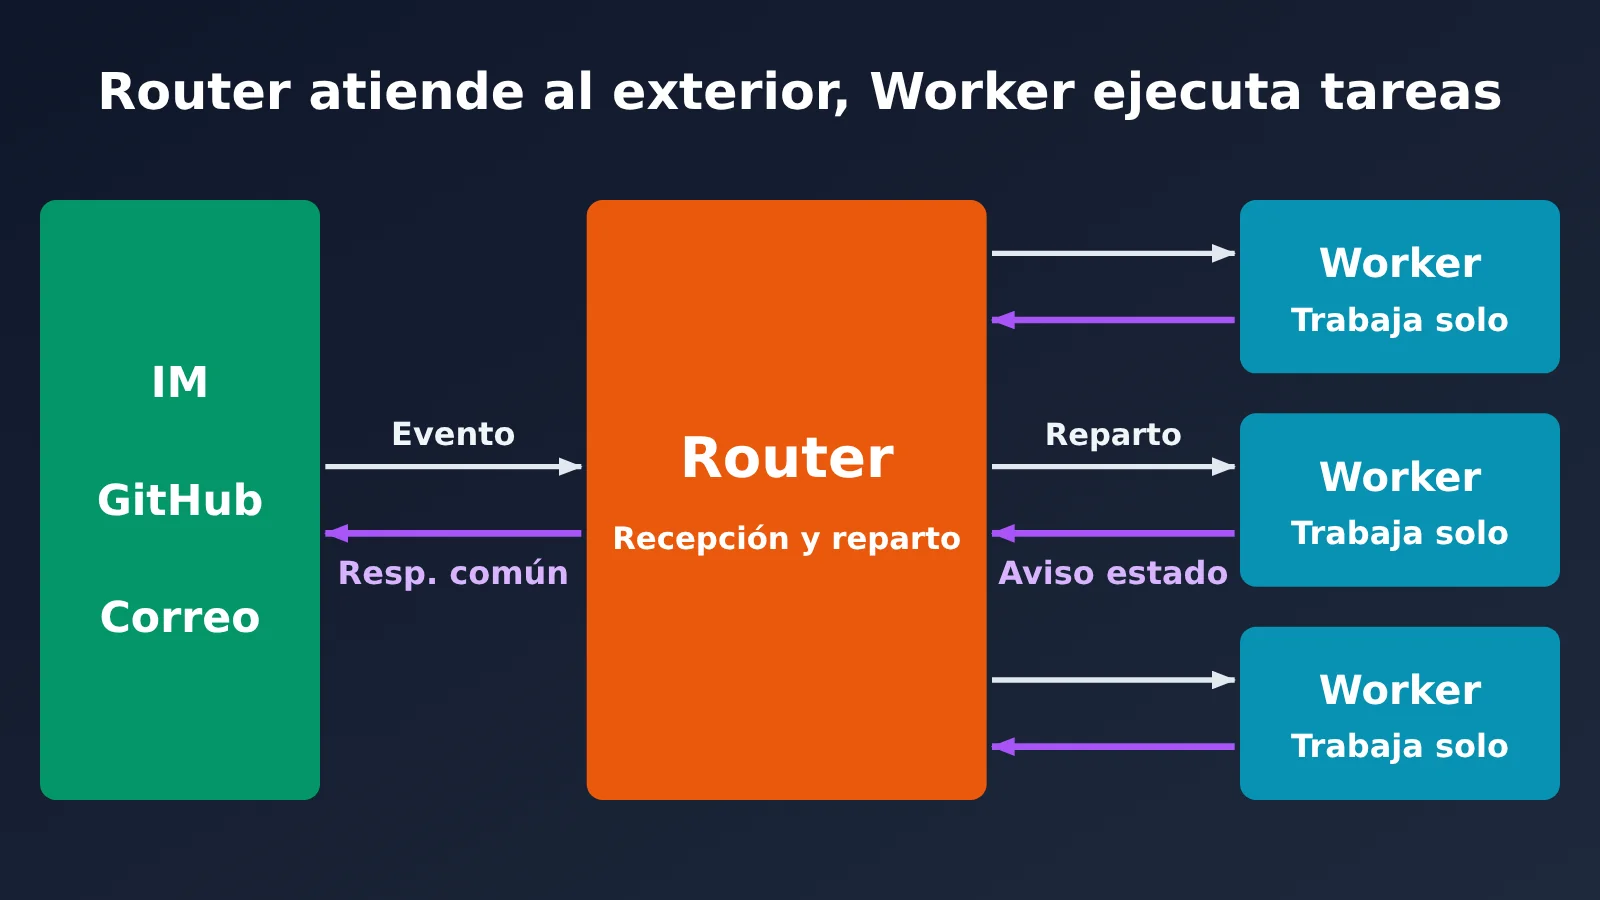
Módulo dos: Trigger y la lógica basada en eventos del superagente de DeepSeek
Analogía: El portero filtra a las personas según una lista y consulta al gerente cuando tiene dudas; los asuntos posteriores de clientes habituales se derivan directamente a la persona que ya los atendía.
Para que un agente trabaje de forma proactiva, su entrada principal debe pasar de las indicaciones manuales a los eventos del entorno, como mensajes de chat grupal, resultados de CI y comentarios de revisión de código. El flujo real de eventos contiene mucho ruido: si se le pide al Modelo de Lenguaje Grande que evalúe cada uno, la latencia y el consumo de recursos se disparan. Por eso, el artículo propone dos capas de filtrado:
- Fast Path (filtrado rápido por código): Realiza comprobaciones deterministas según listas de fuentes, grupos, usuarios o bots permitidos. Para cada fuente se puede configurar «responder solo a solicitudes explícitas», «tratar como evento candidato» o «ignorar».
- Slow Path (evaluación del modelo): Solo los eventos candidatos que superan el filtro rápido se envían al LLM, que decide si debe actuar teniendo en cuenta el contexto y las políticas escritas en una indicación.
El enrutamiento también tiene una vía rápida y otra lenta. Los eventos consecutivos de un mismo PR, tema de mensajería instantánea o cadena de correo forman un Thread. Una vez que un Worker se suscribe, el código le transmite directamente los eventos posteriores, sin que el Router tenga que volver a tomar una decisión. Si varios Workers se suscriben al mismo Thread, reciben las mismas notificaciones y pueden detectar y resolver conflictos por su cuenta.
El contexto se gestiona como una caché. La información que se necesitará pronto se coloca directamente en la ventana de contexto (Inline); la información completa que se usa con poca frecuencia se mantiene fuera, dejando solo una referencia o un resumen (Spill). El artículo también menciona la acción anticipada: consultar el calendario o reproducir un issue en segundo plano, entregar solo los resultados útiles y descartar el resto. Así se emplean recursos de cómputo adicionales para reducir el tiempo de espera y la intervención humana.
Módulo tres: interacción dúplex completo y multicanal del superagente de DeepSeek
Analogía: cuando pones agua a hervir, no necesitas quedarte junto al hervidor: te avisa cuando está lista. Mientras tanto, puedes seguir conversando con otras personas.
ReAct asíncrono sustituye las llamadas que tardan mucho por start() y stop(). start() devuelve el control de inmediato, mientras la herramienta se ejecuta en segundo plano. Al terminar, el resultado vuelve a la conversación como un evento nuevo. El modelo también puede usar stop() para detener un comando que está tardando demasiado. Así, las nuevas entradas del usuario pueden procesarse en cuanto termina el paso de razonamiento actual. El artículo original aclara que DeepSeek Harness ya implementa este mecanismo de tareas asíncronas, pero todavía no lo activa de forma predeterminada.
El enfoque multicanal resuelve la cuestión de «cómo comunicarse». En mensajería instantánea, las respuestas deben ser breves y poco intrusivas: solo se envían notificaciones cuando hace falta tomar una decisión o dar una aprobación. Una regla estricta que el equipo ha validado es que ninguna respuesta supere las 100 palabras. En GitHub, el correo electrónico y los documentos, en cambio, se necesitan respuestas estructuradas y con mucha información. Por ejemplo, en un PR hay que explicar con claridad el contexto del problema, los cambios y los resultados de la validación.
Módulo cuatro: separación de la capacidad de cómputo, el estado y el entorno del superagente de DeepSeek
Analogía: los expedientes se guardan en el archivo de la empresa, así que un empleado puede seguir trabajando aunque cambie de puesto. Y si necesita usar una herramienta de otra máquina, se envía a alguien para operarla allí.
El artículo plantea el desacoplamiento en dos pasos. Primero, el bucle del agente se ejecuta en contenedores de nube sin estado y el estado de la sesión se guarda en una base de datos. Así, reiniciar o reemplazar un contenedor no interrumpe la continuidad de la tarea. Segundo, el entorno de ejecución permanece donde está: cada equipo solo necesita un daemon ligero —un pequeño programa que funciona en segundo plano— que no guarda el estado de la sesión, sino que se limita a ejecutar comandos y devolver resultados.
Este diseño también admite BYOM (Bring Your Own Machine, o conectar tu propia computadora al agente en la nube). Así no es necesario sincronizar con la nube todos los cambios sin confirmar y las credenciales locales. Cuando el dispositivo vuelve a estar en línea, el agente en la nube puede seguir con las tareas que deben ejecutarse en él. El artículo de Anthropic “Decoupling the brain from the hands” también emplea una idea de desacoplamiento similar y puede servir como lectura complementaria.
Módulo cinco: supervisión externa mediante Watchdog del superagente de DeepSeek
Analogía: El supervisor de turno no participa en el trabajo concreto; revisa periódicamente quién se ha detenido y quién se ha desviado del objetivo.
Muchos fallos de los agentes no son caídas: el proceso sigue activo, pero el modelo queda atrapado en un bucle que no produce resultados. Las sondas de disponibilidad tradicionales no pueden detectarlo. Watchdog es una sesión independiente que se ejecuta fuera del sistema principal y se activa mediante mensajes programados. Gestiona fallos de infraestructura, como errores de API o fallos al recuperar el estado, y también usa un modelo para evaluar si cada Worker está avanzando de verdad. El personal de mantenimiento puede preguntarle en lenguaje natural «por qué falló» o pedirle que ajuste las indicaciones y las reglas de activación mientras el sistema está en funcionamiento.
Hasta dónde se puede probar hoy el prototipo del superagente de DeepSeek
El repositorio asociado es github.com/deepseek-ai/dsh-superagent-prototype y utiliza la licencia MIT. En la consulta del 2 de noviembre de 2026 tenía 8.636 estrellas y 863 forks. Es un prototipo de investigación, no un producto oficial de DeepSeek, y tampoco equivale a la versión interna del equipo ni a la implementación completa que describe el artículo. Algunos de los diseños mencionados son planes para el futuro y aún no están implementados en el prototipo.
El prototipo es un agente de programación proactivo para un único repositorio de GitHub, empaquetado como un bundle de DeepSeek Harness. Supervisa GitHub y también puede conectarse opcionalmente a Feishu. Cuando alguien le asigna una tarea, crea un elemento de trabajo, la completa en su propia sesión y directorio, y vuelve a la conversación original para responder, por ejemplo, con una pull request. También cuenta con un panel web que muestra los asuntos que requieren atención humana.
Qué revelan los dos experimentos sobre el Super-agent de DeepSeek
Todos los datos proceden del artículo oficial. Los experimentos utilizaron cargas sintéticas y entornos simplificados; sus autores advierten que los resultados son solo orientativos. En el primer experimento, cada ejecución incluía unos 300 mensajes, de los cuales alrededor de 20 eran solicitudes de trabajo. Cada diseño se probó 5 veces. Las tareas de programación se simularon con herramientas que solo consumían tiempo, así que se midieron la planificación y la coordinación, no la calidad de ejecución.
En la tabla, p50 indica que la mitad de las tareas se completó en ese tiempo, y p95 indica que el 95 % se completó en ese plazo. Los cache-read tokens son los tokens leídos de la caché —es decir, contexto almacenado que se reutiliza sin volver a procesarlo— y aquí representan el total de todas las sesiones.
| Diseño | p50 (minutos) | p95 (minutos) | cache-read tokens / ejecución |
|---|---|---|---|
| Super-agent | 12,4 | 15,7 | 23,2 M |
| Sin Pass-through (paso directo de suscripciones) | 12,6 | 15,5 | 31,8 M |
| Una sesión + subagentes (indicación neutral) | 20,4 | 29,5 | 6,1 M |
| Una sesión + subagentes (indicación que prioriza la delegación) | 13,8 | 29,0 | 10,8 M |
Con la indicación neutral, el modelo no invocó ningún subagente en las 5 ejecuciones. Con la indicación que priorizaba la delegación, delegó en 4 de las 5; en la otra, consideró que el trabajo era pequeño y lo hizo por sí mismo. Esto indica que, con esta carga, el rendimiento de una sola sesión depende mucho de la indicación y de las decisiones que toma el modelo sobre la marcha, mientras que la arquitectura de dos capas incorpora la delegación en el sistema. El coste también es evidente: Super-agent consume muchos más tokens de lectura de caché a cambio de tiempos de finalización más cortos y estables.
Al eliminar el paso directo, el tiempo de finalización casi no cambió, pero el Router tomó aproximadamente un 30 % más de decisiones y los cache-read tokens aumentaron cerca de un 37 %. Por tanto, con esta carga, el paso directo no aceleró el proceso; su principal función fue reducir la sobrecarga del Router.
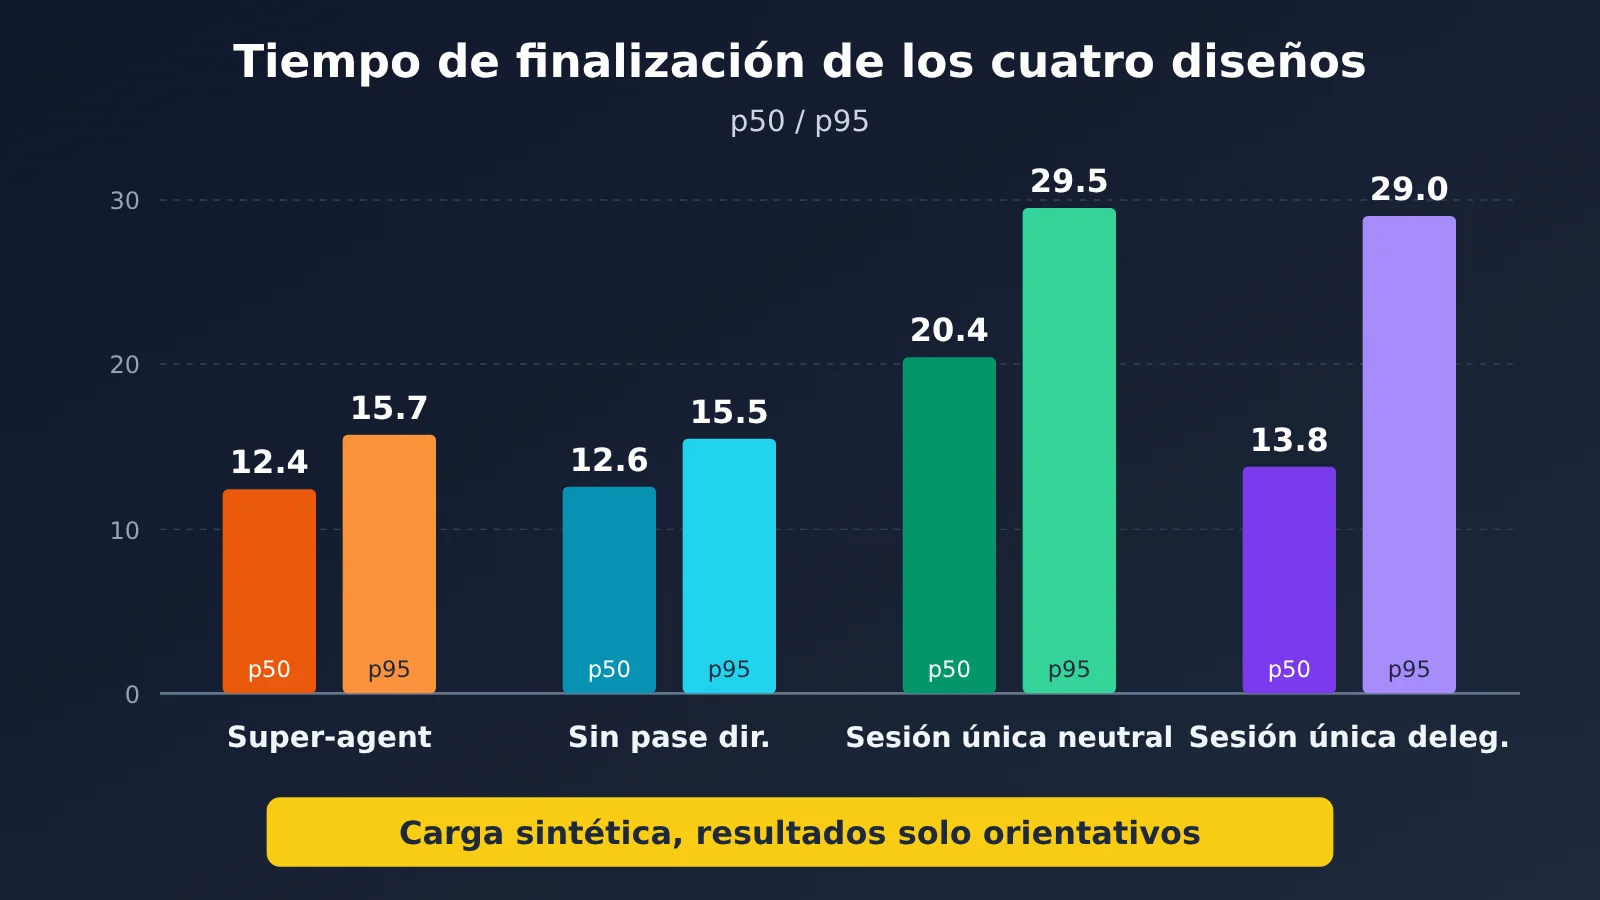
El segundo experimento puso a prueba por separado la capa del Router: este utilizó un modelo real, mientras que el Worker empleó uno simulado. La tasa de llegada de Triggers que requerían una decisión del Router aumentó de forma gradual.
| Tasa de llegada (veces/minuto) | Tamaño medio del lote | Tiempo por solicitud | Tiempo de inferencia amortizado por decisión |
|---|---|---|---|
| Aprox. 1 | 1,0 | 2,5 segundos | 6,4 segundos |
| Aprox. 40 | 2,8 | 3,9 segundos | 1,6 segundos |
Una decisión puede incluir varias solicitudes al LLM, por lo que el tiempo amortizado puede ser mayor que el tiempo por solicitud. Estos datos respaldan la conclusión de que, ante ráfagas de eventos, la agrupación automática puede aumentar el rendimiento efectivo del Router. Sin embargo, no demuestran que se obtengan los mismos resultados en un entorno de producción real ni permiten evaluar la calidad de las tareas o el rendimiento con distintas bases de código.
Cuatro preguntas abiertas sobre el superagente de DeepSeek
El artículo reconoce que las siguientes cuestiones siguen sin resolverse y que deben tenerse en cuenta al evaluar una implementación:
- Cómo escalar la arquitectura: Cuando las tareas crecen y están más interconectadas, aún no está claro si conviene dividir el Router en fragmentos, con qué granularidad o cuándo deberían comunicarse directamente los Workers. Cuanto más fina sea la división, mayor será la concurrencia, pero menos memoria y contexto se compartirán. La memoria a largo plazo también es un obstáculo importante.
- Cómo usarlo sin sesiones: Se necesitan nuevas formas de interacción para presentar las tareas y permitir que las personas intervengan en detalles clave sin interrumpir el trabajo en segundo plano.
- Límites del contexto y A2A: A2A (agent-to-agent) se refiere a la comunicación y colaboración entre distintos agentes. A medida que crece la organización, configurar un superagente implica decidir qué contextos se comparten y cuáles se aíslan. Aún no hay una respuesta sobre cómo colaborar de forma segura entre distintos niveles de permisos.
- Seguridad y privacidad: Esta es la cuestión que debe evaluarse con mayor prioridad. El ciclo en la nube recibe eventos externos de forma continua, mientras que los dispositivos conectados almacenan código privado y credenciales locales. Si se compromete el servidor o se ataca el ciclo mediante una inyección de indicaciones (instrucciones maliciosas ocultas en la entrada), todos los dispositivos conectados podrían quedar bajo el control del atacante. Según el artículo, los agentes necesitan una forma de «usar las credenciales sin poder verlas».
Lista mínima para implementar el superagente de DeepSeek en un equipo pequeño
El siguiente orden es una propuesta basada en las ideas del artículo original, no una hoja de ruta oficial. Empiecen con una prueba piloto en un solo repositorio y dentro de un entorno de confianza. Por ahora, dejen de lado la fragmentación del Router.
Primer paso: separar Router y Worker
- Código: creen un Router que permanezca activo de forma continua y no le den acceso a la herramienta Bash. Para cada tarea, abran un Worker independiente, con su propio contexto y directorio de trabajo. El Worker solo comunica sus resultados al Router.
- Modelo: usen un modelo ligero para el Router y uno más potente para los Worker. Configúrenlos por separado para poder sustituirlos de forma independiente.
- Personas: interactúen solo con el Router. Su función es definir los límites de cada tarea, atender las solicitudes de decisión y dar la aprobación final.
Segundo paso: añadir el filtro Trigger
- Código: configuren una lista de fuentes permitidas y una política de tres niveles. Asocien los PR y los temas de mensajería instantánea (IM) a un Thread, y envíen directamente al Worker los eventos posteriores de las conversaciones suscritas.
- Modelo: apliquen el análisis semántico solo a los eventos candidatos para decidir si hay que actuar y si es necesario abrir un nuevo Worker.
- Personas: definan claramente en la indicación las condiciones para actuar. Revisen periódicamente muestras de activaciones incorrectas y eventos no detectados, y ajusten la lista de fuentes y la política.
Tercer paso: añadir Watchdog
- Código: despliéguenlo fuera del sistema principal y actívenlo mediante mensajes programados para que detecte problemas de infraestructura, como errores de API o fallos al recuperar el estado.
- Modelo: revisen los registros de progreso del Worker para determinar si está avanzando de verdad, si está bloqueado o si se está desviando del objetivo.
- Personas: definan los permisos de reparación de Watchdog, aprueben sus cambios en las indicaciones y las reglas de activación, y analicen las causas de los fallos.
Desde el primer día, eviten incluir credenciales de producción directamente en el contexto del modelo y configuren los permisos con el alcance mínimo necesario. Las llamadas asíncronas a herramientas y la separación de recursos de cómputo pueden esperar hasta que los tres primeros pasos funcionen de forma estable y aparezcan problemas reales de bloqueo o de dispositivos desconectados.
Combinación de modelos y estimación de costos para el superagente de DeepSeek
La siguiente tabla recoge los modelos de APIYI · apiyi.com consultados el 2 de noviembre de 2026. Los precios se expresan en $/1 millón de tokens. Consulta la lista de modelos de la plataforma para conocer los modelos y precios vigentes; el cargo real aparece en la consola.
| Modelo | Entrada | Salida | Lectura de caché |
|---|---|---|---|
| deepseek-v4.1-flash | 0.3 | 1.2 | 0.006 |
| deepseek-v4-flash | 0.44 | 1.32 | 0.01408 |
| deepseek-v4-pro | 1.32 | 3.96 | 0.043996 |
| claude-opus-5-5 | 4 | 20 | 0.2 |
Las siguientes cifras son estimaciones basadas en precios públicos, no resultados medidos. Suponiendo que cada invocación consume 20 000 tokens de entrada y 2000 de salida, sin contar la caché:
deepseek-v4.1-flashcuesta aproximadamente $0.0084;deepseek-v4-pro, $0.0343; yclaude-opus-5-5, $0.12.- Una invocación con
deepseek-v4.1-flashpara el Router y otra condeepseek-v4-propara el Worker suman aproximadamente $0.0427. Usarclaude-opus-5-5para ambos cuesta unos $0.24, alrededor de 5.6 veces más. - Si ejecutas 20 grupos al día con ese consumo, la combinación de modelos cuesta unos $0.85 y usar solo
claude-opus-5-5, unos $4.8. En la práctica, un Worker suele necesitar más de una ronda de invocaciones, así que conviene recalcular con los tokens de tus propios registros.
En los sistemas que funcionan durante periodos prolongados también hay que calcular por separado la lectura de caché. Tomando como referencia los 23.2 millones de tokens de lectura de caché del experimento, el costo sería de unos $0.14 si todos se facturaran con deepseek-v4.1-flash, $1.02 con deepseek-v4-pro o $4.64 con claude-opus-5-5. Estas cifras solo sirven para hacerse una idea del orden de magnitud: el experimento no publicó la distribución de tokens por capa y el cálculo tampoco incluye los costos de entrada y salida.
Lo mejor es que los modelos del Router y el Worker sean configurables. Con APIYI · apiyi.com puedes cambiar entre estos modelos usando una sola clave API. El base_url de la interfaz compatible con OpenAI es https://api.apiyi.com/v1; para cambiar de modelo, basta principalmente con modificar su nombre. Esto facilita comparar la calidad y el costo con un mismo conjunto de tareas. El precio es solo una parte de la elección: para definir el modelo predeterminado del Worker también hay que tener en cuenta la tasa de éxito de las tareas y la cantidad de retrabajo.
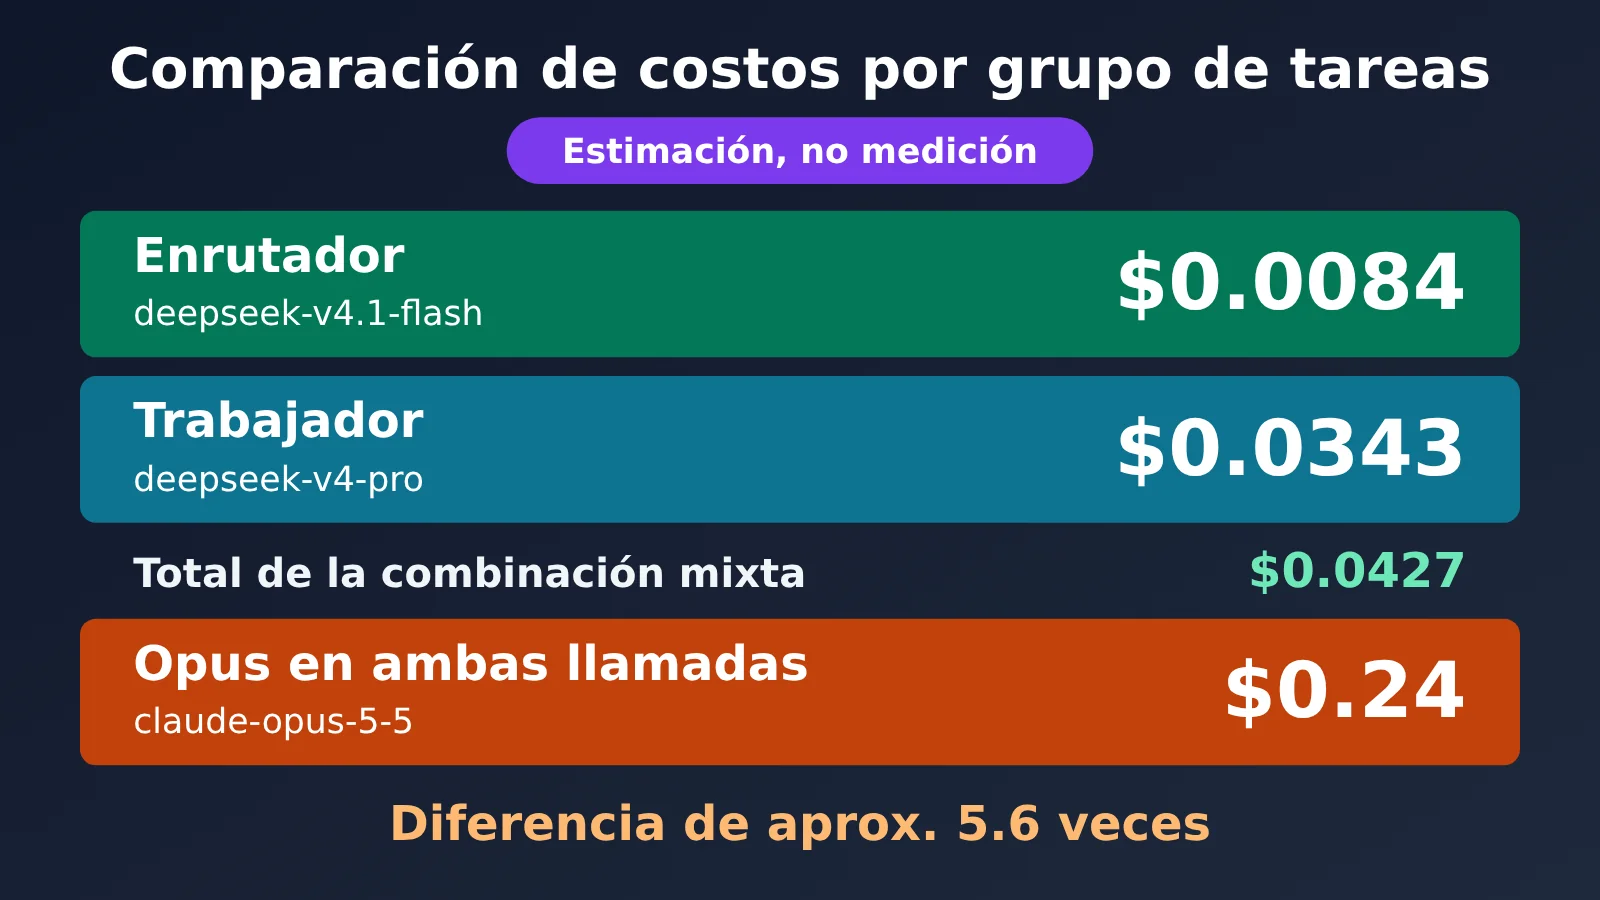
El gráfico muestra una estimación basada en los precios predeterminados de la lista de modelos de APIYI · apiyi.com. Usa tu propio consumo de tokens para calcular el presupuesto.
Preguntas frecuentes sobre el superagente de DeepSeek
P1: ¿Es un modelo nuevo?
No. Es un artículo sobre la arquitectura de sistemas de agentes. Se centra en cómo el sistema que los rodea organiza las sesiones, los eventos, el estado y la monitorización. No se ha publicado ningún modelo nuevo.
P2: ¿Puede usarlo directamente cualquier desarrollador?
No se pueden usar los cinco módulos como funciones listas para usar. Por ahora, puedes probar el prototipo de investigación o crear tu propia implementación siguiendo las ideas del artículo. La única implementación existente que menciona explícitamente el texto original es el mecanismo de tareas asíncronas de DeepSeek Harness, que está desactivado por defecto.
P3: ¿dsh-superagent-prototype es un producto oficial?
No. Su README aclara que es solo una referencia para investigación. No es un producto oficial de DeepSeek ni equivale a una versión interna o a la implementación completa descrita en el artículo.
P4: ¿Usar varios agentes cuesta más?
En estos experimentos, el superagente sí leyó más tokens de caché: 23,2 millones, frente a los 6,1 a 10,8 millones de la solución de una sola sesión. A cambio, los tiempos de finalización fueron más cortos y estables. El costo total también depende de la combinación de modelos y del tamaño de la tarea. Usar un modelo ligero para el Router y habilitar el paso directo de Thread ayuda a controlar el gasto.
P5: ¿Cómo se accede a estos modelos desde China?
Puedes registrarte en APIYI · apiyi.com y obtener una clave API. Los usuarios nuevos reciben crédito gratuito para pruebas. Después, cambia el `base_url` del cliente por la dirección indicada arriba e introduce en el parámetro del modelo uno de los modelos de la tabla. Estos modelos de DeepSeek y Claude admiten los endpoints chat y messages. Antes de pasar a producción, conviene validarlos con un volumen bajo de tráfico.
Resumen
El valor del artículo sobre el súper agente de DeepSeek está en aplicar principios clásicos de ingeniería de sistemas a los agentes. Estas son las ideas principales:
- El problema: en tareas individuales, los modelos necesitan cada vez menos intervención humana; en múltiples tareas, el cuello de botella se está desplazando hacia la atención de las personas.
- Cinco módulos: arquitectura de dos capas, procesamiento basado en eventos, múltiples canales full-duplex, separación del cómputo, el estado y el entorno, y Watchdog. En conjunto, permiten cuatro características: continuidad, eficiencia, proactividad y persistencia.
- Límites de la evidencia: los dos experimentos son resultados con cargas de trabajo sintéticas reportados por el propio autor, por lo que solo sirven como referencia para el diseño.
- Orden de implementación: primero separa Router y Worker, después añade el filtrado mediante Trigger y, por último, incorpora Watchdog. Mantén los límites de seguridad como prioridad durante todo el proceso.
No hace falta decidir la combinación de modelos de una vez. Puedes usar APIYI · apiyi.com para hacer primero una comparación a pequeña escala con el mismo conjunto de tareas y, después, elegir la configuración según la tasa de éxito y el costo.
Primero deja de actuar como un «Router humano»; después, plantéate añadir más agentes.
Autor: Equipo técnico de APIYI
Contacto técnico: Puedes contactarnos desde la página principal de APIYI. Encontrarás más recursos en el centro de documentación docs.apiyi.com