Nota del autor: este artículo presenta el contexto, los cuatro niveles de intensidad de razonamiento y el precio de Gemini 4 Neon, explica cómo configurar los dos accesos, nativo y compatible, en APIYI, y muestra cómo usar la misma solicitud mínima para localizar errores comunes de integración.
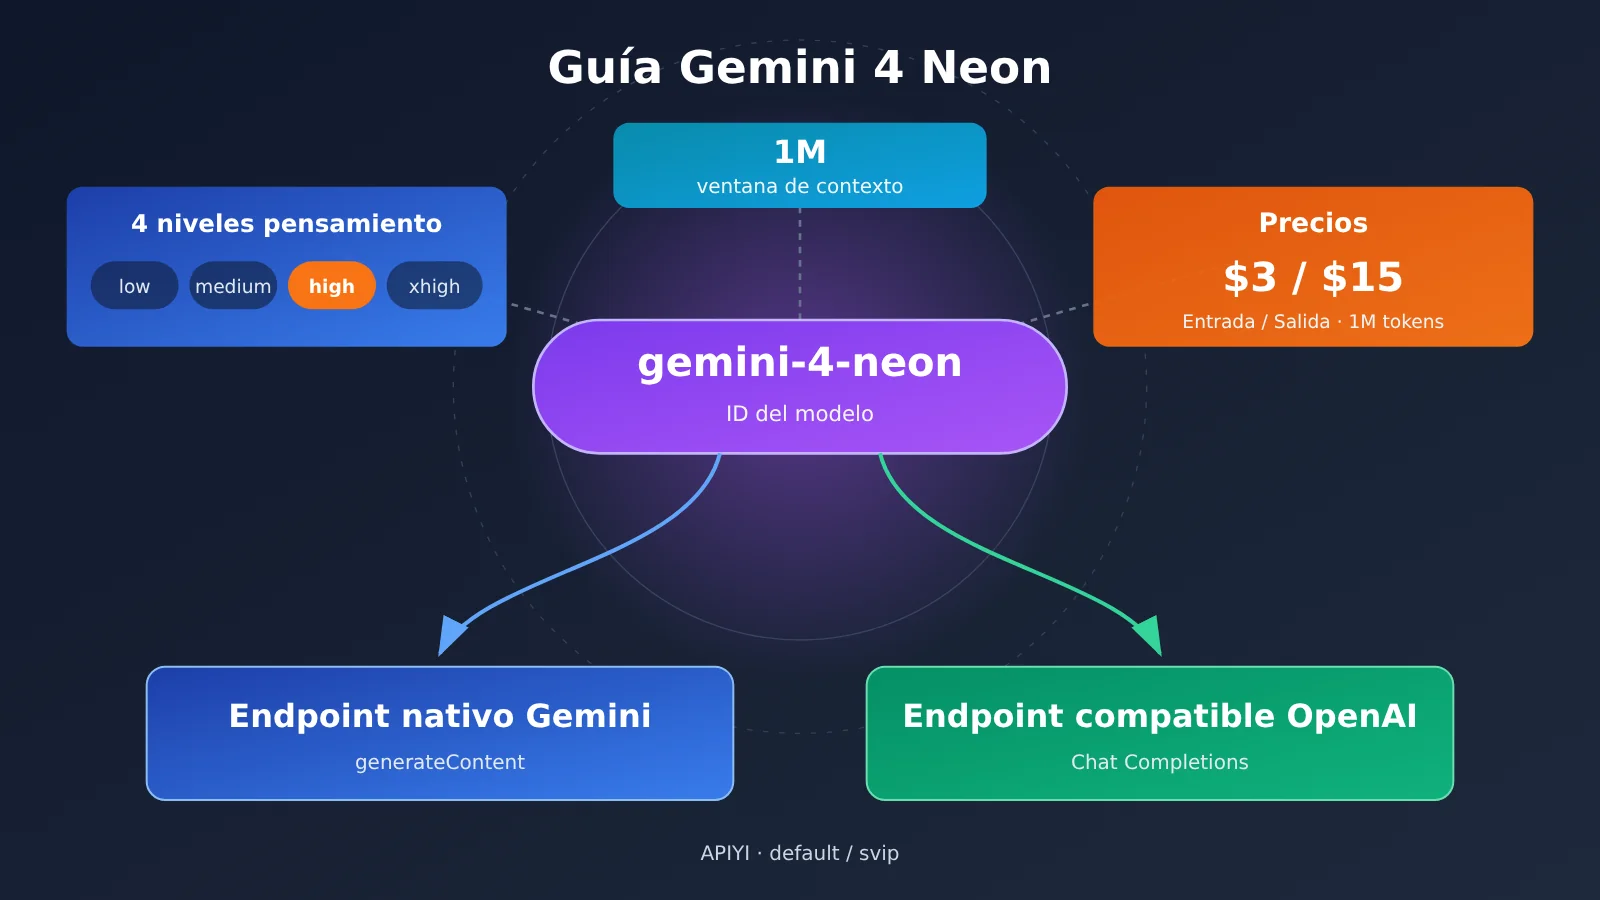
En una frase: Gemini 4 Neon fue lanzado por Google el 18 de noviembre de 2026, APIYI lo puso en línea el 20 de noviembre en los grupos default/svip, el ID del modelo es gemini-4-neon y el precio de lista es de $3 por millón de tokens de entrada, $15 por millón de tokens de salida y $0.15 por lectura de caché. Si necesitas control nativo de los niveles de razonamiento, prioriza el endpoint nativo de Gemini; si solo quieres cambiar el modelo en un cliente OpenAI existente, el endpoint compatible es más sencillo. No obstante, en ambas rutas conviene validar primero la solicitud más corta y luego habilitar, uno por uno, el streaming, las llamadas a herramientas y los niveles de razonamiento más altos.
Esto no es un artículo de noticias que se limita a reescribir una nota de prensa. Los parámetros, precios, resultados de benchmark y rutas de diagnóstico que aparecen a continuación incluyen su fuente y condiciones de aplicación; los ejemplos de código se elaboraron según la documentación oficial. La nota de lanzamiento de APIYI indica que, antes de la publicación, solo se verificó la interfaz de precios y no se realizaron llamadas reales; por eso este artículo no afirma que los dos endpoints ni las llamadas a herramientas estén “verificados en pruebas reales”.
Valor central: después de leer este artículo, podrás confirmar las especificaciones de Neon y los criterios de facturación, escribir las dos solicitudes mínimas, una nativa y otra compatible, elegir el nivel de razonamiento según los resultados de las pruebas y localizar rápidamente problemas según los síntomas de error.
Términos que debe conocer antes de integrar Gemini 4 Neon
Estos conceptos aparecerán varias veces a lo largo del texto. Si unificamos la terminología desde el principio, será más difícil confundirse cuando toque diagnosticar problemas.
- ID del modelo: la cadena completa que especifica el modelo en la solicitud; en este artículo es
gemini-4-neon. Hay que copiar exactamente las mayúsculas/minúsculas y los guiones, sin abreviarlo por cuenta propia. - URL base: la dirección raíz con la que el cliente compone la ruta de la solicitud. Que incluya o no un prefijo de versión como
/v1depende del SDK que se use; configurarla mal es una causa habitual de errores 404. - Endpoint nativo de Gemini: recibe el protocolo
generateContenty encaja en escenarios donde se necesitan los parámetros de razonamiento nativos. - Endpoint compatible con OpenAI: usa el formato Chat Completions, de modo que los clientes de OpenAI ya existentes pueden reutilizar directamente la estructura básica de mensajes.
- Nivel de razonamiento: valor de enumeración que indica la intensidad de inferencia del modelo. Neon admite de forma nativa
low,medium,highyxhigh; APIYI, al desplegar el servicio, marca dinámicamente el nivel predeterminado comohigh. - Firma de razonamiento
thoughtSignature: marca de contexto que devuelve el modelo. En invocaciones de herramientas de varios turnos, debe conservarse y devolverse conforme al protocolo original. - Ventana de contexto: presupuesto total que comparten la entrada, el razonamiento y la salida. Cuánto puede generar una generación síncrona individual debe comprobarse por separado con su propio límite.
- Precio de lectura de caché: tarifa aplicable al reutilizar una entrada existente que cumpla los requisitos; es bastante inferior al precio estándar de entrada.
Puntos clave de Gemini 4 Neon: parámetros, precios y grupos
Según el anuncio de lanzamiento de APIYI, Neon es el nivel intermedio de la serie Gemini 4, situado entre Carbon (para las tareas más difíciles) y Hydrogen (para la ejecución diaria). Google lo anunció el 18 de noviembre y lo puso en disponibilidad general (GA) ese mismo día; APIYI lo integró el 20 de noviembre.
| Punto clave | Detalle | Fuente y condiciones |
|---|---|---|
| ID del modelo | gemini-4-neon |
Registro de modelos de APIYI (generado el 2026-11-20) |
| Grupos disponibles | default y svip |
Anuncio de lanzamiento de APIYI (2026-11-20) |
| Endpoints de acceso | Gemini nativo + compatible con OpenAI | Anuncio de lanzamiento de APIYI; no se probó en la práctica antes del lanzamiento |
| Ventana de contexto | 1M, compartida entre entrada, razonamiento y salida | Tanto el anuncio de Google como Artificial Analysis la indican como 1M |
| Límite de generación síncrona | aproximadamente 64K tokens | Documentación de lanzamiento de APIYI |
| Niveles de razonamiento | low/medium/high/xhigh, high por defecto | Anuncio de lanzamiento de APIYI |
| Precio de lista (por millón de tokens) | entrada $3, salida $15, lectura de caché $0.15 | Registro de APIYI; el anuncio afirma que coincide punto por punto con el sitio web oficial y que no tiene fecha de vencimiento |
Relación entre la ventana de contexto y el límite de salida de Gemini 4 Neon
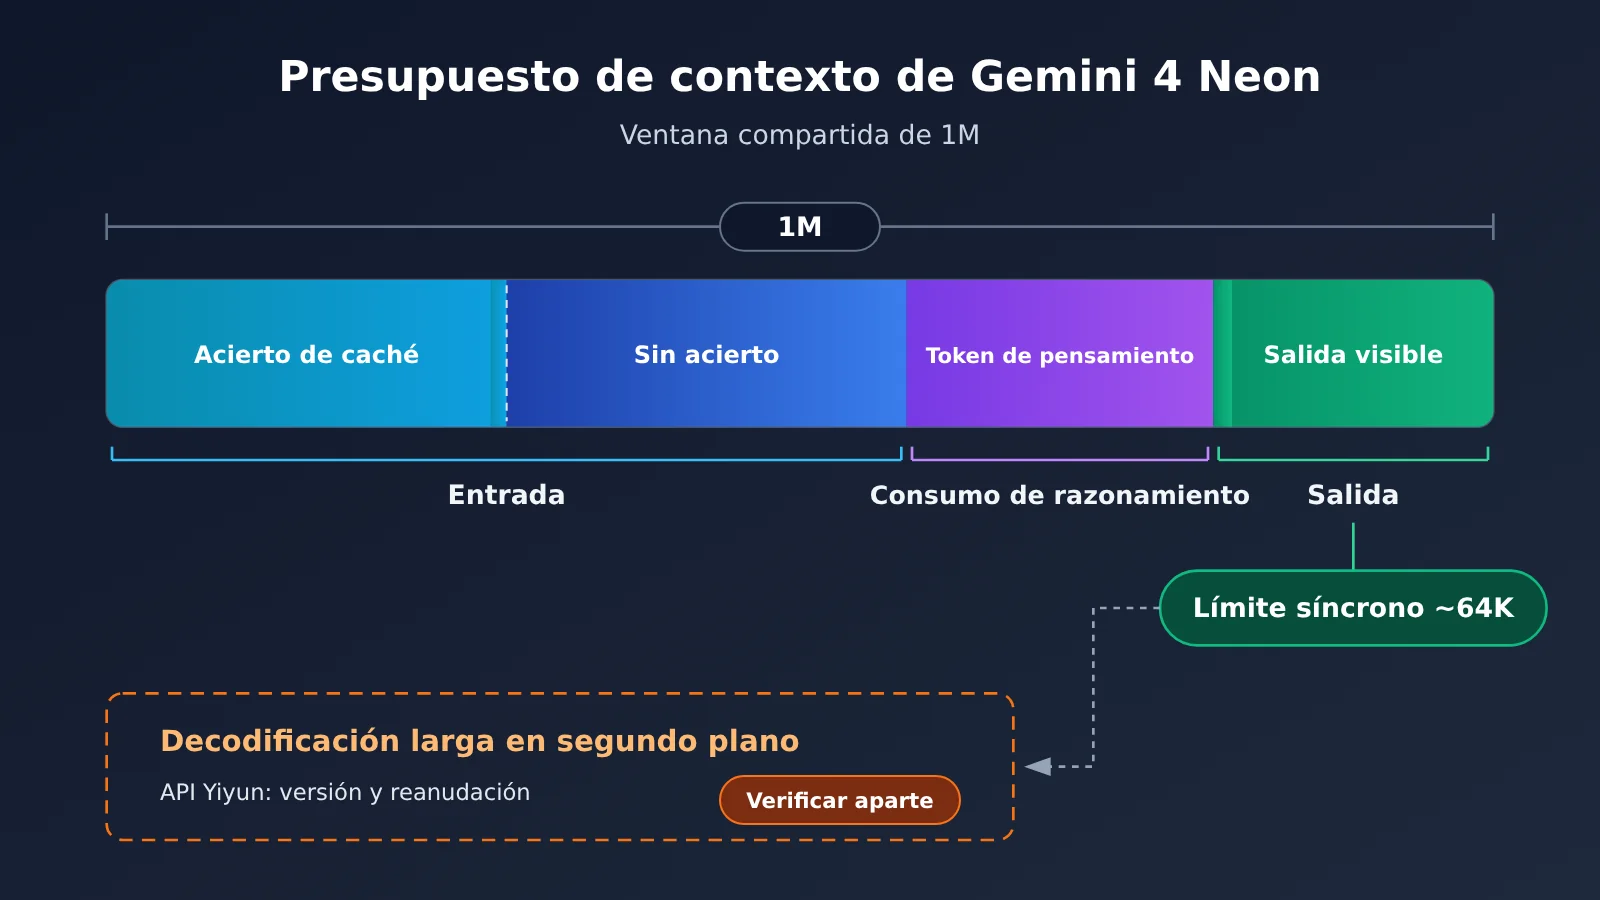
A menudo se malinterpreta que una ventana de contexto de 1M significa “poder generar 1M de salida de una vez”. En realidad, ese 1M es una ventana compartida por entrada, razonamiento y salida. Según la documentación de lanzamiento de APIYI, el límite de generación en llamadas síncronas es de aproximadamente 64K tokens; es decir, las entradas largas no son un problema, pero no esperes que una sola solicitud síncrona produzca más que ese orden de magnitud.
La documentación de Google Cloud menciona una capacidad de decodificación larga en segundo plano que puede llegar hasta 1M. Sin embargo, depende de una versión específica de la interfaz en la nube y de condiciones de reanudación, y no es lo mismo que una llamada síncrona normal. Para el endpoint Chat Completions compatible con APIYI, por ahora no hay resultados reales de invocaciones de decodificación larga que se puedan verificar. Si el caso de uso requiere salidas extremadamente largas, se recomienda diseñar primero la generación por segmentos y luego validar la decodificación larga por separado.
Cómo estimar el precio de Gemini 4 Neon
El siguiente ejemplo se calcula con el precio de lista y no representa una factura real. Supongamos una solicitud con 100K tokens de entrada y 5K tokens de salida visible: el costo de entrada sería de aproximadamente $0.30, el de salida de aproximadamente $0.075, y el total de aproximadamente $0.375. Si 80K de la entrada acierta en la caché, esa parte se factura a $0.15 y suma unos $0.012; los 20K restantes, a $3, suman unos $0.06, con lo que el costo de entrada baja de forma notable.
La forma en que se contabilizan los tokens que consume el razonamiento y las condiciones en las que se aplica la caché deben confirmarse con la factura real. El anuncio de lanzamiento de APIYI también menciona que, a partir del 1 de diciembre, tras vencer el precio por tiempo limitado de Carbon/Argon, este volverá a $4/$20; en ese momento, el precio de lista de Neon será un 25% inferior al de ellos. Se trata de una comparación de precios incluida en el anuncio de la plataforma; no implica una comparación de resultados.
Inicio rápido de Gemini 4 Neon: dos solicitudes mínimas, nativa y compatible
Se recomienda enviar una solicitud mínima por cada una de las dos rutas y confirmar que el ID del modelo, el grupo y el enrutamiento son correctos antes de añadir otras funcionalidades. Los ejemplos siguientes se construyen según la documentación oficial del SDK Google GenAI y del SDK OpenAI; la clave se usa siempre como marcador de posición.
| Elemento de comparación | Endpoint nativo de Gemini | Endpoint compatible con OpenAI |
|---|---|---|
| SDK recomendado | Google GenAI SDK | OpenAI SDK |
| Cómo se escribe la Base URL | Dirección raíz de la plataforma, con api_version="v1beta" aparte |
Dirección raíz con /v1 |
| Estructura de la solicitud | contents[].parts[] |
messages[] |
| Nivel de razonamiento | generationConfig.thinkingConfig.thinkingLevel |
El mapeo de parámetros entre endpoints requiere validación por separado |
| Escenarios adecuados | Control fino del razonamiento y llamadas a herramientas en múltiples turnos | Migración rápida de código OpenAI existente |
Ejemplo de endpoint nativo de Gemini 4 Neon
El endpoint nativo usa la dirección raíz de la plataforma; el prefijo de versión lo gestiona el SDK mediante api_version. No vuelvas a escribir v1beta en la Base URL, porque se concatenaría en una ruta duplicada.
from google import genai
from google.genai import types

client = genai.Client(
    api_key="YOUR_API_KEY",
    http_options=types.HttpOptions(
        base_url="https://api.apiyi.com",  # Dirección raíz de la plataforma APIYI; la versión la especifica api_version
        api_version="v1beta",
    ),
)

resp = client.models.generate_content(
    model="gemini-4-neon",
    contents="用三句话解释什么是上下文窗口",
    config=types.GenerateContentConfig(
        thinking_config=types.ThinkingConfig(thinking_level="medium")
    ),
)
print(resp.text)
La nomenclatura snake_case del SDK termina correspondiendo a los campos camelCase del cuerpo de la solicitud REST. Si envías la solicitud HTTP directamente, la estructura del cuerpo es aproximadamente la siguiente; presta atención a los dos niveles:
{
  "contents": [
    { "role": "user", "parts": [ { "text": "用三句话解释什么是上下文窗口" } ] }
  ],
  "generationConfig": {
    "thinkingConfig": { "thinkingLevel": "medium" }
  }
}
Hay dos puntos a tener en cuenta. Primero, el antiguo thinkingBudget y el nivel minimal no aplican a Gemini 4; al migrar código, elimínalos. Segundo, la documentación de Google indica que Gemini 4 ignora temperature y topP; que ajustar estos dos parámetros no produzca ningún efecto visible es el comportamiento esperado.
Ejemplo de endpoint compatible con Gemini 4 Neon
El endpoint compatible es ideal para proyectos que ya usan el SDK de OpenAI. A continuación usamos solo lo más básico de messages, para confirmar primero que el enrutamiento y el grupo funcionan.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1",  # Entrada compatible con OpenAI de APIYI
)

resp = client.chat.completions.create(
    model="gemini-4-neon",
    messages=[{"role": "user", "content": "用三句话解释什么是上下文窗口"}],
)
print(resp.choices[0].message.content)
print(resp.choices[0].finish_reason)
En la respuesta, además del cuerpo del texto, conviene registrar también finish_reason. Cuando el cuerpo está vacío, es la primera pista. En el endpoint nativo, lo equivalente son los campos de motivo de finalización y clasificación de seguridad dentro de los resultados candidatos, y también hay que conservarlos al depurar.
Ver el código envolvente con información de diagnóstico
import os
import time
import random
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url=os.environ["APIYI_BASE_URL"],  # Rellena aquí la dirección del endpoint compatible indicada arriba
)

def ask_neon(prompt: str, max_retries: int = 3) -> str:
    """Llama a gemini-4-neon e imprime el motivo de finalización y el uso, para facilitar el diagnóstico"""
    for attempt in range(max_retries + 1):
        try:
            resp = client.chat.completions.create(
                model="gemini-4-neon",
                messages=[{"role": "user", "content": prompt}],
            )
            choice = resp.choices[0]
            print("finish_reason:", choice.finish_reason)
            print("usage:", resp.usage)
            if not choice.message.content:
                print("正文为空:检查结束原因、安全状态与输出预算")
            return choice.message.content or ""
        except APIStatusError as e:
            print("status:", e.status_code, "body:", e.response.text)
            # Reintentar solo en caso de límite de tasa o indisponibilidad temporal; el resto de errores se lanza directamente
            if e.status_code in (429, 503) and attempt < max_retries:
                delay = (2 ** attempt) + random.uniform(0, 1)
                time.sleep(delay)
                continue
            raise
    return ""

if __name__ == "__main__":
    print(ask_neon("列出三个适合用长上下文的任务"))
🚀 Inicio rápido: Cuando crees un token en la consola de APIYI en apiyi.com, confirma que el grupo del token pertenece a
defaultosvip. Los usuarios nuevos pueden usar primero la cuota gratuita de prueba para ejecutar una vez cada una de las dos solicitudes mínimas anteriores. Nativo y compatible comparten la misma Key, así que al cambiar de endpoint solo hay que ajustar la Base URL y la estructura de la solicitud.
Cómo elegir el nivel de razonamiento de Gemini 4 Neon
Cuanto más alto el nivel, más exhaustivo es el razonamiento, pero también aumentan el tiempo empleado y el costo. Artificial Analysis (AA) realizó pruebas independientes de los cuatro niveles de Neon en el Intelligence Index v5.0.1, con los siguientes resultados.
| Nivel de razonamiento | Índice de inteligencia AA | Tiempo medio por tarea | Descripción |
|---|---|---|---|
low |
44 | aprox. 3.7 minutos | Prioriza la velocidad |
medium |
55 | aprox. 8.3 minutos | 11 puntos más que low |
high (predeterminado) |
60 | aprox. 14.8 minutos | 5 puntos más que medium |
xhigh |
61 | aprox. 21.5 minutos | costo ponderado de aprox. $6.44 por tarea de evaluación |
A la vista de estos datos, pasar de medium a high sigue suponiendo una mejora notable, mientras que de high a xhigh solo se gana 1 punto de índice, a cambio de aprox. 6.7 minutos más por tarea de media. Estas cifras provienen de la cadena de evaluación de AA, y el costo de la tarea se calcula según los pesos de las nueve pruebas. El tiempo empleado y la factura en escenarios como la lectura de documentos o las preguntas y respuestas interactivas tienes que medirlos por tu cuenta, y la latencia de extremo a extremo, la tasa de éxito y la factura real de APIYI también deben probarse por separado.
Así puedes decidir el nivel: para tareas de pregunta y respuesta sensibles a la latencia, empieza con low o medium; cuando necesites razonamiento de varios pasos, mantén el high predeterminado; y solo cuando confirmes en tu propio conjunto de pruebas fijo que xhigh aporta una mejora significativa, paga el tiempo y el costo adicionales que implica.
Gemini 4 Neon frente a modelos de su misma gama
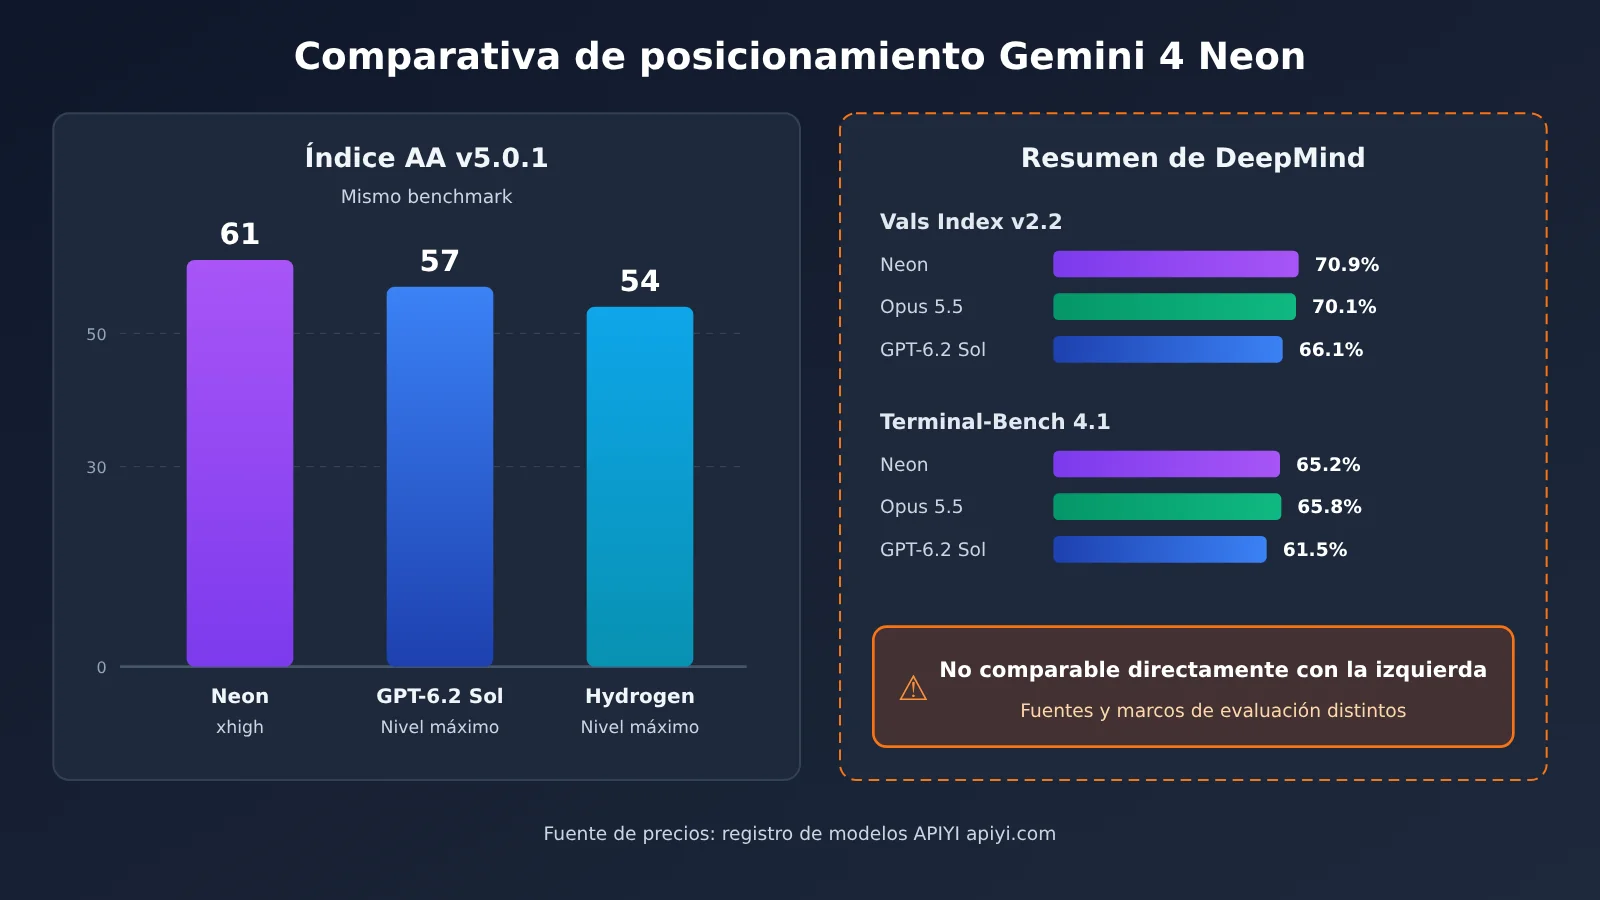
Para comparar modelos conviene usar el mismo benchmark y niveles equiparables. Las dos primeras columnas de la tabla siguiente proceden de la misma versión de AA, y los precios vienen del registro de APIYI.
| Modelo | Índice AA v5.0.1 (nivel más alto) | Entrada/salida estándar (por millón de tokens) | Plataformas disponibles |
|---|---|---|---|
| Gemini 4 Neon | 61 (xhigh) | $3/$15 | APIYI apiyi.com, entre otras |
| GPT-6.2 Sol | 57 | $2/$10 | APIYI, entre otras |
| Gemini 4 Hydrogen | 54 | Según el registro | APIYI, entre otras |
GPT-6.2 Sol tiene un precio de lista más bajo: tanto la entrada como la salida son un tercio más baratas que las de Neon. Pero, bajo el mismo benchmark de AA, la puntuación de Neon en xhigh supera en 4 puntos al nivel más alto de Sol. Conviene tener en cuenta que la diferencia de puntuación no se traduce directamente en una diferencia de precisión en el negocio real; también hay que medir por separado la latencia y el consumo real de tokens de ambos.
Otra referencia es el resumen de evaluaciones publicado por Google DeepMind: en Vals Index v2.2, Neon obtiene 70.9 %, Claude Opus 5.5 el 70.1 % y GPT-6.2 Sol el 66.1 %; en Terminal-Bench 4.1, la precisión ajustada es, por este orden, 65.2 %, 65.8 % y 61.5 %. Ese resumen utiliza explícitamente distintas fuentes de evaluación y frameworks de ejecución, y en Terminal-Bench Opus 5.5 queda incluso un poco por encima de Neon. Sirve como referencia de orientación, pero la elección debería basarse en el mismo lote de tareas ejecutadas sobre tu propia cadena de herramientas.
💡 Recomendación de elección: conviene preparar entre 20 y 50 tareas de prueba fijas que representen el negocio real y, en APIYI apiyi.com, invocar con la misma clave los distintos niveles de Neon y los modelos candidatos, registrando la precisión, el tiempo de ejecución y la factura antes de tomar una decisión.
Solución de errores comunes de integración con Gemini 4 Neon
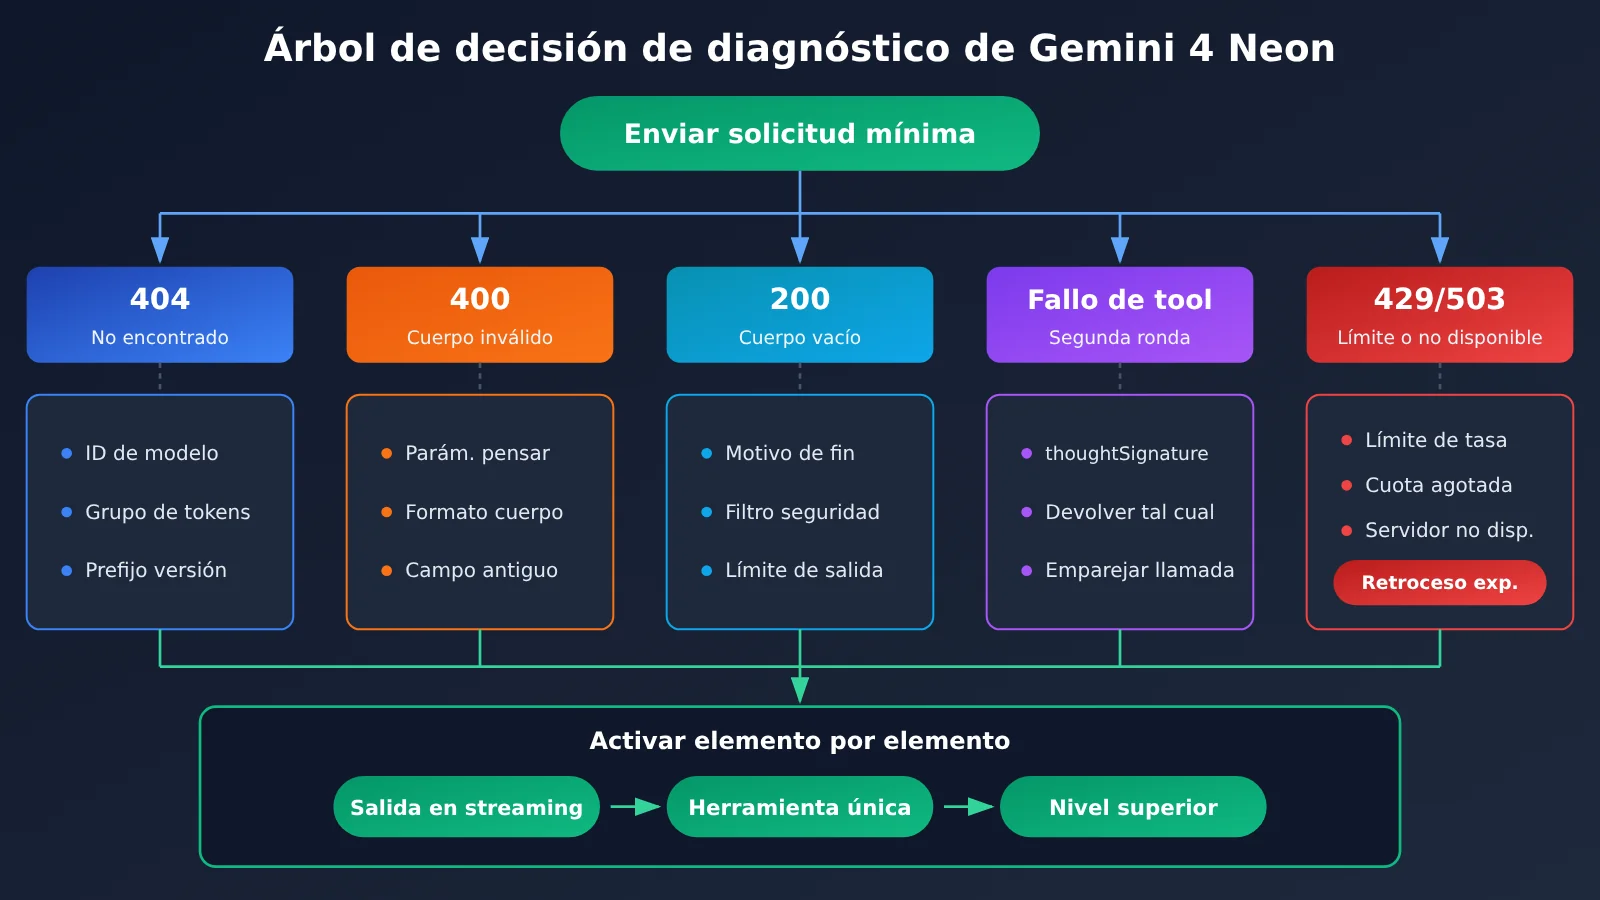
Cuando aparece un problema, primero vuelve a la petición más corta mencionada arriba para comparar, confirma que la ruta básica funciona y luego revisa punto por punto las funcionalidades nuevas.
| Síntoma | Qué revisar primero | Cómo solucionarlo |
|---|---|---|
| 404 / modelo no disponible | ID del modelo, grupo del token, enrutamiento, prefijo de versión | Copia gemini-4-neon tal cual; con el SDK de OpenAI usa el endpoint compatible con /v1, con el SDK GenAI usa la dirección raíz más v1beta; evita concatenar el prefijo de versión dos veces |
| 400 / comportamiento distinto tras cambiar de nivel | Parámetros nativos de razonamiento, campos del cuerpo de la petición compatible | En el endpoint nativo, usa thinkingLevel para confirmar si el nivel está activo; elimina thinkingBudget y minimal; no mezcles campos de los dos protocolos |
| 200 pero cuerpo vacío | Motivo de finalización, estado de seguridad, presupuesto de salida | Confirma que el presupuesto de salida alcanza para el razonamiento y la salida visible a la vez; revisa la información del filtro de seguridad |
| Falla la segunda ronda de llamadas a herramientas | thoughtSignature, emparejamiento de llamadas a herramientas y respuestas |
Devuelve la firma de razonamiento tal cual y asegúrate de que cada respuesta de herramienta corresponda a la llamada correcta |
| 429 / 503 temporal del upstream | Cuerpo del error, límite del token, restricciones de concurrencia | Cuando haya limitación temporal o indisponibilidad, usa retroceso exponencial con jitter y un número limitado de intentos; si es un problema de saldo o permisos, corrige la configuración antes de reenviar |
Distinguir entre 404 y 400 en Gemini 4 Neon
Un 404 normalmente indica que la solicitud no se enrutó hasta este modelo, es decir, el problema está en «no encontrarlo»: ID mal escrito, agrupación de tokens que no incluye ese modelo, o una URL construida con rutas duplicadas como /v1/v1/... o /v1beta/v1beta/.... Un 400, en cambio, indica que la solicitud sí llegó, pero que el cuerpo no cumple el protocolo; lo más habitual es haber metido campos nativos en una solicitud compatible o seguir usando parámetros antiguos de la época de Gemini 2.x.
La asignación de parámetros entre distintos puntos de conexión requiere una verificación aparte. Si intentas controlar la intensidad de razonamiento en el punto de conexión compatible y no obtienes el resultado esperado, primero vuelve al punto de conexión nativo para confirmar si el nivel realmente surte efecto; después decide si el problema es de parámetros o de asignación.
Cuerpo vacío y fallos de invocación de herramientas en Gemini 4 Neon
Cuando receives HTTP 200 pero no obtienes texto en el cuerpo, lo primero que debes mirar es el motivo de finalización. Si se truncó por longitud, significa que el proceso de razonamiento ya consumió el presupuesto de salida y no quedó espacio para el texto visible; si fue por motivos de seguridad, tendrás que ajustar el contenido de entrada. Los niveles de razonamiento altos tienden más a provocar el primer caso.
Los fallos en invocaciones de herramientas de múltiples turnos casi siempre están relacionados con thoughtSignature. Según la documentación de Thought signatures de Google, la firma devuelta por el modelo debe enviarse de vuelta tal cual en los turnos siguientes, siguiendo el protocolo original, y cada invocación de herramienta debe tener una respuesta de herramienta correspondiente uno a uno. Para depurar, puedes empezar quitando las herramientas y usando la solicitud sin herramientas más corta como control, para luego ir añadiéndolas poco a poco.
Orden recomendado de verificación para Gemini 4 Neon
Una vez que la solicitud mínima funcione, se recomienda habilitar las funcionalidades una por una en el siguiente orden, confirmando el resultado de cada paso por separado:
- Una solicitud de solo texto, sin streaming, sin herramientas y con el nivel predeterminado, para confirmar que el ID, el grupo y el enrutamiento funcionan correctamente.
- Activar la salida en streaming y confirmar que el ensamblado de fragmentos y la lectura del motivo de finalización son correctos.
- Añadir una sola herramienta y completar las dos rondas de «llamada → devolución del resultado → respuesta final», comprobando si se conserva
thoughtSignature. - En el endpoint nativo, alternar entre
low,mediumyxhigh, y comparar con un conjunto de pruebas fijo la calidad, el tiempo de ejecución y la facturación. - Por último, añadir optimizaciones relacionadas con el costo, como entradas largas y reutilización de caché.
Preguntas frecuentes (FAQ)
Q1: ¿Qué es Gemini 4 Neon?
Gemini 4 Neon es el modelo de gama media de Gemini 4 que Google lanzó el 18 de noviembre de 2026 y llevó a disponibilidad general (GA) ese mismo día. Se posiciona entre Carbon y Hydrogen. Ofrece 1M de contexto compartido y cuatro niveles de intensidad de razonamiento; su ID de modelo es `gemini-4-neon`.
Q2: ¿Cómo elegir entre Gemini 4 Neon y GPT-6.2 Sol?
Según el mismo benchmark AA Intelligence Index v5.0.1, Neon en `xhigh` obtiene 61 puntos, mientras que el nivel más alto de Sol obtiene 57 puntos. Sin embargo, el precio de lista de Sol es $2/$10, inferior al $3/$15 de Neon. Una diferencia de puntuación no equivale a una diferencia de precisión en el negocio; te recomendamos comparar en tu propio conjunto de pruebas los resultados, la latencia y el consumo real de tokens antes de decidir.
Q3: ¿Cuándo se puede usar Gemini 4 Neon en APIYI?
APIYI lanzó este modelo el 20 de noviembre de 2026 y abrió los grupos `default` y `svip`. Según el anuncio de lanzamiento, el precio estándar no tiene fecha de caducidad.
Q4: ¿En qué escenarios encaja Gemini 4 Neon?
– **Análisis de documentos extensos**: la ventana de 1M permite incluir una gran cantidad de material de una vez, pero el límite de salida sincrónica por solicitud es de aproximadamente 64K.
– **Razonamiento de varios pasos y tareas de agente**: el nivel `high` predeterminado equilibra calidad y tiempo de ejecución; para la invocación de herramientas se recomienda usar el endpoint nativo.
– **Procesamiento por lotes con costos controlables**: usar `low`/`medium` junto con reutilización de caché para reducir el costo por solicitud.
Q5: ¿Cómo llamar rápidamente a Gemini 4 Neon a través de la API?
1. Regístrate en APIYI (apiyi.com) y reclama crédito de prueba gratuito.
2. Crea un token perteneciente al grupo `default` o `svip`.
3. Si ya tienes código de OpenAI, usa el endpoint compatible; si necesitas controlar el nivel de razonamiento, usa el SDK Google GenAI para conectarte al endpoint nativo.
En ambos casos, te recomendamos ejecutar primero la solicitud mínima de este artículo y, una vez confirmado que la cadena de llamadas funciona correctamente, añadir funcionalidades.
Q6: ¿Qué limitaciones conocidas tiene Gemini 4 Neon?
– **Límite de salida**: 1M es una ventana compartida; el límite de generación sincrónica es de aproximadamente 64K. La decodificación larga depende de interfaces específicas de la nube y de condiciones de reanudación.
– **Cambios de parámetros**: `thinkingBudget` y `minimal` ya no se aplican; `temperature` y `topP` se ignoran.
– **Estado de verificación**: antes del lanzamiento en APIYI solo se comprobó la interfaz de precios; se recomienda validar primero ambos endpoints y la invocación de herramientas con tus propias solicitudes en APIYI apiyi.com.
Puntos clave de Gemini 4 Neon
- Identidad del modelo:
gemini-4-neon, gama media de Gemini 4, lanzado por Google el 18 de noviembre. - Límites de especificaciones: 1M de contexto compartido, límite de generación sincronizada de ~64K; las decodificaciones largas requieren verificación aparte.
- Precios de facturación: $3 por millón de tokens de entrada, $15 de salida, $0.15 de lectura de caché; lo que realmente se cobra depende de la factura.
- Elección de nivel: en las pruebas AA, pasar de
highaxhighsolo suma 1 punto, y aumenta el tiempo por tarea en unos 6.7 minutos. - Selección de endpoint: para controlar el nivel de razonamiento usa el endpoint nativo; para reutilizar código existente usa el endpoint compatible.
- Orden de diagnóstico: parte de la solicitud más pequeña y activa progresivamente streaming, herramientas y niveles superiores.
Resumen
Los puntos clave para integrar Gemini 4 Neon se resumen en tres:
- Verifica primero las especificaciones: 1M es una ventana compartida, la salida sincronizada ronda los 64K, el precio es $3/$15 y la lectura de caché $0.15.
- Prueba ambos endpoints por separado: el endpoint nativo usa la dirección raíz más
v1beta, el compatible usa una dirección con/v1; no mezcles los campos. - Elige el nivel con datos: los puntajes AA son solo una referencia; al final manda el rendimiento, el tiempo y la factura en tu propio conjunto de pruebas fijo.
Después de confirmar el método de integración, se recomienda usar la misma clave en APIYI apiyi.com para comparar los distintos niveles de Neon con otros modelos candidatos, y luego decidir la configuración predeterminada del entorno de producción.
📚 Referencias
-
Novedades del lanzamiento de APIYI Gemini 4 Neon: grupos, endpoints, precios y límite de salida
- Enlace:
docs.apiyi.com/live/2026-11/gemini-4-neon-launch - Descripción: publicado el 2026-11-20, incluye los cuatro niveles de razonamiento y la información del nivel predeterminado
- Enlace:
-
Anuncio de lanzamiento de Google Gemini 4 Neon: información oficial del lanzamiento
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon/ - Descripción: publicado el 2026-11-18, incluye la ventana de contexto y la descripción de posicionamiento
- Enlace:
-
Página del modelo Artificial Analysis Gemini 4 Neon: evaluaciones independientes de los cuatro niveles
- Enlace:
artificialanalysis.ai/models/gemini-4-neon - Descripción: puntuaciones y tiempos del Intelligence Index v5.0.1, métricas actualizadas dinámicamente
- Enlace:
-
Solución de problemas de Google Gemini API y firmas de pensamiento: documentación de diagnóstico y firmas de razonamiento
- Enlace:
aistudio.google.com/docs/troubleshooting,aistudio.google.com/docs/thought-signatures - Descripción: significado de los códigos de error y reglas de retorno de firmas en llamadas a herramientas de múltiples turnos
- Enlace:
-
Gemini 4 Neon Model Evaluation: recopilación de evaluaciones de DeepMind
- Enlace:
storage.googleapis.com/deepmind-media/gemini/gemini_4_neon_model_evaluation.pdf - Descripción: resultados de evaluación de múltiples fuentes y frameworks; al citar, es necesario indicar la configuración
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: si encuentras problemas durante la integración, no dudes en contactarnos a través del sitio web oficial de APIYI. Para más documentación sobre la interfaz, consulta el centro de documentación en docs.apiyi.com