Nota del autor: comparamos los precios de lista escalonados de entrada de GPT-6.2 Sol y 6.1 Sol en APIYI, usamos un ejemplo con un documento largo de 300.000 tokens para mostrar la diferencia en el costo de entrada al superar el umbral y damos una lista de verificación para revisar la factura.
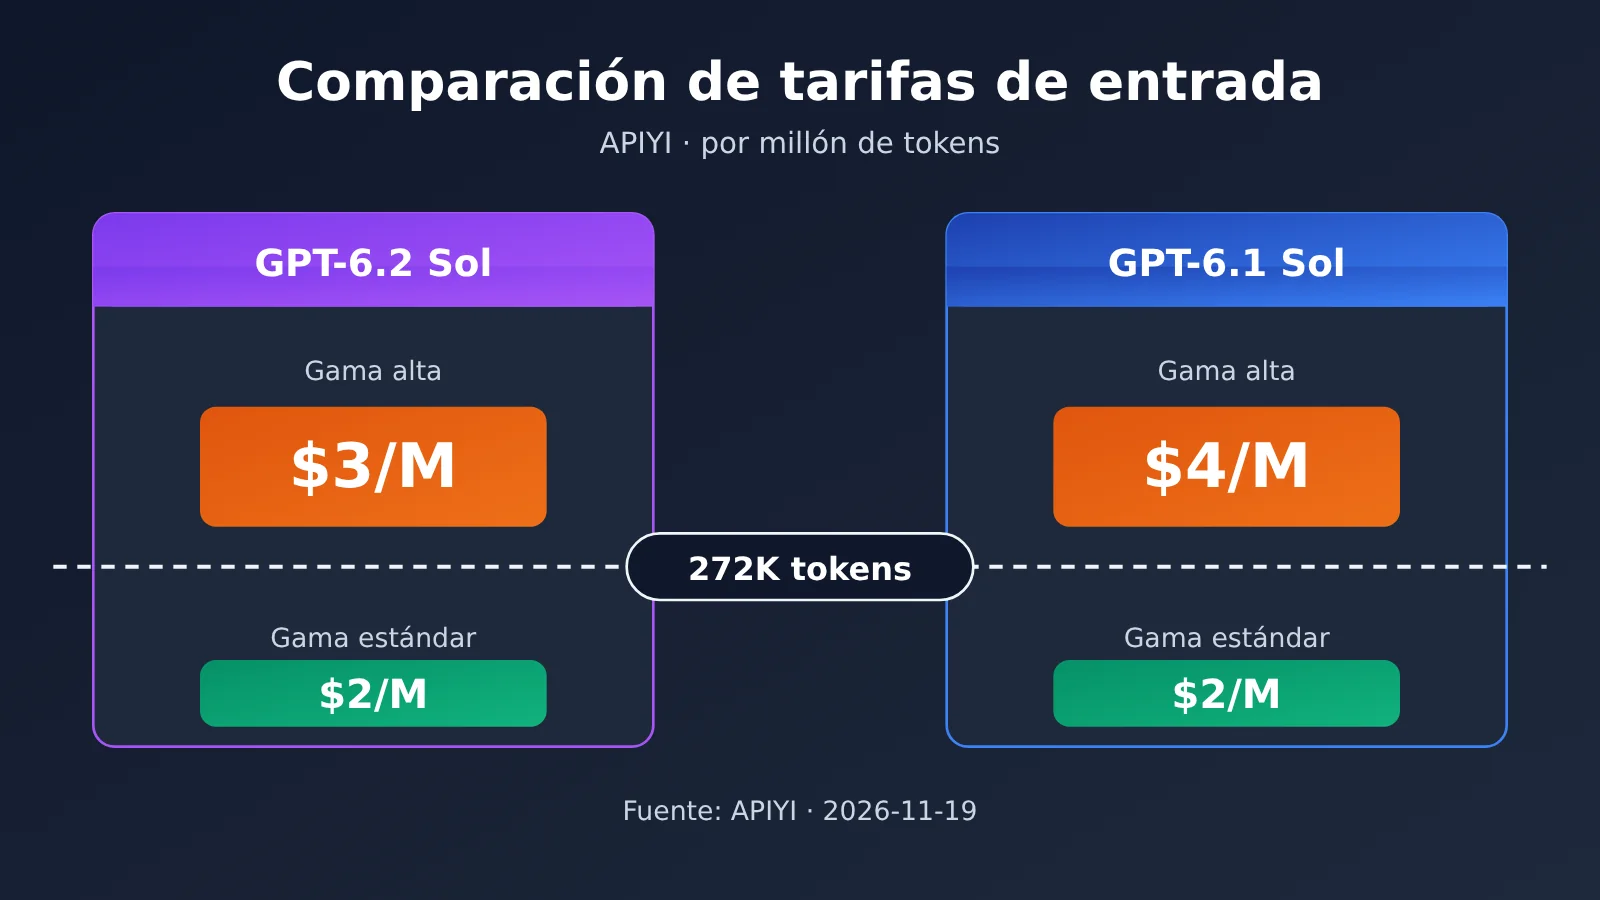
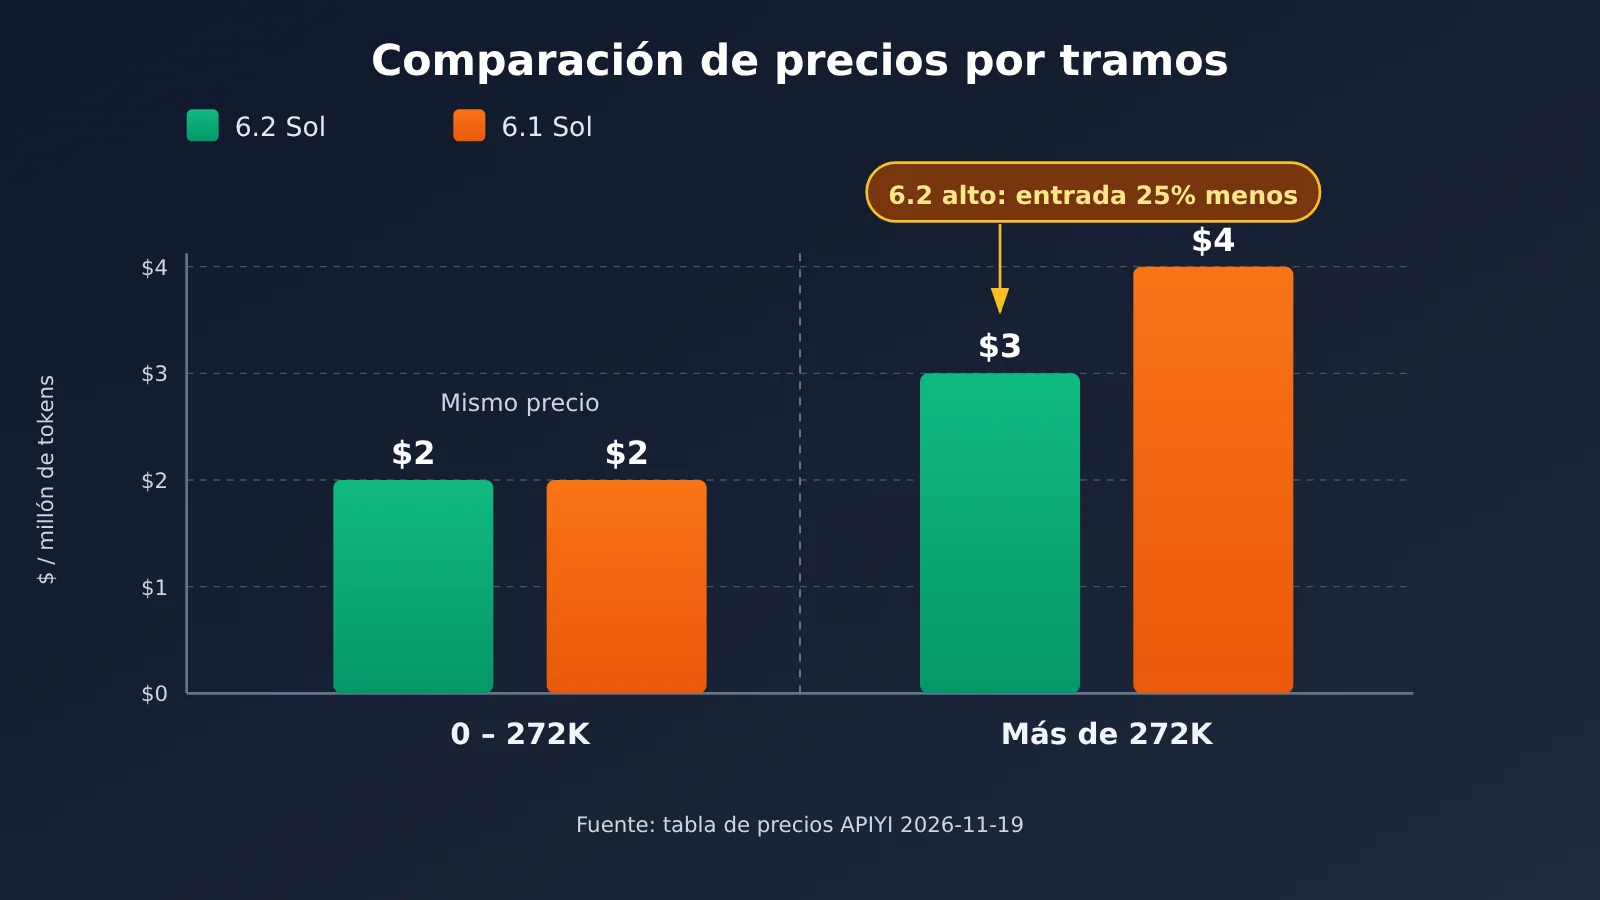
Antes de nada, la conclusión: cuando una entrada individual no supera los 272.000 tokens, GPT-6.2 Sol y 6.1 Sol tienen el mismo precio de lista de entrada en APIYI: $2 por millón de tokens; elegir uno u otro no ahorra nada en esta tarifa. La diferencia aparece solo en el tramo superior, por encima de 272.000 tokens. En la tabla general de precios de APIYI, las tarifas de entrada del tramo superior son $3 para GPT-6.2 Sol y $4 para GPT-6.1 Sol (por millón de tokens); el precio de lista del tramo superior de GPT-6.2 Sol es 25% más bajo.
Esto no es una factura real medida. Todas las cifras de este artículo provienen de la tabla general de precios de modelos de APIYI (apiyi.com), consultada el 19 de noviembre de 2026. El ejemplo de 300.000 tokens solo ilustra el costo de entrada calculado bajo supuestos de facturación concretos; no representa el costo total de una factura y no incluye los costos de salida ni de caché.
Valor clave: después de leer este artículo, podrás determinar si tus tareas con documentos largos entrarán en el tramo superior, calcular la diferencia de costo de entrada entre GPT-6.2 Sol y 6.1 Sol, y saber qué partidas de la factura revisar antes de poner el servicio en producción.
Diferencias clave entre GPT-6.2 Sol y GPT-6.1 Sol: precios de entrada escalonados
Ambos modelos usan precios escalonados en APIYI, con un punto de corte en 272,000 tokens. La siguiente tabla compara, lado a lado, el precio de entrada dentro y fuera de ese umbral. Los datos provienen de la sección de precios escalonados de la tabla general de precios de modelos de APIYI; fecha de consulta: 2026-11-19.
| Intervalo de entrada | Precio de entrada de gpt-6.2-sol | Precio de entrada de gpt-6.1-sol | Diferencia | Fuente de datos |
|---|---|---|---|---|
| 0 – 272,000 tokens | $2 / millón de tokens | $2 / millón de tokens | Igual | Tabla general de precios de APIYI apiyi.com |
| Más de 272,000 tokens | $3 / millón de tokens | $4 / millón de tokens | 6.2 es 25% más bajo | Tabla general de precios de APIYI |
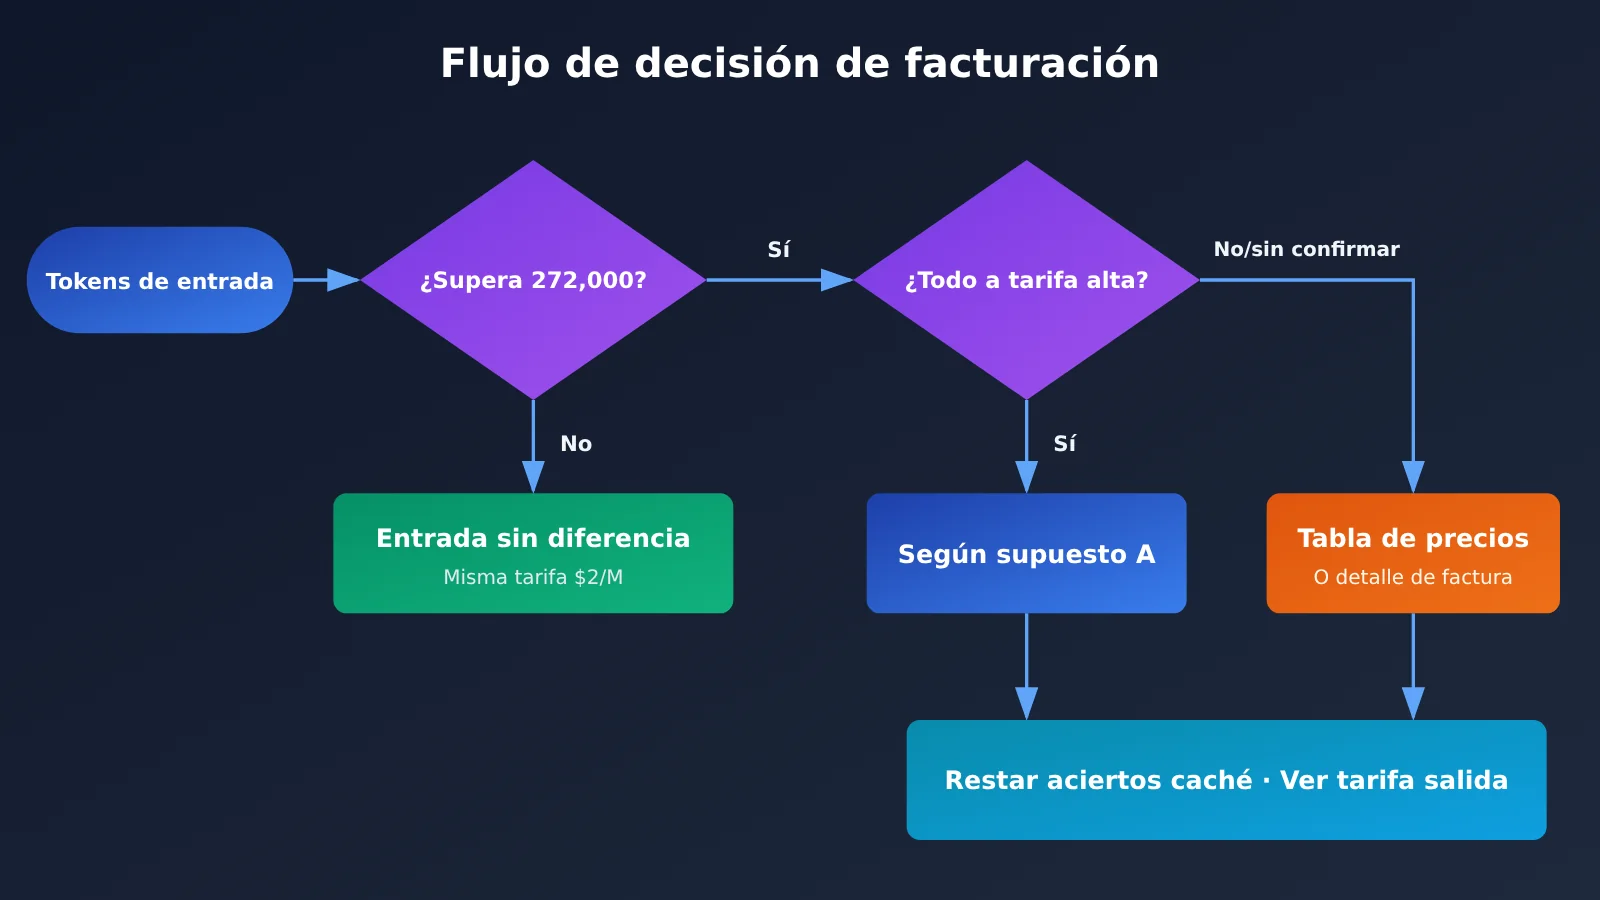
Ten en cuenta que esta tabla solo cubre las tarifas de entrada. La tabla general pública de APIYI no confirma con esta información que todos los grupos apliquen la tarifa alta al total del pedido, ni ofrece en esta nota las tarifas altas de salida y caché. Por eso, “la entrada de 6.2 Sol en el tramo alto cuesta 25% menos” no implica directamente “el pedido completo cuesta 25% menos”; para esto último, tendrás que revisar la factura real de tu grupo.
Además, la ficha oficial del modelo de OpenAI para gpt-6.2-sol también tiene su propia descripción de tramos. Las reglas oficiales del proveedor y los precios publicados por APIYI son dos criterios distintos; este artículo no los mezcla en un mismo cálculo. Todas las cifras corresponden a los precios de la plataforma APIYI; si quieres conocer las reglas del proveedor, consulta la ficha oficial del modelo por separado.
GPT-6.2 Sol frente a 6.1 Sol: ejemplo de cálculo del costo de entrada de 300,000 Token
Supón que la entrada de una solicitud es de 300,000 Token y que no hay ningún acierto de caché. Esto ya supera el umbral de 272,000; la clave está en cómo la plataforma aplica la tarifa alta a esta solicitud. La facturación por tramos suele tener dos criterios; la siguiente tabla muestra los resultados de cada uno.
| Supuesto de facturación | Costo de entrada de gpt-6.2-sol | Costo de entrada de gpt-6.1-sol | Diferencia | Estado |
|---|---|---|---|---|
| A: aplicar la tarifa alta a toda la entrada | 0.3 × $3 = $0.90 | 0.3 × $4 = $1.20 | $0.30 | Algoritmo ilustrativo según la referencia; requiere confirmar el enrutamiento |
| B: aplicar la tarifa alta solo al excedente | 0.272 × $2 + 0.028 × $3 = $0.628 | 0.272 × $2 + 0.028 × $4 = $0.656 | $0.028 | Deducción puramente matemática; no confirmada por la plataforma |
Si el enrutamiento de APIYI que usas confirma que aplica la tarifa alta a toda la entrada, entonces la diferencia para una sola solicitud de 300,000 Token sin caché es de $0.30. El supuesto B solo sirve para mostrar que “con criterios distintos, la diferencia puede variar en un orden de magnitud”; no es una regla publicada por la plataforma. Antes de hacer un presupuesto, confirma a qué criterio pertenece tu grupo; eso importa más que cualquier ejemplo de cálculo.
Tres distinciones en el presupuesto de documentos largos: Token, caracteres y factura
Muchas desviaciones de presupuesto no vienen de la tarifa, sino de confundir conceptos. Estos tres pares de conceptos deben verse por separado al presupuestar documentos largos con GPT-6.2 Sol o 6.1 Sol.
| Concepto que se confunde fácilmente | Interpretación correcta | Impacto en el presupuesto |
|---|---|---|
| Caracteres vs Token | La facturación se hace por Token; no hay una proporción fija entre caracteres y Token, varía según el idioma y el contenido | No se puede usar directamente “300 mil caracteres” con el ejemplo de 300,000 Token |
| Token del documento vs Token de entrada por solicitud | La entrada de una sola solicitud también incluye la indicación del sistema, el historial de conversación, definiciones de herramientas, etc. | Aunque el documento por sí solo no alcance el umbral, al sumar el contexto puede superar 272,000 |
| Costo de entrada teórico vs factura real | El valor teórico se calcula multiplicando el precio de lista por la cantidad de Token; la factura real también se ve afectada por los aciertos de caché, el criterio del grupo y el costo de salida | El ejemplo de cálculo solo sirve como referencia de límite superior; la factura detallada es la referencia final |
La forma más fiable es leer directamente el campo usage que devuelve la API y usar el prompt_tokens real para determinar si se supera el umbral, en lugar de estimar por número de caracteres.
Cómo estimar el costo de entrada de documentos largos para GPT-6.2 Sol y 6.1 Sol
Ejemplo mínimo: leer la cantidad real de tokens de entrada
Primero envía una solicitud para obtener la cantidad de tokens de entrada que consume este documento largo en la llamada real:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz unificada de APIYI
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)
print("prompt_tokens:", resp.usage.prompt_tokens)
Ver el código de implementación completo: estimar el costo de entrada según dos supuestos de facturación
import openai

# Instantánea de precios: tabla general de precios de APIYI, consulta del 2026-11-19, unidad: USD por millón de tokens
# Solo incluye la tarifa de entrada; las tarifas de salida y de caché deben consultarse en la tabla de precios y la facturación de la plataforma
PRICES = {
    "gpt-6.2-sol": {"low": 2.0, "high": 3.0},
    "gpt-6.1-sol": {"low": 2.0, "high": 4.0},
}
THRESHOLD = 272_000

def estimate_input_cost(model: str, input_tokens: int, cached_tokens: int = 0,
                        mode: str = "full") -> float:
    """
    Estima el costo teórico de entrada de la parte no cacheada.
    mode="full":     al superar el umbral, aplica la tarifa alta a todo el consumo (confirma si tu grupo funciona así)
    mode="marginal": aplica la tarifa alta solo a la parte que supera el umbral (supuesto de cálculo, no confirmado por la plataforma)
    cached_tokens solo se descuenta del cálculo; el costo de la parte cacheada debe comprobarse por separado
    """
    p = PRICES[model]
    uncached = max(input_tokens - cached_tokens, 0)
    if input_tokens <= THRESHOLD:
        return uncached / 1e6 * p["low"]
    if mode == "full":
        return uncached / 1e6 * p["high"]
    low_part = min(uncached, THRESHOLD)
    high_part = max(uncached - THRESHOLD, 0)
    return low_part / 1e6 * p["low"] + high_part / 1e6 * p["high"]

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

doc = open("long_doc.txt", encoding="utf-8").read()
resp = client.chat.completions.create(
    model="gpt-6.2-sol",
    messages=[{"role": "user", "content": "请总结以下文档:\n" + doc}]
)

usage = resp.usage
cached = 0
details = getattr(usage, "prompt_tokens_details", None)
if details is not None and getattr(details, "cached_tokens", None):
    cached = details.cached_tokens

for m in PRICES:
    for mode in ("full", "marginal"):
        cost = estimate_input_cost(m, usage.prompt_tokens, cached, mode)
        print(f"{m} [{mode}] 未缓存输入费估算: ${cost:.4f}")
Si sustituyes input_tokens=300_000 y cached_tokens=0, el modo full dará $0.90 y $1.20, lo que coincide con el ejemplo de cálculo A anterior. Los precios del script son una instantánea del día de la consulta; cuando la plataforma ajuste sus precios, habrá que actualizarlos también.
🚀 Inicio rápido: te recomendamos procesar primero un documento largo real en APIYI apiyi.com con el crédito de prueba gratuito para nuevos usuarios, obtener
prompt_tokensjunto con el detalle de la factura y, a partir de ahí, definir el presupuesto. Esto es mucho más fiable que estimar únicamente por cantidad de caracteres.
Recomendaciones de escenarios: GPT-6.2 Sol frente a GPT-6.1 Sol
La siguiente tabla ofrece recomendaciones únicamente desde la perspectiva de la tarifa de entrada; no entra en diferencias de calidad ni de velocidad del modelo, porque esos dos factores tienes que probarlos tú con tus tareas reales.
| Tu escenario de documentos largos | Conclusión desde la tarifa de entrada | Acción recomendada |
|---|---|---|
| Entrada única estable por debajo de 272,000 tokens | Ambos cuestan $2 por millón de tokens, así que esta tarifa no marca diferencias | Elige según el rendimiento y otros conceptos de coste; no esperes ahorrar en la tarifa de entrada |
| Entrada única que supera a menudo los 272,000 tokens | La entrada de tramo alto de 6.2 Sol cuesta un 25% menos | Tras confirmar el criterio de facturación por grupo, evalúa primero 6.2 Sol |
| Entrada que oscila cerca del umbral | La diferencia depende de la proporción de solicitudes que superan el umbral | Analiza la distribución de prompt_tokens durante un periodo antes de decidir |
| Un mismo documento se consulta una y otra vez | Los aciertos de caché alteran la factura real | Revisa por separado la tarifa de la parte en caché; no extrapoles con cálculos sin caché |
Situaciones típicas para elegir GPT-6.2 Sol
- Contratos, informes financieros, repositorios de código y otros materiales ultralargos que hay que meter de una vez en el contexto, con entradas que superan a menudo los 272,000 tokens.
- Cuando el grueso del presupuesto se lo lleva la tarifa de entrada de tramo alto y ya tienes confirmado el criterio de facturación de tu grupo.
Situaciones típicas para seguir con GPT-6.1 Sol
- Cuando la entrada de tus tareas se mantiene por debajo del umbral de forma sostenida, esta tarifa es igual que la de 6.2 Sol y cambiar no aporta ningún ahorro en la tarifa de entrada.
- Cuando tu flujo actual ya funciona de forma estable con 6.1 Sol y necesitas evaluar antes las diferencias de rendimiento para migrar.
Recomendaciones de decisión y lista de verificación de facturación: GPT-6.2 Sol frente a GPT-6.1 Sol
La lógica de decisión se puede resumir en una frase: si no superas el umbral, esta tarifa no te ayuda a ahorrar; si lo superas, tienes que revisar al mismo tiempo el grupo de facturación, la caché y la salida. Antes de poner en producción tareas de documentos largos, conviene repasar punto por punto la lista siguiente.
| Punto a verificar | Pregunta que hay que confirmar | Cómo verificarlo |
|---|---|---|
| Tokens de entrada por llamada | ¿De verdad supera los 272,000? ¿Incluye el prompt del sistema y el historial? | Leer usage.prompt_tokens en la respuesta |
| Criterio de facturación por grupos | Al superar el umbral, ¿se aplica el tramo alto a todo el consumo o existe otra regla? | Consultar la explicación de precios escalonados en la tabla general de precios de APIYI y, si hace falta, preguntar a la plataforma |
| Aciertos de caché | ¿Cuántos tokens de entrada aciertan en caché y cómo se factura esa parte? | Revisar el campo cached_tokens y el detalle de la factura |
| Coste de salida | ¿La salida también tiene tramos? ¿Cuál es la tarifa? | Guiarse por la tabla de precios de la plataforma; este artículo no cita precios de salida sin verificar |
| Vigencia de los precios | La instantánea de este artículo es del 2026-11-19, ¿ya han cambiado los precios? | Volver a consultar la tabla general de precios antes de llamar |
| Consistencia de criterios | ¿Se están mezclando los tramos oficiales del proveedor con los precios de la plataforma? | Anotar por separado las reglas del proveedor y usar un solo criterio para el presupuesto |
💡 Consejo de elección: Si tus tareas de documentos largos superan el umbral con frecuencia, te sugiero que en APIYI apiyi.com uses el mismo documento para llamar por separado a gpt-6.2-sol y gpt-6.1-sol, compares el detalle de facturación de ambas llamadas y luego decidas si conviene migrar. Con la misma clave API puedes cambiar de modelo, lo que facilita este tipo de comparación.
Preguntas frecuentes (FAQ)
P1: GPT-6.2 Sol frente a 6.1 Sol, ¿dónde está exactamente la diferencia en el precio de entrada?
Solo hay diferencia en el tramo alto. Según la tabla general de precios de APIYI, para entradas de 0–272.000 tokens ambos cuestan $2 por millón de tokens; por encima de 272.000, 6.2 Sol cuesta $3 y 6.1 Sol cuesta $4, por lo que 6.2 Sol cuesta un 25% menos.
P2: ¿Un documento de 300.000 caracteres equivale a 300.000 tokens?
No. La cantidad de caracteres y los tokens no tienen una proporción de conversión fija, y además una entrada individual también incluye la indicación del sistema y el historial de conversación. Usa los `prompt_tokens` que devuelve la API para determinar si se supera el umbral.
P3: ¿Usar 6.2 Sol para una entrada de 300.000 tokens siempre permite ahorrar $0,30?
No necesariamente. Los $0,30 son una estimación del costo de entrada calculada suponiendo que toda la entrada se cobra al tramo alto y que no hay ningún acierto de caché. Si el criterio de agrupación de precios es diferente o hay aciertos de caché, la diferencia cambiará, y esto no incluye el costo de salida.
P4: ¿Se puede afirmar que 6.2 Sol es 25% más barato que 6.1 Sol en el total de la factura?
No. El 25% es solo la diferencia en el precio de lista del tramo alto de entrada. La tabla pública de APIYI no confirma con base en ello las reglas de facturación del total para todos los grupos, ni ofrece tarifas de tramo alto para la salida y la caché; la diferencia en el total debe consultarse en la factura real.
P5: ¿Cómo verificar rápidamente en APIYI el costo de tus documentos largos?
1. Regístrate en APIYI (apiyi.com) y obtén una clave API; los nuevos usuarios reciben crédito de prueba gratuito.
2. Con el código de este artículo, configura `base_url` como `https://api.apiyi.com/v1` y envía un documento largo real.
3. Anota `prompt_tokens` y `cached_tokens`, y compáralos con el detalle de facturación de la plataforma.
P6: ¿Qué limitaciones tienen los datos de este artículo?
Las cifras de este artículo provienen únicamente de la tabla general de precios de la plataforma consultada el 2026-11-19; no son facturas medidas en pruebas reales y no abarcan precios de salida, calidad del modelo ni velocidad. Las reglas de tramos de la ficha oficial del modelo del fabricante y los precios de lista de la plataforma responden a criterios distintos; este artículo no las combina. Si los precios cambian, toma como referencia la tabla de precios más reciente.
GPT-6.2 Sol frente a 6.1 Sol: puntos clave
- Mismo precio dentro del umbral: hasta 272,000 tokens, el precio de lista de entrada de ambos es $2 por millón de tokens.
- Diferencia en el tramo superior: por encima del umbral, 6.2 Sol cuesta $3 y 6.1 Sol cuesta $4; el primero es 25% más barato.
- El ejemplo tiene condiciones: si todos los tokens se facturan al tramo superior y no hay caché, la diferencia en el costo de entrada para 300,000 tokens es $0.30.
- Los tokens no equivalen al número de caracteres: usa
prompt_tokenspara determinar si se superó el umbral. - La teoría no equivale a la factura: la caché, los criterios de agrupación y las tarifas de salida modifican el gasto real.
- Primero prueba, luego define el presupuesto: haz una prueba con documentos reales en APIYI apiyi.com, compara con la factura y después decide.
Resumen
Los puntos clave de GPT-6.2 Sol frente a 6.1 Sol en el costo de entrada de documentos largos:
- Sin diferencias dentro del umbral: cuando la entrada no supera 272,000 tokens, cambiar de modelo no ahorra este costo.
- Por encima del umbral, fíjate en la tarifa del tramo superior: el precio de lista de entrada de 6.2 Sol en el tramo superior es 25% menor que el de 6.1 Sol; para 300,000 tokens, si todos se facturan al tramo superior y sin caché, la diferencia es $0.30.
- El presupuesto se basa en la factura: revisa también los criterios de agrupación, los aciertos de caché y las tarifas de salida; el ejemplo solo ilustra el costo de entrada.
Si tu negocio realmente trabaja con frecuencia con documentos muy largos, te recomendamos comparar en APIYI apiyi.com los detalles de facturación de ambos modelos mediante solicitudes reales y, con esa base, definir la selección de modelo y el presupuesto mensual.
📚 Referencias
-
Tabla general de precios de modelos de APIYI: explicación de precios escalonados
- Enlace:
docs.apiyi.com/models - Nota: fuente de todos los precios de entrada citados en este artículo, fecha de consulta 2026-11-19; vuelva a confirmar antes de realizar la llamada
- Enlace:
-
Ficha oficial del modelo de OpenAI – gpt-6.2-sol: descripción de las categorías oficiales del fabricante
- Enlace:
developers.openai.com/api/docs/models/gpt-6.2-sol - Nota: las reglas del fabricante y los precios de la plataforma responden a criterios distintos; utilícelas solo como referencia independiente y no las mezcle con las cifras de este artículo
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: Puede contactarnos desde la página de inicio del sitio oficial de APIYI; para más información sobre facturación e integración, visite el centro de documentación en docs.apiyi.com