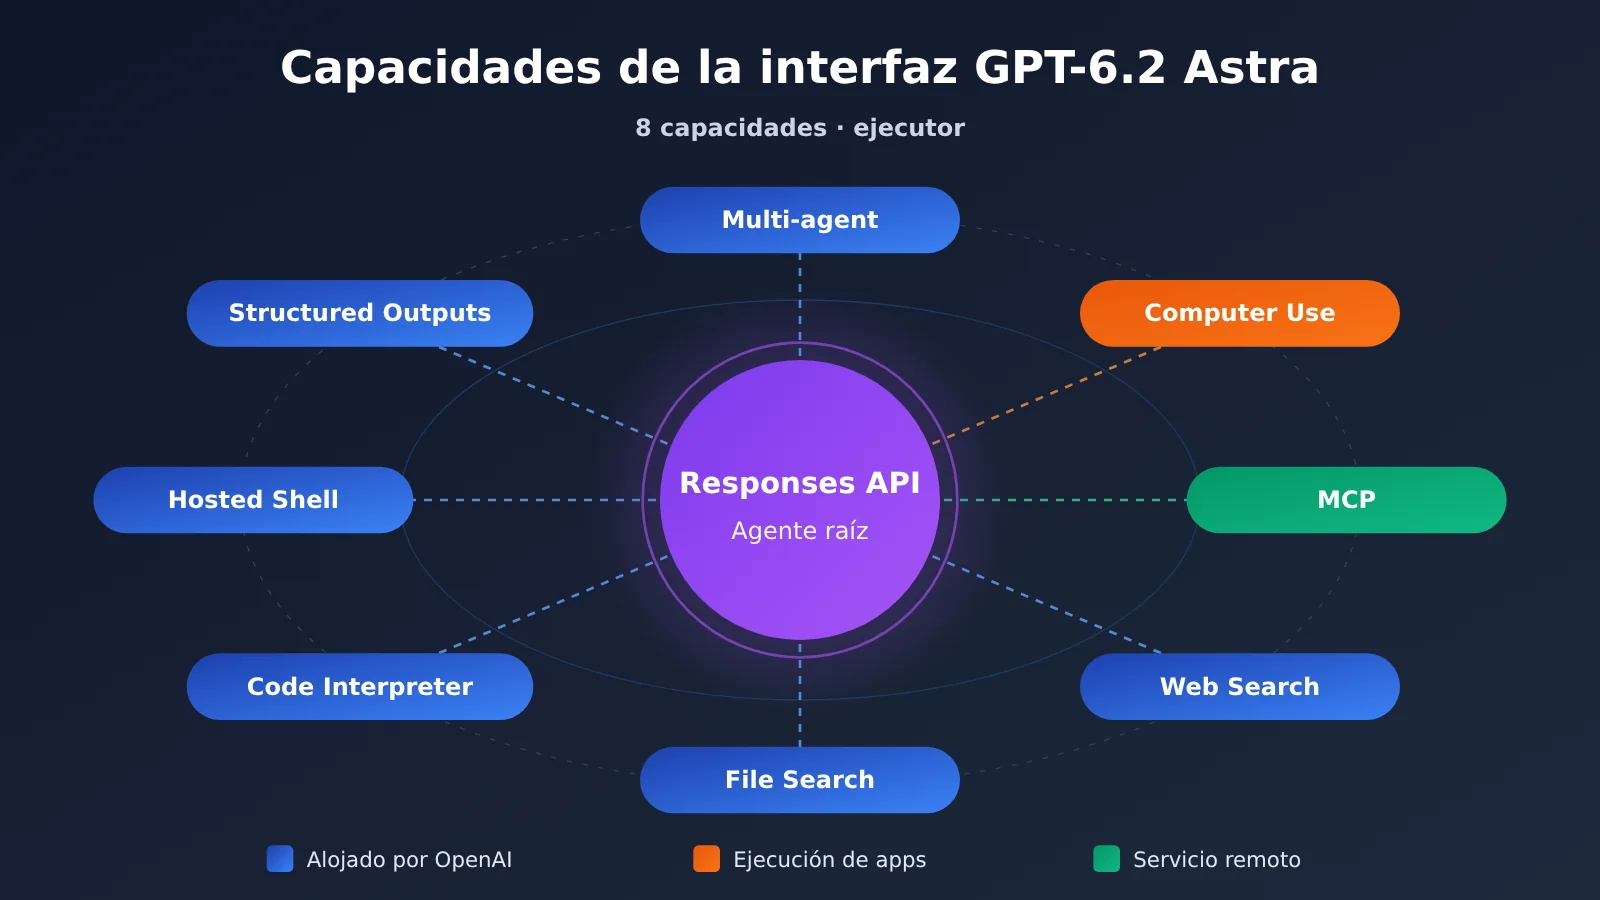
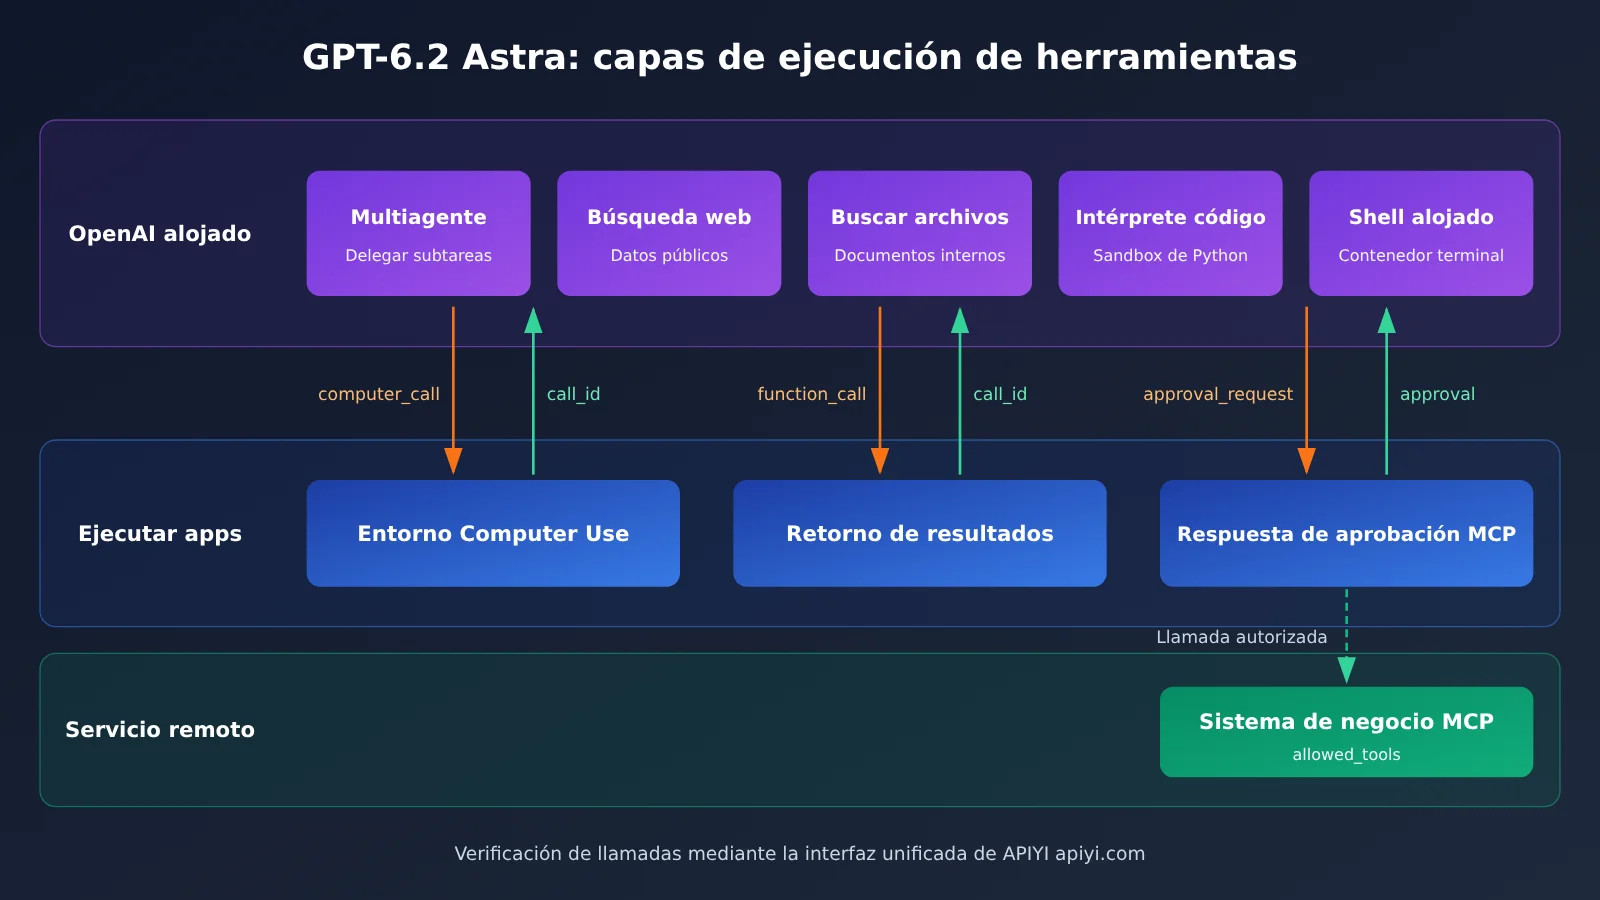
Respuesta directa: GPT-6.2 Astra en Responses API puede delegar subtareas en paralelo (Multi-agent), puede operar navegador o interfaz de escritorio mediante capturas de pantalla (Computer Use), y también puede conectarse a servicios MCP remotos para invocar herramientas de negocio del equipo. Ahora bien, el ejecutor de estas tres capacidades es distinto en cada caso: la delegación la aloja la API, el entorno de ejecución de la operación de interfaz lo proporciona tu aplicación, y el objeto de la llamada MCP es el servicio remoto que tú configuras.
Conclusión central: La dificultad de ingeniería está principalmente en la orquestación, no en la capacidad del modelo en sí. Un agente de negocio que realmente se pueda poner en producción necesita dejar claras tres cosas de antemano: quién ejecuta cada herramienta, hasta dónde llega la autorización de datos y quién valida el resultado final.
¿Qué puedes aprender leyendo este artículo?
- Las 6 categorías de herramientas integradas y Structured Outputs que GPT-6.2 Astra admite en Responses API, junto con el ejecutor y los requisitos de uso de cada una;
- Cómo habilitar el beta de Multi-agent, el número predeterminado de concurrencia, y qué tareas convienen en paralelo y cuáles deben ejecutarse en secuencia;
- La diferencia entre las dos rutas de ejecución de Computer Use y MCP remoto, incluyendo aprobación, alcance de permisos y división de responsabilidades;
- Cómo encadenar recuperación, cálculo y salida estructurada para entregar un resultado de verificación de compras que se pueda validar.
Índice: El cuerpo del artículo primero resume la identidad del modelo, las especificaciones y el precio que OpenAI publicó el 17 de noviembre. Luego usa una tabla para comparar el ejecutor de 8 capacidades y, siguiendo el ejemplo de diseño de «verificación de compras de solo lectura», explica en orden los límites de paralelismo de Multi-agent, las rutas de ejecución de Computer Use y MCP, y la forma de traspaso desde la recuperación hasta la salida estructurada. La sección de análisis al final responderá: qué deberían hacer primero los desarrolladores y responsables de producto ahora.
GPT-6.2 Astra To Know: explicación de conceptos
| Concepto | Explicación breve |
|---|---|
| Responses API | Interfaz de OpenAI para las respuestas del modelo y la invocación de herramientas; tanto las herramientas integradas como Multi-agent que se analizan en este artículo se basan en ella. |
| Multi-agent | Funcionalidad beta que permite habilitar varios agentes colaborativos dentro de una solicitud de Responses compatible. |
| Subagente | Unidad de trabajo que procesa tareas delegadas en un contexto independiente y, al finalizar, informa al agente raíz. |
| Computer Use | Capacidad del modelo para localizar elementos de la interfaz a partir de capturas de pantalla y solicitar acciones en el navegador o el escritorio. |
| MCP | Protocolo que define cómo los clientes de modelo descubren e invocan herramientas de servicios externos. |
| Web Search | Herramienta que busca información en la web pública y puede devolver las fuentes citadas en la respuesta. |
| File Search | Herramienta que busca archivos cargados previamente en un almacén vectorial específico. |
| Code Interpreter | Entorno aislado gestionado que ejecuta Python para analizar datos y generar archivos. |
| Hosted Shell | Entorno aislado alojado por OpenAI en el que se pueden ejecutar comandos de terminal. |
| Structured Outputs | Capacidad de salida que restringe el formato de la respuesta mediante JSON Schema. |
| ID de invocación de herramienta | Identificador que vincula una solicitud de invocación con el resultado de su ejecución, como call_id. |
GPT-6.2 Astra: panorama de impacto
- Ingenieros de agentes de negocio: en una sola solicitud ya se pueden combinar delegación, recuperación, herramientas remotas y salidas estructuradas, así que el código de orquestación se reduce. Pero el retorno de resultados de funciones, el entorno de ejecución de Computer Use y la aprobación de MCP siguen teniendo que implementarse del lado de la aplicación.
- Responsables de producto: eso de que «el agente puede operar el sistema por su cuenta» ahora cuenta con respaldo en interfaces oficiales. El alcance de permisos, la confirmación de escrituras y la responsabilidad de la revisión humana deben quedar escritos en el flujo desde la fase de diseño del producto.
- Equipos sensibles al costo: el precio unitario oficial bajó un poco respecto a la generación anterior. Sin embargo, el paralelismo multiagente puede disparar el consumo de tokens, así que conviene recalcular el presupuesto según la estructura de las tareas.
GPT-6.2 Astra en datos objetivos: lanzamiento, especificaciones y lista de herramientas
Lanzamiento e identidad del modelo GPT-6.2 Astra
OpenAI lanzó el 17 de noviembre de 2026 tanto GPT-6.2 Astra como GPT-6.2 Sol. La compañía posiciona oficialmente a Astra como un modelo orientado a razonamiento complejo, programación y trabajo profesional, con ID de modelo API gpt-6.2-astra, y su predecesor es GPT-6 Astra (gpt-6-astra). El registro de cambios de la API documentó ese mismo día tanto el lanzamiento del modelo como entradas relacionadas con la ventana de finalización en segundo plano.
Las especificaciones que enumera la ficha del modelo son: ventana de contexto de 1 050 000 tokens, entrada máxima de 922 000 tokens y salida máxima de 128 000 tokens. El modelo acepta entrada de texto e imágenes, produce salida de texto y es compatible tanto con la API Responses como con la API Chat Completions. Conviene prestar especial atención a un detalle: la ficha indica que las solicitudes en las que reasoning.effort está configurado como none serán rechazadas, así que hay que revisar este parámetro al migrar código antiguo.
En cuanto al precio, la tarifa unitaria estándar publicada por OpenAI para texto puro con contexto corto, calculada por millón de tokens, es: entrada normal $8, entrada con acierto de caché $0.40 y salida $40. Frente a la generación anterior, la compañía anunció oficialmente una reducción del 20% en el precio unitario de entrada normal y de salida, y una reducción del 60% en el precio de entrada con acierto de caché. Estas cifras solo sirven para estimaciones sobre la API oficial directa; el costo por pregunta que se emplea en evaluaciones de terceros responde a otra base de precios y no admite comparación directa.
🚀 Inicio rápido: si quieres validar primero cómo se comporta GPT-6.2 Astra con los datos de tu propio negocio, puedes lanzar una invocación compatible con OpenAI a través de APIYI apiyi.com usando una sola clave API. Los usuarios nuevos disponen de crédito de prueba gratuito, ideal para hacer una validación a pequeña escala antes de la integración definitiva. La disponibilidad de las herramientas beta dependerá del soporte real que ofrezca la plataforma.
Tabla general de capacidades de la interfaz de GPT-6.2 Astra
La model card enumera Web Search, File Search, Code Interpreter, Hosted Shell, Computer Use y MCP como las herramientas que Astra admite en la Responses API; Structured Outputs figura como capacidad de salida, y Multi-agent como funcionalidad beta de Responses. El desarrollador declara en la petición qué herramientas tiene disponibles, y el modelo decide según la tarea si lanza una invocación. En la respuesta pueden aparecer solicitudes de herramientas, solicitudes de aprobación, resultados de ejecución o texto final; qué elementos de salida debe gestionar el cliente depende de quién ejecuta cada herramienta.
| Capacidad | Ejecutor | Requisitos / configuración | Acciones adecuadas |
|---|---|---|---|
| Multi-agent | Delegación gestionada por Responses | Habilitar la beta de forma explícita | Procesar subtareas independientes en paralelo y consolidarlas |
| Computer Use | Navegador o escritorio que aporta la aplicación | La aplicación asume el entorno y la sesión iniciada | Ver u operar interfaces que requieren interacción |
| MCP | OpenAI invoca el servicio remoto que configures | Dirección del servicio, autenticación, allowed_tools | Consultar sistemas de negocio o solicitar escrituras |
| Web Search | Gestionado por OpenAI | Basta declarar la herramienta | Consultar material público que cambia rápido |
| File Search | Gestionado por OpenAI | Subir e indexar previamente en un vector store | Buscar documentos internos por semántica y palabras clave |
| Code Interpreter | Contenedor Python gestionado por OpenAI | Gestionar la entrada y la recuperación de archivos | Conciliaciones, estadísticas, generar gráficos |
| Hosted Shell | Contenedor de terminal gestionado por OpenAI | Se puede configurar con container_auto | Flujos de línea de comandos en varios pasos y manejo de múltiples archivos |
| Structured Outputs | Restricción del formato de respuesta | Declarar JSON Schema en text.format | Producir datos de negocio verificables |
Cómo habilitar Multi-agent en GPT-6.2 Astra y su alcance compartido
Para habilitar Multi-agent, hay que configurar multi_agent.enabled en la solicitud a Responses. Si usas HTTP o WebSocket en crudo, además debes incluir la cabecera OpenAI-Beta: responses_multi_agent=v1; si usas el SDK, llama a la interfaz beta correspondiente. El agente raíz puede crear subagentes, comunicarse con ellos, esperar a que terminen y encargarse de la síntesis final.
Cada subagente tiene su propio contexto, pero comparte el modelo y las herramientas disponibles de esa solicitud. El valor predeterminado de max_concurrent_subagents es 3, y lo que limita es el número de turnos de subagentes activos al mismo tiempo en todo el árbol de agentes. La acción de delegación multi_agent_call la gestiona la API. Si un subagente llama a una función personalizada del desarrollador, la aplicación debe devolver el resultado de la ejecución según el ID de llamada correspondiente. La documentación oficial también advierte que la ejecución en paralelo encaja bien con tareas de investigación independientes entre sí, y que el consumo de tokens puede subir por ello; los pasos que dependen de resultados previos y las escrituras compartidas exigen que tú organices el orden de ejecución.
Los límites de ejecución de Computer Use y MCP en GPT-6.2 Astra
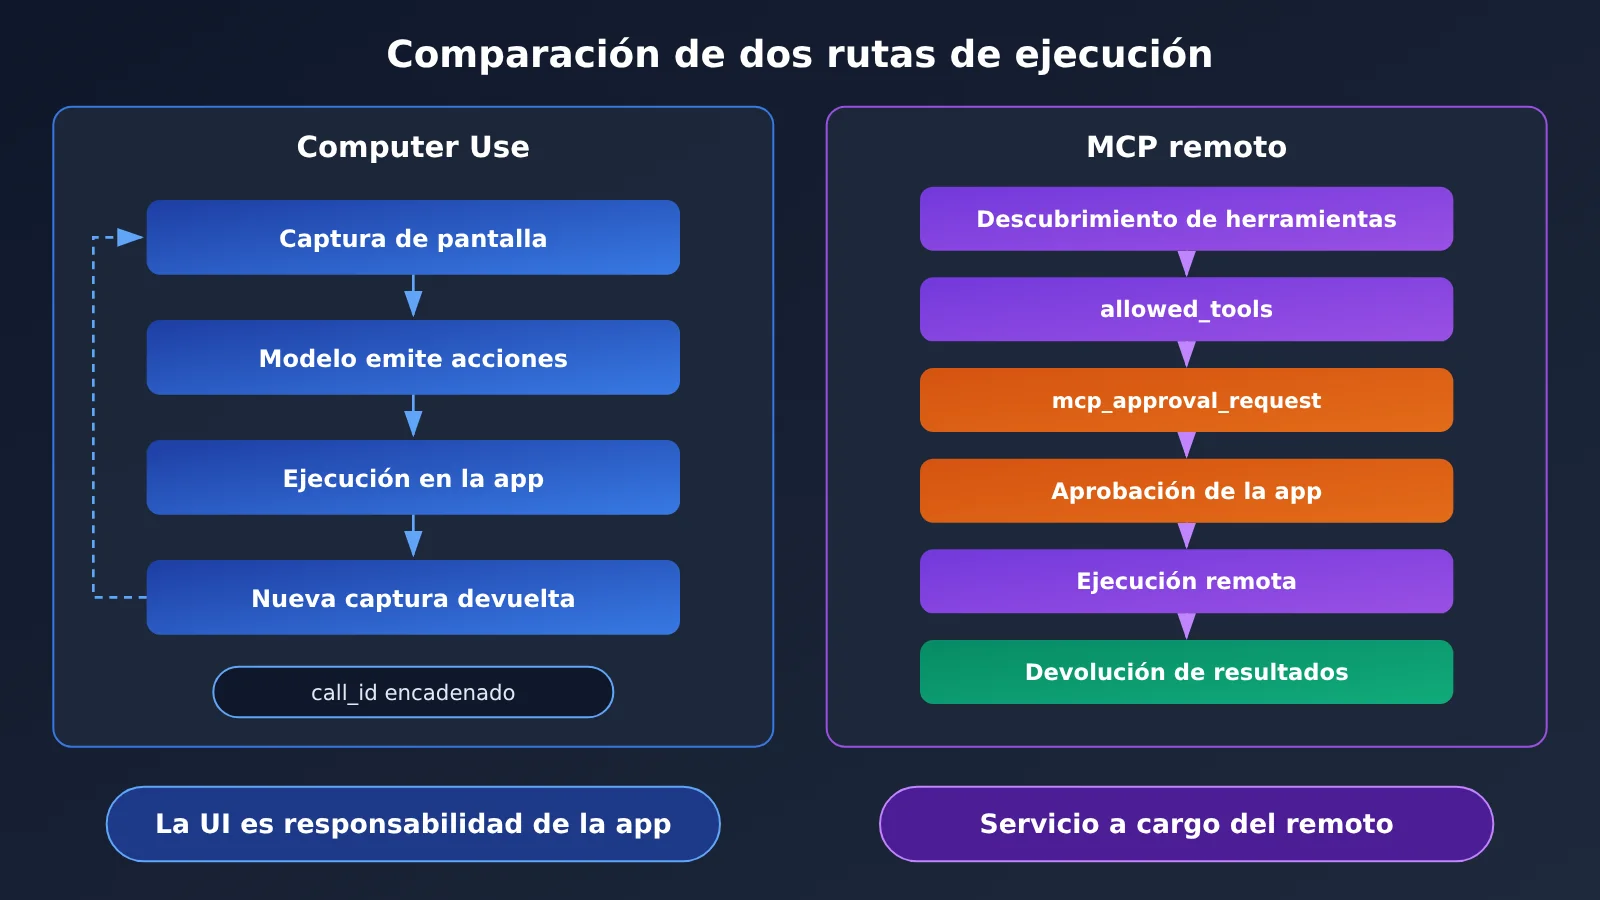
El entorno de ejecución de Computer Use lo proporciona la aplicación. Cuando usas la herramienta nativa computer, el modelo emite computer_call, tu entorno de ejecución realiza las acciones que contiene (clics, entrada de texto, etc.) y luego devuelve al modelo una nueva captura de pantalla mediante computer_call_output y el call_id correspondiente, y así en bucle hasta que la tarea termina. La guía oficial también plantea otra forma de conectarlo: hacer que el modelo genere un script y que la aplicación lo ejecute en un entorno aislado. En cualquiera de los dos casos, el entorno en sí, la sesión iniciada, las páginas accesibles y la confirmación antes de escrituras críticas son responsabilidad de la aplicación.
El MCP remoto funciona de otra manera. La API se conecta a la dirección de servicio que indiques, importa las herramientas que expone el servidor y ejecuta las llamadas autorizadas. La autenticación remota se configura según lo que pida el servicio, y allowed_tools permite limitar qué herramientas se importan. De forma predeterminada, antes de enviar datos a un conector o a un servicio remoto se solicita aprobación: la aplicación puede leer el nombre de la herramienta y los parámetros en mcp_approval_request y luego ir devolviendo mcp_approval_response llamada por llamada.
Reglas de búsqueda, cálculo y salida estructurada de GPT-6.2 Astra
Web Search apunta a la internet pública, y las aplicaciones pueden usar url_citation para vincular las conclusiones con sus fuentes. File Search busca, dentro de un almacén vectorial concreto, los archivos que ya se han subido, lo que encaja bien con material interno ya archivado. Code Interpreter ofrece un sandbox de Python y además puede generar archivos. Hosted Shell permite configurar una terminal en la nube mediante container_auto; la guía de Shell también explica cómo alojar el runtime por cuenta propia desde la aplicación. Los archivos de ambos entornos de cálculo hay que gestionarlos y recuperarlos de forma activa cuando se usan.
Structured Outputs declara un JSON Schema a través de text.format, y lo que restringe es la respuesta completada y no rechazada. La documentación oficial lo dice sin rodeos: quien recibe la respuesta todavía tiene que gestionar rechazos, respuestas incompletas, errores de API y reglas de negocio que el schema no puede expresar.
Análisis y criterio de GPT-6.2 Astra: encadenar todas las capacidades con una verificación de compras
El siguiente flujo es un ejemplo de diseño, deducido a partir de la combinación de capacidades descritas en los materiales de referencia; no es un caso oficial. En cada solicitud hay que configurar las herramientas según la situación real, y qué combinaciones puedes habilitar al final depende de tu cuenta, de la configuración de las herramientas y del entorno de ejecución.
Cuándo conviene paralelizar en GPT-6.2 Astra Multi-agent
El objetivo de la tarea es comprobar si coinciden tres elementos: las cláusulas de un contrato, los registros de pedidos del sistema de compras y la información pública en el sitio web del proveedor. Todo el proceso es de solo lectura. Estas tres consultas no dependen entre sí, así que encajan justo con el número de concurrencia predeterminado de 3: el grupo de contratos usa File Search para consultar las cláusulas, el grupo de compras consulta los pedidos mediante MCP de solo lectura y el grupo web usa Web Search para consultar información pública. El agente raíz espera a que los tres grupos reporten y luego consolida.
Para determinar si se puede paralelizar, hay un criterio: ¿la entrada de una subtarea necesita la salida de otra subtarea? Por ejemplo, “primero obtener el número de pedido y luego usar ese número para consultar la factura” debe ejecutarse en secuencia; forzar una división en paralelo solo hará que los subagentes hagan suposiciones por separado, y el resultado será más difícil de verificar. También hay que tener en cuenta que, aunque la acción de delegación la gestiona la API, si el subagente llama a una función definida por ti, el resultado de la función sigue teniendo que devolverse desde la aplicación mediante el ID de llamada. Si se omite este paso, todo el árbol de agentes se quedará en estado de espera.
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # Interfaz compatible con OpenAI de APIYI
)

# Código ilustrativo: para la estructura de parámetros, consulta la guía más reciente de OpenAI
resp = client.responses.create(
    model="gpt-6.2-astra",
    reasoning={"effort": "medium"},  # si se establece en none, se rechazará
    input="只读核验:合同 C-102 条款、订单 PO-881 记录、供应商官网公示信息是否一致",
    tools=[
        {"type": "file_search", "vector_store_ids": ["vs_contracts"]},
        {"type": "web_search"},
        {
            "type": "mcp",
            "server_label": "procurement",
            "server_url": "https://mcp.example.com/procurement",
            "allowed_tools": ["get_purchase_order"],  # exponer solo una herramienta de solo lectura
            "require_approval": "always",
        },
    ],
    extra_headers={"OpenAI-Beta": "responses_multi_agent=v1"},
    extra_body={"multi_agent": {"enabled": True, "max_concurrent_subagents": 3}},
)
💡 Recomendación de configuración: la delegación en paralelo aumenta el consumo de tokens; conviene medir primero el uso real de una verificación con una muestra pequeña y luego decidir el número de concurrencia. Con llamadas de pago por uso a través de APIYI (apiyi.com), puedes comparar rápidamente el costo entre distintas configuraciones de concurrencia.
División de responsabilidades entre GPT-6.2 Astra Computer Use y MCP
Supongamos que la fecha de validez de la certificación en el sitio web oficial del proveedor solo aparece después de abrir una ventana emergente de “certificado de cualificación”, y que Web Search no puede capturar ese campo. En ese caso, se necesita Computer Use. El flujo tiene tres pasos: la aplicación abre la página en un navegador aislado y toma una captura de pantalla; el modelo devuelve las coordenadas del clic o una instrucción de operación; y, tras ejecutarla, la aplicación devuelve al modelo la nueva captura de pantalla junto con call_id. Dado que el estado de sesión y el alcance de accesibilidad están en manos de la aplicación, para las tareas de solo lectura es mejor prohibir el envío de formularios directamente desde la capa de entorno, y no depender únicamente de las restricciones de la indicación.
Las consultas de pedidos, en cambio, se realizan mediante MCP. En la fase de descubrimiento de herramientas, se importa únicamente la herramienta de solo lectura get_purchase_order a través de allowed_tools; para la autenticación se utilizan credenciales de solo lectura con el mínimo de permisos. Antes de cada invocación, la aplicación lee los parámetros de mcp_approval_request, confirma que el número de pedido está dentro del alcance de esta verificación y luego devuelve la aprobación. La responsabilidad de ambas rutas puede dividirse así: lo que ocurre en la interfaz es responsabilidad de la aplicación, lo que devuelve el sistema remoto es responsabilidad del proveedor del servicio, y el modelo solo se encarga de realizar la solicitud.
| Dimensión | Computer Use | MCP remoto |
|---|---|---|
| Entorno de ejecución | Navegador / escritorio proporcionado por la aplicación | Servicio remoto que configuras |
| Identificador de correlación | computer_call y call_id |
mcp_approval_request / response |
| Puntos de control de permisos | Aislamiento del entorno, estado de sesión, lista blanca de páginas | Autenticación del servicio, allowed_tools, aprobación en cada llamada |
| Campos adecuados | Información pública que se muestra solo tras una interacción | Registros estructurados en sistemas de negocio |
| Riesgos principales | Clics accidentales, cambios de versión de la página | Invocaciones fuera de los permisos, parámetros fuera de rango |
GPT-6.2 Astra: de la recopilación de datos a resultados utilizables
Elige la herramienta de búsqueda según dónde vive el documento: para información pública que cambia con frecuencia, Web Search, conservando el url_citation; para contratos ya archivados, File Search. El entorno de cómputo se elige según la forma de la tarea: para conciliar importes, hacer resúmenes estadísticos y trabajos parecidos, el sandbox de Python de Code Interpreter basta; cuando haya que descomprimir lotes, convertir varios archivos o encadenar herramientas de línea de comandos, entonces plantéate Hosted Shell. Y no te olvides de dejar bien definido en el flujo el paso de recuperar los archivos.
Una vez que el agente raíz termina la consolidación, conviene generar el resultado estructurado en una solicitud Responses posterior lanzada por la aplicación, sin mezclarlo con la búsqueda en la misma solicitud. Así el schema queda más simple y, si algo falla, es más fácil reintentar.
Ver el código de ejemplo para la devolución de aprobaciones y la salida estructurada
from openai import OpenAI

client = OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

ALLOWED_PO = {"PO-881"}

def handle_approvals(resp):
    """Aprueba las llamadas MCP una por una: solo deja pasar los números de pedido dentro del alcance de esta verificación"""
    replies = []
    for item in resp.output:
        if item.type == "mcp_approval_request":
            ok = item.name == "get_purchase_order" and \
                 item.arguments and any(po in item.arguments for po in ALLOWED_PO)
            replies.append({
                "type": "mcp_approval_response",
                "approval_request_id": item.id,
                "approve": bool(ok),
            })
    return replies

schema = {
    "type": "object",
    "properties": {
        "records": {
            "type": "array",
            "items": {
                "type": "object",
                "properties": {
                    "record_id": {"type": "string"},
                    "evidence": {"type": "array", "items": {"type": "string"}},
                    "status": {"type": "string",
                               "enum": ["match", "mismatch", "needs_review"]},
                },
                "required": ["record_id", "evidence", "status"],
                "additionalProperties": False,
            },
        }
    },
    "required": ["records"],
    "additionalProperties": False,
}

def to_structured(prev_id):
    final = client.responses.create(
        model="gpt-6.2-astra",
        previous_response_id=prev_id,
        input="把核验结论整理为结构化记录,evidence 只写可追溯来源",
        text={"format": {"type": "json_schema", "name": "procurement_check",
                         "schema": schema, "strict": True}},
    )
    if final.status != "completed":
        raise RuntimeError(f"未完成:{final.status}")  # Los rechazos y las respuestas incompletas hay que tratarlos aparte
    return final.output_text
Las restricciones de formato son solo la primera línea de defensa; la lógica de los campos necesita además programas y personas que la controlen. Aquí tienes un ejemplo de salida y quién valida cada campo:
| Campo | Valor de ejemplo | Garantía de formato | Qué queda por comprobar | Responsable |
|---|---|---|---|---|
| record_id | PO-881 | El schema lo obliga a ser string | Si existe realmente en el sistema de compras | Reconsulta automática |
| evidence | Cláusula 5.2 del contrato; página de cualificaciones del sitio web | Debe ser un array | Si la fuente se puede abrir y si la cita corresponde | Programa + muestreo |
| status | mismatch | Solo puede tomar valores del enum | Si el veredicto encaja con el criterio de negocio | Revisión humana |
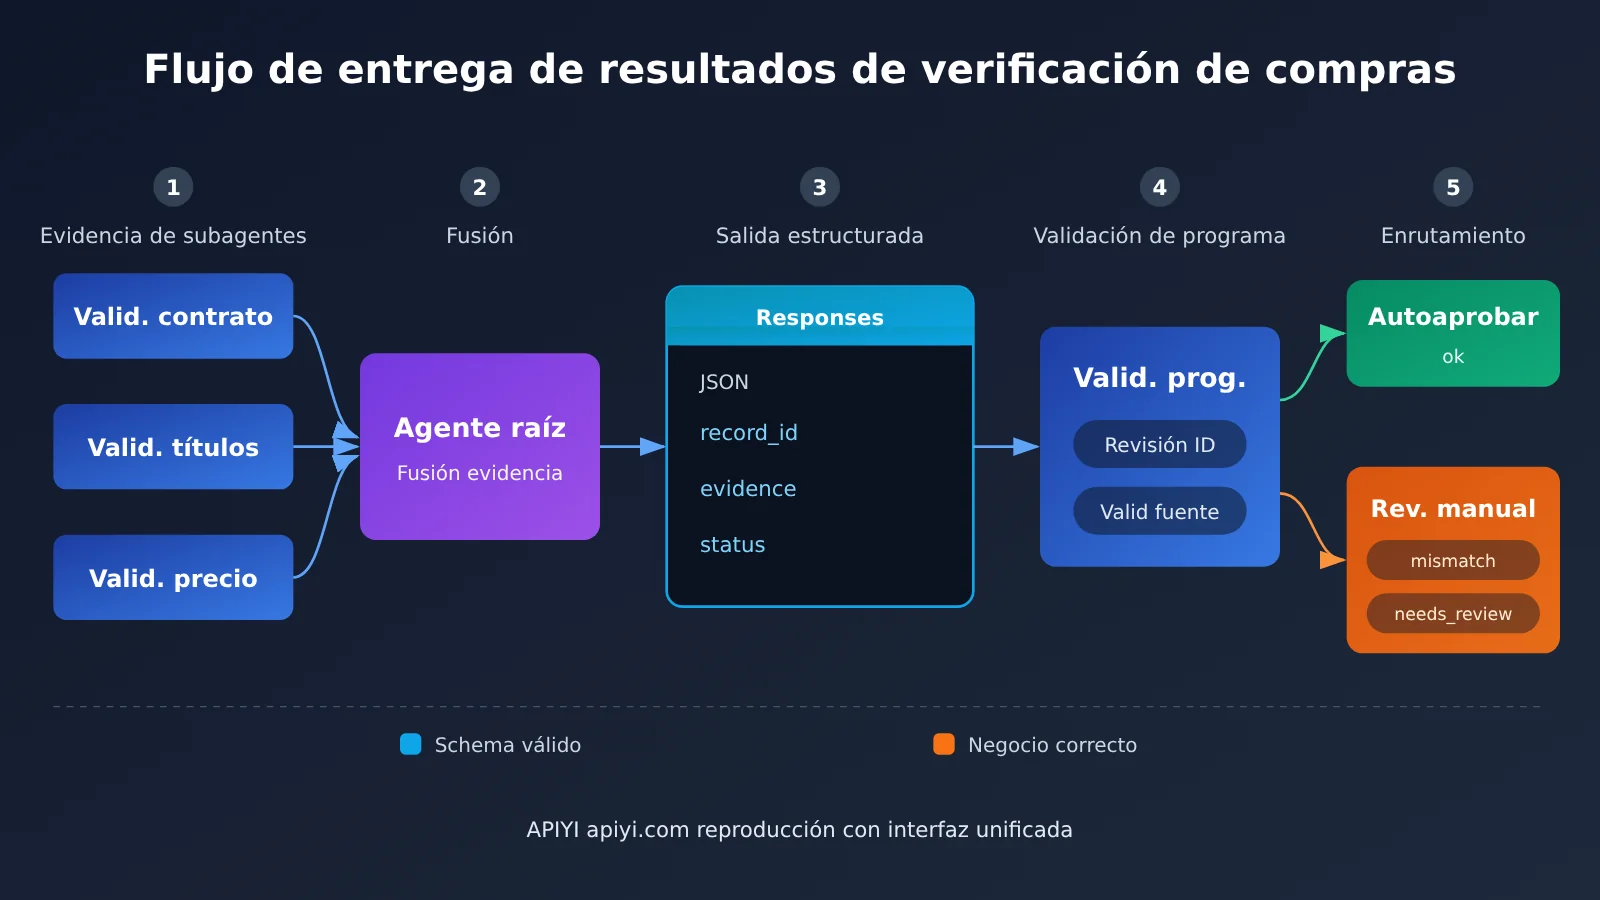
🎯 Consejo técnico: conviene separar «schema válido» y «correcto para el negocio» en dos pasos de comprobación independientes; todos los registros cuyo
statusseamismatchoneeds_reviewvan directo a la cola de revisión humana. Antes de salir a producción, puedes reproducir todo el flujo en APIYI apiyi.com usando pedidos de compra históricos, medir la tasa de falsos veredictos y después decidir qué estados se pueden liberar de forma automática.
Criterios para el orden de implementación de GPT-6.2 Astra
Partiendo de los hechos anteriores, nuestra valoración sobre el orden de integración es la siguiente: primero dejar funcionando Structured Outputs y File Search, después conectar MCP en modo de solo lectura y, por último, incorporar Multi-agent y Computer Use. Los dos primeros los gestiona OpenAI, así que la probabilidad de error es la más baja; el retorno de aprobaciones de MCP es una máquina de estados que necesita pruebas propias; Multi-agent sigue en beta y la estabilidad de Computer Use depende de la calidad del entorno que tú mismo montes, por lo que ambos encajan mejor cuando el flujo principal ya está estable.
Esta conclusión se sostiene bajo dos premisas: que las interfaces beta no sufran cambios disruptivos a corto plazo y que tu cuenta pueda habilitar las herramientas correspondientes. Ambas exigen seguir de cerca el registro de actualizaciones de la API de OpenAI. Además, «solo lectura» es, en los ejemplos, una restricción de diseño. En cuanto el negocio necesite escritura, la política de aprobaciones, el orden de escritura y el plan de reversión tendrán que rediseñarse por completo; no basta reutilizar la configuración de este artículo.
💰 Optimización de costes: cuando se consulta repetidamente un contrato largo, el precio unitario de la entrada con caché es muy inferior al de la entrada normal. Colocar las instrucciones de sistema fijas y el schema al inicio de la petición ayuda a aumentar la tasa de aciertos de caché. Los equipos pequeños y medianos también pueden llamar por volumen a través de APIYI apiyi.com y ampliar poco a poco la escala de verificación.
La lista de herramientas no deja de crecer, pero lo que realmente decide si un agente puede pasar a producción siguen siendo esos límites sencillos: quién ejecuta, quién autoriza, quién revisa. Como escribió Lu You en Una noche de invierno, leyendo, se lo muestro a mi hijo Yu:
Lo que se aprende en el papel siempre parece superficial; para conocerlo de verdad, hay que practicarlo uno mismo.
Autor: Equipo técnico de APIYI
Intercambio técnico: contáctanos desde la página principal del sitio APIYI apiyi.com para obtener más materiales prácticos sobre la integración de GPT-6.2 Astra.