Nota del autor: comparo por separado programación, gráficos y contexto largo entre Gemini 4 Neon y GPT-6.2 Sol, y verifico el coste por tarea, el tiempo de ejecución, el precio unitario oficial y el precio de catálogo de APIYI. Cada cifra indica su fuente.
Muchos equipos consideran que GPT-6.2 Sol es la opción más barata. Gemini 4 Neon se publicó el 2026-11-18 y la página del modelo en Artificial Analysis le otorga una puntuación de inteligencia de 61; la de Sol es 57. Dónde caen esos 4 puntos —en qué tareas— determina cuánto valen para tu carga de trabajo. Este artículo analiza por separado tres cosas —programación, gráficos y contexto largo— y luego separa el coste por tarea y el precio unitario en dos cuentas distintas.
Cada cifra del texto lleva su etiqueta de fuente: autoinforme oficial, ficha del modelo, página del modelo de Artificial Analysis, artículo de Artificial Analysis, tabla general de APIYI y endpoint de precios. Cuando dos metodologías no coinciden, las cifras se conservan una al lado de la otra, sin promediarlas ni fabricar números nuevos.
Valor clave: al terminar, podrás explicar en qué pruebas aparecen los puntos extra de Neon, en qué apartado Sol es, en cambio, superior, cuánto difieren ambos en coste por tarea y tiempo de ejecución, y cómo invocar el gpt-6.2-sol ya disponible en APIYI.
Diferencias clave entre Gemini 4 Neon y GPT-6.2 Sol: vista rápida
Empecemos reuniendo las siete filas más importantes. Ojo con los niveles: en la página del modelo de Artificial Analysis, los 61 puntos de Neon corresponden al nivel xhigh y los 57 de Sol al nivel max. En ambos casos se trata del nivel más alto que aparece en su respectiva página, pero los nombres y el significado de los niveles no son equivalentes.
| Dimensión | Gemini 4 Neon | GPT-6.2 Sol | Fuente |
|---|---|---|---|
| Inteligencia general | 61 (xhigh) | 57 (max) | Página del modelo de Artificial Analysis |
| Programación: Terminal-bench 4.1 (precisión ajustada por trampas) | 65.2% | 61.5% | Ficha del modelo |
| Gráficos: Chartography | 73.5% | 75.1% | Ficha del modelo |
| Contexto largo: GraphWalks (de 256k a 1M, F1 de BFS) | 95.2% | 80.1% | Ficha del modelo |
| Costo por tarea | 6.44 USD | 1.01 USD | Página del modelo de Artificial Analysis |
| Tiempo por tarea | 21.5 minutos | 8.5 minutos | Página del modelo de Artificial Analysis |
| Precio de lista (entrada/salida, por millón de tokens) | 3 / 15 USD | 2 / 10 USD | Autodeclarado oficial / página del modelo de Artificial Analysis |
Tres criterios que conviene tener claros antes de leer la tabla comparativa entre Gemini 4 Neon y GPT-6.2 Sol
El primero tiene que ver con la naturaleza de la ficha del modelo. La tabla comparativa de la ficha del modelo de DeepMind solo tiene tres columnas: Gemini 4 Neon, Claude Opus 5.5 y GPT-6.2 Sol. El PDF de notas de evaluación que la acompaña indica que los resultados de modelos que no son Gemini provienen, por defecto, de lo que reporta cada fabricante. Por eso, la columna de Sol en la ficha del modelo son cifras oficiales recopiladas por Google, no una nueva medición repetida por el mismo laboratorio el mismo día.
El segundo es la coherencia de la puntuación de inteligencia. El 61 coincide en el blog de Google (reportado oficialmente), la ficha del modelo (la fila de AA Index v5.0.1 indica 61 / 59 / 57) y la página del modelo de Artificial Analysis; el 57 de Sol también coincide en la ficha del modelo y en la página del modelo de Artificial Analysis. Los índices de programación no están tan alineados; los veremos por separado más adelante.
El tercero es el criterio de costos. El costo por tarea de Artificial Analysis es el monto que queda al ejecutar todo el conjunto de índices y repartirlo entre cada tarea; depende tanto del precio unitario como del número de tokens de salida. Esa cifra y el precio por llamada que cobra la plataforma según los tokens son dos cuentas distintas y no se pueden sustituir la una por la otra.
Comparativa de capacidades de codificación entre Gemini 4 Neon y GPT-6.2 Sol
En el apartado de codificación, de los cinco subapartados que recoge la ficha del modelo, Neon supera a Sol en todos aquellos que tienen datos, pero la magnitud de la diferencia es muy desigual. La tabla siguiente procede íntegramente de la ficha del modelo; en el caso de Sol, según las notas de evaluación, se trata de cifras autodeclaradas por OpenAI.
| Subapartado de codificación (ficha del modelo) | Gemini 4 Neon | GPT-6.2 Sol | Diferencia |
|---|---|---|---|
| CursorBench 4.1 | 65,4 % | Sin datos | No comparable |
| Terminal-bench 4.1 (tras ajuste por trampas) | 65,2 % | 61,5 % | 3,7 puntos porcentuales |
| FrontierCode 2.0 | 46,2 % | 43,8 % | 2,4 puntos porcentuales |
| SWE-sweep (harness del fabricante) | 39,0 % | 8,3 % | 30,7 puntos porcentuales |
| SWE-sweep (harness mini-SWE) | 12,8 % | 11,6 % | 1,2 puntos porcentuales |
Los dos harness de SWE-sweep deben leerse por separado
SWE-sweep es la fila que más fácilmente se malinterpreta. El 39,0 % de Neon proviene de Google Antigravity, el harness del fabricante, mientras que con el harness mini-SWE unificado baja al 12,8 %. El blog de Google (autodeclaración oficial) describe la diferencia entre 12,8 y 39,0 como lo que desbloquea el harness, así que este conjunto de cifras refleja el efecto combinado de «modelo más cadena de herramientas».
Dentro del mismo harness mini-SWE, Neon obtiene 12,8 % frente al 11,6 % de Sol: solo 1,2 puntos porcentuales de diferencia. En el harness de su propio fabricante, Sol se queda en 8,3 %, es decir, por debajo incluso de su resultado con mini-SWE. Si tu agente de codificación no se ejecuta dentro de Antigravity, la fila de mini-SWE se acerca más a las condiciones que puedes reproducir.
Las dos cifras del Coding Agent Index
El blog de Google (autodeclaración oficial) atribuye a Neon un 58,6 en el Artificial Analysis Coding Agent Index y afirma que ocupa el primer puesto global. El artículo de Artificial Analysis indica 59 para Neon en modo xhigh sobre Antigravity CLI. Ambas cifras provienen de fuentes distintas, así que este texto las mantiene tal cual, sin fusionarlas. En los materiales de referencia no aparece ninguna puntuación de Sol en este índice, por lo que aquí no es posible comparar a los dos modelos. Además, el 46,2 % de FrontierCode 2.0, según la autodeclaración oficial, se midió con el nivel high predeterminado.
Comparación de capacidades de gráficos: Gemini 4 Neon frente a GPT-6.2 Sol
De los tres apartados, el de gráficos es uno en los que Sol aventaja. En la línea Chartography de la ficha del modelo, Neon marca 73.5% y Sol 75.1%, lo que pone a Sol 1.6 puntos porcentuales por delante. El blog de Google (dato autoinformado por el fabricante) también da para Neon la misma cifra, 73.5%, así que ambas fuentes coinciden.
En LVBench, que también entra en la comprensión multimodal, la ficha del modelo indica Neon 89.0% y Sol 87.6%; aquí Neon aventaja por 1.4 puntos porcentuales. Los dos resultados apuntan en direcciones opuestas y las diferencias no son grandes, así que es difícil resumir en una sola frase «quién es mejor en gráficos y tareas visuales»; dependerá de si tu tarea se parece más a leer gráficos o a ver videos largos.
En cuanto a las modalidades de entrada, la ficha del modelo especifica que Neon acepta texto, imágenes, audio y video. El material de referencia no incluye la lista de modalidades de entrada de Sol; si tu flujo depende de entradas de audio o video, primero deberías revisar la compatibilidad de Sol en la documentación oficial de OpenAI.
Comparación de contexto largo: Gemini 4 Neon frente a GPT-6.2 Sol
Para el apartado de contexto largo, este artículo utiliza únicamente los datos de GraphWalks de la ficha del modelo. En el rango de 256k a 1M tokens se hace un recorrido BFS; la puntuación F1 es 95.2% para Neon y 80.1% para Sol, una diferencia de 15.1 puntos porcentuales, la mayor de los tres apartados.
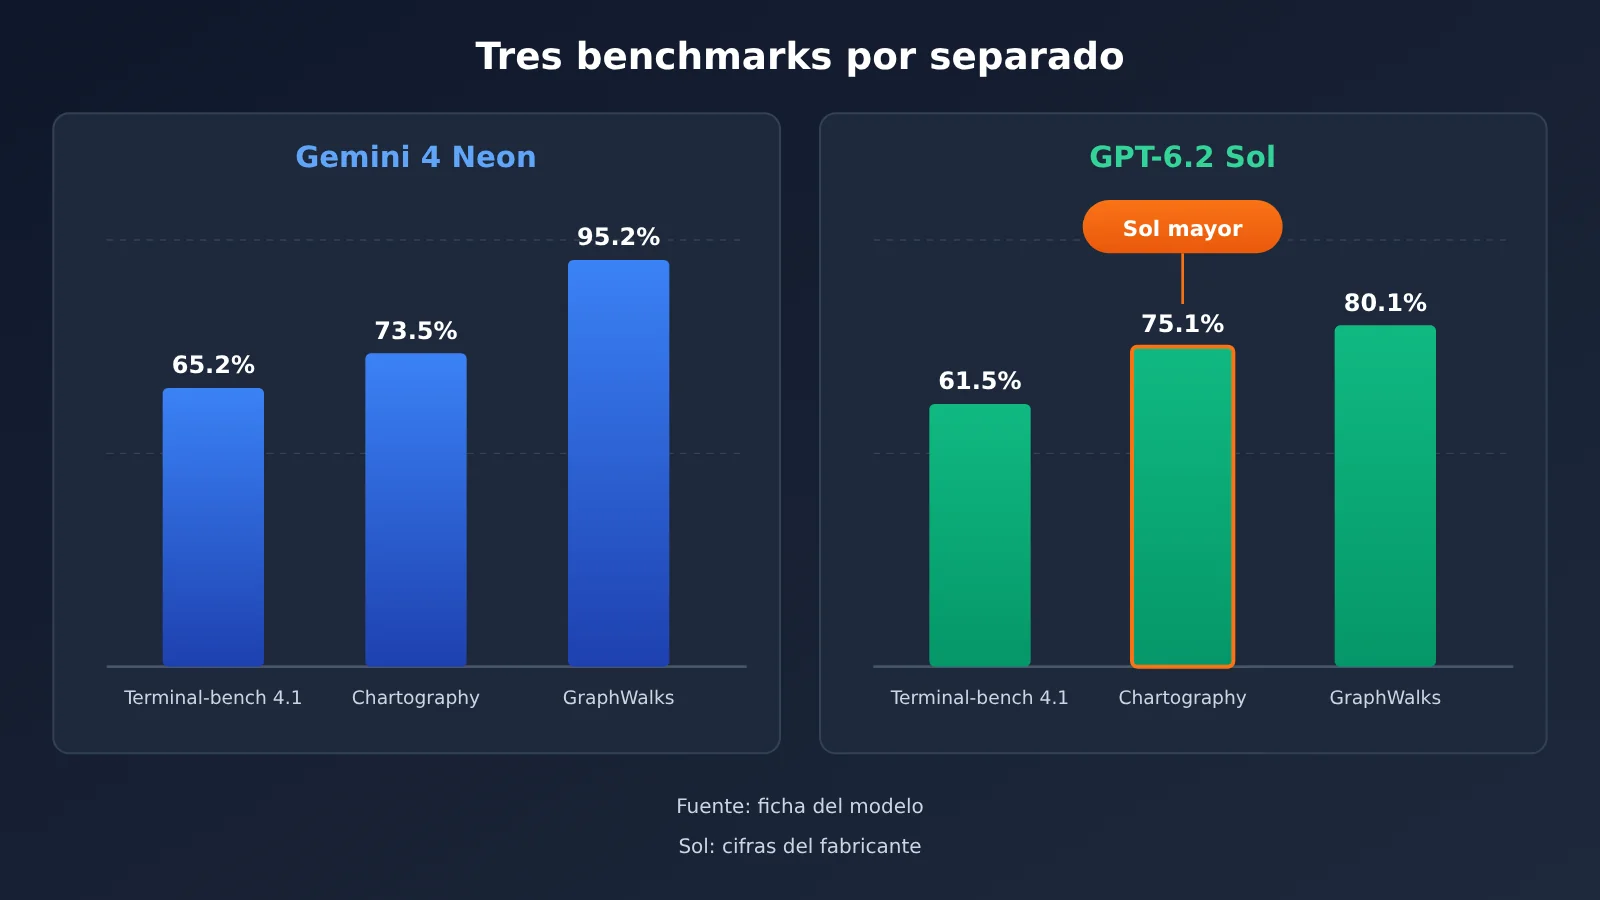
📊 Nota sobre el gráfico: todas las cifras de la imagen anterior provienen de la ficha del modelo; la columna de Sol, según las notas de evaluación, contiene datos autoinformados por el fabricante. Si quieres comprobar el rendimiento de Sol con tus propios documentos largos, puedes lanzar directamente una solicitud a
gpt-6.2-sola través de APIYI apiyi.com con la misma clave.
Parámetros de contexto largo de Gemini 4 Neon
Las especificaciones de ventana de Neon están documentadas por completo. La ficha del modelo indica que la ventana unificada admite hasta 1 millón de tokens; por defecto, la salida síncrona llega a 64 mil tokens, y la decodificación larga en segundo plano hasta 1 millón. La guía para desarrolladores de Google Cloud ofrece los valores exactos: el límite unificado es de 1048576 tokens, que incluye tanto la entrada como la salida; la salida incluye además el razonamiento, las llamadas a funciones y la respuesta final; por defecto, cada segmento admite hasta 65536 tokens, y la decodificación larga puede llegar a 1048576 menos la entrada.
En cuanto al almacenamiento en caché, la guía para desarrolladores especifica que Neon no admite caché de contexto explícita. La caché implícita se aplica automáticamente a los prefijos compartidos de más de 4096 tokens, y la caché persistente está activada por defecto. En escenarios en los que haces preguntas repetidas sobre documentos largos, esto significa que debes mantener estable el prefijo compartido para aprovechar el precio de caché de 0.15 USD que figura en la página de precios de AI Studio.
Información de contexto largo de GPT-6.2 Sol
El material de referencia no proporciona el límite máximo de la ventana de contexto de Sol, por lo que este artículo no compara el tamaño de la ventana. Lo que sí se puede confirmar es el cobro: la tabla general de APIYI muestra que gpt-6.2-sol cambia de tramo cuando la entrada supera los 272000 tokens; la sección de precios más abajo lo detalla. En tareas de contexto largo, este umbral afecta directamente la estructura de tu factura.
Comparación de costes y tiempos entre Gemini 4 Neon y GPT-6.2 Sol
La diferencia de coste por tarea es mucho mayor que la diferencia de precio unitario. La página del modelo en Artificial Analysis muestra que Neon xhigh cuesta 6,44 dólares por tarea y Sol max cuesta 1,01 dólares por tarea, de modo que el primero es aproximadamente 6,4 veces el segundo. Sin embargo, la relación entre sus precios de entrada es de 3 a 2 y la de precios de salida es de 15 a 10, es decir, 1,5 veces en ambos casos.
La parte adicional procede del volumen de salida. En esa misma página, Neon xhigh, al ejecutar el índice, generó 283 millones de tokens, mientras que Sol max generó 60,9 millones de tokens, lo que hace que el primero sea aproximadamente 4,6 veces el segundo. Un precio unitario 1,5 veces mayor y un volumen de salida varias veces superior: solo al combinar ambos fatores se llega al resultado de 6,44 frente a 1,01.
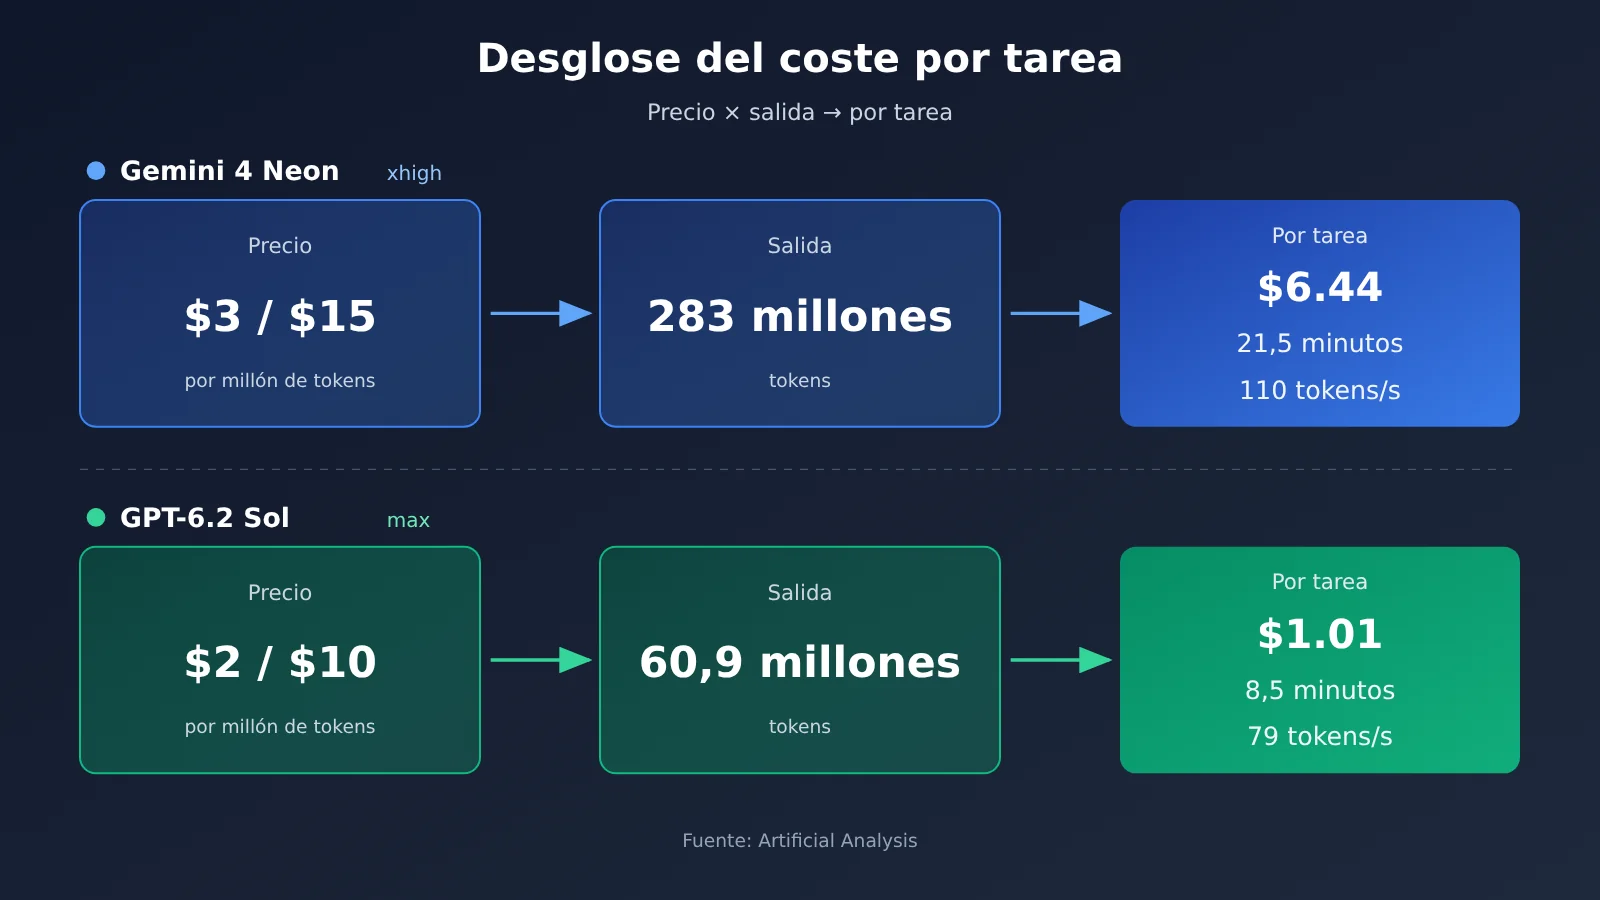
En cuanto al tiempo, ocurre lo mismo. La velocidad de salida de Neon xhigh es de unos 110 tokens/segundo, superior a los 79 tokens/segundo de Sol max, pero como genera más salida, el tiempo por tarea es de 21,5 minutos frente a 8,5 minutos. El tiempo hasta el primer token de respuesta es de 56,51 segundos para Neon xhigh y de 75,06 segundos para Sol max; en este aspecto Neon es más rápido.
Puntuación de inteligencia y tiempo por tarea según el nivel
Ambos modelos tienen varios niveles de razonamiento, y la tabla siguiente procede de la página del modelo en Artificial Analysis. El coste por tarea solo aparece en la fila del nivel más alto; para los demás niveles, la página muestra la puntuación, el tiempo y la velocidad.
| Nivel | Puntuación de inteligencia de Neon | Tiempo por tarea de Neon | Velocidad de salida de Neon | Puntuación de inteligencia de Sol | Tiempo por tarea de Sol | Velocidad de salida de Sol |
|---|---|---|---|---|---|---|
| max | No existe este nivel | — | — | 57 | 8,5 minutos | 79 tokens/segundo |
| xhigh | 61 | 21,5 minutos | 110 tokens/segundo | 56 | 5,3 minutos | 76 tokens/segundo |
| high | 60 | 14,8 minutos | 101 tokens/segundo | 55 | 4,6 minutos | 73 tokens/segundo |
| medium | 55 | 8,3 minutos | 101 tokens/segundo | 53 | 3,2 minutos | 70 tokens/segundo |
| low | 44 | 3,7 minutos | 97 tokens/segundo | 41 | 1,5 minutos | 65 tokens/segundo |
Esta tabla se puede leer de dos maneras. Si se comparan niveles con el mismo nombre, el nivel high de Neon obtiene 60 puntos frente a 55 de Sol, con un tiempo de 14,8 minutos frente a 4,6 minutos. Si se compara por tiempo, los 8,3 minutos de Neon medium y los 8,5 minutos de Sol max son similares, con puntuaciones de 55 frente a 57. El nivel predeterminado de Neon es high (así lo indican tanto la guía para desarrolladores como la página del modelo más reciente en AI Studio), y esta es también la fila en la que recaen por defecto muchas integraciones. El tiempo hasta el primer token de los tres niveles inferiores de Neon se recoge por separado en las preguntas frecuentes de la página del modelo: high 40,64 segundos, medium 20,14 segundos y low 13,93 segundos; estos datos no aparecen en la misma columna que la tabla resumen.
Comparativa de precios entre Gemini 4 Neon y GPT-6.2 Sol: tarifa oficial y catálogo de APIYI
El tema del precio tiene dos capas: la tarifa publicada en la página del proveedor del modelo o de un tercero, y el precio de catálogo en APIYI (apiyi.com).
| Concepto | Gemini 4 Neon | GPT-6.2 Sol |
|---|---|---|
| Precio de entrada (por millón de tokens) | 3,00 USD (según lo declarado oficialmente / página de precios de AI Studio) | 2,00 USD (página del modelo en Artificial Analysis) |
| Precio de salida (por millón de tokens) | 15,00 USD, incluidos los tokens de pensamiento | 10,00 USD |
| Caché | 0,15 USD, solo caché implícita | Descuento en caché del 95 % (página del modelo en Artificial Analysis) |
| Nivel gratuito | No (página de precios de AI Studio) | No se menciona en las referencias |
| ID del modelo en APIYI | Aún no listado | gpt-6.2-sol |
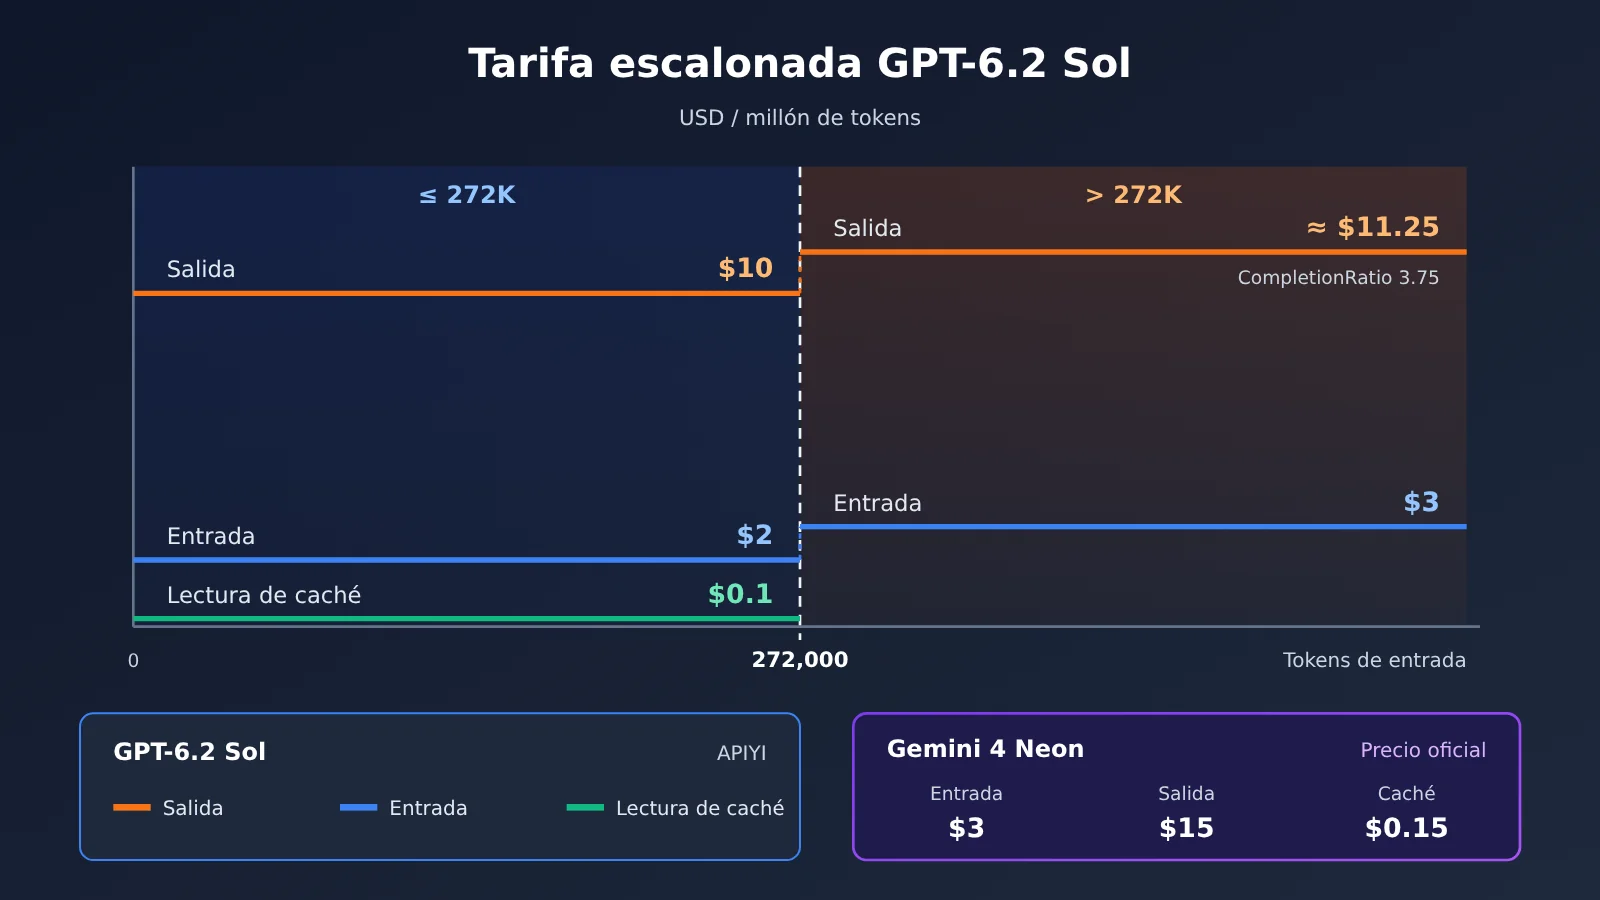
| Primer tramo en APIYI (de 0 a 272000 tokens de entrada) | — | Entrada 2 / lectura de caché 0,1 / salida 10 USD |
| Tramo superior en APIYI (más de 272000 tokens de entrada) | — | Entrada 3 USD; salida de unos 11,25 USD según la interfaz de precios |
| Endpoints en APIYI | — | responses (recomendado), chat |
| Plataformas disponibles | Canales oficiales como Gemini API de Google AI Studio | APIYI apiyi.com y otros |
gemini-4-neon todavía no aparece ni en la tabla general de APIYI ni en la interfaz de precios, así que aún no está listado. Lo incorporaremos lo antes posible; el modelo y el precio que valen son los de la lista de modelos de la plataforma.
Detalles del cambio de tramo de gpt-6.2-sol en APIYI
La tabla general de APIYI (con nota de actualización del 2026-11-16 09:39, UTC+8) indica para gpt-6.2-sol un primer tramo de 2 USD de entrada, 0,1 USD de lectura de caché y 10 USD de salida, en línea con los 2/10 publicados en la página del modelo en Artificial Analysis. Al superar los 272000 tokens de entrada, el cuerpo de la tabla general solo dice que la entrada pasa de 2 USD a 3 USD.
La consulta a la interfaz de precios del 2026-11-19 (versión shell-api-modelmak-v1, 285 modelos en total) ofrece información más completa. En la interfaz, model_ratio igual a 1 corresponde a 2 USD por millón de tokens de entrada, y completion_ratio igual a 5 significa que la salida cuesta 5 veces la entrada; al pasar de 272000 tokens, CompletionRatio cambia de 5 a 3,75, de modo que con una entrada de 3 USD la salida queda en unos 11,25 USD por millón de tokens, y no sigue calculándose a 10 USD.
Los nombres de grupo aparecen con pequeñas diferencias en los dos sitios: la tabla general escribe CodexResponses, Codex_Reverse, Default y SVIP, mientras que la interfaz de precios escribe CodexResponses, CodexReverse, default y svip. Y conviene insistir otra vez: los 1,01 USD de Artificial Analysis son el coste diluido por tarea al ejecutar el índice, y no tienen nada que ver con el gasto real en tokens que genera una llamada tuya en la plataforma.
Comparación de escenarios entre Gemini 4 Neon y GPT-6.2 Sol
A continuación se muestran las cifras más relevantes para cada tipo de tarea, para que puedas relacionar las evaluaciones con tu propia carga de trabajo. Cuál encaja mejor depende de tu distribución de tareas y de tu presupuesto; aquí solo hacemos una comparación, sin sacar conclusiones.
Cifras relacionadas con agentes de codificación
- En Google Antigravity: fíjate en la fila de SWE-sweep en el harness del proveedor: Neon 39.0% y Sol 8.3%; además, ten en cuenta que Google atribuye esta diferencia al harness.
- En un harness genérico: fíjate en la fila de mini-SWE: 12.8% frente a 11.6%, y en Terminal-bench 4.1: 65.2% frente a 61.5%.
- Cambios pequeños y frecuentes: el tiempo por tarea importa más; puedes comparar los tiempos del mismo rango de puntuación en la tabla de niveles.
Cifras relacionadas con gráficos y documentos largos
- Preguntas y respuestas sobre gráficos de resultados financieros y capturas de paneles de control: Chartography da Sol 75.1% y Neon 73.5%; esta métrica apunta en dirección contraria a la puntuación global.
- Recorrido de estructuras de grafos o documentos a escala de cientos de miles de tokens: GraphWalks da Neon 95.2% y Sol 80.1%; además, debes incluir en el costo el salto de tarifa de Sol en APIYI al superar los 272000 tokens.
- Comprensión de videos largos: LVBench da Neon 89.0% y Sol 87.6%, y la ficha del modelo indica que Neon admite entrada de video.
Recomendación para elegir entre Gemini 4 Neon y GPT-6.2 Sol: primero verifica, luego decide
Antes de decantarte por uno, conviene repasar tu situación en este orden, en lugar de decidir directamente con ese 61 frente a 57.
- Calcula qué proporción de tus tareas corresponde a codificación, gráficos y contexto largo, y luego contrástala con las tres tablas por categoría que aparecen más arriba.
- Estima el volumen medio de salida por tarea. Los datos de Artificial Analysis muestran que la diferencia de costo por tarea entre ambos modelos viene principalmente del volumen de salida: cuanto más largas sean las respuestas de tus tareas, más evidente será esa diferencia.
- Confirma si la longitud de entrada supera los 272000 tokens. Una vez pasado ese punto, los precios unitarios de entrada y salida de
gpt-6.2-solen APIYI cambian. - Confirma el nivel de razonamiento. Neon solo admite cuatro niveles: low, medium, high y xhigh; si le pasas
thinking_budgetoMINIMAL, devuelve un HTTP400(guía para desarrolladores). - Ejecuta un lote pequeño de comparación sobre tu propio conjunto de muestras, anotando puntuación, tiempo y consumo de tokens.
💡 Recomendación: ambos modelos tienen virtudes y flaquezas en cada categoría, y la decisión final depende de cómo se distribuyen tus tareas y de tu presupuesto. Te sugerimos empezar conectando
gpt-6.2-sol, que ya está disponible en APIYI apiyi.com, y registrar el consumo de tokens y el tiempo sobre tus propias muestras; cuando Neon esté disponible en el catálogo, usa el mismo conjunto de scripts para hacer la comparación.
Cómo invocar GPT-6.2 Sol rápidamente mediante APIYI
APIYI recomienda el endpoint responses para gpt-6.2-sol; la base_url compatible con OpenAI es https://api.apiyi.com/v1. La integración completa solo requiere cuatro pasos:
- Preparar la clave: genera una clave API en la consola de la plataforma, guárdala en la variable de entorno
APIYI_API_KEYy, en el código, léela únicamente desde la variable de entorno, nunca en texto plano. - Definir la dirección de la solicitud: el endpoint de Responses es
POST https://api.apiyi.com/v1/responses; incluye en los encabezadosAuthorization: Bearer $APIYI_API_KEYyContent-Type: application/json. - Construir el cuerpo de la solicitud: el cuerpo mínimo es
{"model": "gpt-6.2-sol", "input": "请总结这份季度报告里的三张图表"}. - Invocar con el SDK de OpenAI: inicializa
OpenAI(base_url="https://api.apiyi.com/v1", api_key=os.environ["APIYI_API_KEY"])y luego llama aclient.responses.create(model="gpt-6.2-sol", input=...); lee el resultado desdeoutput_textdel objeto devuelto.
Si tu código actual se basa en Chat Completions, también puedes enviar el mismo ID de modelo al endpoint chat, cuya ruta es /v1/chat/completions. El protocolo nativo de Gemini utiliza https://api.apiyi.com más la versión v1beta, y resulta adecuado para los modelos Gemini que ya están disponibles en la plataforma.
Al hacer pruebas con contexto largo, se recomienda registrar también en los logs el número de tokens de entrada de cada solicitud, para saber con facilidad si se ha cruzado el umbral de 272000. Los valores concretos de los parámetros de nivel de razonamiento deben consultarse en la documentación oficial de OpenAI y en la página del modelo en la plataforma.
🚀 Inicio rápido: los nuevos usuarios pueden reclamar una cuota de prueba gratuita en APIYI (apiyi.com). Con una sola clave API pueden invocar simultáneamente modelos ya disponibles como OpenAI, Claude y Gemini; primero haz funcionar la cadena de
responsesdegpt-6.2-soly, para cambiar de modelo más adelante, solo tendrás que modificar el campomodel.
Preguntas frecuentes (FAQ)
P1: ¿Cuál es el posicionamiento de Gemini 4 Neon y de GPT-6.2 Sol respectivamente?
Neon deriva de Gemini 4 Carbon (model card), y la guía para desarrolladores de Google lo sitúa entre Hydrogen (ciclo diario rápido) y Carbon (tareas complejas de horizonte largo). GPT-6.2 Sol aparece en la página del modelo en Artificial Analysis con un precio de 2/10 USD, y su nivel más alto, max, alcanza una puntuación de inteligencia de 57.
P2: ¿Dónde se notan sobre todo los 4 puntos que Neon tiene de más frente a Sol?
Según el desglose de la model card, las mayores diferencias están en GraphWalks de contexto largo (95.2% frente a 80.1%) y en SWE-sweep bajo el harness del proveedor (39.0% frente a 8.3%). En la sección Chartography, en cambio, Sol va por delante (75.1% frente a 73.5%).
P3: ¿Cuándo se lanzó Gemini 4 Neon y en qué canales está disponible?
La fecha de publicación del blog de Google es 2026-11-18. Según la publicación de lanzamiento de Sundar Pichai, ese mismo día llegó a la Gemini API de Google AI Studio, a Gemini for business, a Google Antigravity de los planes de pago Google AI Pro y Ultra, y a la Gemini App de los planes Pro y Ultra. El ID del modelo es `gemini-4-neon`.
P4: ¿Se puede tomar el 1.01 USD por tarea de Sol como presupuesto de invocación?
Esa cifra es el coste por tarea que resulta de repartir el gasto total de ejecutar la batería completa de índices de Artificial Analysis; en esa prueba, Sol max generó 60.9 millones de tokens de salida. Tu gasto real depende de tus propios tokens de entrada y salida y del tramo de facturación, así que conviene estimarlo con el primer tramo de la tabla general de APIYI: 2 / 0.1 / 10 USD, y tener en cuenta el salto de tramo al superar los 272000 tokens.
P5: ¿Cómo puedo invocar estos dos modelos rápidamente vía API?
`gpt-6.2-sol` ya está disponible en APIYI. Regístrate en apiyi.com, reclama tu cuota de prueba y configura base_url como `https://api.apiyi.com/v1`; después solo tienes que llamar al endpoint `responses`. `gemini-4-neon` todavía no aparece ni en la tabla general ni en la interfaz de precios, así que aún no está publicado; lo añadiremos lo antes posible. El modelo y el precio válidos son los que figuren en la lista de modelos de la plataforma.
P6: ¿Qué limitaciones tienen estos datos comparativos?
Basicamente tres:
– **Criterio**: según las notas de evaluación, las puntuaciones de Sol en la model card son autodeclaradas por el proveedor y no se volvieron a medir el mismo día.
– **Tramos**: en Artificial Analysis, el tramo más alto de Neon es xhigh y el de Sol es max, así que no son del todo equivalentes.
– **Cifras inconsistentes**: el Coding Agent Index aparece como 58.6 en el blog de Google y como 59 en el artículo de Artificial Analysis; WebExploitBench v1.2 figura como 51.26% en el blog y como 51.3% en la model card. En este artículo se mantienen tal cual.
Puntos clave de Gemini 4 Neon y GPT-6.2 Sol
- Puntuación global: en la página del modelo de Artificial Analysis, Neon xhigh marca 61 puntos y Sol max 57.
- Programación: la model card de Terminal-bench 4.1 indica 65.2% frente a 61.5%; la diferencia en SWE-sweep depende del harness que se mire.
- Gráficos: en Chartography Sol va por delante, 75.1% frente a 73.5%.
- Contexto largo: en GraphWalks, de 256k a 1M, el F1 es 95.2% frente a 80.1%, la diferencia más grande.
- Coste y tiempo: por tarea, 6.44 frente a 1.01 dólares y 21.5 frente a 8.5 minutos; la causa principal es que el volumen de salida difiere varias veces.
- Precio unitario: Neon 3/15 dólares, Sol 2/10 dólares; en APIYI,
gpt-6.2-solcambia de tramo al superar los 272000 tokens de entrada.
Resumen
Las diferencias entre Gemini 4 Neon y GPT-6.2 Sol, una vez desglosadas, son mucho más claras que la puntuación global:
- Programación: Neon es superior en las subcategorías donde la model card tiene datos, pero bajo un mismo harness mini-SWE la diferencia es de solo 1.2 puntos porcentuales.
- Gráficos: en el apartado de Chartography Sol va por delante, mientras que en LVBench Neon es ligeramente superior.
- Contexto largo: en GraphWalks Neon lidera por 15.1 puntos porcentuales, la diferencia más marcada de las tres.
- Coste: el precio unitario difiere 1.5 veces, el coste por tarea unas 6.4 veces; esa amplificación intermedia viene del número de tokens de salida.
Elegir uno u otro depende de la distribución de tus tareas y de la longitud de salida. Se recomienda conectar primero gpt-6.2-sol a través de APIYI apiyi.com, registrar el consumo y el tiempo sobre muestras reales, y cuando Neon esté disponible completar la comparación con el mismo proceso.
📚 Referencias
-
Blog de Google «Introducing Gemini 4 Neon»: anuncio oficial y evaluación autoinformada
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descripción: las capacidades generales, de codificación, científica y el posicionamiento de precios son todos datos autoinformados oficialmente
- Enlace:
-
Ficha del modelo DeepMind Gemini 4 Neon: fuente de la tabla comparativa de tres columnas
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon - Descripción: datos desglosados como Chartography, GraphWalks, SWE-sweep, etc.
- Enlace:
-
Guía para desarrolladores de Google Cloud Gemini 4 Neon: reglas de ventana, niveles de razonamiento y caché
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descripción: límite unificado de 1048576 tokens, regla HTTP 400, explicación del almacenamiento en caché implícito
- Enlace:
-
Página de precios de Google AI Studio: precio unitario oficial de Neon
- Enlace:
aistudio.google.com/docs/pricing - Descripción: entrada 3, salida 15, caché 0.15 USD por millón de tokens
- Enlace:
-
Página de modelos de Artificial Analysis: datos por niveles de Neon y Sol
- Enlace:
artificialanalysis.ai/models/gemini-4-neon,artificialanalysis.ai/models/gpt-6-2-sol - Descripción: puntuación de inteligencia, costo por tarea, tiempo, velocidad de salida
- Enlace:
-
Artículo de Artificial Analysis: interpretación de las mediciones de terceros de Neon
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descripción: datos como Coding Agent Index 59, entre otros
- Enlace:
-
Tabla resumen y endpoint de precios de APIYI: modelos ya disponibles y precios por tramos
- Enlace:
docs.apiyi.com/models.md,api.apiyi.com/api/pricing - Descripción: primer tramo de
gpt-6.2-soly la regla de cambio de tarifa a los 272000 tokens
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: puedes contactarnos desde la página principal del sitio web de APIYI; para más modelos e instrucciones de integración, visita el centro de documentación docs.apiyi.com