Nota del autor: la “rapidez” de Gemini 4 Neon se puede medir de al menos tres formas. Este artículo las ordena por separado según el tiempo hasta el primer token, los tokens por segundo y el tiempo que tarda en completar una tarea, e indica la fuente de cada cifra.
Gemini 4 Neon se lanzó el 18/11/2026. En su publicación de lanzamiento, Sundar Pichai afirma que puede completar tareas más rápido en ingeniería de software compleja, trabajo del conocimiento y procesos científicos. Mucha gente interpreta esta frase como “el más rápido en todo”. En realidad, medir la velocidad implica al menos tres criterios, y sus rankings no coinciden.
Todas las cifras de velocidad de este artículo provienen de la página del modelo de Artificial Analysis y de artículos de Artificial Analysis; las puntuaciones de benchmark provienen de datos autodeclarados por el fabricante y de la ficha del modelo. Ninguna la obtuvimos nosotros mismos. Las cifras de distintas fuentes y criterios se presentan una al lado de la otra, sin promediarlas ni combinarlas en nuevos números.
Valor clave: al terminar de leer, podrás distinguir cuáles son el tiempo hasta el primer token, los tokens por segundo y el tiempo por tarea de Gemini 4 Neon, entenderás cómo afectan los cuatro niveles de razonamiento a la velocidad y a las puntuaciones, y sabrás qué métrica mirar al elegir un modelo.
Puntos clave sobre la velocidad de Gemini 4 Neon
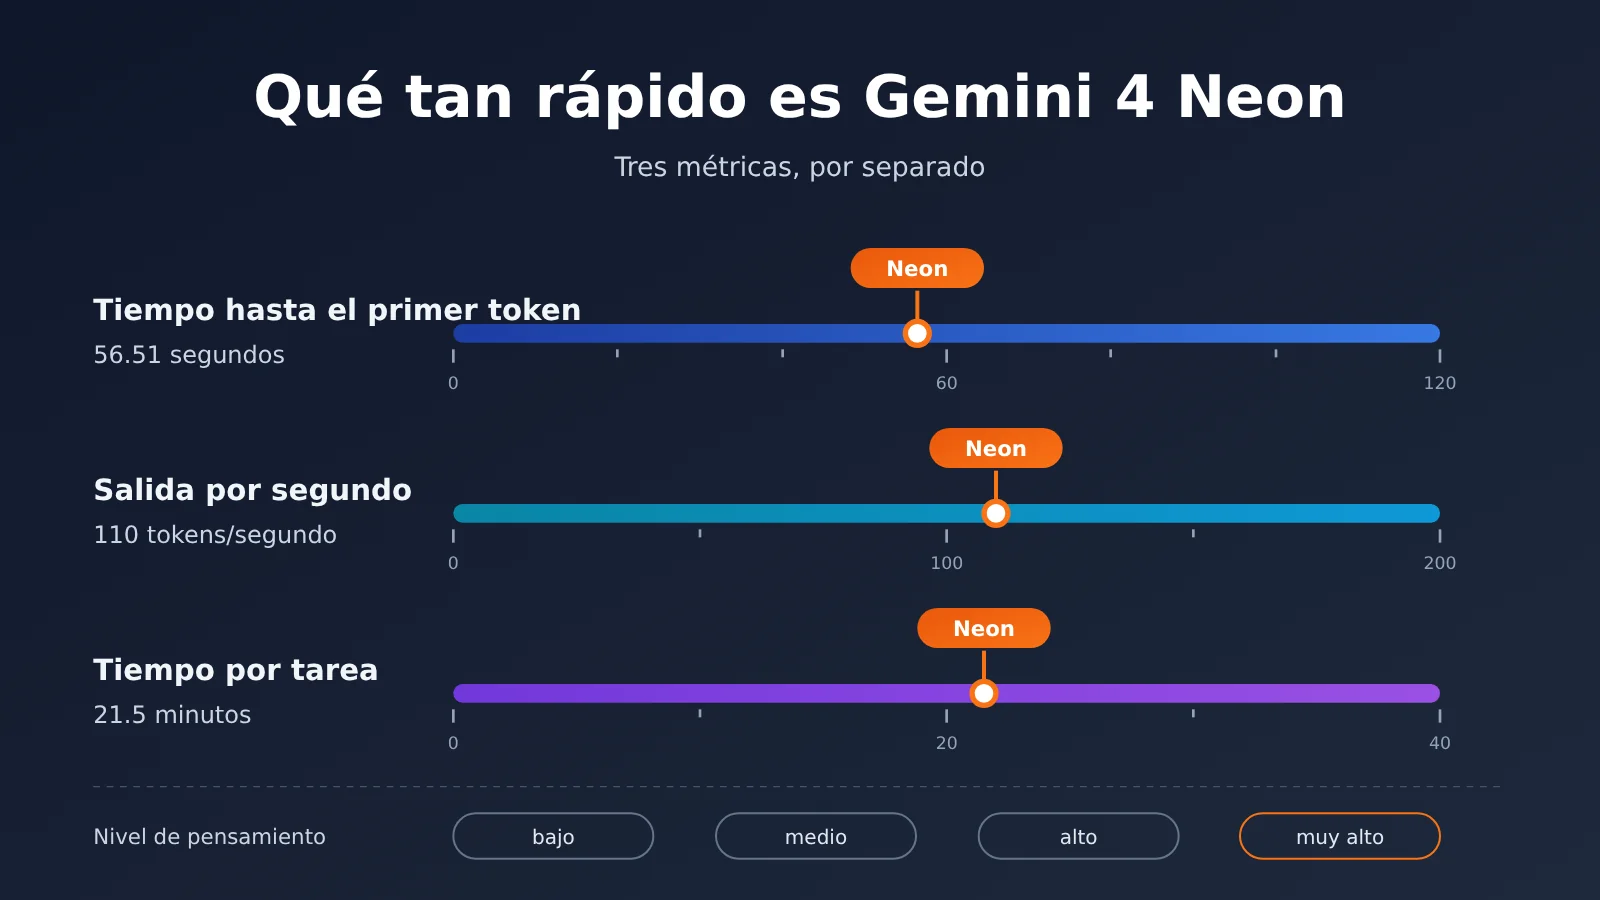
Primero, separemos tres métricas que se confunden con facilidad. En la tabla siguiente, los valores de Neon corresponden al nivel xhigh y provienen de la página del modelo en Artificial Analysis (consultada el 2026-11-19; índice v5.0.1).
| Métrica | Qué mide | Valor de Gemini 4 Neon en xhigh | Percepción del usuario |
|---|---|---|---|
| Tiempo hasta el primer token | Espera desde que se envía la solicitud hasta que aparece el primer token de respuesta | 56,51 segundos | «Cuánto se queda atascado antes de empezar a escribir» en una interacción |
| Salida por segundo | Cuántos tokens se generan por segundo una vez iniciada la salida | 110 tokens/segundo | «Qué tan rápido avanza la salida en streaming» |
| Tiempo por tarea | Tiempo medio para completar una pregunta del índice | 21,5 minutos | «Cuánto tarda en entregarse una tarea» |
| Tokens de salida al ejecutar el índice | Cuántos tokens se generan en total al ejecutar todo el conjunto del índice | 283 millones de tokens | La otra mitad de lo que determina el tiempo por tarea |
Por qué conviene analizar por separado las tres métricas de velocidad de Gemini 4 Neon
El tiempo hasta el primer token es el que más afecta a las interacciones de chat. Los modelos de razonamiento tienen que completar una fase de razonamiento antes de emitir el primer token de respuesta; por eso, ese tiempo suele medirse en segundos o incluso minutos, y está muy ligado al nivel de esfuerzo de razonamiento.
La salida por segundo solo mide el rendimiento una vez que el modelo empieza a escribir; no tiene relación con la cantidad de texto que decide producir. El tiempo por tarea depende de dos cosas a la vez: cuántos tokens se generan por segundo y cuántos tokens requiere en total la tarea. Un modelo puede tener una salida por segundo muy alta, pero si tiende a escribir procesos de razonamiento muy largos, aun así puede tardar más en completar una tarea. La comparación de Neon con GPT-6.2 Sol y GPT-6.2 Astra que veremos más adelante es justo ese caso.
Funciones clave de Gemini 4 Neon: posicionamiento en la familia y cuatro niveles de pensamiento
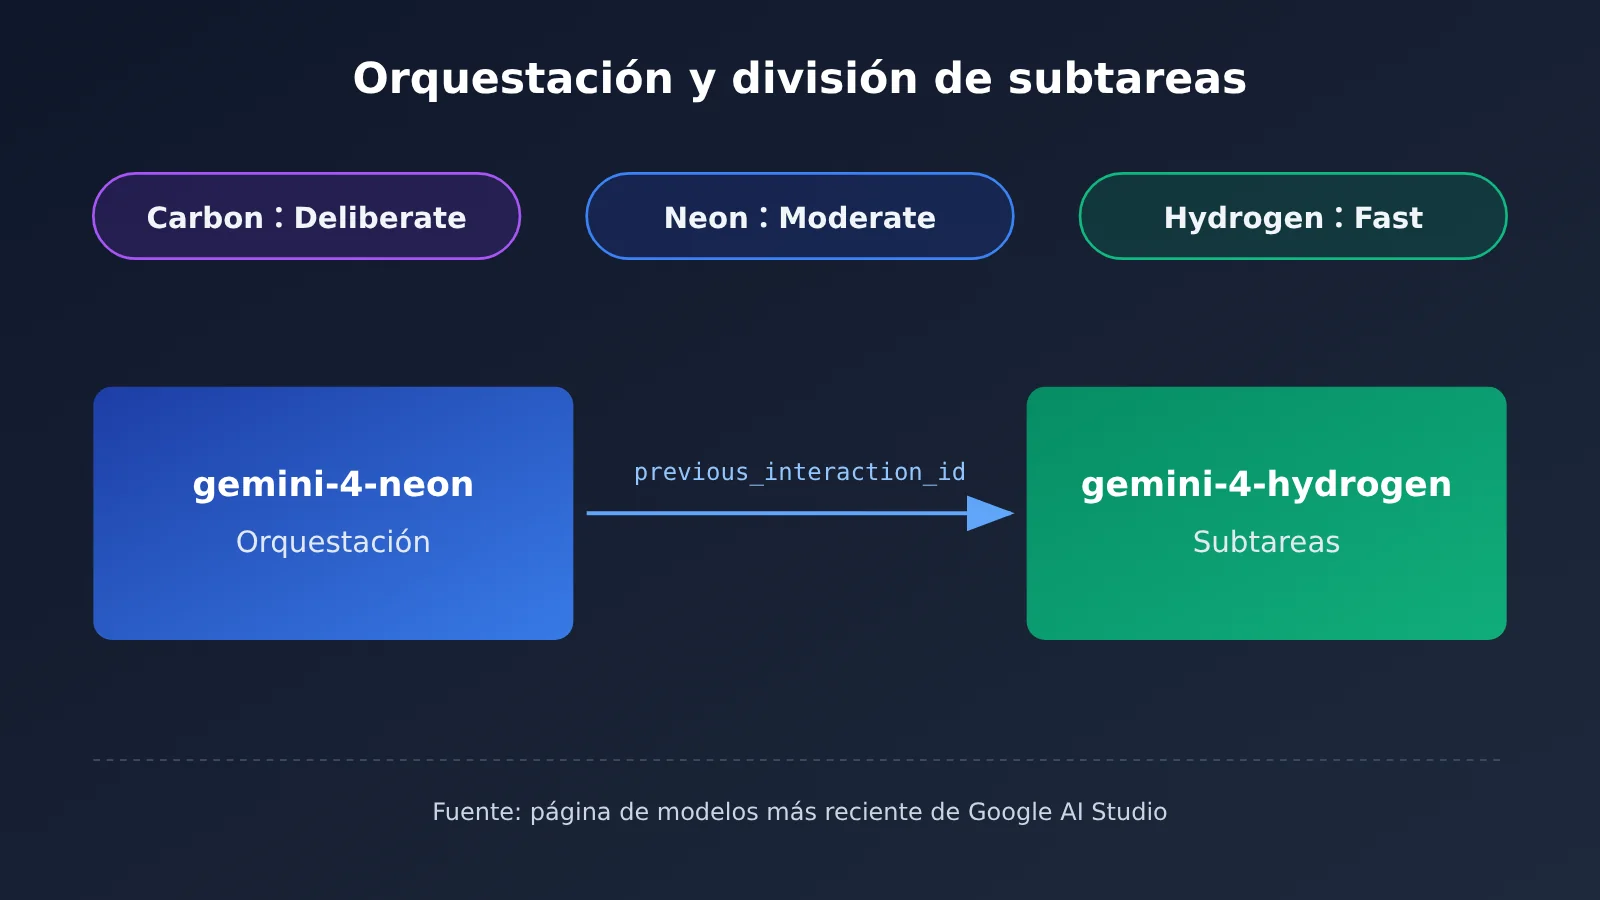
La página de modelos más reciente de Google AI Studio asigna etiquetas cualitativas de velocidad a los tres modelos Gemini 4: Carbon es Deliberate, Neon es Moderate y Hydrogen es Fast. Es decir, según la propia calificación oficial, Neon ocupa el punto medio dentro de la familia, mientras que Hydrogen es el que lleva la etiqueta Fast. El blog de Google también sitúa a Carbon como el modelo para las tareas de horizonte largo más difíciles, a Hydrogen como el de ejecución rápida para el día a día y a Neon como el término medio, orientado a flujos complejos de alta frecuencia.
| Modelo | Calificación de velocidad en AI Studio | Nivel de pensamiento | Nivel predeterminado | Posicionamiento en la familia (blog de Google / guía para desarrolladores) |
|---|---|---|---|---|
| Gemini 4 Carbon | Deliberate | low, medium, high | medium | Tareas complejas de horizonte largo |
| Gemini 4 Neon | Moderate | low, medium, high, xhigh | high | Término medio, flujos complejos de alta frecuencia |
| Gemini 4 Hydrogen | Fast | La documentación no lo detalla | La documentación no lo detalla | Ciclo rápido diario |
Capacidades y especificaciones de Gemini 4 Neon
Según la ficha del modelo, Gemini 4 Neon deriva de Gemini 4 Carbon, tiene fecha de corte de conocimiento en marzo de 2026 y acepta texto, imágenes, audio y video como entrada, con una ventana unificada de hasta 1 millón de tokens. La salida síncrona predeterminada admite hasta 64.000 tokens, y la decodificación larga en segundo plano hasta 1 millón de tokens. La guía para desarrolladores de Google Cloud indica que el ID del modelo es gemini-4-neon, con un límite unificado de 1048576 tokens que incluye entrada y salida; la salida, a su vez, comprende pensamiento, llamadas a funciones y respuesta final.
En cuanto a capacidades, el Artificial Analysis Intelligence Index reportado por el propio fabricante es 61 en el nivel xhigh, tercer puesto en la clasificación general, y el blog también reconoce que queda por detrás de modelos más grandes y lentos. La tabla comparativa de la ficha del modelo solo tiene tres columnas: Neon, Claude Opus 5.5 y GPT-6.2 Sol. Los resultados de modelos que no son Gemini se toman por defecto de lo reportado por cada proveedor, así que esa tabla es un resumen oficial, no una nueva medición realizada el mismo día por el mismo laboratorio. La tabla también incluye apartados donde Neon queda por detrás; por ejemplo, en la precisión ajustada por trampas de Terminal-bench 4.1, Opus 5.5 obtiene 65,8 %, por encima del 65,2 % de Neon.
La guía para desarrolladores también propone un patrón de orquestación: usar gemini-4-neon como controlador principal y pasar previous_interaction_id a gemini-4-hydrogen para ejecutar subtareas más rápidas. Si te parece que Neon no es lo bastante rápido, esta vía merece más la pena que limitarse a bajar de nivel (este es nuestro juicio, no una cita literal de la guía).
Datos de velocidad de Gemini 4 Neon: desglose nivel por nivel de los cuatro niveles de razonamiento
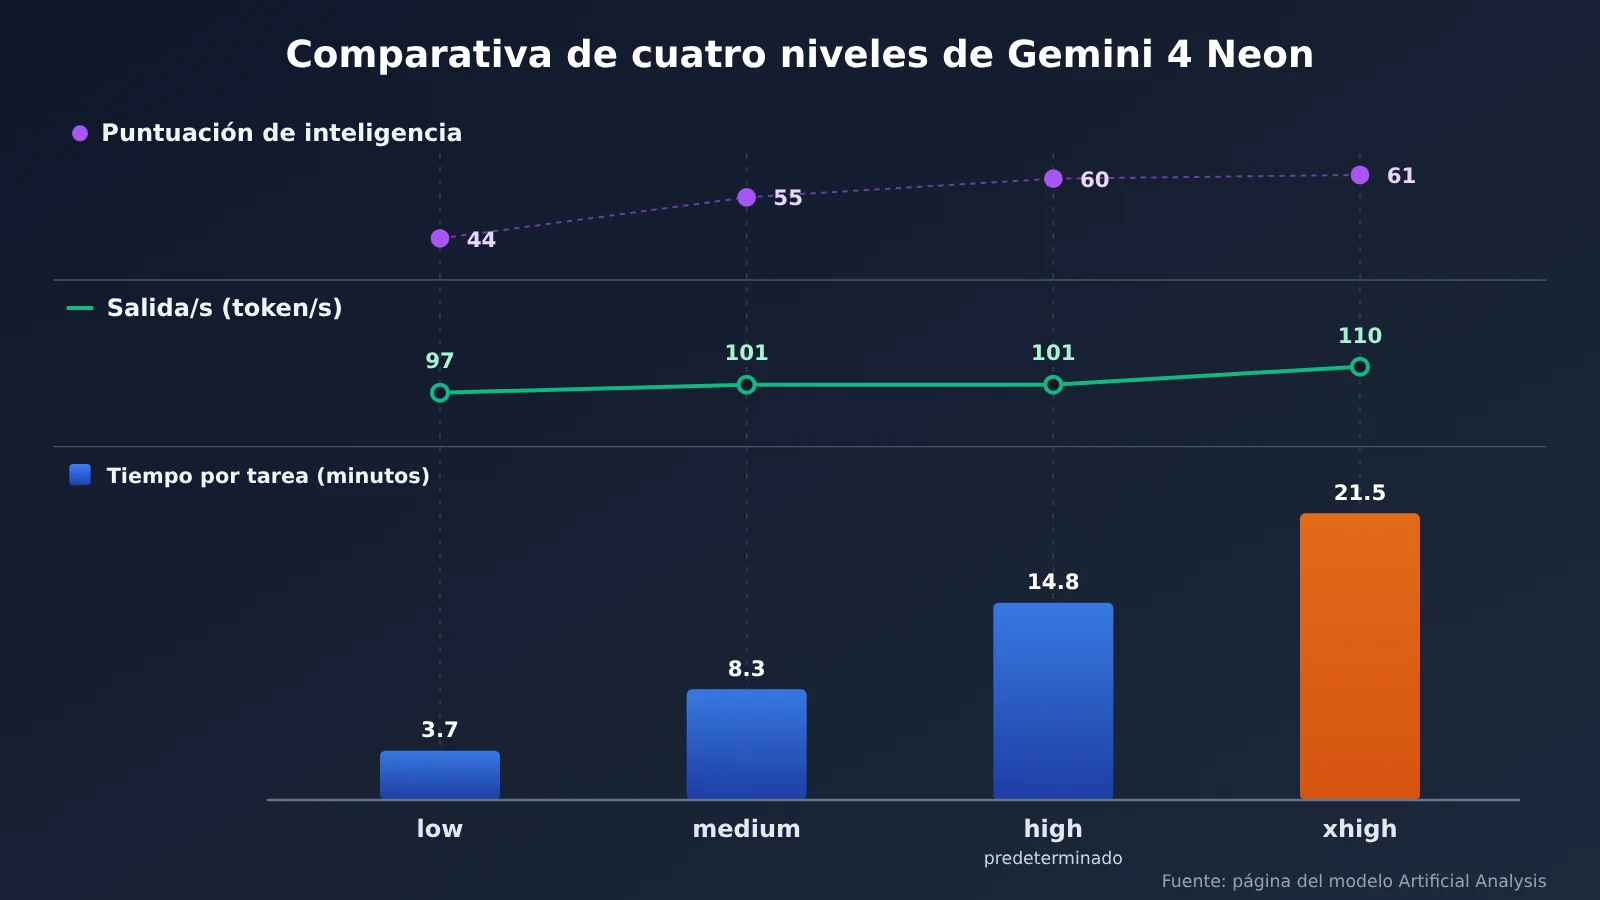
La siguiente tabla proviene de la página del modelo en Artificial Analysis. La última columna, el tiempo hasta el primer token, requiere una aclaración aparte: la tabla resumen de la página solo da los 56.51 segundos de xhigh; los valores de esa columna para high, medium y low proceden de la sección FAQ de esa misma página, no de la tabla resumen. Al citarlos, conserva esta procedencia.
| Nivel de razonamiento | Puntuación de inteligencia | Tiempo por tarea | Salida por segundo | Tiempo hasta el primer token (sección FAQ de la página del modelo) |
|---|---|---|---|---|
| xhigh | 61 | 21.5 minutos | 110 tokens/segundo | 56.51 segundos |
| high (predeterminado) | 60 | 14.8 minutos | 101 tokens/segundo | 40.64 segundos |
| medium | 55 | 8.3 minutos | 101 tokens/segundo | 20.14 segundos |
| low | 44 | 3.7 minutos | 97 tokens/segundo | 13.93 segundos |
Según esta tabla, la salida por segundo de los cuatro niveles apenas oscila entre 97 y 110 tokens/segundo, mientras que el tiempo por tarea pasa de 3.7 a 21.5 minutos. Cambiar de nivel altera principalmente “cuánto hay que pensar” y no tanto “a qué velocidad escribe por segundo”. Esto es una inferencia a partir de las cifras de la tabla; la página del modelo no lo expresa así.
El costo en puntuación también es evidente. Si bajas del high predeterminado (60 puntos) a medium, solo pierdes 5 puntos; si bajas a low, caes hasta 44. xhigh suma 1 punto frente a high, pero el tiempo por tarea aumenta casi 7 minutos. Que merezca la pena depende de tu tarea.
Gemini 4 Neon es más rápido por segundo, pero ¿por qué una tarea puede tardar más de todos modos?
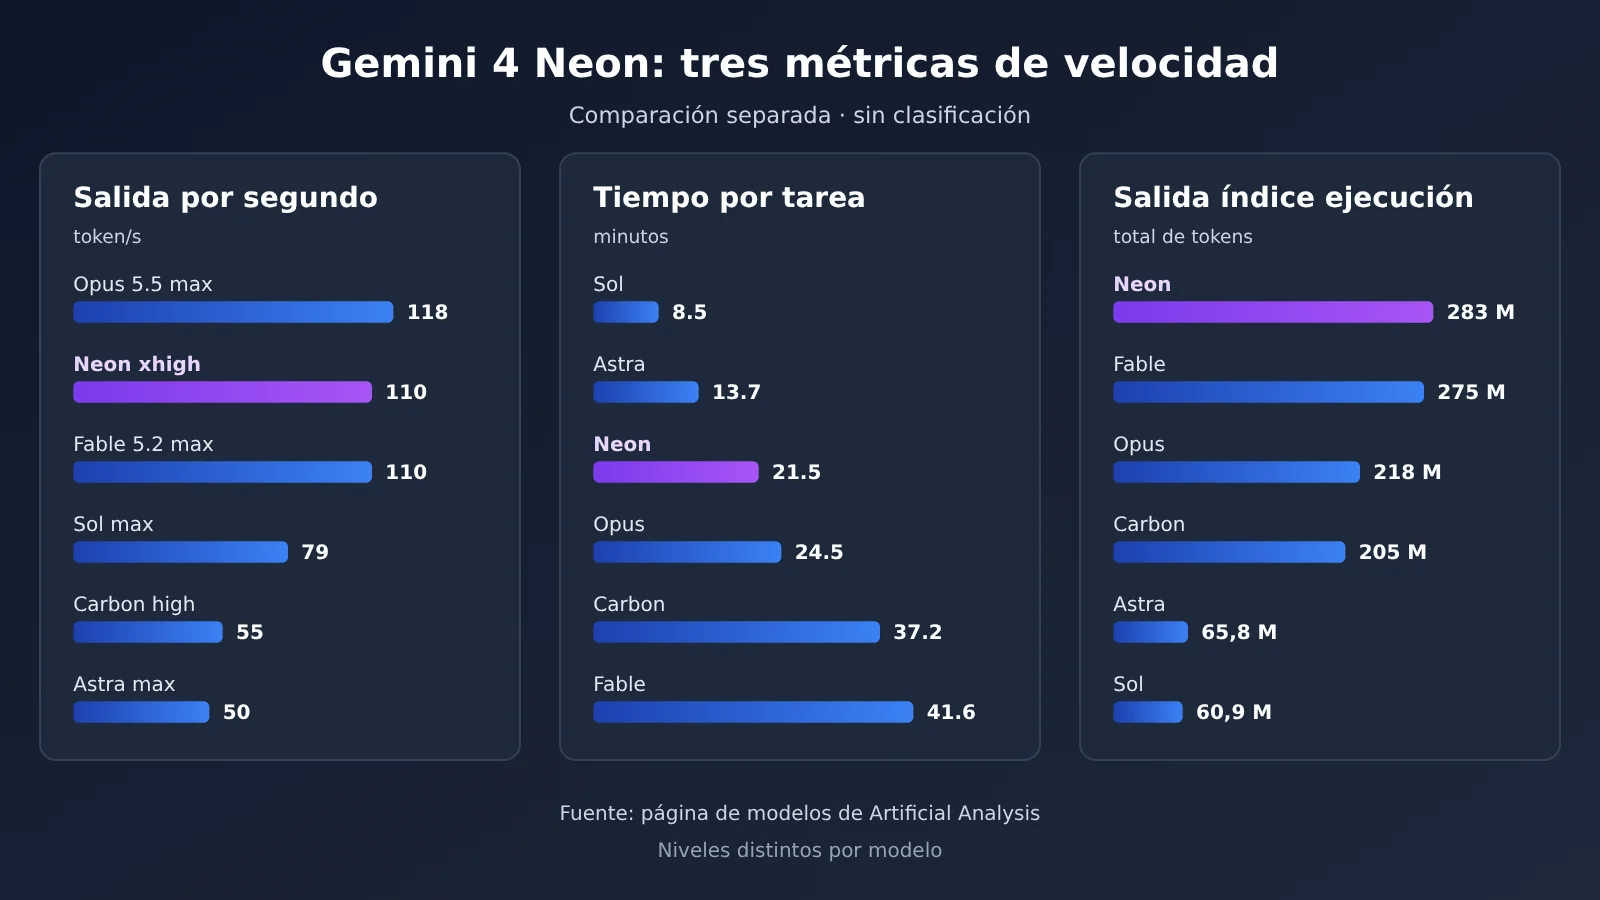
La página del modelo de Artificial Analysis registra que Neon xhigh, al ejecutar toda la suite de índices, produce 283 millones de tokens de salida y 8120 millones de tokens de entrada. Cuantos más tokens genere, aunque sea a 110 por segundo, más se alargará el tiempo total. GPT-6.2 Astra, en el nivel max, solo genera 50 tokens por segundo, pero al ejecutar los índices solo produce 65,8 millones de tokens, y tarda 13,7 minutos por tarea. GPT-6.2 Sol, en el nivel max, genera 79 tokens por segundo, produce 60,9 millones de tokens y tarda 8,5 minutos por tarea.
Así que “más tokens de salida por segundo” y “terminar antes la tarea” son dos cosas distintas. Si comparamos Neon con estos dos GPT, Neon genera más tokens por segundo, pero tarda más por tarea; la razón es que produce muchos más tokens.
Gemini 4 Neon frente a los modelos de referencia: comparación por separado
Todas las cifras de la tabla siguiente salen de las páginas de modelos de Artificial Analysis. Cada modelo usa un nivel de esfuerzo distinto (Neon en xhigh, Carbon en high, el resto en max), así que solo sirven para leer relaciones relativas dentro de una misma columna; no es una carrera en igualdad de condiciones.
| Modelo (nivel) | Puntuación de inteligencia | Tiempo por tarea | Salida por segundo | Tiempo al primer token | Tokens de salida al ejecutar el índice |
|---|---|---|---|---|---|
| Gemini 4 Neon (xhigh) | 61 | 21,5 minutos | 110 | 56,51 segundos | 283 millones |
| Gemini 4 Carbon (high) | 60 | 37,2 minutos | 55 | 73,04 segundos | 205 millones |
| Claude Opus 5.5 (max) | 59 | 24,5 minutos | 118 | 335,85 segundos | 218 millones |
| Claude Fable 5.2 (max) | 65 | 41,6 minutos | 110 | 247,46 segundos | 275 millones |
| GPT-6.2 Astra (max) | 62 | 13,7 minutos | 50 | 197,65 segundos | 65,8 millones |
| GPT-6.2 Sol (max) | 57 | 8,5 minutos | 79 | 75,06 segundos | 60,9 millones |
Vamos indicador por indicador:
- Salida por segundo: Claude Opus 5.5 max alcanza 118 tokens/s, por encima de los 110 de Neon xhigh; Claude Fable 5.2 max también está en 110, igual que Neon.
- Tiempo por tarea: los 8,5 minutos de GPT-6.2 Sol max y los 13,7 minutos de GPT-6.2 Astra max son más cortos que los 21,5 minutos de Neon xhigh.
- Tiempo al primer token: los 56,51 segundos de Neon xhigh son el valor más bajo de la tabla, pero como cada fila usa un nivel de esfuerzo distinto, no se puede concluir a partir de eso que va por delante en todo.
La mejora de velocidad de Neon respecto a Carbon tiene dos versiones de las cifras. La página de modelos de Artificial Analysis atribuye a Carbon high 55 tokens/s y 37,2 minutos. El artículo de Artificial Analysis da números aproximados: Neon tarda alrededor de 21 minutos por tarea, aproximadamente un 40% menos que los ~36 minutos de Carbon; la ganancia viene de la velocidad de salida, unos 110 frente a unos 57 tokens/s, y además Neon produce alrededor de un 15% más tokens de salida por tarea. Las dos series de datos de Carbon no se midieron con el mismo criterio, así que aquí no las restamos.
Cómo empezar rápidamente: selección de niveles de Gemini 4 Neon y método de prueba de velocidad
gemini-4-neon por ahora debe invocarse a través de los canales oficiales de Google. Los pasos siguientes se dividen en dos partes: primero explicamos cómo elegir el nivel de Neon, y luego montamos un flujo de prueba de velocidad con los modelos Gemini 4 ya disponibles en APIYI, de modo que cuando Neon se publique solo haga falta cambiar el ID del modelo.
Paso 1: Entender los cuatro niveles de razonamiento de Neon. La guía para desarrolladores de Google Cloud indica que los niveles de razonamiento de gemini-4-neon son solo low, medium, high y xhigh, con high como valor predeterminado. Pasar thinking_budget o MINIMAL devuelve un HTTP 400, y este es justamente el error en el que cae más fácilmente el código migrado desde una versión anterior de Gemini.
Paso 2: Bajar de nivel según las necesidades de velocidad. Si te parece lento, puedes bajar del high predeterminado a medium o low. Según la página del modelo en Artificial Analysis, el tiempo por tarea pasará de 14.8 minutos en high a 8.3 minutos o 3.7 minutos, mientras que la puntuación de inteligencia caerá del 61 de xhigh (el high predeterminado es 60) a 55 o 44. La caída de puntuación con low es muy grande, así que antes de bajar de nivel conviene hacer un muestreo en tus propias tareas para confirmarlo.
Paso 3: Preparar una cuenta y una clave de APIYI. Regístrate en APIYI apiyi.com y obtén una clave API; coloca la clave en una variable de entorno (por ejemplo APIYI_API_KEY) y en el código lee solo la variable de entorno, nunca escribas la clave en texto plano.
Paso 4: Elegir el método de invocación. Para la interfaz compatible con OpenAI, el base_url es https://api.apiyi.com/v1 y el nombre del modelo es gemini-4-carbon o gemini-4-hydrogen (los ya disponibles); si usas el protocolo nativo de Gemini, la dirección es https://api.apiyi.com y la versión de API v1beta.
Paso 5: Registrar tres métricas por separado. Activa la salida en streaming con stream y anota por separado: el tiempo hasta que llega el primer token de respuesta, los tokens por segundo una vez iniciada la salida, y el tiempo total hasta que termina toda la tarea; además, registra el número total de tokens de salida de esta ejecución. Solo con el número de tokens de salida podrás determinar si el tiempo se debe a «escribir lento» o a «escribir mucho».
🚀 Sugerencia para empezar rápido: conviene probar primero el flujo de medición de velocidad en los modelos Gemini 4 ya disponibles. APIYI cubre con una sola clave las series Gemini, Claude y GPT, y el script que registra las tres métricas, escrito una vez, permite comparar varios modelos de forma horizontal; cuando Neon se publique solo tendrás que cambiar el ID del modelo.
Precio de Gemini 4 Neon y verificación de modelos en APIYI
El precio oficial de Gemini 4 Neon (según la página de precios de Google AI Studio) es de 3 USD por millón de tokens de entrada y 15 USD por millón de tokens de salida.
En APIYI, verificamos dos fuentes: la tabla general de APIYI (docs.apiyi.com/models.md, página con fecha de actualización 2026-11-16 09:39, UTC+8) y la interfaz de precios consultada el 2026-11-19 (api.apiyi.com/api/pricing, versión shell-api-modelmak-v1, 285 modelos en total). Los modelos ya disponibles que se pueden comparar entre ambas fuentes son los siguientes, en USD por millón de tokens.
| ID del modelo | Entrada | Lectura de caché | Salida | Endpoint | Notas (fuente) |
|---|---|---|---|---|---|
gemini-4-carbon |
2 | 0.1 | 10 | chat, gemini | Corresponde al precio introductorio de Google hasta 2026-11-30 (tabla general de APIYI) |
gemini-4-hydrogen |
1.5 | 0.075 | 7.5 | chat, gemini | tabla general de APIYI |
claude-opus-5-5 / claude-opus-5-5-thinking |
4 | 0.2 | 20 | chat, messages | tabla general de APIYI |
claude-fable-5-2 / claude-fable-5-2-thinking |
8 | 0.2 | 40 | chat, messages | tabla general de APIYI |
gpt-6.2-sol |
2 (3 si supera 272000) | 0.1 | 10 (el tramo alto en la interfaz de precios es aprox. 11.25) | responses (recomendado), chat | la tabla general solo indica el cambio de tramo de entrada |
gpt-6.2-astra |
8 (16 si supera 272000) | 0.4 | 40 (el tramo alto en la interfaz de precios es aprox. 60) | responses, chat | la tabla general solo indica el cambio de tramo de entrada |
Hay varios detalles que conviene tener en cuenta. El precio de lista de gemini-4-carbon coincide con el precio introductorio de Google, no con el precio estándar posterior de 4/20. Los nombres de los grupos no coinciden del todo entre las dos fuentes: los modelos Gemini aparecen en la tabla general como Default, SVIP, y en la interfaz de precios como default, svip; los modelos Claude aparecen en la tabla general como ClaudeCode, Claude_Reverse, Claude_Enterprise, Default, SVIP, y en la interfaz de precios como ClaudeCode, ClaudeCodeReverse, ClaudeOfficial, default, svip. El precio de salida del tramo alto de los modelos GPT solo se refleja en la interfaz de precios; en esta, cuando se superan 272000 tokens, CompletionRatio pasa de 5 a 3.75.
gemini-4-neon no está incluido ni en la tabla general de APIYI ni en la interfaz de precios; aún no está disponible, pero lo publicaremos lo antes posible. Los modelos y precios se rigen por la lista de modelos de la plataforma.
Análisis de ventajas y desventajas de Gemini 4 Neon
Ventajas
- Mayor salida por segundo que los modelos anteriores de la familia: la página del modelo en Artificial Analysis muestra Neon xhigh a 110 tokens/s, mientras que Carbon high está en 55 tokens/s.
- Menor espera hasta el primer token: en xhigh, el primer token tarda 56.51 segundos, el valor más bajo en la tabla comparativa anterior (aunque las configuraciones son distintas, así que solo sirve como referencia).
- Niveles de razonamiento granulares: cuatro niveles, desde 3.7 minutos en low hasta 21.5 minutos en xhigh, para elegir según la tarea.
- Especificaciones completas: la ficha del modelo indica entradas de texto, imagen, audio y video, y una ventana unificada de 1 millón de tokens; la guía para desarrolladores señala que la caché implícita se activa automáticamente para prefijos compartidos de más de 4096 tokens.
Limitaciones
- Genera demasiados tokens de salida: la ejecución del benchmark consumió 283 millones de tokens de salida, lo que hace que una sola tarea en xhigh tarde más que en Sol y Astra. La solución es bajar de nivel o delegar las subtareas a Hydrogen.
- La clasificación oficial es solo Moderate: AI Studio asignó la etiqueta Fast a Hydrogen; si buscas la interacción más rápida, deberías probar Hydrogen primero.
- Algunas configuraciones no son compatibles: la guía para desarrolladores indica que no se admite la caché de contexto explícita, y que
thinking_budgetyMINIMALdevolverán400. - No hay nivel gratuito: la página de precios de AI Studio indica que
gemini-4-neonno tiene nivel gratuito. - Criterios de medición inconsistentes: Coding Agent Index aparece como 58.6 en el blog de Google y como 59 en el artículo de Artificial Analysis; el 12.8% y el 39.0% de SWE-sweep provienen de dos harness distintos. Al leer los datos, asegúrate de comprobar la fuente.
Preguntas frecuentes (FAQ)
P1: ¿Gemini 4 Neon es el más rápido de la familia Gemini 4?
Según la clasificación de la página de modelos más reciente de Google AI Studio, Hydrogen es Fast, Neon es Moderate y Carbon es Deliberate. Cuando la documentación oficial dice que «termina más rápido», se refiere principalmente a la comparación con Carbon.
P2: ¿Cuánto tarda Gemini 4 Neon en emitir el primer token?
La tabla resumen de la página del modelo de Artificial Analysis indica 56.51 segundos hasta el primer token en xhigh. En la sección de FAQ de la misma página se indican por separado high 40.64 segundos, medium 20.14 segundos y low 13.93 segundos; las cifras de estos tres niveles provienen de la sección de FAQ, no de la tabla resumen.
P3: ¿Por qué Gemini 4 Neon genera 110 tokens por segundo y aun así tarda 21.5 minutos por tarea?
Porque genera muchos tokens. La página del modelo de Artificial Analysis registra que, al ejecutar la prueba del índice, Neon xhigh genera 283 millones de tokens, mientras que Sol max genera solo 60.9 millones y Astra max solo 65.8 millones. Por eso los dos últimos son más lentos por segundo, pero completan cada tarea en menos tiempo.
P4: ¿Qué nivel usa Gemini 4 Neon por defecto? ¿Cómo ajustarlo si quiero ir más rápido?
La guía para desarrolladores indica que el valor predeterminado es high. Si quieres ir más rápido, puedes bajar a medium o low; según la página del modelo de Artificial Analysis, el tiempo por tarea sería de 8.3 minutos y 3.7 minutos respectivamente, y la puntuación de inteligencia bajaría de 61 en xhigh (60 en high) a 55 o 44.
P5: ¿Ya se puede invocar Gemini 4 Neon a través de APIYI?
A fecha de 2026-11-19, `gemini-4-neon` todavía no aparece en la tabla general ni en la interfaz de precios de APIYI; aún no está disponible, pero lo publicaremos lo antes posible. Por ahora puedes registrarte en apiyi.com y preparar tu flujo de pruebas de velocidad con `gemini-4-carbon` o `gemini-4-hydrogen`, que ya están disponibles; la URL compatible con OpenAI es la misma que se muestra en la sección de inicio rápido anterior.
P6: ¿Cuánto más barato es Gemini 4 Neon que Carbon?
Hay tres cifras en juego: el blog de Google afirma que, con high por defecto, el coste por tarea es 32% menor que el de Carbon; un artículo de Artificial Analysis dice que es aproximadamente 17% más barato que el precio sin descuento de Carbon; y la página del modelo de Artificial Analysis, usando el precio introductorio, calcula 4.90 dólares por tarea para Carbon en high. Los tres usan criterios diferentes y no se pueden combinar en una sola cifra.
P7: ¿Se pueden comparar directamente los resultados de benchmark de Gemini 4 Neon con los de la competencia?
Hay que tener cuidado. La ficha del modelo indica que los resultados de modelos que no son Gemini provienen, por defecto, de lo que reporta cada proveedor; forman parte de un resumen oficial, no de una repetición de pruebas el mismo día. Además, en la comparación de Artificial Analysis hay diferencias de nivel (xhigh, high y max aparecen mezclados).
Puntos clave de Gemini 4 Neon
- La velocidad se mide de tres formas: el tiempo hasta el primer token, los tokens por segundo y el tiempo por tarea son independientes, y sus rankings pueden contradecirse entre sí.
- La clasificación oficial es intermedia: AI Studio marca Neon como Moderate, mientras que Hydrogen es el que figura como Fast.
- Datos de xhigh: la página del modelo en Artificial Analysis reporta 61 puntos, 21.5 minutos, 110 tokens por segundo y 56.51 segundos hasta el primer token.
- El volumen de salida alarga el tiempo: 283 millones de tokens de salida hacen que el tiempo por tarea de Neon sea mayor que el de Sol y Astra.
- No tiene la mayor salida por segundo: los 118 tokens por segundo de Opus 5.5 max superan los 110 de Neon.
- Bajar de nivel para ganar velocidad: medium: 8.3 minutos y 55 puntos; low: 3.7 minutos y 44 puntos; high es el valor predeterminado.
- Disponibilidad actual: APIYI aún no ofrece Neon; por ahora puedes usar los modelos Gemini 4 ya disponibles para preparar el flujo de pruebas de velocidad.
Resumen
Las conclusiones centrales sobre la velocidad de Gemini 4 Neon:
- Frente a Carbon, sí es más rápido: los dos conjuntos de datos de Artificial Analysis muestran que la salida por segundo de Neon es aproximadamente el doble de la de Carbon, y el tiempo por tarea es claramente menor.
- Visto en un contexto más amplio, no lidera en todo: su salida por segundo es inferior a la de Opus 5.5 max, y su tiempo por tarea es mayor que el de Sol max y Astra max.
- Los niveles son el principal ajuste: la salida por segundo cambia poco entre los cuatro niveles; la diferencia de tiempo proviene principalmente de la cantidad de tokens de razonamiento.
Nuestra lectura es: en escenarios interactivos, mira primero el tiempo hasta el primer token; en procesamiento por lotes, el tiempo por tarea; y solo en experiencias de streaming conviene prestar especial atención a la salida por segundo. Si Neon es «suficientemente rápido» depende de cuál de estas métricas te importa. Recomendamos empezar a través de APIYI (apiyi.com) con los modelos Gemini 4 existentes para dejar listo el flujo de registro de las tres métricas; cuando Neon esté disponible, podrás sustituir directamente el modelo y hacer comparaciones.
📚 Referencias
-
Publicación de Sundar Pichai: lanzamiento de Gemini 4 Neon y su alcance de disponibilidad
- Enlace:
x.com/sundarpichai/status/2123167780988125621 - Descripción: el canal de anuncio y la declaración oficial de «terminar antes las cosas»
- Enlace:
-
Blog de Google Introducing Gemini 4 Neon: puntuaciones autodeclaradas oficialmente, precios y posicionamiento dentro de la familia
- Enlace:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-neon - Descripción: todas las cifras son autodeclaradas por la compañía
- Enlace:
-
Ficha del modelo de DeepMind: especificaciones y tabla comparativa de tres columnas
- Enlace:
deepmind.google/models/model-cards/gemini-4-neon/ - Descripción: los resultados que no son de Gemini provienen por defecto de lo que cada empresa declara
- Enlace:
-
Guía para desarrolladores de Google Cloud: ID del modelo, niveles de razonamiento y explicación de errores
- Enlace:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-neon - Descripción: los cuatro niveles de razonamiento, el valor predeterminado high y las condiciones que activan un HTTP 400
- Enlace:
-
Página de precios y de últimos modelos de Google AI Studio: precios oficiales y caracterización de la velocidad
- Enlace:
aistudio.google.com/docs/pricing,aistudio.google.com/docs/latest-model - Descripción: caracterización de los tres niveles Deliberate, Moderate y Fast
- Enlace:
-
Artículo de Artificial Analysis: comparación de terceros entre Neon y Carbon
- Enlace:
artificialanalysis.ai/articles/gemini-4-neon-intelligence-gain - Descripción: cifras aproximadas como unos 21 minutos, unos 36 minutos y unos 57 tokens/segundo
- Enlace:
-
Página del modelo de Artificial Analysis: velocidad de los cuatro niveles y datos de los modelos de comparación
- Enlace:
artificialanalysis.ai/models/gemini-4-neon - Descripción: consultada el 2026-11-19, índice v5.0.1; la sección FAQ incluye además el tiempo hasta el primer token de cada nivel
- Enlace:
-
Tabla general de APIYI: modelos ya disponibles y precios
- Enlace:
docs.apiyi.com/models.md - Descripción: los modelos y precios se rigen por la lista de modelos de la plataforma
- Enlace:
Autor: Equipo técnico de APIYI
Contacto técnico: para consultas sobre el progreso de disponibilidad de Gemini 4 Neon y sobre modelos, no duden en contactarnos desde la página principal de APIYI apiyi.com