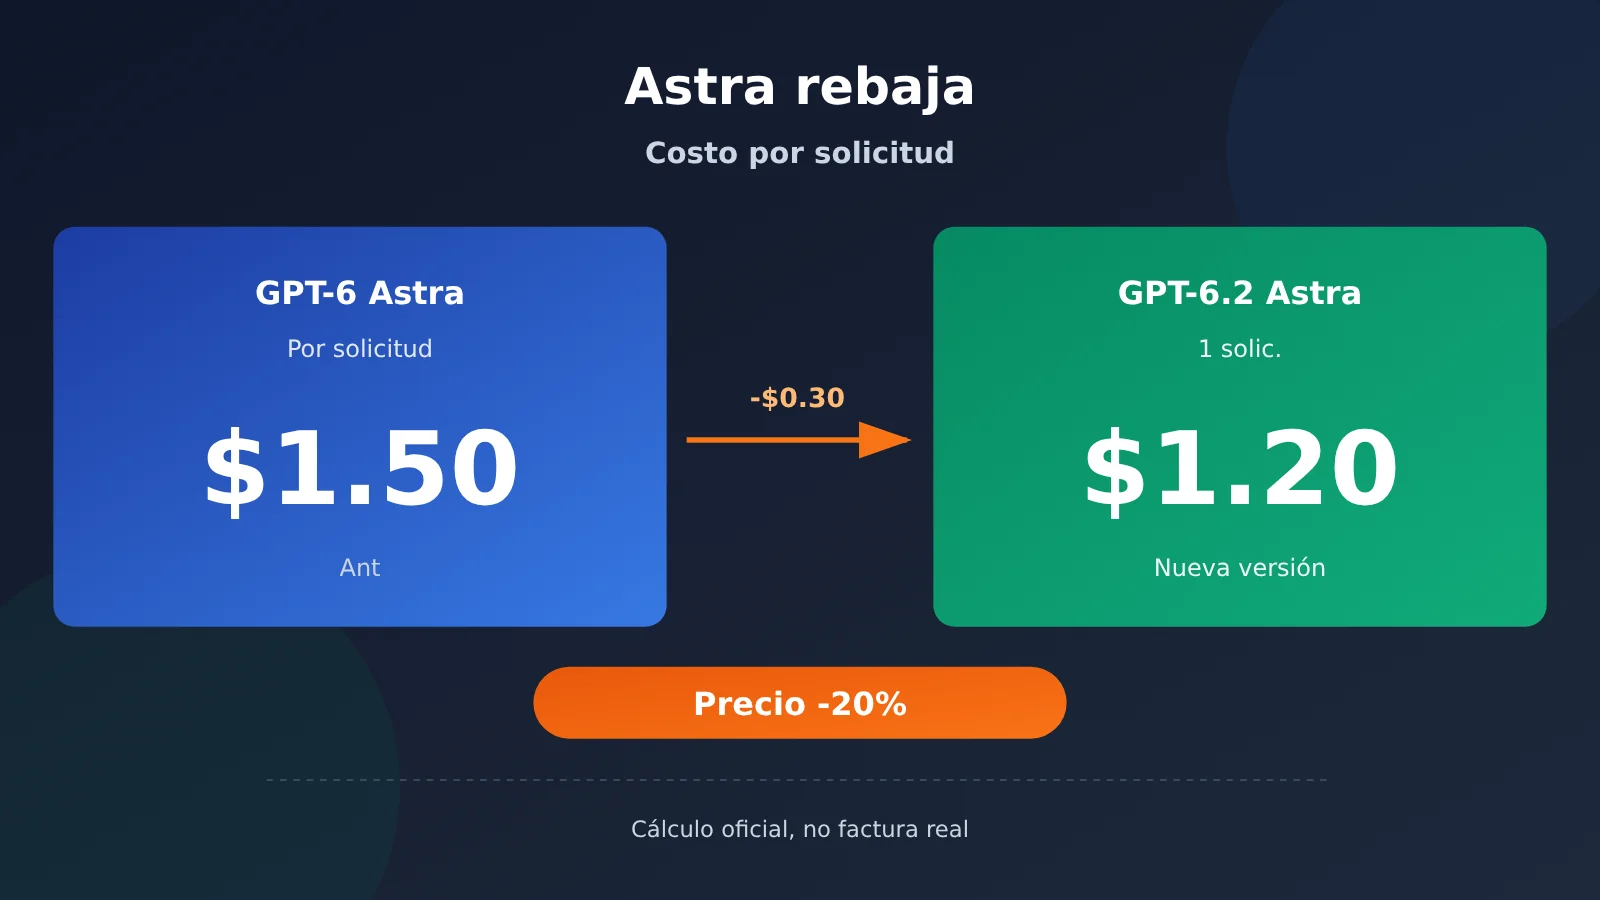
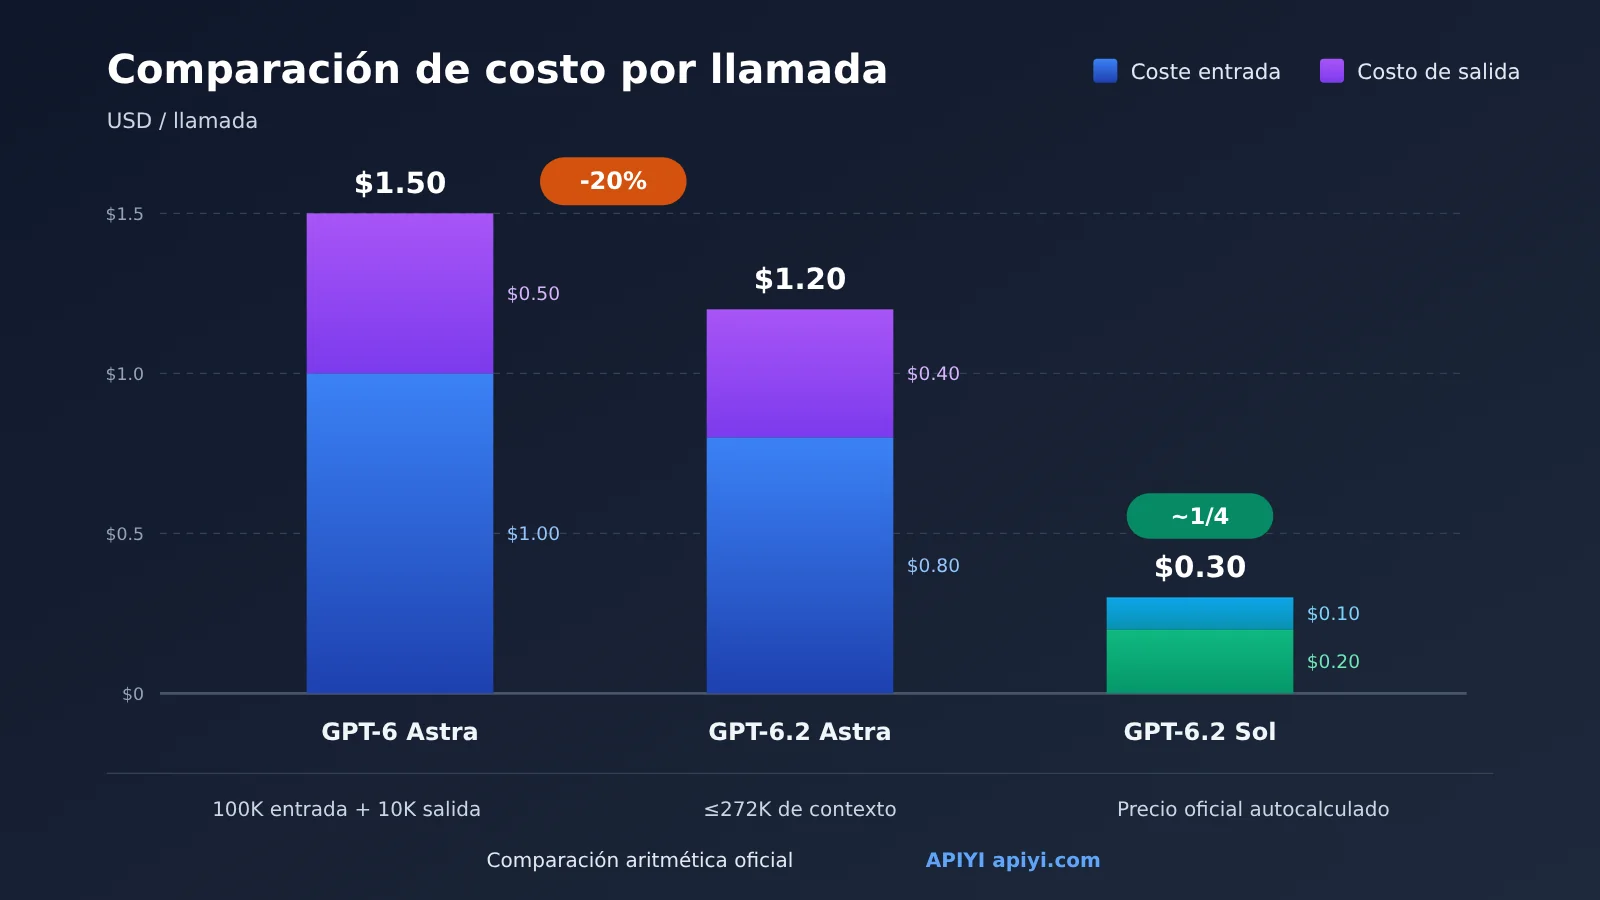
Tomemos como ejemplo una solicitud estándar «sin caché de 100 000 de entrada + 10 000 de salida, con entrada inferior a 272K»: según el precio unitario oficial estándar, GPT-6 Astra cuesta aproximadamente $1.50, GPT-6.2 Astra aproximadamente $1.20, es decir, $0.30 menos por solicitud, exactamente un 20%. La misma cantidad de tokens con GPT-6.2 Sol cuesta solo unos $0.30. Cabe señalar que esto es una «reducción del 20% en el precio unitario». Factores como la caché, el escalonamiento de contexto largo, el volumen de salida de inferencia y las llamadas a herramientas afectan el costo final; la factura real no necesariamente baja en la misma proporción del 20%.
¿Qué aprenderá al leer este artículo?
- Cuáles son los precios oficiales estándar de GPT-6.2 Astra y Sol, lanzados por OpenAI el 17 de noviembre de 2026.
- Cómo se calcula el costo de una solicitud API: cada multiplicación, las unidades de conversión y los supuestos previos.
- Cuánto pueden desviar el costo real de la «rebaja del 20%» factores como la lectura de caché, el contexto largo superior a 272K y las variaciones en los tokens de salida.
- Cómo deberían reevaluar los desarrolladores y responsables de presupuesto sus propios costos de invocación.
Índice: este artículo primero presenta el contexto con una tabla conceptual y un resumen rápido de impactos; la primera parte, «Hechos objetivos», recopila la información oficial del lanzamiento, la tabla de precios y las evaluaciones oficiales, y ofrece tres ejemplos de cálculo propio basados en el precio unitario oficial; la segunda parte, «Análisis y juicio», explica la diferencia entre la bajada del precio unitario y la bajada de la factura, ofrece recomendaciones de acción para distintos perfiles y añade un fragmento de código de estimación de costos que se puede ejecutar directamente.
Conceptos clave sobre la rebaja de precio de GPT-6.2 Astra
| Concepto | Breve explicación |
|---|---|
| Token | Unidad básica de facturación y procesamiento de texto del modelo; la API fija el precio «por millón de tokens» |
| Entrada no cacheada | En este artículo, la parte de entrada normal que no se factura ni como lectura de caché ni como escritura de caché |
| Lectura de caché | La parte de la solicitud que acierta en la caché de indicaciones; su precio unitario es muy inferior al de la entrada no cacheada |
| Escritura de caché | Los tokens escritos usan una tarifa total independiente; el mismo token ya no acumula la tarifa de entrada normal |
| Escalón de contexto largo | Cuando la entrada supera los 272K tokens, las tarifas de entrada y caché de toda la solicitud se duplican, y la tarifa de salida pasa a ser 1,5 veces |
| Nivel de razonamiento | La intensidad de razonamiento que el modelo dedica antes de responder; cuanto más alto el nivel, normalmente más tokens consume |
| GDPval v2 / ALE / FrontierCode 2.0 | Tres evaluaciones citadas por OpenAI en el anuncio; sus objetos y criterios son distintos, y los resultados no se pueden convertir entre sí |
Vista rápida del impacto de la rebaja del 20% en GPT-6.2 Astra
| Perfil | Impacto principal |
|---|---|
| Desarrolladores de API | En solicitudes de longitud normal, los precios unitarios de entrada y salida de Astra bajan un 20%, y el coste de un mismo volumen de invocaciones se reduce en consecuencia; las solicitudes con contexto muy largo hay que calcularlas aparte |
| Responsables de presupuesto | Pueden recalcular el presupuesto unitario de Astra con ese 20%, pero la reducción real depende de la tasa de acierto de caché, la longitud del contexto y el volumen de salida, así que conviene verificarla con los datos de facturación |
| Equipos en fase de selección | El precio unitario estándar de Sol es aproximadamente 1/4 del de Astra, así que las tareas sensibles al coste ganan una opción que merece la pena evaluar |
| Usuarios habituales de ChatGPT | Esta fase se abre gradualmente a ChatGPT Work, Codex y la API; el Chat normal queda fuera del alcance de este lanzamiento |
I. Hechos objetivos sobre la reducción de precio del 20% de GPT-6.2 Astra
El siguiente contenido proviene de la página oficial de lanzamiento de OpenAI, la documentación del modelo y la página de precios; la fecha de verificación es el 18 de noviembre de 2026. Todos los datos de evaluación son informes oficiales y no son resultados de pruebas realizadas por nuestro equipo.
1.1 Información básica sobre el lanzamiento de GPT-6.2 Astra y Sol
OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol el 17 de noviembre de 2026. Ambos modelos aceptan texto e imágenes como entrada, generan texto como salida y no pueden generar video de forma nativa.
En cuanto a la disponibilidad, OpenAI indica que los nuevos modelos se abrirán gradualmente a usuarios de ChatGPT Work, Codex y API; el Chat estándar no entra en esta fase de lanzamiento. El ritmo específico de disponibilidad se consultará en la documentación de ayuda de OpenAI.
1.2 Precio estándar de la API oficial de GPT-6.2 Astra
La siguiente tabla muestra los precios del nivel Standard oficial de OpenAI, cuando la entrada no supera los 272K tokens. Las unidades son dólares por millón de tokens, y no son las tarifas de APIYI. El volumen de salida se calcula según el total de salida facturable que aparece en usage, e incluye los tokens de razonamiento; no equivale a la longitud del texto visible.
| Modelo | Entrada no cacheada | Lectura de caché | Salida | Fuente de datos |
|---|---|---|---|---|
| GPT-6 Astra (generación anterior) | $10 | $1.00 | $50 | Página del modelo de OpenAI |
| GPT-6.2 Astra | $8 | $0.4 | $40 | Página del modelo / página de precios de OpenAI |
| GPT-6.2 Sol | $2 | $0.1 | $10 | Página del modelo / página de precios de OpenAI |
Hay dos reglas de facturación oficiales que conviene tener en cuenta:
- La escritura en caché se factura con una tarifa total independiente: en Standard con contexto corto, la tarifa de escritura de Astra es de $10 por millón de tokens para 30 minutos y de $20 por millón de tokens para 12 horas; no se trata de un cargo adicional sobre la entrada normal de $8. Un mismo token de entrada debe clasificarse en una sola de estas categorías: entrada normal, lectura de caché o escritura de caché con la vida útil correspondiente. No puede facturarse dos veces.
- Cuando la entrada supera los 272K tokens, las tarifas de entrada y de caché de toda la solicitud se multiplican por 2, y la tarifa de salida por 1.5.
En comparación con la generación anterior, la entrada no cacheada de Astra baja de $10 a $8 y la salida de $50 a $40; ambas caen un 20%. Ese es el significado exacto de «20% de reducción»: el precio unitario estándar baja un 20%.
1.3 Datos oficiales de evaluación de GPT-6.2 Astra (no medidos por este equipo)
OpenAI incluyó varios resultados de evaluación en el anuncio de lanzamiento. Cada evaluación utiliza criterios distintos, por lo que no conviene interpretarlas de forma conjunta:
- GDPval v2: GPT-6.2 Astra supera a GPT-6 Astra en 6,2 puntos porcentuales y genera 22% menos tokens de salida; GPT-6.2 Sol supera a GPT-6.1 Sol en 5,3 puntos porcentuales.
- ALE: GPT-6.2 Astra mejora 5,2 puntos. Esta es otra evaluación y no debe sumarse ni compararse con los puntos porcentuales de GDPval.
- FrontierCode 2.0: en el nivel de razonamiento max, Sol obtiene 0,5 puntos menos que Astra, y el coste de la tarea es aproximadamente 1/5 del de Astra. Esto solo aplica a esta prueba y a este nivel, así que no debe tomarse como una conclusión general sobre costes.
1.4 Ejemplo de cálculo propio del costo por solicitud de GPT-6.2 Astra
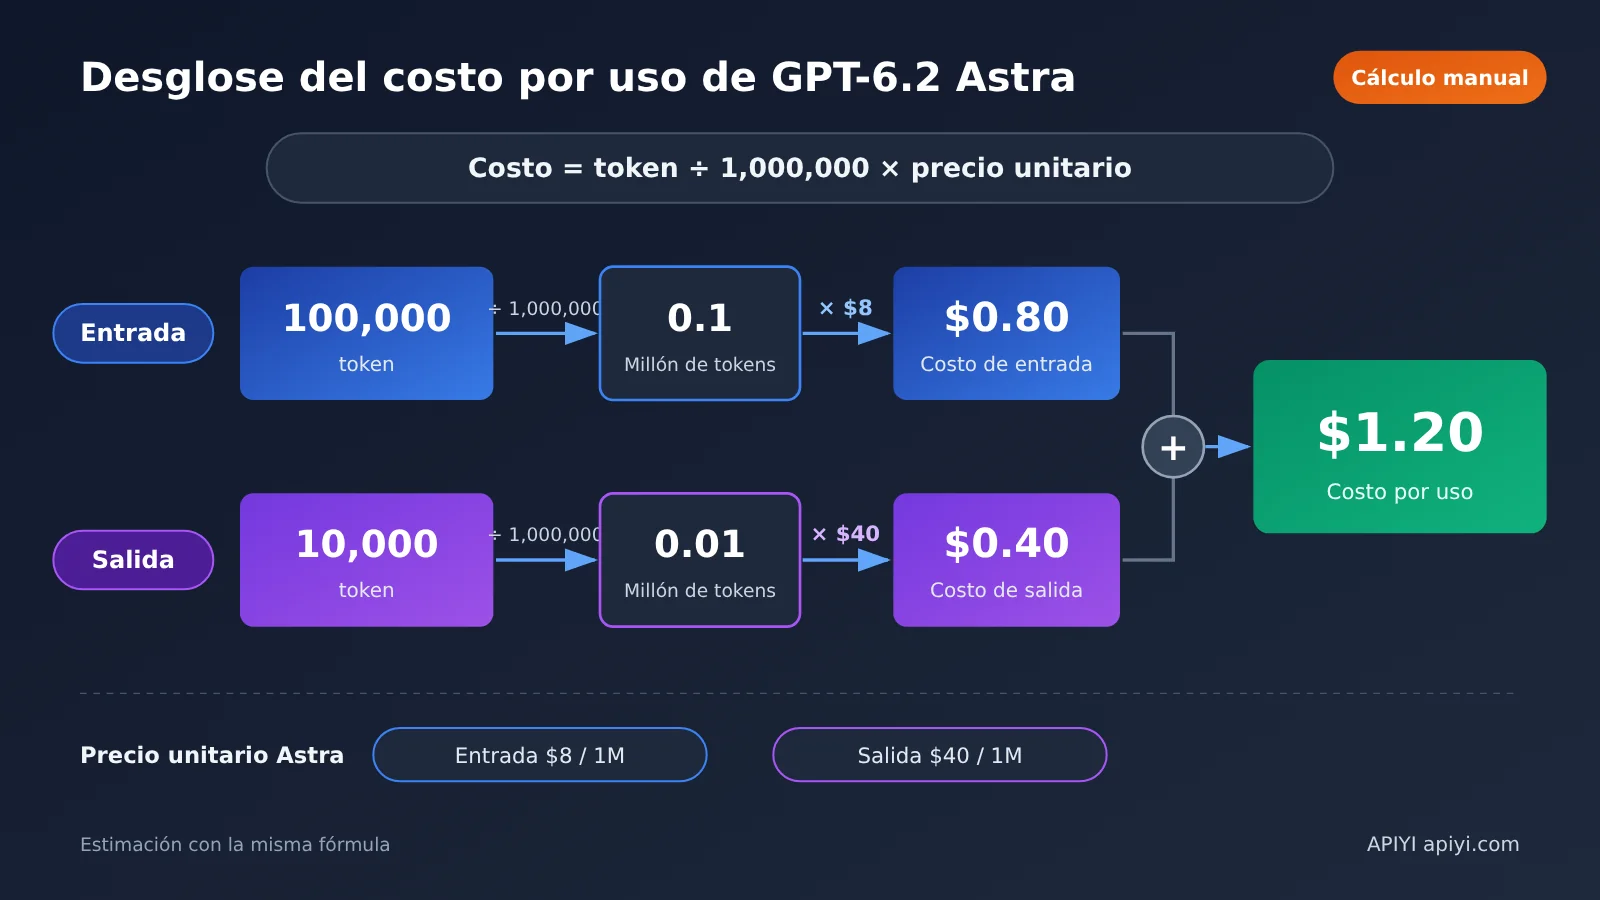
Los siguientes tres ejemplos son cálculos aritméticos hechos por nosotros con los precios estándar publicados en el sitio oficial, no mediciones reales de la API ni representan la factura real de ninguna cuenta. La fórmula es:
Costo = cantidad de tokens ÷ 1,000,000 × precio por millón de tokens
Ejemplo 1: solicitud estándar, comparación entre el Astra anterior y los nuevos Astra y Sol
Supuestos: entrada no cacheada de 100,000 tokens, salida de 10,000 tokens, entrada que no supera 272K, sin lectura ni escritura de caché, sin llamadas a herramientas y facturada a precio estándar.
| Concepto | GPT-6 Astra | GPT-6.2 Astra | GPT-6.2 Sol |
|---|---|---|---|
| Costo de entrada | 0.1 × $10 = $1.00 | 0.1 × $8 = $0.80 | 0.1 × $2 = $0.20 |
| Costo de salida | 0.01 × $50 = $0.50 | 0.01 × $40 = $0.40 | 0.01 × $10 = $0.10 |
| Total por solicitud | $1.50 | $1.20 | $0.30 |
| Respecto a GPT-6 Astra | Referencia | $0.30 menos (-20%) | $1.20 menos (-80%) |
En la tabla, “0.1” se refiere a 100,000 ÷ 1,000,000, y “0.01” a 10,000 ÷ 1,000,000. Si cada mes se envían 10,000 solicitudes iguales, con estos supuestos GPT-6 Astra costaría alrededor de $15,000 y GPT-6.2 Astra, alrededor de $12,000. Este resultado es solo una extrapolación lineal y no constituye ningún compromiso de precio.
Ejemplo 2: solicitud de GPT-6.2 Astra con aciertos de caché
Supuestos: entrada total de 100,000 tokens, de los cuales 80,000 se leen desde la caché y 20,000 son entrada normal que no se escribe en caché; salida de 10,000 tokens. La cantidad escrita en caché de esta solicitud se fija en cero; el costo histórico de creación de la caché no se incluye en este ejemplo.
- Entrada no cacheada: 0.02 × $8 = $0.16
- Lectura de caché: 0.08 × $0.4 = $0.032
- Salida: 0.01 × $40 = $0.40
- Total: aproximadamente $0.592
La generación anterior, GPT-6 Astra, tenía un precio de lectura de caché de $1.00 por millón de tokens; la nueva versión lo tiene en $0.40, una reducción del 60%. Con la misma cantidad de tokens, la generación anterior costaría $0.20 + $0.08 + $0.50 = $0.78; la nueva, $0.592, es decir, $0.188 menos, aproximadamente un 24.1% menos. En ambos casos no se incluyen la escritura de caché, las herramientas ni otros costos, así que no deben considerarse una factura completa.
Ejemplo 3: solicitud de contexto largo de GPT-6.2 Astra que supera 272K
Supuestos: entrada normal de 300,000 tokens (más de 272K), salida de 10,000 tokens, y lectura y escritura de caché iguales a cero.
- Entrada: 0.3 × ($8 × 2) = $4.80
- Salida: 0.01 × ($40 × 1.5) = $0.60
- Total: $5.40
Ten en cuenta que el tramo se calcula sobre la solicitud completa. En cuanto la entrada supera 272K, toda la entrada de esa solicitud se factura al doble de tarifa, no solo la parte que excede el límite.
La configuración de la vida útil de la caché se realiza mediante prompt_cache_options.ttl de la Responses API: el valor predeterminado es "30m", se puede elegir "12h" y un punto de interrupción explícito individual se puede sobrescribir con prompt_cache_breakpoint.ttl. Indica la vida útil mínima de la caché, no un plazo de eliminación de datos, y no debe confundirse con el parámetro prompt_cache_retention de los modelos anteriores.
Cuando la entrada supera los 272K, en el nivel Standard de Astra, la entrada normal, la lectura de caché, la escritura de 30 minutos, la escritura de 12 horas y la salida cuestan $16, $0.80, $20, $40 y $60 por millón de tokens, respectivamente; el multiplicador se aplica a toda la solicitud, no solo a la parte que excede el límite.
1.5 Fuentes oficiales de GPT-6.2 Astra
-
Anuncio de OpenAI: openai.com/index/introducing-gpt-6-2-astra-sol/
- Documentación del modelo GPT-6 Astra: precios oficiales del modelo antiguo
- Documentación del modelo GPT-6.2 Astra: precios oficiales del nuevo modelo y condiciones de tarifa
- Documentación del modelo GPT-6.2 Sol: developers.openai.com/api/docs/models/gpt-6.2-sol
- Página de precios de la API de OpenAI: developers.openai.com/api/docs/pricing
- Documentación de ayuda de ChatGPT Work y Codex: help.openai.com/en/articles/20001275-chatgpt-work-and-codex
II. Análisis y valoración de la rebaja del 20 % en GPT-6.2 Astra
Lo siguiente es la interpretación del editor basada en los hechos anteriores; se trata de análisis y juicio, no de una conclusión oficial.
2.1 El precio unitario baja un 20 %, pero ¿por qué la factura no baja necesariamente un 20 %?
El ejemplo de cálculo 1 arroja exactamente un 20 % porque solo incluye dos partidas: entrada no cacheada y salida estándar, y ambas bajaron justo un 20 %. La factura de un negocio real suele estar compuesta por varios tipos de costes; cualquier cambio en la proporción de una de ellas hará que la reducción total se aleje del 20 %.
| Factor de coste | Posible impacto en la factura real | Base para la valoración |
|---|---|---|
| Lectura y escritura de caché | El precio unitario de lectura de caché baja un 60 %, distinto del 20 % de la entrada no cacheada; debe calcularse según el número de tokens de cada partida, no se puede presuponer una bajada global; la escritura de caché usa una tarifa total independiente y no se suma a la tarifa de entrada normal | Tabla de precios oficial |
| Escalonamiento de contexto largo | Al superar 272K, la tarifa de toda la solicitud sube; en escenarios de documentos largos, el coste por solicitud puede ser notablemente superior al del ejemplo de cálculo 1 | Reglas oficiales de facturación |
| Cantidad de tokens de salida / razonamiento | En GDPval v2 la firma oficial reporta un 22 % menos tokens de salida; si tus tareas muestran un cambio similar, el ahorro podría superar el 20 %; si el nivel de razonamiento es mayor, también podría resultar más caro | Evaluación oficial (tareas específicas) |
| Llamadas a herramientas y niveles de velocidad | La modalidad Fast de GPT-6.2 Astra cuesta el doble de la tarifa Standard con el mismo contexto, y Batch el 50 %; las tarifas de herramientas se calculan aparte según la herramienta utilizada | Página oficial del modelo y página de precios |
| Canal de llamada | Al invocar mediante APIYI apiyi.com u otras plataformas de terceros, rige la facturación real publicada por la plataforma; no se puede aplicar directamente el precio oficial | Diferencias entre canales |
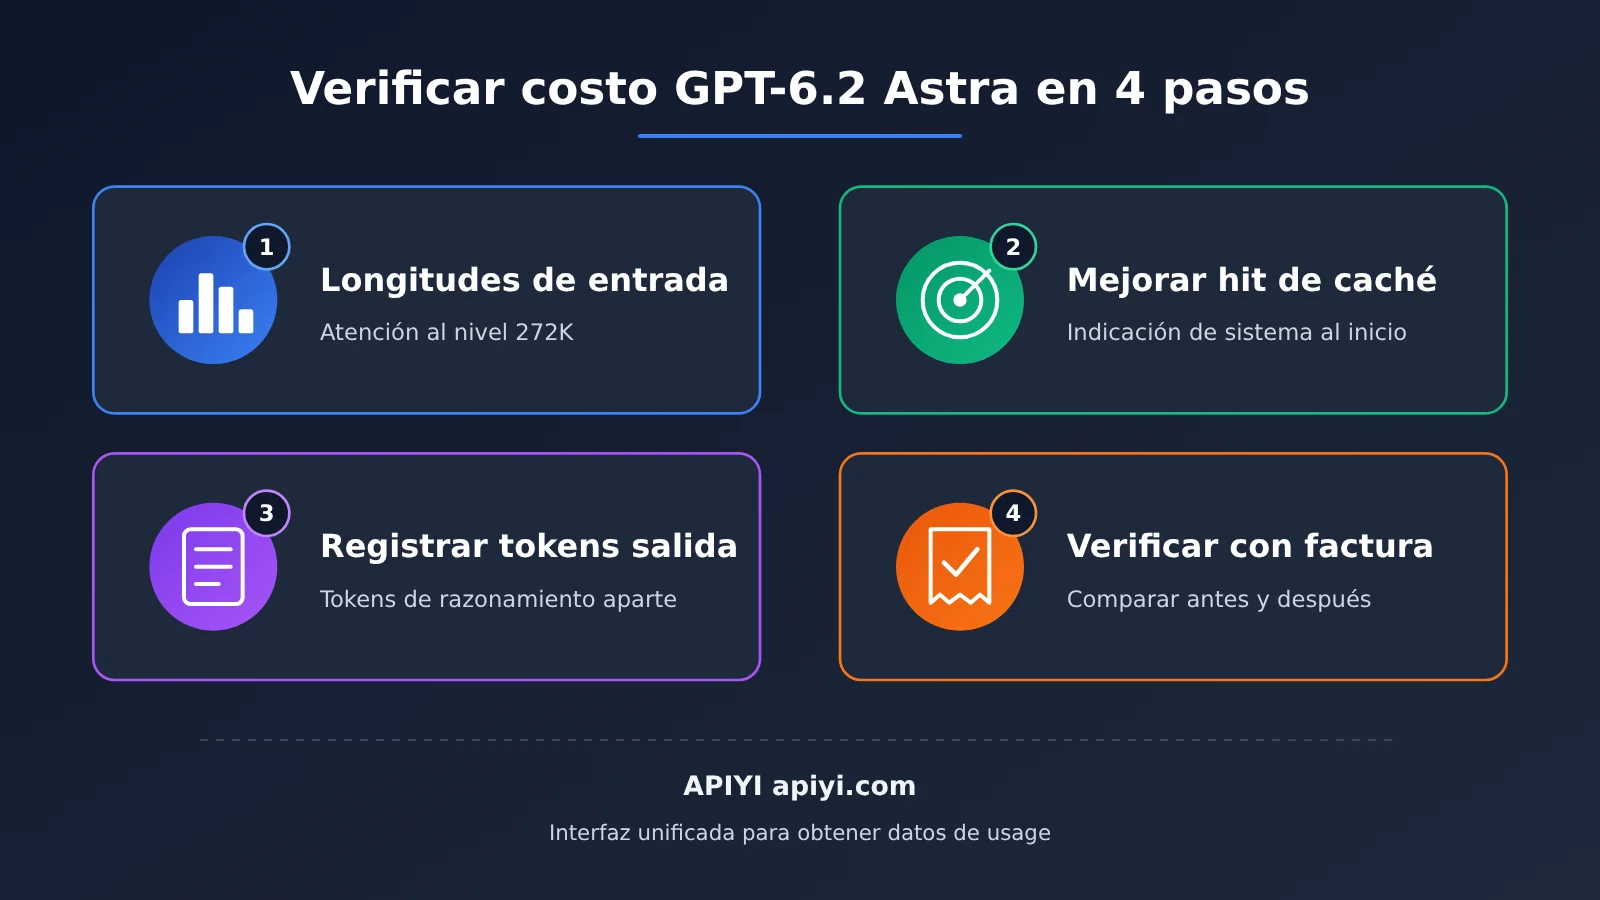
Un punto que se pasa por alto con facilidad es el “22 % menos salida”. Esta cifra procede de la evaluación GDPval v2; si se aplica directamente a todos los negocios y se concluye que “se ahorra más del 30 % en la práctica”, se estará tomando un resultado oficial de una evaluación específica como si fuera una regla general. Lo más prudente es hacer una prueba con una muestra pequeña usando tus propias solicitudes reales, registrar el número de tokens en el campo usage y después decidir.
2.2 Criterios de selección entre GPT-6.2 Astra y Sol
Si miramos el precio unitario estándar, cada uno de los precios de Sol ronda 1/4 del de Astra. En el ejemplo de cálculo 1, el costo por uso de Sol era apenas una cuarta parte del de Astra. Los resultados de FrontierCode 2.0 muestran que, en el nivel de razonamiento max, la diferencia entre Sol y Astra es muy pequeña, pero la documentación oficial no aclara si esta conclusión puede extrapolarse a otras tareas.
Por eso nuestra lectura es la siguiente: en escenarios sensibles al costo y con dificultad media, vale la pena evaluar Sol primero; en escenarios donde se exige alta calidad o las tareas son complejas, el umbral de Astra también ha bajado tras la reducción de precio. La decisión final sobre cuál elegir debería tomarse con una comparación A/B usando tu propio conjunto de tareas.
💡 Recomendación de selección: si necesitas comparar, dentro de un mismo código, el consumo de tokens y la calidad de salida de varios modelos, puedes considerar cambiar de modelo a través de interfaces agregadoras compatibles con OpenAI como APIYI apiyi.com. Si la serie GPT-6.2 ya está disponible en la plataforma y a qué precio, consúltalo en la lista de modelos y la página de facturación de la plataforma.
2.3 Código de estimación de costos de GPT-6.2 Astra
El siguiente script solo realiza aritmética local, no llama a la interfaz. Divide la entrada en cuatro categorías mutuamente excluyentes: entrada normal, lectura de caché, escritura de 30 minutos y escritura de 12 horas; el volumen total de entrada se usa para determinar el tramo de 272K. La tarifa de escritura es la tarifa total, así que no se suma la tarifa de entrada normal encima de los tokens de escritura.
# Tarifas estándar de OpenAI, USD por millón de tokens; no incluye herramientas, impuestos ni otros cargos por tramo
PRICES = {
    "gpt-6-astra":   {"input": 10.0, "cached": 1.0, "output": 50.0},
    "gpt-6.2-astra": {"input": 8.0, "cached": 0.4, "output": 40.0},
    "gpt-6.2-sol":   {"input": 2.0, "cached": 0.1, "output": 10.0},
}

def estimate_cost(model, ordinary_input, output_tokens, cached_read=0,
                  write_30m=0, write_12h=0):
    counts = (ordinary_input, output_tokens, cached_read, write_30m, write_12h)
    if any(n < 0 for n in counts):
        raise ValueError("token 数不得为负")
    p = PRICES[model]
    total_input = ordinary_input + cached_read + write_30m + write_12h
    im, om = (2.0, 1.5) if total_input > 272_000 else (1.0, 1.0)
    input_cost = (ordinary_input * p["input"] + cached_read * p["cached"]
                  + write_30m * p["input"] * 1.25
                  + write_12h * p["input"] * 2.5) * im
    return round((input_cost + output_tokens * p["output"] * om) / 1e6, 6)

print(estimate_cost("gpt-6-astra", 100_000, 10_000))  # 1.5
print(estimate_cost("gpt-6.2-astra", 100_000, 10_000))  # 1.2
print(estimate_cost("gpt-6.2-sol", 100_000, 10_000))  # 0.3
print(estimate_cost("gpt-6.2-astra", 20_000, 10_000, cached_read=80_000))  # 0.592
# Los mismos 100 000 de entrada facturados todos como escritura de 30 minutos: no es 1.2 más otro 1.0
print(estimate_cost("gpt-6.2-astra", 0, 10_000, write_30m=100_000))  # 1.4
Para el usage de Responses, primero hay que identificar el volumen de lectura de caché y el de escritura, y luego restar ambos del total de entrada para obtener la entrada normal. Cuando se mezclan vidas útiles de 30 minutos y 12 horas, también hay que distribuir el volumen de escritura según el desglose real de facturación; no se puede aplicar una sola tarifa a todas las escrituras. Si el canal no dispone del desglose de escritura o si el criterio de facturación es distinto, verifíquelo con la factura de ese canal; no conviene asumir por defecto que el volumen de escritura es cero. Cuando la salida facturable incluye tokens de razonamiento, no vuelva a sumar el volumen de razonamiento. Este artículo no realiza llamadas reales a la API; que las plataformas de terceros admitan estas configuraciones y cómo cobren depende de su documentación.
2.4 Recomendaciones tras la rebaja de precio de GPT-6.2 Astra
Para desarrolladores: primero conviene analizar la distribución de longitudes de entrada de las solicitudes actuales, para ver cuántas se acercan o superan las 272K. Si la proporción de solicitudes con contexto largo es alta, se puede mantener la entrada dentro de los escalones mediante recuperación por fragmentos, compresión con resúmenes, etc.; el ahorro podría ser incluso mayor que el de una rebaja del 20%. Al mismo tiempo, colocar la indicación de sistema fija al inicio de la solicitud ayuda a aumentar la tasa de aciertos de caché.
Para responsables de presupuesto: la «caída del 20% en el precio unitario estándar de Astra» puede usarse como referencia presupuestaria para el mismo volumen de entrada y salida sin caché, no como el límite máximo real de la reducción ni como un ahorro garantizado. Se recomienda comparar las facturas reales de un período antes y otro después de la migración, desglosando por separado los cambios en caché, contexto largo y tokens de salida. Los equipos que invocan a través de plataformas como APIYI apiyi.com también deben atenerse a los criterios de facturación de la plataforma.
Cambios posteriores a los que seguir prestando atención: las actualizaciones oficiales de precios, el avance de la apertura de canales y si las evaluaciones independientes de terceros logran reproducir los datos oficiales. La documentación oficial ya detalla las tarifas de escritura de caché y de los niveles de velocidad, por lo que al estimar hay que verificar el nivel elegido y no tratarlas como si aún no estuvieran publicadas. El nuevo Astra, en Standard con contexto corto, cobra $10 por millón de tokens por escritura de caché con retención de 30 minutos, y $20 por millón de tokens con 12 horas; los tres cálculos principales de este artículo asumen un volumen de escritura de caché igual a cero, lo que no significa que las solicitudes API por defecto necesariamente no tengan escritura.
Si primero se quiere validar el flujo de verificación de facturación, se puede usar el mismo código en APIYI apiyi.com para comparar los datos de usage de distintos modelos. Cuando la serie GPT-6.2 esté disponible en el canal que uses, bastará introducir los números reales de tokens en las funciones de estimación anteriores.
Una rebaja del 20% es una señal clara, pero la cifra en la factura depende de cuánto mide la entrada de cada solicitud, cuántos aciertos de caché hay y cuánto se genera de salida. Tener clara cada multiplicación es más útil que memorizar un porcentaje.
«Beware of little expenses; a small leak will sink a great ship.»
——Benjamin Franklin, Poor Richard’s Almanack
(Cuidado con los pequeños gastos; una pequeña fuga basta para hundir un gran barco.)