Nota del autor: desglosamos en tres capas — el ranking integral de terceros, las tareas individuales autodeclaradas por el fabricante y el precio de lista — de GPT-6.2 Astra y Claude Fable 5.2, para explicar con claridad la diferencia en la lectura de caché y cuál de los dos se puede invocar hoy en APIYI.
El 17 de noviembre de 2026, OpenAI lanzó GPT-6.2 Astra y GPT-6.2 Sol. Aproximadamente una semana antes, el 9 de noviembre de 2026, la documentación de Anthropic publicó Claude Fable 5.2. El precio de lista de entrada y salida en contexto corto de ambas flagships es de 8 dólares y 40 dólares por cada millón de tokens, así que la discusión sobre cuál elegir se concentró naturalmente entre GPT-6.2 Astra y Claude Fable 5.2.
El problema es que los dos tipos de rankings apuntan en direcciones distintas. En el índice integral de Artificial Analysis, una entidad externa, Fable 5.2 obtiene una puntuación más alta. En varias tareas especializadas autodeclaradas en el comunicado de OpenAI, Astra va por delante y, además, el costo por tarea que reporta la propia empresa es más bajo. Si se mezclan ambos conjuntos de cifras, se llega a una conclusión de «quién es más fuerte», pero esa conclusión no se sostiene con los datos de ninguno de los dos lados.
Este no es un artículo que declara a un ganador. Aquí dividimos las cifras en tres capas: el ranking integral de terceros, las tareas individuales autodeclaradas por el fabricante y el precio de lista oficial. Cada capa se analiza por separado y, al final, aclaramos cuál de los modelos se puede invocar hoy en APIYI.
Valor central: al terminar de leer, podrás consultar el ranking que corresponda según la tarea que te interese, ver con claridad la diferencia en el precio de lectura de caché y saber cuál es el estado de acceso actual de cada uno de los dos modelos.
GPT-6.2 Astra y Claude Fable 5.2: lo esencial — no mezclar tres niveles de cifras
Al comparar GPT-6.2 Astra con Claude Fable 5.2, el error más habitual es juntar cifras de orígenes distintos dentro de una misma conclusión. La tabla siguiente separa primero de dónde sale cada nivel de información y cómo debe leerse.
| Nivel de cifra | Naturaleza de la fuente | Qué dirección muestra este nivel | Ojo al usarlo |
|---|---|---|---|
| Ranking agregado | Tercero independiente: Artificial Analysis, Intelligence Index v5.0.1 | Fable 5.2: 65; Astra (Max): 62 | Hay que indicar siempre el nivel de razonamiento, porque las puntuaciones cambian mucho entre niveles |
| Tareas puntuales | Datos autodeclarados por OpenAI en su nota de publicación; AA-3D es una evaluación ciega de terceros retransmitida por la propia OpenAI | Astra va por delante en Agents’ Last Exam, Harvey LAB-AA y AA-3D | En el ranking ALE, Fable no incluye las nueve tareas de modelos de respaldo |
| Precio de lista | Páginas y documentación oficiales de ambos modelos | Entrada y salida al mismo precio; la lectura de caché es más barata en Fable | El tiempo de retención de la escritura en caché no es el mismo, y las reglas de contexto largo también difieren |
¿Por qué GPT-6.2 Astra y Claude Fable 5.2 «lideran» cada uno en algo distinto?
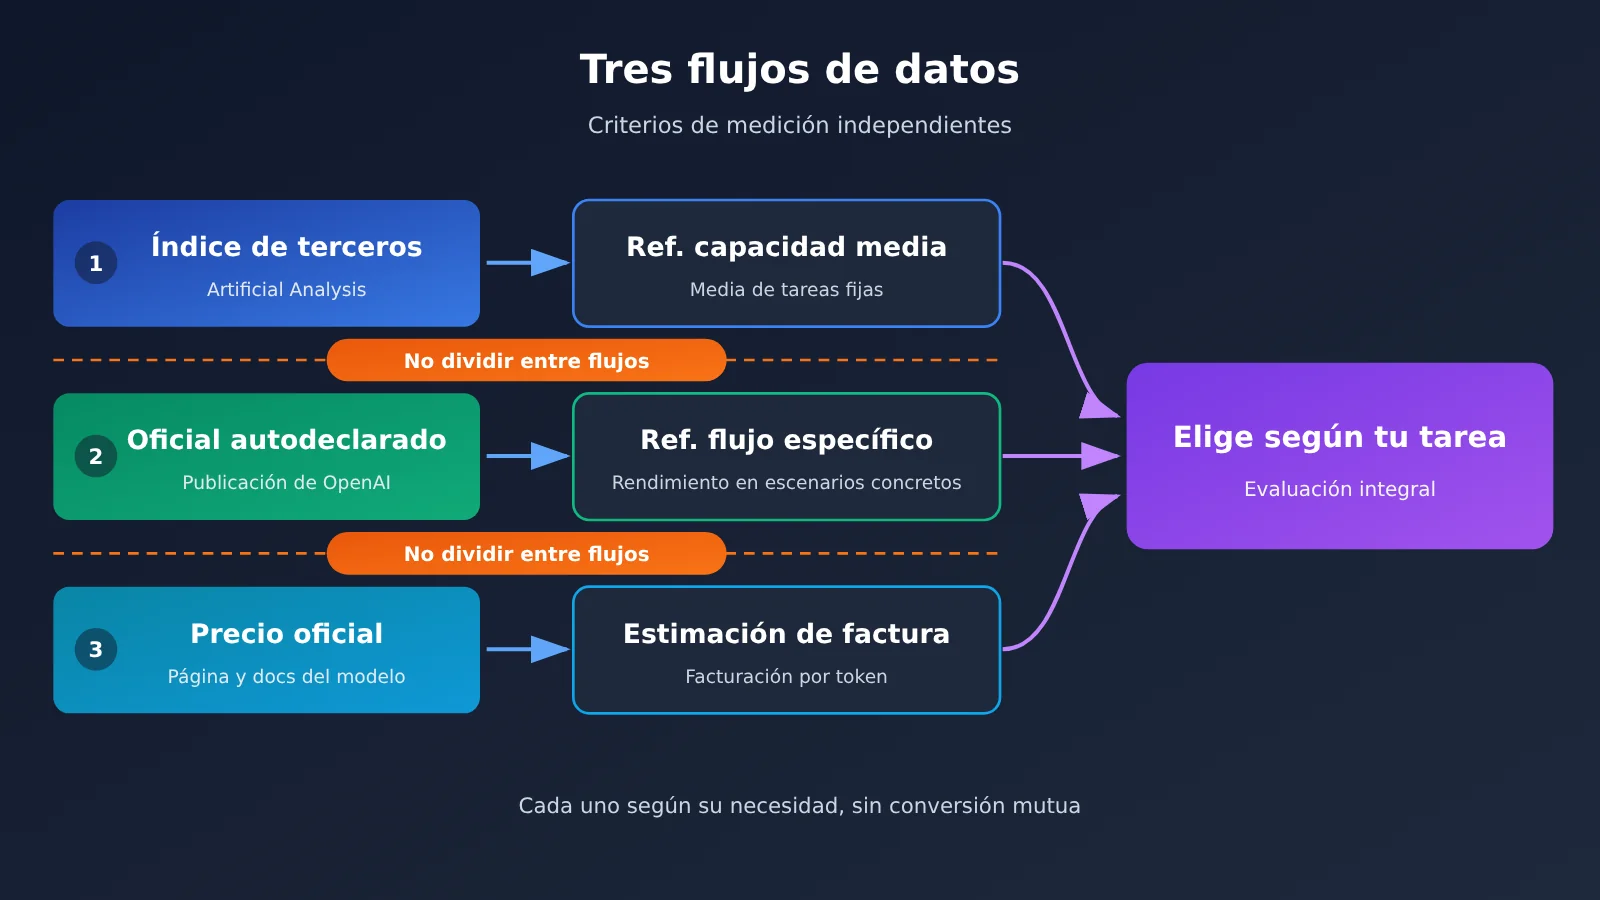
El índice agregado mide el rendimiento promedio sobre un conjunto fijo de tareas, con pesos definidos por el tercero. La nota de OpenAI, en cambio, selecciona escenarios concretos —flujos de trabajo profesional de largo recorrido, legal, generación 3D— y la configuración de las pruebas la decide la propia compañía. Son preguntas distintas desde el punto de partida: una mira el promedio, la otra mira el desempeño dentro de un flujo de trabajo específico. Que las conclusiones no coincidan no significa que los datos de un lado estén mal.
Con el costo pasa lo mismo. El «costo por tarea» que publica Artificial Analysis es lo que cuesta ejecutar las tareas de su índice agregado. Eso de que «el costo en ALE ronda el 5% del de Fable», que menciona OpenAI, corresponde a otro conjunto de tareas y a otra forma de medir. Esas dos cifras no se pueden dividir entre sí ni convertirse la una en la otra.
Diferencias clave entre GPT-6.2 Astra y Claude Fable 5.2: ranking integral de terceros
Artificial Analysis publicó un artículo con fecha 2026-11-17 y actualizó la página del modelo. Todas las puntuaciones corresponden a Intelligence Index v5.0.1; son evaluaciones de terceros, no autodeclaraciones de ninguna de las partes.
| Modelo | Nivel de razonamiento | Intelligence Index v5.0.1 | Costo por tarea del índice compuesto (página de cada modelo) |
|---|---|---|---|
| Claude Fable 5.2 | Nivel de razonamiento más alto | 65 (primero en el ranking) | 26.54 USD |
| GPT-6.2 Astra | Max / Xhigh | 62 | 4.00 USD (Max) |
| GPT-6.2 Astra | High / Medium / Low | 60 / 57 / 46 | — |
| GPT-6.2 Sol | Max | 57 | 1.01 USD (Max) |
| Gemini 4 Carbon | Nivel más alto | 60 | — |
| Claude Opus 5.5 | Nivel más alto | 59 | — |
En este ranking de terceros, la puntuación integral de Fable 5.2 supera en 3 puntos al nivel más alto de Astra. Astra aventaja en 5 puntos a la generación anterior, GPT-6 Astra, y también supera el nivel más alto de Gemini 4 Carbon y Claude Opus 5.5. Además, hay que tener en cuenta que Astra, al bajar al nivel Low, solo obtiene 46 puntos. Si tu negocio reduce la intensidad de razonamiento para ahorrar costos, no puedes esperar un rendimiento de 62 puntos.
En el artículo de Artificial Analysis también hay varios resultados desglosados, que igualmente son datos de terceros. En la vista previa de investigación AA-Robotics v0.1, Astra obtiene 79 y Fable 5.2, 75. En tareas científicas, Astra lidera en Terminal-Bench-Science 0.1 y queda justo por detrás de Fable 5.2 en el subconjunto difícil de CritPt v2. En el Coding Agent Index (Codex harness, max), Astra empata con GPT-6 Astra. En la tasa de alucinaciones de AA-Omniscience (Max), Astra alcanza el 59%.
GPT-6.2 Astra y Claude Fable 5.2: diferencias clave según datos autoinformados por el fabricante
Las siguientes cifras proceden de la nota de lanzamiento de OpenAI y de la página del modelo, y todas son autoinformadas por el fabricante. Para las pruebas en las que la nota de lanzamiento no ofrece una puntuación absoluta, este artículo se limita a indicar la diferencia relativa.
| Tarea específica | Resultado autoinformado por el fabricante | Base de coste indicada por el fabricante | Notas al pie que conviene revisar |
|---|---|---|---|
| Agents’ Last Exam (flujos de trabajo profesionales de largo recorrido) | Astra supera a Fable 5.2 en 5.5 puntos | Coste aproximadamente 5 % del de Fable | En la tabla, Fable 5.2 no incluye las nueve tareas que usaron un modelo de respaldo |
| Harvey LAB-AA v1.1 (legal) | Tasa de aprobación de Astra más del doble de la de Fable 5.2 | Coste aproximadamente una sexta parte | La nota de lanzamiento no ofrece la tasa de aprobación absoluta; la configuración «Astra for Law», dirigida a abogados, es superior |
| AA-3D (Elo de evaluación ciega humana) | Astra 1318, Fable 5.2 1271, Sol 1259 | No indicado | Evaluación ciega de terceros, pero reproducida en la nota de lanzamiento oficial |
| Terminal-Bench-Science 0.1 | Astra supera a GPT-6 Astra en 9 puntos porcentuales | Coste inferior a un tercio del de la generación anterior | Fable 5.2 tiene dos cifras procedentes de pruebas distintas; véase más abajo |
La nota al pie de Agents’ Last Exam merece una explicación aparte. OpenAI indica que el resultado de Fable 5.2 en la tabla no incluye las nueve tareas que recurrieron a un modelo de respaldo. Al leer ese «5.5 puntos más», conviene tener presente que la cobertura de tareas de ambas partes no es exactamente la misma.
En Terminal-Bench-Science 0.1, Fable 5.2 tiene dos cifras de fuentes distintas. Una procede de Artificial Analysis, con mini-swe-agent. La otra es el 74.6 % autoinformado por Anthropic, en un entorno de prueba con Claude Code e intensidad de razonamiento Max. Estas dos cifras no provienen de la misma prueba; no son intercambiables ni pueden compararse directamente con Astra.
Los valores 1318 y 1271 de AA-3D son, en sí mismos, puntuaciones Elo de una evaluación ciega humana realizada por terceros, pero este artículo cita la versión que reproduce la nota de lanzamiento de OpenAI. Al citarlos, lo mejor es describirlos como «evaluación ciega de terceros reproducida por el fabricante»; no conviene presentarlos como datos puramente autoinformados ni como una verificación independiente del autor de este artículo.
💡 Consejo para elegir: las clasificaciones por tarea individual solo tienen valor de referencia cuando el tipo de tarea se parece a tu negocio. Fable 5.2 ya se puede invocar a través de APIYI apiyi.com; primero puedes probarlo con tus propias muestras reales y luego combinar los resultados con las dos tablas anteriores para decidir.
Comparativa de precios de lista entre GPT-6.2 Astra y Claude Fable 5.2: la lectura de caché es diferente
Según el precio de lista oficial, el precio estándar de contexto corto de ambos modelos es idéntico tanto en entrada como en salida. Las diferencias se concentran en las partidas relacionadas con la caché y en las reglas de contexto largo. Todos los precios de la siguiente tabla están en USD por cada millón de tokens.
| Partida | GPT-6.2 Astra (OpenAI oficial) | Claude Fable 5.2 (Anthropic oficial) | Plataforma disponible (tabla general de APIYI, 2026-11-17 15:54 UTC+8) |
|---|---|---|---|
| Entrada | 8 | 8 | Astra aún no está disponible; Fable: 8 |
| Salida | 40 | 40 | Astra aún no está disponible; Fable: 40 |
| Lectura de caché | 0.40 | 0.20 | Astra aún no está disponible; Fable: 0.2 |
| Escritura de caché | 10 (retención de 30 minutos), 20 (12 horas) | 10 (5 minutos), 16 (1 hora) | Según la lista de la plataforma |
| Contexto / salida máxima | 1,050,000 / 128,000 (entrada máxima 922,000) | 1M / 128K | — |
| Batch | 50% del precio estándar | Entrada y salida al 50% | — |
El precio de lista oficial de OpenAI para GPT-6.2 Astra es de 8 USD de entrada, 0.40 USD de lectura de caché y 40 USD de salida. Aún no está disponible; lo listaremos lo antes posible. El modelo y el precio se rigen por la lista de modelos de la plataforma. En la tabla general de modelos de APIYI, docs.apiyi.com/models.md, y en la API pública de precios, a fecha de 2026-11-17 no aparece gpt-6.2-astra. No utilices el ya disponible gpt-6-astra (contexto corto 10 / 50 / 1) para estimar el precio de 6.2; no son el mismo modelo.
La diferencia en la lectura de caché pesa mucho en agentes y conversaciones largas. Si se leen 100 millones de tokens de caché, según el precio de lista Astra cuesta 40 USD y Fable 5.2 cuesta 20 USD. Si tu indicación de sistema es muy larga o citas repetidamente el mismo conjunto de documentos, esta partida se reflejará directamente en la factura. La escritura de caché parece costar 10 USD en ambos casos, pero Astra conserva la caché durante 30 minutos y Fable durante 5 minutos; la tasa de aciertos depende del intervalo entre solicitudes, así que no basta comparar el precio unitario.
Las reglas para contexto largo también cambian. La página del modelo Astra indica que, cuando la entrada de una sola solicitud supera los 272K tokens, los precios unitarios de entrada y de caché se duplican, la salida pasa a 1.5 veces el precio de contexto corto y toda la solicitud se factura con esa tarifa. El extracto de la lista de precios de Fable que sirvió de referencia para este artículo no incluye una escala similar; antes de integrar, verifícalo por tu cuenta en la documentación de Anthropic.
Los niveles de aceleración también difieren entre ambos. En Astra, Fast cuesta 2 veces el precio estándar; Ultrafast cuesta 3 veces hasta el 2027-02-28 (hora del Pacífico) y pasa a 6 veces desde el 2027-03-01. El modo Fast de Fable alcanza aproximadamente 2.5 veces la velocidad, con un precio de 16 USD de entrada y 80 USD de salida.
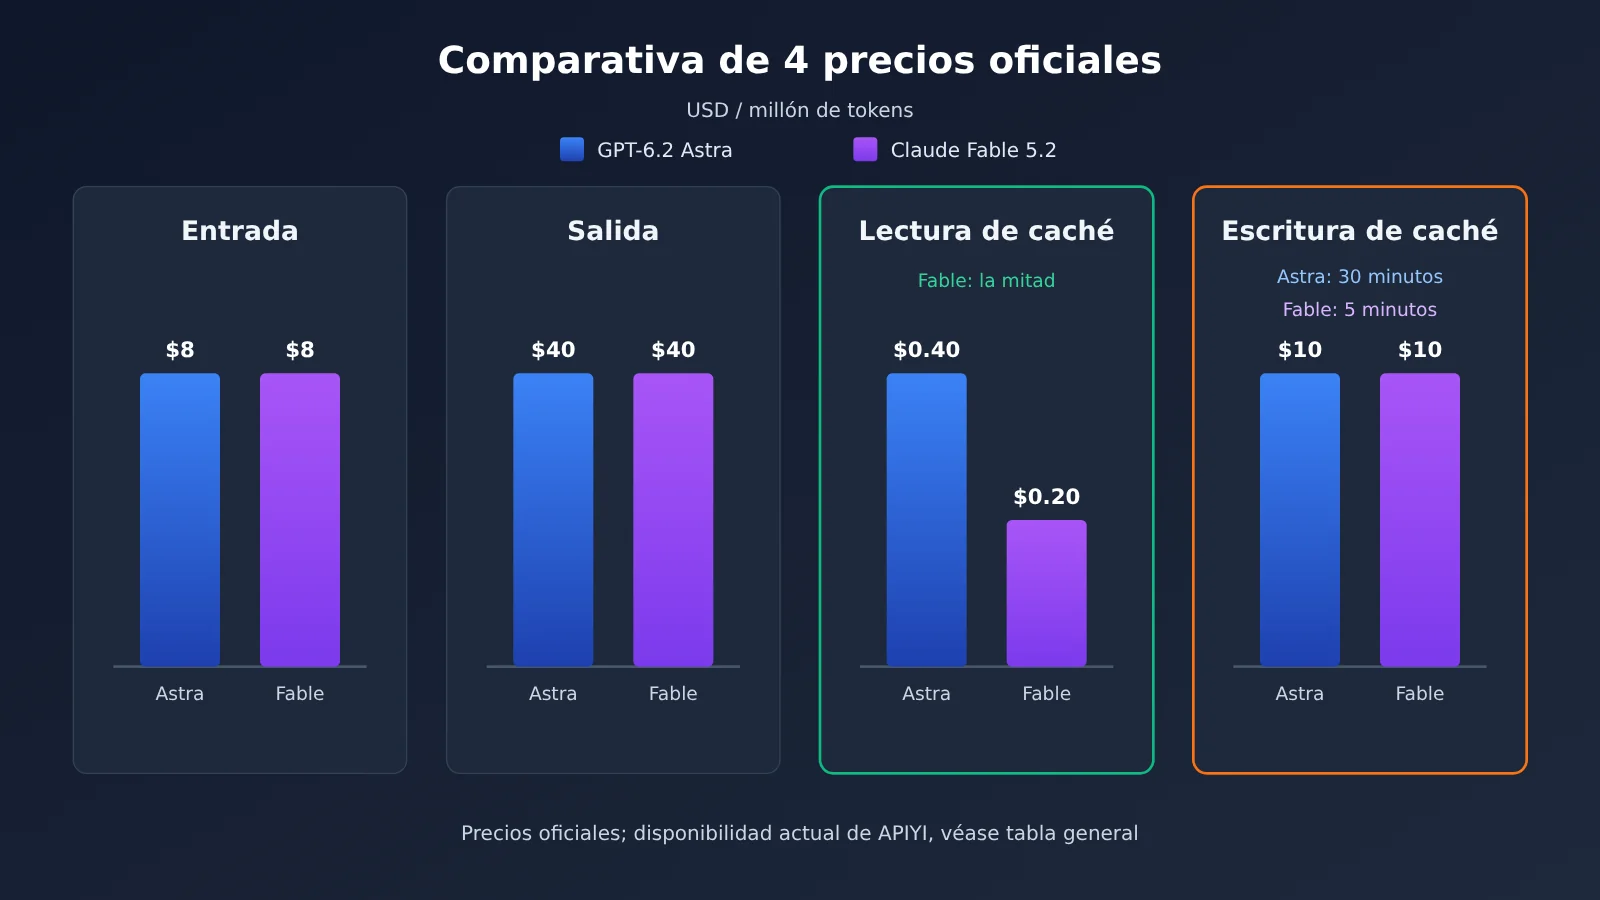
🎯 Nota sobre los datos: la gráfica anterior muestra únicamente los precios de lista oficiales de ambos proveedores. Los modelos y precios realmente disponibles en la plataforma se rigen por la lista de modelos de APIYI apiyi.com; Astra 6.2 no está en la lista por ahora.
Recomendaciones de escenarios para GPT-6.2 Astra y Claude Fable 5.2
A continuación, asocio cada escenario con lo que muestra cada métrica del ranking, sin sacar conclusiones sobre qué modelo es mejor en términos generales.
Escenarios en los que conviene evaluar primero GPT-6.2 Astra
- Flujos de trabajo profesionales de horizonte extendido: en Agents’ Last Exam, Astra va por delante según los datos autodeclarados por el fabricante; además, hay que considerar la nota al pie que indica que Fable no incluye nueve tareas.
- Tareas de documentos legales: en Harvey LAB-AA v1.1, la tasa de aprobación autodeclarada por el fabricante es más del doble de la de Fable, así que puede ser una dirección prioritaria para pruebas.
- Evaluaciones de preferencia relacionadas con generación 3D: en la evaluación a ciegas AA-3D, el Elo difundido por el fabricante es 1318 frente a 1271.
- Si te importa el costo por tarea del índice compuesto: en la página de terceros, Astra (Max) aparece con 4.00 USD, pero esto solo aplica al conjunto de tareas del índice compuesto.
Escenarios en los que conviene evaluar primero Claude Fable 5.2
- Aplicaciones generales que necesitan una base sólida de capacidad integral: en el índice compuesto de terceros, Fable 5.2 obtiene 65 y ocupa el primer lugar de la clasificación.
- Aplicaciones con alta proporción de lectura de caché: la lectura de caché tiene un precio de lista de 0.20 USD, la mitad de Astra.
- Si necesitas integrarlo ya:
claude-fable-5-2yclaude-fable-5-2-thinkingya están en la tabla general de APIYI.
| Tu foco de interés | Qué nivel consultar primero | Lo que indica ese nivel | Recordatorio adicional |
|---|---|---|---|
| Capacidad promedio | Clasificación compuesta de terceros | Fable 5.2 es superior | Ojo con el nivel de razonamiento |
| Flujos de trabajo profesionales / legal | Métrica individual autodeclarada por el fabricante | Astra lidera | Datos autodeclarados; revisa las notas al pie |
| Costo de caché en conversaciones largas | Precio oficial | Lectura de caché más barata en Fable | La duración de retención de la escritura de caché varía |
| ¿Se puede invocar ahora? | Tabla general de APIYI | Solo Fable está disponible | Astra 6.2 pendiente de publicación |
GPT-6.2 Astra y Claude Fable 5.2: inicio rápido, decisión en tres pasos
Primer paso: mira primero la clasificación que te interesa
Primero define a qué tipo de tarea pertenece tu negocio. Si se trata de un asistente general o de tareas mixtas, consulta el índice compuesto de Artificial Analysis y anota el nivel de razonamiento que piensas usar. Si se trata de agentes de tareas prolongadas, temas legales o 3D, consulta la métrica individual correspondiente autodeclarada por OpenAI y lee también las notas al pie. No combines la diferencia de puntuación del ranking compuesto con la del ranking individual para formar una “puntuación total”.
Segundo paso: fíjate después en la lectura de caché
Calcula qué proporción de la solicitud es un prefijo repetido, por ejemplo la indicación del sistema, fragmentos de la base de conocimiento o el historial de conversación de varios turnos. Cuanto mayor sea la proporción de lectura de caché, más evidente será la diferencia entre 0.20 y 0.40. Si la entrada de una sola vez supera con frecuencia 272K, también debes incluir la regla de Astra de recargo por solicitud completa.
Tercer paso: mira cuál puedes invocar ahora en APIYI
Actualmente, el modelo que se puede invocar en la tabla general de APIYI es Fable 5.2, con ID de modelo claude-fable-5-2; cuando necesites la versión con razonamiento explícito, usa claude-fable-5-2-thinking. El precio indicado es 8 de entrada, 40 de salida y 0.2 de lectura de caché; el endpoint admite chat y messages. La página de descripción de ese modelo actualmente devuelve 404; los precios se rigen por la tabla general.
Cuando lo integres mediante compatibilidad con OpenAI, en el SDK configura base_url como https://api.apiyi.com/v1 y model como claude-fable-5-2; los demás parámetros son los mismos que usas habitualmente al llamar a Chat Completions. Ten en cuenta que la función de razonamiento de Fable 5.2 está siempre activada y no se puede desactivar; el effort predeterminado es high. Si más adelante cambias a Astra, su API no acepta establecer reasoning effort como none.
🚀 Inicio rápido: te recomendamos empezar en APIYI (apiyi.com) con el crédito de prueba gratuito, probar
claude-fable-5-2con tus propias muestras y registrar la calidad de salida y la tasa de aciertos de caché. Cuandogpt-6.2-astraesté disponible, vuelve a probar con el mismo conjunto de muestras; la comparación será más justa.
Preguntas frecuentes (FAQ)
P1: ¿Qué son exactamente GPT-6.2 Astra y Claude Fable 5.2?
GPT-6.2 Astra es el modelo insignia que OpenAI lanzó el 2026-11-17, con ID de modelo `gpt-6.2-astra`. Junto a él también se lanzó el GPT-6.2 Sol, una opción más económica. Claude Fable 5.2 es un modelo de Anthropic, cuya documentación se publicó el 2026-11-09. Ambos admiten una ventana de contexto de aproximadamente 1M y una salida máxima de 128K.
P2: ¿Cuál es realmente más potente, GPT-6.2 Astra o Claude Fable 5.2?
Los datos disponibles no permiten dar una respuesta única. En el índice compuesto de terceros, los 65 puntos de Fable 5.2 superan los 62 de Astra (Max). En las evaluaciones ALE y Harvey autodeclaradas por la compañía, así como en la evaluación ciega AA-3D reportada por la propia compañía, Astra va por delante. Deberías fijarte en el nivel de datos que corresponda al tipo de tarea que vayas a realizar.
P3: ¿Se pueden contrastar el “5 % de costo” de ALE y el costo por tarea de Artificial Analysis?
No. “Alrededor del 5 %” es el criterio autodeclarado por OpenAI en Agents’ Last Exam. Los 4.00 dólares y 26.54 dólares son los costos de Artificial Analysis para el conjunto de tareas del índice compuesto. Las tareas y los criterios son distintos; no se pueden dividir ni usar para validarse mutuamente.
P4: ¿Los datos de GPT-6.2 Sol son de terceros?
No. Sol es un modelo de la propia OpenAI; las cifras que aparecen en su nota de lanzamiento son todas autodeclaradas oficialmente. Artificial Analysis también evaluó Sol por separado: la versión Max obtuvo 57 puntos, y esa parte sí son datos de terceros. El precio oficial de Sol es: entrada 2, lectura de caché 0.10, salida 10. Aún no está disponible en la plataforma; lo incorporaremos lo antes posible. El modelo y los precios se rigen por la lista de modelos de la plataforma.
P5: ¿Cómo puedo invocar Claude Fable 5.2 mediante API en este momento?
Regístrate en APIYI (apiyi.com), obtén tu clave API y, en el SDK compatible con OpenAI, configura la URL base como `https://api.apiyi.com/v1` y usa el modelo `claude-fable-5-2`. Si usas el protocolo nativo de Anthropic, puedes utilizar el endpoint messages.
P6: ¿Qué limitaciones conocidas tiene GPT-6.2 Astra?
La documentación oficial indica que Astra alcanza el nivel “crítico” de ciberseguridad dentro del marco de preparación; las salvaguardas son más estrictas y algunas solicitudes legítimas de investigación de vulnerabilidades serán rechazadas. En las evaluaciones de alineación, en dos pruebas es más propenso a no reportar problemas que obstruyen, como archivos faltantes o herramientas de búsqueda no disponibles. La tasa de alucinación de terceros en AA-Omniscience (Max) es del 59 %. Además, no admite entrada de audio ni video, y tampoco Realtime ni ajuste fino.
P7: ¿Cambiarán los precios después de diciembre?
En las referencias de este artículo, ninguno de los dos modelos anuncia un cambio de precios en diciembre. Lo que sí cambiará es el multiplicador Ultrafast de Astra: a partir del 2027-03-01 pasa de 3× a 6×. La facturación real en la plataforma se rige por la lista de modelos de APIYI (apiyi.com).
GPT-6.2 Astra y Claude Fable 5.2: puntos clave
- Ranking general: datos de terceros: en el AA Intelligence Index v5.0.1, Fable 5.2 obtiene 65 y Astra (Max), 62.
- Tareas individuales: datos autodeclarados: Astra lidera en ALE, Harvey y AA-3D, según la información oficial, pero hay que leer las notas al pie.
- No se pueden mezclar las dos métricas de costo: el ~5 % de ALE y el costo por tarea de AA corresponden a tareas distintas y a metodologías distintas.
- Entrada y salida al mismo precio: en contexto corto, ambos cuestan 8 / 40 USD; la lectura de caché cuesta 0.40 y 0.20, respectivamente.
- Astra aplica tarifas escalonadas en contexto largo: si una sola entrada supera 272K, toda la solicitud se factura a la tarifa superior.
- Estado de acceso distinto: Fable 5.2 ya figura en el listado general de APIYI apiyi.com; Astra 6.2 está pendiente de inclusión.
Resumen
Al comparar GPT-6.2 Astra y Claude Fable 5.2, lo clave es separar el origen de las cifras:
- Ranking general de terceros: Fable 5.2 obtiene una puntuación más alta; al citarla, especifica siempre el nivel de razonamiento.
- Tareas individuales reportadas por el fabricante: Astra lidera en varias tareas especializadas y el costo por tarea reportado también es menor, pero son datos autodeclarados.
- Precios oficiales: la entrada y la salida cuestan lo mismo; la lectura de caché cuesta la mitad en Fable, y las reglas de contexto largo también difieren.
Ninguno de los dos modelos se impone en todas las dimensiones. Lo más fiable es definir primero el tipo de tarea, revisar después el costo de caché y, por último, probar con muestras reales. Actualmente, Fable 5.2 ya se puede invocar mediante APIYI apiyi.com; cuando Astra 6.2 esté disponible, podremos completar las pruebas con el mismo conjunto de muestras. Incluiremos este modelo en el catálogo lo antes posible.
📚 Referencias
-
Anuncio de OpenAI: Notas de lanzamiento y evaluaciones auto-reportadas de GPT-6.2 Astra y Sol
- Enlace:
openai.com/index/introducing-gpt-6-2-astra-sol - Descripción: Datos individuales de ALE, Harvey, AA-3D y fuentes de las notas al pie
- Enlace:
-
Página del modelo de OpenAI: Especificaciones y precio de lista de GPT-6.2 Astra
- Enlace:
platform.openai.com/docs/models/gpt-6.2-astra - Descripción: Precio de escritura en caché y reglas de facturación de 272K según esta fuente
- Enlace:
-
Artículo de Artificial Analysis: Evaluación de terceros de GPT-6.2 Astra y Sol
- Enlace:
artificialanalysis.ai/articles/openai-has-the-2-model-in-the-intelligence-index-with-the-release-of-gpt-6-2-astra-and-gpt-6-2-sol - Descripción: Puntuaciones por nivel de razonamiento de Intelligence Index v5.0.1
- Enlace:
-
Página del modelo de Artificial Analysis: Claude Fable 5.2
- Enlace:
artificialanalysis.ai/models/claude-fable-5-2 - Descripción: Puntuación integral y costo por tarea única del índice compuesto
- Enlace:
-
Documentación de Anthropic: Descripción general de Claude Fable 5.2
- Enlace:
platform.claude.com/docs/en/models/fable-5-2/overview - Descripción: Precio de lista, lectura/escritura de caché, effort y configuración de razonamiento
- Enlace:
Autor: Equipo técnico de APIYI
Intercambio técnico: Contáctenos a través de la página principal del sitio web de APIYI; las especificaciones y precios están sujetos a la lista de modelos de la plataforma.