Resumen: DeepSeek Harness puede conectarse a gateways como APIYI mediante la «API de modelo personalizado». Para cada protocolo, el desarrollador configura un proveedor independiente, introduce el ID de modelo que el gateway realmente admite y, si la tarea lo requiere, integra además herramientas de búsqueda en línea.
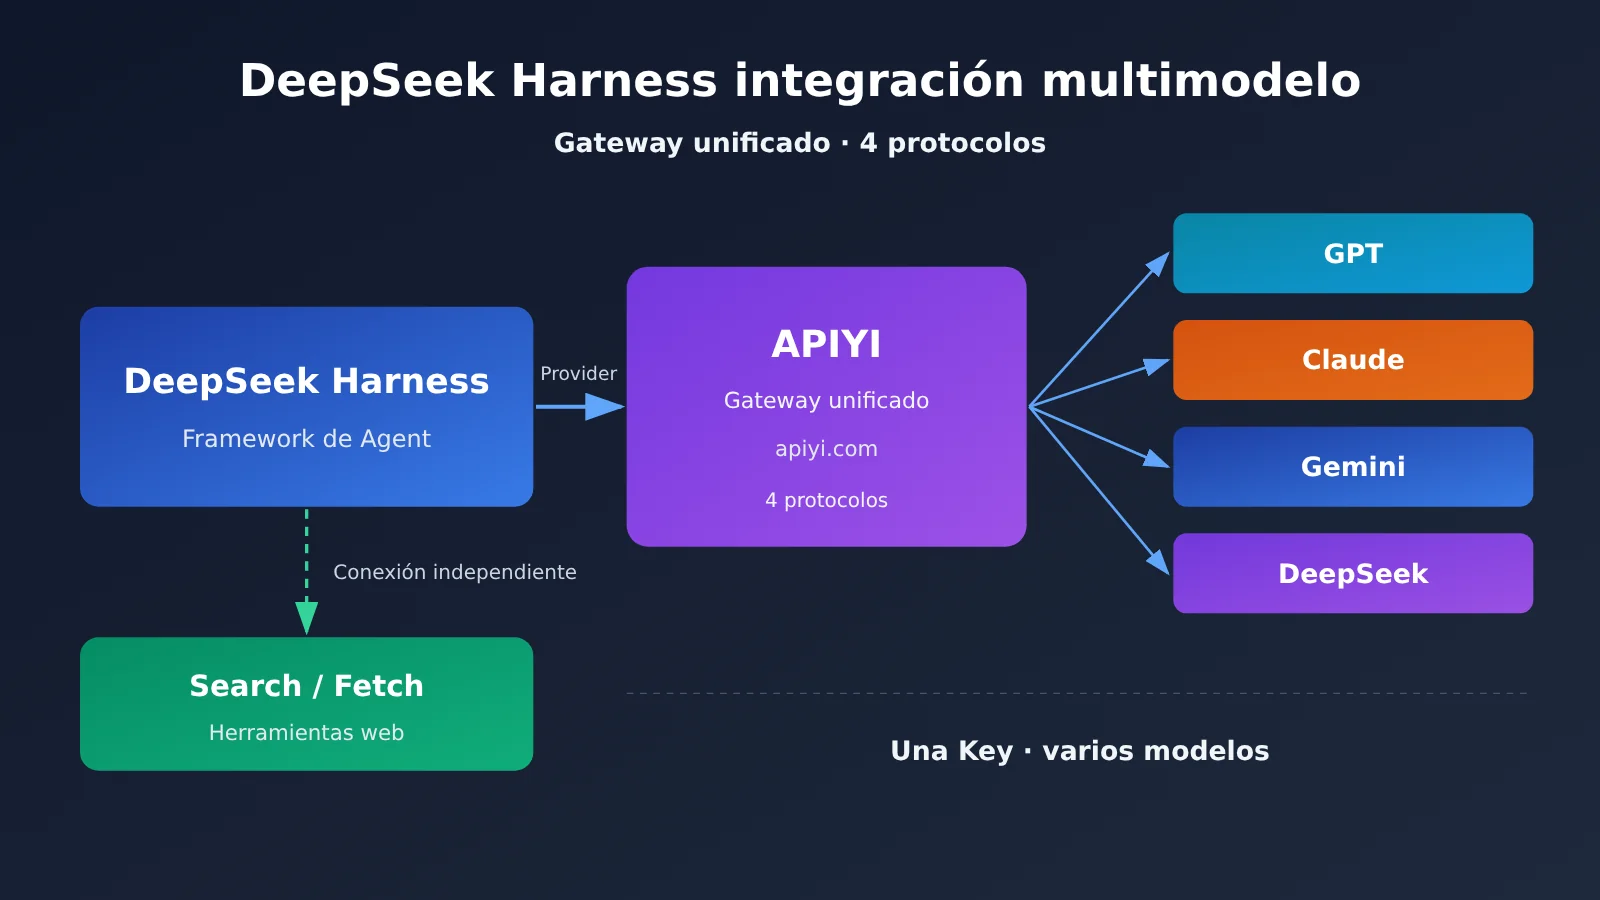
DeepSeek Harness permite añadir gateways de API de terceros como proveedores de modelos personalizados. Hay cuatro protocolos disponibles: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages y Gemini API. Por eso, una instancia de Harness puede invocar modelos de distintos fabricantes al mismo tiempo a través de gateways unificados como APIYI (apiyi.com). Que la integración funcione depende de cuatro puntos: que el protocolo y la Base URL coincidan, que el ID del modelo se corresponda con el que admite el gateway, que los parámetros de inferencia y salida sean compatibles y que las herramientas de búsqueda en línea se planifiquen por separado.
En las secciones siguientes se explica primero cómo Harness adapta los modelos y qué papel ocupa el gateway dentro de ese mecanismo. Después, se recorre la interfaz de configuración paso a paso para completar una configuración de proveedor personalizado y se incluye una plantilla de archivo de configuración para APIYI. A continuación, se repasan los problemas de compatibilidad y los códigos de error más frecuentes cuando el endpoint conecta pero las invocaciones fallan. Luego se distinguen dos rutas de acceso a internet: la búsqueda integrada en el servidor de DeepSeek y las herramientas Search / Fetch independientes de APIYI. Por último, se proponen ideas de diseño por capas y de despliegue para agentes multimodelo.
Para saber: terminología de integración multimodelo de DeepSeek Harness
| Término | Explicación |
|---|---|
| Harness | Marco de ejecución de los agentes; se encarga de la integración de modelos, las llamadas a herramientas, el contexto, las sesiones y el bucle de ejecución de tareas |
| API Gateway | Puerta de enlace que centraliza el reenvío y la gestión de solicitudes a las API de varios modelos, ofreciendo un único punto de entrada |
| Base URL | Dirección base de las solicitudes a la API; según el protocolo, el prefijo de ruta de la dirección cambia |
| Provider | Proveedor de servicios de modelos configurado en Harness, que corresponde a un conjunto de dirección, protocolo y clave |
| Model ID | Identificador del modelo especificado en la solicitud; debe coincidir con el nombre que realmente ofrece la puerta de enlace |
| Chat Completions | Interfaz de finalización de chat al estilo OpenAI, el protocolo más habitual en las puertas de enlace compatibles |
| Responses API | Interfaz de respuestas estructuradas de OpenAI, orientada a llamadas a herramientas e interacción multiturno |
| Anthropic Messages | Interfaz de mensajes al estilo Anthropic, protocolo nativo de los modelos de la familia Claude |
| Reasoning Effort | Parámetro del nivel de razonamiento del modelo, como off, low, medium, high o max |
| Tool Calling | Capacidad del modelo o del agente para decidir invocar herramientas externas y usar sus resultados en el razonamiento posterior |
| Search / Fetch | Search se encarga de la búsqueda web y devuelve una lista de resultados; Fetch se encarga de recuperar el cuerpo de una página web concreta |
| API Key | Credencial de autenticación que determina a qué modelos e interfaces puede acceder una solicitud |
1 Por qué DeepSeek Harness encaja bien en la integración multimodelo mediante API
1.1 El mecanismo de proveedores de modelos de DeepSeek Harness
DeepSeek Harness se publicó como código abierto el 13 de agosto de 2026 en versión de vista previa para desarrolladores, bajo licencia MIT, y su arquitectura central se resume en una idea: «Everything is a Plugin». Los adaptadores de modelos, las herramientas, las Skills, el almacenamiento y la gestión de sesiones son plugins sustituibles, así que la conexión de modelos pasa a ser un elemento de configuración abierto en lugar de un vínculo al fabricante incrustado en el producto.
En la capa de modelos, Harness permite añadir varios proveedores e ir cambiando de modelo dentro de una misma sesión. Cada proveedor admite configurar API Key, Base URL, nombre del modelo, protocolo de API, longitud del contexto, máximo de tokens de salida, capacidad de entrada de imágenes y nivel de razonamiento. Tanto los sitios proxy como las pasarelas internas de empresa y los servicios de modelos autoalojados pueden conectarse como proveedores independientes.
Conviene tener en cuenta que Harness sigue en fase de vista previa para desarrolladores y que el equipo oficial advierte de posibles cambios incompatibles en versiones futuras. Antes de usarlo en producción, se recomienda fijar la versión y hacer copia de seguridad de la configuración.
1.2 El papel de la pasarela API dentro de DeepSeek Harness
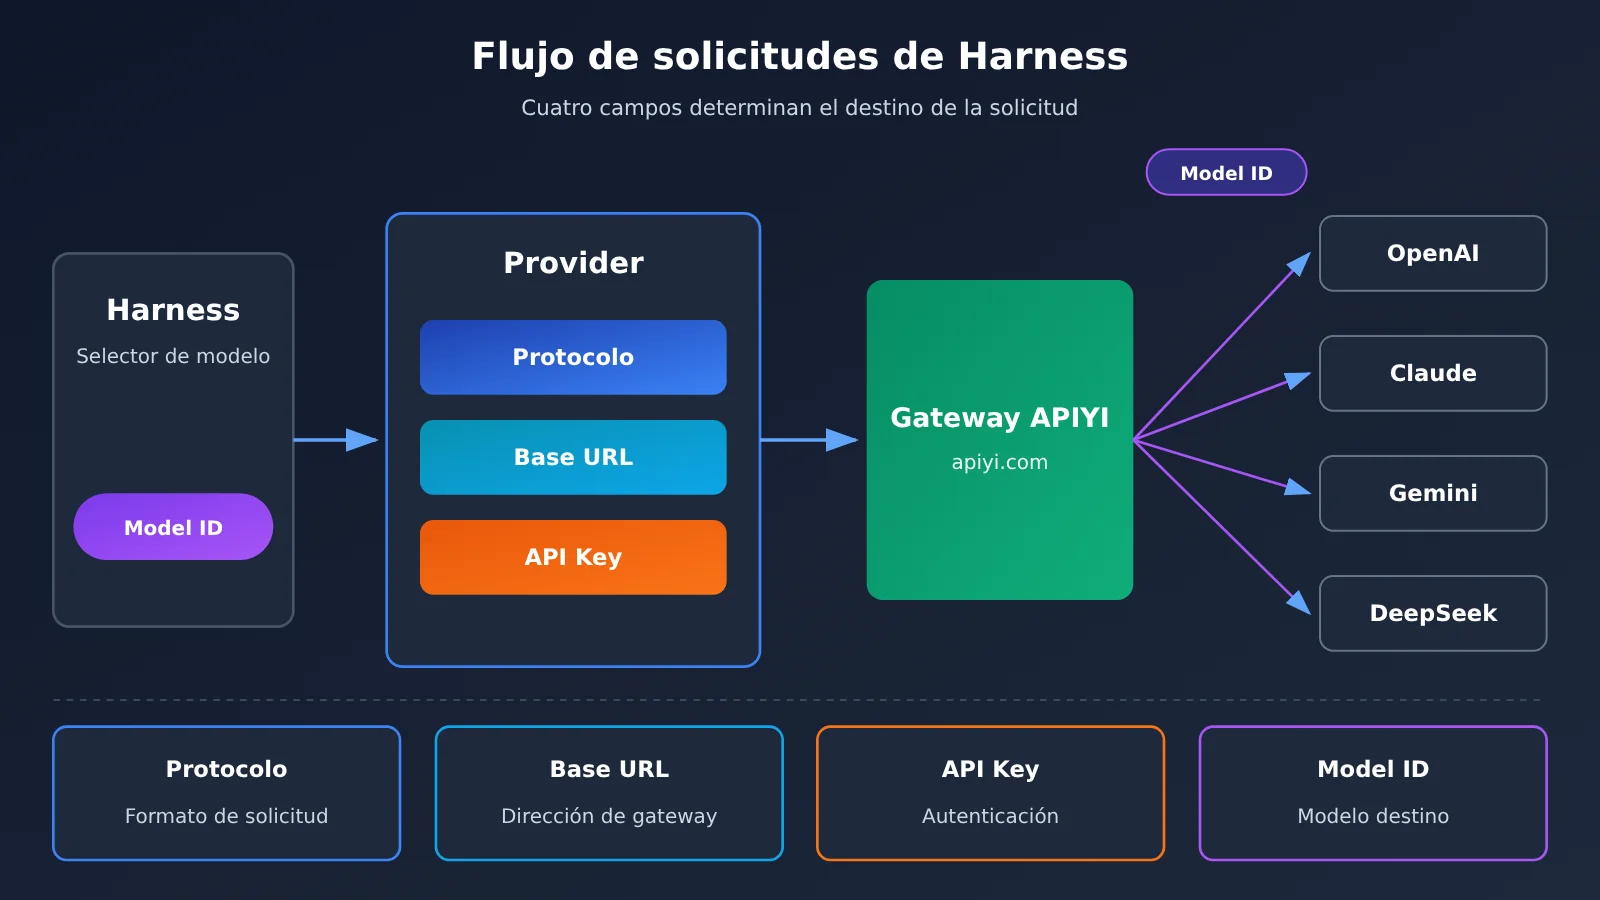
Para Harness, una pasarela es simplemente un Provider. Cuatro campos determinan el destino de una petición: la Base URL apunta a la dirección de la pasarela, el protocolo define el formato de la petición y de la respuesta, la API Key acredita la identidad de quien llama y el Model ID indica a la pasarela a qué modelo debe reenviar la petición.
Poniendo el caso de APIYI apiyi.com: la plataforma ofrece con una sola API Key modelos de OpenAI, Claude, Gemini, DeepSeek y otros, y expone tres puntos de entrada de protocolo: compatible con OpenAI, nativo de Anthropic y Gemini. En Harness basta crear el proveedor correspondiente según el protocolo, y cambiar de modelo se reduce a modificar el Model ID, sin necesidad de abrir una cuenta y mantener una clave por cada fabricante.
2 Configurar un proveedor de modelos personalizado en DeepSeek Harness desde cero
2.1 Abrir la interfaz de configuración de modelos de DeepSeek Harness
La forma más rápida de iniciar Harness en local es con el comando oficial de npm, aunque antes necesitas tener Node.js instalado:
npx @deepseek-ai/dsh web
# Abre por defecto la interfaz web local: http://127.0.0.1:3080
Una vez dentro de la interfaz, haz clic en Configuración → Modelos → Añadir proveedor de modelos → API de modelo personalizado y verás el formulario de configuración del proveedor. La versión de escritorio oficial ofrece instaladores para macOS Apple Silicon y Windows de 64 bits; la ruta de configuración es la misma.
2.2 Completar la información del proveedor DeepSeek Harness
| Campo de configuración | Función | Qué tener en cuenta al rellenar |
|---|---|---|
| Provider ID | Identificador único del proveedor | Debe ir en minúsculas y no se puede renombrar después de crearlo, por ejemplo apiyi |
| Nombre para mostrar | Nombre que aparece en el menú de modelos | Puede ser algo como «APIYI compatible con OpenAI» |
| Protocolo de API | Formato de las peticiones y respuestas | Debe corresponder al Base URL, ver 2.3 |
| Base URL | Dirección del servicio de API | Ojo con el prefijo de versión, ver 2.4 |
| API Key | Credencial de autenticación | Se guarda en el archivo de credenciales; la interfaz solo muestra una vista parcial enmascarada |
| Model ID | Nombre real del modelo que se invoca | Debe coincidir exactamente con la lista de modelos del gateway |
| Context Window / Max Output Tokens | Longitud del contexto y de la salida máxima | Rellénelos según las especificaciones reales del modelo |
| Input Type | Entrada de texto o de imágenes | Marque la opción de imágenes solo para modelos visuales |
| Reasoning Effort | Nivel de razonamiento y mapeo de parámetros | Añada únicamente los niveles que el modelo realmente admite |
El Provider ID no se puede renombrar porque la configuración de los modelos, el historial de conversaciones y las referencias a credenciales apuntan todos a ese ID. Si necesitas cambiarlo, primero crea un proveedor nuevo y luego elimina el antiguo.
El botón «Obtener modelos disponibles» del formulario intenta leer la lista de modelos desde el gateway. Si el gateway no ofrece una lista de modelos estándar, o si el formato devuelto no entra dentro de lo que Harness reconoce, basta con añadir el Model ID manualmente: el resultado es el mismo.
2.3 Elegir el protocolo de API de DeepSeek Harness
La API de modelos personalizados de Harness admite cuatro protocolos: OpenAI Chat Completions, OpenAI Responses, Anthropic Messages y Gemini API. Un proveedor solo puede vincularse a un protocolo; si una misma pasarela expone entradas para los tres protocolos, será necesario crear tres proveedores.
La elección del protocolo va de la mano con la familia del modelo. Para GPT, DeepSeek y la mayoría de los modelos nacionales, lo más seguro es usar OpenAI Chat Completions; en la serie Claude se puede optar por Anthropic Messages para conservar las características nativas; y la serie Gemini utiliza Gemini API. El protocolo Responses resulta adecuado para escenarios que requieren respuestas estructuradas y llamadas a herramientas, siempre que tanto la pasarela como el modelo de destino soporten esa interfaz.
2.4 Configurar una instancia de DeepSeek Harness con APIYI
La correspondencia oficial entre protocolos y Base URL que ofrece APIYI es la siguiente:
| Protocolo | Base URL de APIYI | Modelos compatibles | Plataformas disponibles |
|---|---|---|---|
| Compatible con OpenAI (Chat Completions) | https://api.apiyi.com/v1 |
GPT, DeepSeek, etc. | APIYI apiyi.com, API oficial de cada fabricante |
| Anthropic nativo | https://api.apiyi.com |
Serie Claude | APIYI, Anthropic oficial |
| Gemini | https://api.apiyi.com/v1beta |
Serie Gemini | APIYI, Google oficial |
El protocolo Anthropic utiliza el dominio raíz, y el adaptador añade por su cuenta las rutas posteriores. Si se escribe un /v1 adicional después del dominio raíz, pueden producirse rutas duplicadas y devolver un 404. Para la integración del protocolo Responses, conviene consultar la documentación de la API Responses de APIYI antes de rellenar los datos.
Además de la configuración desde la interfaz, Harness también permite editar manualmente el archivo de configuración, ubicado en $DSH_HOME/profiles/web/cordis.patch.yml. A continuación se muestra una plantilla de proveedor compatible con OpenAI de APIYI, elaborada según la estructura de configuración oficial:
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY          # Lee la clave desde la variable de entorno
        api: openai-completions           # Protocolo OpenAI Chat Completions
        baseURL: https://api.apiyi.com/v1 # Punto de entrada compatible con OpenAI de APIYI
        models:
          - id: MODEL_ID_FROM_APIYI       # Sustituir por el ID de modelo realmente disponible en la cuenta
Los pasos de uso son los siguientes:
- Definir la variable de entorno
APIYI_API_KEY; - Sustituir
MODEL_ID_FROM_APIYIpor el nombre del modelo realmente disponible en la consola de APIYI; - Guardar la configuración y seleccionar en el selector de modelos de Harness el proveedor
apiyiy el modelo correspondiente; - Iniciar una conversación sencilla para confirmar que la interfaz funciona correctamente.
Esta plantilla muestra la estructura de configuración oficial; los nombres de modelo deben ajustarse a la lista de los que realmente se pueden invocar desde la propia cuenta. Los cambios en la configuración de modelos suelen surtir efecto en la siguiente solicitud, sin necesidad de reiniciar la interfaz web. La configuración desde la interfaz resulta adecuada para añadir modelos y modificar claves en el día a día; el archivo de configuración lo es para ajustar parámetros avanzados como la compatibilidad, el modo de razonamiento, los tiempos de espera y los reintentos.
Antes de integrar Harness, se recomienda verificar por separado la Key y el Model ID con un script, de modo que los dos problemas —»la pasarela funciona» y «la configuración de Harness es correcta»— se investiguen de forma independiente:
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["APIYI_API_KEY"],
    base_url="https://api.apiyi.com/v1"  # Punto de entrada compatible con OpenAI de APIYI apiyi.com
)

resp = client.chat.completions.create(
    model="MODEL_ID_FROM_APIYI",  # Debe coincidir con el Model ID introducido en Harness
    messages=[{"role": "user", "content": "用一句话介绍你自己"}],
    max_tokens=100
)
print(resp.choices[0].message.content)
🚀 Consejo para empezar rápido: los nuevos usuarios pueden registrarse en APIYI apiyi.com y obtener crédito de prueba gratuito; primero conviene confirmar con el script anterior que el ID de modelo está disponible y después escribirlo en la configuración de Harness. Así el tiempo total de resolución de problemas se reduce bastante.
3 La interfaz de DeepSeek Harness conecta, pero ¿por qué la invocación del modelo sigue fallando?
La documentación oficial de Harness lo deja claro: aunque la dirección de la API y la clave API sean correctas, la pasarela puede seguir rechazando la solicitud. El motivo es que las distintas interfaces compatibles tienen requisitos diferentes en cuanto a los roles de los mensajes, la longitud de salida y los parámetros de razonamiento. Los tres parámetros compat que se describen a continuación sirven para resolver este tipo de problemas y conviene habilitarlos según los errores que devuelva realmente la interfaz.
3.1 Compatibilidad con el rol Developer
La nueva especificación de OpenAI introdujo role: developer, pero algunas pasarelas compatibles solo reconocen system. Si te encuentras con casos en los que «todas las solicitudes fallan» o «solo fallan los modelos de razonamiento», puedes desactivar el rol developer:
compat:
  supportsDeveloperRole: false
Al activar esta opción, el adaptador ajusta la forma en que se gestionan los roles en las solicitudes, de modo que estas se ajusten al formato que la pasarela puede aceptar.
3.2 Compatibilidad del parámetro de salida máxima
La nueva interfaz de OpenAI usa max_completion_tokens para indicar la salida máxima, mientras que algunas pasarelas solo aceptan el tradicional max_tokens. Ambos significan lo mismo, pero si el nombre del campo no coincide, la validación de parámetros falla. La configuración correspondiente es:
compat:
  maxTokensField: max_tokens
3.3 Compatibilidad con el modo de razonamiento de DeepSeek
Algunos modelos DeepSeek tienen el razonamiento activado por defecto. Cuando en Harness se pone el nivel de razonamiento en off, algunos protocolos compatibles simplemente omiten los parámetros de razonamiento, y el modelo sigue pensando según su comportamiento por defecto, lo que hace que «off» no se pueda apagar de verdad. Por eso, oficialmente se ofrece un formato de pensamiento específico para DeepSeek:
compat:
  thinkingFormat: deepseek
Una vez activado, al desactivar el razonamiento el adaptador envía explícitamente {"thinking": {"type": "disabled"}}, y al activarlo envía {"thinking": {"type": "enabled"}}. El ejemplo oficial está pensado para el modelo DeepSeek V4 detrás de una pasarela compatible con OpenAI. En una pasarela multimodelo, este parámetro se puede configurar solo para el modelo DeepSeek, mientras que GPT, Claude y otros modelos mantienen el valor por defecto.
En cuanto al nivel de razonamiento, Harness permite mapear los valores off, low, medium, high, max de la interfaz a los valores que la API realmente acepta. Incluir en la configuración solo los niveles que el modelo realmente soporta evita errores en las peticiones cuando el usuario selecciona un nivel no válido. A continuación, un ejemplo completo que combina los tres parámetros de compatibilidad:
- id: llm-pi-ai
  config:
    providers:
      apiyi:
        apiKeyEnv: APIYI_API_KEY
        api: openai-completions
        baseURL: https://api.apiyi.com/v1
        compat:
          supportsDeveloperRole: false
          maxTokensField: max_tokens
        models:
          - id: MODEL_ID_FROM_APIYI
3.4 Solución rápida de errores comunes de DeepSeek Harness
| Error o síntoma | Posible causa | Cómo resolverlo |
|---|---|---|
| MISSING_CREDENTIAL | Clave no configurada | Revisa la API Key y el nombre de la variable de entorno |
| UNKNOWN_MODEL | ID del modelo no registrado | Agrega el ID de modelo correcto dentro del proveedor |
| HTTP 401 | Clave inválida o permisos insuficientes | Verifica el contenido de la clave y el grupo al que pertenece |
| HTTP 404 | Ruta del Base URL incorrecta | Confirma el protocolo y el prefijo de versión (/v1, dominio raíz, /v1beta) |
| Lista de modelos vacía | La pasarela no soporta la interfaz estándar de listado de modelos | Agrega el ID del modelo manualmente |
| Todas las solicitudes fallan | Conflicto de roles o formato de parámetros | Revisa los parámetros de compatibilidad compat |
| Solo fallan los modelos de razonamiento | El rol Developer no es compatible | Configura supportsDeveloperRole: false |
| off no logra desactivar el pensamiento | El modelo activa el pensamiento por defecto | Configura thinkingFormat: deepseek |
| La interfaz de búsqueda devuelve 503 | El grupo del token no tiene permisos de herramientas | Cambia a un token del grupo default o svip |
| El chat funciona pero la conexión a internet no | La herramienta de búsqueda no está integrada o el protocolo no es compatible | Revisa las capacidades de la herramienta y la configuración del cliente |
Las primeras ocho filas se basan en la documentación oficial de configuración de Harness, mientras que los problemas relacionados con grupos provienen de la documentación oficial de APIYI. Te sugerimos seguir este orden de arriba hacia abajo: primero confirma las credenciales, luego el ID del modelo, después la ruta y, por último, la compatibilidad de parámetros.
4 Añadir capacidad de búsqueda en línea al Harness de DeepSeek
4.1 Distinguir entre búsqueda integrada del modelo y API de búsqueda independiente
Que una conversación normal se ejecute correctamente solo demuestra que la clave API funciona, que el ID del modelo es el correcto y que el protocolo de chat es básicamente compatible. La capacidad de conexión a internet requiere además que el modelo soporte la herramienta correspondiente, que la solicitud declare correctamente la herramienta, que el servicio API soporte ese protocolo de herramientas, que el Harness pueda procesar la respuesta de la herramienta, o que el desarrollador integre la búsqueda por separado en la capa de aplicación. Por eso, que el chat funcione y que la conexión a internet funcione son dos pasos de verificación independientes.
Dentro del ecosistema DeepSeek, la capacidad de conexión a internet tiene dos rutas técnicas:
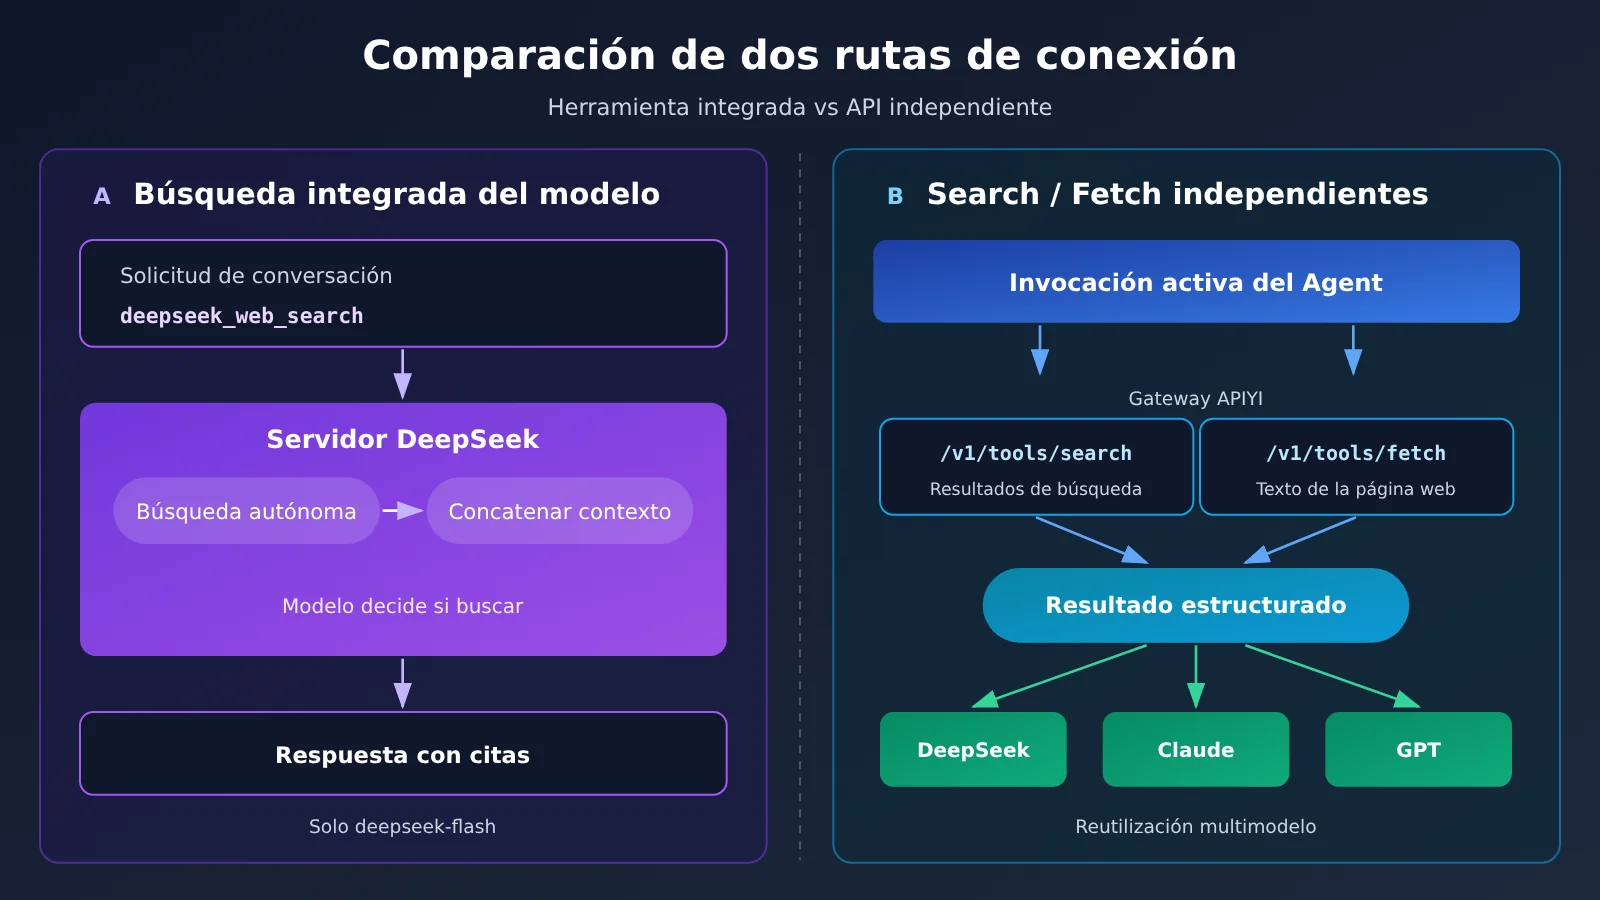
| Dimensión | Ruta A: herramientas del servidor integradas al modelo | Ruta B: API independiente de Search / Fetch |
|---|---|---|
| Forma de invocación | Declarar deepseek_web_search y deepseek_read_url en la solicitud de chat |
El programa solicita activamente /v1/tools/search y /v1/tools/fetch |
| Quién decide buscar | El modelo decide por sí mismo | La lógica de herramientas del desarrollador o del Agent |
| Ejecución de la herramienta | El servidor de DeepSeek realiza la búsqueda y la concatenación de contexto | El cliente procesa el resultado por su cuenta tras recibirlo |
| Alcance de modelos | El anuncio oficial apunta explícitamente a deepseek-flash |
Es independiente del modelo, cualquier modelo puede reutilizar los resultados |
| Criterio de facturación | Se cobra según el número real de términos de búsqueda, páginas web rastreadas, etc. | Se cobra por número de solicitudes exitosas, sin consumir tokens del modelo |
| Canales disponibles actualmente | API oficial de DeepSeek | API oficial de DeepSeek, APIYI |
4.2 Cómo funciona la búsqueda integrada del modelo
El 13 de noviembre de 2026, DeepSeek abrió varias capacidades de aplicación que respaldan la app, entre ellas la búsqueda web y la lectura de enlaces, que se ofrecen como herramientas del lado del servidor. Basta declararlas en la lista de herramientas de la solicitud:
[
  {"type": "deepseek_web_search", "name": "deepseek_web_search"},
  {"type": "deepseek_read_url", "name": "deepseek_read_url"}
]
Una vez declaradas, el modelo decide por sí mismo si necesita conectarse a internet y genera los términos de búsqueda; el servidor de DeepSeek ejecuta la búsqueda y devuelve una respuesta con citas de fuentes. Al activar el modo de pensamiento, la búsqueda pasa a un flujo de varios pasos: el modelo puede buscar varias palabras clave, abrir páginas web, buscar dentro de la página y verificar de forma cruzada. La documentación oficial indica que responde tras un máximo de aproximadamente 20 llamadas a herramientas. deepseek_read_url solo reconoce las URL del último mensaje del usuario y considera como máximo 10 enlaces distintos.
Los desarrolladores todavía deben gestionar los bloques de contenido devueltos, la información de citas, los eventos de streaming y el historial de varios turnos. Según el anuncio oficial, esta integración completa de herramientas a nivel de conversación corre a cargo de deepseek-flash (DeepSeek-V4.1-Flash). De acuerdo con la documentación de APIYI, el trabajo de compatibilidad para llamar a este tipo de búsqueda integrada a través de la pasarela desde clientes como Harness o Claude Code sigue en planificación para etapas posteriores; por ahora, para usar la ruta A, hay que conectarse directamente a la API oficial de DeepSeek.
4.3 Integración independiente de Search / Fetch de APIYI
APIYI lanzó el 21 de octubre de 2026 las interfaces de herramientas independientes DeepSeek Search & Fetch, correspondientes a deepseek-search y deepseek-fetch. Search devuelve resultados de búsqueda estructurados, y Fetch recupera una página web concreta y devuelve el cuerpo en Markdown. Las solicitudes no requieren pasar un ID de modelo ni consumen tokens del modelo, y se facturan por número de llamadas exitosas.
El siguiente ejemplo primero busca y después recupera la página web que ocupa el primer puesto:
import os
import requests

BASE = "https://api.apiyi.com/v1/tools"  # Interfaz de herramientas independientes de APIYI
headers = {"Authorization": f"Bearer {os.environ['APIYI_API_KEY']}"}

search = requests.post(
    f"{BASE}/search",
    headers=headers,
    json={"query": "DeepSeek Harness 插件", "count": 5},
    timeout=60,
)
search.raise_for_status()
results = search.json()["results"]

if results:
    url = results[0]["url"]
    fetch = requests.post(
        f"{BASE}/fetch",
        headers=headers,
        json={"url": url},
        timeout=60,
    )
    if fetch.ok:
        print(fetch.json()["content"])
Hay que prestar especial atención a los grupos de tokens: los grupos default y svip pueden llamar a estas dos interfaces, mientras que los tokens del grupo ClaudeCode no pueden hacerlo directamente, y la documentación registra casos en los que devolvió 503. Las pruebas internas de la documentación de APIYI muestran que Search devuelve 5 resultados en aproximadamente 1.8 segundos y que 20 solicitudes concurrentes devolvieron todas 200; cuando Fetch accede a una página inaccesible, devuelve un fallo y no se cobra. Estos datos provienen de las pruebas de la propia plataforma, y el rendimiento real depende de la red y del sitio de destino. En cuanto al precio, la documentación indica un precio interno de $0.90 por cada 1000 llamadas, y con la bonificación por recarga el pago efectivo resulta aún menor; consulta la consola para el dato exacto.
Para que el Agent de Harness utilice esta lógica de forma autónoma, es necesario encapsularla como un plugin de herramientas. Los plugins de Harness se escriben en TypeScript y registran herramientas a través del objeto de contexto ctx; cuando se desinstala el plugin, el framework elimina automáticamente las herramientas y los eventos registrados. Al encapsular, se recomienda registrar search y fetch como dos herramientas independientes, de modo que el modelo primero obtenga la lista de resultados y luego decida qué páginas recuperar.
💡 Consejo técnico: Search / Fetch independientes están desacoplados del modelo, por lo que un mismo conjunto de resultados de búsqueda puede entregarse a distintos modelos como GPT, Claude o DeepSeek para su procesamiento. Mediante APIYI apiyi.com puedes gestionar con una sola clave API tanto la invocación del modelo como la herramienta de búsqueda, lo que facilita comparar en Harness la calidad de las respuestas de distintos modelos basadas en la misma información.
5 Cómo diseñar un Agent multimodelo con DeepSeek Harness
5.1 Elegir distintos modelos según la tarea
El valor de conectar varios modelos está en asignar el modelo adecuado a cada tarea. Un Agent de programación puede usar un modelo que domine el código; las tareas de alta frecuencia como organizar documentación, resumir o reescribir encajan mejor con modelos de menor coste; y para analizar capturas de pantalla o entender gráficos hay que escoger sí o sí un modelo visual que admita entrada de imágenes, marcando la casilla de imagen en Input Type.
Tomemos como ejemplo los modelos oficiales de DeepSeek: DeepSeek-V4.1-Flash admite comprensión de imágenes y DeepSeek-V4-Pro no, y sus precios también difieren varias veces. Si en Harness los configuras como dos Model ID dentro de un mismo provider y vas cambiando según la tarea dentro de la sesión, consigues equilibrar resultados y coste.
5.2 Gestionar por capas la invocación de modelos de DeepSeek Harness y las capacidades de búsqueda
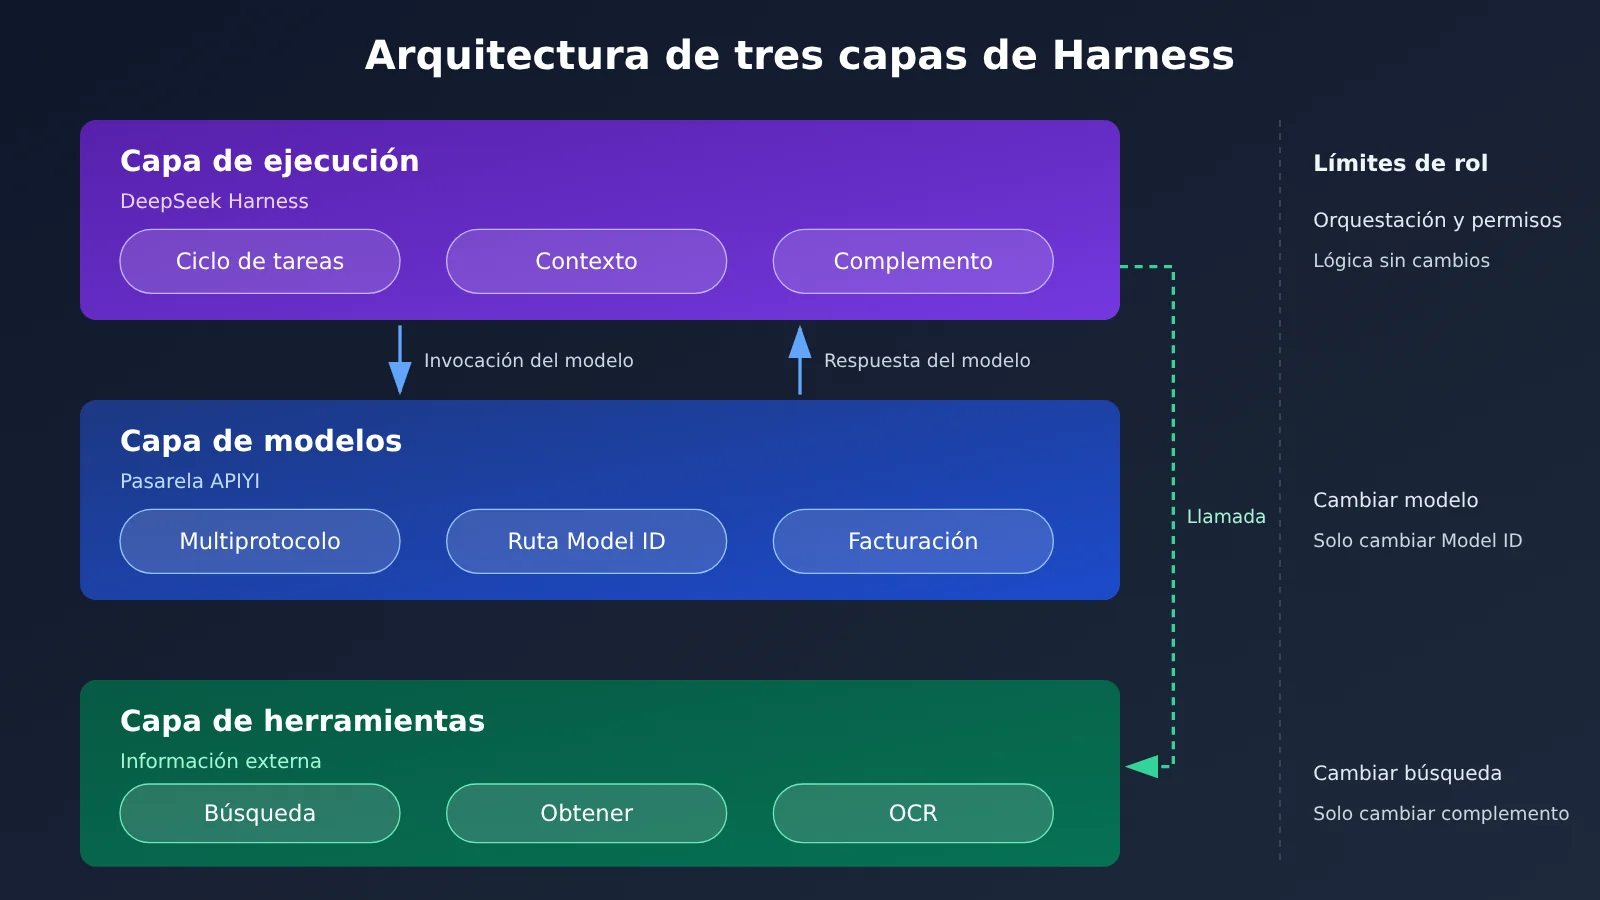
La estructura recomendada se divide en tres capas. La capa de ejecución corre a cargo de Harness: bucle de tareas, compresión de contexto, carga de plugins y control de permisos. La capa de modelos la asume el gateway de API: conversión de protocolos, enrutado de modelos y facturación. La capa de herramientas la aportan interfaces independientes como Search / Fetch para obtener información externa. Las tres capas son sustituibles por separado: cambiar de modelo implica solo modificar el Model ID, cambiar de servicio de búsqueda implica solo cambiar el plugin de herramientas, y la lógica de ejecución queda intacta.
La separación por capas también aporta ventajas de seguridad. Una evaluación controlada del laboratorio Zhuque de Tencent sobre Harness mostró que contenidos no confiables —páginas web, archivos, Skills, etc.— pueden influir en el comportamiento del Agent mediante inyección indirecta de indicaciones. Al separar la capa de herramientas de la capa de ejecución, se puede añadir un filtro y una confirmación unificados antes de que los resultados de búsqueda entren en el contexto y antes de que se ejecuten herramientas sensibles.
5.3 Recomendaciones prácticas para desplegar DeepSeek Harness
- Configuración de modelos: un protocolo corresponde a un provider; el Provider ID en minúsculas y definido de una vez por todas; los model ID se copian siempre desde la consola del gateway.
- Gestión de claves: Harness guarda las claves en
$DSH_HOME/.credentials.yaml; el archivo de configuración solo referencia variables de entorno, para evitar que una Key en texto plano acabe en configuraciones compartidas o en repositorios de código. - Pruebas de compatibilidad: cada vez que integres un modelo nuevo, verifica en orden conversación normal, desactivar el pensamiento, salidas largas y entrada de imágenes; después, según el error, activa el parámetro
compat. - Invocación de herramientas: controla el número de plugins. La comunidad reporta que, tras instalar más de una decena de plugins, pueden aparecer desbordamientos de contexto y un aumento del consumo de tokens; mantener descripciones escuetas en las herramientas de búsqueda resulta más estable.
- Registro de costes: los tokens del modelo y las llamadas a herramientas se facturan por separado, así que conviene contabilizarlos por separado en el panel del gateway. La consola de APIYI apiyi.com permite consultar el uso por Key, lo que va bien para asignar Keys independientes a cada Agent y imputar costes.
Además, antes de actualizar Harness, haz copia de seguridad de la configuración bajo $DSH_HOME. La comunidad documentó un caso en el que, tras una actualización de versión, se perdieron configuraciones de plugins de terceros y la recuperación llevó varias horas.
Preguntas Frecuentes (FAQ)
P1: ¿DeepSeek Harness solo puede usar modelos DeepSeek?
Harness permite, mediante la API de modelos personalizados, conectarse a cualquier servicio compatible con uno de los cuatro protocolos, incluidos las familias OpenAI, Claude, Gemini, así como diversos gateways de API y servicios de modelos autoalojados. El modelo oficial de DeepSeek es solo una de las opciones.
P2: ¿Por qué crear varios proveedores para un mismo gateway?
Harness establece que un proveedor solo se vincula a un protocolo. APIYI ofrece simultáneamente tres entradas: compatible con OpenAI, Anthropic y Gemini. Si quieres invocar GPT, Claude y Gemini respectivamente con protocolos nativos, necesitas crear tres proveedores, con Base URL respectivamente `/v1`, el dominio raíz y `/v1beta`.
P3: ¿Cómo confirmo qué ID de modelo debo escribir?
Prueba primero la función «Obtener modelos disponibles»; si no pueden leerse, copia el nombre exacto de la lista de modelos en la consola de APIYI apiyi.com y añádelo manualmente. El ID del modelo distingue entre mayúsculas y minúsculas y sufijos de versión; cualquier diferencia activará UNKNOWN_MODEL o un error del gateway.
P4: Tras conectarse vía APIYI, ¿se puede usar deepseek_web_search directamente?
Actualmente APIYI ya admite las interfaces independientes Search / Fetch de DeepSeek; el trabajo de compatibilidad para invocar la búsqueda integrada del modelo a través de clientes como Harness sigue en planificación. En esta etapa se recomienda usar `/v1/tools/search` y `/v1/tools/fetch` de APIYI para encapsularlos como herramientas de Agent; cuando se necesite búsqueda integrada, conéctate directamente a la API oficial de DeepSeek.
P5: La interfaz de búsqueda devuelve 503, pero el diálogo funciona perfectamente, ¿cuál es la causa?
La causa más común es la agrupación de tokens. Los tokens del grupo ClaudeCode no pueden llamar directamente a interfaces de herramientas independientes; basta cambiar a una Key de los grupos default o svip. Puedes crear por separado un token del grupo correspondiente para la herramienta de búsqueda en el panel de APIYI apiyi.com, gestionándolo por separado de la Key de invocación del modelo.
P6: ¿Qué limitaciones tiene la integración multimodelo de DeepSeek Harness?
Harness sigue siendo una versión preliminar para desarrolladores; la estructura de configuración puede cambiar según la versión. El grado de transferencia transparente de Responses, parámetros de razonamiento y protocolos de herramientas varía entre gateways, y debe verificarse modelo por modelo. Demasiados plugins aumentarán el contexto y el costo de Tokens, y la calidad de entrega de tareas complejas también depende de la configuración de plugins y la gestión del proceso de ejecución.
Resumen
El mecanismo de adaptación de modelos abiertos de DeepSeek Harness permite que un framework de Agent llame a modelos de múltiples proveedores a través de una pasarela unificada. A la hora de implementarlo, conviene tener en cuenta estos puntos:
- El protocolo define el proveedor: se crea un Provider por cada protocolo, y el prefijo de versión de la Base URL se corresponde estrictamente con el protocolo.
- El ID del modelo se copia de la pasarela: cópielo desde la consola y, si no puede leer la lista, añádalo manualmente.
- Los parámetros de compatibilidad se activan según el error: el rol developer, el campo
max_tokensy el formato de pensamiento de DeepSeek cubren la mayoría de los problemas del tipo «conecta pero no funciona». - La capacidad de búsqueda en internet se planifica aparte: la búsqueda integrada utiliza la API oficial de DeepSeek, mientras que Search / Fetch independientes pueden invocarse a través de la pasarela y encapsularse como herramientas.
- Capas y gobernanza: separe la capa de ejecución, la capa de modelos y la capa de herramientas, y gestione por separado las claves, las versiones y los costes.
Se recomienda empezar ejecutando un único modelo para completar el flujo «verificación del script → configuración de Harness → conversación sencilla» y, después, ir añadiendo más modelos y herramientas de búsqueda. Le sugerimos solicitar una cuota de prueba gratuita a través de APIYI apiyi.com y completar con una sola clave la verificación integral de varios modelos junto con Search / Fetch.
📚 Referencias
- Documentación de configuración de modelos de DeepSeek Harness: campos de proveedor personalizado y parámetros de compatibilidad
compat - Enlace:
deepseek-harness.github.io/deepseek-harness/guide/providers -
Descripción: documentación oficial de supportsDeveloperRole, maxTokensField y thinkingFormat
-
Repositorio GitHub de DeepSeek Harness: código fuente, Releases y forma de inicio
- Enlace:
github.com/deepseek-ai/deepseek-harness -
Descripción: actualizaciones de versión y notas sobre la fase de vista previa para desarrolladores
-
Documentación de las herramientas web de DeepSeek: deepseek_web_search y deepseek_read_url
- Enlace:
api-docs.deepseek.com/zh-cn/guides/web_tools/ -
Descripción: forma de declaración de la búsqueda integrada, limitaciones y criterios de facturación
-
Guía de configuración de Base URL de APIYI: descripción de las tres rutas de protocolo
- Enlace:
help.apiyi.com/apiyi-base-url-v1-claude-gemini-endpoint-config-guide.html -
Descripción: casos de uso de
/v1, el dominio raíz y/v1beta -
Documentación de DeepSeek Search & Fetch de APIYI: interfaces de herramientas independientes y requisitos de agrupación
- Enlace:
docs.apiyi.com/api-capabilities/deepseek-search-fetch/overview - Descripción: parámetros de solicitud, agrupación de tokens y criterios de facturación
Autor: Equipo técnico de APIYI
Intercambio técnico: si encuentra problemas durante la configuración, puede contactarnos a través de la página de inicio de APIYI apiyi.com; para más información sobre interfaces, consulte el centro de documentación en docs.apiyi.com