Hinweis des Autors: Gemini 4 Hydrogen erledigt alltägliches Programmieren, Dokumentverarbeitung und Agent-Ausführung mit ein und demselben Modell. Dieser Artikel gibt einen Überblick über die neuen Fähigkeiten, die kostenlosen Zugänge und die Aufgabenteilung mit den Modellen derselben Serie.
Zusammenfassung in einem Satz: Gemini 4 Hydrogen ist Googles hocheffizientes Ausführungsmodell innerhalb der Gemini-4-Familie. Der Schwerpunkt liegt auf alltäglichem Programmieren, Agenten mit mehreren Werkzeugen und der Verarbeitung von Dokumenten in verschiedenen Formaten. Nutzer der kostenlosen Version können es im Auto-Modus der Gemini App oder in der kostenlosen Stufe von Google AI Studio ausprobieren.
Gut zu wissen: 5 Begriffe, die Sie vor dem Lesen kennen sollten
- Agent: Ein System, in dem Modell und Werkzeug-Ausführungsumgebung gemeinsam mehrstufige Aufgaben erledigen – zum Beispiel zuerst Dateien durchsuchen, dann Code ändern und schließlich Tests ausführen.
- Token: Die Recheneinheit, mit der das Modell Text und andere Informationen verarbeitet; API-Abrechnung und Kontextbudget werden in Token berechnet.
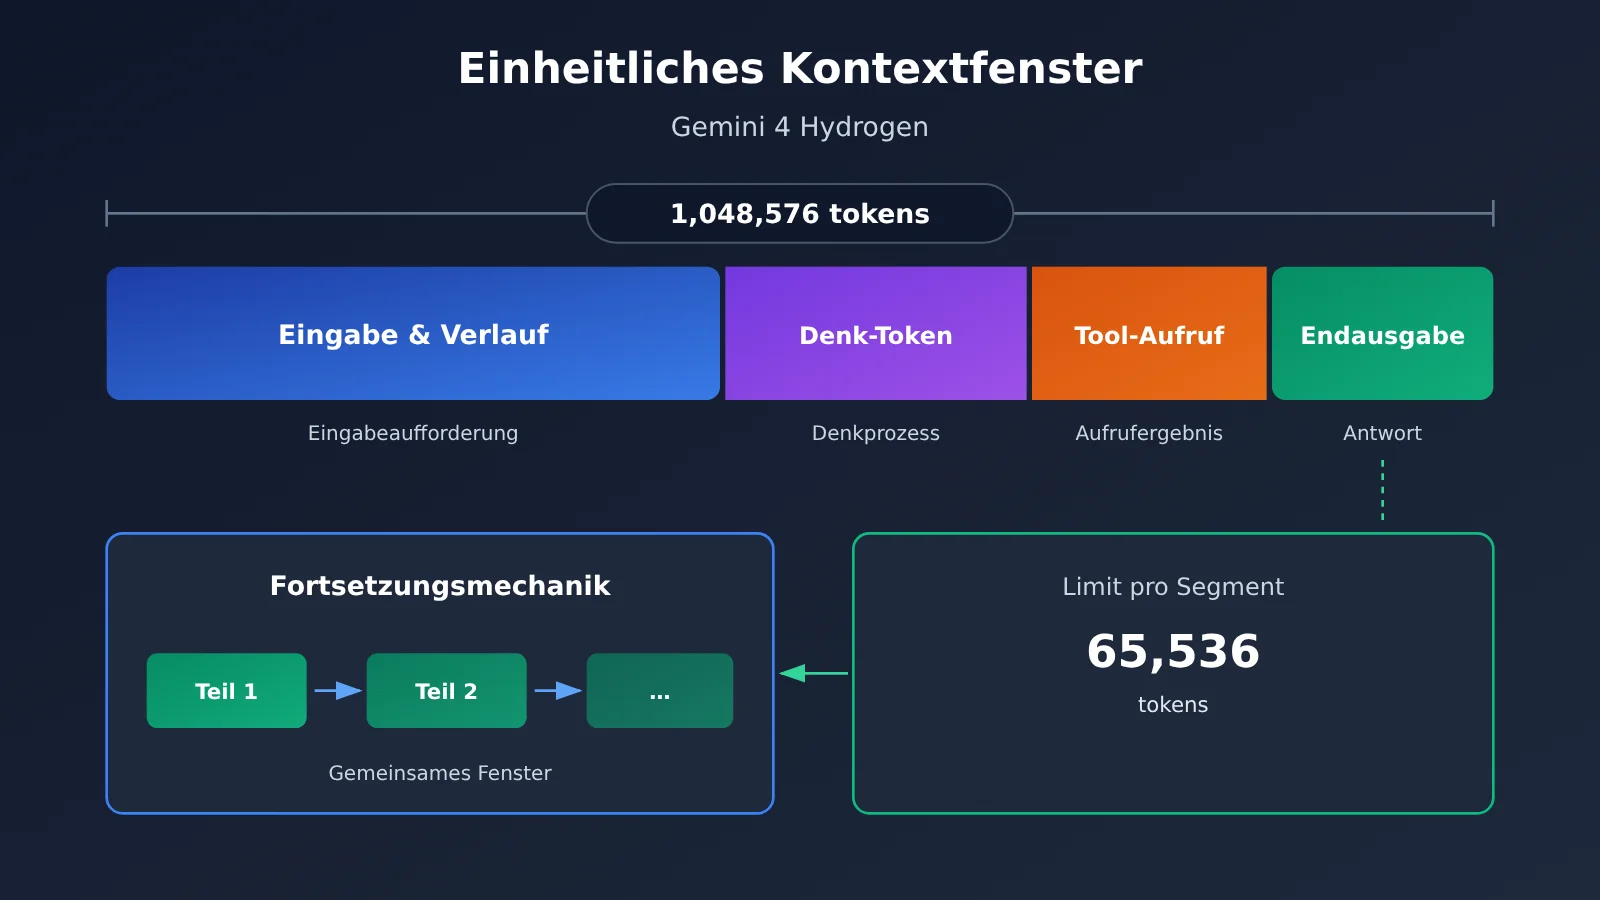
- Kontextfenster: Der Informationsumfang, den ein einzelner Modellaufruf aufnehmen kann; die konkrete Obergrenze wird durch das Modell festgelegt. Bei Hydrogen ergeben Eingabe, Denken, Werkzeugaufrufe und Ausgabe zusammen 1,048,576 Token.
- thinking_level: Der Parameter für die Denkstufe, der die Tiefe der Schlussfolgerung des Modells steuert. Hydrogen bietet vier Stufen: Low, Medium, High und XHigh.
- Grounding: Die Verknüpfung generierter Antworten mit abgerufenen externen Belegen, zum Beispiel Google Search Grounding und Google Maps Grounding.
Google hat am 12. November 2026 offiziell Gemini 4 Hydrogen veröffentlicht und rollt es seitdem schrittweise in der Gemini API, in Google AI Studio, in der Gemini App und in der Google-Suche aus. Die größte Veränderung besteht darin, dass es das Intelligenzniveau der Gemini-4-Serie in häufig anfallende Alltagsaufgaben bringt. Bei Terminal-Bench 4.1 liegt das offizielle Ergebnis bei 57.0%, für die vorherige Generation Gemini 3.8 Flash bei 18.2%.
Das ist keine geleakte oder vorab angekündigte Meldung. Googles offizieller Blog, die Model Card von Google DeepMind, die technische Dokumentation von Google Cloud und Googles offizieller chinesischsprachiger Blog bestätigen diese Veröffentlichung übereinstimmend. Auch TechCrunch, Ars Technica, 9to5Google und The Verge haben darüber berichtet.
Der Kernnutzen: Verschaffen Sie sich in wenigen Minuten einen Überblick darüber, was Gemini 4 Hydrogen verbessert, wo Sie es kostenlos nutzen können und ob es zu Ihrer Arbeit passt.
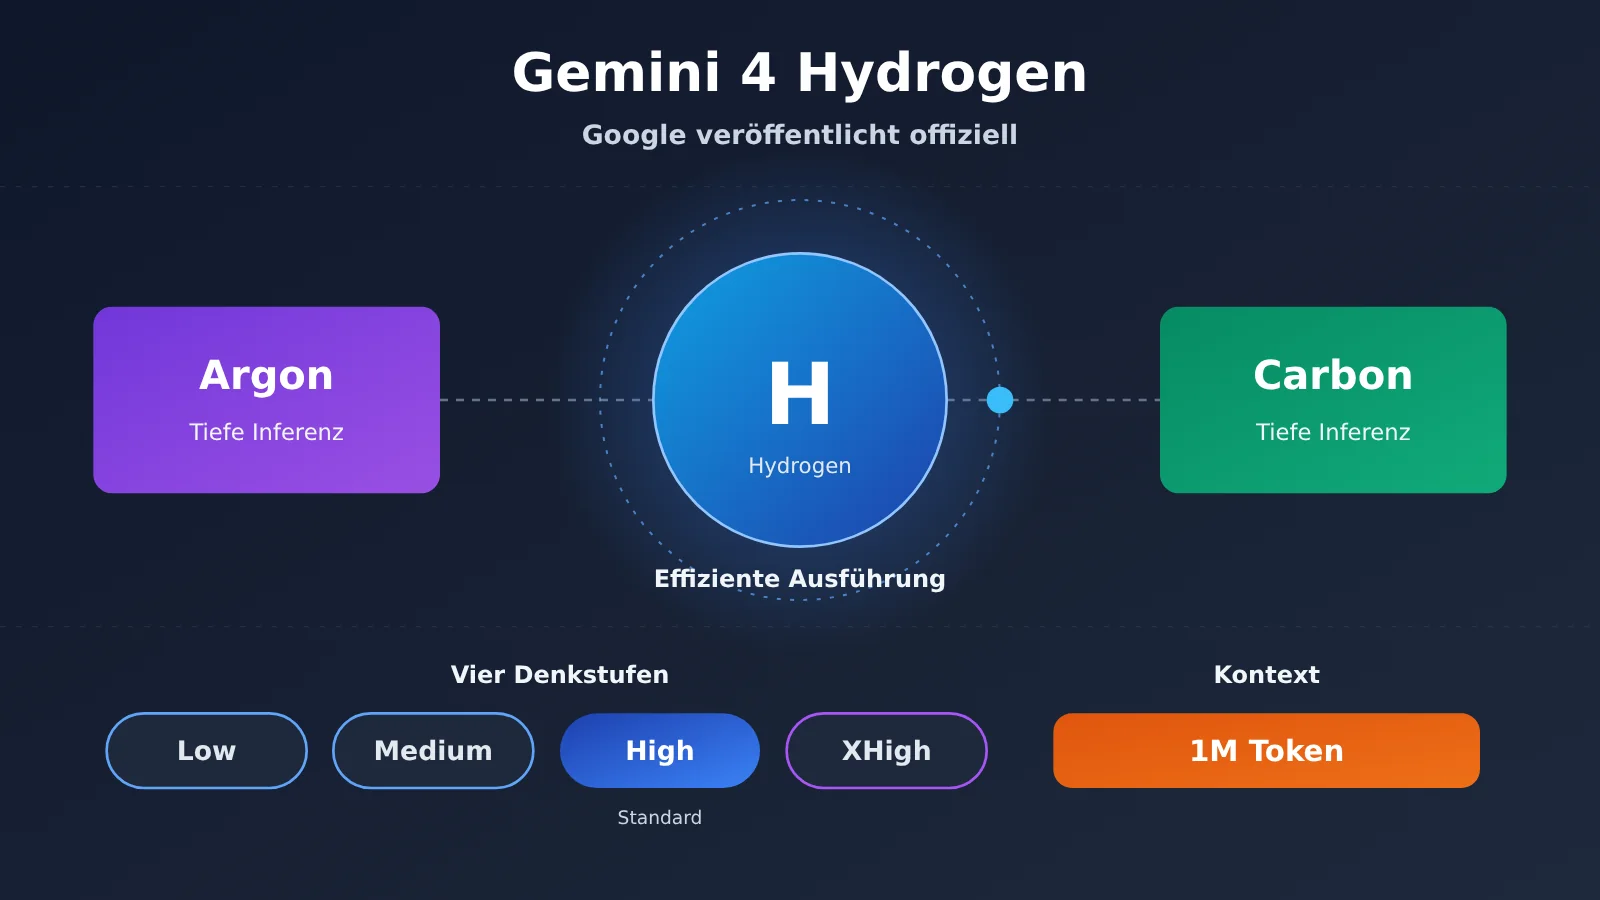
Google stellt Gemini 4 Hydrogen offiziell vor: ein neues Mitglied der Gemini-4-Familie
Gemini 4 Hydrogen: Kerninformationen im Überblick
| Information | Verifizierte Details |
|---|---|
| Veröffentlichung | 12. November 2026, weltweiter schrittweiser Rollout |
| Anbieter | Google DeepMind |
| API-Modell-ID | gemini-4-hydrogen |
| Offizielle Positionierung | Hocheffizientes Ausführungsmodell für alltägliche Programmieraufgaben und KI-Agenten |
| Modelle derselben Serie | Gemini 4 Carbon, Gemini 4 Argon |
| Kontextbudget | Eingabe, Denken, Tool-Aufrufe und Ausgabe zusammen 1,048,576 Tokens |
| Reasoning-Stufen | Low / Medium / High / XHigh, API-Standard: High |
| Wissensstand | März 2026 |
| Produktstatus | Allgemein verfügbar (Google Cloud kennzeichnet es als kurzfristiges GA-Angebot; vor der Stilllegung wird mindestens 45 Tage im Voraus benachrichtigt) |
In der Gemini-4-Familie ist die Aufgabenteilung der drei Modelle klar. Carbon und Argon sind für komplexe, zeitintensive Reasoning-Aufgaben zuständig; Hydrogen setzt stärker auf Geschwindigkeit, alltägliches Programmieren, viele Tool-Aufrufe und automatisierte Ausführung. Die offizielle Modellkarte erklärt außerdem, dass Hydrogen von Gemini 4 Carbon abgeleitet wurde, Google aber keine konkreten Parameterzahlen veröffentlicht hat.
Hydrogen lässt sich eigenständig einsetzen oder in Multi-Modell-Agentensystemen als Ausführender oder Validierer fungieren. Üblich ist, dass Carbon oder Argon die Entscheidung treffen und Hydrogen anschließend die Ausführung übernimmt. Ars Technica interpretiert die Ankündigung dahingehend, dass Hydrogen an die Stelle der Flash-Serie tritt.
Offizielle Benchmark-Ergebnisse von Gemini 4 Hydrogen im Vergleich zu Gemini 3.8 Flash
| Bewertungspunkt | Gemini 4 Hydrogen | Gemini 3.8 Flash | Datenquelle |
|---|---|---|---|
| Terminal-Bench 4.1 | 57.0% | 18.2% | Google (offiziell) |
| Geschwindigkeit bei der Aufgabenausführung unter identischen Testbedingungen | etwa 2.5-mal schneller | Referenz | Google (offiziell) |
| Häufigkeit erfundener Fakten | um mehr als das 5-Fache reduziert | Referenz | Google (offiziell) |
| Unternehmensdatenaufgaben wie Graphendaten, SQL und ähnliche | 2-2.8-mal schnellere Ausführung, Token-Verbrauch um 12%-23% reduziert | Referenz | Partnertests |
Diese Zahlen sind offiziell veröffentlicht oder stammen aus Partnertests und lassen nicht direkt den Schluss zu, dass Hydrogen bei allen Aufgaben 2.5-mal schneller ist. In der modellübergreifenden Auswertung der DeepMind-Modellkarte erreicht Hydrogen 76.1% bei AutomationBench-AA, 71.6% bei Agents‘ Last Exam v1.1 und 58.8% bei HLE-Diamond. Bei Terminal-Bench 4.1 (57.0%) und OSWorld-2.1 (77.6%) liegt es jedoch unter den Werten von Claude Sonnet 5.5 (63.9% bzw. 83.9%). Die offizielle Methodenbeschreibung merkt außerdem an, dass einige Konkurrenzwerte von Herstellern oder öffentlichen Ranglisten übernommen wurden und die Testkonfigurationen nicht vollständig einheitlich sind.
Welche Fähigkeiten wurden bei Gemini 4 Hydrogen erweitert?
Verbesserungen in vier konkreten Aufgabenbereichen
Die von Google offiziell aufgeführten Schwerpunkt-Szenarien lassen sich in vier Kategorien einteilen, die jeweils konkreten Arbeitsschritten im Alltag entsprechen:
- Codeänderung und Debugging: Code-Repositories verstehen, Fehler lokalisieren, Bugs beheben, Abhängigkeiten anpassen und Tests ausführen. Der Schwerpunkt liegt diesmal auf präzisen Bearbeitungen, also nur die Stellen zu ändern, die geändert werden müssen, und irrelevanten Code unangetastet zu lassen.
- Mehrstufige Agent-Ausführung: Tools nacheinander aufrufen, Dateien parallel durchsuchen und Aktionen ausführen. Wenn ein Tool-Aufruf fehlschlägt, kann es seine Strategie anpassen und weiterarbeiten.
- Dokument- und multimodales Verständnis: Es kann PDF, DOC/DOCX, PPT/PPTX, XLS/XLSX, OpenDocument, Diagramme und Webseiten lesen. Eine einzelne Anfrage kann bis zu 3000 Bilder oder Dokumente enthalten; Videoeingaben mit Audio etwa 45 Minuten, ohne Audio etwa 1 Stunde, Audio bis zu etwa 8,4 Stunden.
- Interaktive Webentwicklung: interaktive Seiten, Website-Prototypen, lauffähige Komponenten und Visualisierungen erzeugen.
Zu beachten ist: Hydrogen gibt nur Text aus; Bilder, Audio und Video dienen ausschließlich als Eingabe. Es kann Videos verstehen und an Video-Produktionsprozessen mitwirken, ist aber selbst kein Videogenerierungsmodell. Die von Google gezeigten Videoschnitt-Beispiele beruhen auf benutzerdefinierten Skills und externen Tools.
Gemini 4 Hydrogen in der Praxis: Box, Pixelcut und Google-Demos
Die folgenden Partnerdaten stammen aus frühen Tests, die in der Google-Ankündigung offengelegt wurden, und wurden nicht von unabhängigen Dritten nachgeprüft. Box setzt Hydrogen für Unternehmensdokumente, Tabellen und Datenberechnungen ein: rund 2-mal schneller als 3.8 Flash und 12 % weniger Token-Verbrauch. Pixelcut hat 276 Durchläufe für automatisiertes Design und Codegenerierung absolviert – 1,8-mal schneller und 30 % bessere Code-Sauberkeit.
Googles eigene Demos sind eher visuell ausgerichtet. So werden etwa 3D-Strukturen auf einer gemeinsamen Voxel-Insel in Echtzeit per natürlicher Sprache erzeugt (Geminisland), E-Commerce-Website-Prototypen mit WebGL2-Effekten und 3D-Produktkomponenten generiert sowie Google Slides aus YouTube-Vortragsvideos und Vorlagen erstellt, wobei Textüberlappungen automatisch geprüft und korrigiert werden. Diese Beispiele zeigen, dass Google die entsprechenden Workflows erfolgreich umgesetzt hat – normale Nutzer kommen mit denselben Eingabeaufforderungen aber nicht unbedingt beim ersten Versuch zum Erfolg.
Eine Million Token vereinter Kontext und vier Denkstufen
Hydrogens 1.048.576 Tokens sind ein einheitliches Budget: Eingabe, Verlaufskontext, Denk-Tokens, Tool-Aufruf-Tokens und die finale Ausgabe werden alle davon abgezogen. Es handelt sich also nicht um „1 Million Eingabe und dann nochmal 1 Million Ausgabe“. Die Generierung im Vordergrund ist pro Abschnitt in der Regel auf 65.536 Tokens begrenzt; längere Ausgaben benötigen eine Fortsetzung über continuation_token oder Mechanismen zur langen Generierung im Hintergrund – und unterliegen weiterhin dem einheitlichen Budget.
Die Denkstufe hat großen Einfluss auf die tatsächliche Leistung. Im Folgenden die unabhängige Auswertung von Artificial Analysis vom 12. November, also Drittanbieterdaten:
| Denkstufe | Offiziell empfohlener Einsatz | Intelligenzindex | Ø Dauer der Benchmark-Aufgabe | Ø Kosten der Benchmark-Aufgabe |
|---|---|---|---|---|
| Low | Einfache Aufgaben wie Klassifizierung | 27 | 1,3 Minuten | $0,29 |
| Medium | Reguläre Programmierung | 41 | 3,7 Minuten | $0,80 |
| High (API-Standard) | Mehrstufige Agenten | 51 | 8,3 Minuten | $1,87 |
| XHigh | Komplexes tiefes Reasoning | 54 | 13,5 Minuten | $3,16 |
Die Dauer- und Kostenangaben in dieser Tabelle sind Ergebnisse auf standardisierten Benchmark-Aufgaben des Artificial Analysis Intelligence Index v5.0.1 und geben nicht die tatsächliche Latenz oder die Kosten pro Nachricht in einem normalen Gespräch wieder. Aus den Daten lassen sich zwei Punkte ablesen. Erstens: Unter demselben Modellnamen liegen High und Medium 10 Punkte auseinander – beim Vergleich muss die Stufe angegeben werden. Zweitens: XHigh liegt nur 3 Punkte über High, doch die durchschnittlichen Kosten steigen von 1,87 auf 3,16 US-Dollar – die höchste Stufe ist also nicht unbedingt lohnenswert.
Wie lässt sich Gemini 4 Hydrogen kostenlos ausprobieren? Die drei Zugänge im Detail
Wie Gemini 4 Hydrogen auf den verschiedenen Ebenen genutzt wird
| Zugang / Nutzerebene | Nutzung von Hydrogen | Beschreibung |
|---|---|---|
| Kostenloses Konto in der Gemini App | Automatisches Routing über Auto | Einfache Fragen werden meist von Flash-Lite beantwortet, Anfragen, die Schlussfolgern erfordern, können an Hydrogen gehen |
| Google AI Plus | Manuell auswählbar | Umschalten über die Modellauswahl |
| Google AI Pro | Manuell auswählbar, auch in Tasks nutzbar | Wird in Antigravity schrittweise freigeschaltet |
| Google AI Ultra | Manuell auswählbar, zusätzlich Modelle höherer Ebenen verfügbar | Orchestrator (Carbon/Argon) verfügbar |
| Kostenlose Stufe von Google AI Studio | Modell-ID direkt auswählen | Unterliegt den Kontingenten der kostenlosen Stufe |
| Kostenlose Stufe der Gemini API | Aufruf von gemini-4-hydrogen |
Limits für RPM/TPM/RPD werden pro Projekt berechnet |
Zugang 1: Gemini App. Wenn kostenlose Nutzer Auto aktivieren, wählt das System das Modell automatisch nach der Schwierigkeit der Aufgabe; Anfragen, die Schlussfolgern erfordern, können an Hydrogen gehen. Ist Auto deaktiviert, verwendet das kostenlose Konto Flash-Lite. Ein Punkt, der leicht für Verwirrung sorgt: Wählt man in der Gemini App ein Modell manuell aus und gibt keine Denkstufe (Thinking-Level) an, gilt standardmäßig Low – bei der Hydrogen API ist dagegen High der Standard.
Um herauszufinden, welches Modell eine Antwort erzeugt hat, kann man am Desktop nach der Anleitung im offiziellen Hilfe-Center vorgehen: unter der Antwort auf More → Show thinking steps klicken und ans Ende scrollen, um die Modellinformationen zu sehen. Die Oberfläche kann je nach Client und Region unterschiedlich sein; maßgeblich ist die tatsächliche Anzeige.
Zugang 2: Google AI Studio. In der Modellliste lässt sich Gemini 4 Hydrogen direkt auswählen und im Chat testen – ideal, um Eingabeaufforderungen und Denkstufen zu prüfen, bevor man Code schreibt. Die kostenlose Stufe hat keine feste Aufrufzahl; stattdessen werden pro Projekt gleichzeitig RPM (Anfragen pro Minute), TPM (Eingabe-Token pro Minute) und RPD (Anfragen pro Tag, zurückgesetzt um Mitternacht pazifischer Zeit) betrachtet. Maßgeblich sind die in AI Studio angezeigten effektiven Limits.
Zugang 3: Gemini API. Sowohl die kostenlose als auch die kostenpflichtige Stufe lassen sich aufrufen, die Limits unterscheiden sich jedoch. Außerdem können Inhalte der kostenlosen API-Stufe zur Verbesserung von Google-Produkten verwendet werden; laut offizieller Preisseite werden Inhalte der kostenpflichtigen Stufe nicht für diesen Zweck genutzt. Bei der Verarbeitung sensibler Geschäftsdaten sollte man das berücksichtigen.
Google spricht von einem „schrittweisen Rollout“. Schon am Veröffentlichungstag berichteten Nutzer, dass die Modelloption in der Gemini App kurz erschien und dann wieder verschwand oder dass das Modell in Antigravity sichtbar war, ein Aufruf aber fehlschlug. Eine globale Veröffentlichung bedeutet auch nicht, dass Netzwerkzugang, Kontoberechtigung und Servicerichtlinien in der Region Festlandchina keinen Einschränkungen unterliegen.
Beispielaufruf der Gemini 4 Hydrogen API
Wenn Sie die Integration über die OpenAI-kompatible Schnittstelle in ein bestehendes Projekt einbinden möchten, können Sie sich an der folgenden Variante orientieren:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

response = client.chat.completions.create(
    model="gemini-4-hydrogen",  # Der tatsächlich verfügbare Modellname richtet sich nach der Modellliste der Plattform
    messages=[{"role": "user", "content": "帮我定位这段 Python 代码的 Bug 并给出最小修改"}]
)
print(response.choices[0].message.content)
Vollständigen Code mit System-Eingabeaufforderung und Fehlerbehandlung ansehen
import openai
from typing import Optional

def ask_hydrogen(
    prompt: str,
    system_prompt: Optional[str] = None,
    max_tokens: int = 4000
) -> str:
    """Ruft Gemini 4 Hydrogen für alltägliche Programmier- oder Rechercheaufgaben auf"""
    client = openai.OpenAI(
        api_key="YOUR_API_KEY",
        base_url="https://api.apiyi.com/v1"
    )
    messages = []
    if system_prompt:
        messages.append({"role": "system", "content": system_prompt})
    messages.append({"role": "user", "content": prompt})

    try:
        # Hinweis: Hydrogen ignoriert benutzerdefinierte temperature/top_p/top_k, daher nicht setzen
        # Denk-Tokens fließen in die Abrechnung der Ausgabe ein, max_tokens muss Platz fürs Denken mit einkalkulieren
        response = client.chat.completions.create(
            model="gemini-4-hydrogen",
            messages=messages,
            max_tokens=max_tokens
        )
        return response.choices[0].message.content
    except Exception as e:
        return f"Error: {str(e)}"

print(ask_hydrogen(
    prompt="把这份会议纪要整理为三级标题的 Markdown 文档",
    system_prompt="严格遵守用户指定的格式,不添加无关内容"
))
🚀 Schnellstart: APIYI apiyi.com bietet eine OpenAI-kompatible Schnittstelle – mit einem einzigen API-Schlüssel lassen sich gängige Modelle wie OpenAI, Claude und Gemini aufrufen, und neue Nutzer erhalten ein kostenloses Testkontingent. Prüfen Sie vor der Integration in der Modellliste der Plattform, ob Hydrogen verfügbar ist und wie das Modell genau heißt; wie Parameter wie die Denkstufe übergeben werden, entnehmen Sie bitte der Plattformdokumentation.
Entwickler, die von 3.8 Flash migrieren, sollten einige inkompatible Änderungen besonders beachten:
thinking_budgetundMINIMALwerden nicht mehr unterstützt; bei weiterer Verwendung wird ein HTTP 400 zurückgegeben.- Die Standard-Denkstufe wechselt von Medium auf High.
- Explizites Kontext-Caching wird nicht mehr unterstützt, es gibt nur noch implizites Caching mit mindestens 4096 Tokens.
- Bei mehrstufigen Tool-Aufrufen müssen Thought Signatures korrekt gespeichert und zurückgegeben werden.
Wie wählt man zwischen Gemini 4 Hydrogen, Flash, Argon und Carbon?
Aufteilung nach Aufgabenschwierigkeit, Reaktionsgeschwindigkeit und Ausführungskomplexität
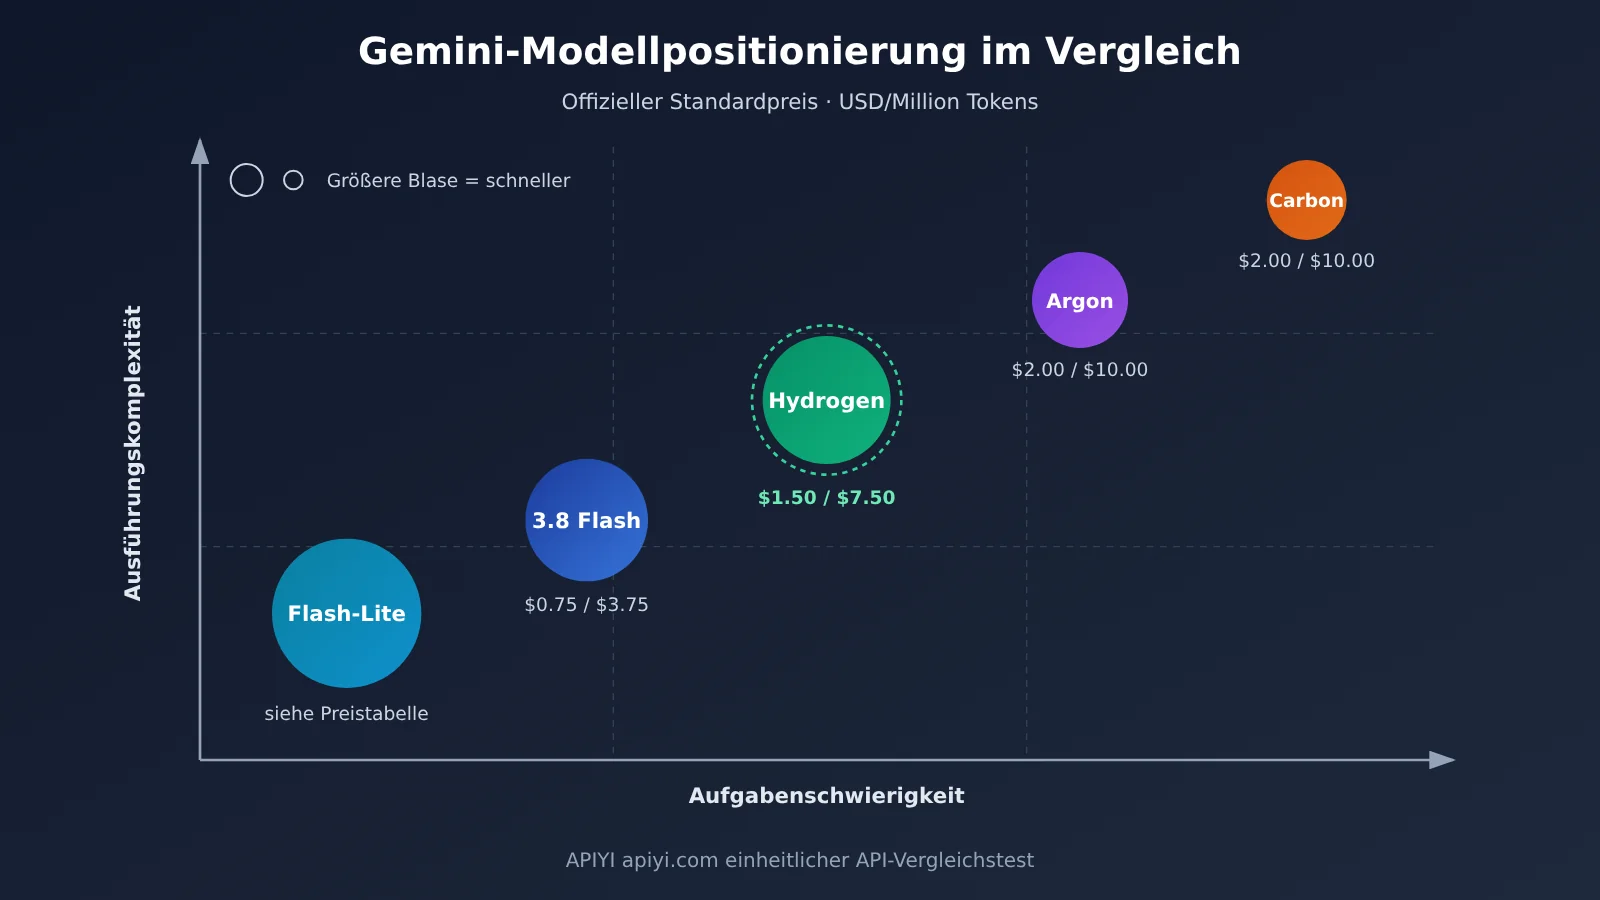
| Modell | Aufgabenschwierigkeit | Reaktionsgeschwindigkeit | Ausführungskomplexität | Typische Aufgaben | Offizieller API-Standardpreis (Eingabe/Ausgabe) | Verfügbare Plattformen |
|---|---|---|---|---|---|---|
| Flash-Lite | Niedrig | Am schnellsten | Niedrig | Einfache Frage-und-Antwort-Aufgaben | Nicht angegeben | Gemini App u. a. |
| Gemini 3.8 Flash | Mittel-niedrig | Schnell | Mittel | Leichte Alltagsaufgaben | $0.75 / $3.75 (bis 31. Dezember 2026) | Gemini API, APIYI apiyi.com (gemäß Modellliste) |
| Gemini 4 Hydrogen | Mittel-hoch | Schnell | Hoch (mehrere Tools) | Alltägliches Programmieren, Datenverarbeitung, Agent-Ausführung | $1.50 / $7.50 | Gemini API, AI Studio, APIYI apiyi.com (gemäß Modellliste) |
| Gemini 4 Argon | Hoch | Mittel | Hoch | Komplexe Workflows | $2.00 / $10.00 (bis 30. November 2026) | Gemini API u. a. |
| Gemini 4 Carbon | Höchste | Langsam | Höchste | Tiefgehende Architekturarbeit, langfristig schwierige Aufgaben | $2.00 / $10.00 (bis 30. November 2026) | Gemini API u. a. |
Die Preisangaben stammen von der offiziellen Preisseite von Google AI Studio, die Einheit ist US-Dollar pro Million Tokens, Stand der Prüfung: 13. November 2026, berechnet nach Standard-Aufrufen. Auf der Preisseite ist vermerkt, dass 3.8 Flash ab dem 1. Januar 2027 auf $1.50/$7.50 angepasst wird, Argon und Carbon ab dem 1. Dezember 2026 auf $4/$20; für Hydrogen ist derzeit keine vergleichbare Preisanpassung angekündigt. Die Batch- und Flex-Preise von Hydrogen liegen bei $0.75/$3.75, der Priority-Preis bei $2.70/$13.50.
Zum Zeitpunkt der Veröffentlichung liegt der Standardpreis pro Token bei Hydrogen also doppelt so hoch wie der aktuelle Preis von 3.8 Flash – nicht niedriger. Reasoning-Token werden zum Ausgabepreis gerechnet; die tatsächlichen Gesamtkosten einer Aufgabe hängen von der Länge des Reasonings, der Anzahl der Wiederholungsversuche, dem Umfang der Tool-Aufrufe und der Abschlusseffizienz ab. Bei Google Search Grounding sind in der kostenpflichtigen Ebene die ersten 5.000 Aufrufe pro Monat kostenlos (geteilt mit Gemini 3 und neueren Modellen), danach kostet jede 1.000 Aufrufe 14 US-Dollar; in der kostenlosen API-Ebene gibt es dieses Kontingent nicht.
Der Unterschied zwischen Alleineinsatz und Multi-Modell-Kooperation
Wie man Aufgaben den Modellen zuordnet, lässt sich so verstehen: Einfache Frage-und-Antwort-Aufgaben gehen an Flash-Lite; für alltägliches Programmieren, Dokumentenaufbereitung und Agent-Aufgaben mittlerer Komplexität ist Hydrogen die ausgewogene Wahl mit gutem Preis-Leistungs-Verhältnis; tiefgehende Architekturentwürfe, die modulübergreifendes Reasoning erfordern, übernimmt Carbon oder Argon. Hydrogen allein eignet sich für Aufgaben mit klarem Ziel und eindeutigen Schritten. Bei schwierigen Problemen, bei denen die Richtung immer wieder neu bewertet werden muss, neigt es dazu, zu viele Schritte in die falsche Richtung auszuführen, wenn man sich nur auf dieses Modell verlässt.
Das Paradebeispiel für Multi-Modell-Kooperation ist der zeitgleich veröffentlichte Google Antigravity Orchestrator. In diesem Ablauf analysiert Carbon zuerst das Code-Repository und legt den Änderungsplan fest, Hydrogen übernimmt die konkreten Edits, das Aktualisieren von Abhängigkeiten und das Ausführen von Tests, und bei komplexen Fehlern geht es zurück an Carbon zur Bewertung. Laut dem offiziellen Google-Bericht reduziert dieser Ansatz im Terminal-Bench 4.1 den durchschnittlichen Quota-Verbrauch gegenüber dem alleinigen Einsatz von Carbon um 24 %, die Fertigstellungsgeschwindigkeit steigt um 19 %, und die Erfolgsquote liegt nahe an der von Carbon.
💡 Auswahlempfehlung: Welches Modell man wählt, hängt von der Aufgabenschwierigkeit und dem Budget ab. Es empfiehlt sich, zunächst dieselbe Reihe echter Aufgaben einmal mit Hydrogen in den Stufen Medium und High sowie mit Argon laufen zu lassen und dann die Abschlussrate und den Token-Verbrauch zu vergleichen. APIYI apiyi.com unterstützt einheitliche Schnittstellenaufrufe für mehrere Modelle – ein Modellwechsel erfordert nur die Anpassung des Parameters model, was solche Vergleiche erleichtert.
Wirkungsanalyse von Gemini 4 Hydrogen
Auswirkungen auf Entwickler
- Neue Option für die Agent-Ausführungsebene: Bei Multi-Tool-Aufrufen und Automatisierungsaufgaben liegen die offiziellen Ergebnisse von Hydrogen deutlich über denen von 3.8 Flash – das Modell eignet sich damit gut als Ausführender und Prüfer in Agent-Systemen.
- Migration erfordert Konfigurationsanpassungen: Reasoning-Parameter, Caching-Mechanismus, Sampling-Parameter und die Signaturen der Tool-Aufrufe haben sich geändert. Ein bloßes Austauschen des Modellnamens kann zu Fehlern führen.
- Kostenschätzung muss neu gedacht werden: Der Stückpreis verdoppelt sich, gleichzeitig kann die Effizienz bei der Aufgabenbewältigung steigen. Entscheidend ist die Gesamtrechnung pro vollständiger Aufgabe, nicht pro einzelner Anfrage.
Auswirkungen auf die Branche und Endnutzer
- Suchfunktion wird besser: Hydrogen kommt bereits in der Google-Suche zum Einsatz und verbessert dort den Umgang mit komplexen Fragen mit mehreren Bedingungen, Tippfehlern, mehrgleisigen Suchanfragen und visuellen Antworten.
- „Planung durch das große Modell, Ausführung durch das kleine Modell“ wird zur gängigen Praxis: Der Orchestrator hat die Arbeitsteilung zwischen Modellen zu einer Produktfunktion gemacht – die Hürde für die Orchestrierung mehrerer Modelle sinkt.
- Grenzen bleiben bestehen: Laut offizieller Model Card ist der Anteil unbegründeter Ablehnungen bei Hydrogen um 5,57 Prozentpunkte schlechter als bei 3.8 Flash; ein vollständiger Sicherheitsbericht steht noch aus. Auf Hacker News berichten zudem Nutzer, dass das Modell bei manchen Agent-Aufgaben über das Ziel hinausgeht.
Häufig gestellte Fragen (FAQ) zu Gemini 4 Hydrogen
F1: Was ist Gemini 4 Hydrogen?
Es ist ein Modell aus der Gemini-4-Reihe, das Google DeepMind am 12. November 2026 offiziell veröffentlicht hat. Die API-Modell-ID lautet `gemini-4-hydrogen`. Es ist als hocheffizientes Modell für den täglichen Programmiereinsatz und die Ausführung von KI-Agenten positioniert und unterstützt ein einheitliches Kontextfenster von einer Million Token sowie vier Denkstufen.
F2: Worin unterscheidet sich Gemini 4 Hydrogen von Gemini 3.8 Flash?
Den offiziellen Angaben zufolge erreicht Hydrogen beim Terminal-Bench 4.1 einen Wert von 57,0 %, während 3.8 Flash bei 18,2 % liegt. Unter gleichen Bedingungen erledigt es Aufgaben etwa 2,5-mal schneller. Allerdings kostet die Standard-API doppelt so viel wie der aktuelle Preis von 3.8 Flash, und bei der Migration muss man sich zusätzlich mit inkompatiblen Parametern auseinandersetzen.
F3: Können Nutzer der kostenlosen Version Gemini 4 Hydrogen verwenden?
Ja. Wenn im kostenlosen Gemini-App-Konto die Option Auto aktiviert ist, können Anfragen, die Reasoning erfordern, an Hydrogen weitergegeben werden. In der kostenlosen Ebene von Google AI Studio lässt sich das Modell direkt auswählen, es unterliegt jedoch den Limits für RPM, TPM und RPD.
F4: Für welche Szenarien eignet sich Gemini 4 Hydrogen am besten?
– **Bugfixes und Dependency-Upgrades im Code-Repository**: Es legt Wert auf präzise Änderungen und vermeidet möglichst Eingriffe in nicht betroffenen Code.
– **Zusammenführung verschiedener Formate**: PDF, Excel, PPT, Diagramme und Webseiten lassen sich gleichzeitig analysieren.
– **Agent-Ausführung mit mehreren Tools**: Es kann eigenständig laufen oder konkrete Schritte unter der Planung von Carbon/Argon ausführen.
F5: Wie ruft man Gemini 4 Hydrogen schnell über die API auf?
Neben der offiziellen Gemini API von Google kann man auch OpenAI-kompatible Aggregationsplattformen nutzen:
1. Bei APIYI apiyi.com ein Konto registrieren und einen API-Schlüssel sowie ein kostenloses Testkontingent erhalten.
2. In der Modellliste prüfen, ob Hydrogen verfügbar ist und wie der Modellname lautet.
3. Die `base_url` im Code dieses Artikels auf `https://api.apiyi.com/v1` setzen und dann zur Überprüfung ausführen.
F6: Welche bekannten Einschränkungen hat Gemini 4 Hydrogen?
Es kann weiterhin Halluzinationen erzeugen, sein Wissen endet im März 2026, aktuelle Ereignisse müssen über eine Suche abgerufen werden. Höhere Denkstufen erhöhen Aufwand und Kosten deutlich und führen gelegentlich zu Timeouts. Live API, explizites Caching und Fine-Tuning werden nicht unterstützt. Wer andere Modelle als Alternative vergleichen möchte, kann bei APIYI apiyi.com mit demselben Code das Modell wechseln und testen.
Gemini 4 Hydrogen – Die wichtigsten Erkenntnisse
- Offizielle Veröffentlichung: Am 12. November 2026 verfügbar; bestätigt durch den offiziellen Blog, die Model Card und die technische Dokumentation.
- Kernpositionierung: Das effiziente Ausführungsmodell der Gemini-4-Familie für alltägliche Programmier- und Agent-Aufgaben.
- Kontextfenster-Regel: 1.048.576 Tokens werden von Eingabe, Denken, Tool-Aufrufen und Ausgabe gemeinsam genutzt.
- Vier Denkstufen: High ist die Standardstufe mit dem ausgewogensten Preis-Leistungs-Verhältnis; bei XHigh steigen die Kosten deutlich.
- Kostenlose Einstiege: Auto-Modus in der Gemini App, kostenlose Stufe von AI Studio, kostenlose Stufe der Gemini API.
- Kostenhinweis: Der Standardpreis ist doppelt so hoch wie der aktuelle Preis von 3.8 Flash; die Gesamtkosten sollten pro vollständiger Aufgabe berechnet werden.
- Einstieg: Für die Entwicklungsintegration lassen sich über die einheitliche Schnittstelle von APIYI apiyi.com schnell Vergleiche und Validierungen durchführen.
Fazit: Wer sollte Gemini 4 Hydrogen zuerst testen?
Verschiedene Nutzergruppen können an unterschiedlichen Einstiegspunkten beginnen:
- Normale Nutzer: In der Gemini App den Auto-Modus öffnen und über More → Show thinking steps prüfen, welches Modell tatsächlich aufgerufen wird.
- Content-Ersteller: In der kostenlosen AI-Studio-Stufe die Aufbereitung langer Dokumente, formatierte Umformulierungen und die Zusammenführung von Materialien in verschiedenen Formaten testen.
- Entwickler: Der Fokus liegt auf Codeänderungen und Debugging; vor einer Migration zuerst die Thinking-Parameter und die Caching-Konfiguration prüfen.
- Agent-Entwickler: Hydrogen als Ausführungsschicht einsetzen, komplexe Entscheidungen an Carbon oder Argon übergeben und die Gesamtkosten anhand realer Aufgaben vergleichen.
Der Einstieg lässt sich so wählen: Wenn Sie nur ausprobieren möchten, nutzen Sie die Gemini App oder Google AI Studio; für die Entwicklungsintegration wählen Sie die API. Wenn Sie mit einem einzigen API-Schlüssel gleichzeitig Gemini, Claude, OpenAI und weitere Modelle im eigenen Anwendungsszenario vergleichen möchten, können Sie das über APIYI apiyi.com schnell prüfen; neue Nutzer erhalten ein kostenloses Testkontingent.
📚 Referenzen
- Offizieller Google-Blog: Introducing Gemini 4 Hydrogen – Ankündigung und Partnerbeispiele
- Link:
blog.google/innovation-and-ai/models-and-research/gemini-models/introducing-gemini-4-hydrogen/ -
Beschreibung: offizielle Positionierung, Leistungsvergleich und Demo-Beispiele
-
Offizieller chinesischer Google-Blog: chinesische Veröffentlichungsankündigung
-
Link:
china.googleblog.com/2026/11/gemini-4-hydrogen.html -
Google DeepMind Modellkarte und Evaluierungsmethodik: modellübergreifende Evaluierung und Sicherheitsdaten
- Link:
deepmind.google/models/model-cards/gemini-4-hydrogen/ -
Link:
deepmind.google/models/evals-methodology/gemini-4-hydrogen/ -
Google Cloud technische Dokumentation: Spezifikationsparameter und Migrationsleitfaden
- Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/gemini/4-hydrogen -
Link:
docs.cloud.google.com/gemini-enterprise-agent-platform/models/guides/gemini-4-hydrogen -
Google AI Studio Preis- und Ratenlimit-Seite: API-Preise und Regeln für die kostenlose Stufe
- Link:
aistudio.google.com/docs/pricing -
Link:
ai.google.dev/gemini-api/docs/rate-limits -
Gemini Apps Hilfe-Center: Abonnementstufen, Auto-Modus und Anzeige des Modells
-
Link:
support.google.com/gemini/answer/18648722 -
Unabhängige Evaluation von Artificial Analysis: Thinking-Intelligenzindex in vier Stufen
-
Link:
artificialanalysis.ai/models/gemini-4-hydrogen -
Google Antigravity Blog: Orchestrator für Multi-Modell-Orchestrierung
-
Link:
antigravity.google/blog/gemini-4-hydrogen-in-google-antigravity -
Berichterstattung Dritter: TechCrunch, Ars Technica, 9to5Google, The Verge
- Link:
arstechnica.com/google/2026/11/google-rolls-out-gemini-4-hydrogen-finally-replacing-3-8-flash/ - Link:
9to5google.com/2026/11/12/gemini-4-hydrogen-launch/
Autor: APIYI-Team
Technischer Austausch: Sie erreichen uns gerne über die Startseite der offiziellen APIYI-Website; weitere Integrationsmaterialien finden Sie im Dokumentationszentrum unter docs.apiyi.com