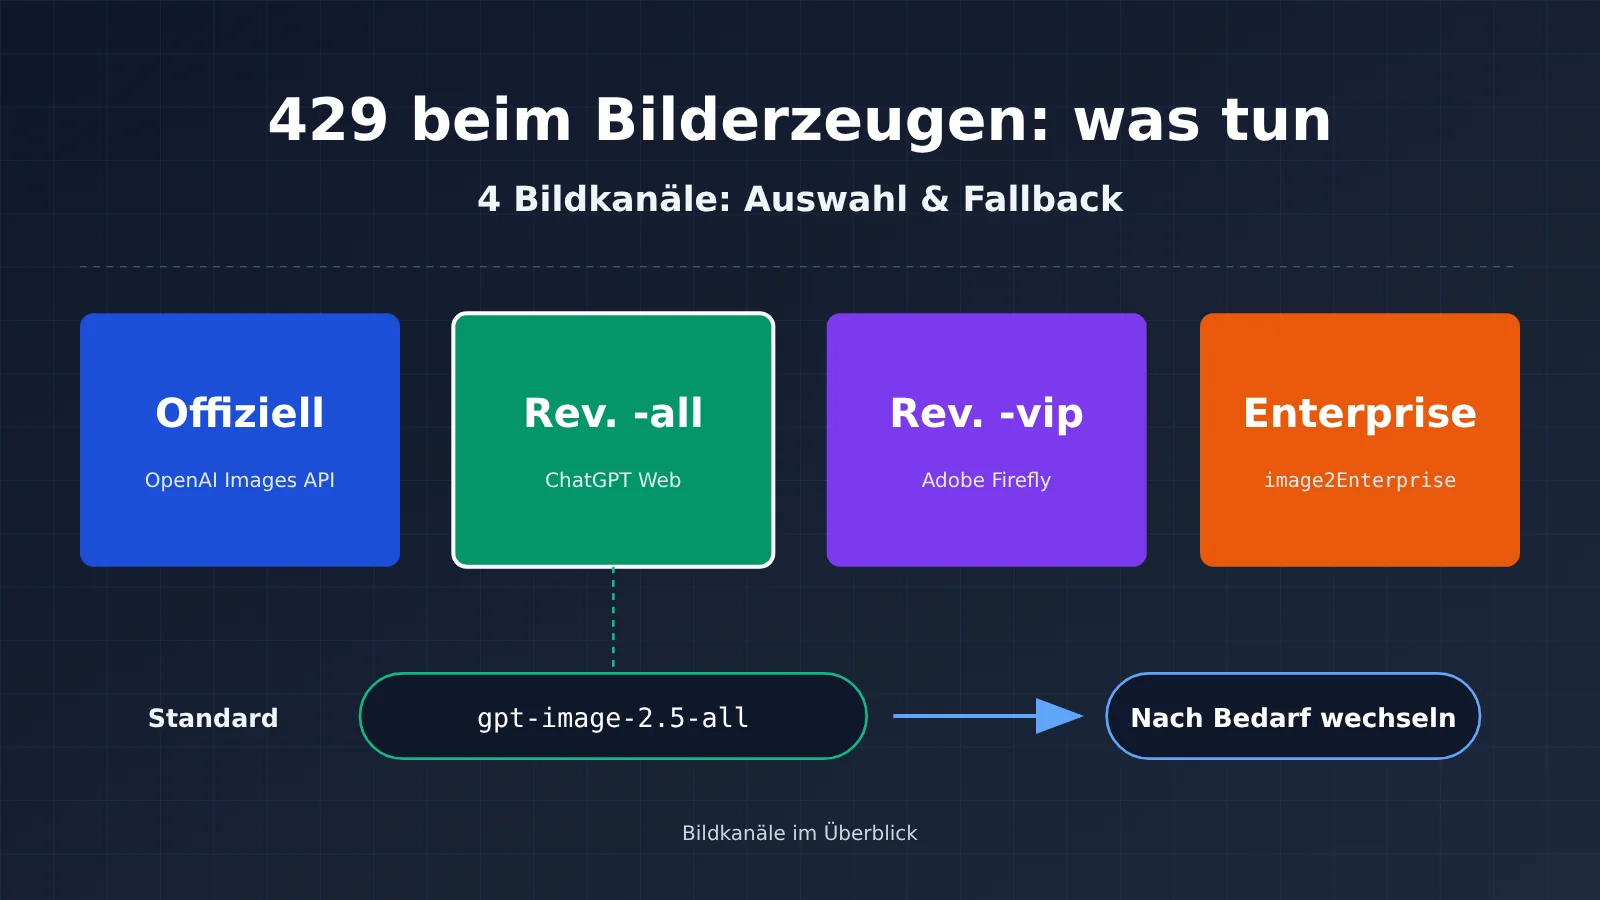
Zuerst das Fazit. Für die Batch-Bilderzeugung auf APIYI gilt: Für Routineaufgaben standardmäßig gpt-image-2.5-all in der Default-Gruppe verwenden – aufrufbar sowohl mit Token pro Aufruf als auch mit Token nach Verbrauch, Listenpreis 0.025 USD pro Bild. Wenn eine feste Größe oder 4K gefragt ist, wechseln Sie den Modellnamen auf ein -vip-Modell wie gpt-image-2.5-vip, Listenpreis 0.03 USD pro Bild. Allerdings steht auf der -all-Seite selbst, dass 4K bei -vip Stabilitätsschwankungen zeigt und deshalb nicht die erste Wahl für 4K ist. Wenn Sie die offizielle quality-Stufe, partielles Inpainting mit Maske oder beliebige zulässige Größen brauchen, nehmen Sie den offiziellen Weiterleitungskanal; bei neuen Projekten lohnt zuerst ein Blick auf gpt-image-2.6-flare (Geschwindigkeit zuerst) und gpt-image-2.6-sunburst (Bearbeitung und Präzision zuerst).
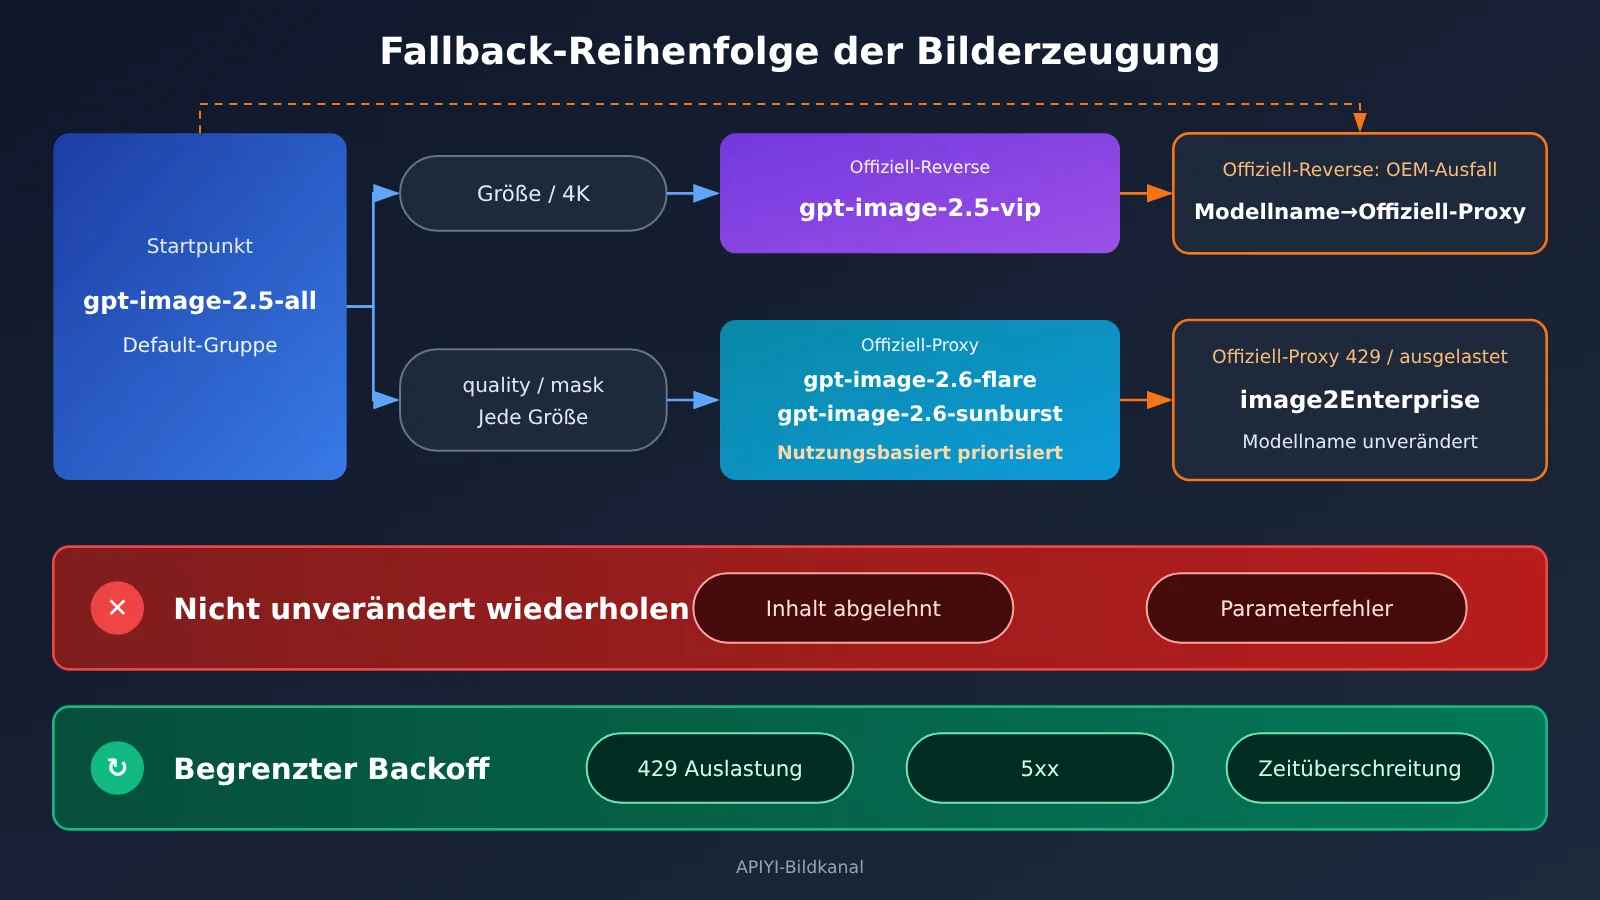
Beim Fallback gibt es zwei Szenarien. Wenn der Weiterleitungskanal in der Default-Gruppe dauerhaft 429 meldet oder gesättigt ist, wechseln Sie die Token-Gruppe auf image2Enterprise – der Modellname bleibt unverändert. Wenn beim Reverse-Kanal die ChatGPT-Webversion oder der Adobe-Originalservice ausfällt, sollten Sie auf derselben Reverse-Route nicht wiederholt Backoff betreiben, sondern den Modellnamen auf ein Weiterleitungs-Modell ändern und prüfen, dass das Token auf „Abrechnung nach Verbrauch priorisiert“ steht. Außerdem gibt es zwei Fehlerarten, die man nicht unverändert wiederholen darf: Ablehnung durch die Inhaltssicherheit und Parameterfehler. Beachten Sie zudem den Parameter n: Bei -all wird er mit dem n-fachen Preis abgerechnet, liefert aber trotzdem nur 1 Bild.
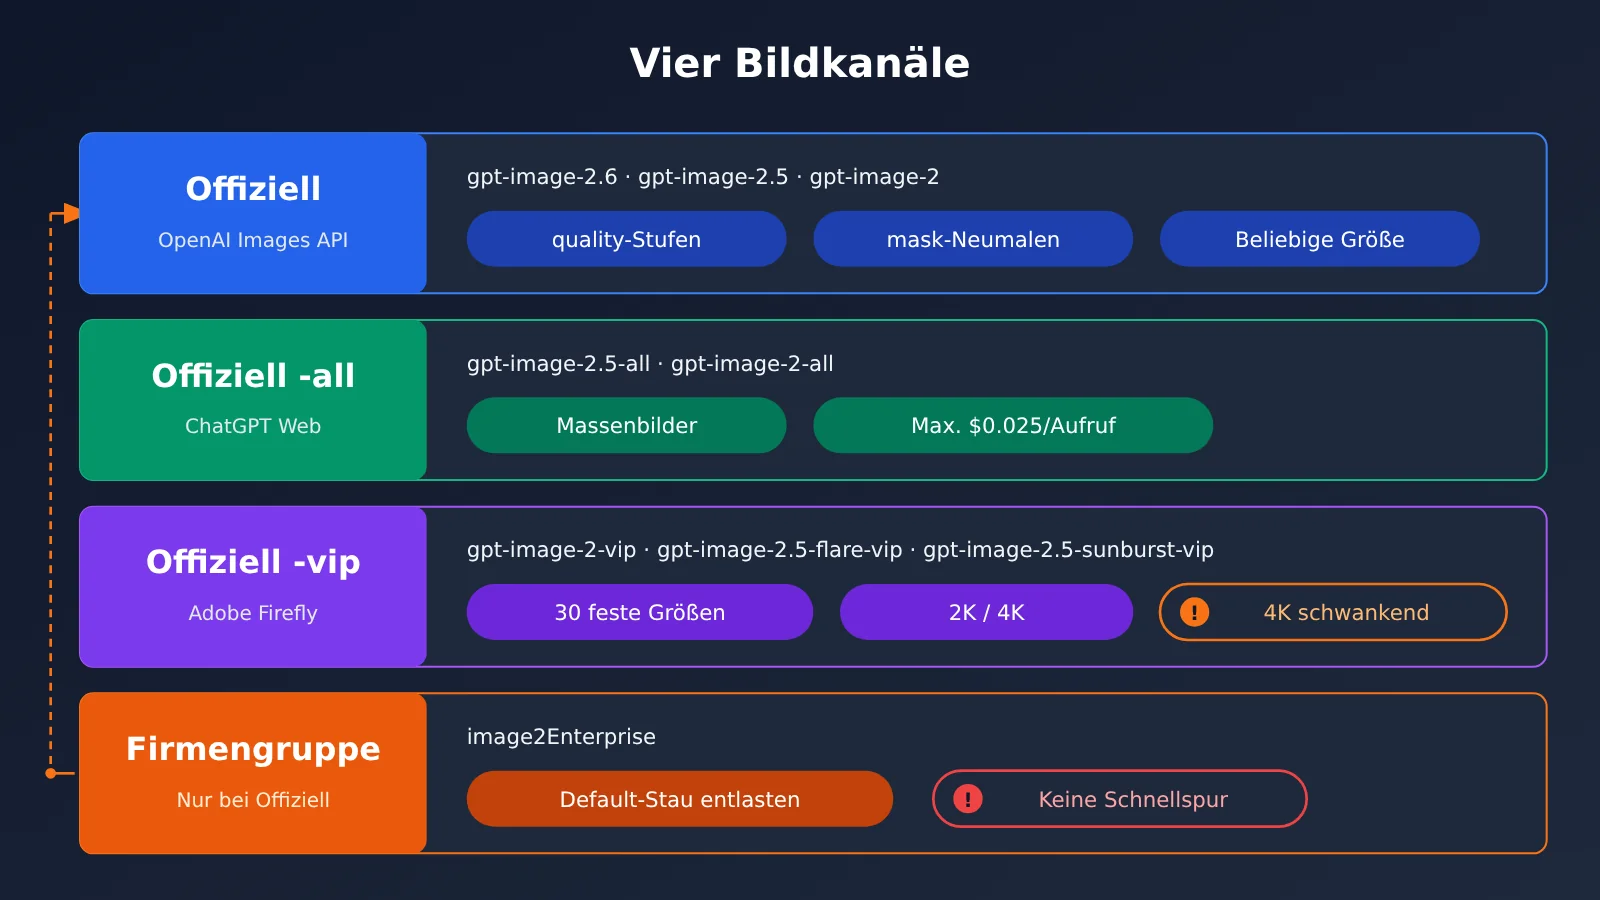
Wie heißen die vier GPT-Bildkanäle?
Dasselbe GPT-Bildmodell erscheint in der Liste mit mehreren Suffixen. Sie stehen für die jeweilige Upstream-Quelle und die Abrechnungsart. Die „Enterprise-Gruppe“ (企业分组) ist dabei kein Modell, sondern eine Routing-Option am Token. Im Folgenden erklären wir die Begriffe so, wie sie in der Dokumentation verwendet werden:
- 官转 (offizieller Relay-Kanal): direkte Verbindung zur offiziellen OpenAI Images API. Laut Dokumentation entsprechen Anfragen und Antworten dem offiziellen OpenAI-Format. In der Preisübersicht sind die offiziellen Relay-Bildmodelle
gpt-image-2.6-flare,gpt-image-2.6-sunburst,gpt-image-2.5-flare,gpt-image-2.5-sunburst, die Datums-Snapshots der beidengpt-image-2.5-flare-2026-09-08undgpt-image-2.5-sunburst-2026-09-08sowie das Vorgängermodellgpt-image-2aufgeführt. Die Dokumentation empfiehlt für Text-zu-Bild vorrangig die flare-Variante und für Bearbeitung sowie die Fusion mehrerer Bilder vorrangig die sunburst-Variante. In Produktionsumgebungen können Sie Datums-Snapshots festlegen, damit sich das Ziel eines Alias nicht ändert. - 官逆 -all (Reverse-Kanal zur ChatGPT-Webversion): Reverse-Engineering der ChatGPT-Webversion.
gpt-image-2-allundgpt-image-2.5-allkosten gleich viel, verhalten sich identisch und sind austauschbar. Der Grund: Die ChatGPT-Webversion wurde vollständig auf Images 2.5 umgestellt, daher liefert auchgpt-image-2-allBilder der Version 2.5. Für neue Projekte empfiehlt die Dokumentation direktgpt-image-2.5-all. - 官逆 -vip (Adobe-Reverse-Kanal, Firefly): Die Modelle sind
gpt-image-2-vip,gpt-image-2.5-flare-vipundgpt-image-2.5-sunburst-vip. Der Aliasgpt-image-2.5-vipverweist aufgpt-image-2.5-sunburst-vip. - Enterprise-Gruppe
image2Enterprise(企业分组): die Enterprise-Fallback-Gruppe des offiziellen Relays auf der OpenAI-Upstream-Seite. Die FAQ stellt ausdrücklich klar, dass es sich weder um Google Vertex noch um eine Beschleunigungslinie zur Verkürzung der Bilderzeugungszeit handelt. Sie stellt einen zusätzlichen Ressourcenpool bereit, wenn die Standardgruppe überlastet ist, garantiert aber nicht, dass der Upstream immer verfügbar ist.
Eine weitere Gruppe, die leicht für einen Fallback gehalten wird, ist image2_OSS. Sie ist eine Gruppe mit Faktor 1 und ohne Preisaufschlag und hat nur einen Zweck: sicherzustellen, dass eine URL zurückgegeben wird und die Ausgabe nicht auf base64 heruntergestuft wird. Sie erhöht nicht die Stabilität und gilt für -all und -vip.
2.6 ist derzeit nur als offizielle Relay-Variante (官转) verfügbar. In der Preisübersicht und in der Preis-API vom 2026-11-10 gibt es weder gpt-image-2.6-all noch gpt-image-2.6-vip oder ähnliche Namen. Modelle und Preise richten sich nach der Modellliste der Plattform.
Standard-Bildkanal nach Szenario wählen: Preis- und Funktionsvergleichstabelle
Bei der Kanalwahl sind zuerst drei Fragen entscheidend: Wird eine offizielle Qualitätsstufe benötigt, wie streng sind die Größenanforderungen und sollen die Kosten pro Bild gedeckelt sein? Die Entscheidung kann in dieser Reihenfolge getroffen werden:
- Batch-Bilderzeugung, Kosten pro Bild gedeckelt, lange Kante der Größe zwischen 512 und 1536:
gpt-image-2.5-allverwenden. Akzeptanzkriterium: Die tatsächliche Breite und Höhe des zurückgegebenen Bildes entsprechen den Erwartungen, und die Abrechnung in der Konsole entspricht pro Vorgang dem Einzelpreis multipliziert mit der Anzahl der Aufrufe. - Eine feste Größe aus den 30 Stufen wird benötigt oder 2K bzw. 4K: Stattdessen ein -vip-Modell verwenden und
sizeexplizit übergeben. Akzeptanzkriterium: Maßgeblich sind die tatsächliche Breite und Höhe des zurückgegebenen Bildes, nicht nur die Anfrageparameter. - Offizielles
quality, lokale Neuzeichnung mitmask, transparenter Hintergrund, beliebige gültige Größen oder Ausrichtung an den OpenAI-Feldern erforderlich: Den offiziellen Relay-Weg verwenden. Für neue Projekte 2.6 einsetzen; wenn das Verhalten fixiert werden soll, einen datierten 2.5-Snapshot verwenden. Akzeptanzkriterium: Die Anfragefelder stimmen mit der offiziellen Parametertabelle des Zielmodells überein, und es tritt kein 400-Fehler auf.
Preistabelle für Bildkanäle
Die Abrechnungsart und die Listenpreise in der folgenden Tabelle stammen aus der Preisübersicht (aktualisiert am 2026-11-09) und sind durchgängig Preise vor Rabatt. Nach einer Aufladung mit 10 % bis 20 % Bonus fällt die tatsächliche Abrechnung niedriger aus; maßgeblich ist der Wert im Konsolen-Dashboard. Die vollständigen Modellbezeichnungen und Preise finden Sie unter docs.apiyi.com/models.
| Modell | Kanalart | Abrechnung | Listenpreis (vor Rabatt) | Verfügbare Gruppen |
|---|---|---|---|---|
gpt-image-2.6-flare / gpt-image-2.6-sunburst |
Offizieller Proxy (seit 2026-11-05 online) | Nutzungsbasiert | Pro Million Tokens: Texteingabe 5, Bildeingabe 8, Ausgabe 30 US-Dollar | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-flare / gpt-image-2.5-sunburst sowie Snapshot vom 2026-09-08 |
Offizieller Proxy | Nutzungsbasiert | Wie oben; Cache-Lesen: Text 1,25, Bild 2 US-Dollar | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2 |
Offizieller Proxy (vorherige Generation) | Nutzungsbasiert | Wie oben | Default, image2Enterprise, image2_OSS, SVIP |
gpt-image-2.5-all / gpt-image-2-all |
Offizieller Reverse-Kanal (ChatGPT-Webversion) | Pro Aufruf | 0,025 US-Dollar pro Aufruf | Default, image2_OSS, SVIP |
gpt-image-2.5-vip und drei weitere -vip-Namen |
Offizieller Reverse-Kanal (Adobe Firefly) | Pro Aufruf | 0,03 US-Dollar pro Aufruf | Default, image2_OSS, SVIP |
Zwischen der Preis-API und der Preisübersicht gibt es eine Abweichung, die getrennt betrachtet werden muss. In der Preis-API haben gpt-image-2, gpt-image-2.5-flare und gpt-image-2.5-sunburst bei quota_type den Wert 1 und bei model_price den Wert 0.2. Bei gpt-image-2.6-flare, gpt-image-2.6-sunburst und den beiden Snapshots vom 2026-09-08 sind quota_type 0 und model_price 0. Die Preisübersicht führt diese offiziellen Proxy-Modelle jedoch alle als nutzungsbasiert. In diesem Artikel richten sich die Listenpreise nach der nutzungsbasierten Angabe in der Preisübersicht; 0.2 wird nicht als Preis pro Aufruf behandelt. Prüfen Sie vor der Buchung im Konsolen-Dashboard den tatsächlichen rabattierten Preis für die jeweilige Gruppe. Die 0,025 für -all und die 0,03 für -vip stimmen in beiden Quellen überein und können als Preis pro Aufruf verwendet werden.
Bei offiziellen Proxy-Modellen hängen die Kosten pro Bild von den Ausgabe-Tokens ab. Die Vergleichsseite (laut Dokumentation selbst) nennt einen typischen Bereich von etwa 0,03 bis 0,2 US-Dollar pro Bild. Je länger die Eingabeaufforderung und je höher size und quality, desto höher die Kosten. Die Dokumentation enthält eine grobe Beispielrechnung vom 2026-09-09: Ein quadratisches 1024×1024-Bild kostet mit Version 2.5 und xhigh etwa 0,094 US-Dollar (3122 Ausgabe-Tokens), mit max etwa 0,211 US-Dollar (7024 Ausgabe-Tokens); die Eingabekosten, die normalerweise unter 0,001 US-Dollar liegen, sind nicht enthalten. Die Dokumentation kommt zu dem Schluss: Für 1K-Low-Skizzen ist der offizielle Proxy nicht unbedingt teurer; bei mittlerer bis hoher Bildqualität ist der offizielle Reverse-Kanal mit 0,025 bis 0,03 US-Dollar die günstigere Option.
Es gibt noch einen alten Preis, an den ich erinnern möchte. Ein älterer Artikel im Hilfe-Center vom 2026-04-25 nennt für gpt-image-2-all 0,03 USD pro Aufruf – das sind die Daten von vor der Preissenkung. -all wurde am 2026-10-10 auf 0,025 USD gesenkt, beide -all-Namen wurden dabei synchron angepasst. Als Grund für die Preissenkung nennt die Dokumentation: -all ist stabiler als -vip, -vip schwankt wegen der Risikokontrolle des Originalherstellers stärker, wird aber weiterhin gepflegt und bleibt wie gewohnt nutzbar.
Fähigkeitsvergleich der Bildkanäle
| Fähigkeit | Offiziell-Reverse -all | Offiziell-Reverse -vip | Offiziell-Weiterleitung |
|---|---|---|---|
size |
Sonderseite: gängige Breiten/Höhen mit langer Kante 512 bis 1536, auch Nicht-16-Vielfache; 2K wird nicht als exakt unterstützt gelistet | 30 Stufen (10 Seitenverhältnisse × 1K/2K/4K), nur am images-Endpunkt wirksam | Beliebige gültige Größe, Kantenlänge als Vielfaches von 16, Seitenverhältnis höchstens 3:1, Presets inkl. 3840×2160 |
quality |
Wird nicht akzeptiert | Kanalverhalten, keine Zusage; die beiden 2.5-Modelle wurden am 2026-09-10 erneut bis max getestet, gpt-image-2-vip nur bis high |
Offiziell zugesagte Stufen; xhigh/max nur bei den beiden 2.5-Modellen (Vergleichsseite) |
n |
Wird nicht akzeptiert, aber trotzdem mit n-fachem Betrag abgerechnet | Nicht unterstützt, 1 Bild pro Aufruf | Unterstützt |
| Maske | Nur vollständige Neubearbeitung des ganzen Bildes | Nur vollständige Neubearbeitung des ganzen Bildes | Unterstützt mask für lokale Neubearbeitung |
| Transparenter Hintergrund | Kein background, lässt sich nur in die Eingabeaufforderung schreiben |
Kann alpha-PNG liefern, die Dokumentation sagt dazu nichts zu | 2.5 unterstützt es; gpt-image-2 ist abgeschaltet |
| Geschwindigkeit (laut Dokumentation) | Sonderseite ca. 30 bis 60 Sekunden; Vergleichsseite ca. 90 Sekunden | gpt-image-2-vip 90 bis 150 Sekunden; flare-vip 22 bis 138 Sekunden, sunburst-vip 37 bis 120 Sekunden |
Stand 2026-09-09: 2.5-flare 1K low ca. 10 Sekunden, sunburst ca. 14 Sekunden; gpt-image-2 100 bis 120 Sekunden |
Bei der Geschwindigkeit von -all weichen die beiden Dokumente voneinander ab: Die Sonderseite nennt etwa 30 bis 60 Sekunden, die Vergleichsseite etwa 90 Sekunden. Dieser Artikel führt beide Zahlen auf und bildet keinen Mittelwert. Auch bei size von -all sind die Dokumente nicht synchron: Die Sonderseite schreibt „size wird jetzt unterstützt“, die Vergleichsseite schreibt weiterhin, dass es nicht akzeptiert wird. Dieser Artikel folgt der Sonderseite. Die Sonderseite erwähnt außerdem, dass 1536er-Quadratbilder möglicherweise interpoliert werden und keine nativen Details darstellen. Die Angabe zu 2.6 – „50 % schnellere Generierung, Flare in niedrigster Qualität in 6 Sekunden“ – stammt aus einer offiziellen Ankündigung, die in den Live-Updates vom 2026-11-05 wiedergegeben wurde, und nicht aus Nachtestdaten der Plattform. Die neuen Parameter von 2.6 (complexity, SVG, GIF usw.) richten sich nach der offiziellen OpenAI-Dokumentation und lassen sich nicht direkt auf die Parametertabelle von 2.5 übertragen.
Wenn 4K häufig gebraucht wird, erwähnt die -all-Sonderseite noch einen anderen Weg: Nano Banana bei APIYI. In der Preisübersicht kosten nano-banana-pro und die gemini-3-pro-image-Reihe 0,09 USD pro Aufruf, nano-banana-2 und gemini-3.1-flash-image 0,055 USD pro Aufruf. Die Unternehmensgruppen dieses Wegs sind NanoBananaEnterprise und NanoBananaReverse und dürfen nicht mit image2Enterprise gemischt werden.
Token-Typen und Gruppenprioritäten im Bildkanal richtig konfigurieren
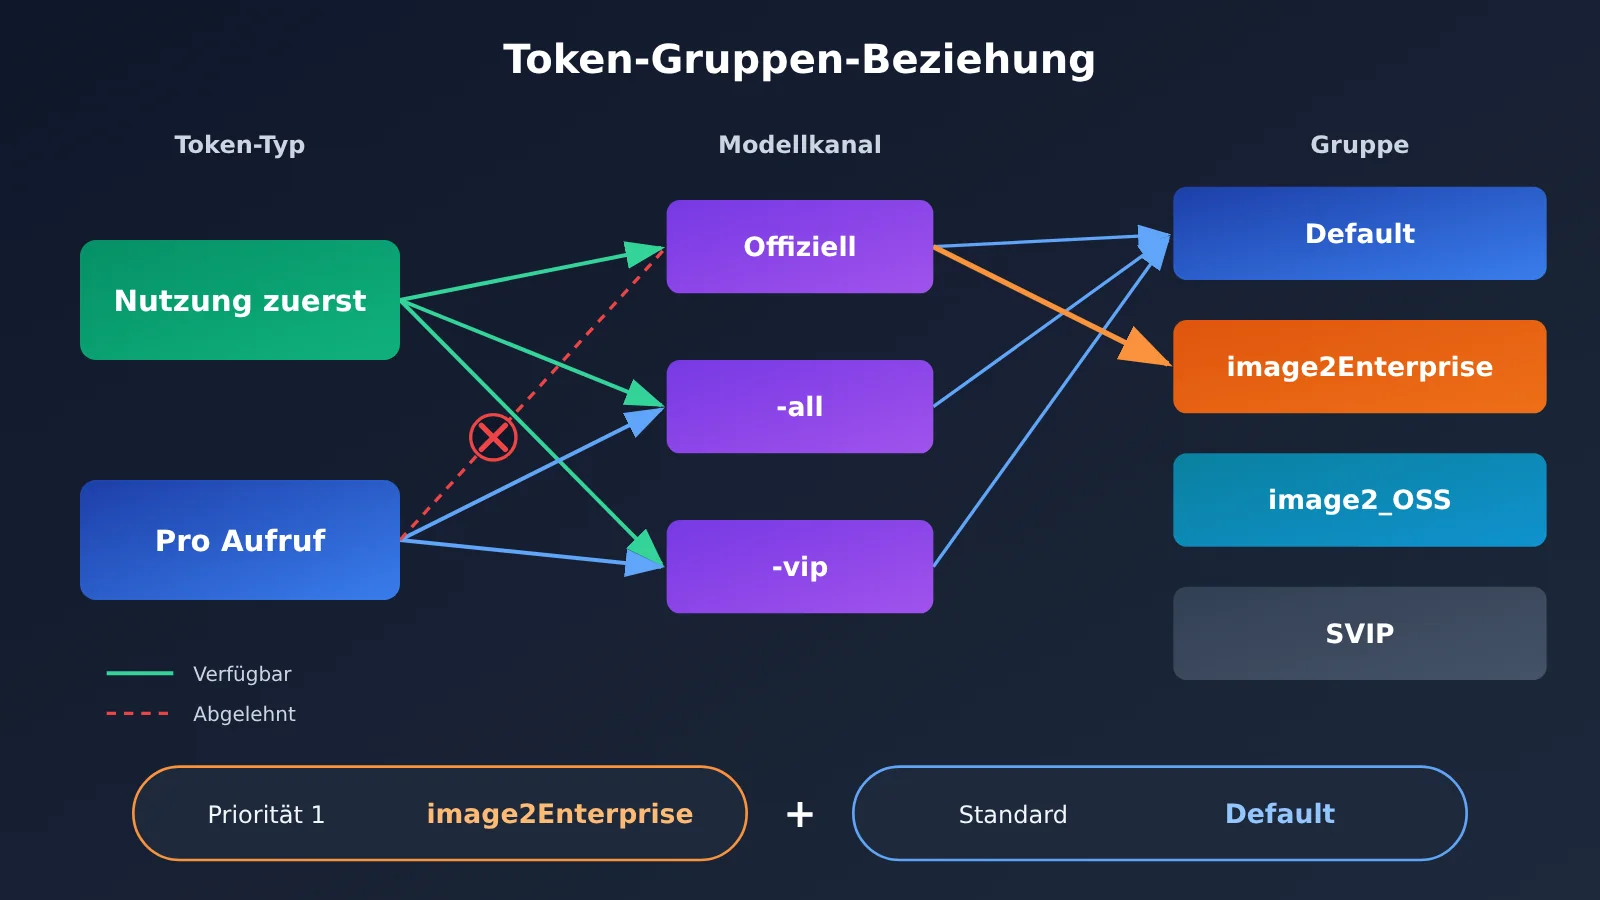
Viele Fehlermeldungen kommen gar nicht vom Kanal selbst, sondern von einem falsch konfigurierten Token-Typ oder einer falschen Gruppe. Alle Kanäle laufen über dieselbe Base URL: https://api.apiyi.com/v1. Als Endpunkte empfehlen sich /v1/images/generations und /v1/images/edits. Bei den Token-Typen gibt es genau eine Regel, die man sich merken muss: Für die Offiziell-Weiterleitung (官转) ist zwingend „Nach Verbrauch“ (按量优先) nötig. Wer mit einem Token für Abrechnung pro Aufruf die Offiziell-Weiterleitung anspricht, wird wegen der nicht passenden Abrechnungsart abgelehnt. Bei -all und -vip funktionieren sowohl „Pro Aufruf“ (按次计费) als auch „Nach Verbrauch“ (按量优先).
| Gruppe | Multiplikator (Preis-API, Stand 2026-11-10) | Geeignete Kanäle | Zweck | Hinweis |
|---|---|---|---|---|
Default |
1 | Offiziell-Weiterleitung, -all, -vip | Standard, erste Wahl | Bei der Offiziell-Weiterleitung kann es in Spitzenzeiten eng werden – dann 429 |
image2Enterprise |
1.2 | nur Offiziell-Weiterleitung | Enterprise-Fallback beim OpenAI-Upstream | Keine Beschleunigungsspur, kein Vertex; -all und -vip liegen nicht in dieser Gruppe |
image2_OSS |
1 | Offiziell-Weiterleitung, -all, -vip | Garantierte URL-Ausgabe | Erhöht die Stabilität nicht; die URL verfällt nach etwa 24 Stunden |
SVIP |
Die API meldet 1, maßgeblich ist die Token-Seite in der Konsole | Offiziell-Weiterleitung, -all, -vip | Gemäß Konsolenbeschreibung | Seit 2026-10-29 ist die zeitlich begrenzte Multiplikator-Aktion beendet |
Der Faktor 1,2 der Enterprise-Gruppe wird in der Doku so erklärt: Er ist so angesetzt, dass nach dem Bonus von 20 % für Großkunden mit einer Einzelaufladung von 3000 US-Dollar ungefähr der offizielle Listenpreis herauskommt; Steuerkosten rechnet die Plattform nicht ein. Welche Modelle in dieser Gruppe sichtbar sind, listet die Tabelle im FAQ-Haupttext mit gpt-image-2.5-flare, gpt-image-2.5-sunburst und gpt-image-2. Die Preisübersicht und das Feld enable_groups der Preis-API zeigen dagegen, dass auch die beiden 2.6-Varianten dazugehören – die FAQ-Tabelle ist noch nicht nachgezogen. Ob man diese Gruppe separat beantragen muss, sagt die Doku nicht; falls Sie sie nicht auswählen können, gilt das, was die Konsole anzeigt.
Die empfohlene Konfiguration lautet „ein Token für beide Modelltypen“. Ein Token kann eine Standardgruppe und bis zu zwei Fallback-Gruppen haben. Nach der Doku setzt man die erste Priorität auf image2Enterprise und die Standardgruppe auf Default. Damit laufen Anfragen an die Offiziell-Weiterleitung bevorzugt über die Enterprise-Gruppe, während -all und -vip, die nicht in der Enterprise-Gruppe sind, in Default bleiben und ganz normal Bilder erzeugen. Vorgehen: api.apiyi.com/token öffnen, Token bearbeiten, Gruppe auswählen und speichern – am Code muss nichts geändert werden. Abnahmekriterium: Mit derselben Anfrage einmal ein Modell der Offiziell-Weiterleitung und einmal ein -all-Modell aufrufen; beide liefern ein Bild, und in der Konsole wird der Aufruf über die Offiziell-Weiterleitung mit Faktor 1,2 abgerechnet.
Anwendungen, die zwingend auf eine URL angewiesen sind, brauchen eine Sonderbehandlung. In der Standardgruppe ist dokumentiert, dass 2026-07 ohne response_format ein b64_json zurückkam; gibt man response_format explizit als url an, bekommt man einen Link – die Standardgruppe garantiert das Ausgabeformat aber nicht. Solche Anwendungen sollten das Token auf image2_OSS umstellen und zusätzlich url explizit übergeben, um den Link direkt herunterzuladen und woanders abzulegen. Abnahmekriterium: In der Antwort steht das Feld url, und die abgelegte Datei lässt sich öffnen.
Wie Sie bei der Bilderzeugung mit 429, Sättigung und Herstellerausfällen jeweils auffangen
Fehler sind nicht gleich Fehler: Die Ursachen dahinter können völlig unterschiedlich sein. Deshalb lesen Sie zuerst error.message im Fehlerobjekt und entscheiden dann, wie Sie vorgehen. Die -vip-Seite unterscheidet bei 429 zwei Fälle: abgelehnte Parameter und Sättigung der Gruppe. Die -all-Seite erklärt 429 pauschal als „Rate-Limiting oder unzureichendes Kontingent“. In den Live-Updates sind außerdem zwei Arten von Herstellerausfällen dokumentiert, eine von der ChatGPT-Webversion und eine von OpenAI-Upstream. Die folgende Tabelle fasst diese Fälle als „Welchen Fehler sehen Sie – was tun Sie zuerst?“ zusammen:
| Was Sie sehen | Einschätzung | Erste Maßnahme | Erfolgskriterium |
|---|---|---|---|
| Beim offiziellen Relay kommt auf Default weiterhin 429 oder eine Sättigungsmeldung | Standardgruppe überlastet | Wechseln Sie unter api.apiyi.com/token die Gruppe zu image2Enterprise oder erhöhen Sie deren Priorität; der Modellname bleibt unverändert |
Derselbe Request liefert ein Bild, die Abrechnung erfolgt mit dem 1,2-fachen Satz |
Die -vip-Seite gibt 429 zurück, message ist z. B. quality must be one of… |
Parameter abgelehnt | Parameter ändern, nicht unverändert wiederholen | Nach der Änderung ist der erste Request erfolgreich |
Die -vip-Seite gibt 429 zurück, message lautet „Die Upstream-Last der aktuellen Gruppe ist ausgelastet“ |
Gelegentliche Sättigung | Exponentielles Backoff mit Wiederholung, parallel die Live-Updates prüfen | Innerhalb einer begrenzten Anzahl von Versuchen wiederhergestellt, sonst zum offiziellen Relay wechseln |
| -all/-vip zeigen am selben Tag gehäuft Fehler, in den Live-Updates wird ein Herstellerausfall gemeldet | Herstellerausfall bei der ChatGPT-Webversion oder bei Adobe | Backoff stoppen und durch Ändern des Modellnamens zum offiziellen Relay wechseln | Request über den offiziellen Relay erfolgreich, Token auf „nutzungsbasiert priorisiert“ gestellt |
Die Enterprise-Gruppe des offiziellen Relay gibt The server had an error while processing your request. zurück |
OpenAI-Upstream-Ausfall | 1 bis 2 Mal wiederholen; wenn es weiterhin nicht geht, zum offiziellen Reverse-Kanal wechseln | Nach dem Wechsel zu -all lässt sich ein Bild erzeugen |
| 401 | Token-Problem | Token prüfen, nicht wiederholen | Mit korrektem Token funktioniert es wieder |
gpt-image-2 gibt 400 zurück, wenn background auf transparent steht |
Die Funktion wurde offiziell eingestellt | Für transparenten Hintergrund stattdessen 2.5 über den offiziellen Relay mit PNG oder WebP verwenden | Das zurückgegebene Bild hat einen Alpha-Kanal |
Wenn Sie einen Herstellerausfall vermuten, prüfen Sie zuerst unter docs.apiyi.com/live, ob es für den Tag eine entsprechende Meldung gibt, und entscheiden Sie dann, ob Sie mit Backoff arbeiten oder den Kanal wechseln. Der Wechsel vom offiziellen Reverse- zum offiziellen Relay-Kanal ist einfach: Bei APIYI reicht derselbe Token, Sie ändern nur den Modellnamen. Die Vergleichsseite sagt es wörtlich: „Man muss nur den model-Namen ändern, um zum offiziellen Relay zu wechseln.“ Es gibt jedoch zwei Voraussetzungen, die Sie Punkt für Punkt prüfen sollten:
- Token-Typ: Stellen Sie sicher, dass der Token auf „nutzungsbasiert priorisiert“ eingestellt ist. Bei einem aufrufbasierten Token wird die Anfrage abgelehnt.
- Felder je nach Zielmodell reduzieren: Beim Wechsel zu
gpt-image-2entfernen Sie die Qualitätsstufen xhigh und max sowie den transparenten Hintergrund; Größen, die von -all übernommen wurden und keine Vielfachen von 16 sind, müssen auf ein Vielfaches von 16 geändert werden, wobei das Seitenverhältnis 3:1 nicht überschreiten darf. Beim umgekehrten Wechsel vom offiziellen Relay zurück zu -all müssen Siequality,n,aspect_ratioundmaskentfernen. - Timeouts: Beim offiziellen Relay setzen Sie für niedrige und mittlere Bildqualität 240 Sekunden, für high und xhigh 300 Sekunden und für max sowie high bei
gpt-image-2600 Sekunden als Sicherheitsnetz. Bei -all und -vip konservativ 300 Sekunden. Komprimieren Sie Eingabebilder vorher auf unter 1,5 MB.
Historische Meldungen von April bis November 2026: Bewertungstabelle
Die folgenden Ereignisse dienen nur dazu, zu zeigen, welche Arten von Störungen es bereits gab und wie damals damit umgegangen wurde. Sie geben nicht den Stand vom 2026-11-10 wieder. Ob aktuell eine Sättigung vorliegt, richtet sich nach der jeweiligen Fehlerantwort und den Live-Meldungen.
| Datum | Ereignis (historische Meldung) | Damalige Reaktion | Heutige Einordnung |
|---|---|---|---|
| 2026-04-29 | Die Standardgruppe des offiziellen Proxys meldet weiterhin 429; nur image2Enterprise ist stabil, -all und -vip sind ebenfalls stabil | Offizieller Proxy nutzt die Enterprise-Gruppe | Typisches Beispiel für „Überlastung der Standardgruppe des offiziellen Proxys“ |
| 2026-05-07 | Auch die Enterprise-Gruppe des offiziellen Proxys gibt einen Serverfehler zurück; Ursache ist der OpenAI-Upstream | Auf Wiederherstellung des Upstreams warten oder Kanal wechseln | Auch die Enterprise-Gruppe garantiert nicht, dass der Upstream immer verfügbar ist |
| 2026-05-13 | Standardgruppe gesättigt, image2Enterprise kann weiterhin Bilder erzeugen | Zur Enterprise-Gruppe wechseln | Belegt die Konfiguration mit Prioritäten |
| 2026-05-23 | Der Standardgruppe wurden Ressourcen hinzugefügt; laut Dokumentation ist ein gezielter Wechsel zur Enterprise-Gruppe nicht nötig | Zurück zu Default | Überlastung tritt phasenweise auf |
| 2026-09-21 | Bei 2.5 ist die Parallelitätskapazität der Standardgruppe des offiziellen Proxys angespannt; die Enterprise-Gruppe ist stabil | Zur Enterprise-Gruppe wechseln | Wie oben |
| 2026-10-15 | gpt-image-2-vip ist überlastet; -all meldet einen Fehler wegen einer Störung beim Originalhersteller der ChatGPT-Webversion; gpt-image-2 mit transparentem Hintergrund wurde abgeschaltet (auf der Vergleichsseite als 2026-09-30 vermerkt) |
Offizieller Reverse-Proxy nutzt zunächst den offiziellen Proxy als Fallback; für transparenten Hintergrund auf 2.5 über den offiziellen Proxy umstellen | Bei einer Störung beim Originalhersteller sollte man den Kanal wechseln und nicht hartnäckig weiterprobieren |
| 2026-11-05 | 2.6 geht beim offiziellen Proxy live; die Default-Gruppe ist verfügbar | Kann für neue Projekte verwendet werden | Dies ist eine Go-live-Meldung, keine Störungsmeldung |
Fehler bei der Bilderzeugung: Was wiederholen, was nicht
Für die Entscheidung, ob ein Fehler wiederholt werden soll, gibt es nur ein Kriterium: Verschwindet die Fehlerursache mit der Zeit von selbst? Lastbedingte 429er, 5xx und Timeouts können sich von allein erholen; hier ist ein begrenztes Backoff sinnvoll. Parameterfehler, Tokenfehler und Inhaltsablehnungen verschwinden nicht von selbst. Ein unverändertes Wiederholen kostet nur Zeit und manchmal zusätzliches Geld. Die im Themenarchiv vom 2026-08-25 festgehaltene Betriebsrichtlinie lautet: „429 kann wiederholt werden, bei Inhaltssicherheit ist keine Wiederholung nötig“ – das passt zu diesem Kriterium.
- Mit Backoff wiederholen: Bei lastbedingten 429-Fehlern exponentielles Backoff verwenden; 5xx ein- bis zweimal wiederholen; bei Timeouts zuerst den Client-Timeout auf den empfohlenen Wert setzen. Notieren Sie die
request-idaus den Antwort-Headern, um die Fehlersuche zu erleichtern. In der -vip-Dokumentation steht, dass bei weniger als 500 RPM Parallelitätsprobleme zunächst keine Rolle spielen. - Ändern und dann erneut senden: Bei abgelehnten Parametern zuerst die Parameter ändern; bei 401 zuerst den Token prüfen; bei 400 zuerst die Feldtabelle des Zielmodells abgleichen. Fehler bei Authentifizierung und Parametervalidierung werden nicht berechnet.
- Nicht automatisch wiederholen: Inhaltsablehnungen gibt es in zwei Formen. Eine liefert einen eindeutigen Fehler zurück, etwa „Das Bild wurde nicht wie erwartet erzeugt. Bitte passen Sie die Eingabeaufforderung an und versuchen Sie es erneut.“ Dieser Fall wird nicht berechnet; Sie sollten die Eingabeaufforderung ändern. Die andere liefert 200, aber im Text steht eine sanfte Ablehnung wie „Ich kann diese Anforderung nicht erfüllen“. Protokollarisch gilt sie als normale Antwort und wird berechnet; auch der Anbieter kann sie auf Protokollebene nicht vorab erkennen. Reichen Sie dieselbe Eingabeaufforderung nicht automatisch erneut ein.
Frage: Bei -all wurde n=4 übergeben – warum kommt nur 1 Bild zurück, aber es wird 4-mal abgebucht?
-all akzeptiert kein n, aber wenn du es trotzdem übergibst, wird weiterhin das n-Fache berechnet. Das Beispiel auf der speziellen Seite: Bei n=3 werden 0,075 US-Dollar abgebucht, und trotzdem kommt nur 1 Bild zurück. Wenn du N Bilder brauchst, solltest du N Aufrufe parallel ausführen. Abnahmekriterium: Die Anzahl der Abbuchungen in der Konsole entspricht der Anzahl der tatsächlich erhaltenen Bilder.
Frage: Auf der Vergleichsseite steht, dass -all kein size akzeptiert – kann man es nun übergeben oder nicht?
Maßgeblich ist die spezielle -all-Seite: Ja, du kannst es übergeben. Ein explizit übergebenes size hat Vorrang vor der Größenangabe in der Eingabeaufforderung; wenn du es weglässt oder auto übergibst, bleibt das native Verhalten erhalten. Die Vergleichsseite wurde einfach noch nicht synchron aktualisiert.
Frage: Kann eine Enterprise-Gruppe die Bilderzeugung beschleunigen?
Nein. In den FAQ steht ausdrücklich, dass es sich nicht um einen Beschleunigungspfad handelt. Die Funktion stellt lediglich einen weiteren Ressourcenpool bereit, wenn die Default-Gruppe ausgelastet ist. Offizielle Reverse-Modelle können einfach in der Default-Gruppe bleiben.
Frage: Sind die 0,2 für den offiziellen Transfer in der Preis-API ein Preis pro Aufruf?
So sollte man das nicht verstehen. Die Preisübersicht weist nutzungsbasierte Abrechnung aus, und auch dieser Artikel orientiert sich an der nutzungsbasierten Abrechnung. Für einige Aliasse ohne Datumsangabe gibt die API model_price 0.2 zurück. Diese beiden Angaben sind nicht konsistent. Bitte prüfen Sie vor der Bestellung den tatsächlichen rabattierten Preis in der Konsole.
Frage: Gibt es für 2.6 -all- oder -vip-Versionen?
In der Preistabelle und der Preis-API vom 2026-11-10 tauchen sie nicht auf, und dieser Artikel stellt auch keine Vermutungen zum Veröffentlichungszeitpunkt an.
Empfohlene Standardkonfiguration
- Modellname:
gpt-image-2.5-all; wenn du bestimmte Größen oder 4K brauchst, wechsle zugpt-image-2.5-vip; wenn du die offiziellen Parameter brauchst, wechsle zugpt-image-2.6-flareodergpt-image-2.6-sunburst - Gruppe: höchste Priorität
image2Enterprise, StandardgruppeDefault; für Geschäfte, die stark von URLs abhängen, legst du ein separates Token mitimage2_OSSan - Token-Typ: Pay-per-Use bevorzugt (sowohl offizielle Weiterleitung als auch offizielle Reverse-Weiterleitung können aufrufen)
- Timeout in Sekunden: für -all/-vip auf 300 setzen; bei offizieller Weiterleitung mit niedriger und mittlerer Qualität 240, bei high/xhigh 300, bei max 600
- Base-URL:
https://api.apiyi.com/v1
Wenn du mit dieser Konfiguration läufst, musst du im Alltag nur auf zwei Dinge achten: was in error.message im Fehlerkörper steht und ob es in den aktuellen Live-Meldungen des Tages entsprechende Hinweise gibt. Mit den beiden Tabellen oben kannst du dann entscheiden, ob du mit Backoff erneut versuchen, die Anfrage anpassen oder den Kanal wechseln solltest.
Autor: APIYI Technikteam
Technischer Austausch: Wenn du auf Fehler stößt, die im Artikel nicht behandelt werden, kontaktiere uns gerne über die Startseite der APIYI-Website und füge dierequest-idsowie den vollständigen Fehlerkörper bei.