Anmerkung des Autors: Ausgehend von einer 30-minütigen Softwareentwicklungsaufgabe mit einem Agenten schlüsseln wir auf, wie sich bei mehrstufigen Agent-Aufrufen die Kosten für normale Eingaben, Cache-Schreibvorgänge, Cache-Lesevorgänge, Ausgaben und Tool-Aufrufe zusammensetzen. Außerdem vergleichen wir die Cache-Abrechnung dreier Anbieter und zeigen anhand eines Beispiels mit 12 Aufrufen, unter welchen Bedingungen Caching tatsächlich Geld spart.
Am 9. November 2026 veröffentlichte Google Cloud zwei Systeme der achten TPU-Generation: TPU 8tx und TPU 8i Max. Gleichzeitig wurde TPU Sync als Open-Source-Lösung für die Übertragung von KV-Caches freigegeben. Die „Memory Wall im Agent-Zeitalter“ ist damit erneut Thema. Viele Entwickler fragen sich verständlicherweise: Werden meine Agent-API-Kosten günstiger, wenn der zugrunde liegende KV-Cache immer schneller wird?
Der Mehrwert dieses Artikels: Nach der Lektüre kennen Sie eine vollständige Formel zur Berechnung der Agent-Kosten, einen Vergleich der Cache-Abrechnung dreier Anbieter und eine Checkliste zur Kostenoptimierung, die sich sofort umsetzen lässt.
API-Kosten bei mehrstufigen Agent-Aufrufen: die wichtigsten Fakten im Überblick
| Information | Details |
|---|---|
| Hintergrund | Am 09.11.2026 stellte Google TPU 8tx, TPU 8i Max und TPU Sync vor. Im Mittelpunkt standen die Engpässe bei Speicher und KV-Cache in Agenten. |
| Frage, die Entwickler beschäftigt | Können Optimierungen auf Hardwareebene zu niedrigeren Agent-API-Kosten führen? |
| Kernaussage | Die Kosten hängen gemeinsam von regulären Eingabe-Token, Cache-Schreibvorgängen, Cache-Lesevorgängen, Ausgabe-Token, der Anzahl der Aufrufe und den Kosten für Tools ab. |
| Wichtige Variablen | Ist der Präfix stabil? Deckt die Cache-TTL die Wartezeit auf Tools ab? Wächst der historische Kontext unkontrolliert? |
| Betroffene Anwendungsfälle | Mehrstufige Aufrufe, etwa bei Coding-Agenten, Agenten für lange Dokumente und der Zusammenarbeit mehrerer Agenten |
So sieht eine 30-minütige Aufgabe mit einem Agenten aus
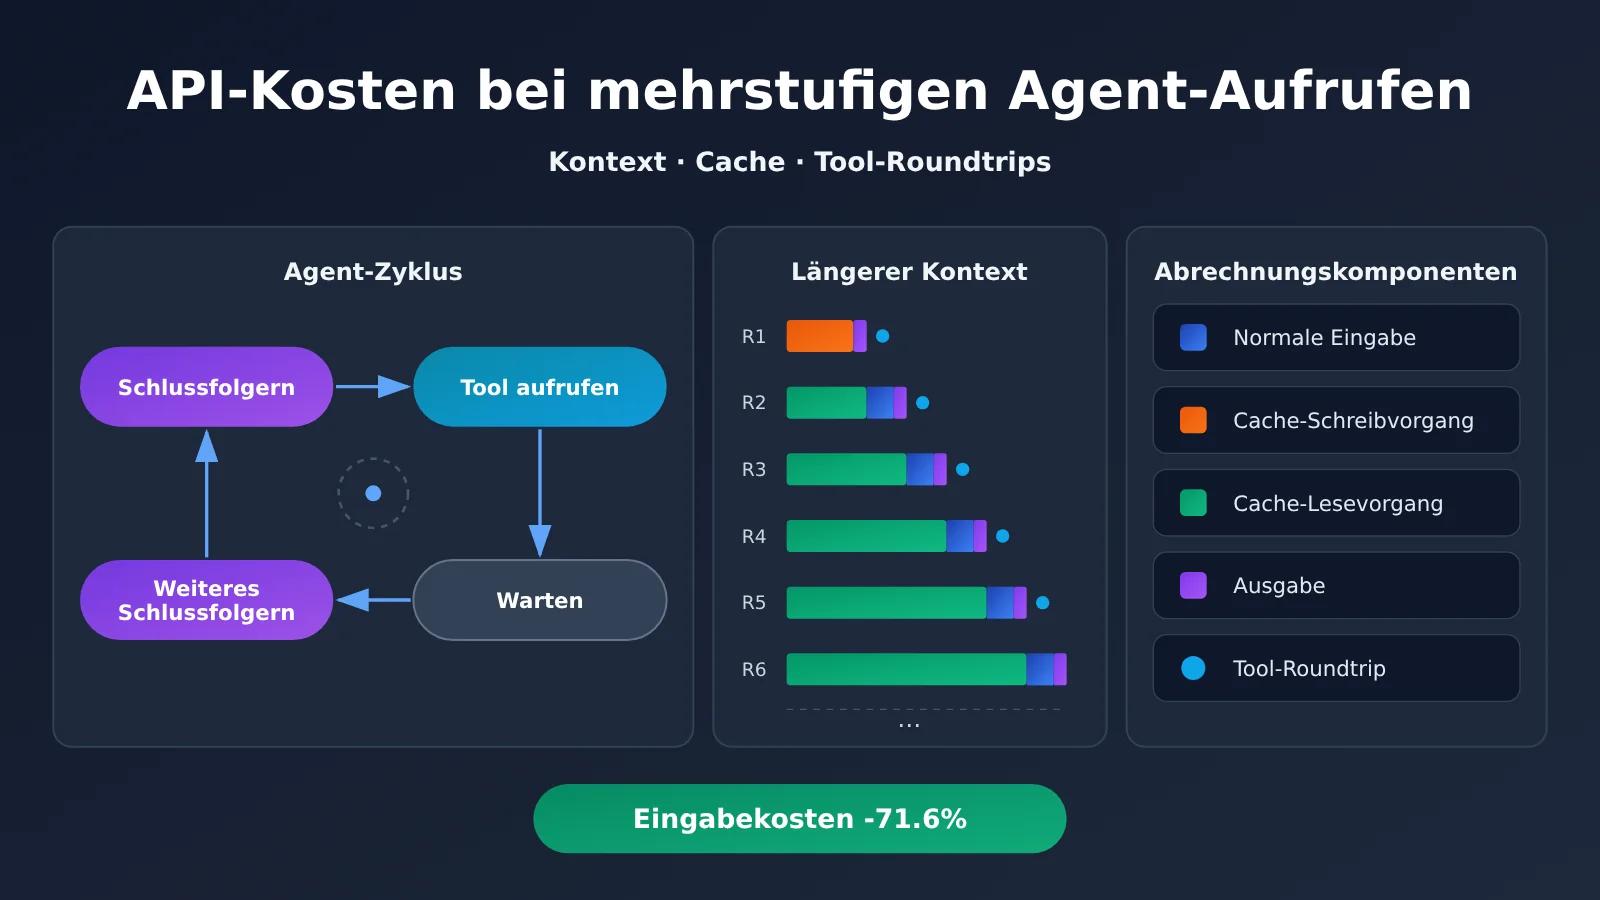
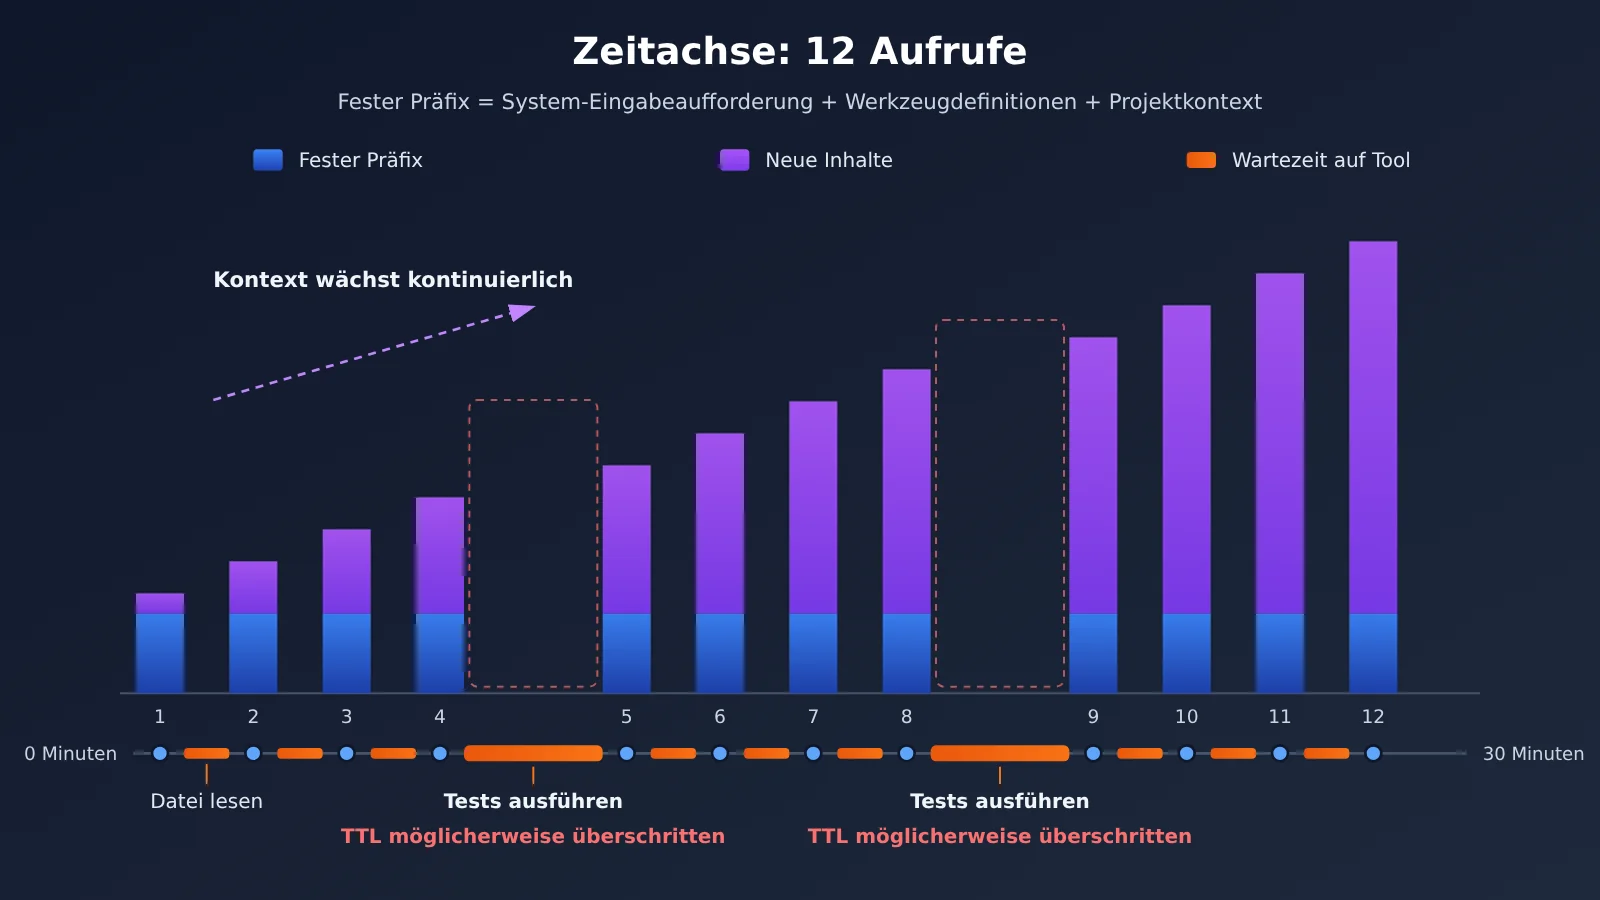
Stellen Sie sich vor, ein Softwareentwicklungs-Agent soll fehlschlagende Tests in einem Modul beheben. Zuerst liest er die Projektstruktur und den relevanten Quellcode, erstellt einen Änderungsvorschlag, bearbeitet Dateien mit einem Tool und führt Tests aus. Dann wartet er auf die Testergebnisse und beginnt anhand der Fehlermeldungen erneut mit dem Schlussfolgern. Innerhalb von 30 Minuten kann sich dieser Zyklus aus „Schlussfolgern – Tool-Aufruf – Warten – Schlussfolgern“ ein Dutzend Mal oder öfter wiederholen.
Das Problem: APIs für große Sprachmodelle sind grundsätzlich zustandslos. Bei jeder Anfrage muss der Agent den Systemprompt, die Tool-Definitionen, den Projektkontext sowie den bisherigen Dialog und die Tool-Ausgaben erneut an das Modell senden. Die zwölfte Anfrage enthält oft fast den gesamten Verlauf der ersten elf Runden. Genau dadurch wird der Kontext wiederholt verarbeitet.
Aus welchen Bestandteilen setzen sich die Kosten für mehrstufige Agent-API-Aufrufe zusammen?
Betrachtet man eine Agent-Aufgabe im Detail, fallen mindestens fünf Kostenarten an. Die ersten vier betreffen Token-Kosten des Modells. Die fünfte entsteht außerhalb des Modells und wird trotzdem oft übersehen.
| Kostenposition | Bedeutung | Abrechnungsmerkmale |
|---|---|---|
| Normale Eingabe | Eingabe-Token, die nicht aus dem Cache stammen und zum Standardpreis abgerechnet werden | Standardpreis für Eingaben |
| Cache-Schreibvorgang | Der Teil der Eingabe, der in einem wiederverwendbaren Cache gespeichert wird | Einige Anbieter und Modelle berechnen dafür einen Aufschlag gegenüber dem Standardpreis für Eingaben |
| Cache-Lesevorgang | Eingabe, die aus einem vorhandenen Cache abgerufen wird | In der Regel deutlich günstiger als der Standardpreis für Eingaben |
| Ausgabe-Token | Vom Modell generierte Inhalte einschließlich der Parameter für Tool-Aufrufe | Meist der teuerste Posten; Caching senkt diese Kosten nicht |
| Tools und externe Ausführung | Externe Dienste wie Suche, Codeausführung oder Datenbanken | Abrechnung nach den jeweiligen Servicepreisen; außerdem steigt dadurch die Anzahl der Modellaufrufe |
Daraus ergibt sich folgende Formel für die Kosten einer einzelnen Aufgabe:
Gesamtkosten der Aufgabe = Σ (normale Eingabe × Eingabepreis + Cache-Schreibvorgänge × Schreibpreis + Cache-Lesevorgänge × Lesepreis + Ausgabe × Ausgabepreis) + Kosten für Tools und externe Ausführung
Das Σ in der Formel steht für die Summe aller Modellaufrufe innerhalb der Aufgabe. Damit ist die Anzahl der Aufrufe selbst ein Kostenmultiplikator: Je mehr Tool-Rückfragen es gibt, desto mehr Modellaufrufe sind nötig und desto häufiger wird auch ein fester Präfix erneut abgerechnet. Tool-Aufrufe verursachen nicht nur eigene Kosten, sondern teilen einen einzelnen Schlussfolgerungsschritt in mehrere Schritte auf, bei denen der Kontext jedes Mal erneut mitgegeben werden muss.
Unterschiede zwischen KV Cache, Prompt Cache und Kontextkomprimierung bei mehrstufigen Agent-Aufrufen
Wenn es um die Kosten von Agents geht, werden diese drei Begriffe besonders häufig verwechselt. Sie beziehen sich auf unterschiedliche Ebenen und wirken sich ganz verschieden auf die Abrechnung aus.
| Technik | Ebene | Bedeutung | Auswirkungen für API-Nutzer |
|---|---|---|---|
| KV Cache | Unterste Ebene der Modellinferenz | Speichert Key-/Value-Zustände aus der Attention-Berechnung, damit historische Tokens nicht erneut berechnet werden müssen | Nutzer können ihn nicht direkt steuern; er beeinflusst die Kosten und Latenz des Anbieters |
| Prompt Cache | API-Dienstebene | Der Anbieter verwendet wiederkehrende Prompt-Präfixe erneut und rechnet das Schreiben und Auslesen des Caches separat ab | Schlägt sich direkt in den Cache-Feldern der Abrechnung nieder |
| Kontextkomprimierung | Anwendungsebene | Fasst den bisherigen Verlauf zusammen, filtert ihn oder kürzt ihn, bevor er erneut übermittelt wird | Verringert die tatsächlich übermittelte Tokenzahl, kann aber Details kosten |
Wichtig ist: Laut der offiziellen Dokumentation von OpenAI speichert Prompt Cache tatsächlich KV-Tensoren und nicht den Text der ursprünglichen Tokens. Prompt-Caching lässt sich daher als Bereitstellung und Abrechnung der Wiederverwendung von KV-Zuständen auf der unteren Ebene verstehen. Es hat durchaus einen Bezug zum KV Cache, aber für Nutzer sind nur die Abrechnungsregeln sichtbar.
Kontextkomprimierung ist etwas anderes. Sie verändert, was bei späteren Anfragen mitgeschickt wird – nicht, wie Inhalte wiederverwendet werden. Je stärker die Komprimierung, desto weniger Tokens werden benötigt. Gleichzeitig steigt aber das Risiko, dass der Agent wichtige Details vergisst.
Warum Optimierungen auf niedriger Ebene bei mehrstufigen Agent-Aufrufen nicht automatisch die Rechnung senken
Googles neu vorgestellter TPU 8i Max verdoppelt die HBM-Bandbreite und den On-Chip-SRAM. In internen Tests auf der Ironwood-Plattform senkte TPU Sync die Übertragungslatenz des KV Cache um mehr als 90 Prozent. Die Agent Compute Engine pausiert Sitzungen, wenn Agents gerade nicht aktiv sind, und lagert den Arbeitsspeicher aus dem Chip aus. Diese Optimierungen verbessern die Ressourcenauslastung des Anbieters und verringern die Inferenzlatenz, etwa die TTFT. Für Nutzer kann sich das in schnelleren Antworten bemerkbar machen.
Die API-Preise legt der Anbieter jedoch selbst fest, und die Abrechnung der Nutzer erfolgt weiterhin nach Token. Eine effizientere Hardware kann sich langfristig auf die Preise auswirken, aber eine automatische oder proportionale Weitergabe der Einsparungen gibt es nicht. Außerdem sind TPU 8tx und TPU 8i Max zum Stand vom 10. November 2026 weiterhin als „Demnächst verfügbar“ gekennzeichnet; Preise wurden noch nicht bekannt gegeben. Für Entwickler ist es daher sofort möglich, die eigene Tokenstruktur zu steuern – nicht aber die Hardware des Anbieters.
API-Kosten bei mehrstufigen Agentenaufrufen: Vergleich der Cache-Abrechnung bei drei Anbietern
Alle drei großen Anbieter bieten Caching an. Die Auslöser, TTL-Optionen und Abrechnungsmodelle unterscheiden sich jedoch deutlich. Die folgende Tabelle basiert auf den offiziellen Dokumentationen der Anbieter. Maßgeblich sind die Angaben zum jeweiligen Modell und zur jeweiligen Schnittstelle.
| Anbieter | Cache-Mechanismus | TTL-Optionen | Kosten fürs Schreiben | Kosten fürs Lesen | Verfügbare Plattformen |
|---|---|---|---|---|---|
| OpenAI | Prompt Caching, unterstützt automatische Präfix-Caches für Modelle | Bei einigen neueren Modellen standardmäßig 30 Minuten, bei manchen Modellen 12 Stunden | Für Modelle und Schnittstellen mit entsprechender Konfiguration: 30 Minuten kosten das 1,25-Fache normaler Eingaben, 12 Stunden das 2,5-Fache; bei anderen Cache-Modi fallen möglicherweise keine zusätzlichen Schreibkosten an | Üblicherweise das 0,1-Fache normaler Eingaben, bei manchen Modellen weniger | Offizielle API, APIYI apiyi.com |
| Anthropic | Prompt Caching | Standardmäßig 5 Minuten, auf bis zu 1 Stunde verlängerbar | 5 Minuten kosten das 1,25-Fache normaler Eingaben, 1 Stunde das 2-Fache | Je nach Modell unterschiedlich | Offizielle API, APIYI apiyi.com |
| Google Gemini | Context Caching, implizites und explizites Caching | Für explizite Caches lässt sich eine TTL festlegen | Für explizite Caches fallen zusätzliche Gebühren an, die sich nach der Zahl der Cache-Token und der Speicherdauer richten | Bei einem Cache-Treffer sinken die Kosten für wiederholte Eingaben | Offizielle API, APIYI apiyi.com |
Als Beispiel dienen die offiziellen Preise für Claude Sonnet 5.5: Normale Eingaben kosten 2,00 $ pro Million Token, das Schreiben in einen 5-Minuten-Cache 2,50 $, das Schreiben in einen 1-Stunden-Cache 4,00 $ und das Lesen aus dem Cache 0,10 $. Das Lesen aus dem Cache kostet also nur 5 % einer normalen Eingabe. Deshalb lassen sich die Kosten für wiederholte Präfixe so stark senken.
Wichtig ist: OpenAI weist ausdrücklich darauf hin, dass ein Cache-Treffer nicht bei jeder Anfrage garantiert ist. Auch der explizite Gemini-Cache ist kein „kostenloser Speicher“ – für die Speicherdauer fallen Gebühren an. Caching bietet also einen Rabatt unter bestimmten Bedingungen und senkt die Kosten nicht automatisch.
🎯 Technischer Tipp: Die Cache-Funktionen, Abrechnungsregeln und Rückgabefelder unterscheiden sich je nach zugrunde liegendem Modell. Ein einheitliches Gateway sorgt nicht automatisch dafür, dass alle Modelle dieselben Cache-Rabatte erhalten. Testen Sie daher die infrage kommenden Modelle mit demselben OpenAI-kompatiblen Code über APIYI apiyi.com und orientieren Sie sich an den tatsächlich zurückgegebenen
usage-Feldern und der Abrechnung.
Kostenberechnung für Agent-Aufrufe mit mehreren Gesprächsrunden und Caching: Beispiel mit 12 Aufrufen
Wir verwenden wieder die 30-minütige Entwicklungsaufgabe aus dem vorherigen Abschnitt und rechnen mit den offiziellen Preisen für Claude Sonnet 5.5. Dabei gelten folgende Annahmen:
- Die Aufgabe umfasst 12 Modellaufrufe mit jeweils 22.000 Token Eingabe;
- davon entfallen 20.000 Token auf wiederholte System-Eingabeaufforderungen, Tool-Definitionen und den Projektkontext;
- pro Aufruf kommen 2.000 neue Token hinzu;
- es wird ein Cache mit einer Laufzeit von 1 Stunde verwendet, der bei allen nachfolgenden Anfragen erfolgreich wiederverwendet wird.
Ohne Caching: 12 × 22.000 × $2 / 1.000.000 = $0.528.
Mit einem Cache von 1 Stunde: Das erstmalige Schreiben von 20.000 Token kostet $0.080, die erstmalige normale Eingabe von 2.000 Token kostet $0.004, die 11 nachfolgenden Cache-Lesevorgänge kosten $0.022 und die 11 nachfolgenden neuen Eingaben kosten $0.044. Insgesamt ergibt das $0.150 – eine Einsparung bei den Eingabekosten von rund 71.6 %.
Dieses Beispiel berücksichtigt nur Eingabe-Token. Ausgabe-Token, Tool-Aufrufe und externe Dienste sind nicht enthalten. In der Praxis wächst der Gesprächsverlauf eines Agents mit jeder Runde, doch die grundsätzliche Aussage bleibt: Wiederholter Kontext ist der Kostenfaktor, der sich bei mehrstufigen Agent-Aufrufen am stärksten auswirken kann.
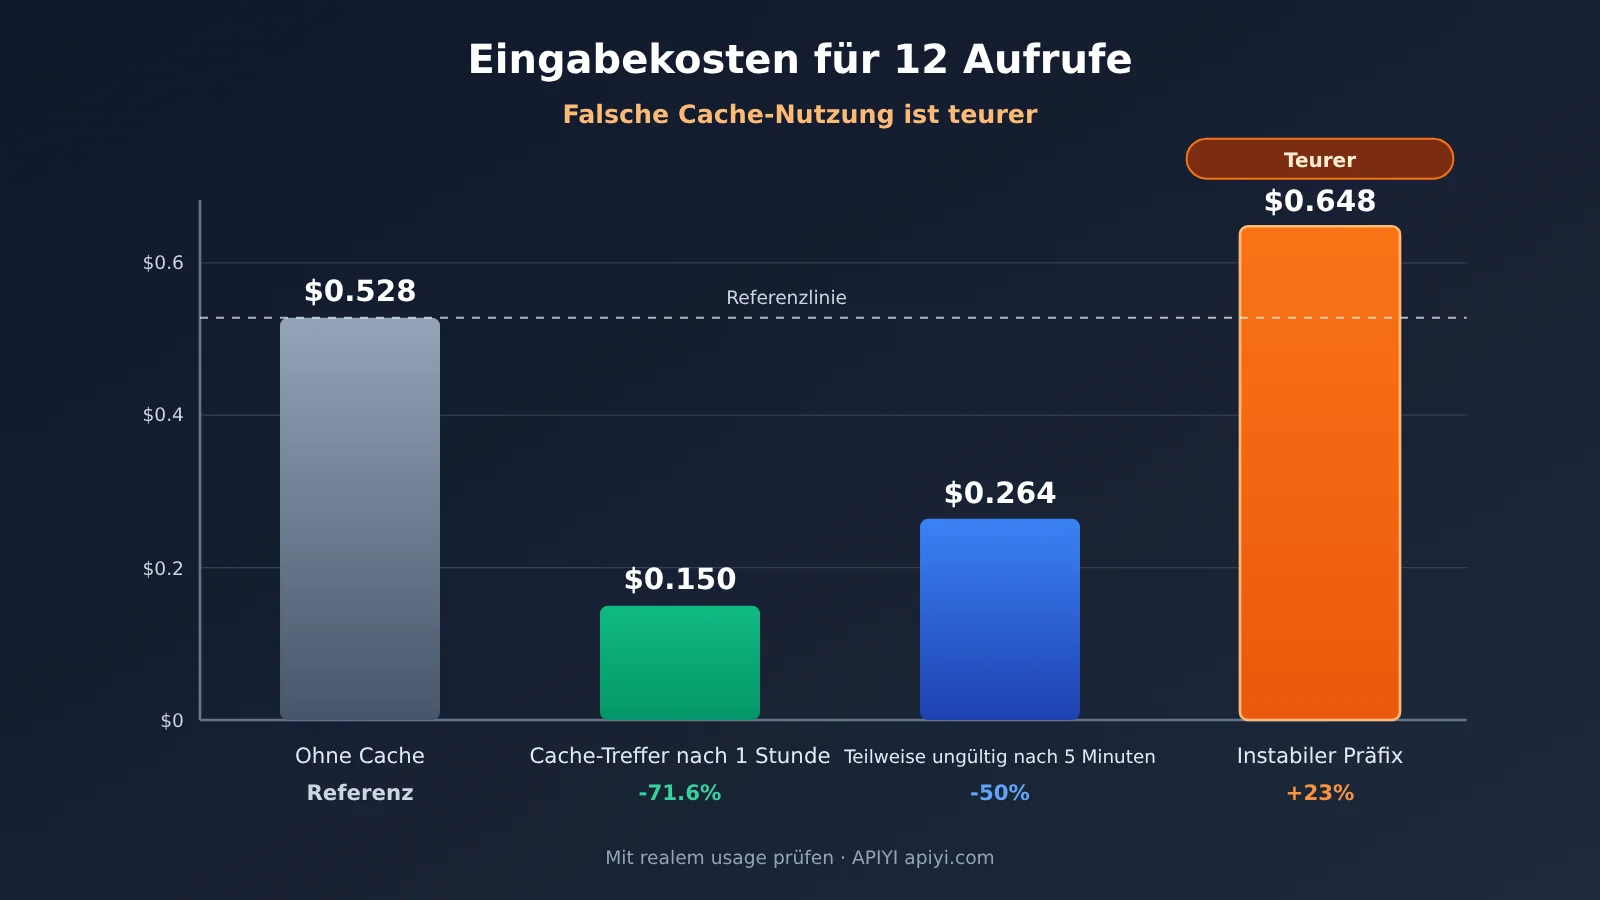
Wie Cache-Ablauf, Präfixänderungen und TTL die Kosten eines Agents beeinflussen
Oben wurde der Idealfall betrachtet. Anhand derselben Preise rechnen wir nun drei häufige Abweichungen durch. (Die folgenden Beispiele wurden für diesen Artikel auf Basis der offiziellen Preise selbst berechnet.)
| Szenario | Annahme | Eingabekosten | Im Vergleich zu „ohne Caching“ |
|---|---|---|---|
| Ohne Caching | Alle 12 Aufrufe werden als normale Eingabe abgerechnet | $0.528 | Basiswert |
| 1-Stunden-Cache mit vollständigen Treffern | 1 Schreibvorgang, 11 Lesevorgänge | $0.150 | Rund 71.6 % Einsparung |
| 5-Minuten-Cache mit vollständigen Treffern | Schreibpreis $2.50, 11 Lesevorgänge | $0.120 | Rund 77.3 % Einsparung |
| 5-Minuten-Cache mit teilweisem Ablauf | Wegen einer Zeitüberschreitung beim Warten auf ein Tool erfolgen insgesamt 4 Schreib- und 8 Lesevorgänge | $0.264 | Rund 50 % Einsparung |
| Instabiles Präfix | Das Präfix ändert sich bei jedem Aufruf; alle 12 Aufrufe werden zum Schreibpreis des 5-Minuten-Caches abgerechnet | $0.648 | Rund 23 % Mehrkosten |
Diese Punkte können direkt als Entscheidungshilfe dienen:
- Die TTL muss die Wartezeit auf Tools abdecken: Das Schreiben in einen 5-Minuten-Cache ist günstiger. Dauert ein Testlauf oder eine manuelle Bestätigung jedoch länger als 5 Minuten, läuft der Cache ab und muss erneut geschrieben werden. Dadurch sinkt die Ersparnis deutlich.
- Ein stabiles Präfix ist wichtiger als die TTL: Stehen Zeitstempel oder zufällige IDs am Anfang der Eingabeaufforderung, kann keine Anfrage den Cache-Treffer nutzen. Bei Abrechnungsmodellen mit Aufpreis für Schreibvorgänge macht Caching die Rechnung dann sogar teurer.
- Eine längere TTL ist nicht automatisch besser: Der Schreibpreis für eine Stunde ist 1,6-mal so hoch wie für 5 Minuten. Sie lohnt sich nur, wenn der Abstand zwischen den Aufrufen tatsächlich länger als 5 Minuten sein kann.
So senken Sie die API-Kosten bei mehrstufigen Agent-Aufrufen
Minimalbeispiel: Cache-Treffer bei jedem Aufruf erfassen
Der erste Schritt zur Kostenoptimierung ist, die Kosten sichtbar zu machen. Der folgende Code sendet eine Anfrage über eine OpenAI-kompatible Schnittstelle und gibt die Cache-relevanten Felder aus usage aus:
import openai

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"  # OpenAI-kompatible Schnittstelle von APIYI
)

resp = client.chat.completions.create(
    model="your-model-name",  # Ersetzen Sie den Wert durch das zu testende Modell
    messages=[
        {"role": "system", "content": "固定的系统提示词与工具说明……"},
        {"role": "user", "content": "本轮新增的任务内容"}
    ]
)
usage = resp.usage
details = getattr(usage, "prompt_tokens_details", None)
print("输入:", usage.prompt_tokens, "输出:", usage.completion_tokens,
      "缓存命中:", getattr(details, "cached_tokens", None))
Vollständige Implementierung ansehen: stabiler Präfix und Kostenverfolgung pro Aufgabe
import openai
from dataclasses import dataclass, field

client = openai.OpenAI(
    api_key="YOUR_API_KEY",
    base_url="https://api.apiyi.com/v1"
)

# Stabiler Präfix: Systemanweisungen, Werkzeugdefinitionen und allgemeiner Projektkontext stehen ganz am Anfang und bleiben bytegenau unverändert
STABLE_PREFIX = [
    {"role": "system", "content": "你是代码修复 Agent。工具定义与项目规范如下……"},
]

@dataclass
class TaskCost:
    # Preise pro Million Token in US-Dollar; tragen Sie die offiziellen Preise des verwendeten Modells ein
    input_price: float
    cache_read_price: float
    output_price: float
    records: list = field(default_factory=list)

    def add(self, usage):
        details = getattr(usage, "prompt_tokens_details", None)
        cached = getattr(details, "cached_tokens", 0) or 0
        uncached = usage.prompt_tokens - cached
        cost = (uncached * self.input_price
                + cached * self.cache_read_price
                + usage.completion_tokens * self.output_price) / 1_000_000
        self.records.append({"cached": cached, "uncached": uncached,
                             "output": usage.completion_tokens, "cost": cost})

    def summary(self):
        total_in = sum(r["cached"] + r["uncached"] for r in self.records)
        hit = sum(r["cached"] for r in self.records) / max(total_in, 1)
        return {"calls": len(self.records), "cache_hit_rate": round(hit, 3),
                "total_cost": round(sum(r["cost"] for r in self.records), 4)}

def run_turn(history, new_msg, tracker, model="your-model-name"):
    # Fügen Sie nur neue Nachrichten hinzu, ohne den Verlauf umzusortieren; dynamische Informationen wie Zeitstempel gehören ans Ende
    history.append({"role": "user", "content": new_msg})
    resp = client.chat.completions.create(
        model=model, messages=STABLE_PREFIX + history)
    tracker.add(resp.usage)
    history.append({"role": "assistant",
                    "content": resp.choices[0].message.content})
    return resp

tracker = TaskCost(input_price=2.0, cache_read_price=0.1, output_price=0.0)
history = []
run_turn(history, "测试 test_auth 失败,报错如下……", tracker)
print(tracker.summary())
Beachten Sie, dass die obige Schätzung nur die Kosten für das Lesen aus dem Cache berücksichtigt. Berechnet das verwendete Modell das Schreiben in den Cache separat, müssen Sie die Schreibkosten anhand der zurückgegebenen Felder ergänzen. Die Namen und Bedeutungen der usage-Felder können je nach Modell variieren. Maßgeblich ist daher die tatsächliche Antwort.
🚀 Schnellstart: Testen Sie das Skript zur Kostenverfolgung zunächst mit dem kostenlosen Testkontingent von APIYI auf apiyi.com. So erhalten Sie für dieselbe Aufgabe die Cache-Trefferrate und die Kosten pro Aufgabe bei verschiedenen Modellen – und können anschließend entscheiden, welches Modell und welche TTL Sie in der Produktionsumgebung verwenden.
Fünf Maßnahmen zur Kostenoptimierung bei mehrstufigen Agent-Aufrufen
- Stabilen Präfix der Eingabeaufforderung verwenden: Systemanweisungen, Tool-Definitionen und allgemeine Referenzmaterialien an den Anfang setzen, Zeitstempel und dynamische Nutzerinformationen ans Ende. Auch die Reihenfolge und die Felder der Tool-Definitionen sollten nicht willkürlich geändert werden.
- TTL sinnvoll wählen: Für Aufgaben mit hoher Aufruffrequenz und kurzen Abständen eignet sich ein kurzes TTL. Bei Agents mit langen Test-, Build- oder Freigabephasen sollte geprüft werden, ob der Aufpreis für ein längeres TTL durch vermiedene erneute Schreibvorgänge ausgeglichen wird.
- Verlaufskontext begrenzen: Inhalte nur anhängen, nicht neu anordnen – so bleibt der Cache-Präfix erhalten. Lange Tool-Ausgaben zusammenfassen und dabei wichtige Schlussfolgerungen, den Aufgabenstatus und notwendige Belege bewahren.
- Unnötige Modellaufrufe reduzieren: Tools, die sich gesammelt ausführen lassen, in einem Aufruf bündeln. Deterministische Schritte mit Code statt durch das Modell ausführen lassen, um die Zahl der Interaktionen von vornherein zu senken.
- Reale Kennzahlen überwachen: Pro Aufgabe normale Eingabe-Token, Cache-Schreibvorgänge, Cache-Lesevorgänge, Ausgabe-Token, Cache-Trefferquote, TTFT und Gesamtkosten erfassen. Die Bewertung sollte auf den Kosten pro Aufgabe beruhen, nicht auf den Kosten pro einzelner Anfrage.
Analyse der Auswirkungen mehrstufiger Agent-Aufrufe auf die API-Kosten
Auswirkungen auf Entwickler
- Das Kostenmodell muss von der einzelnen Anfrage auf die gesamte Aufgabe erweitert werden: Die Kosten eines Agents hängen von der kompletten Aufrufkette ab. Wer nur den Einzelpreis betrachtet, unterschätzt die tatsächliche Rechnung erheblich.
- Prompt Engineering muss auch die Abrechnungsstruktur berücksichtigen: Die Stabilität des Präfixes entscheidet unmittelbar darüber, ob der Cache greift. Der Aufbau der Eingabeaufforderung wird damit Teil der Kostenoptimierung.
- Die Auswahl zwischen mehreren Modellen erfordert Praxistests: Rabatte für Cache-Treffer, TTL und Aufpreise für Schreibvorgänge unterscheiden sich je nach Modell. Selbst bei derselben Aufgabe können die Kosten je nach Modell stark variieren.
Auswirkungen auf die Branche
- Der Infrastrukturwettbewerb richtet sich stärker auf Agent-Workloads aus: Google setzt auf Speicherbandbreite, die Übertragung von KV-Caches sowie das Pausieren und Fortsetzen von Agents. Das zeigt, dass mehrstufige Aufrufe mit langem Kontext inzwischen zu den typischen Workloads gehören.
- Nutzer profitieren zunächst vor allem von geringeren Latenzen: Optimierungen auf Infrastrukturebene verbessern zuerst TTFT und Durchsatz. Ob die Token-Preise sinken, hängt von der Preisstrategie des Anbieters ab – Entwickler sollten solche Senkungen daher nicht vorab in ihr Budget einrechnen.
Häufig gestellte Fragen (FAQ)
F1: Warum sind die API-Kosten bei Agent-Aufrufen über mehrere Runden höher als erwartet?
Da die API zustandslos ist, müssen bei jedem Aufruf die System-Eingabeaufforderung, die Tool-Definitionen und der bisherige Kontext erneut mitgesendet werden. Je mehr Aufrufe erfolgen, desto häufiger werden diese festen Inhalte erneut berechnet. Tool-Aufrufe mit Rückfragen erhöhen zusätzlich die Anzahl der Aufrufrunden.
F2: Sind KV Cache und Prompt Cache dasselbe?
Nicht ganz. KV Cache ist die Wiederverwendung von Zuständen auf der Ebene der Modellinferenz. Prompt Cache bezeichnet das Caching wiederverwendbarer Präfixe auf API-Ebene durch den Anbieter, einschließlich der Abrechnung. Laut OpenAI-Dokumentation werden dabei KV-Tensoren gespeichert. Nutzer können Prompt Cache nur anhand der Abrechnungsregeln nachvollziehen, KV Cache aber nicht direkt steuern.
F3: Sinken die API-Preise sofort, wenn Google neue TPUs vorstellt?
Dafür gibt es keine Grundlage. TPU 8tx und TPU 8i Max waren am 10.11.2026 weiterhin als „Coming soon“ angekündigt; Preise wurden nicht veröffentlicht. Hardwareoptimierungen verbessern vor allem die Ressourcenauslastung und Latenz bei den Anbietern. Ob sich das auf die Token-Preise auswirkt, hängt von deren Preisgestaltung ab.
F4: Spart Caching immer Geld?
Nicht unbedingt. Wenn sich das Präfix bei jedem Aufruf ändert und deshalb kein Cache-Treffer zustande kommt, während für Schreibvorgänge im Cache ein Aufpreis anfällt, können die Kosten sogar höher sein als ohne Cache. Dauert das Warten auf ein Tool länger als die TTL, können häufige erneute Schreibvorgänge die Einsparungen ebenfalls schmälern.
F5: Wie lassen sich die Cache-Effekte verschiedener Modelle schnell vergleichen?
Führen Sie am besten dieselbe Agent-Aufgabe mit mehreren Modellen durch und protokollieren Sie dabei die Cache-Trefferrate und die Gesamtkosten pro Aufgabe. Über APIYI auf apiyi.com können Sie OpenAI-, Claude-, Gemini- und andere Modelle mit einem API-Schlüssel aufrufen. Zum Vergleichen müssen Sie lediglich den Parameter `model` ändern.
F6: Welche Risiken birgt die Kontextkomprimierung?
Durch die Komprimierung ändern sich die Inhalte, die bei späteren Anfragen mitgesendet werden. Dabei können wichtige Details verloren gehen, sodass der Agent Fehler wiederholt und dadurch womöglich mehr Aufrufrunden benötigt. Wird der komprimierte Inhalt außerdem in jeder Runde neu erzeugt, kann das die Cache-Präfixe beeinträchtigen. Die Komprimierung sollte daher gemeinsam mit der Caching-Strategie geplant werden.
F7: Gelten Cache-Vorteile bei Aufrufen über ein einheitliches Gateway für alle Modelle gleichermaßen?
Nein. Cache-Funktionen, Abrechnungsregeln und zurückgegebene Felder hängen vom jeweiligen zugrunde liegenden Modell ab. Wenn Sie über APIYI auf apiyi.com testen, sollten Sie für jedes Modell die Cache-Felder und die tatsächlichen Kosten einzeln prüfen und diese anschließend in die Kostenplanung einbeziehen.
Zentrale Erkenntnisse zu den API-Kosten bei mehrstufigen Agent-Aufrufen
- Abgerechnet wird pro Aufgabe: Die Rechnung für einen Agenten umfasst die gesamte Aufrufkette, nicht nur eine einzelne Anfrage.
- Wiederholter Kontext verursacht den größten Teil der Kosten: Im Beispiel mit 12 Aufrufen senkt ein Cache mit einer Gültigkeitsdauer von einer Stunde die Eingabekosten um etwa 71,6 %.
- Caching senkt die Kosten nur unter bestimmten Bedingungen: Ist der Präfix nicht stabil oder die TTL zu kurz, fällt die Ersparnis geringer aus oder die Kosten steigen sogar.
- Drei Anbieter, drei Abrechnungsmodelle: Schreibmultiplikator, Lesepreisnachlass und Speichergebühren müssen für das jeweilige Modell geprüft werden.
- Hardwareoptimierung senkt nicht automatisch die Rechnung: Optimierungen am KV-Cache verbessern zunächst die Latenz. Der Preis hängt von der Preisgestaltung des Anbieters ab.
- Erst messen, dann optimieren: Mit APIYI apiyi.com lassen sich über eine einheitliche Schnittstelle die Cache-Trefferrate und die Aufgabenkosten verschiedener Modelle in der Praxis messen.
Zusammenfassung
Die API-Kosten mehrstufiger Agent-Aufrufe werden gemeinsam durch wiederholt berechneten Kontext, Cache-Treffer und Tool-Aufrufe bestimmt:
- Wiederholt berechneter Kontext bildet die Kostenbasis: Je mehr Aufrufe, desto mehr Wiederholungen.
- Cache-Treffer bestimmen, wie stark sich die Kosten für wiederholte Inhalte senken lassen. Entscheidend sind ein stabiler Präfix und die TTL.
- Tool-Aufrufe verursachen zusätzliche externe Kosten und erhöhen zugleich die Zahl der Modellaufrufe.
Googles Investitionen in KV-Cache und die Überwindung der Memory Wall auf Infrastrukturebene sorgen dafür, dass Agenten schneller laufen. Was Entwickler unmittelbar beeinflussen können, ist jedoch die eigene Token-Struktur. Empfehlenswert sind fünf Maßnahmen: stabile Präfixe, eine passende TTL, ein kompakter Verlauf, weniger Aufrufe und Monitoring auf Aufgabenebene. Mit APIYI apiyi.com können Sie anhand realer Daten überprüfen, wie wirksam die einzelnen Optimierungen sind.
📚 Referenzen
- Google Cloud Blog – Introducing TPU 8tx and TPU 8i Max: Ankündigung der neuen TPU-Systeme der achten Generation
- Link:
cloud.google.com/blog/topics/ai-infrastructure/tpu-8tx-and-tpu-8i-max -
Hintergrund: Informationen zur Speicherwand bei Agents und zu KV Cache
-
Google Cloud Blog – Introducing TPU Sync: Open-Source-Bibliothek für die Übertragung von KV Cache und Gewichten
- Link:
cloud.google.com/blog/topics/ai-infrastructure/introducing-tpu-sync-fast-kv-cache-and-weight-transfer-on-tpu -
Hintergrund: Optimierungen der KV-Cache-Übertragung auf niedriger Ebene und Testmethodik
-
OpenAI API-Dokumentation – Prompt Caching: Caching-Mechanismus und Best Practices
- Link:
platform.openai.com/docs/guides/prompt-caching -
Hintergrund: Regeln für das Präfix-Caching, Aufbewahrungsdauer und Überwachungsempfehlungen
-
Anthropic-Dokumentation – Prompt Caching: Informationen zu Cache-TTL und Abrechnung
- Link:
docs.anthropic.com/en/docs/build-with-claude/prompt-caching -
Hintergrund: Preise für das Schreiben und Lesen von Caches mit einer Laufzeit von 5 Minuten bzw. 1 Stunde
-
Google AI for Developers – Context Caching: Implizites und explizites Caching in Gemini
- Link:
ai.google.dev/gemini-api/docs/caching - Hintergrund: Informationen zu TTL und Speicherkosten für explizite Caches
Autor: APIYI-Technikteam
Technischer Austausch: Besuchen Sie die APIYI-Website unter apiyi.com und kontaktieren Sie uns. Weitere Informationen zur Anbindung finden Sie im Dokumentationsbereich unter docs.apiyi.com.