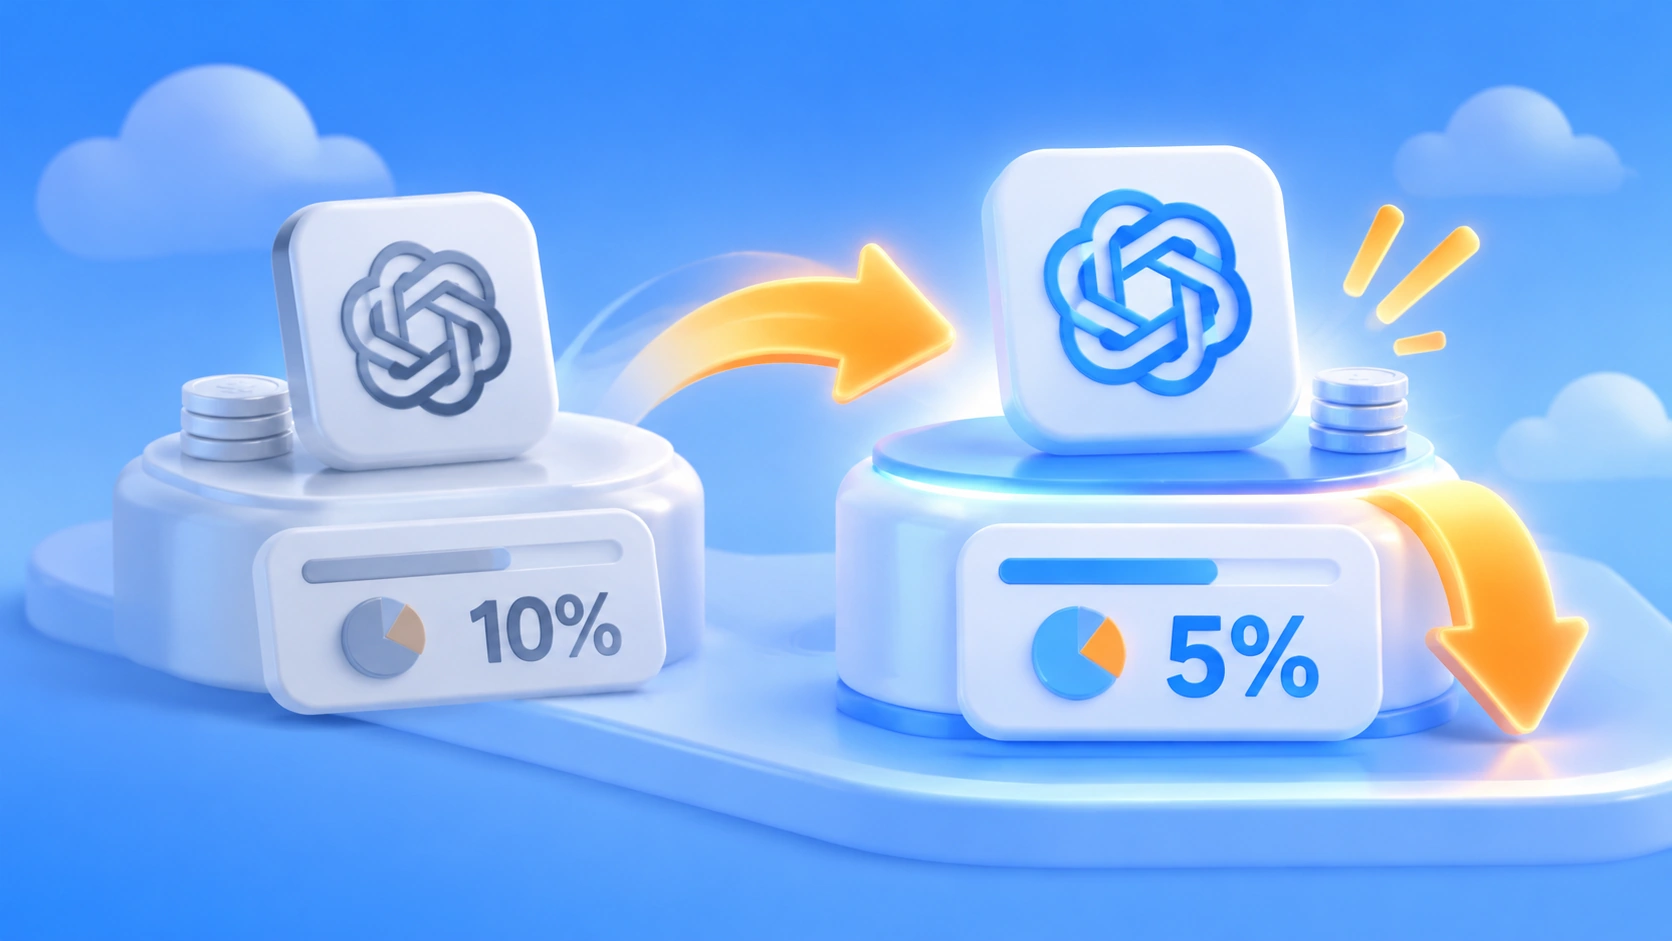
Autorenhinweis: Bei gpt-6-sol und gpt-6.1-sol sind die Preise für Ein- und Ausgabe gleich, der Multiplikator für das Lesen aus dem Cache unterscheidet sich jedoch um den Faktor zwei. Dieser Artikel zeigt, wie du die Cache-Kosten langer Sitzungen senkst, indem du nur das Feld model in der Anfrage änderst.
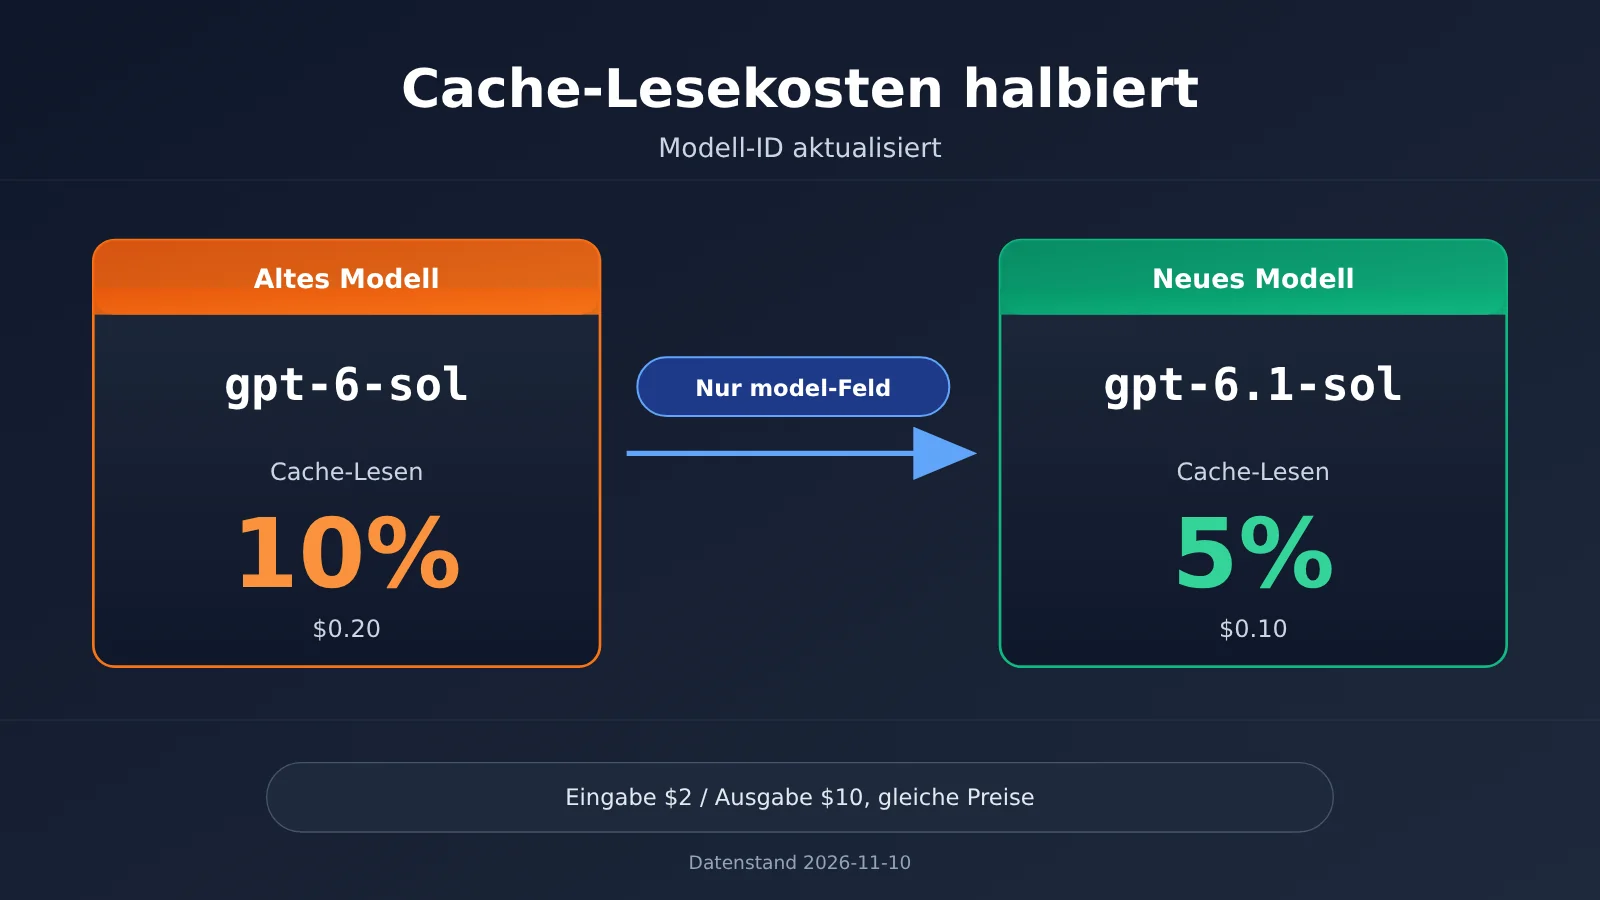
Viele Entwickler verwenden im Alltag bereits 6.1 Sol, 6.1 Terra oder 6 Luna. Ein Blick in die Projektkonfiguration zeigt jedoch oft, dass in den Anfragen eines älteren Dienstes noch gpt-6-sol steht. Dieser Artikel stellt eine einfache Änderung vor: Ersetze gpt-6-sol durch gpt-6.1-sol. Die Preise für Ein- und Ausgabe bleiben gleich, während der Preis für das Lesen aus dem Cache von 10 % auf 5 % des Eingabepreises sinkt.
Das ist weder eine Aktion noch musst du dafür deinen Tarif wechseln. Die Preisunterschiede zwischen den beiden Sol-Modellen sind direkt in der offiziellen Preisliste von OpenAI aufgeführt. Die Multiplikatoren in der Modellübersicht der APIYI-Plattform stimmen mit den offiziellen Angaben überein. Du musst lediglich eine Zeichenfolge in der Anfrage ändern.
Der wichtigste Nutzen: Nach der Lektüre weißt du, welche Modell-ID du ändern musst, wie viel du dadurch beim Lesen aus dem Cache sparst und warum sich die Schlussfolgerung „halbierte Cache-Lesekosten“ nicht auf andere Modelle außerhalb von Terra und Luna übertragen lässt – insbesondere nicht auf Luna.
Die wichtigsten Preisunterschiede zwischen gpt-6-sol und gpt-6.1-sol
Werfen wir zuerst einen Blick auf die wichtigste Tabelle. Alle Preise gelten pro einer Million Token. Die Daten stammen vom 10.11.2026 und basieren auf den Standardpreisen in der offiziellen Preisliste von OpenAI. Sie stimmen mit den Multiplikatoren überein, die der Preislisten-Endpunkt von APIYI zurückgibt.
| Modell-ID | Eingabepreis | Ausgabepreis | Preis für Cache-Lesezugriffe | Cache-Lesezugriffe im Verhältnis zum Eingabepreis |
|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 10% |
gpt-6.1-sol |
$2 | $10 | $0.10 | 5% |
Die Tabelle zeigt: Bei Eingaben und Ausgaben gibt es zwischen den beiden Sol-Versionen keinen Preisunterschied. Der einzige Unterschied betrifft Cache-Lesezugriffe. Bei kurzen Anfragen in einer einzelnen Runde ist er kaum spürbar. Bei Anwendungen, die immer wieder lange System-Eingabeaufforderungen, umfangreiche Tool-Definitionen und lange Gesprächsverläufe mitsenden, machen Cache-Lesezugriffe jedoch oft einen großen Teil der Eingabe-Token aus. Ein doppelt so hoher Multiplikator summiert sich mit jeder Anfrage.
Warum der Preis für Cache-Lesezugriffe bei gpt-6.1-sol besonders interessant ist
Prompt-Caching bedeutet: Wenn der Präfix einer Anfrage mit dem einer früheren Anfrage übereinstimmt, werden die betreffenden Token zum Preis für Cache-Lesezugriffe abgerechnet und nicht zum vollen Eingabepreis. Anwendungen wie Agenten, Code-Assistenten und Kundenservice-Bots senden in jeder Runde dieselben System-Eingabeaufforderungen und Nachrichten aus dem bisherigen Verlauf erneut mit. Daher ist die Cache-Trefferquote oft hoch.
Bei solchen Workloads wirkt sich der Preis für Cache-Lesezugriffe oft direkter auf die Rechnung aus als der Eingabepreis. Für gpt-6-sol kostet ein Cache-Lesezugriff $0.20, für gpt-6.1-sol $0.10. Bei gleicher Zahl an Cache-Treffern zahlen Sie mit der älteren Version also doppelt so viel. Wenn Ihr Dienst noch die alte ID verwendet und lange Gespräche verarbeitet, zahlen Sie laufend mehr für denselben Kontext.
Wie die Plattformmultiplikatoren den offiziellen Preisen entsprechen
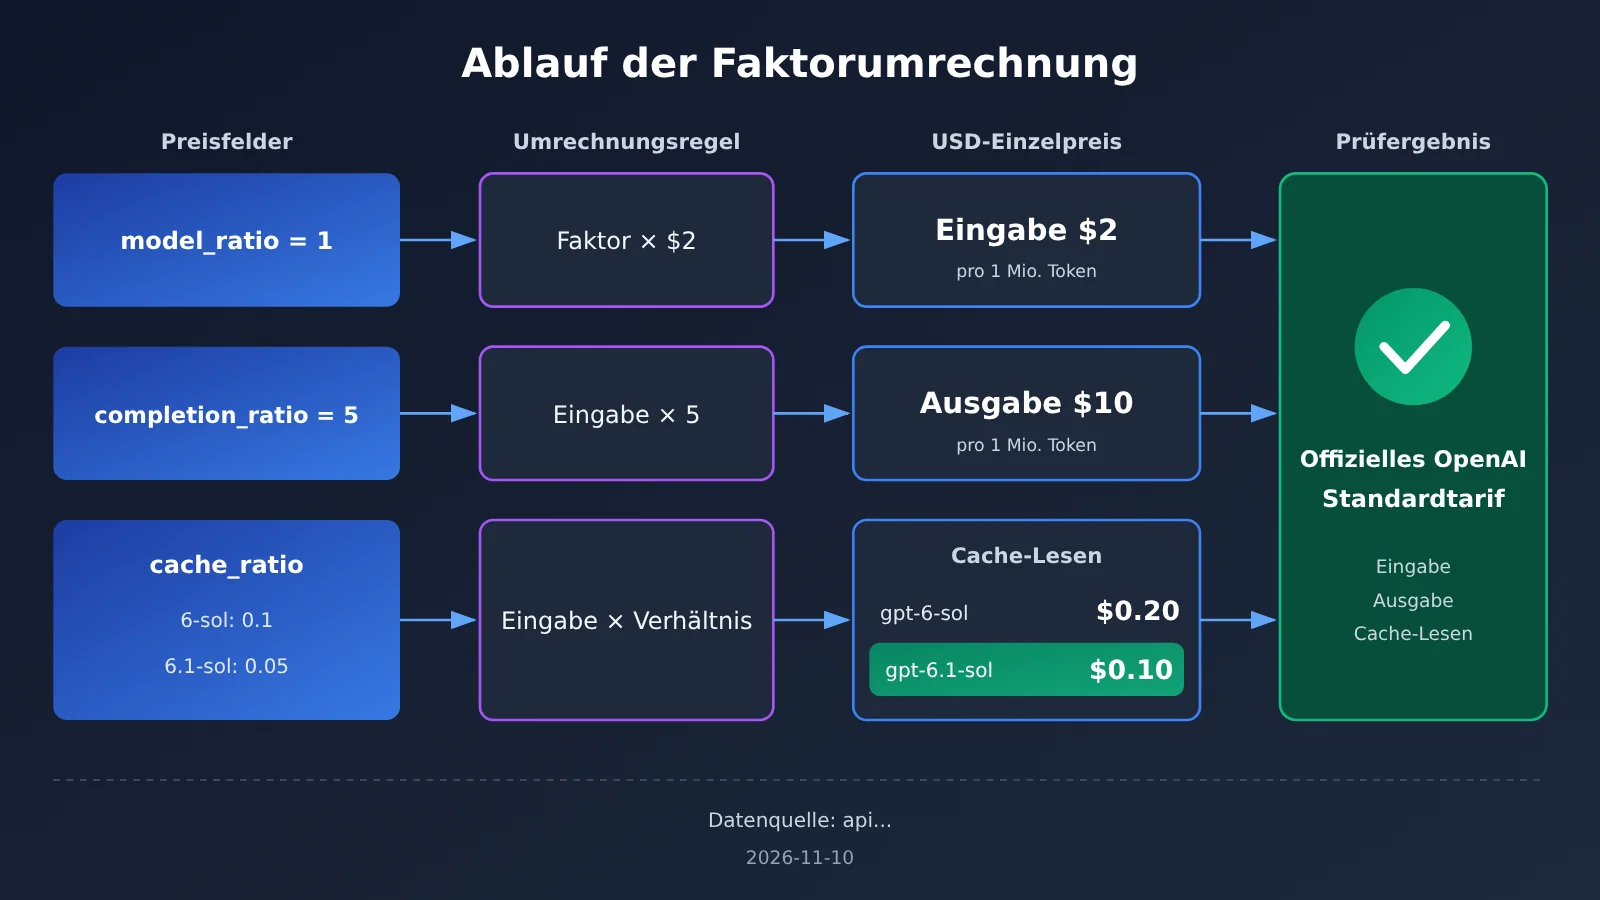
Die Preisschnittstelle von APIYI gibt Preise als Multiplikatoren an. Die am 10.11.2026 abgerufenen Daten enthalten beide Sol-Versionen mit folgenden Multiplikatoren:
| Feld | gpt-6-sol |
gpt-6.1-sol |
Bedeutung |
|---|---|---|---|
| model_ratio | 1 | 1 | Multiplikator 1 entspricht einem Eingabepreis von $2 pro einer Million Token |
| completion_ratio | 5 | 5 | Die Ausgabe kostet das Fünffache der Eingabe, also $10 |
| cache_ratio | 0.1 | 0.05 | Cache-Lesezugriffe kosten 10 % bzw. 5 % des Eingabepreises |
Bei der Umrechnung mit „Multiplikator 1 = $2 Eingabepreis pro einer Million Token“ ergeben sich für beide Modelle $2 für Eingaben und $10 für Ausgaben. Cache-Lesezugriffe kosten jeweils $0.20 und $0.10. Damit entsprechen die Werte vollständig der offiziellen Preisliste. Zu beachten ist, dass hier nur die Multiplikatoren des Modells selbst umgerechnet werden; Gruppenmultiplikatoren sind nicht berücksichtigt. Für die konkreten Abrechnungspreise sind die Gruppe Ihres Kontos und die Modellliste der Plattform maßgeblich. Zum Preisvergleich können Sie die Modellpreisseite auf APIYI unter apiyi.com aufrufen und die drei Multiplikatoren überprüfen.
So berechnen Sie die Kosten für lange Sitzungen mit gpt-6.1-sol
Der Einheitspreis allein macht den Unterschied nicht besonders anschaulich. Ein rein mathematisches Beispiel zeigt ihn deutlicher: Angenommen, eine Agent-Sitzung umfasst 100 Runden und bei jeder Anfrage werden etwa 50.000 Token des Präfixes aus dem Cache abgerufen. Dann summieren sich die Cache-Lesezugriffe über die gesamte Sitzung auf 5 Millionen Token.
| Berechnungsposten | gpt-6-sol |
gpt-6.1-sol |
|---|---|---|
| Insgesamt aus dem Cache abgerufene Token | 5 Mio. | 5 Mio. |
| Preis für Cache-Lesezugriffe (pro Million) | $0.20 | $0.10 |
| Kosten für Cache-Lesezugriffe | $1.00 | $0.50 |
| Ein- und Ausgabe | Gleicher Preis | Gleicher Preis |
Das sind die Kosten für eine einzelne Sitzung. Gibt es täglich Tausende vergleichbarer Sitzungen, ergibt sich bei den Cache-Lesezugriffen eine konstante Differenz von 50 Prozent. Da die Preise für Eingabe und Ausgabe identisch sind, steigen die übrigen Kosten beim Wechsel zu gpt-6.1-sol nicht. Die Einsparung ergibt sich vollständig aus den halbierten Kosten für Cache-Lesezugriffe.
Voraussetzung für dieses Beispiel ist natürlich, dass der Cache tatsächlich Treffer erzielt. Ändert sich das Präfix Ihrer Anfragen jedes Mal – etwa weil Zeitstempel oder zufällige IDs am Anfang der System-Eingabeaufforderung stehen –, ist die Cache-Trefferquote möglicherweise sehr niedrig. Dann bringt auch der Wechsel der Modell-ID nur wenig. In diesem Fall sollten Sie zuerst die festen Inhalte an den Anfang und die variablen Inhalte ans Ende des Präfixes verschieben und erst danach die Modell-ID ändern. So fällt der Effekt deutlicher aus.
Schnellstart: gpt-6-sol auf gpt-6.1-sol umstellen
Der Änderungsumfang ist sehr klein: Beide Modell-IDs stehen heute in der Modellliste von APIYI. Du kannst sie direkt mit demselben API-Schlüssel aufrufen und musst weder ein neues Paket freischalten noch kaufen. Ändern musst du nur das Feld model im Request-Body.
Schnell umstellen: in 3 Schritten
- Alte ID suchen: Durchsuche das Code-Repository und das Konfigurationscenter nach
gpt-6-sol. Achte darauf, nicht versehentlich Zeichenfolgen wiegpt-6.1-solzu erfassen, die bereits die neue ID enthalten. Suche am besten gezielt nach dem vollständigen Wert in Anführungszeichen. - Feld
modelersetzen: Änderemodel="gpt-6-sol"zumodel="gpt-6.1-sol". Die Initialisierung des Clients bleibt unverändert:base_url="https://api.apiyi.com/v1"und dein bisheriger API-Schlüssel. - Mit geringem Traffic testen: Stelle zunächst nur einen Teil der Requests um. Prüfe im zurückgegebenen
usage-Objekt das Feld für Cache-Tokens und vergewissere dich, dass Cache-Treffer korrekt funktionieren. Danach kannst du vollständig umstellen.
Mit dem offiziellen OpenAI-Python-SDK sieht die Client-Initialisierung beispielsweise so aus: client = openai.OpenAI(api_key="YOUR_API_KEY", base_url="https://api.apiyi.com/v1"). Beim Aufruf musst du lediglich model in client.chat.completions.create(model="gpt-6.1-sol", messages=messages) ändern. messages und alle übrigen Parameter bleiben unverändert.
Empfohlene Konfiguration
Wenn der Modellname in deinem Projekt an mehreren Stellen fest eingetragen ist, bietet sich die Umstellung an, um ihn gleich zentral zu konfigurieren. Lege die Modell-ID beispielsweise in einer Umgebungsvariable ab: OPENAI_MODEL=gpt-6.1-sol. Im Code kannst du sie dann mit os.getenv("OPENAI_MODEL", "gpt-6.1-sol") auslesen. Bei einer künftigen Version musst du so nur noch eine Konfiguration ändern, statt die Einträge im gesamten Repository einzeln zu suchen und zu ersetzen.
Auch die Client-Konfiguration solltest du am besten aus Umgebungsvariablen auslesen, zum Beispiel OPENAI_BASE_URL=https://api.apiyi.com/v1. Da die Schnittstelle mit OpenAI kompatibel ist, kannst du SDK, LangChain und verschiedene Agent-Frameworks weiterhin wie bisher anbinden. Prüfe lediglich, ob base_url und model korrekt gesetzt sind.
🚀 Schnellstart: Bevor du die ID änderst, kannst du in der Modellliste von APIYI unter apiyi.com prüfen, ob
gpt-6.1-solin einer für dein Konto verfügbaren Gruppe aufgeführt ist. Danach besteht die Umstellung nur darin, eine Zeichenfolge im Feldmodeldes Requests zu ändern. Neue Nutzer können zunächst mit dem kostenlosen Testguthaben einen Test mit geringem Traffic durchführen.
Häufige Stolperfallen bei der Umstellung
- Nur einen Teil der Dienste umgestellt: Der Hauptdienst verwendet bereits die neue ID, aber in geplanten Aufgaben oder Offline-Batch-Skripten steht noch die alte. In der Abrechnung erscheinen dann beide Modelle.
- Modell-Whitelist im Gateway: Wenn dein internes Gateway oder die Proxy-Schicht Modellnamen anhand einer Whitelist prüft, musst du zuerst
gpt-6.1-solhinzufügen. - Protokolle und Monitoring nach Modellname gruppiert: Wenn dein Dashboard die Kosten nach Modellnamen aufschlüsselt, solltest du nach der Umstellung alte und neue ID gemeinsam beobachten. Andernfalls könnte es so aussehen, als wäre das Aufrufvolumen gesunken.
Vergleich der Cache-Rabatte von gpt-6.1-sol, Terra und Luna
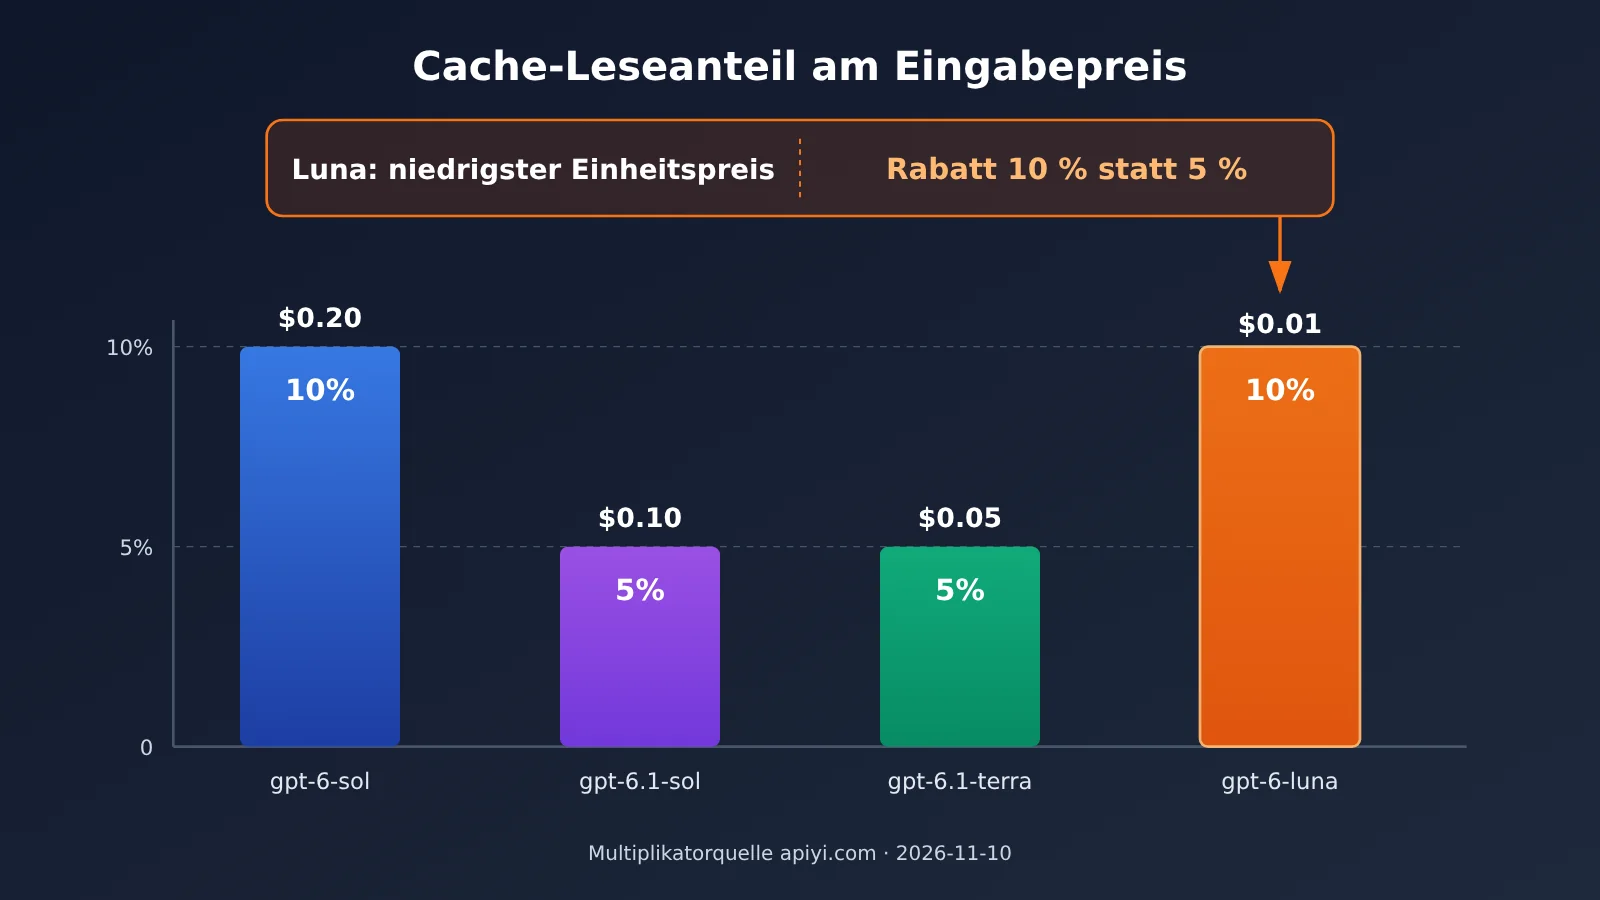
Viele Entwickler nutzen mehrere Modelle gleichzeitig und kommen leicht zu dem Schluss: Wenn der Cache-Leseanteil bei 6.1 Sol 5 % beträgt, gilt das dann auch für die anderen Modelle? Tatsächlich wird der Cache-Lesemultiplikator für jedes Modell einzeln festgelegt und lässt sich nicht einfach übertragen. Hier ist ein Vergleich der offiziellen Preise und Plattformmultiplikatoren vom selben Tag:
| Modell-ID | Eingabepreis | Ausgabepreis | Cache-Lesepreis | cache_ratio | Verfügbare Plattformen |
|---|---|---|---|---|---|
gpt-6-sol |
$2 | $10 | $0.20 | 0.1 | APIYI apiyi.com, offiziell bei OpenAI |
gpt-6.1-sol |
$2 | $10 | $0.10 | 0.05 | APIYI apiyi.com, offiziell bei OpenAI |
gpt-6.1-terra |
$1 | $5 | $0.05 | 0.05 | APIYI, offiziell bei OpenAI |
gpt-6-luna |
$0.10 | $0.50 | $0.01 | 0.1 | APIYI, offiziell bei OpenAI |
Einordnung im Vergleich
Vergleich mit Terra: Der Cache-Lesepreis von gpt-6.1-terra beträgt ebenfalls 5 % des Eingabepreises, der absolute Preis ist jedoch niedriger. In diesem Artikel geht es darum, welche ID innerhalb derselben Sol-Leistungsklasse die richtige ist. Terra gehört zu einer anderen Leistungsklasse. Ob sich ein Wechsel von Sol zu Terra lohnt, ist eine Frage der Modellauswahl und nicht Teil dieser Änderung.
Vergleich mit Luna: gpt-6-luna ist beim absoluten Preis am günstigsten; der Cache-Lesepreis beträgt nur $0.01. Der Cache-Rabatt liegt jedoch bei 10 % des Eingabepreises, nicht bei 5 %. Die Aussage „Mit dem Wechsel von Sol zu 6.1 halbieren sich die Cache-Kosten“ gilt also nur innerhalb der Sol-Leistungsklasse. Übertragen Sie sie nicht auf Luna, wenn Sie Ihr Budget berechnen.
💡 Empfehlung: Wenn Ihre Aufgabe die Leistungsklasse Sol erfordert, ist der direkte Wechsel von der alten ID zu
gpt-6.1-solder sicherste Schritt mit dem zuverlässigsten Einsparpotenzial. Wenn Sie Kosten durch einen Wechsel in eine andere Leistungsklasse senken möchten, testen Sie die verschiedenen Modelle am besten mit demselben APIYI-Key und vergleichen Sie die Ergebnisse. Berücksichtigen Sie bei der Kostenschätzung außerdem die jeweiligen Cache-Multiplikatoren.
Häufige Fragen (FAQ)
Q1: Worin genau unterscheiden sich die Preise von gpt-6-sol und gpt-6.1-sol?
Der einzige Unterschied betrifft das Lesen aus dem Cache. Bei beiden Modellen kostet die Eingabe 2 $ pro Million Token und die Ausgabe 10 $. Das Lesen aus dem Cache kostet bei `gpt-6-sol` 0,20 $ und bei `gpt-6.1-sol` 0,10 $ – das entspricht 10 % beziehungsweise 5 % des Eingabepreises. Datenstand: 10.11.2026. Die offiziellen Preise und die Plattform-Multiplikatoren stimmen überein.
Q2: Muss ich für den Wechsel zu gpt-6.1-sol ein neues Paket kaufen oder ein neues Konto eröffnen?
Nein. Beide Modell-IDs sind in der Modellliste von APIYI aufgeführt und lassen sich mit demselben API-Schlüssel aufrufen. Sie müssen lediglich das Feld `model` in der Anfrage ändern. `base_url` und Authentifizierung bleiben unverändert.
Q3: Wie rechne ich die Multiplikatoren von APIYI in Dollarpreise um?
Ausgehend von „Multiplikator 1 = 2 $ Eingabepreis pro Million Token“ gilt: Bei einem `model_ratio` von 1 kostet die Eingabe 2 $. Ein `completion_ratio` von 5 entspricht einem Ausgabepreis von 10 $. Bei einem `cache_ratio` von 0,05 kostet das Lesen aus dem Cache 0,10 $. Die tatsächliche Abrechnung hängt außerdem von der Kontogruppe ab. Maßgeblich ist die Modellliste auf APIYI apiyi.com.
Q4: In welchen Fällen lohnt sich der Wechsel zu gpt-6.1-sol besonders?
Vor allem bei langen Kontexten mit einer hohen Cache-Trefferquote:
– **Mehrstufige Agenten**: System-Eingabeaufforderung, Tool-Definitionen und frühere Nachrichten werden in jeder Runde erneut mitgesendet.
– **Programmierassistenten**: Dieselben Dateien aus einem Repository werden wiederholt als Kontext übermittelt.
– **Wissensdatenbank-Abfragen**: Ein fester, langer Dokumentpräfix wird mit wechselnden Nutzerfragen kombiniert.
Q5: Kann ich bei Luna und Terra ebenfalls mit „halbierten Cache-Lesekosten“ rechnen?
Nein, das lässt sich nicht pauschal übertragen. Bei `gpt-6.1-terra` betragen die Kosten für das Lesen aus dem Cache 5 % des Eingabepreises, bei `gpt-6-luna` sind es 10 %. Luna hat zwar den niedrigsten absoluten Preis, der Cache-Rabatt beträgt aber nicht 5 %. Berechnen Sie die Kosten bei der Budgetplanung daher jeweils anhand des entsprechenden `cache_ratio`.
Q6: Woran kann es liegen, dass die Rechnung nach dem Wechsel der ID nicht deutlich niedriger ausfällt?
Am häufigsten ist die Cache-Trefferquote zu niedrig. Enthält der Anfragepräfix beispielsweise einen Zeitstempel oder zufällige Felder, wird jedes Mal die vollständige Eingabe berechnet. Außerdem können einzelne Dienste noch die alte ID verwenden. Prüfen Sie die Cache-Token-Angaben im zurückgegebenen `usage` und rufen Sie in der APIYI-Konsole die Aufrufdetails für das jeweilige Modell auf.
Q7: Ändert sich die Ausgabequalität nach dem Wechsel?
Beide Modelle gehören zur selben Leistungsstufe, sind aber unterschiedliche Versionen. Bei einzelnen Aufgaben kann es daher Abweichungen geben. Am sichersten ist es, zunächst mit einem kleinen Datenverkehrsanteil oder einem Testsatz zu vergleichen und erst dann vollständig umzustellen, wenn die Ergebnisse den Anforderungen entsprechen.
gpt-6.1-sol: Die wichtigsten Punkte zu den Preisen für Cache-Lesezugriffe
- Gleicher Preis, anderer Cache-Preis: Die beiden Sol-Modelle kosten jeweils $2 für Eingaben und $10 für Ausgaben. Bei Cache-Lesezugriffen ist der Preis jedoch halb so hoch.
- Konkrete Preise für Cache-Lesezugriffe:
gpt-6-solkostet $0.20,gpt-6.1-sol$0.10 pro einer Million Token. - Besonders vorteilhaft bei langen Sitzungen: Je mehr Cache-Treffer es gibt, desto mehr sparst du mit dem Wechsel zu
gpt-6.1-sol. - Nur eine Änderung nötig: Ändere lediglich das Feld
modelin der Anfrage. Ein neuer Tarif ist nicht erforderlich. - Nicht auf Luna übertragen: Bei Luna kosten Cache-Lesezugriffe 10 % des Eingabepreises, nicht 5 %.
- So steigst du um: Teste mit APIYI und demselben Schlüssel zunächst mit einem kleinen Datenverkehr, bevor du vollständig wechselst.
Zusammenfassung
Die wichtigsten Punkte beim Wechsel von gpt-6-sol zu gpt-6.1-sol:
- Preisstruktur: Eingaben und Ausgaben kosten gleich viel. Der Preis für Cache-Lesezugriffe sinkt von 10 % auf 5 % des Eingabepreises. Datenstand: 2026-11-10.
- Umfang der Änderungen: Beide Modell-IDs sind in der Plattformliste aufgeführt. Du musst nur den Modellnamen in der Anfrage ersetzen;
base_urlund API-Schlüssel bleiben unverändert. - Geltungsbereich: Die Halbierung des Preises für Cache-Lesezugriffe gilt nur für Sol. Für Terra und Luna muss der jeweilige Cache-Multiplikator separat berechnet werden.
Wenn dein Dienst für lange Sitzungen noch die alte Modell-ID verwendet, ist das eine Optimierung, die sich nahezu ohne Aufwand umsetzen lässt. Prüfe zuerst bei APIYI unter apiyi.com die Modellliste und die Multiplikatoren. Anschließend kannst du mit den drei Schritten in diesem Artikel wechseln. Maßgeblich sind die Modellliste und Preise auf der Plattform.
📚 Quellen
- Offizielle OpenAI-Preise: Preise für Modelle der Standardklasse für Eingabe, Ausgabe und Cache-Eingabe
- Link:
developers.openai.com/api/docs/pricing -
Hinweis: Offizielle Preise für
gpt-6-sol,gpt-6.1-sol,gpt-6.1-terraundgpt-6-lunaabgleichen -
APIYI-Preisschnittstelle: Multiplikatoren für die Plattformmodelle
- Link:
api.apiyi.com/api/pricing - Hinweis: Die drei Multiplikatoren
model_ratio,completion_ratioundcache_ratioeinsehen
Autor: Technisches Team von APIYI
Technischer Austausch: Kontaktieren Sie uns gern über die Startseite von APIYI. Weitere Informationen zur Anbindung finden Sie im Dokumentationszentrum unter docs.apiyi.com.