Anmerkung des Autors: Am Beispiel des von niemandem beanspruchten kostenlosen Stealth-Modells Iceman auf OpenCode analysieren wir drei Informationsebenen – offizielle Angaben, Katalogparameter und unbestätigte Hinweise –, geben eine 5-Punkte-Checkliste für die Zeit vor der Anbindung und zeigen, wie man mehrere IDs zusammenführt, um Nutzungs-Rankings zu interpretieren.
Kostenlos, unbegrenzte Anfragen, ein großes Kontextfenster – aber niemand weiß, wer dahintersteckt. Solche kostenlosen Stealth-Modelle sind in Programmierwerkzeugen derzeit häufig anzutreffen, und die erste Reaktion vieler Entwickler lautet: „Erst mal ins Projekt einbinden und ausprobieren.“ Dieser Artikel nimmt Iceman auf OpenCode als Fallbeispiel und beantwortet eine konkrete Frage: Was musst du klären, bevor du Code oder Geschäftsdaten an ein kostenloses Modell mit unbekannter Herkunft schickst?
Dies ist kein Artikel, der dir vom Einsatz abrät – kostenlose Stealth-Modelle eignen sich durchaus für Prototypenvalidierung und Experimente mit öffentlichem Code. Entscheidend ist, zu unterscheiden, welche Informationen als Grundlage für die Nutzung taugen und welche nur Gerüchte sind – und welche praktischen Auswirkungen Trainings- und Aufbewahrungsklauseln auf deine Daten haben.
Der Kernnutzen: Nach der Lektüre hast du eine wiederverwendbare Checkliste für Stealth-Modelle, die vier Dimensionen abdeckt: Datentraining, Null-Datenaufbewahrung, kostenloser Zeitraum und Herkunftszuordnung. Außerdem lernst du, Fehlinterpretationen von Rankings wie „falsches Wachstum durch einen ID-Wechsel“ zu erkennen.
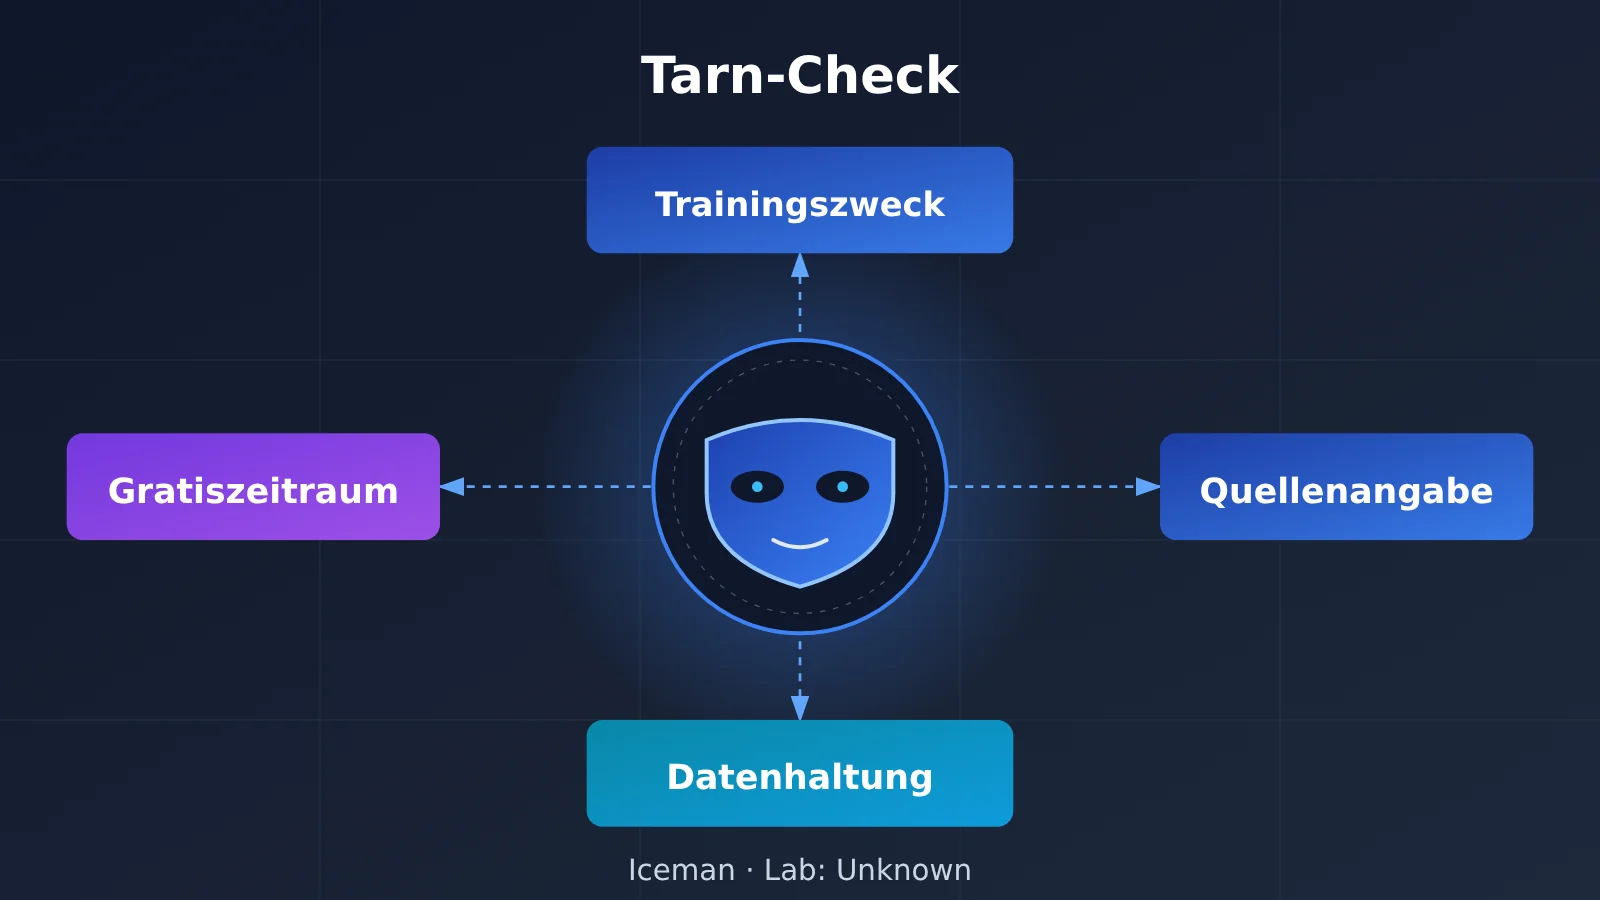
Kernpunkte des kostenlosen Stealth-Modells Iceman
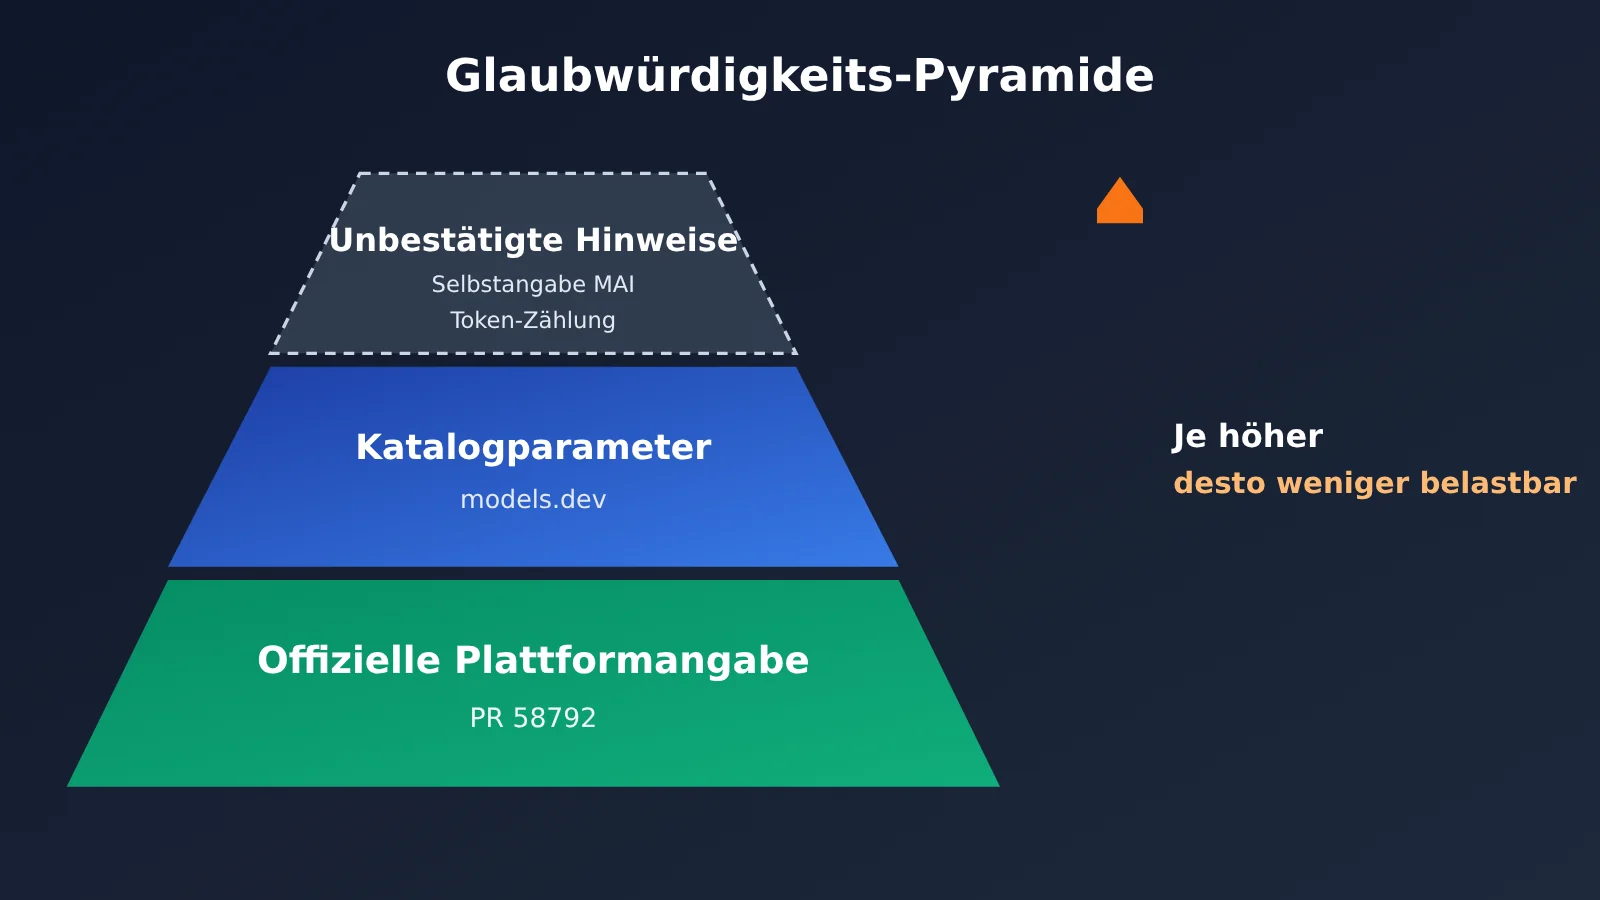
Stand 2026-11-04, 18:31 UTC: Iceman wurde noch von keinem KI-Labor beansprucht. Laut OpenCode-Nutzungsdaten hat es seit dem 23. Oktober unter zwei IDs insgesamt etwa 3,37 Billionen Tokens verarbeitet. Die folgende Tabelle ordnet die Informationen darüber zunächst nach Glaubwürdigkeit in drei Ebenen ein. Das ist die Grundlage für alle weiteren Einschätzungen.
| Informationsebene | Konkreter Inhalt | Als Nutzungsgrundlage geeignet |
|---|---|---|
| Offizielle Angaben der Plattform | Der von OpenCode gemergte PR 58792: zeitlich begrenzt kostenlos, keine Anfragebeschränkungen, Eingabeaufforderungen werden für das Training verwendet, Datenaufbewahrung nicht null | ✅ Ja, das ist ein Fakt auf Ebene der Nutzungsbedingungen |
| Katalogparameter | models.dev-Katalog: 262,144 Kontextfenster, maximal 131,072 Ausgabe-Tokens, unterstützt Reasoning und Tool-Aufrufe, Text rein, Text raus | ✅ Ja, für die Technologieauswahl |
| Unbestätigte Hinweise | Drittanbieter-Tracking behauptet, es bezeichne sich selbst als Microsoft MAI; die Token-Zählung stimme mit MAI Thinking 1 überein | ❌ Nein, nur als Gerücht zu behandeln |
Die offiziellen Bedingungen des Stealth-Modells Iceman im Detail
OpenCode hat Iceman am 24. Oktober in den Go-Tarif für 10 US-Dollar pro Monat aufgenommen; dies entspricht Pull Request 58792 im Repository, der um 20:24 UTC zusammengeführt wurde. Der Modellname lautet Iceman Contributor Free, und die Bedingungen nennen „zeitlich begrenzt kostenlos, keine Anfragebeschränkungen“. An derselben Stelle sind zwei Dinge vermerkt: Eingabeaufforderungen, die an das Modell gesendet werden, werden für das Training verwendet, und die Datenaufbewahrungsrichtlinie sieht keine Null-Datenaufbewahrung vor.
Diese beiden Punkte sind für Entwickler am wichtigsten; sie entscheiden direkter als Kontextfenster und Ausgabelänge darüber, welche Daten man senden darf. Außerdem hat der PR diese ID in die Liste der Stealth-Modelle von OpenCode aufgenommen; deshalb zeigt die Spalte „Labor“ auf der Nutzungsseite Unknown an. Mit anderen Worten: Die Plattform sagt dir selbst deutlich, dass die Herkunft unbekannt ist.
Was Contributor in der Benennung des Stealth-Modells wirklich bedeutet
Viele verstehen Contributor in iceman-contributor als Namen eines Labors oder eines Beitragenden. Tatsächlich bezeichnet es ein Tauschmodell von OpenCode: Trainingsdaten gegen kostenlosen Zugang. Auch Metas Muse Spark 1.3 und 1.2 haben Contributor-Versionen; das zeigt, dass es sich um ein allgemeines Label auf Plattformebene handelt und nicht um einen Hinweis auf die Herkunft des Modells.
Wenn du also das Wort Contributor siehst, lautet die richtige Interpretation: „Die Daten dieses Kanals fließen ins Training“ – und nicht: „Dies ist eine von einem Labor beigesteuerte Version“. Dieser Punkt wird in der folgenden Prüfliste als erster Punkt geprüft.
Auswirkungen der Trainingsbedingungen kostenloser Stealth-Modelle auf Code und Datenschutzdaten
„Eingabeaufforderungen werden zum Training verwendet“ klingt abstrakt – im Projektalltag ist es aber ein sehr konkretes Problem: Jeder Kontext, den Sie hinausschicken, kann zum Trainingsbeispiel eines fremden Modells werden. Bei Programmier-Tools umfasst der Kontext meist nicht nur die Frage, die Sie eintippen, sondern auch automatisch mitgeschickte Dateiinhalte, Fehlerprotokolle, Konfigurationsdateien und sogar Umgebungsvariablen.
Nicht-Null-Datenaufbewahrung bedeutet, dass die Anfrageinhalte für eine gewisse Zeit auf dem Server gespeichert bleiben. Wie lange genau, wo sie liegen und wer sie verarbeitet, lässt sich nicht klären, solange die Herkunft des Modells unbekannt ist. Bei Unternehmensprojekten berührt das meist direkt Vertraulichkeitsklauseln in Verträgen oder Anforderungen an die Datenkonformität. Die folgende Tabelle listet die tatsächlichen Risiken nach Datentyp auf.
| Datentyp | Typische Quelle | Risiko bei Training + Nicht-Null-Aufbewahrung | Empfehlung |
|---|---|---|---|
| Open-Source- oder öffentlicher Code | öffentliche Repos, Beispielprojekte | gering, die Inhalte sind bereits öffentlich | verwendbar |
| Unternehmensinterner Geschäftscode | interne Repos, Kernalgorithmen | hoch, Implementierungsdetails und Architektur könnten preisgegeben werden | nicht senden |
| Schlüssel und Konfiguration | .env, Konfigurationsdateien, CI-Skripte |
extrem hoch, Zugangsdaten könnten gespeichert und zum Training genutzt werden | zwingend ausschließen |
| Personenbezogene Nutzerdaten | Logs, Datenbank-Samples, Tickets | extrem hoch, betrifft die Konformität personenbezogener Daten | nicht senden |
| Synthetische oder anonymisierte Daten | Test-Fixtures, Mock-Daten | gering bis mittel, abhängig von der Qualität der Anonymisierung | nach Anonymisierung nutzbar |
An dieser Stelle sei besonders auf das Problem des „impliziten Kontexts“ bei Programmier-Tools hingewiesen. Viele Agenten lesen automatisch Dateien im Workspace – Sie glauben, nur zu fragen, wie eine Funktion geschrieben wird, tatsächlich landen aber womöglich die gesamte Verzeichnisstruktur und benachbarte Dateien mit im Request. Wer einen Trainings-Kanal nutzt, arbeitet am sichersten in einem separaten Workspace, der ausschließlich öffentliche oder synthetische Daten enthält.
So prüfen Sie kostenlose Stealth-Modelle: 5-Punkte-Checkliste vor der Integration
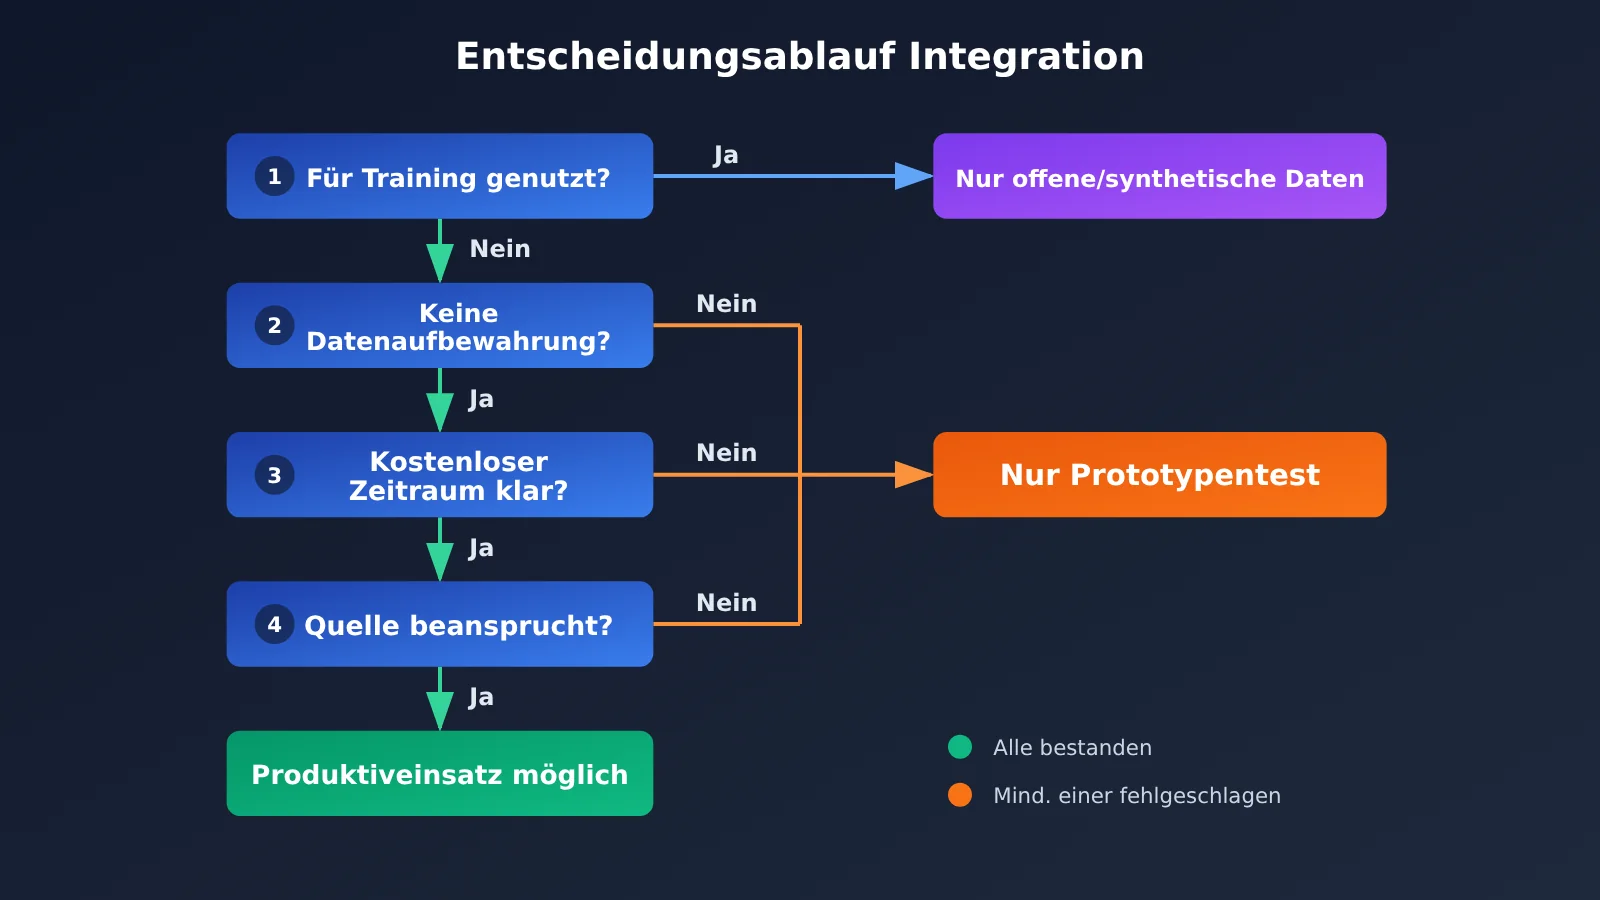
Diese Checkliste gilt nicht nur für Iceman, sondern für jedes kostenlose Modell, dessen Herkunft nicht offiziell bestätigt ist. Die ersten vier Punkte betreffen Nutzungsbedingungen und Herkunft, der fünfte die Interpretation der Daten. Am besten machen Sie daraus einen festen Review-Prozess im Team.
| Nr. | Prüfpunkt | Wo prüfen | Aktueller Status bei Iceman |
|---|---|---|---|
| 1 | Werden Eingabeaufforderungen für das Training verwendet? | Plattformbedingungen, Änderungsprotokoll der Modellkonfiguration | Ja, sie werden für das Training verwendet |
| 2 | Gilt Zero Data Retention? | Plattformbedingungen, Datenschutzhinweise | Nein, keine Zero-Data-Retention |
| 3 | Wie lange gilt die kostenlose Nutzung? | Plattformankündigungen, Tarifbeschreibung | Nur „zeitlich begrenzt“, Dauer unbekannt |
| 4 | Ist die Herkunft bestätigt? | Offizielle Erklärung des Labors | Nicht bestätigt; das Labor wird als „Unknown“ angezeigt |
| 5 | Werden Nutzungsdaten nach ID aufgeteilt? | Alle relevanten IDs in der Nutzungsrangliste | Ja, aufgeteilt in iceman und iceman-contributor |
Herkunft von Stealth-Modellen: Warum ein Hinweis noch keine Bestätigung ist
Zur Herkunft von Iceman berichtet die Tracking-Website stealthmodels.com, dass der X-Account @aitrackerbot entdeckt habe, Iceman stelle sich selbst als Microsofts MAI vor, und die Zählung der Prompt-Tokens stimme exakt mit MAI Thinking 1 überein. Die Tests der Website selbst ergaben jedoch, dass sie sowohl mit MAI Thinking 1 als auch mit der GPT-6-Reihe von OpenAI übereinstimmt. Das bedeutet: Die Token-Zählung kann diese Modelle nicht unterscheiden.
Was ein Modell über sich selbst sagt, ist ebenfalls unzuverlässig: Modelle geben Identitätsinformationen aus ihren Trainingsdaten wieder, und sie können durch System-Eingabeaufforderungen gezielt so gesetzt werden. Bislang hat Microsoft keine Erklärung abgegeben. Diese Information ist daher richtigerweise ein „Hinweis“ und sollte nicht als Tatsache in Ihre Dokumentation zur Technologieauswahl wandern.
Historische Präzedenzfälle bei der Bestätigung von Stealth-Modellen
Bei den bisherigen Stealth-Modellen von OpenCode erfolgte die Bestätigung normalerweise zum Zeitpunkt der Veröffentlichung oder innerhalb weniger Wochen. Z.ai bestätigte ox-alpha als GLM-5.3 Flash, Reflection AI bestätigte cat-jam als Beam, und Space Bunny wurde 26 Tage nach dem ersten Auftauchen von MiniMax als M3.1 Flash bestätigt. Stand 4. November ist Iceman seit 11 Tagen online und noch immer nicht offiziell zugeordnet.
Der Wert solcher Präzedenzfälle liegt darin, eine Erwartung zu setzen, nicht eine Vorhersage zu treffen. Sie sagen Ihnen, dass die Bestätigung mehrere Wochen dauern kann und dass Größe, Herkunft und Dauer der kostenlosen Nutzung in dieser Zeit unbekannt sind. Ihre Lösung darf sich nicht auf diese Unbekannten stützen.
Schnelleinstieg in kostenlose Stealth-Modelle: Mehrere IDs zusammenführen und die Nutzungsrangliste richtig lesen
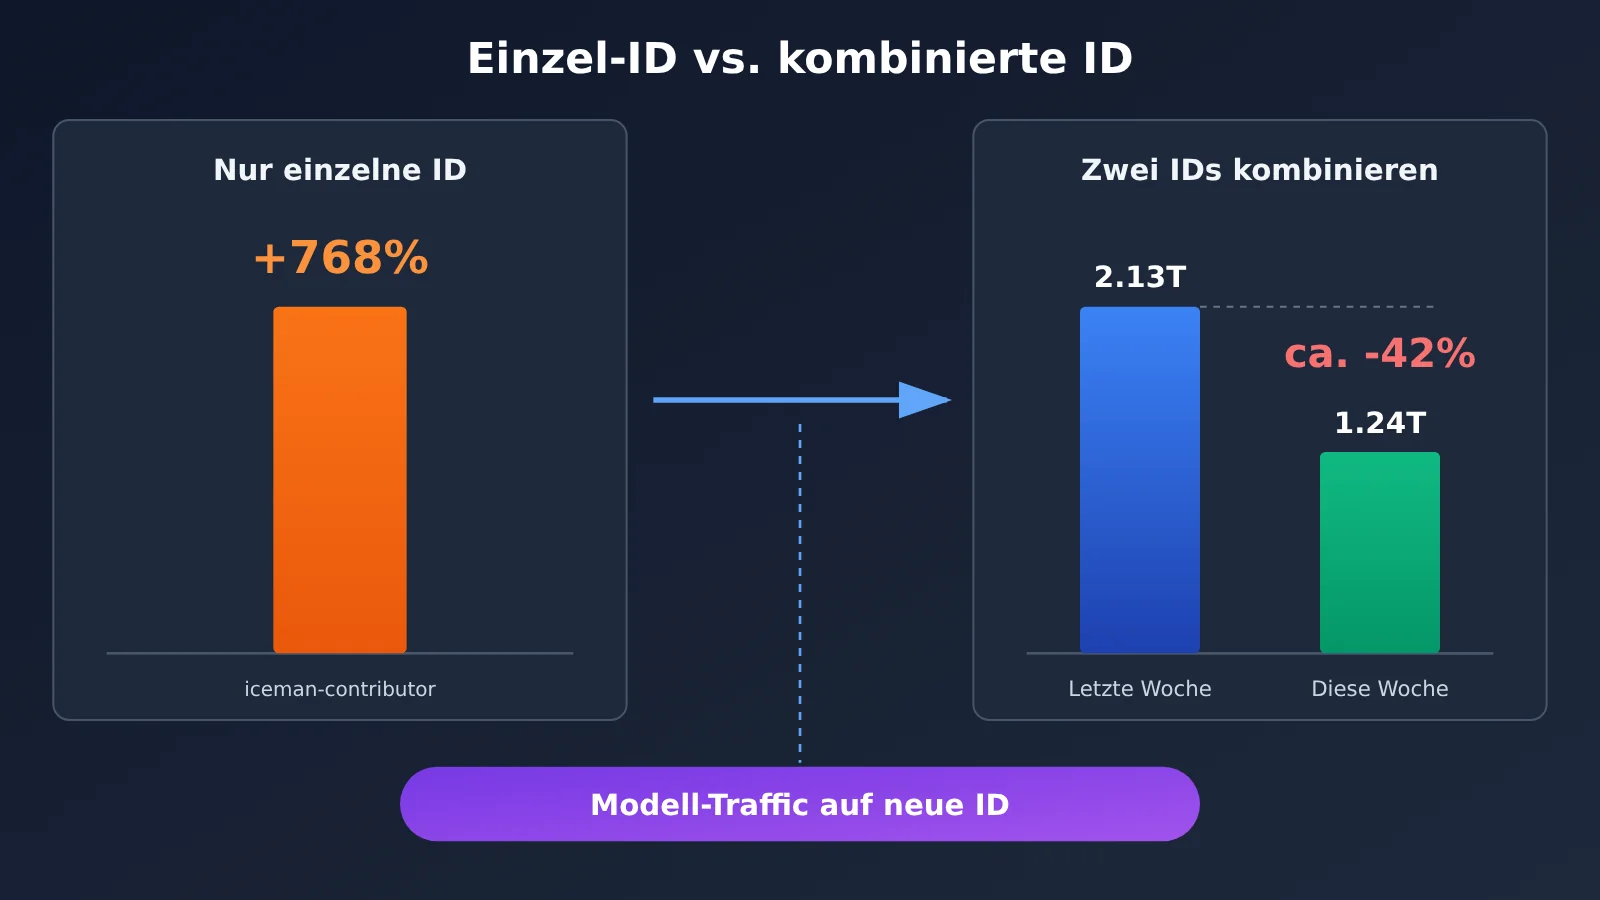
Die Performance von Iceman in der OpenCode-Wochenrangliste ist ein sehr typischer Fall von Fehlinterpretation einer Rangliste. Betrachtet man nur eine einzelne ID, kommt man zu dem Schluss eines „explosionsartigen Wachstums“; betrachtet man beide IDs zusammen, ist das Ergebnis genau umgekehrt.
| ID | Rang in der Wochenrangliste | Tokens diese Woche | Veränderung zur Vorwoche |
|---|---|---|---|
| iceman-contributor | #12 | 670B | +768% |
| iceman | #16 | 567B | -72% |
| Gesamt | — | ca. 1,24T | ca. -42 % (Vorwoche ca. 2,13T) |
Die +768 % sind kein Wachstum, sondern eine Verschiebung des Traffics desselben Modells von einer ID auf eine andere. Zusammen kommen die beiden IDs in den vergangenen 7 Tagen auf rund 1,24 Billionen Tokens – etwa 42 % weniger als die rund 2,13 Billionen der Vorwoche. Die tägliche Nutzung erreichte am 28. Oktober mit rund 653 Milliarden Tokens ihren Höhepunkt; vom 29. Oktober bis 3. November lag sie täglich zwischen 162 und 251 Milliarden.
Minimalbeispiel: IDs zusammenführen und die tatsächliche Veränderung zur Vorwoche berechnen
Das folgende Python-Snippet zeigt die Zusammenführungslogik. Die Daten stammen aus den oben genannten öffentlichen Zahlen. Die Werte der einzelnen IDs für die Vorwoche werden aus dem dieswöchigen Wert und der Veränderungsrate zurückgerechnet und sind daher Näherungswerte.
# Mehrere IDs desselben Modells, Tokens dieser Woche (Einheit: Milliarden) und Veränderung zur Vorwoche
ids = {
    "iceman-contributor": {"this_week": 670, "change": 7.68},   # +768%
    "iceman":             {"this_week": 567, "change": -0.72},  # -72%
}

this_total = sum(v["this_week"] for v in ids.values())
# Vorwochenwert aus der Veränderungsrate zurückrechnen: last = this / (1 + change)
last_total = sum(v["this_week"] / (1 + v["change"]) for v in ids.values())

print(f"本周合计:{this_total}B")
print(f"上周合计(反推):{last_total:.0f}B")
print(f"合并后环比:{(this_total / last_total - 1):.1%}")
Nach dem Ausführen erhält man für diese Woche rund 1.237B, für die Vorwoche eine Größenordnung von etwa 2.100B und eine kombinierte Veränderung von ungefähr -41 % bis -42 %. Das deckt sich im Wesentlichen mit den in der Berichterstattung genannten Summen. Die Rückrechnung ist mit Rundungsfehlern behaftet – in einer echten Analyse sollte man die原始 Wochendaten jeder einzelnen ID direkt auslesen.
Vollständige Implementierung ansehen: Modell-Strategie-Gate vor dem Zugriff
Der folgende Code gießt die Prüfliste in ein einfaches „Strategie-Gate“. Er ruft keine Schnittstelle einer konkreten Plattform auf, sondern entscheidet allein anhand der Metadaten, die du nach manueller Prüfung eingetragen hast, ob eine bestimmte Datenkategorie an ein bestimmtes Modell geschickt werden darf. Du kannst ihn vor deine eigene Request-Routing-Schicht setzen.
from dataclasses import dataclass
from typing import Optional

@dataclass
class ModelPolicy:
    model_id: str
    used_for_training: bool          # Prüfpunkt 1
    zero_data_retention: bool        # Prüfpunkt 2
    free_until: Optional[str]        # Prüfpunkt 3, None bedeutet Frist unbekannt
    lab_confirmed: bool              # Prüfpunkt 4
    related_ids: tuple = ()          # Prüfpunkt 5, für zusammengefasste Auswertung

# Daten-Sensitivitätsstufen: 0 öffentlich, 1 anonymisiert/synthetisch, 2 privater Code, 3 Schlüssel oder personenbezogene Daten
SENSITIVITY = {"public": 0, "synthetic": 1, "private_code": 2, "secret_or_pii": 3}

def max_allowed_level(p: ModelPolicy) -> int:
    """Gibt anhand der Modellbedingungen die höchste Sensitivitätsstufe zurück, die gesendet werden darf"""
    if p.used_for_training or not p.zero_data_retention:
        return 1          # Training oder keine Null-Aufbewahrung: nur öffentliche und synthetische Daten
    if not p.lab_confirmed:
        return 1          # Herkunft nicht bestätigt: ebenfalls nur Daten mit geringer Sensitivität
    return 2              # Erst wenn Bedingungen und Zuordnung bestätigt sind, kommt privater Code infrage

def can_send(p: ModelPolicy, data_kind: str) -> bool:
    level = SENSITIVITY[data_kind]
    if level >= 3:
        return False      # Schlüssel und personenbezogene Daten gehen niemals über externe kostenlose Kanäle
    return level <= max_allowed_level(p)

def production_ready(p: ModelPolicy) -> list:
    """Gibt eine Liste der Probleme zurück, die den Produktionseinsatz blockieren; eine leere Liste bedeutet, dass die Evaluierung starten kann"""
    issues = []
    if p.used_for_training:
        issues.append("提示词用于训练")
    if not p.zero_data_retention:
        issues.append("非零数据保留")
    if p.free_until is None:
        issues.append("免费期限未知,存在突然收费或下线风险")
    if not p.lab_confirmed:
        issues.append("来源未认领,无法评估模型规模与长期可用性")
    return issues

iceman = ModelPolicy(
    model_id="iceman-contributor",
    used_for_training=True,
    zero_data_retention=False,
    free_until=None,
    lab_confirmed=False,
    related_ids=("iceman", "iceman-contributor"),
)

for kind in SENSITIVITY:
    print(f"{kind:15s} -> {'允许' if can_send(iceman, kind) else '拒绝'}")

print("生产接入阻碍:", production_ready(iceman))
Praxistipp: Pflegen Sie die oben gezeigten Metadaten als teamweit geteilte Konfiguration und aktualisieren Sie sie immer dann, wenn sich die Plattformbedingungen oder der Status der Modellzuordnung ändern. So können neue Kolleginnen und Kollegen beim Anbinden irgendeines kostenlosen Modells direkt dieselben Bewertungsmaßstäbe wiederverwenden, statt aus dem Bauch heraus zu entscheiden.
Häufig gestellte Fragen (FAQ)
F1: Was ist ein kostenloses Stealth-Modell?
Ein Stealth-Modell ist ein Modell, das auf einer Plattform unter einem Codenamen live geht, während die Identität des Labors vorerst geheim bleibt. Die Nutzungsseite der Plattform zeigt die Herkunft üblicherweise als Unknown an. Iceman ist eines der Modelle in der Stealth-Modell-Liste von OpenCode und war Stand 2026-11-04 noch nicht beansprucht.
F2: Worin unterscheiden sich Iceman und iceman-contributor?
Den öffentlichen Daten zufolge sind es zwei IDs, die die OpenCode-Nutzungsrangliste für dasselbe Modell führt: In der Wochenrangliste schießt die eine steil nach oben, die andere fällt steil ab – tatsächlich wandert der Traffic nur zwischen den beiden IDs hin und her. Der Begriff „Contributor“ bezeichnet das Plattform-Tauschmodell „Trainingsdaten gegen kostenlosen Zugang“ und nicht den Namen eines Labors.
F3: Wie lange dauert die kostenlose Phase von Iceman?
Dazu gibt es derzeit keine öffentliche Antwort. Die Änderung bei OpenCode sagt nur „zeitlich begrenzt kostenlos, keine Anfragebegrenzung“ und nennt kein Enddatum. Modellgröße, Entwickler und Dauer der kostenlosen Phase gehören alle zu den derzeit unbekannten Informationen – deshalb sollte man sich in Produktionsszenarien nicht auf seinen kostenlosen Status verlassen.
F4: Für welche Szenarien eignen sich kostenlose Stealth-Modelle am besten?
Unter der Voraussetzung, dass die Bedingungen ausdrücklich „Verwendung für Training, Aufbewahrung ungleich null“ festhalten, sind vor allem diese Szenarien geeignet:
– **Experimente mit Open-Source-Projekten**: Arbeiten an ohnehin öffentlichem Code, etwa Beispiele oder Tests für eine Open-Source-Bibliothek schreiben.
– **Einschätzung der Fähigkeiten**: Mit synthetischen Aufgaben das Reasoning und die Tool-Aufrufe testen, um das Verhalten bei großem Kontext kennenzulernen.
– **Persönliche Lernprototypen**: Ein Demo ohne echte Daten aufbauen, um zu prüfen, ob der Interaktionsablauf funktioniert.
F5: Wie setze ich diese Checkliste zur Prüfung von Stealth-Modellen im Team um?
Empfohlen sind drei Schritte: Zuerst die fünf Prüfpunkte in das Dokument zur Modellfreigabe schreiben, dann wie beim oben beschriebenen Policy-Gate auf der Routing-Ebene nach Daten-Sensibilitätsstufe blockieren und schließlich für Programmier-Tools einen separaten Workspace einrichten, damit der Agent nicht automatisch private Dateien mitnimmt. Ändern sich die Bedingungen, genügt es, die Metadaten entsprechend zu aktualisieren.
F6: Kann man es glauben, wenn ein Modell behauptet, Produkt einer bestimmten Firma zu sein?
Nicht direkt. Die Selbstauskunft eines Modells kann aus dem Trainingskorpus oder aus der System-Eingabeaufforderung stammen, und auch die Token-Zählweise kann zwischen mehreren Modellen völlig identisch sein. Bei Iceman etwa hat ein Test von Drittanbietern ergeben, dass die Zählung ebenso gut zu MAI Thinking 1 und zur GPT-6-Reihe passt – eine Unterscheidung ist damit nicht möglich. Die Zuordnung gilt nur, wenn das Labor sie offiziell beansprucht.
F7: Was passiert mit bereits gesendeten Daten, wenn ein Stealth-Modell beansprucht wird?
Eine Beanspruchung ändert nur die Angaben zur Herkunft, nicht die Bedingungen, die beim Senden deiner Daten galten. Waren diese damals so formuliert, dass die Daten für Training verwendet und ungleich null aufbewahrt werden, steht die Behandlung dieser Daten bereits fest. Genau deshalb muss die Prüfung vor dem Senden abgeschlossen sein und nicht erst nach der Beanspruchung nachgeholt werden.
Kernaussagen zum kostenlosen Stealth-Modell (Key Takeaways)
- Erst die Bedingungen lesen, dann die Parameter: Wofür das Modell trainiert wird und welche Daten aufbewahrt werden, entscheidet darüber, was man senden darf. Die Kontextlänge entscheidet nur darüber, wie viel man senden kann.
- Contributor ist ein Tauschmodell: Es steht für Trainingsdaten im Gegenzug für kostenlosen Zugang – nicht für die Herkunft des Modells.
- Hinweise sind keine Bestätigung: Weder die Selbstauskunft eines Modells über seine Identität noch Token-Zählungen beweisen, wem es gehört.
- Kostenlose Laufzeit als unbekannt behandeln: Ein „zeitlich begrenztes“ Angebot ohne Enddatum sollte in der Planung nicht einkalkuliert werden.
- Ranglisten mit zusammengefassten IDs lesen: Die +768 % von Iceman ergeben nach dem Zusammenführen der IDs tatsächlich etwa -42 %.
- Sensible Daten grundsätzlich isolieren: API-Schlüssel, personenbezogene Daten und privater Kerncode gehören nicht in Trainingskanäle.
Fazit
Ob sich ein kostenloses Stealth-Modell in ein Projekt integrieren lässt, hängt davon ab, welche Daten man senden will – nicht davon, ob es kostenlos ist. Am Beispiel Iceman lassen sich die Plattformbedingungen und die Katalogparameter als belastbare Grundlage heranziehen: Nutzung für das Training, Datenaufbewahrung ungleich null, zeitlich begrenzte kostenlose Nutzung, 262.144 Kontextfenster, Unterstützung von Reasoning und Tool-Aufrufen. Nicht belastbar sind die verschiedenen Hinweise auf den Entwickler – sie bleiben bis zur offiziellen Bestätigung Gerüchte.
Die wiederverwendbare Methodik lässt sich in drei Punkten zusammenfassen:
- Informationen schichten: Plattformaussagen, Katalogparameter und unbestätigte Hinweise getrennt betrachten und nur die ersten beiden Ebenen für Entscheidungen nutzen.
- Nach Datenklassifizierung einsetzen: Trainingskanäle nur mit öffentlichen oder synthetischen Daten beschicken; privater Code und personenbezogene Daten werden separat behandelt.
- Ranglisten mit einheitlichem Bezug lesen: Bei mehreren IDs desselben Modells müssen die Werte erst addiert werden, bevor man Wachstumsraten berechnet – sonst täuscht ein ID-Wechsel ein Wachstum vor.
Wer auch immer Iceman später offiziell bestätigt: Diese Prüfmethode lässt sich dauerhaft auf das nächste Stealth-Modell übertragen, das auftaucht.
📚 Referenzen
- ArtificialWatch – Analyse zu Iceman-Nutzung und -Zuschreibung: Zentrale Faktenquelle dieses Artikels
- Link:
artificialwatch.com/wire/iceman-opencode-stealth-model-3-trillion-tokens-unclaimed -
Beschreibung: Fasst die Nutzung beider Iceman-IDs, Änderungen der Nutzungsbedingungen und Hinweise zur Zuschreibung zusammen; veröffentlicht am 2026-11-04
-
OpenCode Data – Nutzungsseite: Nutzungsdaten von iceman und iceman-contributor
- Link:
opencode.ai/data -
Beschreibung: Zeigt direkt die Wochenranglisten-Position und den Token-Verbrauch der einzelnen IDs
-
models.dev – Modellkatalog: Technische Parameter von Iceman
- Link:
models.dev -
Beschreibung: Liefert Katalogdaten zu Kontextfenster, maximaler Ausgabe, Reasoning und Tool-Aufrufen
-
stealthmodels.com – Tracking von Stealth-Modellen: Quelle für Berichte zu Zuschreibungshinweisen
- Link:
stealthmodels.com - Beschreibung: Dokumentiert Tests zur selbst angegebenen Identität von Iceman und zur Token-Zählung; dient nur als Hinweisquelle
Autor: APIYI-Technikteam
Hinweis: Die Fakten in diesem Artikel haben den Stand vom 2026-11-04. Der Zuschreibungsstatus und die kostenlose Nutzungsfrist von Iceman können sich jederzeit ändern; maßgeblich sind die jeweils aktuellen Bedingungen der Plattform.